Kiadja a legújabb szoftverfrissítést, és máris özönlenek a bejelentések.
Hirtelen egyetlen mutató határozza meg mindent a CSAT/NPS-től a fejlesztési ütemterv elcsúszásáig: a hibaelhárítási idő.
A vezetők ezt a mutatószámot az ígéretek betartásának mércéjeként tekintik: képesek vagyunk-e a tervek szerint kiadni a termékeket, tanulni és megőrizni a bevételeket? A gyakorlati szakemberek viszont a frontvonalban érzik a nehézségeket: ismétlődő jegyek, nem egyértelmű felelősségi körök, zavaros eskalációk, valamint a Slackben, táblázatokban és különálló eszközökben szétszórt kontextus.
Ez a széttagoltság meghosszabbítja a ciklusokat, elrejti a kiváltó okokat, és a prioritások meghatározását találgatássá teszi.
Az eredmény? Lassúbb tanulás, be nem tartott vállalások és egy olyan felhalmozódott munkamennyiség, amely minden sprintet csendben megterhel.
Ez az útmutató egy átfogó kézikönyv a hibajavítási idő méréséhez, összehasonlításához és csökkentéséhez, amely konkrét példákkal szemlélteti, hogyan változtatja meg a mesterséges intelligencia a munkafolyamatot a hagyományos, manuális folyamatokhoz képest.
Mi az a hibajavítási idő?
A hibaelhárítási idő az a időtartam, amely egy hiba kijavításához szükséges, és amelyet a hiba bejelentésének pillanatától annak teljes kijavításáig mérnek.
A gyakorlatban az időmérés akkor kezdődik, amikor egy hibát jelentettek vagy észleltek (felhasználók, minőségbiztosítás vagy felügyelet révén), és akkor áll meg, amikor a javítást végrehajtották és beépítették, és az készen áll az ellenőrzésre vagy a kiadásra – attól függően, hogy a csapata hogyan határozza meg a „kész” fogalmát.
Példa: egy hétfőn 10:00-kor bejelentett P1-es összeomlás, amelynek javítását kedden 15:00-kor egyesítették, körülbelül 29 órás megoldási idővel jár.
Ez nem azonos a hiba észlelési idejével. Az észlelési idő azt méri, hogy milyen gyorsan ismeri fel a hibát annak bekövetkezte után (riasztások, a minőségbiztosítási tesztelőeszközök által történő észlelés, az ügyfelek által bejelentett hibák).
A hibaelhárítási idő azt méri, milyen gyorsan jut el a hiba észlelésétől a kijavításig – azaz a triázs, a reprodukálás, a diagnosztizálás, a megvalósítás, az ellenőrzés, a tesztelés és a kiadásra való felkészülés lépésein keresztül. Gondoljon az észlelésre úgy, mint „tudjuk, hogy nem működik”, a hibaelhárításra pedig úgy, mint „már kijavítottuk és készen áll”.
A csapatok kissé eltérő határokat alkalmaznak; válasszon egyet, és tartsa be következetesen, hogy a trendek valósak legyenek:
- Jelentett → Megoldott: A folyamat akkor zárul le, amikor a kódjavítás beépítésre került és készen áll a minőségbiztosításra. Alkalmas a fejlesztési teljesítmény mérésére
- Jelentett → Lezárt: Tartalmazza a minőségbiztosítási ellenőrzést és a kiadást. Leginkább az ügyfeleket érintő SLA-k esetében ajánlott
- Észlelés → Megoldás: A folyamat akkor kezdődik, amikor a felügyelet/minőségbiztosítás észleli a problémát, még mielőtt jegy lenne róla. Hasznos a nagy termelési terheléssel dolgozó csapatok számára
🧠 Érdekesség: A Final Fantasy XIV -ben előforduló furcsa, de nevetséges hiba azért kapott dicséretet, mert annyira specifikus volt, hogy az olvasók a „2025-ös év legspecifikusabb MMO-hibajavítása” névvel illették. ” Akkor jelentkezett, amikor a játékosok egy bizonyos eseményzónában pontosan 44 442 és 49 087 gil közötti árat állítottak be a tárgyakra – ami valószínűleg egy egészszám-túlcsordulási hiba miatt kapcsolatmegszakadásokat okozott.
Miért fontos ez?
A hibaelhárítási idő a kiadási ütem szabályozó tényezője. A hosszú vagy kiszámíthatatlan időtartamok kényszerítik a hatókör szűkítését, a gyorsjavítások kiadását és a kiadások befagyasztását; tervezési adósságot okoznak, mert a hosszú farok (szélsőséges értékek) jobban megzavarja a sprinteket, mint azt az átlag sugallná.
Ez közvetlenül összefügg az ügyfél-elégedettséggel is. Az ügyfelek eltűrik a problémákat, ha azokat gyorsan felismerik és kiszámítható módon megoldják. A lassú – vagy ami még rosszabb, az ingadozó – javítások eskalációkat eredményeznek, rontják a CSAT/NPS-értékeket, és veszélybe sodorják a szerződésmegújításokat.
Röviden: ha pontosan méri a hibajavítási időt, és szisztematikusan csökkenti azt, akkor fejlesztési tervei és kapcsolatai is javulni fognak.
📖 További információk: Hogyan rangsorolhatja a hibákat a hatékony problémamegoldás érdekében
Hogyan mérhető a hibajavítási idő?
Először is döntse el, hol kezdődik és hol végződik az időmérés.
A legtöbb csapat vagy a „Jelentett → Megoldott” (a javítás beépítve és ellenőrzésre kész) vagy a „Jelentett → Lezárt” (a minőségbiztosítás ellenőrizte, és a módosítás kiadásra került vagy más módon lezárult) állapotot választja.
Válasszon ki egy definíciót, és használja azt következetesen, hogy a trendjei értelmezhetőek legyenek.
Most pedig szükséged van néhány megfigyelhető mutatóra. Vessünk rá egy pillantást ezekre:
A hibakövetés során figyelembe veendő legfontosabb mutatók:
| 📊 Mérőszám | 📌 Mit jelent ez | 💡 Hogyan segít ez | 🧮 Képlet (ha alkalmazható) |
|---|---|---|---|
| Hibaszám 🐞 | A bejelentett hibák összesen száma | Áttekintést nyújt a rendszer állapotáról. Magas az érték? Ideje kivizsgálni. | Hibák összesen = A rendszerben rögzített összes hiba {Nyitott + Lezárt} |
| Nyitott hibajelentések 🚧 | Még nem javított hibák | Megjeleníti az aktuális munkaterhelést. Segít a prioritások meghatározásában. | Nyitott hibák = Összes hiba – Lezárt hibák |
| Lezárt hibák ✅ | Megoldott és ellenőrzött hibák | Nyomon követi az előrehaladást és az elvégzett munkát. | Lezárt hibák = A „Lezárt” vagy „Megoldott” állapotú hibák száma |
| A hibák súlyossága 🔥 | A hiba súlyossága (pl. kritikus, jelentős, kisebb) | Segít a hatások alapján történő osztályozásban. | Kategóriás mezőként kerül nyomon követésre, képlet nélkül. Használjon szűrőket/csoportosítást. |
| A hibák prioritása 📅 | Mennyire sürgős egy hiba kijavítása | Segít a sprint- és kiadási tervezésben. | Ezenkívül egy kategorikus mező is, amely általában rangsorolva van (pl. P0, P1, P2). |
| A hibaelhárítás ideje ⏱️ | A hibajelentéstől a javításig eltelt idő | Méri a reagálási képességet. | A hibaelhárítás ideje = a lezárás dátuma – a bejelentés dátuma |
| Újra megnyitási arány 🔄 | A lezárás után újra megnyitott hibák aránya | A javítások minőségét vagy a regressziós problémákat tükrözi. | Újra megnyitási arány (%) = {Újra megnyitott hibák ÷ Összes lezárt hiba} × 100 |
| Hibaszivárgás 🕳️ | A termelésbe becsúszott hibák | A minőségbiztosítás/szoftvertesztelés hatékonyságát jelzi. | Szivárgási arány (%) = {Termelési hibák ÷ Összes hiba} × 100 |
| Hibasűrűség 🧮 | Hibák a kód méret egységeként | Kiemeli a kockázatra hajlamos kódrészeket. | Hibasűrűség = hibák száma ÷ KLOC {kiló sor kód} |
| Kijelölt és kijelöletlen hibák 👥 | A hibák megoszlása felelősségi kör szerint | Így biztosítható, hogy semmi ne maradjon figyelmen kívül. | Használjon szűrőt: Hozzárendelés nélküli = Hibák, ahol az „Hozzárendelve” mező értéke üres |
| A nyitott hibák életkora 🧓 | Mennyi ideig marad megoldatlan egy hiba? | Felismeri a stagnálás és a felhalmozódott munkák kockázatait. | A hiba életkora = aktuális dátum – bejelentés dátuma |
| Ismétlődő hibák 🧬 | Az ismétlődő bejelentések száma | Kiemeli a beérkező ügyek feldolgozási folyamatában fellépő hibákat. | Duplikátumok aránya = Duplikátumok ÷ Összes hiba × 100 |
| MTTD (átlagos észlelési idő) 🔎 | A hibák vagy incidensek felderítéséhez átlagosan szükséges idő | Méri a monitorozás és a tudatosság hatékonyságát. | MTTD = Σ(Felfedezés ideje – Felmerülés ideje) ÷ Hibák száma |
| MTTR (átlagos hibaelhárítási idő) 🔧 | A hiba észlelését követő teljes kijavításához szükséges átlagos idő | Nyomon követi a mérnökök reagálási idejét és a hiba kijavításához szükséges időt. | MTTR = Σ(A hiba kijavításáig eltelt idő – A hiba észleléséig eltelt idő) ÷ A kijavított hibák száma |
| MTTA (átlagos visszaigazolási idő) 📬 | Az észleléstől addig az idő, amíg valaki megkezdi a hiba kijavítását | Megmutatja a csapat reagálóképességét és a riasztásokra való reagálási képességét. | MTTA = Σ(A hibajelentés nyugtázásának ideje – A hiba észlelésének ideje) ÷ A hibák száma |
| MTBF (átlagos meghibásodás közötti idő) 🔁 | Az egyik kijavított hiba és a következő hiba között eltelt idő | Az időbeli stabilitást jelzi. | MTBF = Teljes üzemidő ÷ Meghibásodások száma |
⚡️ Sablonarchívum: 15 ingyenes hibajelentési sablon és űrlap a hibák nyomon követéséhez
A hibajavítási időt befolyásoló tényezők
A hibaelhárítási időt gyakran egyenlővé teszik azzal, hogy „milyen gyorsan írnak kódot a fejlesztők”.
De ez csak a folyamat egyik része.
A hibajavítási idő a beérkezéskori minőség, a rendszeren belüli folyamat hatékonysága és a függőségi kockázat összessége. Ha ezek közül bármelyik meghibásodik, a ciklusidő megnyúlik, a kiszámíthatóság csökken, és egyre hangosabbá válnak a panaszok.
A beérkező ügyek minősége meghatározza a további folyamatot
Azok a bejelentések, amelyekhez nincsenek egyértelmű reprodukciós lépések, környezeti részletek, naplófájlok vagy verzió-/build-adatok, felesleges oda-vissza levelezést eredményeznek. A több csatornáról (támogatás, minőségbiztosítás, felügyelet, Slack) érkező duplikált bejelentések zavart okoznak és széttöredezetté teszik a felelősségi köröket.
Minél hamarabb rögzíti a megfelelő kontextust – és elvégzi a duplikátumok kiszűrését –, annál kevesebb átadásra és tisztázó megkeresésre lesz szüksége később.
A prioritásmeghatározás és az irányítás határozza meg, ki foglalkozik a hibával és mikor
Azok a súlyossági címkék, amelyek nem tükrözik az ügyfelekre vagy az üzletre gyakorolt hatást (vagy amelyek idővel eltolódnak), a várólista felborulásához vezetnek: a leghangosabb jegyek előreugranak a sorban, míg a nagy hatással járó hibák várakoznak.
A komponensenkénti/tulajdonosonkénti egyértelmű irányítási szabályok és az egységes „igazság-sor” megakadályozzák, hogy a P0/P1-es feladatok elsüllyedjenek a „legfrissebb és legzajosabb” feladatok alatt.
A felelősségvállalás és az átadások a csendes gyilkosok
Ha nem egyértelmű, hogy egy hiba a mobil-, a háttér-hitelesítési vagy a platformcsapat hatáskörébe tartozik-e, akkor a hiba továbbkerül. Minden ilyen továbbítás visszaállítja a kontextust.
Az időzónák tovább nehezítik a helyzetet: egy nap végén bejelentett, felelős nélkül maradt hiba akár 12–24 órát is veszíthet, mire valaki egyáltalán megpróbálja reprodukálni. A „ki miért felelős” kérdés szigorú meghatározása, készenléti vagy heti DRI kijelöléssel, kiküszöböli ezt a késedelmet.
A reprodukálhatóság a megfigyelhetőségtől függ
A hiányos naplófájlok, a hiányzó korrelációs azonosítók vagy a rendszerleállási nyomok hiánya miatt a diagnosztika találgatássá válik. Azokat a hibákat, amelyek csak bizonyos jelzők, bérlők vagy adatformátumok esetén jelentkeznek, nehéz reprodukálni a fejlesztői környezetben.
Ha a fejlesztők nem férhetnek hozzá biztonságosan a tisztított, termeléshez hasonló adatokhoz, akkor végül napokig – órák helyett – kell műszerezniük, újratelepíteniük és várniuk.
A környezet és az adatok egységessége biztosítja a megbízhatóságot
A „Nálam működik” általában azt jelenti, hogy „a termelési adatok eltérőek”. Minél jobban eltér a fejlesztői/tesztkörnyezeted a termeléstől (konfiguráció, szolgáltatások, harmadik féltől származó verziók), annál több időt fogsz tölteni hiábavaló keresgéléssel. Az adatpillanatképek, a seed szkriptek és a paritásellenőrzések csökkentik ezt a különbséget.
A folyamatban lévő munkák (WIP) és a fókusz határozzák meg a tényleges átbocsátási teljesítményt
A túlterhelt csapatok egyszerre túl sok hibát vesznek kezelésbe, figyelmük szétszóródik, és a feladatok és megbeszélések között rohangálnak. A kontextusváltás láthatatlan órákat jelent.
A látható WIP-korlát és az a szemlélet, hogy a megkezdett munkát befejezzük, mielőtt új feladatot vállalnánk, gyorsabban csökkenti a mediánt, mint bármely egyéni hősi erőfeszítés.
A kódfelülvizsgálat, a folyamatos integráció (CI) és a minőségbiztosítás (QA) sebessége klasszikus szűk keresztmetszetek
A lassú összeállítási idők, a megbízhatatlan tesztek és a nem egyértelmű felülvizsgálati SLA-k akadályozzák az egyébként gyors javításokat. Egy 10 perces javítás akár két napot is eltölthet azzal, hogy várja a felülvizsgálót, vagy beillesztésre vár egy órákig tartó folyamatba.
Hasonlóképpen, azok a minőségbiztosítási sorok, amelyek a tesztelést kötegenként végzik, vagy manuális füsttesztekre támaszkodnak, akár egész napokkal is meghosszabbíthatják a „Jelentett → Lezárt” folyamatot, még akkor is, ha a „Jelentett → Megoldott” folyamat gyors.
A függőségek meghosszabbítják a várólistákat
A csapatok közötti változások (séma, platformmigrációk, SDK-frissítések), a beszállítói hibák vagy az alkalmazásbolti felülvizsgálatok (mobil) várakozási állapotokat eredményeznek. Kifejezett „Blokkolva/Szüneteltetve” nyomon követés nélkül ezek a várakozások láthatatlanul felfújják az átlagértékeket, és elrejtik a valódi szűk keresztmetszetet.
A kiadási modell és a visszavonási stratégia fontossága
Ha nagy méretű, manuális ellenőrzési pontokkal rendelkező kiadási vonatokban szállít, akkor még a már kijavított hibák is várakoznak a következő vonat indulásáig. A funkciójelzők, a kanári kiadások és a gyorsjavítási sávok lerövidítik a feldolgozási időt – különösen a P0/P1-es incidensek esetében –, mivel lehetővé teszik a javítások telepítésének elválasztását a teljes kiadási ciklusoktól.
Az architektúra és a technológiai adósság határozzák meg a fejlődés felső határát
A szoros összekapcsoltság, a tesztelési határfelületek hiánya és az átláthatatlan, elavult modulok miatt az egyszerű javítások is kockázatosak. A csapatok ezt extra teszteléssel és hosszabb felülvizsgálatokkal kompenzálják, ami meghosszabbítja a ciklusokat. Ezzel szemben a jó szerződéses tesztekkel rendelkező moduláris kód lehetővé teszi a gyors előrelépést anélkül, hogy a szomszédos rendszerek működését megzavarná.
A kommunikáció és a státuszok rendezettsége befolyásolja a kiszámíthatóságot
A homályos frissítések („vizsgáljuk a problémát”) felesleges munkát eredményeznek, amikor az érdekelt felek az várható befejezési időpontról érdeklődnek, a támogatás újra megnyitja a jegyeket, vagy a termékmenedzsment feljebb viszi az ügyet. Az egyértelmű állapotváltozások, a reprodukcióra és a kiváltó okra vonatkozó megjegyzések, valamint a közzétett várható befejezési időpont csökkentik a lemorzsolódást, és segítik a fejlesztői csapat koncentrációját.
📮ClickUp Insight: Az átlagos szakember naponta több mint 30 percet tölt munkával kapcsolatos információk keresésével – ez évente több mint 120 óra, amelyet e-mailek, Slack-beszélgetések és szétszórt fájlok átkutatásával veszteget el.
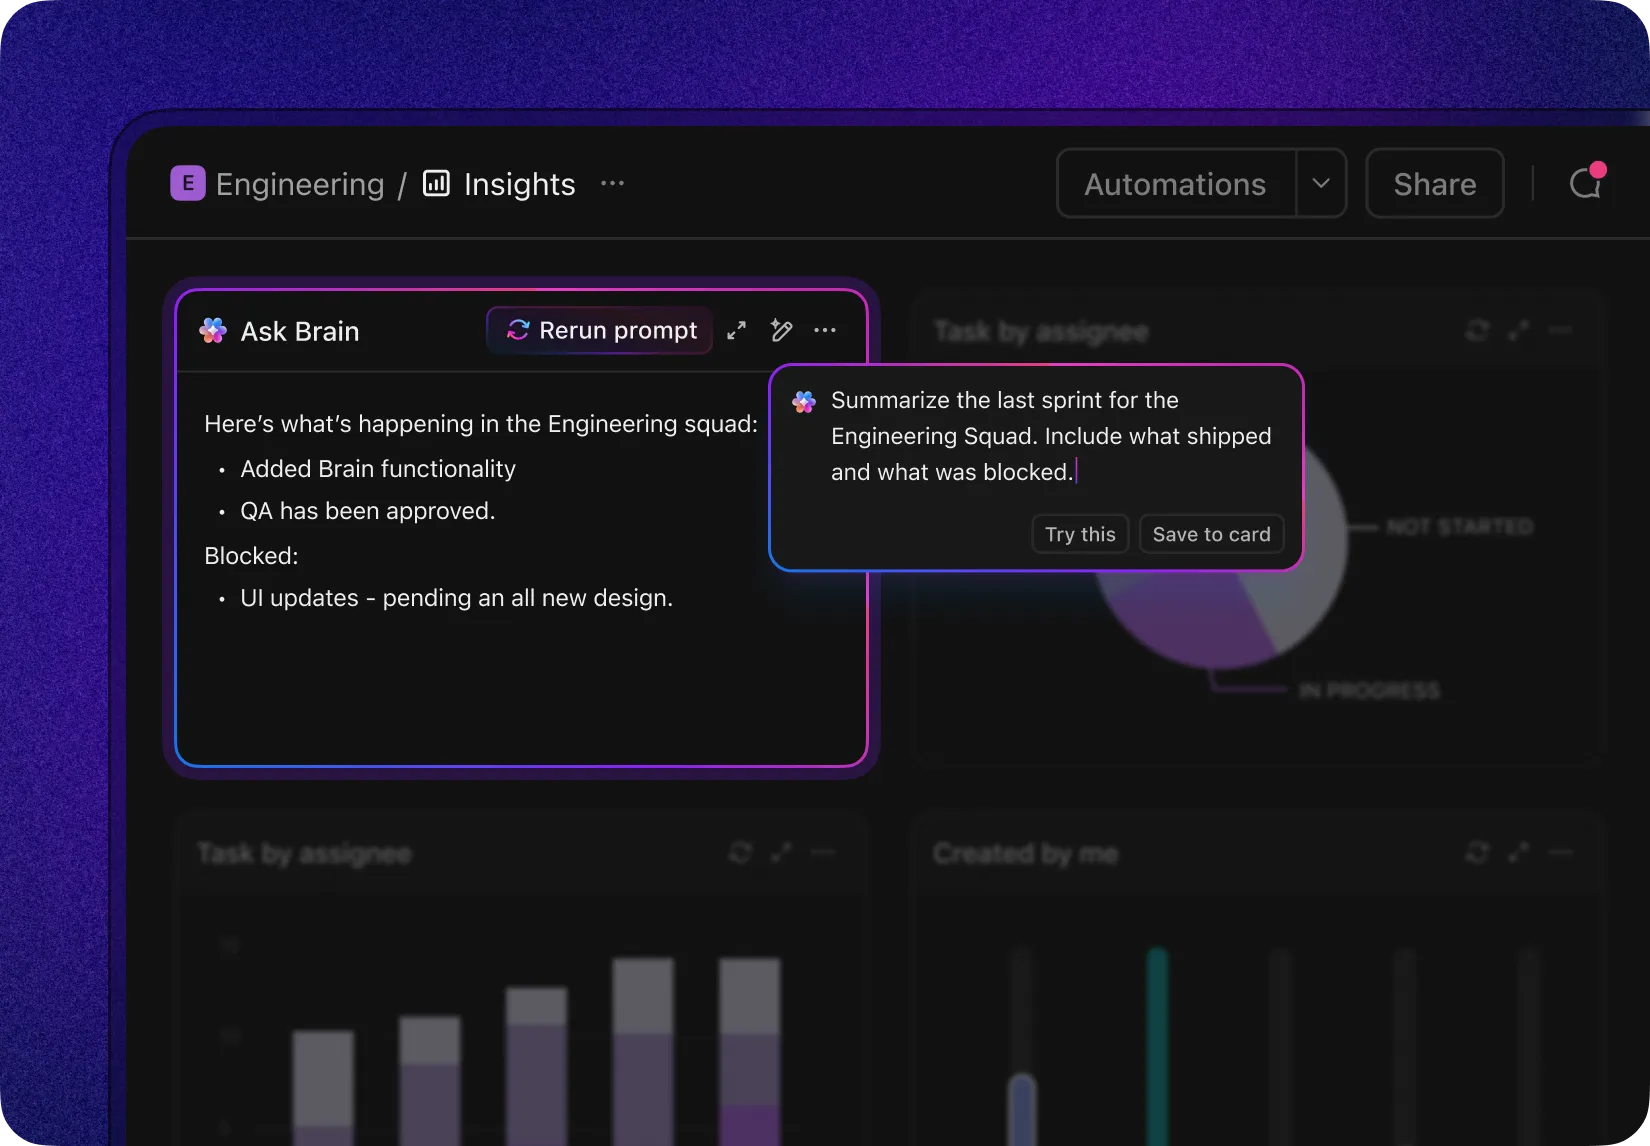
A munkaterületébe beépített intelligens mesterséges intelligencia-asszisztens változtathat ezen. Ismerje meg a ClickUp Brain-t! Az alkalmazás másodpercek alatt megjeleníti a megfelelő dokumentumokat, beszélgetéseket és feladatrészleteket, így azonnali betekintést és válaszokat nyújt – így nem kell tovább keresnie, hanem rögtön munkához láthat.
💫 Valódi eredmények: Az olyan csapatok, mint a QubicaAMF, a ClickUp segítségével hetente több mint 5 órát spóroltak meg – ez évente fejenként több mint 250 óra –, az elavult tudáskezelési folyamatok kiküszöbölésével. Képzelje el, mit tudna létrehozni a csapata egy-egy extra termelékeny héttel minden negyedévben!
A hibaelhárítási idő meghosszabbodását jelző vezető mutatók
❗️Növekvő „nyugtázási idő” és számos, 12 óránál hosszabb ideje tulajdonos nélküli jegy
❗️A „Time in Review/CI” időtartamok növekedése és a tesztek gyakori megbízhatatlansága
❗️Magas az ismétlődő bejelentések aránya a beérkező bejelentések között, és a súlyossági besorolások nem egységesek a különböző csapatok között
❗️Számos hiba a „Blokkolt” állapotban van, anélkül, hogy megnevezett külső függőség lenne hozzájuk rendelve
❗️A hibajelentések újbóli megnyitásának aránya fokozatosan emelkedik (a javítások nem reprodukálhatók, vagy a „befejezett” fogalma nem egyértelmű)
Ezeket a tényezőket a különböző szervezetek eltérő módon érzékelik. A vezetők ezeket elmulasztott tanulási ciklusokként és a bevételi lehetőségek elszalasztásaként élik meg; az operátorok pedig a triázs okozta zavaró tényezőként és a felelősségi körök tisztázatlanságaként érzékelik őket.
A beérkező ügyek, a folyamatok és a függőségek finomhangolásával csökkentheti az egész görbét – a mediánt és a P90-et egyaránt.
Szeretne többet megtudni a jobb hibajelentések írásáról? Kezdje itt! 👇🏼
📖 További információk: A szoftvertesztelés életciklusa (STLC): áttekintés és fázisok
Iparági referenciaértékek a hibajavítási időre vonatkozóan
A hibajavítási referenciaértékek a kockázati toleranciától, a kiadási modelltől és attól függően változnak, hogy milyen gyorsan tudja a változtatásokat kiadni.
Itt használhatja a mediánokat (P50) a tipikus folyamat megértéséhez, valamint a P90-et az ígéretek és az SLA-k meghatározásához – súlyosság és forrás (ügyfél, minőségbiztosítás, felügyelet) szerint.
Nézzük meg, mit is jelent ez pontosan:
| 🔑 Fogalom | 📝 Leírás | 💡 Miért fontos ez? |
|---|---|---|
| P50 (medián) | A középérték – a hibajavítások 50%-a ennél gyorsabb, 50%-a pedig lassabb | 👉 A tipikus vagy leggyakoribb hibaelhárítási időt tükrözi. Hasznos a normál teljesítmény megértéséhez |
| P90 (90. percentilis) | A hibák 90%-át ezen időn belül kijavítják. Csak 10%-uknál tart tovább | 👉 A legrosszabb esetet (de még mindig reális) határértéket jelenti. Hasznos külső ígéretek meghatározásához |
| SLA-k (szolgáltatási szintű megállapodások) | A problémák megoldásának gyorsaságára vonatkozó vállalásai – akár belsőleg, akár az ügyfelek felé – | 👉 Példa: „A P1-es hibákat 90%-ban 48 órán belül kijavítjuk.” Ez elősegíti a bizalom és a felelősségvállalás kialakítását. |
| Súlyosság és forrás szerint | A mutatók két fő dimenzió szerint történő szegmentálása: • Súlyosság (pl. P0, P1, P2) • Forrás (pl. ügyfél, minőségbiztosítás, felügyelet) | 👉 Lehetővé teszi a pontosabb nyomon követést és prioritásba sorolást, így a kritikus hibák gyorsabban kapnak figyelmet |
Az alábbiakban olyan iparágakon alapuló irányadó tartományokat talál, amelyeket az érett csapatok gyakran céloznak meg; tekintse ezeket kiindulási értékeknek, majd igazítsa azokat a saját környezetéhez.
SaaS
A rendszer folyamatosan üzemel és CI/CD-kompatibilis, ezért a gyorsjavítások gyakoriak. A kritikus hibák (P0/P1) esetében a cél általában egy munkanap alatti medián, a P90 pedig 24–48 órán belül. A nem kritikus hibák (P2+) mediánja általában 3–7 nap, a P90 pedig 10–14 napon belül. Azok a csapatok, amelyek robusztus funkciójelzőkkel és automatizált tesztekkel rendelkeznek, általában a gyorsabb vég felé tendálnak.
E-kereskedelmi platformok
Mivel a konverziós és kosárfolyamatok kritikus jelentőségűek a bevételek szempontjából, az elvárások magasabbak. A P0/P1-es hibákat általában órák alatt enyhítik (visszavonás, jelölés vagy konfigurálás), és még aznap teljesen megoldják; a P90-es hibák esetében a nap végére vagy 12 órán belül történő megoldás a csúcsidőszakokban általános gyakorlat. A P2+-os hibák gyakran 2–5 nap alatt oldódnak meg, a P90-es hibák esetében pedig 10 napon belül.
Vállalati szoftver
A szigorúbb validálás és az ügyfelek változási ablakai lassítják a fejlesztési ütemet. A P0/P1 esetében a csapatok célja, hogy 4–24 órán belül ideiglenes megoldást, 1–3 munkanapon belül pedig végleges javítást biztosítsanak; a P90 esetében 5 munkanapon belül. A P2+ kategóriájú elemeket gyakran csoportosítják kiadási sorozatokba, amelyek mediánja 2–4 hét, az ügyfelek bevezetési ütemtervétől függően.
Játékok és mobilalkalmazások
Az élő szolgáltatások háttérrendszerei SaaS-szerűen működnek (flagek és visszavonások percek vagy órák alatt; P90 még aznap). Az ügyféloldali frissítéseket az áruházbeli felülvizsgálatok korlátozzák: a P0/P1 esetében gyakran azonnal alkalmazzák a szerveroldali eszközöket, és 1–3 napon belül kiadnak egy ügyféloldali javítást; a P90 esetében gyorsított felülvizsgálat mellett egy héten belül. A P2+ javításokat általában a következő sprintbe vagy tartalomfrissítésbe ütemezik be.
Banki szektor/Fintech
A kockázati és megfelelőségi ellenőrzési pontok a „gyors kockázatcsökkentés, óvatos változtatás” mintát követik. A P0/P1 hibákat gyorsan enyhítik (jelzések, visszavonások, forgalomátirányítás percek vagy órák alatt), és 1–3 napon belül teljesen kijavítják; a P90 hibákat egy héten belül, figyelembe véve a változáskezelést. A P2+ hibák esetében gyakran 2–6 hétig tart, amíg átmennek a biztonsági, audit- és CAB-felülvizsgálatokon.
Ha az Ön adatai ezen tartományokon kívül esnek, vizsgálja meg a beérkező ügyek minőségét, az ügyek továbbítását és felelősségi körét, a kódfelülvizsgálat és a minőségbiztosítás teljesítményét, valamint a függőségek jóváhagyását, mielőtt azt feltételezné, hogy a „fejlesztési sebesség” a legfőbb probléma.
🌼 Tudta-e: A Stack Overflow 2024-es felmérése szerint a fejlesztők egyre gyakrabban használták a mesterséges intelligenciát megbízható társukként a kódolás során. A válaszadók 82%-a használta az AI-t a kódíráshoz is – ez aztán a kreatív együttműködő partner! Ha elakadtak vagy megoldásokat kerestek, 67,5% támaszkodott az AI-ra a válaszok kereséséhez, és több mint a fele (56,7%) hivatkozott rá a hibakereséshez és segítségkéréshez.
Egyesek számára a mesterséges intelligencia eszközök a projektek dokumentálásában (40,1%), sőt szintetikus adatok vagy tartalmak előállításában is (34,8%) bizonyultak hasznosnak. Kíváncsi egy új kódbázisra? Közel egyharmaduk (30,9%) használja a mesterséges intelligenciát, hogy gyorsan felzárkózzon. A kód tesztelése sokak számára még mindig kézi munkát jelent, de 27,2% itt is bevezette a mesterséges intelligenciát. Más területeken, mint például a kódfelülvizsgálat, a projekttervezés és a prediktív elemzés, alacsonyabb a mesterséges intelligencia elterjedtsége, de egyértelmű, hogy a mesterséges intelligencia folyamatosan beépül a szoftverfejlesztés minden szakaszába.
📖 További információk: Hogyan használható a mesterséges intelligencia a minőségbiztosításban?
Hogyan csökkenthető a hibajavítási idő?
A hibajavítás gyorsasága attól függ, hogy a bejelentéstől a kiadásig minden átadási ponton kiküszöböljük-e az akadályokat.
A legnagyobb előnyök abból származnak, ha az első 30 percet hatékonyabban szervezzük meg (tiszta beérkezés, megfelelő felelős, megfelelő prioritás), majd lerövidítjük az azt követő ciklusokat (reprodukálás, felülvizsgálat, ellenőrzés).
Íme kilenc stratégia, amelyek rendszerként működnek együtt. A mesterséges intelligencia felgyorsítja az egyes lépéseket, a munkafolyamat pedig áttekinthetően egy helyen zajlik, így a vezetők előre láthatóságot, a gyakorlati szakemberek pedig zökkenőmentes munkavégzést kapnak.
1. Központosítsa a beérkező ügyek felvételét, és rögzítse a kontextust a forrásnál
A hibajavítási idő meghosszabbodik, ha a kontextust Slack-beszélgetésekből, támogatási jegyekből és táblázatokból kell rekonstruálnia. Összegyűjtse minden bejelentést – támogatási, minőségbiztosítási, felügyeleti – egyetlen sorba egy strukturált sablon segítségével, amely rögzíti a komponenst, a súlyosságot, a környezetet, az alkalmazás verzióját/építését, a hiba reprodukálásához szükséges lépéseket, a várt és a tényleges eredményeket, valamint a mellékleteket (naplók/HAR/képernyőképek).
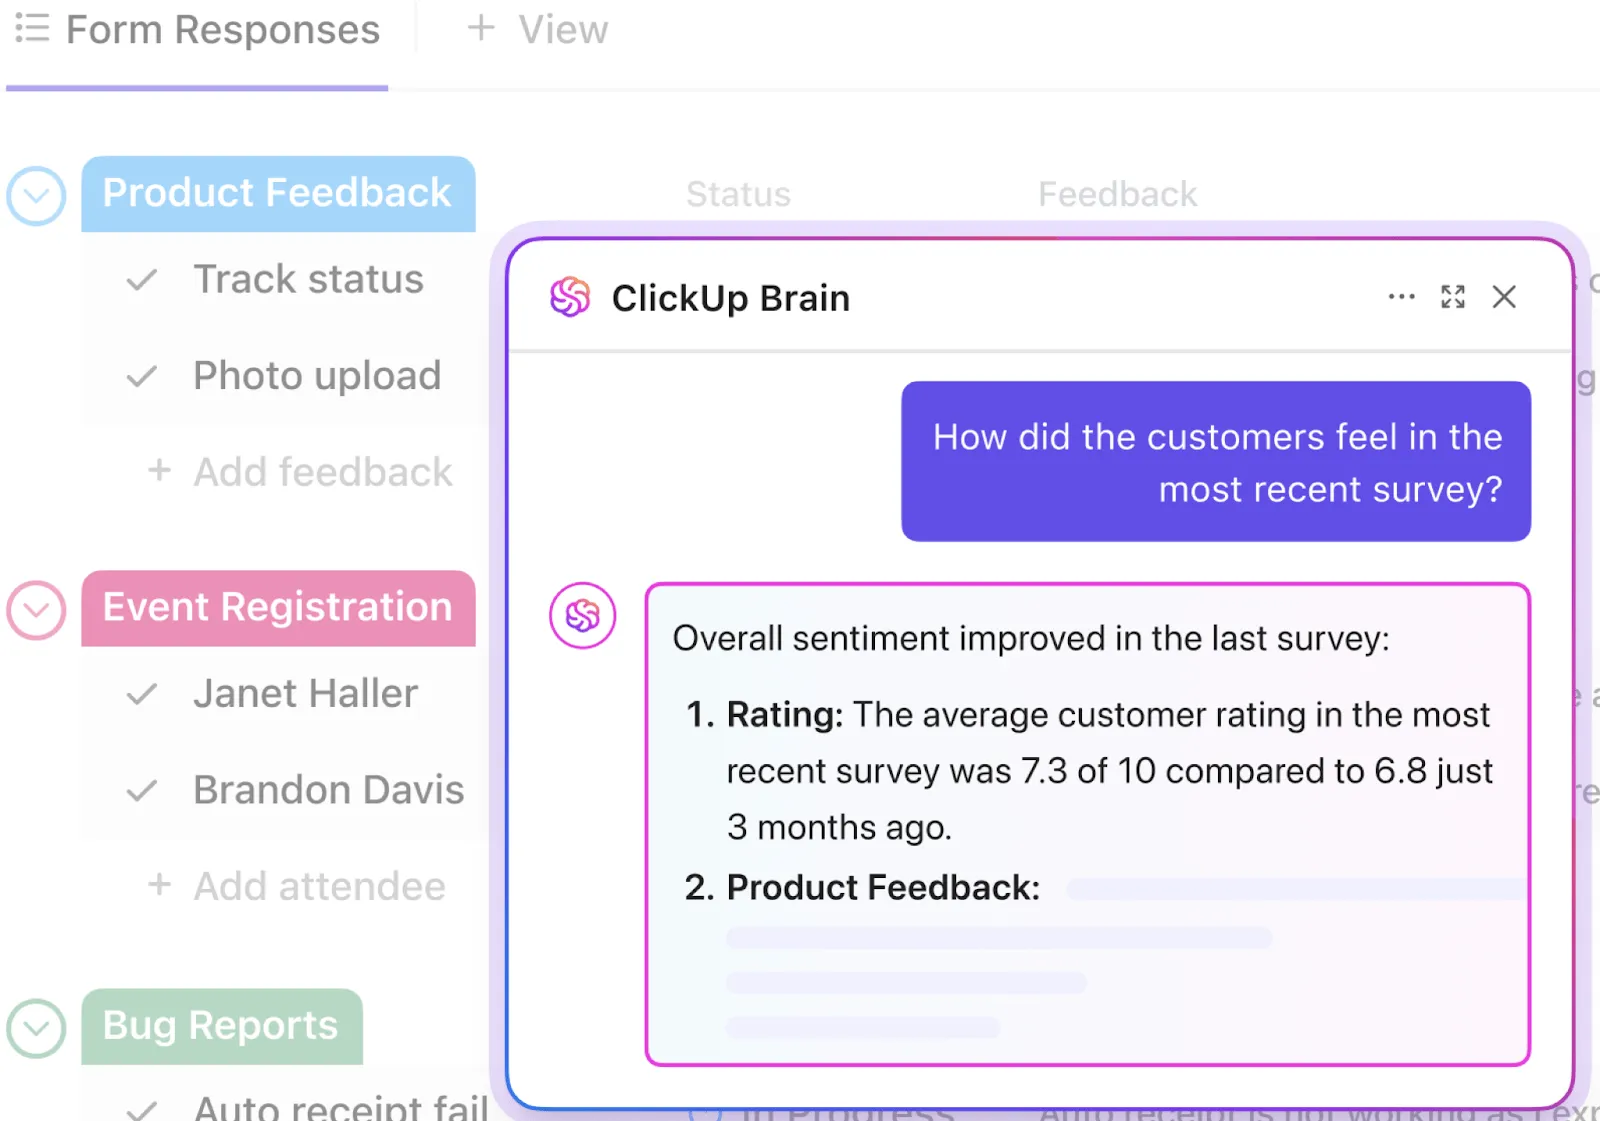
A mesterséges intelligencia automatikusan összefoglalhatja a hosszú jelentéseket, kivonhatja a reprodukciós lépéseket és a környezeti részleteket a mellékletekből, valamint jelölheti a valószínűsíthető duplikátumokat, így a triázs egy koherens, kiegészített nyilvántartás alapján kezdődhet.
Figyelemre méltó mutatók: MTTA (percek alatt történő visszaigazolás, nem órák alatt), az ismétlődő esetek aránya, a „További információ szükséges” állapot időtartama.
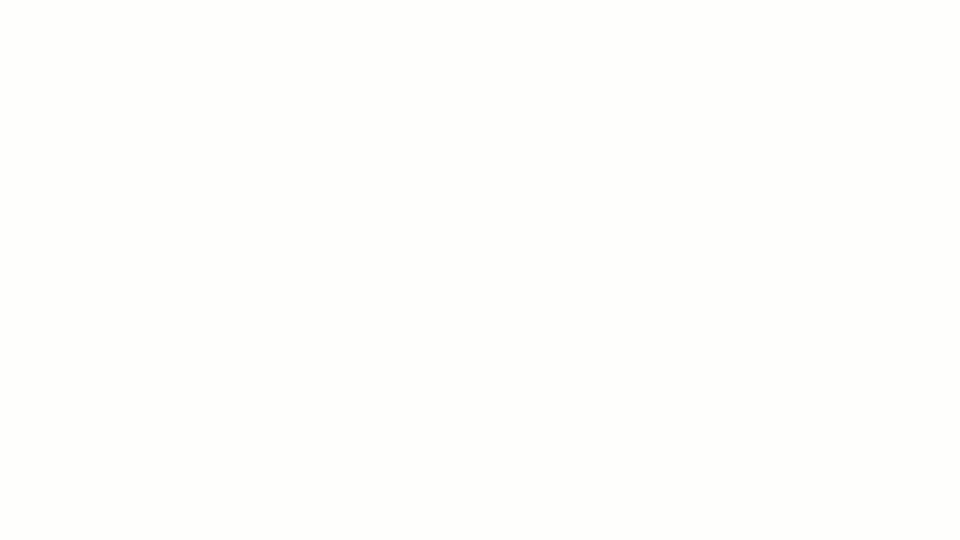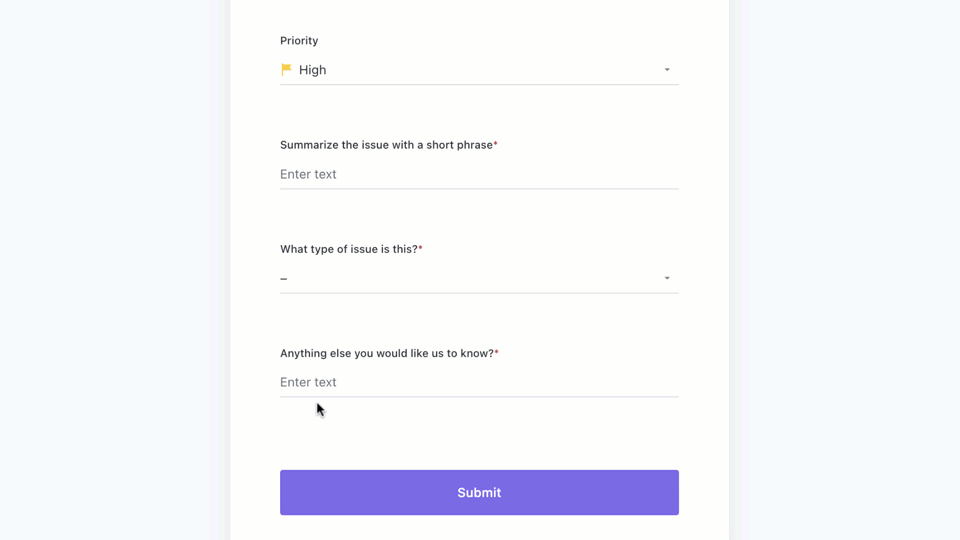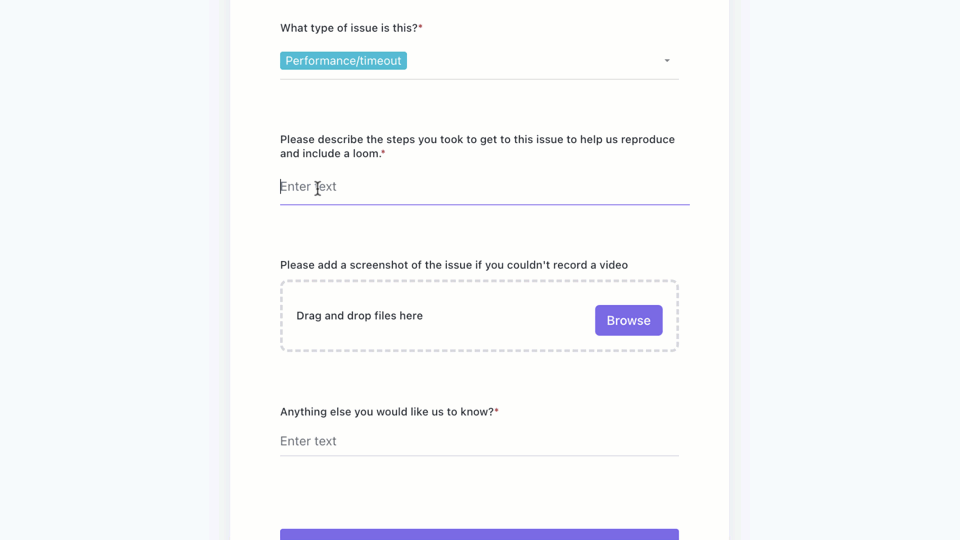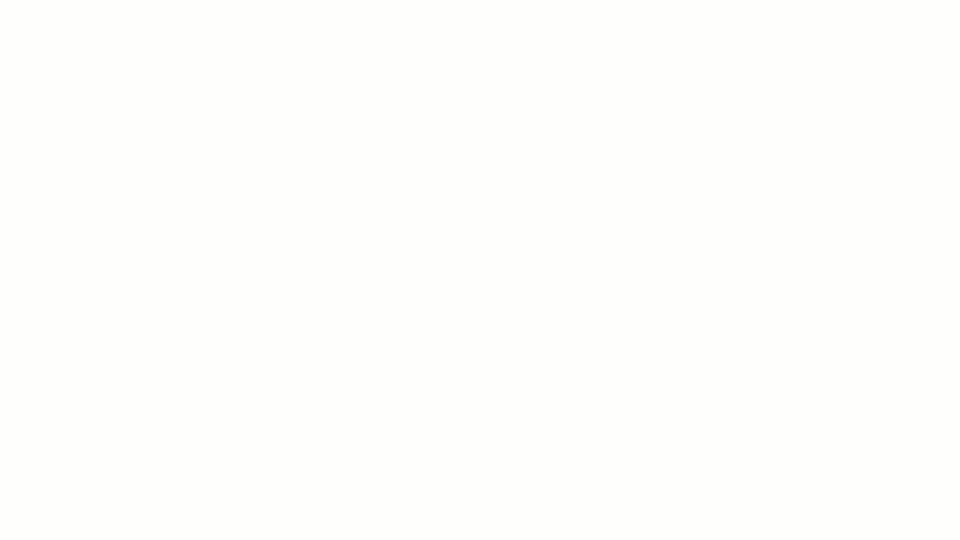
📖 További információ: A ClickUp űrlapok ereje: a szoftverfejlesztő csapatok munkájának racionalizálása
2. AI-támogatott triázs és irányítás az MTTA drasztikus csökkentése érdekében
A leggyorsabb javítások azok, amelyek azonnal a megfelelő asztalra kerülnek.
Használjon egyszerű szabályokat és mesterséges intelligenciát a súlyosság osztályozásához, a valószínűsíthető felelősök azonosításához komponensenként vagy kódterületenként, valamint az SLA-időzítéssel történő automatikus hozzárendeléshez. Határozzon meg egyértelmű sávokat a P0/P1 és az összes többi hiba számára, és tegye egyértelművé, hogy „ki a felelős”.
Az automatizálások a mezők alapján állíthatják be a prioritást, komponensenként irányíthatják a hibákat egy csapat felé, elindíthatják az SLA-időzítőt, és értesíthetik az ügyeletes mérnököt; a mesterséges intelligencia a korábbi minták alapján javaslatot tehet a súlyossági szintre és a felelős személyre vonatkozóan. Amikor a hibák osztályozása 30 perces vita helyett 2–5 perces folyamatgá válik, csökken az MTTA, és az MTTR is követi ezt a tendenciát.
Figyelemre méltó mutatók: MTTA, az első válasz minősége (az első megjegyzésben a megfelelő információt kérik-e?), hibánkénti átadások száma.
Így néz ki ez a gyakorlatban:
3. Priorizáljon az üzleti hatások alapján, egyértelmű SLA-szintekkel
A „ki hangosabban kiabál, az nyer” elv kiszámíthatatlanná teszi a várólistákat, és aláássa a vezetők bizalmát, akik figyelemmel kísérik a CSAT/NPS-mutatókat és a szerződésmegújításokat.
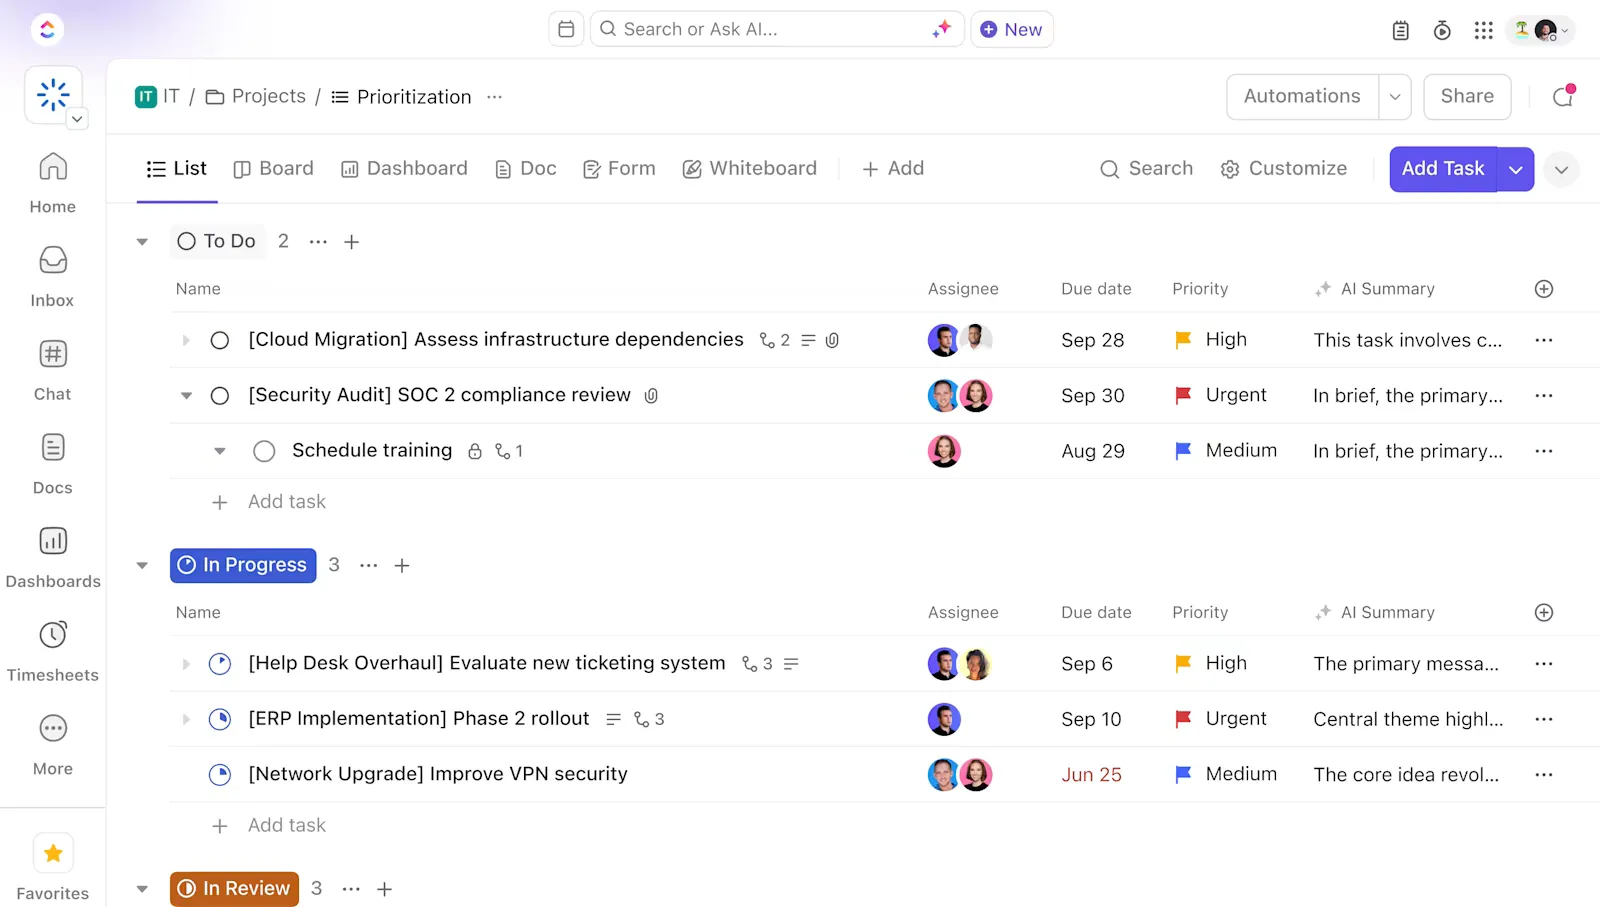
Cserélje le ezt egy olyan pontszámra, amely ötvözi a súlyosságot, a gyakoriságot, az érintett ARR-t, a funkció kritikus fontosságát és a megújításokhoz/bevezetésekhez való közelséget – és támaszkodjon az SLA-szintekre (pl. P0: 1–2 órán belül enyhítés, egy napon belül megoldás; P1: még aznap; P2: egy sprint alatt).
Tartson fenn egy jól látható P0/P1 sávot WIP-korlátokkal, hogy semmi ne maradjon el.
Figyelemre méltó mutatók: P50/P90-es hibaelhárítási arány szintenként, SLA-megszegési arány, összefüggés a CSAT/NPS-szel.
💡Profi tipp: A ClickUp feladatprioritásai, egyéni mezői és függőségi mezői segítségével kiszámíthatja a hatáspontszámot, és összekapcsolhatja a hibákat fiókokkal, visszajelzésekkel vagy ütemtervi elemekkel; ráadásul a ClickUp céljai segítségével összekapcsolhatja az SLA betartását a vállalati szintű célokkal, ami közvetlenül megnyugtatja a vezetőséget az összehangoltság kérdésében.
4. Tegye a hiba reprodukálását és diagnosztizálását egylépéses tevékenységgé
Minden egyes további kör, amikor azt kérdezzük: „Elküldené a naplókat?”, meghosszabbítja a hibaelhárítási időt.
Szabványosítsa a „jó” meghatározását: a build/commit kötelező mezői, a környezet, a reprodukciós lépések, a várt és a tényleges eredmények, valamint a naplókat, összeomlási dumpokat és HAR-fájlokat tartalmazó mellékletek. Vezessen be kliens/szerver telemetriát, hogy az összeomlási azonosítók és a kérelemazonosítók összekapcsolhatók legyenek a nyomkövetésekkel.
Használja a Sentry-t (vagy hasonló eszközt) a stack trace-ekhez, és kapcsolja össze közvetlenül a hibajelentést a hibával. A mesterséges intelligencia elolvassa a naplókat és a trace-eket, hogy javasoljon egy valószínű hibatartományt, és létrehozzon egy minimális reprodukciós példát, így az egy órás szemrevételezés helyett csupán néhány perc célzott munkára lesz szükség.
Tárolja a gyakori hibatípusokra vonatkozó útmutatókat, hogy a mérnököknek ne kelljen a nulláról kezdeniük.
Figyelemre méltó mutatók: az „Információra várás” időtartama, az első próbálkozásnál reprodukálható hibák aránya, valamint a reprodukálhatóság hiánya miatt újra megnyitott ügyek aránya.
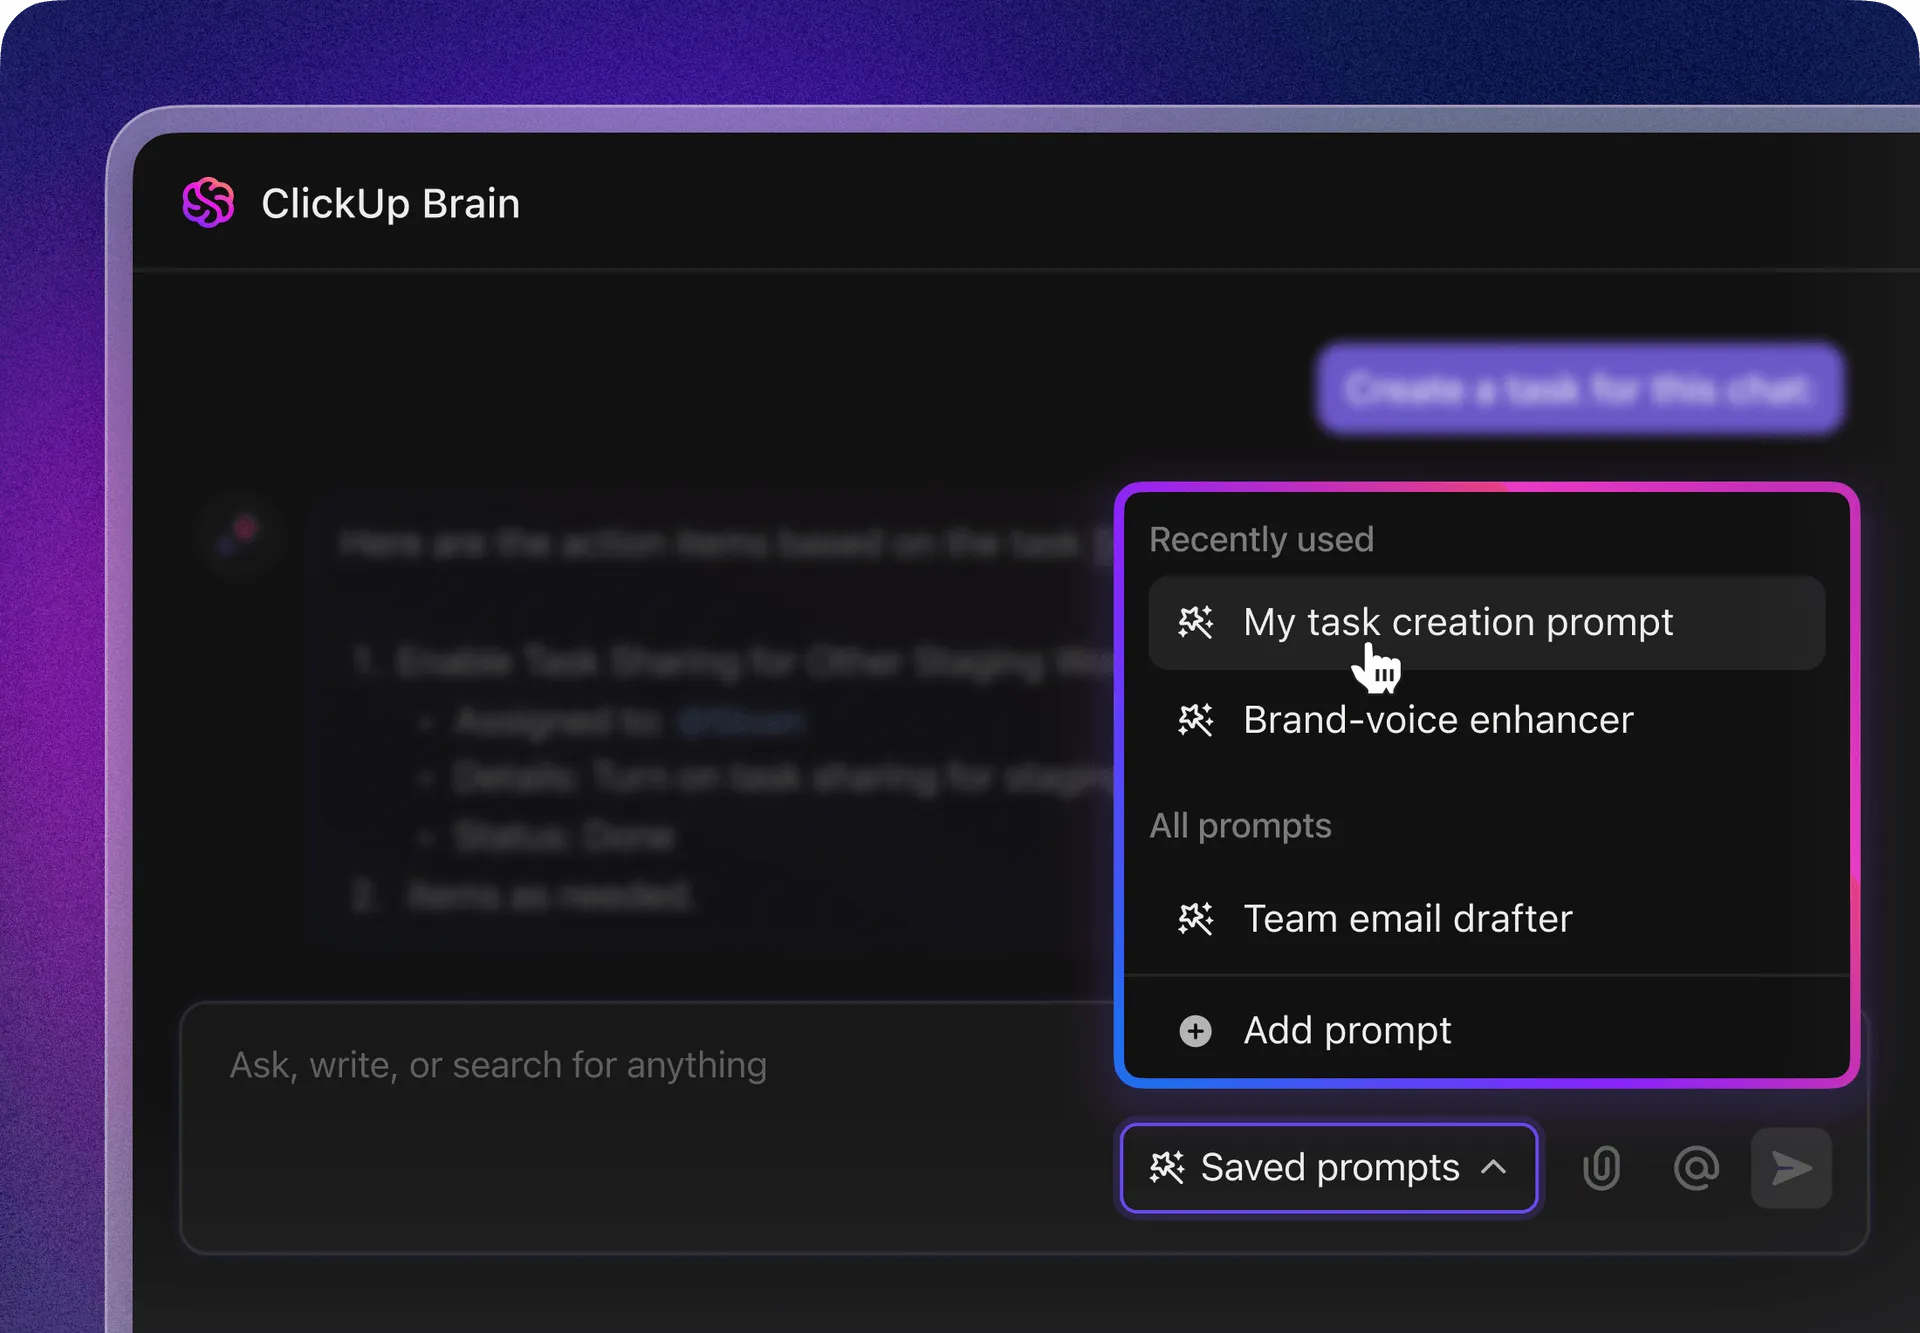
📖 További információk: Hogyan használható a mesterséges intelligencia a szoftverfejlesztésben (alkalmazási példák és eszközök)
5. Rövidítse le a kódfelülvizsgálati és tesztelési ciklust
A nagy PR-ek elakadnak. Törekedj a precíz javításokra, a trunk-alapú fejlesztésre és a funkciójelzőkre, hogy a javítások biztonságosan kerülhessenek kiadásra. A kódtulajdonosok alapján előre rendelj hozzá ellenőröket az állásidő elkerülése érdekében, és használd az ellenőrzőlistákat (frissített tesztek, hozzáadott telemetria, kill switch mögötti jelző), hogy a minőség beépüljön a rendszerbe.
Az automatizálásnak a hibát a PR megnyitásakor „Felülvizsgálat alatt” állapotba, az összevonáskor pedig „Megoldva” állapotba kell helyeznie; a mesterséges intelligencia javasolhat egységteszteket, vagy kiemelheti a kockázatos eltéréseket, hogy a felülvizsgálat ezekre összpontosítson.
Figyelemre méltó mutatók: az „In Review” állapotban töltött idő, a hibajavító PR-ek elutasítási aránya és a P90-es felülvizsgálati késleltetés.
Használhatja a ClickUp GitHub/ GitLab -integrációit a hibaelhárítási állapot szinkronizálásához; az automatizálások segítségével érvényre juttathatja a „kész definícióját”.
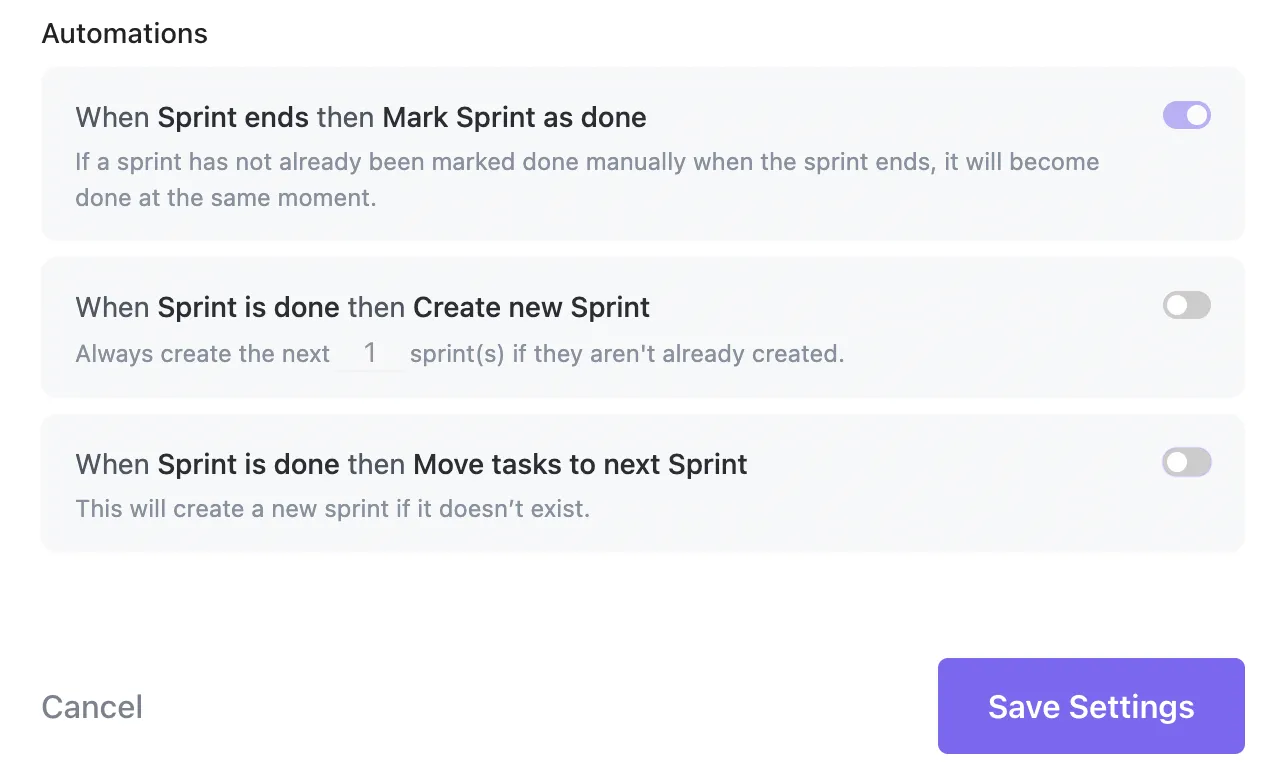
📖 További információk: Hogyan lehet az AI segítségével automatizálni a feladatokat
6. A verifikáció párhuzamosítása és a minőségbiztosítási környezet valódi egyenértékűségének megvalósítása
Az ellenőrzés nem kezdődhet el napokkal később, vagy olyan környezetben, amelyet egyetlen ügyfele sem használ.
Tartsa szigorúan a „QA-ra kész” állapotot: jelölésalapú javítások, amelyeket termeléshez hasonló környezetben validálnak, a bejelentett esetekhez illeszkedő kiindulási adatokkal.
Amennyiben lehetséges, hozzon létre ideiglenes környezeteket a hibajelentési ágból, hogy a minőségbiztosítás azonnal ellenőrizhesse azokat; az AI ezután teszteseteket generálhat a hiba leírása és a korábbi regressziók alapján.
Figyelemre méltó mutatók: A „QA/ellenőrzés” szakaszban eltöltött idő, a QA-ból a fejlesztéshez visszakerülő hibák aránya, valamint a merge után a hiba lezárásáig eltelt idő mediánja.
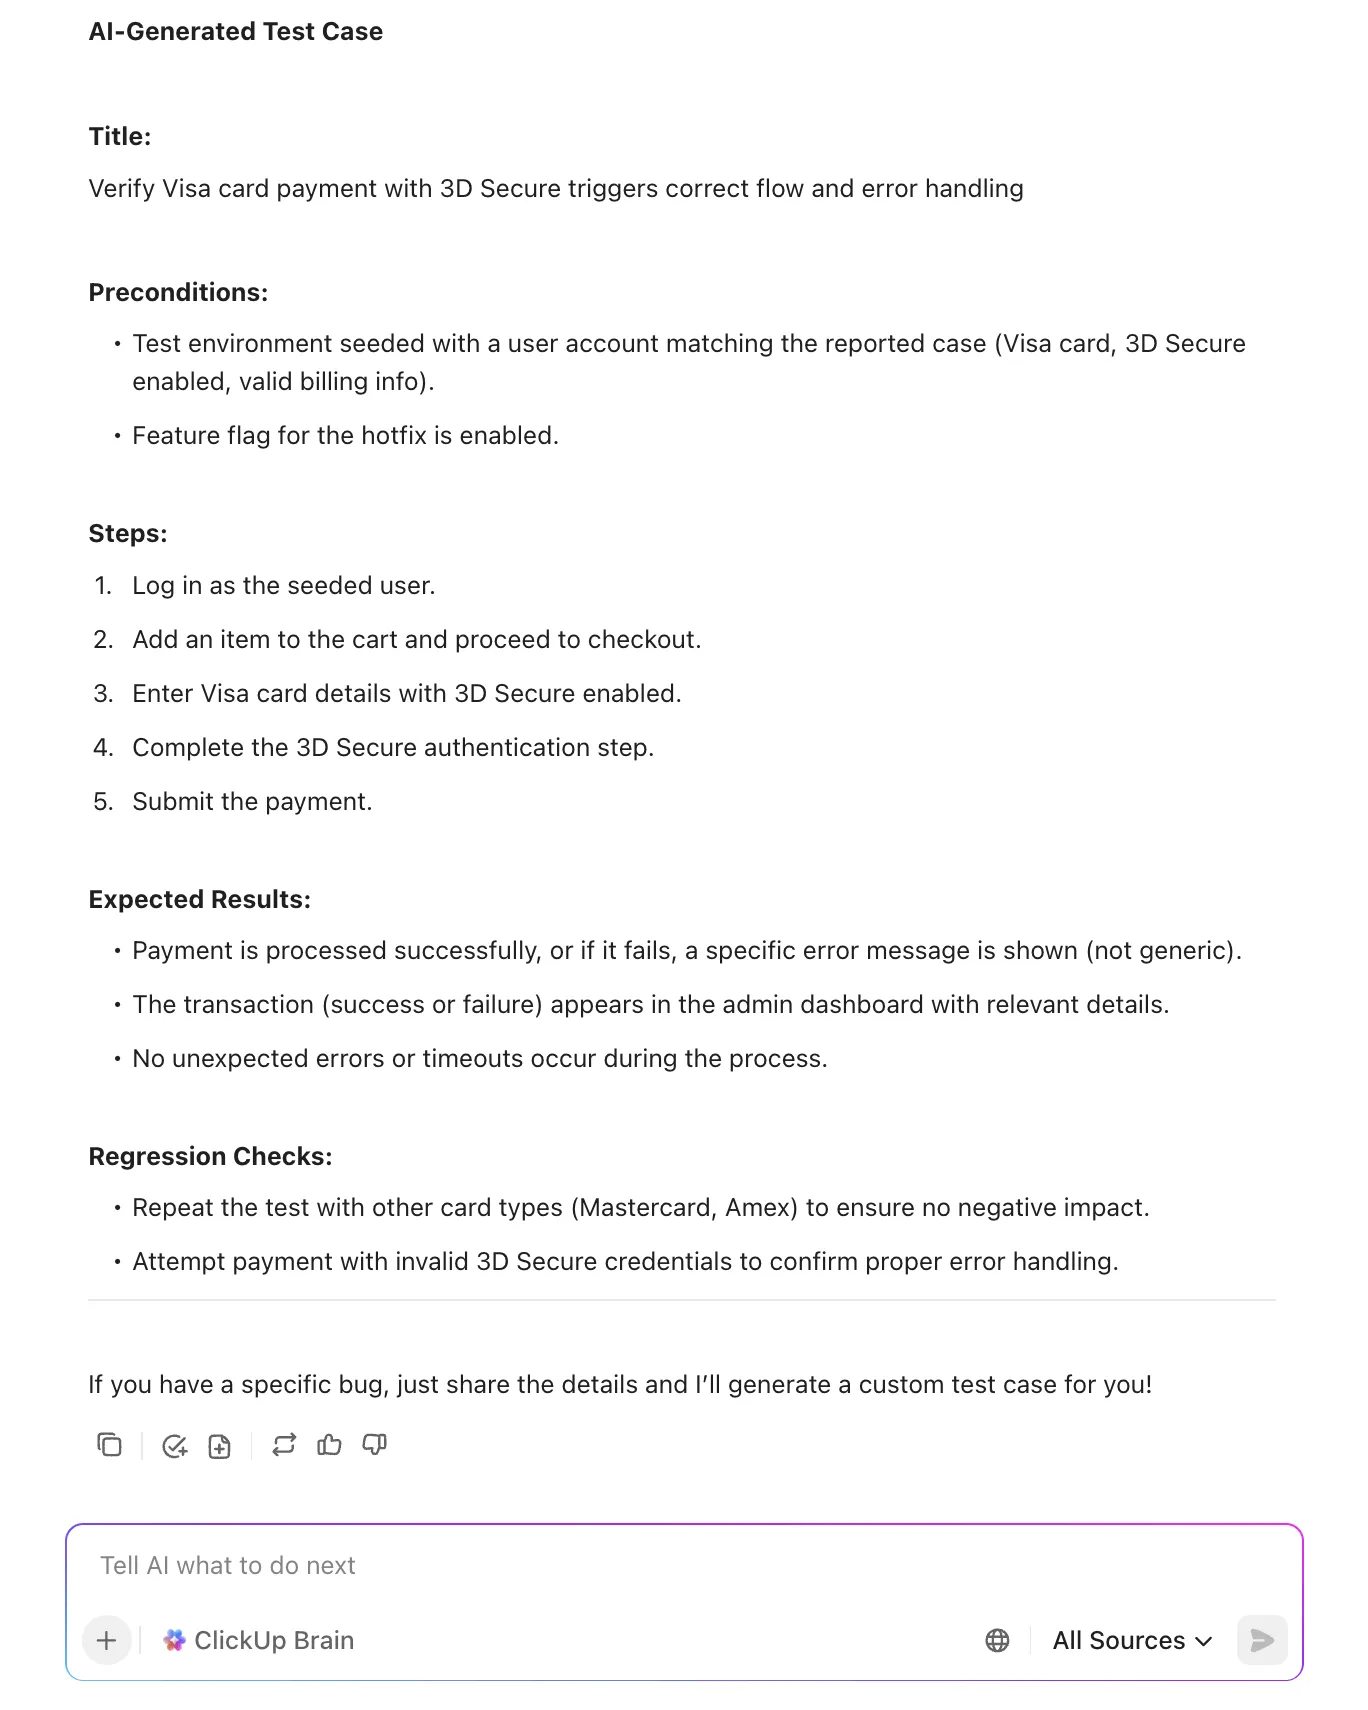
📖 További információ: Hogyan írjunk hatékony teszteseteket?
7. Tájékoztassa világosan a feleket az állapotról, hogy csökkentse a koordinációs terheket
Egy jól végrehajtott frissítés három állapotellenőrzést és egy eskalációt megelőz.
Kezelje a frissítéseket úgy, mint egy terméket: legyenek rövidek, konkrétak és a célközönséget (támogatás, vezetők, ügyfelek) szem előtt tartóak. Határozzon meg egy ritmust a P0/P1 esetekre (pl. óránként, amíg a probléma nem oldódik meg, majd négyóránként), és tartson fenn egyetlen megbízható információforrást.
A mesterséges intelligencia a feladatelőzményekből ügyfélbarát frissítéseket és belső összefoglalókat készíthet, beleértve a súlyossági szint és a munkacsoport szerinti aktuális állapotot is. A termékigazgatóhoz hasonló vezetők számára csoportosítsa a hibákat kezdeményezések szerint, hogy lássák, veszélyezteti-e a kritikus minőségi munka a szállítási ígéreteket.
Figyelemre méltó mutatók: A P0/P1 státuszfrissítések közötti idő, az érintettek kommunikációval kapcsolatos elégedettségi mutatója (CSAT).
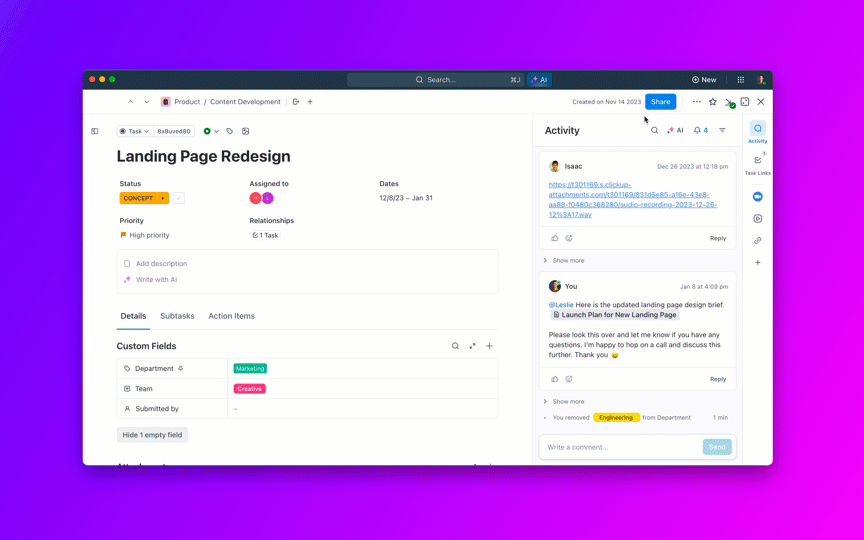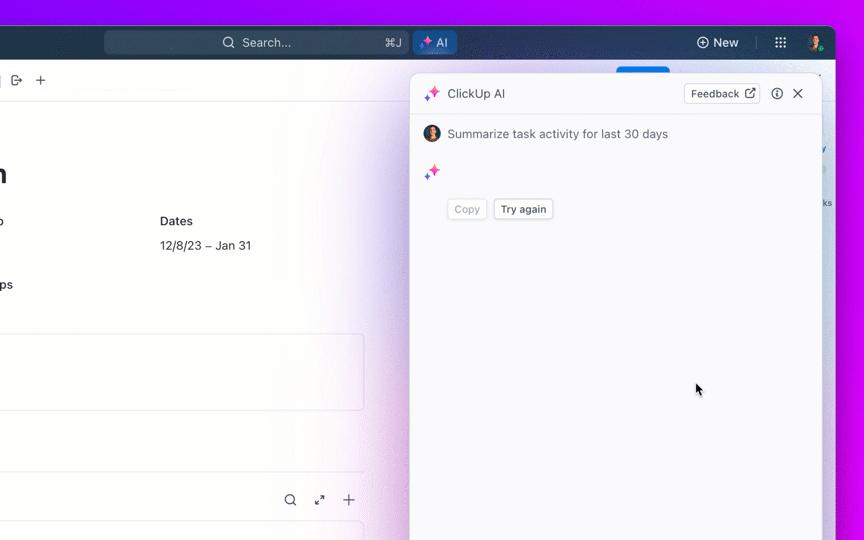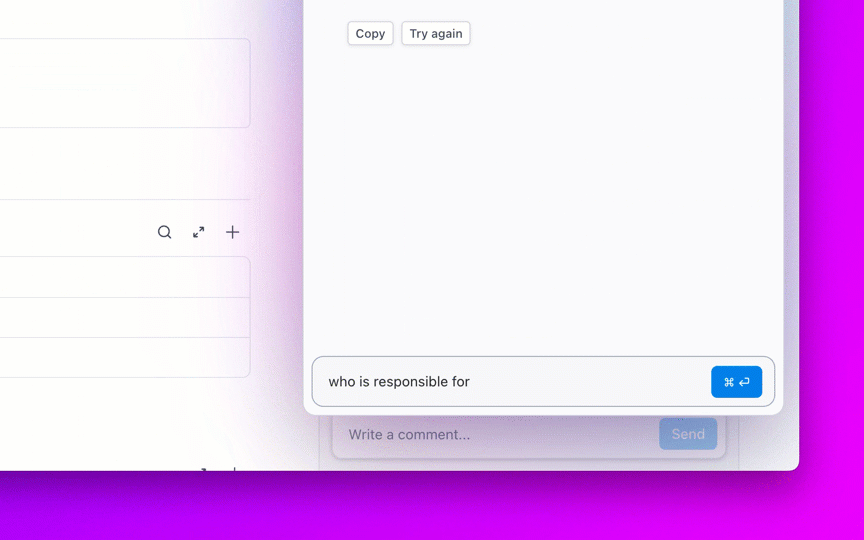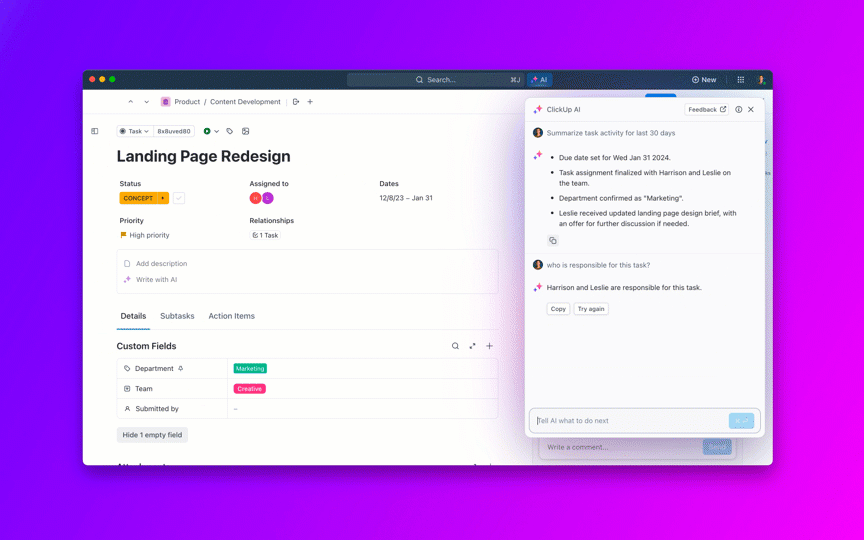
8. A felhalmozódott feladatok elavulásának ellenőrzése és a „véglegesen nyitott” állapotok megelőzése
A növekvő, elavult felhalmozódott feladatállomány minden sprintet csendben megterhel.
Állítson be elavulási szabályokat (pl. P2 > 30 nap esetén felülvizsgálat indul, P3 > 90 nap esetén indoklás szükséges), és tervezzen be heti „elavulási triázst” az ismétlődő bejelentések összevonására, az elavult bejelentések lezárására, valamint az alacsony prioritású hibák termék-backlog-elemekké alakítására.
Használja a mesterséges intelligenciát a felhalmozódott feladatok témák szerinti csoportosításához (pl. „hitelesítési token lejárata”, „képfeltöltési problémák”), így tematikus javítási heteket tervezhet, és egy hibaosztályt egyszerre tud megszüntetni.
Figyelemre méltó mutatók: A hátralévő feladatok száma időtartam-sávonként, a duplikátumként vagy elavultként lezárt problémák aránya, tematikus burn-down sebesség.
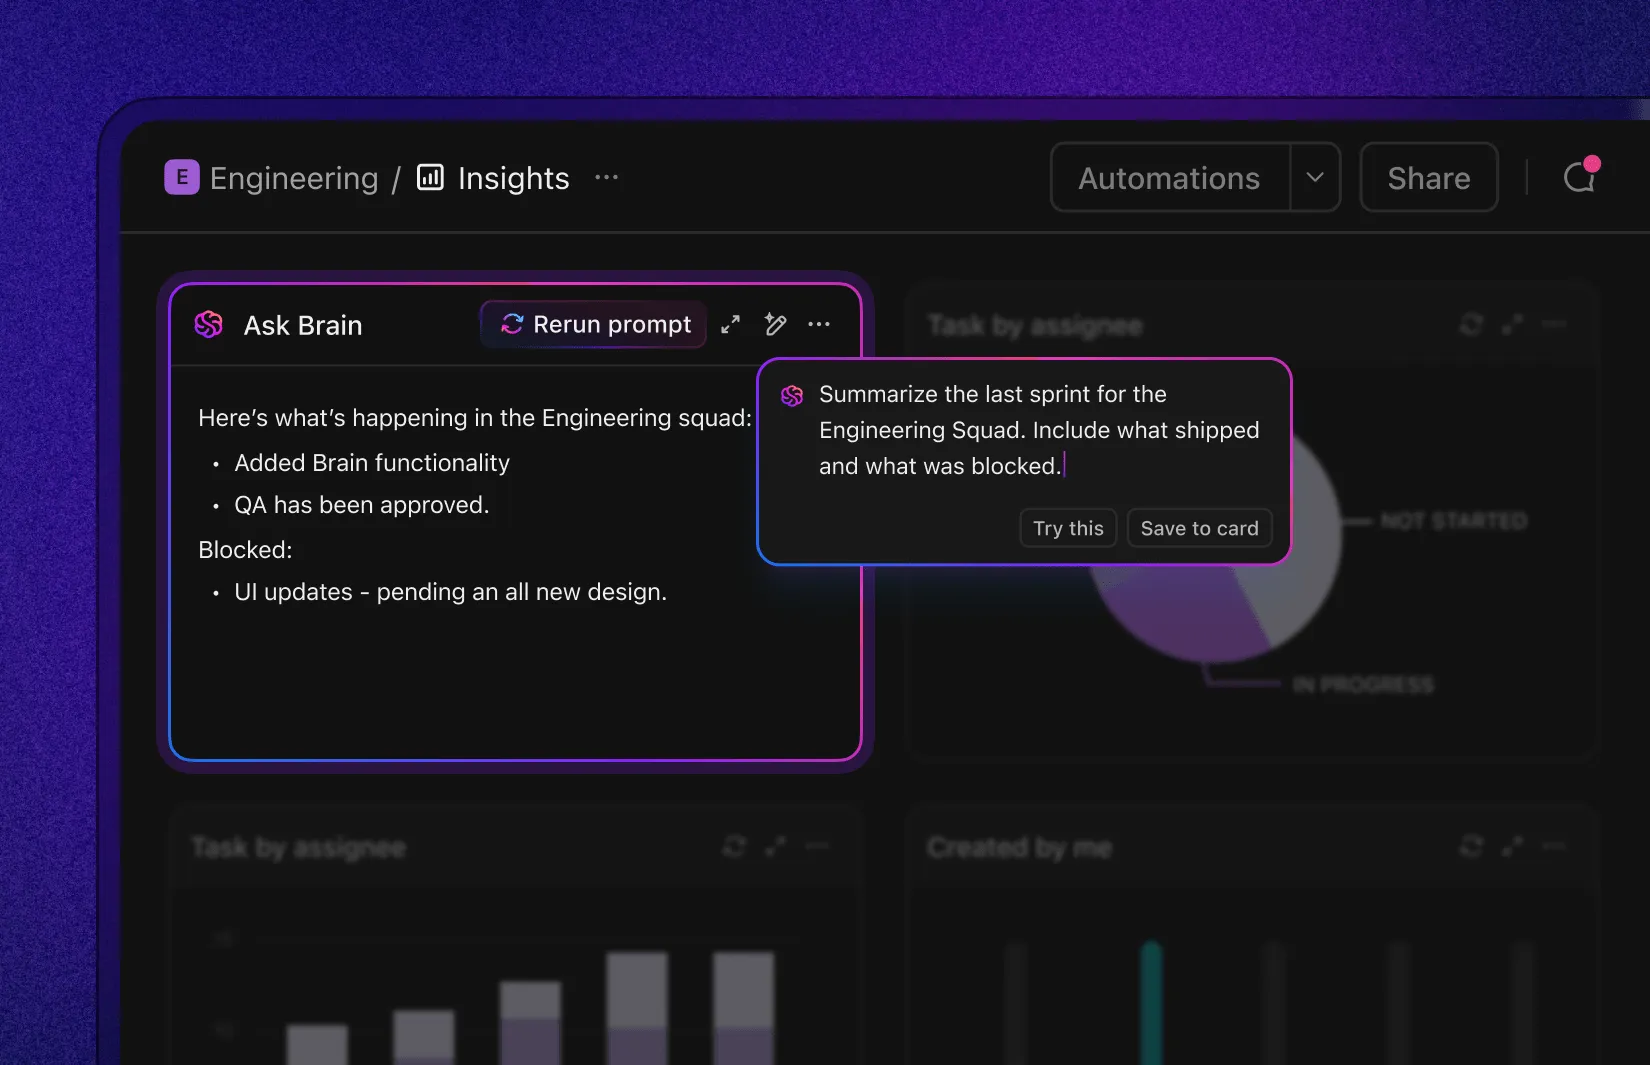
9. Zárja le a kört a kiváltó okok feltárásával és a megelőzéssel
Ha ugyanaz a hibaosztály folyamatosan visszatér, az MTTR-érték javulása egy nagyobb problémát takar.
Végezzen gyors, hibáktól mentes kiváltó ok-elemzést a P0/P1 és a gyakran előforduló P2 hibák esetében; címkézze meg a kiváltó okokat (specifikációs, tesztelési és eszközbeli hiányosságok, integrációs instabilitás), kapcsolja össze az érintett komponensekkel és incidensekkel, majd kövesse nyomon a követő feladatokat (védőmechanizmusok, tesztek, lint-szabályok) a teljesítésig.
A mesterséges intelligencia összeállíthatja az RCA-összefoglalókat, és a változási előzmények alapján javasolhat megelőző teszteket vagy kódszabályokat. Így válthat át a tűzoltásról a tűzesetek számának csökkentésére.
Figyelemre méltó mutatók: az újbóli megnyitás aránya, a regresszió aránya, az ismétlődések közötti idő, valamint a megelőző intézkedésekkel lezárt RCA-k aránya.
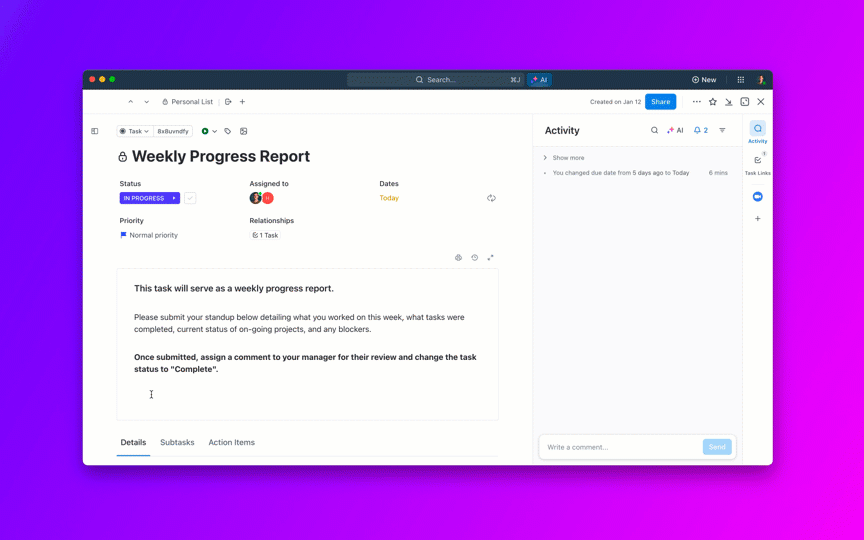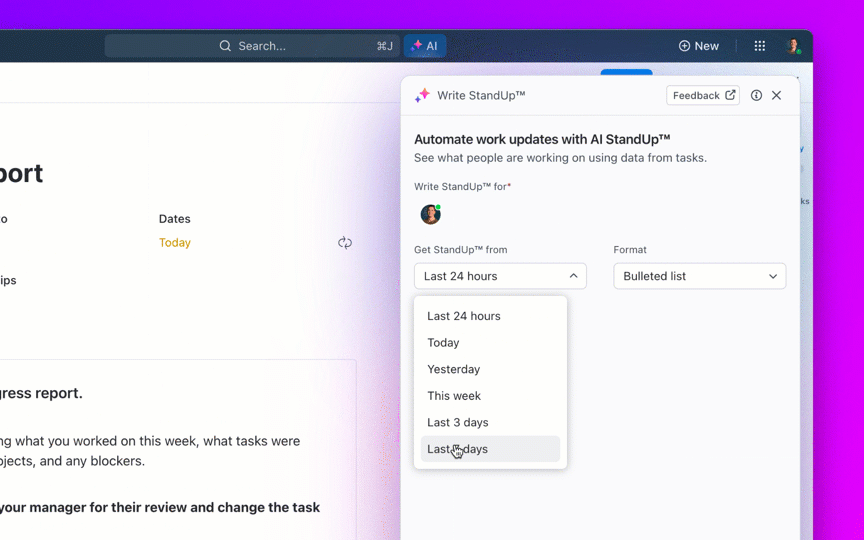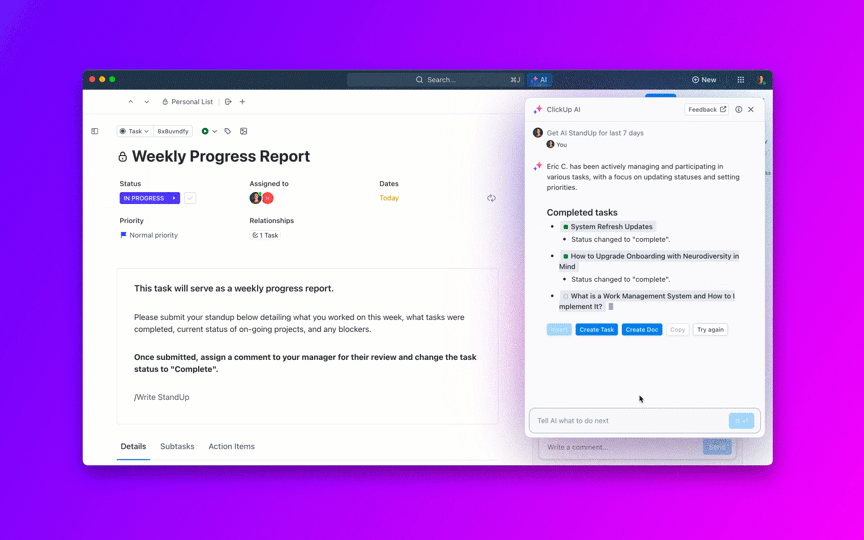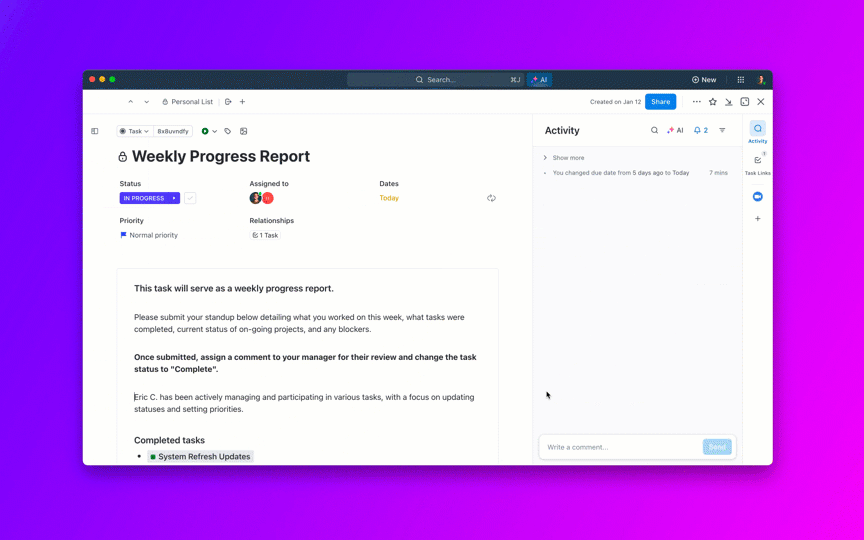
Ezek a változtatások együttesen lerövidítik a teljes folyamatot: gyorsabb visszaigazolás, átláthatóbb osztályozás, okosabb prioritásrend, kevesebb akadozás a felülvizsgálat és a minőségbiztosítás során, valamint egyértelműbb kommunikáció. A vezetők előre jelezhető eredményeket kapnak a CSAT/NPS és a bevételek tekintetében; a szakemberek pedig nyugodtabb munkamenetet élvezhetnek, kevesebb kontextusváltással.
📖 További információ: Hogyan végezzen kiváltó ok elemzést?
A hibajavítási idő csökkentését segítő mesterséges intelligencia-eszközök
A mesterséges intelligencia minden lépésben – a bejelentés fogadásánál, a triázsnál, az irányításnál, a javításnál és az ellenőrzésnél – lerövidítheti a hibajavítási időt.
Az igazi előnyök azonban akkor jelentkeznek, amikor az eszközök megértik a kontextust, és kézfogás nélkül is biztosítják a munka zavartalan folytatását.
Keressen olyan rendszereket, amelyek automatikusan kiegészítik a jelentéseket (a hiba reprodukciójának lépései, környezet, duplikátumok), hatás szerint rangsorolják a hibákat, a megfelelő felelőshez irányítják őket, egyértelmű frissítéseket készítenek, és szorosan integrálódnak a kódjához, a folyamatos integrációhoz (CI) és a megfigyelhetőséghez.
A legjobb megoldások az ügyintézői munkamenetekhez hasonló folyamatokat is támogatnak: olyan botok, amelyek figyelemmel kísérik az SLA-kat, emlékeztetik a felülvizsgálókat, továbbítják a megakadt ügyeket, és összefoglalják az eredményeket az érdekelt felek számára. Íme a jobb hibajavításhoz ajánlott mesterséges intelligencia-eszközök áttekintése:
1. ClickUp (A legjobb kontextusfüggő mesterséges intelligenciához, automatizálásokhoz és ügynökalapú munkafolyamatokhoz)
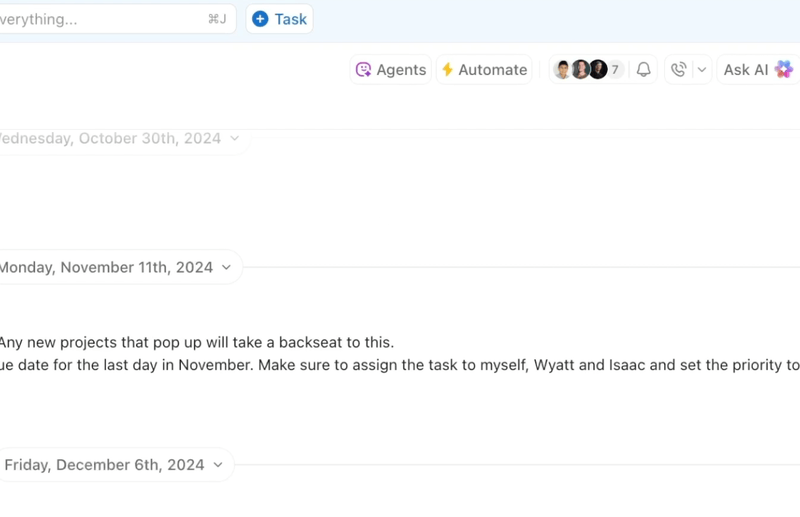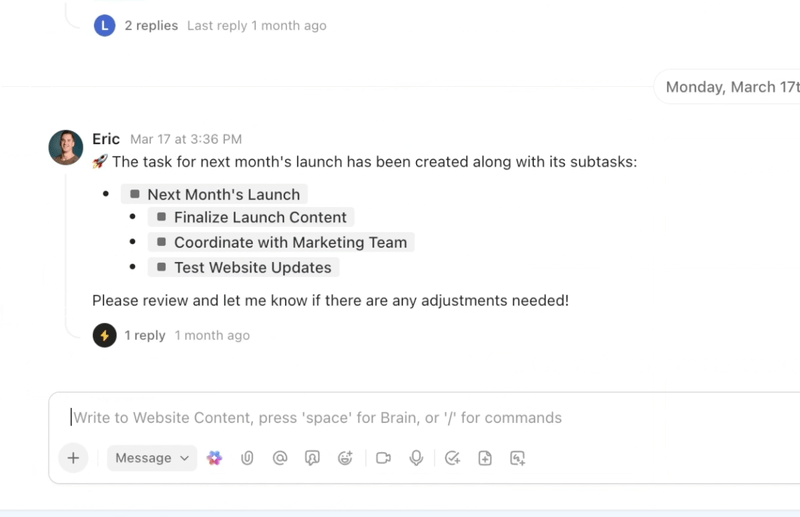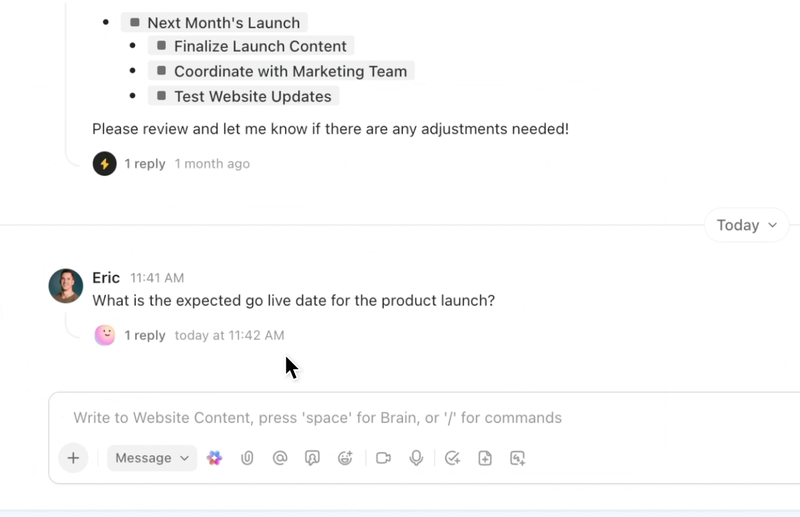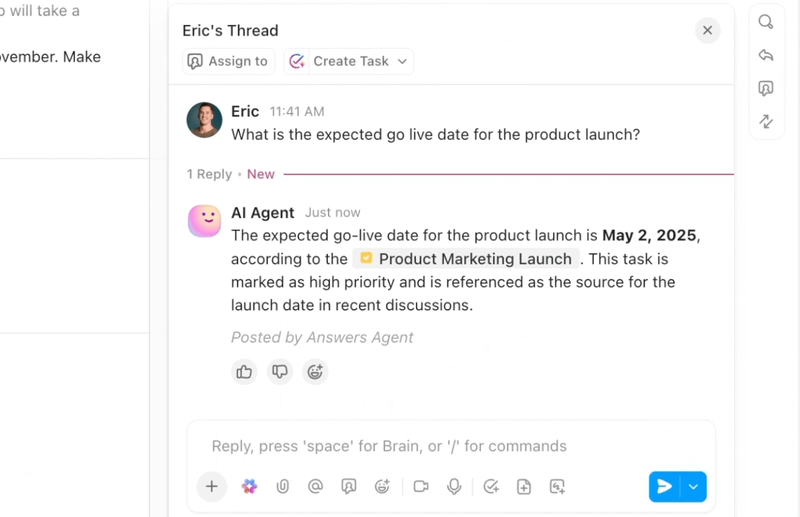
Ha egyszerűsített, intelligens hibajavítási munkafolyamatra vágyik, a ClickUp – a munkához szükséges mindenre kiterjedő alkalmazás – egy helyen egyesíti a mesterséges intelligenciát, az automatizálást és az ügynökszerű munkafolyamat-támogatást.
A ClickUp Brain azonnal megjeleníti a megfelelő kontextust: összefoglalja a hosszú hibajelentési szálakat, kinyeri a reprodukáláshoz szükséges lépéseket és a környezeti részleteket a mellékletekből, jelzi a valószínűsíthető duplikátumokat, és javaslatot tesz a következő teendőkre. Ahelyett, hogy a Slackben, a jegyekben és a naplófájlokban kellene turkálniuk, a csapatok tiszta, kiegészített adatokat kapnak, amelyek alapján azonnal cselekedhetnek.
A ClickUp automatizálási funkciói és Autopilot-ügynökei gondoskodnak arról, hogy a munka folyamatosan haladjon, anélkül, hogy állandóan kézben kellene tartani. A hibajelentéseket automatikusan a megfelelő csapathoz irányítják, kijelölik a felelősöket, meghatározzák az SLA-ket és a határidőket, az állapotok a munka előrehaladtával frissülnek, és az érintettek időben értesítést kapnak.
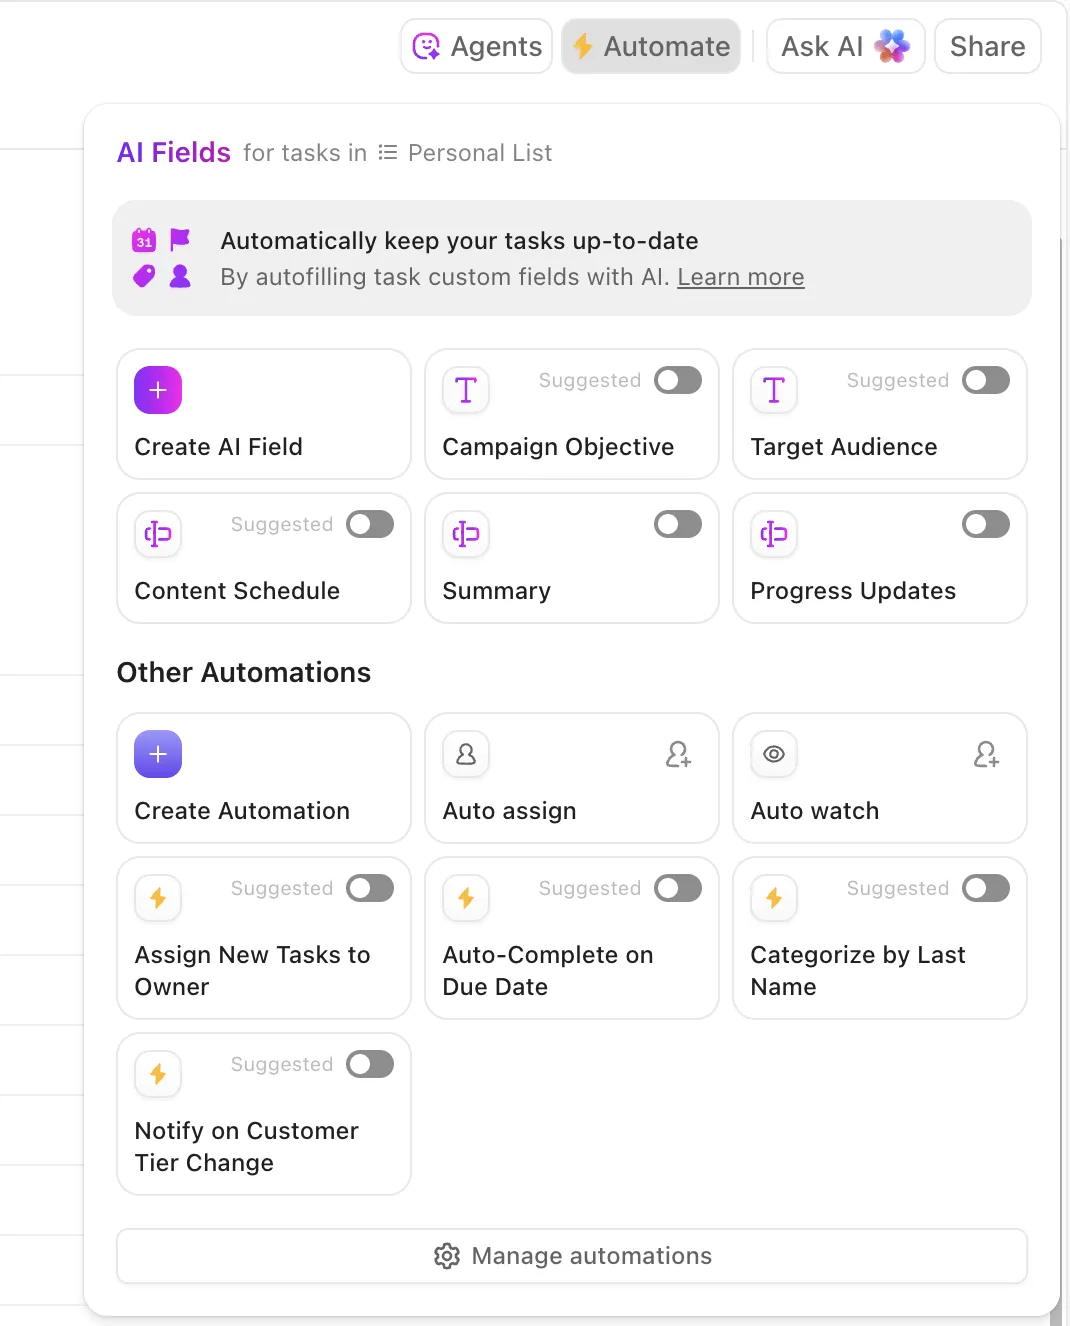
Ezek az ügynökök akár osztályozni és kategorizálni is tudják a problémákat, csoportosítani a hasonló bejelentéseket, hivatkozni a korábbi javításokra a lehetséges megoldási útvonalak javaslása érdekében, valamint eskalálni a sürgős ügyeket – így az MTTA és az MTTR értékei akkor is csökkennek, ha a bejelentések száma hirtelen megugrik.
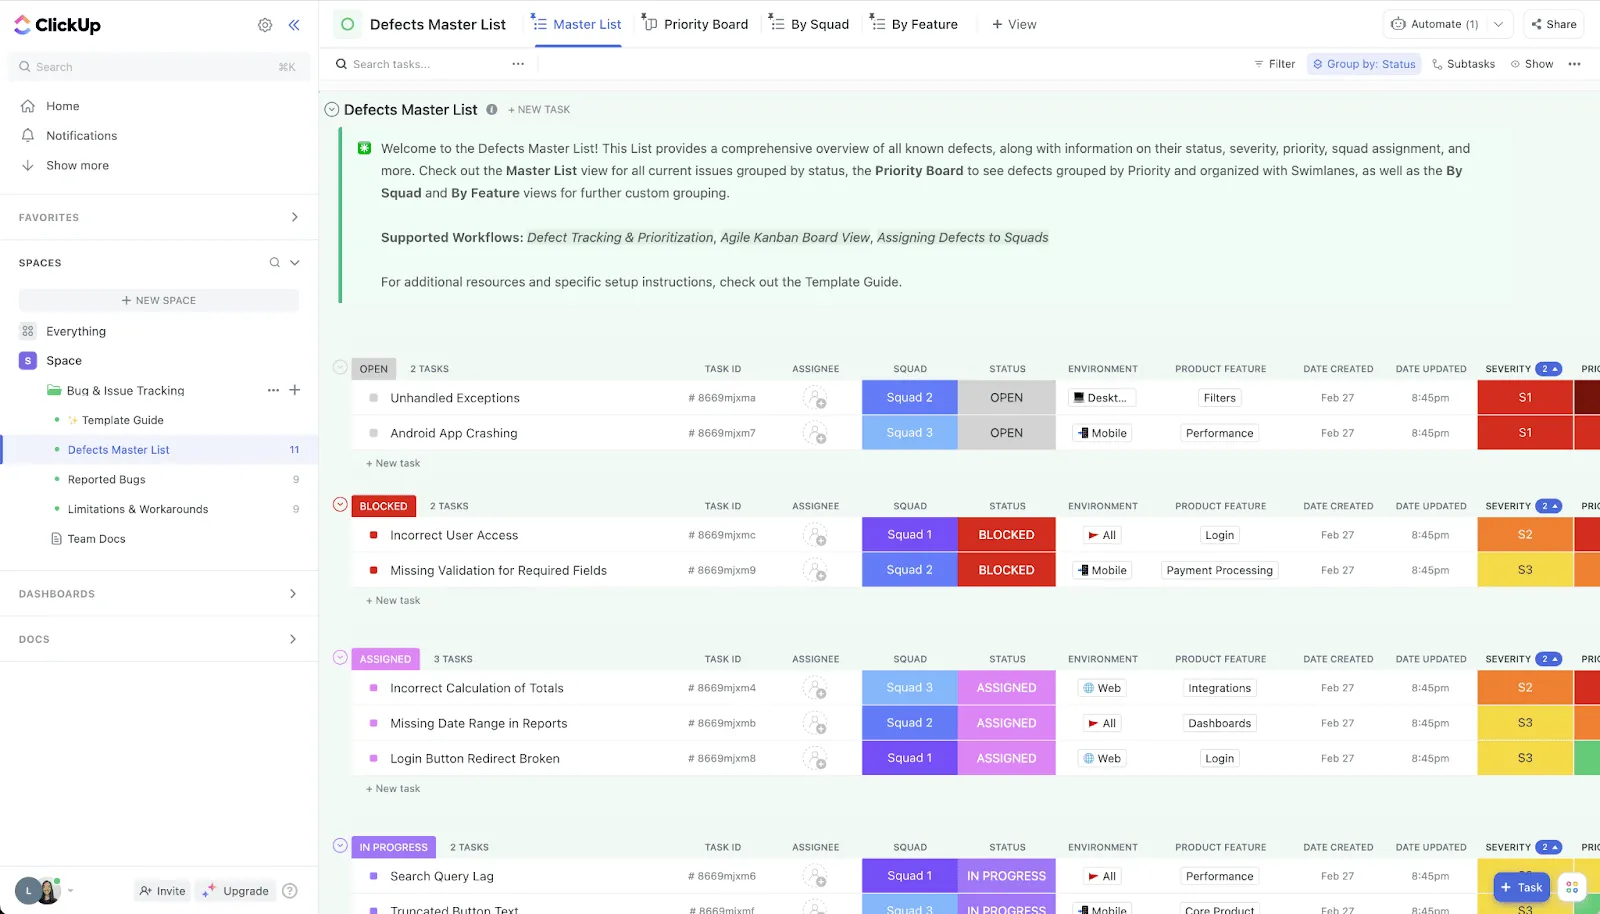
🛠️ Készre szerkesztett eszközkészletre van szüksége? A ClickUp Bug & Issue Tracking Template egy hatékony megoldás a ClickUp for Software-től, amelyet úgy terveztek , hogy segítsen a támogatási, fejlesztői és termékcsapatoknak könnyedén kézben tartani a szoftverhibákat és problémákat. A testreszabható nézetek, mint például a Lista, Tábla, Munkaterhelés, Űrlap és Idővonal segítségével a csapatok a számukra legmegfelelőbb módon jeleníthetik meg és kezelhetik a hibakövetési folyamatot.
A sablon 20 egyéni állapota és 7 egyéni mezője lehetővé teszi a munkafolyamat személyre szabását, biztosítva, hogy minden problémát nyomon kövessenek a felmerüléstől a megoldásig. A beépített automatizálások gondoskodnak az ismétlődő feladatokról, így értékes időt szabadítanak fel és csökkentik a kézi munkát.
💟 Bónusz: A Brain MAX az Ön AI-alapú asztali segédje, amelyet úgy terveztek, hogy intelligens, praktikus funkcióival felgyorsítsa a hibajavítást.
Ha hibát észlel, egyszerűen használja a Brain MAX beszéd-szöveggé alakító funkcióját a probléma leírásához – a hangfelvételét azonnal leírják, és csatolhatja egy új vagy meglévő hibajelentéshez. Az Enterprise Search funkció átkutatja az összes csatlakoztatott eszközét – például a ClickUp-ot, a GitHub-ot, a Google Drive-ot és a Slacket –, hogy előkeresse a kapcsolódó hibajelentéseket, hibajelentéseket, kódrészleteket és dokumentációkat, így az alkalmazások közötti váltás nélkül is rendelkezésére áll minden szükséges háttérinformáció.
Javítást kell koordinálnia? A Brain MAX segítségével a hibát a megfelelő fejlesztőhöz rendelheti, automatikus emlékeztetőket állíthat be az állapotfrissítésekre, és nyomon követheti az előrehaladást – mindezt az asztali számítógépéről!
2. Sentry (A legjobb a hibák rögzítéséhez)
A Sentry egy helyen rögzíti a hibákat, a nyomkövetéseket és a felhasználói munkameneteket, ezzel csökkentve az MTTD-t és a hiba reprodukálásának idejét. A mesterséges intelligencia által vezérelt hibacsoportosítás csökkenti a felesleges információkat; a „Suspect Commit” és a felelősségi szabályok azonosítják a valószínűsíthető kódtulajdonost, így az irányítás azonnali. A Session Replay funkció a mérnököknek pontos felhasználói útvonalat és konzol-/hálózati részleteket biztosít a hiba reprodukálásához, így elkerülhető a végtelen oda-vissza levelezés.
A Sentry AI funkciói összefoglalják a hiba kontextusát, és egyes technológiai környezetekben olyan Autofix javításokat javasolnak, amelyek hivatkoznak a hibás kódra. A gyakorlati hatás: kevesebb ismétlődő jegy, gyorsabb feladathozzárendelés és rövidebb út a bejelentéstől a működő javításig.
3. GitHub Copilot (A legjobb a kód gyorsabb áttekintéséhez)
A Copilot felgyorsítja a javítási ciklust a szerkesztőn belül. Elmagyarázza a veremnyomokat, célzott javításokat javasol, egységteszteket ír a javítás rögzítéséhez, és reprodukálási szkripteket készít.
A Copilot Chat végigvezeti Önt a hibás kódon, biztonságosabb átalakításokat javasol, és olyan megjegyzéseket vagy PR-leírásokat generál, amelyek gyorsabbá teszik a kódfelülvizsgálatot. A kötelező felülvizsgálatokkal és a folyamatos integrációval (CI) párosítva órákat takarít meg a „diagnosztizálás → megvalósítás → tesztelés” folyamatból, különösen az egyértelműen reprodukálható, jól körülhatárolt hibák esetében.
4. Snyk by DeepCode AI (A legalkalmasabb a minták felismerésére)
A DeepCode mesterséges intelligencián alapuló statikus elemzése a kódolás során és a pull requestekben is felismeri a hibákat és a biztonsági kockázatot jelentő mintákat. Kiemeli a problémás folyamatokat, elmagyarázza azok okát, és olyan biztonságos javításokat javasol, amelyek illeszkednek a kódbázis stílusához.
Azáltal, hogy a regressziókat még az összevonás előtt kiszűri, és a fejlesztőket biztonságosabb minták felé irányítja, csökkentheti az új hibák megjelenésének gyakoriságát, és felgyorsíthatja a felülvizsgálat során nehezen észrevehető, bonyolult logikai hibák kijavítását. Az IDE- és PR-integrációk révén mindez a munkafolyamat közvetlen közelében történik.
5. A Datadog Watchdog és AIOps (a legjobb a naplóelemzéshez)
A Datadog Watchdogja gépi tanulást (ML) használ a naplóbejegyzések, mutatók, nyomkövetések és a valós felhasználói monitorozás során fellépő rendellenességek feltárására. Összefüggésbe hozza a hirtelen kiugrásokat a telepítési jelölőkkel, az infrastruktúra-változásokkal és a topológiával, hogy javaslatot tegyen a lehetséges kiváltó okokra.
Az ügyfeleket érintő hibák esetében ez azt jelenti, hogy a hibák felismerése perceken belül megtörténik, az automatikus csoportosítás csökkenti a felesleges riasztások számát, és konkrét támpontokat kap arra vonatkozóan, hol érdemes keresni a hibát. A triázs ideje lerövidül, mivel nem üres lappal indul, hanem azzal a tuddással, hogy „ez a telepítés érintette ezeket a szolgáltatásokat, és ezen a végponton emelkedett a hibaarány”.
⚡️ Sablonarchívum: Ingyenes hibajelentés- és napló-sablonok Excelben és a ClickUpban
6. New Relic AI (A legalkalmasabb a trendek azonosítására és összefoglalására)
A New Relic Errors Inbox funkciója a hasonló hibákat szolgáltatások és verziók szerint csoportosítja, míg a mesterséges intelligencia-alapú asszisztens összefoglalja a hatásokat, kiemeli a valószínűsíthető okokat, és linkeket biztosít a kapcsolódó nyomkövetésekhez és tranzakciókhoz.
A telepítési összefüggések és az entitásváltozásokra vonatkozó információk egyértelművé teszik, ha egy friss kiadás a hibás. Elosztott rendszerek esetében ez a kontextus órákat spórol meg a csapatok közötti egyeztetésekből, és a hibát már egy megalapozott hipotézissel ellátva a megfelelő felelőshez juttatja.
7. Rollbar (A legjobb az automatizált munkafolyamatokhoz)
A Rollbar valós idejű hibafigyelésre specializálódott, intelligens ujjlenyomat-elemzéssel, amely csoportosítja az ismétlődő hibákat és nyomon követi a előfordulási trendeket. AI-vezérelt összefoglalói és a kiváltó okokra utaló tippjei segítenek a csapatoknak a probléma hatókörének (érintett felhasználók, érintett verziók) megértésében, míg a telemetriai adatok és a veremnyomok gyors utalásokat nyújtanak a hiba reprodukálásához.
A Rollbar munkafolyamat-szabályai automatikusan létrehozhatnak feladatokat, súlyossági címkéket rendelhetnek hozzájuk, és továbbíthatják azokat a felelősöknek, így a zavaros hibajelentésekből kontextussal ellátott, prioritás szerint rendezett sorok válnak.
8. PagerDuty AIOps és runbook-automatizálás (A legjobb megoldás az alacsony beavatkozási igényű diagnosztikához)
A PagerDuty eseménykorrelációt és gépi tanuláson alapuló zajcsökkentést alkalmaz, hogy a riasztási áradatokat kezelhető incidensekké sűrítsen.
A dinamikus irányítás az ügyet azonnal a megfelelő ügyeleteshez juttatja, míg a runbook-automatizálás már az emberi beavatkozás előtt elindíthatja a diagnosztikát vagy a hibaelhárítást (szolgáltatások újraindítása, telepítés visszavonása, funkciójelző kapcsolása). A hibaelhárítási idő tekintetében ez rövidebb MTTA-t, gyorsabb P0-es hibajavítást és kevesebb, a riasztásfáradtság miatt elvesztegetett órát jelent.
A közös vonal az automatizálás és a mesterséges intelligencia minden lépésben. Korábban észleli a hibákat, okosabban irányítja őket, gyorsabban jut el a kódhoz, és közli az állapotot anélkül, hogy lassítaná a fejlesztőket – mindez együttesen jelentősen csökkenti a hibajavítási időt.
📖 További információk: Hogyan használható a mesterséges intelligencia a DevOps-ban?
Gyakorlati példák a mesterséges intelligencia hibajavításra való felhasználására
Tehát a mesterséges intelligencia hivatalosan is kilépett a laboratóriumból. A gyakorlatban is csökkenti a hibajavítási időt.
Nézzük meg, hogyan!
| Terület / Szervezet | Hogyan használták az AI-t | Hatás / Előny |
|---|---|---|
| Ubisoft | Fejlesztettük a Commit Assistant nevű mesterséges intelligencia-eszközt, amelyet egy évtizednyi belső kód alapján tanítottunk be, és amely a kódolás szakaszában előre jelzi és megelőzi a hibákat. | Célja az idő és a költségek drasztikus csökkentése – a játékfejlesztési kiadások akár 70%-át hagyományosan hibajavításokra fordítják. |
| Razer (Wyvrn Platform) | Elindítottuk a mesterséges intelligenciával támogatott QA Copilot szolgáltatást (amely integrálva van az Unreal és a Unity szoftverekbe) a hibák automatikus felismerése és a minőségbiztosítási jelentések generálása érdekében. | Akár 25%-kal javítja a hibák felismerését, és felére csökkenti a minőségbiztosítási időt. |
| Google / DeepMind és Project Zero | Bemutattuk a Big Sleep nevű mesterséges intelligencia-alapú eszközt, amely önállóan felismeri a biztonsági réseket olyan nyílt forráskódú szoftverekben, mint az FFmpeg és az ImageMagick. | 20 hibát azonosítottunk, amelyeket mind emberi szakértők ellenőriztek, és javításra kerülnek. |
| A UC Berkeley kutatói | A CyberGym nevű benchmark segítségével a mesterséges intelligencia modellek 188 nyílt forráskódú projektet elemeztek , 17 sebezhetőséget tártak fel – köztük 15 ismeretlen „zero-day” hibát –, és proof-of-concept kihasználási módszereket generáltak. | Bemutatja a mesterséges intelligencia fejlődő képességeit a sebezhetőségek felismerése és az automatizált kihasználás-ellenőrzés terén. |
| Spur (Yale Startup) | Kifejlesztettünk egy mesterséges intelligencián alapuló ügynököt, amely a hétköznapi nyelven megfogalmazott teszteset-leírásokat automatizált weboldal-tesztelési rutinokká alakítja át – gyakorlatilag egy önmagát író minőségbiztosítási munkafolyamatot hozva létre. | Lehetővé teszi az autonóm tesztelést minimális emberi beavatkozással |
| Android-hibajelentések automatikus reprodukálása | NLP-t és megerősítéses tanulást használtunk a hibajelentések nyelvi elemzéséhez, valamint az Android-hibák reprodukálásához szükséges lépések generálásához . | 67%-os pontosságot és 77%-os visszahívási arányt értünk el, valamint a hibajelentések 74%-át sikerült reprodukálnunk, ami felülmúlja a hagyományos módszerek teljesítményét. |
Gyakori hibák a hibajavítási idő mérésében
Ha a mérés nem pontos, a fejlesztési terv sem lesz az.
A hibajavítási munkafolyamatokban előforduló „rossz számok” többsége a homályos definíciókból, az inkonzisztens munkafolyamatokból és a felületes elemzésből származik.
Kezdje tehát az alapokkal – mi számít indításnak/leállításnak, hogyan kezeli a várakozási időket és az újraindításokat –, majd értelmezze az adatokat úgy, ahogyan az ügyfelei tapasztalják azokat. Ez magában foglalja a következőket:
❌ Homályos határok: Ha a „Jelentett→Megoldott” és a „Jelentett→Lezárt” kategóriákat ugyanazon a műszerfalon keveri össze (vagy hónapról hónapra váltogatja őket), az értelmetlenné teszi a trendek értelmezését. Válasszon ki egy határt, dokumentálja azt, és tartassa be a csapatoknál. Ha mindkettőre szüksége van, tegye közzé őket külön mutatóként, egyértelmű címkékkel.
❌ Kizárólag átlagokra épülő megközelítés: Az átlagra támaszkodás elrejti a valóságot, miszerint a várólistákban néhány, hosszú ideig tartó kiugró érték is előfordul. Használja a mediánt (P50) a „tipikus” idő jelzésére, a P90-et a kiszámíthatósághoz és az SLA-khoz, az átlagot pedig tartsa meg a kapacitástervezéshez. Mindig az eloszlást vegye figyelembe, ne csak egy számot.
❌ Nincs szegmentálás: Ha az összes hibát egy kalap alá vesszük, a P0-s incidensek összekeverednek a „kozmetikai” P3-as hibákkal. Szegmentáljon súlyosság, forrás (ügyfél vs. minőségbiztosítás vs. felügyelet), komponens/csapat és „új vs. regresszió” szerint. A P0/P1 P90-es értéke az, amit az érdekelt felek érzékelnek; a P2+ mediánja pedig az, amire a fejlesztőcsapat a tervezés során támaszkodik.
❌ A „szüneteltetett” idő figyelmen kívül hagyása: Vár az ügyfélnaplókra, egy külső beszállítóra vagy egy kiadási időpontra? Ha nem követi nyomon a „Blokkolt/Szüneteltetett” állapotot elsőrendű státuszként, a hibaelhárítási idő vitatémává válik. Jelentse mind a naptári időt, mind az aktív időt, hogy a szűk keresztmetszetek láthatóvá váljanak, és a viták megszűnjenek.
❌ Időnormalizálási eltérések: Az időzónák keverése vagy az üzleti és a naptári órák közötti váltás a folyamat közben torzítja az összehasonlításokat. Normalizálja az időbélyegeket egy időzónára (vagy UTC-re), és egyszer és mindenkorra döntse el, hogy az SLA-kat üzleti vagy naptári órákban méri-e; ezt következetesen alkalmazza.
❌ Hibás bejelentések és duplikátumok: A hiányzó környezeti/build-adatok és a duplikált jegyek meghosszabbítják a kezelési időt, és zavart okoznak a felelősségi körökben. Szabványosítsa a bejelentéskor kötelezően kitöltendő mezőket, automatikusan egészítse ki az adatokat (naplók, verzió, eszköz), és szűrje ki a duplikátumokat anélkül, hogy visszaállítaná a kezelési időt – a duplikátumokat kapcsolódóként zárja le, ne „új” problémaként.
❌ Inkonzisztens állapotmodellek: Az egyedi állapotok („QA Ready-ish”, „Pending Review 2”) elrejtik az állapotban töltött időt, és megbízhatatlanná teszik az állapotváltásokat. Határozzon meg egy kanonikus munkafolyamatot (Új → Osztályozva → Folyamatban → Felülvizsgálat alatt → Megoldva → Lezárva), és ellenőrizze, hogy nincsenek-e a folyamaton kívüli állapotok.
❌ A státuszban töltött idő figyelmen kívül hagyása: Egyetlen „teljes idő” érték nem árulja el, hol akadozik a munka. Rögzítse és vizsgálja meg a „Triage”, „In Review”, „Blocked” és „QA” státuszokban töltött időt. Ha a kódfelülvizsgálat 90. percentilis ideje messze meghaladja az implementációét, akkor a megoldás nem a „gyorsabb kódolás”, hanem a felülvizsgálati kapacitás felszabadítása.
🧠 Érdekesség: A DARPA legújabb AI Cyber Challenge versenye a kiberbiztonsági automatizálás terén elért áttörő fejlődést mutatta be. A versenyen olyan mesterséges intelligencia rendszerek vettek részt, amelyek célja a szoftverekben rejlő sebezhetőségek önálló felismerése, kihasználása és javítása volt – emberi beavatkozás nélkül. A győztes „Team Atlanta” csapat lenyűgözően a beépített hibák 77%-át fedezte fel, és azok 61%-át sikeresen kijavította, ezzel bizonyítva, hogy a mesterséges intelligencia nem csupán képes a hibák felderítésére, hanem azok aktív kijavítására is.
❌ A „reopen blindness” (az újbóli megnyitások figyelmen kívül hagyása): Ha az újbóli megnyitásokat új hibaként kezeljük, az visszaállítja a mérési időt, és kedvezőbb képet ad az MTTR-ről. Kövesse nyomon az újbóli megnyitások arányát és a „stabil lezárásig eltelt időt” (az első jelentéstől a végleges lezárásig, valamennyi ciklusban). Az újbóli megnyitások számának emelkedése általában a reprodukció gyengeségére, a tesztelési hiányosságokra vagy a „kész” fogalmának homályos meghatározására utal.
❌ Nincs MTTA: A csapatok az MTTR-re koncentrálnak, és figyelmen kívül hagyják az MTTA-t (a bejelentés nyugtázásának/felelősségvállalásnak az ideje). A magas MTTA a hosszú megoldási idő korai jele. Mérje meg, állítson be SLA-kat a súlyosság szerint, és automatizálja az irányítást/eskalációt, hogy alacsony szinten tartsa.
❌ Mérőeszközök nélküli mesterséges intelligencia/automatizálás: Ha hagyja, hogy a mesterséges intelligencia felülvizsgálat nélkül állapítsa meg a súlyossági szintet vagy zárja le az ismétlődő hibákat, az a határesetek téves besorolásához vezethet, és észrevétlenül torzíthatja a mutatókat. Használja a mesterséges intelligenciát javaslatokhoz, kérjen emberi megerősítést a P0/P1 besorolásoknál, és havonta ellenőrizze a modell teljesítményét, hogy adatai megbízhatók maradjanak.
Ha ezeket a hiányosságokat orvosolja, a hibaelhárítási időre vonatkozó diagramjai végre a valóságot fogják tükrözni. Ettől kezdve a fejlődés egyre gyorsul: a hatékonyabb beérkező ügyek feldolgozása csökkenti az MTTA-t, a tisztább állapotok feltárják a valódi szűk keresztmetszeteket, a szegmentált P90-es értékek pedig olyan ígéreteket adnak a vezetőknek, amelyeket be is tud tartani.
⚡️ Sablonarchívum: 10 teszteset-sablon szoftverteszteléshez
Bevált gyakorlatok a hibajavítás hatékonyságának növeléséhez
Összefoglalásképpen íme a legfontosabb szempontok, amelyeket érdemes szem előtt tartani!
| 🧩 Bevált gyakorlat | 💡 Mit jelent ez? | 🚀 Miért fontos ez? |
| Használjon megbízható hibakövető rendszert | Kövesse nyomon az összes bejelentett hibát egy központosított hibakövető rendszer segítségével. | Biztosítja, hogy egyetlen hiba se vesszen el, és lehetővé teszi a hibák állapotának átláthatóságát a csapatok között. |
| Írjon részletes hibajelentéseket | Adja meg a vizuális kontextust, az operációs rendszer adatait, a hiba reprodukálásához szükséges lépéseket és a súlyossági szintet. | Segít a fejlesztőknek a hibák gyorsabb kijavításában azáltal, hogy minden lényeges információt előre rendelkezésre bocsát. |
| A hibák kategorizálása és prioritásba rendezése | Használjon prioritási mátrixot a hibák sürgősség és hatás szerinti rendezéséhez. | A csapat figyelmét elsősorban a kritikus hibákra és a sürgős problémákra összpontosítja. |
| Használja ki az automatizált tesztelés előnyeit | Futtassa a teszteket automatikusan a CI/CD-folyamatában. | Támogatja a korai felismerést és megakadályozza a regressziókat. |
| Határozzon meg egyértelmű jelentési irányelveket | Biztosítson sablonokat és képzést a hibák jelentésének módjáról. | Ez pontosabb információkhoz és zökkenőmentesebb kommunikációhoz vezet. |
| Kövesse nyomon a legfontosabb mutatókat | Mérje meg a hibaelhárítási időt, az eltelt időt és a válaszadási időt. | Lehetővé teszi a teljesítmény nyomon követését és javítását a korábbi adatok felhasználásával. |
| Alkalmazzon proaktív megközelítést | Ne várja meg, amíg a felhasználók panaszt tesznek – végezzen proaktív tesztelést! | Növeli az ügyfél-elégedettséget és csökkenti a támogatási terhelést. |
| Használja ki az intelligens eszközöket és a gépi tanulást | Használja a gépi tanulást a hibák előrejelzéséhez és a javítások javaslatához. | Növeli a hatékonyságot a kiváltó okok azonosításában és a hibák kijavításában. |
| Az SLA-knak való megfelelés | Tartsa be a megoldásra vonatkozóan elfogadott szolgáltatási szintű megállapodásokat. | Ezzel bizalmat épít és időben megfelel az ügyfelek elvárásainak. |
| Folyamatos felülvizsgálat és fejlesztés | Elemezze az újra megnyitott hibákat, gyűjtsön visszajelzéseket, és finomítsa a folyamatokat. | Elősegíti a fejlesztési folyamat és a hibakezelés folyamatos fejlesztését. |
A hibajavítás egyszerűsítése kontextusfüggő mesterséges intelligenciával
A leggyorsabb hibajavító csapatok nem a hősi teljesítményekre támaszkodnak. Hanem egy rendszert alakítanak ki: egyértelmű kezdési és befejezési feltételek, áttekinthető beérkező hibajelentések, az üzleti hatások szerinti prioritásba sorolás, világos felelősségi körök, valamint szoros visszacsatolási ciklusok a támogatás, a minőségbiztosítás, a fejlesztés és a kiadás között.
A ClickUp lehet az a mesterséges intelligenciával támogatott irányítóközpont, amelyre a hibajavítási rendszerének szüksége van. Központosítsa az összes bejelentést egy sorba, szabványosítsa a kontextust strukturált mezőkkel, és hagyja, hogy a ClickUp mesterséges intelligenciája osztályozza, összefoglalja és rangsorolja a bejelentéseket, miközben az automatizálások érvényesítik az SLA-kat, eskalálnak, ha a határidők csúsznak, és biztosítják az érintettek összehangoltságát. Kapcsolja össze a hibákat az ügyfelekkel, a kóddal és a kiadásokkal, hogy a vezetők lássák a hatást, a szakemberek pedig zavartalanul folytathassák a munkájukat.
Ha készen áll arra, hogy lerövidítse a hibajavítási időt és előre jelezhetőbbé tegye a fejlesztési ütemtervét, regisztráljon a ClickUp-ra, és már napok alatt – nem pedig negyedéveken belül – tapasztalhatja majd a javulást.
Gyakran feltett kérdések
Mi számít jó hibajavítási időnek?
Nincs egyetlen „jó” érték – ez a hiba súlyosságától, a kiadási modelltől és a kockázati toleranciától függ. Használja a mediánokat (P50) a „tipikus” teljesítményhez és a P90-et az ígéretekhez/SLA-khoz, majd szegmentálja a hiba súlyossága és forrása szerint.
Mi a különbség a hibaelhárítás és a hiba lezárása között?
A megoldás akkor valósul meg, amikor a javítást végrehajtják (pl. a kódot összevonják, a konfigurációt alkalmazzák), és a csapat a hibát megoldottnak tekinti. A lezárás akkor történik, amikor a problémát ellenőrizték és hivatalosan lezárták (pl. a minőségbiztosítás a célkörnyezetben érvényesítette, kiadták, vagy indoklással „nem javítandó”/„duplikátum” jelöléssel látták el). Sok csapat mindkettőt méri: a „Jelentett→Megoldott” arány a fejlesztési sebességet tükrözi; a „Jelentett→Lezárt” arány pedig a teljes minőségi folyamatot. Használjon következetes definíciókat, hogy a műszerfalak ne keverjék össze a szakaszokat.
Mi a különbség a hibajavítási idő és a hibaészlelési idő között?
A felismerési idő (MTTD) azt jelenti, hogy mennyi idő telik el a hiba felismerése és a hiba kijavítása között – akár felügyelet, minőségbiztosítás vagy a felhasználók révén történik a felismerés. A megoldási idő azt jelenti, hogy mennyi idő telik el a felismerés/bejelentés és a javítás végrehajtása (és, ha úgy tetszik, validálása/kiadása) között. Ezek együttesen határozzák meg az ügyfelekre gyakorolt hatás időtartamát: gyors felismerés, gyors nyugtázás, gyors megoldás és biztonságos kiadás. Nyomon követhetjük az MTTA-t (az elismerés/hozzárendelés idejét) is, hogy felismerjük a triázs késedelmeit, amelyek gyakran hosszabb megoldási időt jeleznek előre.
Hogyan segít a mesterséges intelligencia a hibajavításban?
A mesterséges intelligencia lerövidíti azokat a folyamatokat, amelyek általában időt rabolnak: a beérkezés, a triázs, a diagnosztika, a javítás és az ellenőrzés.
- Beérkezés és osztályozás: Automatikusan összefoglalja a hosszú jelentéseket, kivonja a hiba reprodukciójának lépéseit és környezetét, jelzi az ismétlődő bejelentéseket, és javaslatot tesz a súlyossági szintre és a prioritásra, így a fejlesztők tiszta kontextusból indulhatnak (pl. ClickUp AI, Sentry AI).
- Útválasztás és SLA-k: Megjósolja a valószínűsíthető komponens/felelős személyt, időzítőket állít be, és eskalálja az ügyet, ha az MTTA vagy a felülvizsgálati várakozási idő túllépődik – ezzel csökkentve a tétlen „státuszban töltött időt” (ClickUp Automations és ügynökszerű munkafolyamatok).
- Diagnózis: Hasonló hibákat csoportosít, a hirtelen megugrásokat a legutóbbi commitokkal/kiadásokkal hozza összefüggésbe, és a stack trace-ek és a kódkontextus segítségével rámutat a valószínűsíthető kiváltó okokra (Sentry AI és hasonló eszközök).
- Végrehajtás: A kódtárában található minták alapján javasol kódmódosításokat és teszteket, így felgyorsítva az „írás/javítás” ciklust (GitHub Copilot; Snyk Code AI by DeepCode).
- Ellenőrzés és kommunikáció: teszteseteket ír a hibaismétlési lépések alapján, kiadási megjegyzéseket és az érdekelt felek számára szóló frissítéseket készít, valamint összefoglalja az állapotot a vezetők és az ügyfelek számára (ClickUp AI). Ha ezeket együtt használják – a ClickUp-ot irányítóközpontként, a Sentry/Copilot/DeepCode-ot pedig a rendszer részeként –, a csapatok hősi teljesítmények nélkül is csökkenthetik az MTTA/P90 időket.