Пускате най-новата актуализация на софтуера и започват да валят сигналите.
Изведнъж един показател определя всичко – от CSAT/NPS до закъсненията в пътната карта: времето за отстраняване на бъгове.
Ръководителите го възприемат като показател за спазване на обещанията — можем ли да пуснем продукта, да се учим и да защитим приходите според графика? Специалистите на предната линия изпитват трудностите на практика — дублирани заявки, неясна отговорност, шумни ескалации и контекст, разпръснат из Slack, електронни таблици и отделни инструменти.
Тази фрагментация удължава циклите, скрива основните причини и превръща определянето на приоритетите в гадаене.
Резултатът? Забавено усвояване, неизпълнени ангажименти и натрупани задачи, които незабележимо натоварват всеки спринт.
Това ръководство е вашият изчерпателен наръчник за измерване, сравнителен анализ и съкращаване на времето за отстраняване на грешки, като показва конкретно как изкуственият интелект променя работния процес в сравнение с традиционните, ръчни процедури.
Какво представлява времето за отстраняване на грешки?
Времето за отстраняване на грешки е времето, необходимо за отстраняването на дадена грешка, измервано от момента на докладването ѝ до пълното ѝ отстраняване.
На практика отчитането на времето започва, когато даден проблем бъде докладван или открит (от потребители, екипа за контрол на качеството или чрез мониторинг), и спира, когато поправката бъде приложена и интегрирана, готова за проверка или пускане в експлоатация — в зависимост от това как вашият екип дефинира понятието „завършено“.
Пример: срив с приоритет P1, докладван в 10:00 ч. в понеделник, с поправка, приложена в 15:00 ч. във вторник, има време за отстраняване от ~29 часа.
Това не е същото като времето за откриване на грешки. Времето за откриване измерва колко бързо разпознавате даден дефект, след като той възникне (задействане на аларми, откриване от инструменти за QA тестване, сигнализиране от клиенти).
Времето за отстраняване измерва колко бързо преминавате от установяване на проблема до неговото отстраняване – сортиране, възпроизвеждане, диагностициране, внедряване, преглед, тестване и подготовка за пускане. Представете си откриването като „знаем, че има проблем“, а отстраняването като „проблемът е отстранен и всичко е готово“.
Екипите използват леко различаващи се граници; изберете една и бъдете последователни, за да са реални вашите тенденции:
- Докладвано → Решено: Завършва, когато поправката в кода е обединена и готова за QA. Подходящо за инженерна производителност
- Докладвано → Затворено: Включва валидиране от отдела за контрол на качеството и пускане в експлоатация. Най-подходящо за SLA, засягащи клиентите
- Открито → Решено: Започва, когато системата за мониторинг/контрол на качеството открие проблема, дори преди да е създаден тикет. Полезно за екипи с интензивна производствена дейност
🧠 Интересен факт: Една странна, но забавна грешка в Final Fantasy XIV беше похвалена за това, че беше толкова специфична, че читателите я нарекоха „Най-специфичното отстраняване на грешка в MMO за 2025 г.“ “ Той се проявяваше, когато играчите определяха цена на предмети точно между 44 442 и 49 087 гил в определена зона за събития – което предизвикваше прекъсвания на връзката, вероятно поради грешка, свързана с препълване на целочисления регистър.
Защо е важно
Времето за отстраняване на грешките е фактор, който влияе върху ритъма на пускане на версии. Дългите или непредвидими срокове налагат съкращаване на обхвата, изпускане на спешни корекции и замразяване на версиите; те създават „планиращ дълг“, тъй като „дългата опашка“ (изключенията) нарушава хода на спринтовете повече, отколкото показва средната стойност.
Това е пряко свързано и с удовлетвореността на клиентите. Клиентите проявяват търпение към проблемите, когато те се признават бързо и се разрешават по предвидим начин. Бавните решения – или, още по-лошо, непредсказуемите решения – водят до ескалации, влошават показателите CSAT/NPS и излагат на риск подновяването на абонаментите.
Накратко, ако измервате времето за отстраняване на бъгове прецизно и систематично го намалявате, вашите планове за развитие и взаимоотношенията ви ще се подобрят.
Как да измервате времето за отстраняване на грешки?
Първо, определете откъде започва и къде свършва отчитането на времето.
Повечето екипи избират или „Докладвано“ → „Решено“ (поправката е интегрирана и готова за проверка), или „Докладвано“ → „Затворено“ (отделът за контрол на качеството е потвърдил, че промяната е пусната в употреба или по друг начин е приключена).
Изберете едно определение и го използвайте последователно, за да бъдат тенденциите ви значими.
Сега ви трябват някои измерими показатели. Нека ги очертаем:
Ключови показатели за проследяване на грешки, на които да обърнете внимание:
| 📊 Показател | 📌 Какво означава това | 💡 Как ви помага | 🧮 Формула (ако е приложимо) |
|---|---|---|---|
| Брой грешки 🐞 | Общ брой докладвани грешки | Предоставя обща картина на състоянието на системата. Висока стойност? Време е за разследване. | Общ брой грешки = Всички грешки, регистрирани в системата {Отворени + Затворени} |
| Отворени бъгове 🚧 | Грешки, които все още не са отстранени | Показва текущата натовареност. Помага при определянето на приоритетите. | Отворени грешки = Общо грешки – Затворени грешки |
| Затворени грешки ✅ | Отстранени и проверени грешки | Проследява напредъка и извършената работа. | Затворени грешки = Брой грешки със статус „Затворена“ или „Решена“ |
| Тежест на грешката 🔥 | Критичност на грешката (например: критична, сериозна, незначителна) | Помага за сортиране на грешките според тяхното въздействие. | Проследява се като категорично поле, без формула. Използвайте филтри/групиране. |
| Приоритет на грешките 📅 | Колко спешно трябва да бъде отстранена дадена грешка | Помага при планирането на спринтове и версии. | Също така категорично поле, обикновено класифицирано (например P0, P1, P2). |
| Време за отстраняване ⏱️ | Време от докладването на грешката до отстраняването ѝ | Измерва бързината на реакция. | Време за разрешаване = Дата на приключване – Дата на подаване на сигнала |
| Процент на повторно отваряне 🔄 | Процент на грешките, които са били отворени отново след затваряне | Отразява качеството на поправките или проблемите с регресията. | Процент на повторно отваряне (%) = {Повторно отворени бъгове ÷ Общ брой затворени бъгове} × 100 |
| Изтичане на бъгове 🕳️ | Грешки, които са се промъкнали в производствената среда | Показва ефективността на QA/тестването на софтуер. | Процент на пропуските (%) = {Грешки в продукцията ÷ Общ брой грешки} × 100 |
| Плътност на дефектите 🧮 | Брой грешки на единица размер на кода | Посочва областите в кода, които са изложени на риск. | Плътност на дефектите = Брой бъгове ÷ KLOC {хиляди реда код} |
| Възложени срещу невъзложени бъгове 👥 | Разпределение на грешките по отговорност | Гарантира, че нищо няма да бъде пропуснато. | Използвайте филтър: Неприсвоени = Грешки, при които полето „Присвоено на“ е празно |
| Възраст на отворените бъгове 🧓 | Колко дълго една грешка остава неотстранена | Открива рисковете от стагнация и натрупване на задачи. | Възраст на грешката = Текуща дата – Дата на докладване |
| Дублирани бъгове 🧬 | Брой дублиращи се сигнали | Показва грешките в процесите на приемане. | Процент на дублираните грешки = Брой дублирани грешки ÷ Общ брой грешки × 100 |
| MTTD (средно време за откриване) 🔎 | Средно време, необходимо за откриване на грешки или инциденти | Измерва ефективността на мониторинга и осведомеността. | MTTD = Σ(Време на откриване – Време на възникване) ÷ Брой грешки |
| MTTR (средно време за отстраняване на грешки) 🔧 | Средно време за пълно отстраняване на грешка след откриването ѝ | Проследява оперативната реакция на инженерите и времето за отстраняване на грешките. | MTTR = Σ(Време за отстраняване – Време за откриване) ÷ Брой отстранени грешки |
| MTTA (средно време за потвърждение) 📬 | Време от откриването до момента, в който някой започне да работи по грешката | Показва реактивността на екипа и бързината на реакция при сигнали. | MTTA = Σ(Време на потвърждаване – Време на откриване) ÷ Брой грешки |
| MTBF (средно време между откази) 🔁 | Време между отстраняването на една грешка и възникването на следващата | Показва стабилност във времето. | MTBF = Общо време на работа ÷ Брой откази |
⚡️ Архив с шаблони: 15 безплатни шаблона и формуляри за докладване на грешки за проследяване на грешки
Фактори, които влияят върху времето за отстраняване на грешки
Времето за отстраняване на грешки често се приравнява на „колко бързо програмират инженерите“.
Но това е само една част от процеса.
Времето за отстраняване на бъгове е резултат от качеството при приемането, ефективността на потока през системата и риска от зависимости. Когато някой от тези фактори се провали, продължителността на цикъла се удължава, предсказуемостта спада, а оплакванията стават все по-силни.
Качеството на приемането определя тона
Сигналите, които пристигат без ясни стъпки за възпроизвеждане, подробности за средата, логове или информация за версията/билда, налагат допълнителна кореспонденция. Дублиращите се сигнали от различни канали (поддръжка, QA, мониторинг, Slack) създават объркване и раздробяват отговорността.
Колкото по-рано уловите правилния контекст – и премахнете дублиращите се данни – толкова по-малко прехвърляния и запитвания за изясняване ще ви бъдат необходими по-късно.
Приоритизирането и насочването определят кой се занимава с грешката и кога
Етикетите за сериозност, които не съответстват на въздействието върху клиентите/бизнеса (или които се променят с времето), водят до объркване в опашката: най-шумните заявки прескачат опашката, докато дефектите с голямо въздействие остават на заден план.
Ясните правила за насочване по компонент/отговорник и единната „основа на истината“ не позволяват задачите с приоритет P0/P1 да бъдат затрупани от „скорошни и шумни“ задачи.
Отговорността и предаването на задачите са „тихи убийци“
Ако не е ясно дали даден бъг принадлежи към екипа за мобилни приложения, за бекенд автентификация или към екипа на платформата, той се прехвърля. Всяко прехвърляне нулира контекста.
Часовите зони допълнително усложняват ситуацията: грешка, докладвана късно през деня, за която няма посочен отговорен, може да загуби 12–24 часа, преди някой изобщо да започне да я възпроизвежда. Ясните определения за „кой отговаря за какво“, заедно с дежурство или седмичен DRI, премахват това забавяне.
Възможността за възпроизвеждане зависи от наблюдаемостта
Непълните регистри, липсващи идентификатори за корелация или липса на следи от сривове превръщат диагностиката в гадаене. Грешките, които се появяват само при определени флагове, наематели или формати на данните, са трудни за възпроизвеждане в средата за разработка.
Ако инженерите нямат сигурен достъп до пречистени данни, подобни на тези в производствената среда, те се налага да извършват инструментиране, повторно разгръщане и да чакат – дни, вместо часове.
Съвместимостта на средата и данните ви помага да работите коректно
„Работи на моя компютър“ обикновено означава „производствените данни са различни“. Колкото повече вашата среда за разработка/тестване се различава от производствената (конфигурация, услуги, версии на софтуер от трети страни), толкова повече време ще прекарвате в преследване на призраци. Сигурните моментални снимки на данните, скриптовете за инициализация и проверките за съвпадение намаляват тази разлика.
Незавършената работа (WIP) и фокусът определят действителната производителност
Претоварените екипи поемат твърде много бъгове наведнъж, разпиляват вниманието си и се лутат между задачи и срещи. Смяната на контекста добавя невидими часове.
Видимото ограничение на работата в процес (WIP) и стремежът да завършвате започнатото, преди да поемате нова работа, ще намалят медианата ви по-бързо от всяко единично героично усилие.
Прегледът на кода, непрекъснатото интегриране (CI) и скоростта на контрола на качеството (QA) са класическите пречки
Бавните времена за изграждане, нестабилните тестове и неясните споразумения за ниво на обслужване (SLA) при прегледа забавят иначе бързите поправки. Един 10-минутен пач може да отнеме два дни, докато се чака прегледач или се вмъкне в часове наред в производствения поток.
По същия начин опашките за QA, които тестват на партиди или разчитат на ръчни тестове за функционалност, могат да удължат с цели дни преминаването от „Докладвано → Затворено“, дори когато преминаването от „Докладвано → Решено“ е бързо.
Зависимостите удължават опашките
Промените, засягащи различни екипи (схеми, миграции на платформи, актуализации на SDK), грешките на доставчиците или прегледите в магазините за приложения (за мобилни устройства) водят до състояния на изчакване. Без изрично проследяване на състоянията „Блокирано/Пауза“ тези изчаквания незабележимо завишават средните ви стойности и прикриват къде се намира истинското затруднение.
Моделът на пускане на версии и стратегията за връщане към предишна версия са от значение
Ако пускате версии в големи „релийз трейн“-ове с ръчни контролни точки, дори отстранените бъгове остават в очакване до следващия „трейн“. Функционалните флагове, „канарийските“ версии и каналите за спешни поправки съкращават времето за отстраняване – особено при инциденти от категории P0/P1 – като ви позволяват да отделите внедряването на поправките от пълните цикли на пускане на версии.
Архитектурата и технологичният дълг определят вашите ограничения
Тясната обвързаност, липсата на тестови граници и непрозрачните наследени модули правят простите поправки рискови. Екипите компенсират това с допълнителни тестове и по-дълги прегледи, което удължава циклите. От друга страна, модулният код с добри тестове за съответствие ви позволява да действате бързо, без да нарушавате съседните системи.
Комуникацията и поддържането на актуален статус влияят върху предсказуемостта
Неясните актуализации („разглеждаме въпроса“) водят до допълнителна работа, когато заинтересованите страни питат за очакваното време за разрешаване (ETA), отдела за поддръжка отваря отново тикети или продуктовият екип ескалира проблема. Ясните промени в статуса, бележките за възпроизвеждането и основната причина, както и публикуваното очаквано време за разрешаване (ETA) намаляват отпадането на клиенти и помагат на инженерния ви екип да остане фокусиран.
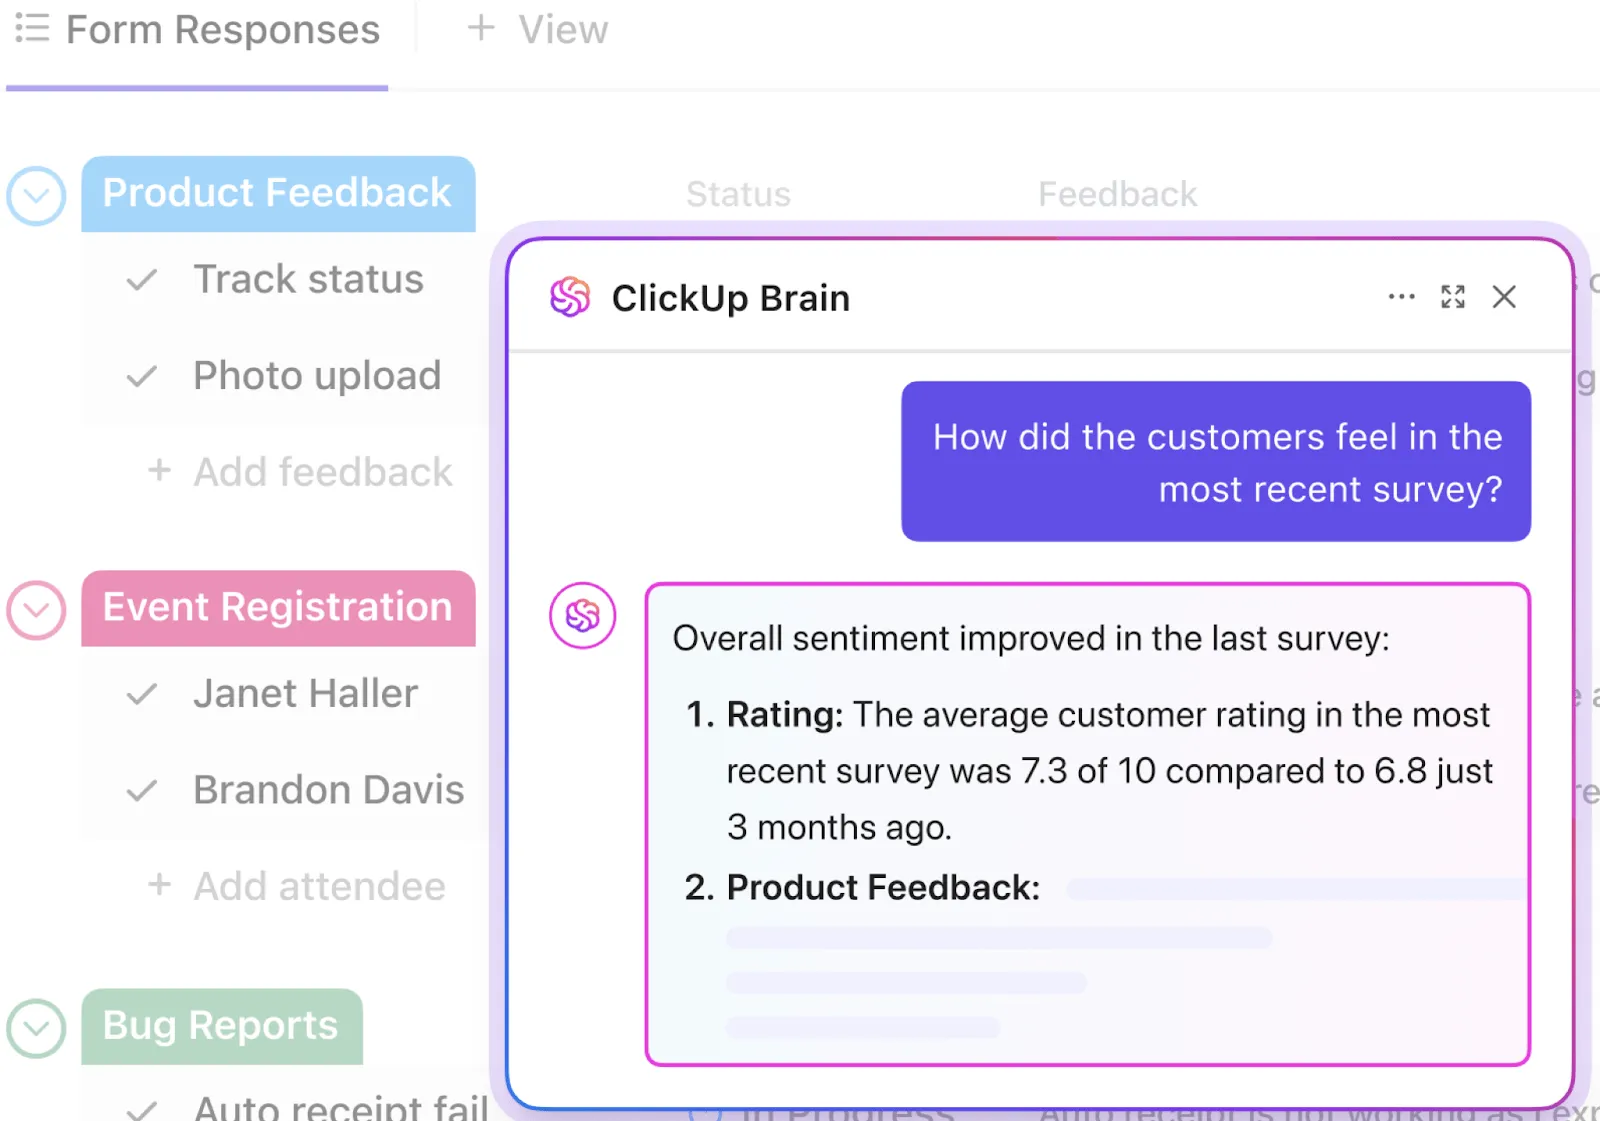
📮ClickUp Insight: Средностатистическият професионалист прекарва над 30 минути на ден в търсене на информация, свързана с работата — това са над 120 часа годишно, загубени в претърсване на имейли, разговори в Slack и разпръснати файлове.
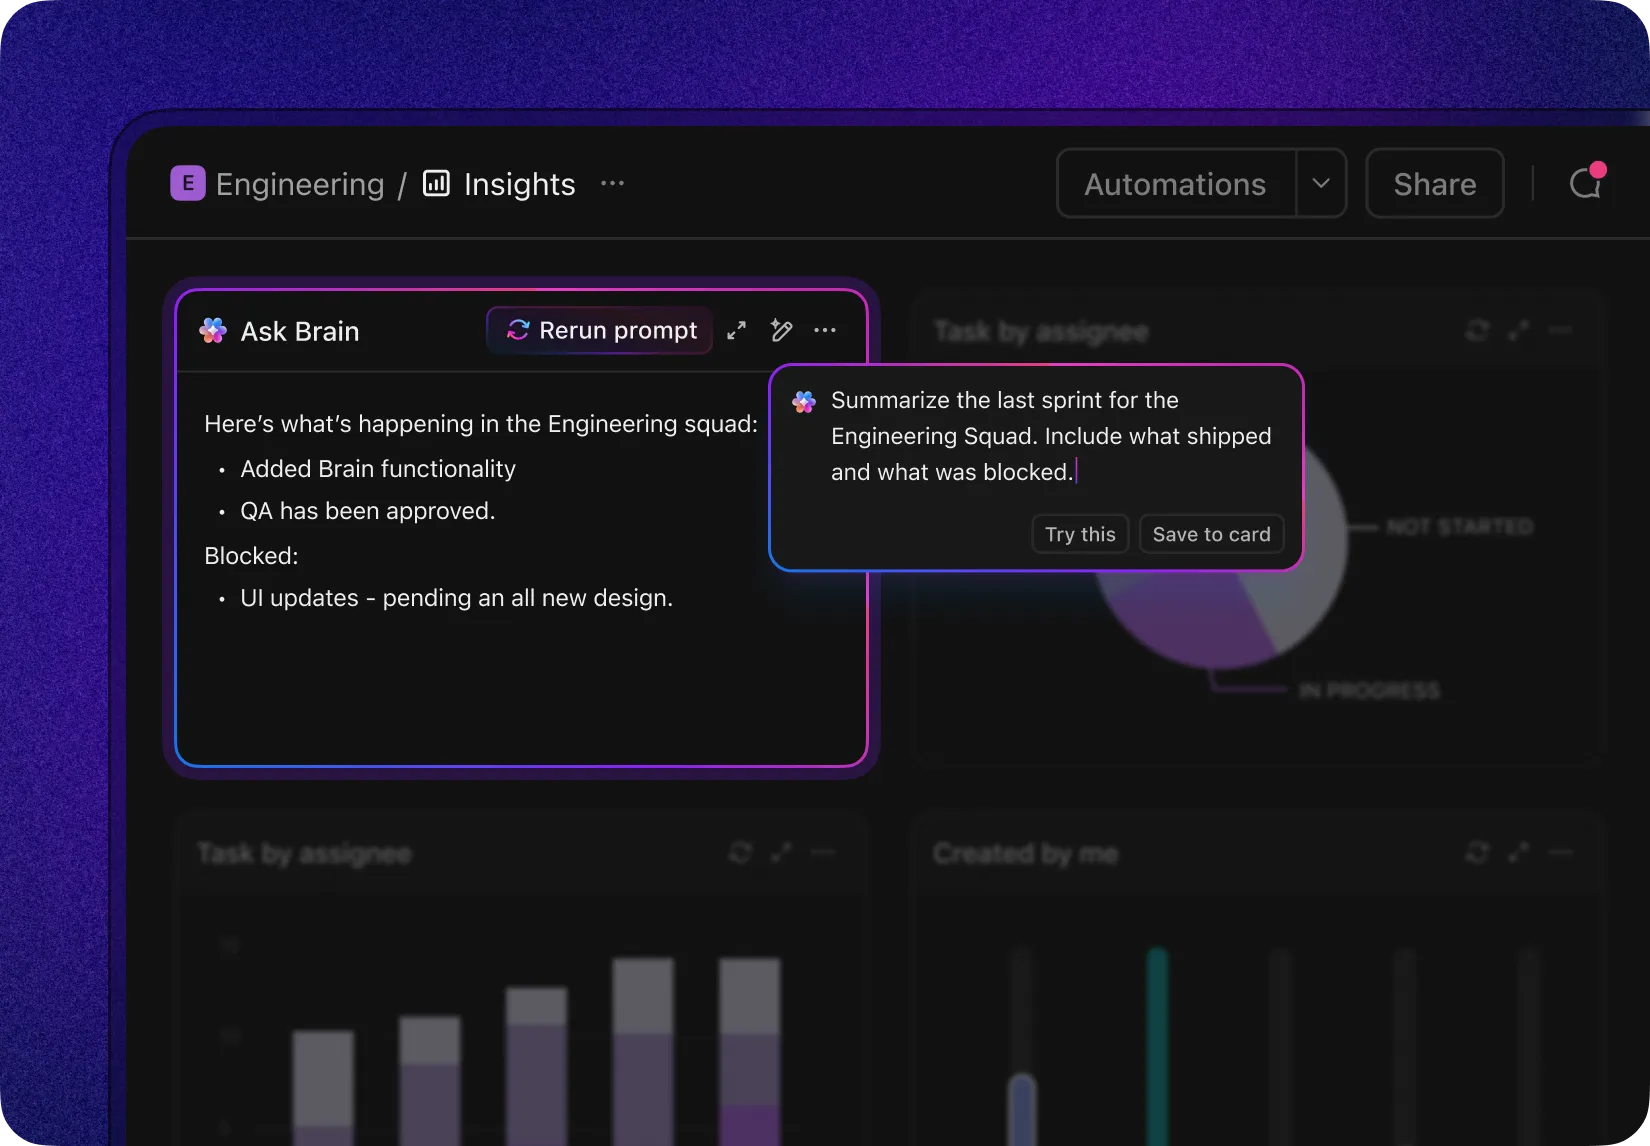
Интелигентен AI асистент, вграден във вашето работно пространство, може да промени това. Запознайте се с ClickUp Brain. Той предоставя незабавни анализи и отговори, като извежда на преден план подходящите документи, разговори и подробности за задачите за секунди — така че можете да спрете да търсите и да започнете да работите.
💫 Реални резултати: Екипи като QubicaAMF спестиха над 5 часа седмично благодарение на ClickUp — това са над 250 часа годишно на човек — като премахнаха остарелите процеси за управление на знанията. Представете си какво би могъл да създаде вашият екип с една допълнителна седмица продуктивност на всяко тримесечие!
Водещи индикатори, че времето за отстраняване на грешките ще се удължи
❗️Увеличаващо се „време за потвърждаване“ и голям брой тикети без отговорник за повече от 12 часа
❗️Увеличаващи се интервали на „Време за преглед/CI“ и чести нестабилности при тестовете
❗️Висок процент на дублиращи се сигнали при приемането им и несъгласувани етикети за сериозност между екипите
❗️Няколко грешки са в състоянието „Блокирани“ без посочена външна зависимост
❗️Процентът на повторно отваряне на заявки се увеличава (поправките не могат да бъдат възпроизведени или дефинициите за „завършено“ са неясни)
Различните организации възприемат тези фактори по различен начин. Ръководителите ги възприемат като пропуснати цикли на обучение и закъснения спрямо моментите на генериране на приходи; операторите ги възприемат като шум при сортирането и неясна отговорност.
Оптимизирането на приемането, потока и зависимостите е начинът, по който можете да понижите цялата крива – медианата и P90.
Искате ли да научите повече за това как да пишете по-добри доклади за грешки? Започнете оттук. 👇🏼
📖 Прочетете още: Жизненият цикъл на тестването на софтуер (STLC): Общ преглед и фази
Секторни референтни стойности за времето за отстраняване на бъгове
Сравнителните показатели за отстраняване на грешки варират в зависимост от толерантността към риска, модела на пускане на версии и скоростта, с която можете да внедрявате промени.
Тук можете да използвате медиани (P50), за да разберете типичния си работен поток, и P90, за да определите обещания и SLA – според сериозността и източника (клиент, QA, мониторинг).
Нека разгледаме по-подробно какво означава това:
| 🔑 Термин | 📝 Описание | 💡 Защо е важно |
|---|---|---|
| P50 (медиана) | Средната стойност – 50% от поправките на грешките се извършват по-бързо от това, а 50% – по-бавно | 👉 Отразява типичното или най-често срещаното време за отстраняване на грешки. Подходящо за разбиране на нормалната производителност |
| P90 (90-ти перцентил) | 90% от грешките се отстраняват в рамките на това време. Само 10% отнемат повече време | 👉 Представлява границата за най-лошия (но все пак реалистичен) случай. Полезно за определяне на външни обещания |
| SLA (споразумения за ниво на обслужване) | Ангажиментите, които поемате – вътрешно или пред клиентите – относно това колко бързо ще бъдат разрешени проблемите | 👉 Пример: „В 90% от случаите разрешаваме грешките от категория P1 в рамките на 48 часа.“ Това спомага за изграждането на доверие и отговорност. |
| По степен на сериозност и източник | Сегментирайте показателите си по две ключови измерения: • Тежест (например P0, P1, P2)• Източник (например клиент, QA, мониторинг) | 👉 Позволява по-точно проследяване и определяне на приоритетите, така че критичните бъгове да получат внимание по-бързо |
По-долу са посочени ориентировъчни диапазони, базирани на отраслите, към които често се насочват опитни екипи; разглеждайте ги като отправни точки, след което ги адаптирайте към вашия контекст.
SaaS
Системата работи непрекъснато и е съвместима с CI/CD, така че корекциите са често явление. При критичните проблеми (P0/P1) често се стремим към медиана под един работен ден, като P90 е в рамките на 24–48 часа. Некритичните проблеми (P2+) обикновено се разрешават за медиана от 3–7 дни, като P90 е в рамките на 10–14 дни. Екипите с надеждни флагове за функции и автоматизирани тестове обикновено постигат по-бързи резултати.
Платформи за електронна търговия
Тъй като потоците на конверсиите и количките са от решаващо значение за приходите, изискванията са по-високи. Проблемите от категории P0/P1 обикновено се смекчават в рамките на няколко часа (възстановяване на предишна версия, маркиране или конфигуриране) и се разрешават напълно в същия ден; P90 до края на деня или за по-малко от 12 часа е обичайно през пиковите сезони. Проблемите от категория P2+ често се разрешават за 2–5 дни, като P90 е в рамките на 10 дни.
Софтуер за големи предприятия
По-задълбочената валидация и прозорците за промени от страна на клиентите забавят темпото. За P0/P1 екипите се стремят да намерят временно решение в рамките на 4–24 часа и окончателно решение в рамките на 1–3 работни дни; P90 – в рамките на 5 работни дни. Проблемите от категория P2+ често се групират в серии от версии, като средната продължителност е 2–4 седмици в зависимост от графиците за внедряване при клиентите.
Игри и мобилни приложения
Бекенд системите на услугите в реално време се държат като SaaS (активиране и отмяна на промени в рамките на минути до часове; P90 – в същия ден). Актуализациите на клиентската страна се ограничават от прегледа на магазина: за P0/P1 често се използват незабавно механизми от страна на сървъра и се пуска клиентски пач в рамките на 1–3 дни; P90 – в рамките на една седмица при ускорен преглед. Поправките за P2+ обикновено се планират за следващия спринт или пускане на ново съдържание.
Банково дело/Финтех
Контролните точки за риск и съответствие налагат модела „бързо отстраняване, внимателно внедряване на промени“. Грешките от категории P0/P1 се отстраняват бързо (маркиране, връщане към предишна версия, пренасочване на трафика в рамките на минути до часове) и се поправят напълно в рамките на 1–3 дни; P90 – в рамките на една седмица, като се отчита контролът върху промените. Грешките от категория P2+ често отнемат 2–6 седмици, за да преминат проверки за сигурност, одит и преглед от Комитета за одобрение на промени (CAB).
Ако вашите показатели са извън тези граници, проверете качеството на приемането, маршрутизацията/отговорността, прегледа на кода и производителността на контрола на качеството, както и одобренията на зависимостите, преди да приемете, че „скоростта на разработката“ е основният проблем.
🌼 Знаете ли, че: Според проучване на Stack Overflow от 2024 г. разработчиците все по-често използват изкуствения интелект като свой надежден помощник в процеса на програмиране. Цели 82% са използвали изкуствен интелект, за да пишат код – това е истински творчески сътрудник! Когато са се затруднявали или са търсили решения, 67,5% са разчитали на изкуствения интелект, за да търсят отговори, а повече от половината (56,7%) са разчитали на него за отстраняване на грешки и получаване на помощ.
За някои инструментите с изкуствен интелект се оказаха полезни и за документиране на проекти (40,1%), а дори и за генериране на синтетични данни или съдържание (34,8%). Любопитни ли сте за нова кодова база? Почти една трета (30,9%) използват изкуствен интелект, за да се ориентират по-бързо. Тестването на код все още е ръчна и монотонна работа за мнозина, но 27,2% са възприели изкуствения интелект и в тази област. В други области като преглед на код, планиране на проекти и прогнозна аналитика се наблюдава по-ниско внедряване на изкуствения интелект, но е ясно, че той постепенно се вписва във всеки етап от разработката на софтуер.
📖 Прочетете още: Как да използвате изкуствения интелект за осигуряване на качеството
Как да съкратите времето за отстраняване на грешки
Бързината при отстраняването на бъгове се свежда до премахването на пречките при всяко прехвърляне на отговорността – от приемането до пускането на продукта.
Най-големите ползи се постигат, като се оптимизират първите 30 минути (ясно записване на проблема, определяне на правилния отговорник, определяне на правилния приоритет), а след това се съкратят следващите етапи (възпроизвеждане, преглед, проверка).
Ето девет стратегии, които работят заедно като система. Изкуственият интелект ускорява всяка стъпка, а работният процес е организиран на едно място, така че ръководителите получават предвидимост, а специалистите – плавен работен поток.
1. Централизирайте приемането на сигналите и записвайте контекста още при източника
Времето за отстраняване на грешки се удължава, когато възстановявате контекста от нишки в Slack, билети за поддръжка и електронни таблици. Насочвайте всеки доклад – за поддръжка, QA, мониторинг – към една-единствена опашка с помощта на структуриран шаблон, който събира информация за компонента, сериозността, средата, версията/билда на приложението, стъпките за възпроизвеждане, очакваните срещу действителните резултати, както и прикачените файлове (логове/HAR/екранни снимки).
Изкуственият интелект може автоматично да обобщава дълги доклади, да извлича стъпки за възпроизвеждане и подробности за средата от прикачените файлове, както и да маркира вероятни дубликати, така че сортирането да започне с последователен и обогатен запис.
Показатели, които трябва да следите: MTTA (потвърждение в рамките на минути, а не часове), процент на дублираните заявки, време за „Необходима информация“.
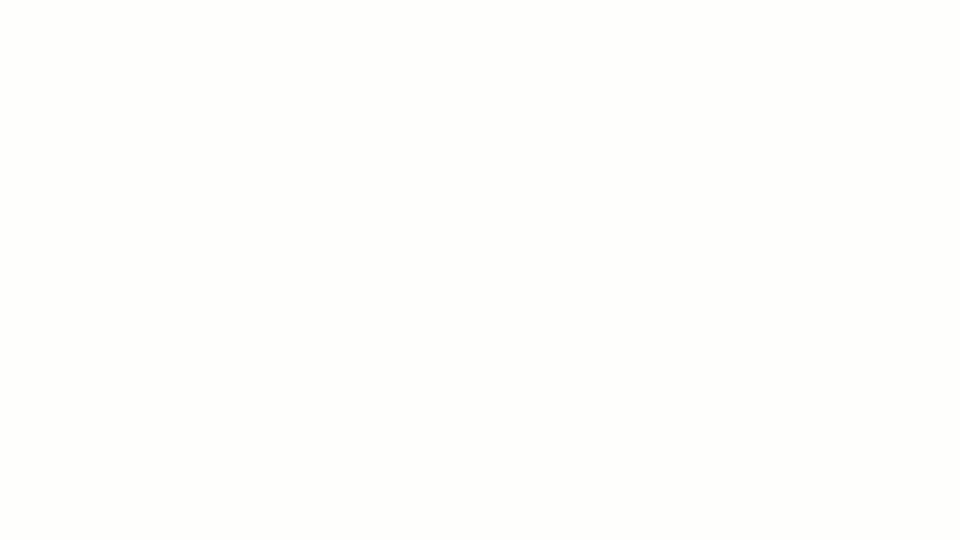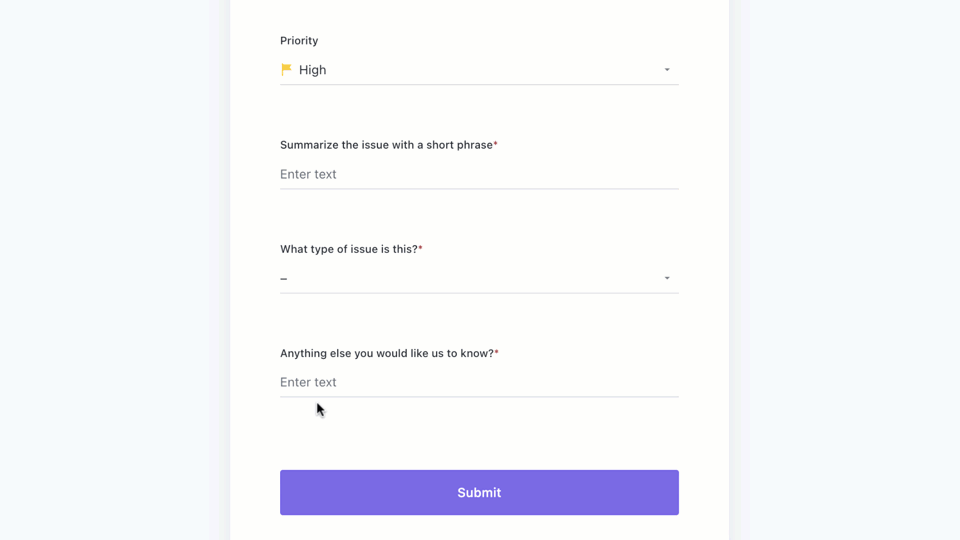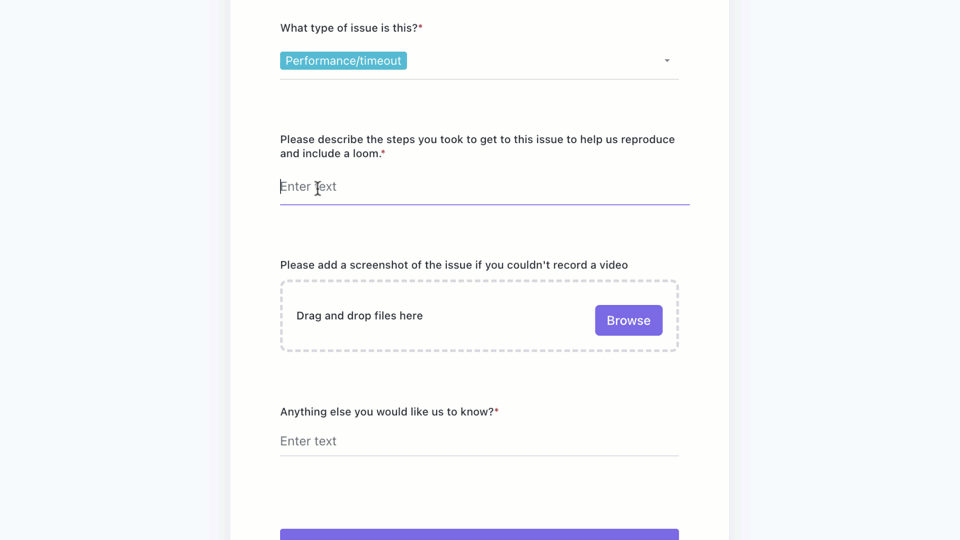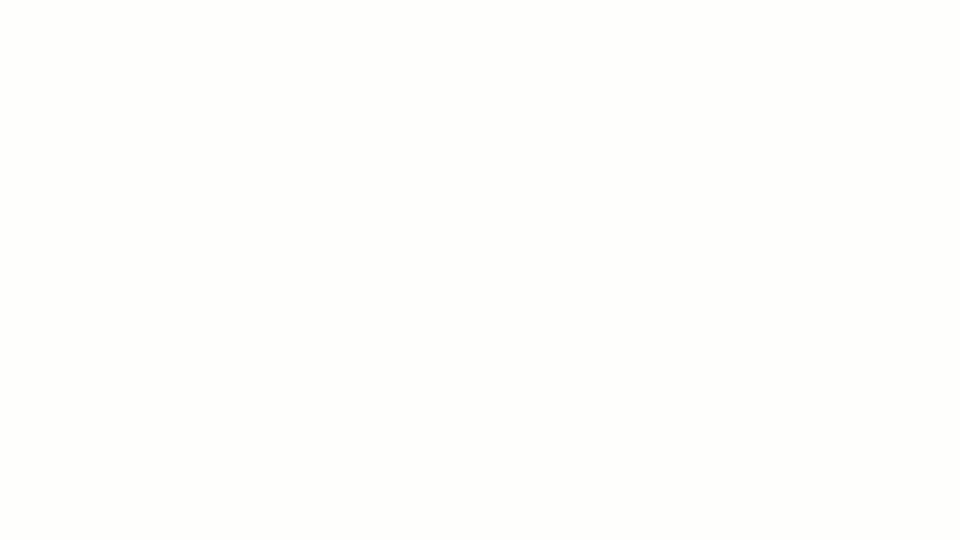
2. Триаж и насочване с помощта на изкуствен интелект за значително съкращаване на MTTA
Най-бързите решения са тези, които веднага попадат на правилното работно място.
Използвайте прости правила в комбинация с изкуствен интелект, за да класифицирате сериозността, да идентифицирате вероятните отговорни лица по компонент/кодова област и да извършвате автоматично разпределяне с SLA-таimer. Определете ясни категории за P0/P1 спрямо всичко останало и направете безспорно ясно „кой отговаря за това“.
Автоматизацията може да задава приоритет въз основа на полета, да насочва грешките към екип според компонента, да стартира таймер за SLA и да уведомява дежурния инженер; изкуственият интелект може да предложи степен на сериозност и отговорно лице въз основа на предишни модели. Когато сортирането отнема 2–5 минути, вместо да се превръща в 30-минутна дискусия, MTTA намалява, а MTTR следва същата тенденция.
Показатели, които трябва да следите: MTTA, качество на първия отговор (изисква ли първият коментар правилната информация?), брой прехвърляния на грешка.
Ето как изглежда това на практика:
3. Определяйте приоритетите според въздействието върху бизнеса чрез ясно дефинирани нива на SLA
Принципът „По-силен глас, по-голям успех“ прави опашките непредсказуеми и подкопава доверието на ръководството, което следи показателите за удовлетвореност на клиентите (CSAT/NPS) и подновяването на договорите.
Заменете това с оценка, която съчетава сериозността, честотата, засегнатия ARR, критичността на функцията и близостта до подновявания/стартирания — и я подкрепете с нива на SLA (например, P0: смекчаване в рамките на 1–2 часа, отстраняване в рамките на един ден; P1: в същия ден; P2: в рамките на един спринт).
Поддържайте видима P0/P1 лента с ограничения за работа в процес (WIP), за да не остава нищо без внимание.
Показатели, които трябва да следите: P50/P90 за отстраняване на проблеми по нива, процент на нарушения на SLA, корелация с CSAT/NPS.
💡Съвет от професионалистите: Полетата „Приоритети на задачите“, „Потребителски полета“ и „Зависимости“ в ClickUp ви позволяват да изчислите оценка на въздействието и да свържете бъговете с акаунти, обратна връзка или елементи от пътната карта; освен това „Целите“ в ClickUp ви помагат да обвържете спазването на SLA с целите на ниво компания, което отговаря пряко на загрижеността на ръководството относно съгласуваността.
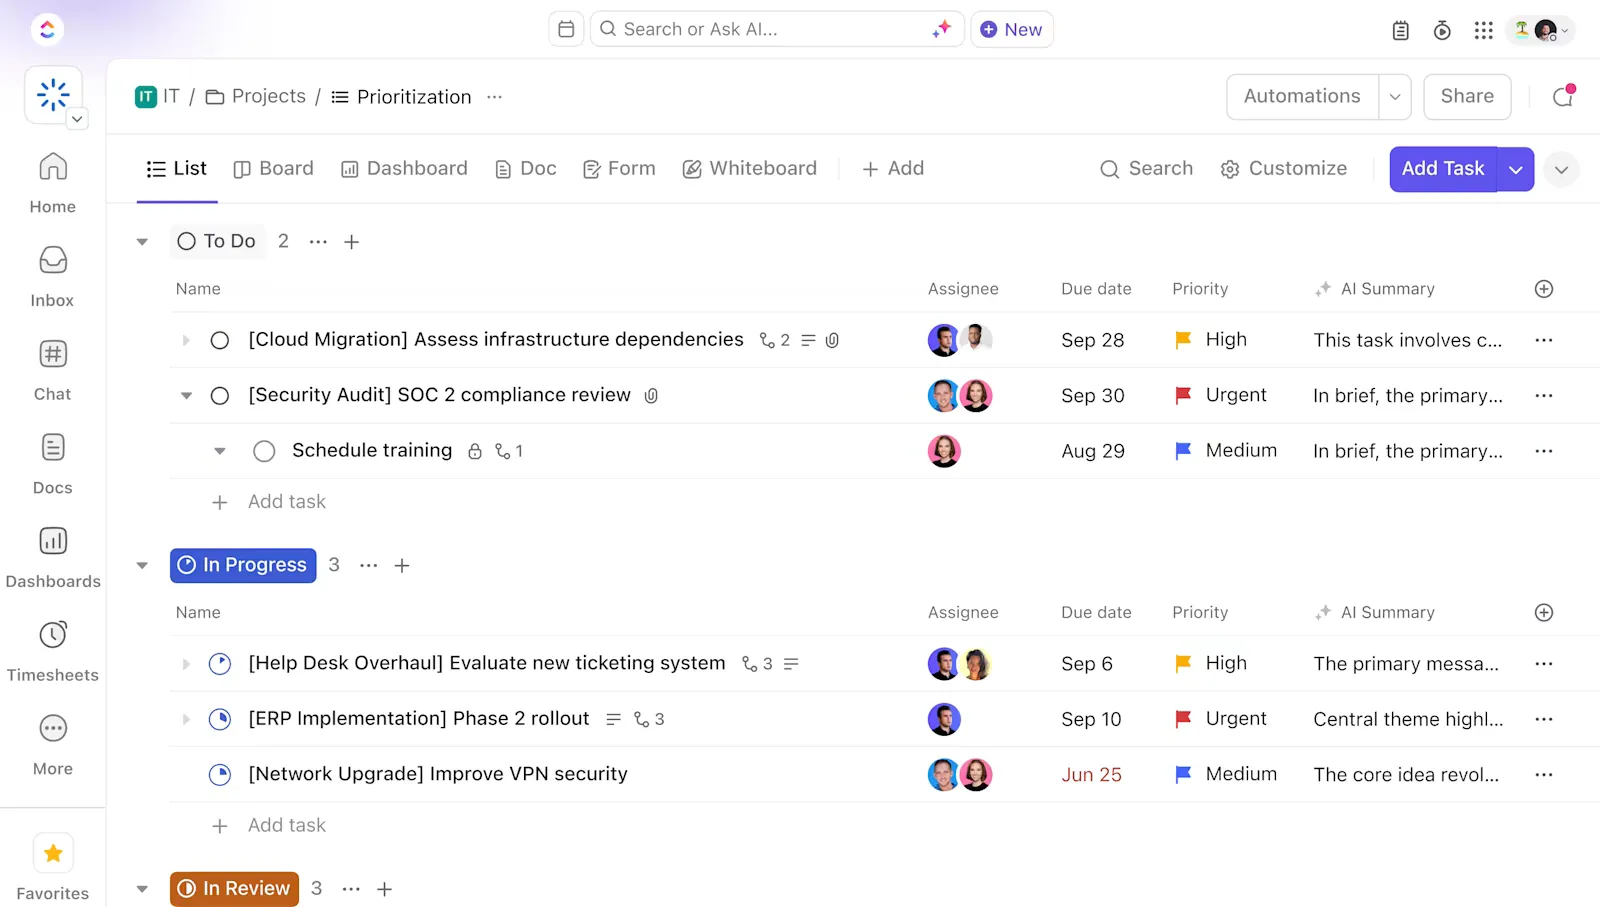
4. Превърнете възпроизвеждането и диагностицирането в дейност, която се извършва на един етап
Всяко допълнително запитване от типа „Можете ли да изпратите логовете?“ удължава времето за отстраняване на грешките.
Стандартизирайте какво означава „добро“: задължителни полета за build/commit, среда, стъпки за възпроизвеждане, очаквани срещу действителни резултати, както и прикачени файлове за логове, краш дъмпове и HAR файлове. Внедрете телеметрия между клиент и сървър, така че ID-тата на сривовете и заявките да могат да се свързват с трасиранията.
Въведете Sentry (или подобен инструмент) за проследяване на стека и свържете този проблем директно с грешката. Изкуственият интелект може да чете логовете и следите, за да предложи вероятна област на повреда и да генерира минимален пример за възпроизвеждане, превръщайки един час визуална проверка в няколко минути целенасочена работа.
Съхранявайте наръчници за типични видове грешки, за да не се налага на инженерите да започват от нулата.
Показатели, които трябва да следите: Време, прекарано в „Очакване на информация“, процент на възпроизвеждане при първия опит, процент на повторно отваряне, свързан с липса на възпроизвеждане.
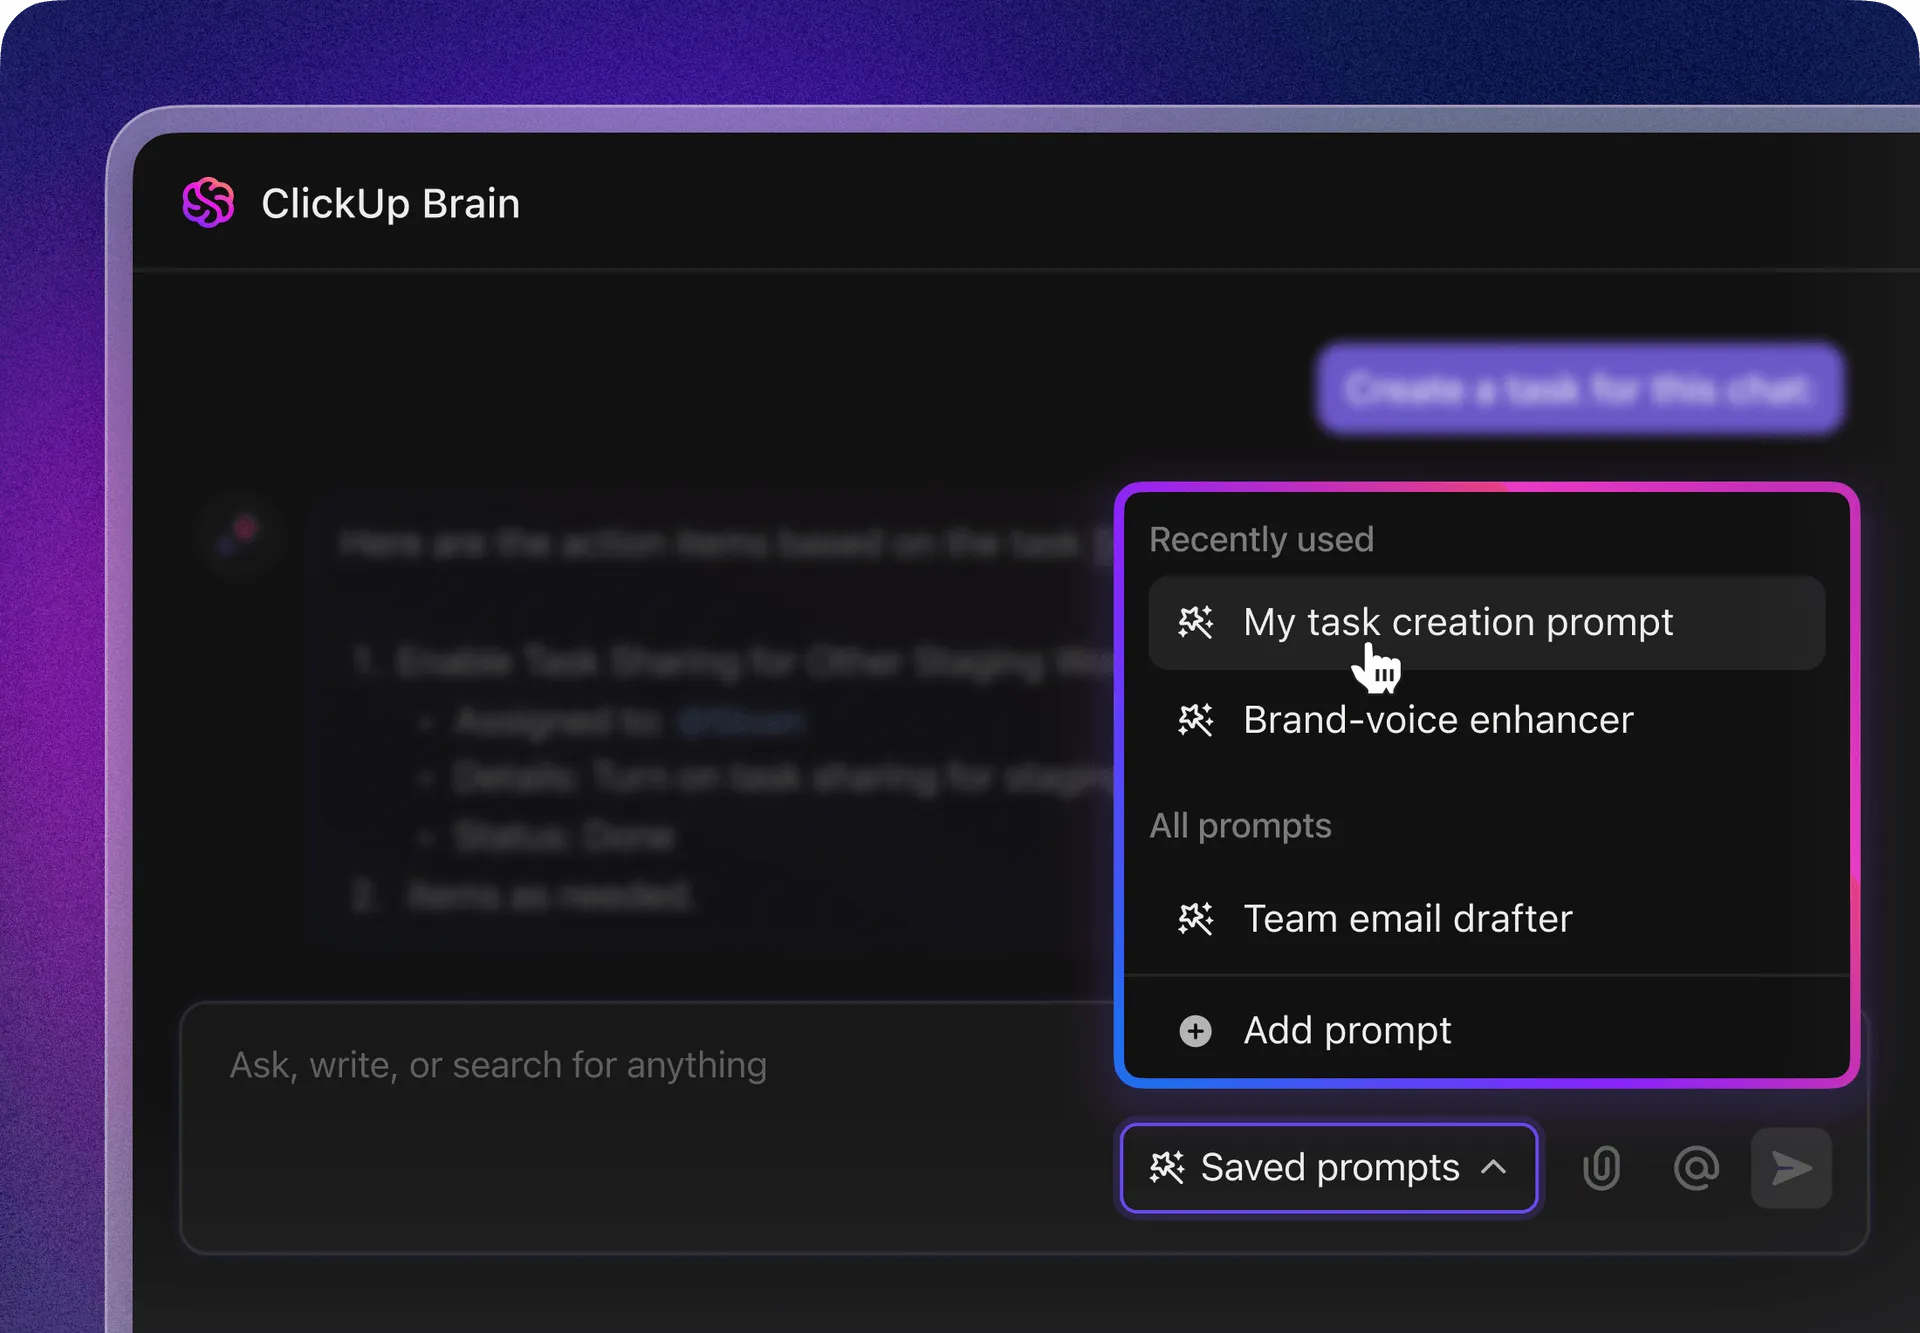
📖 Научете повече: Как да използвате изкуствен интелект в разработката на софтуер (примери за употреба и инструменти)
5. Съкратете цикъла на преглед на кода и тестване
Големите PR-и забавят процеса. Стремете се към прецизни корекции, разработка на базата на trunk и флагове за функции, за да може поправките да бъдат пускани безопасно. Предварително определяйте рецензенти според собствеността върху кода, за да избегнете загуба на време, и използвайте контролни списъци (актуализирани тестове, добавена телеметрия, флаг зад kill switch), за да се гарантира качеството.
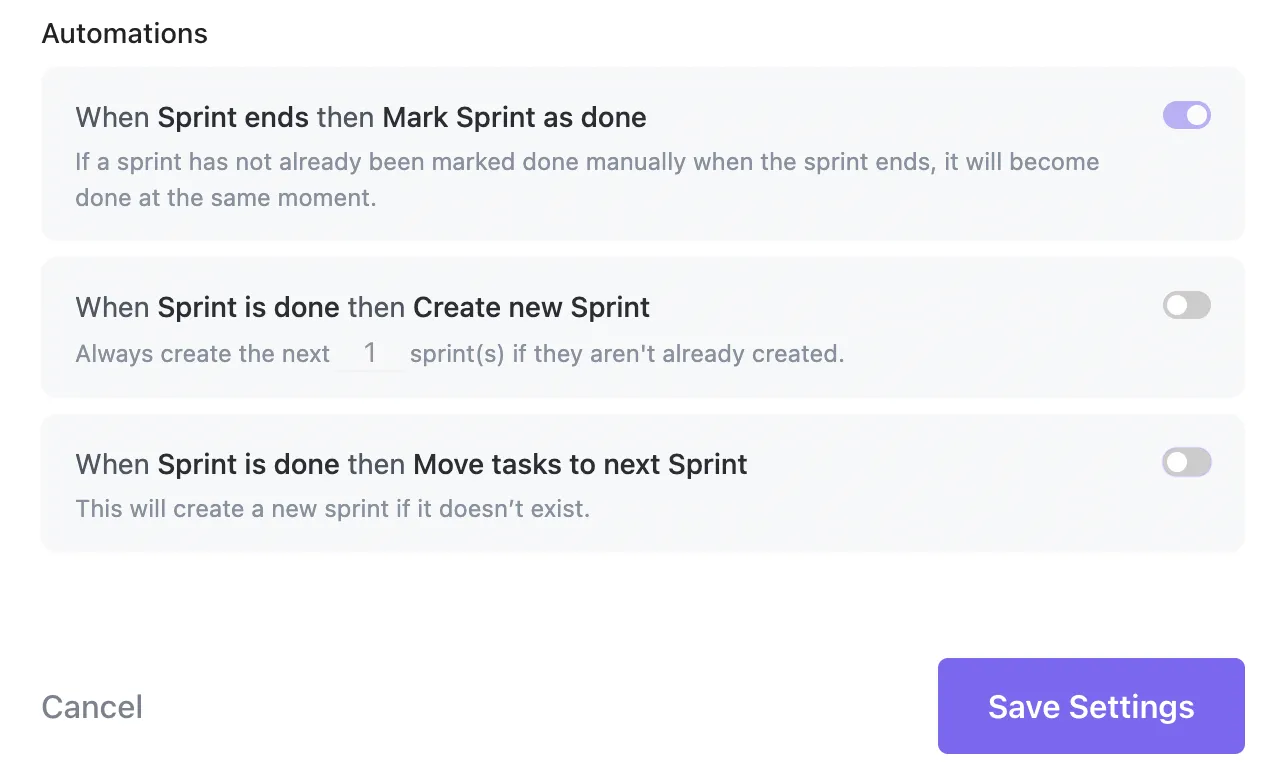
Автоматизацията трябва да премества грешката в състоянието „В преглед“ при отваряне на PR и в състоянието „Решена“ при сливане; изкуственият интелект може да предложи единични тестове или да подчертае рискови разлики, за да се фокусира прегледът.
Показатели, които трябва да следите: Време в състоянието „В процес на преглед“, процент на неуспешни промени при PR-и за отстраняване на бъгове и латентност на прегледа P90.
Можете да използвате интеграциите с GitHub/GitLab в ClickUp, за да синхронизирате статуса на разрешаване; автоматизациите могат да наложат „дефиницията за завършено“.
📖 Прочетете още: Как да използвате изкуствен интелект за автоматизиране на задачи
6. Паралелизирайте проверката и постигнете истинска равностойност на средата за контрол на качеството
Проверката не трябва да започва дни по-късно или в среда, която никой от вашите клиенти не използва.
Поддържайте строги критерии за „готовност за QA“: корекции, задействани от сигнали, валидирани в среди, наподобяващи производствени, с начални данни, които съответстват на докладваните случаи.
Когато е възможно, създавайте временни среди от клона с бъгове, за да може екипът за QA да извърши незабавна валидация; след това изкуственият интелект може да генерира тестови случаи въз основа на описанието на бъга и предишни регресии.
Показатели, които да следите: Време в етапа „QA/верификация“, процент на връщане от QA към разработчиците, медианно време до приключване след сливане.
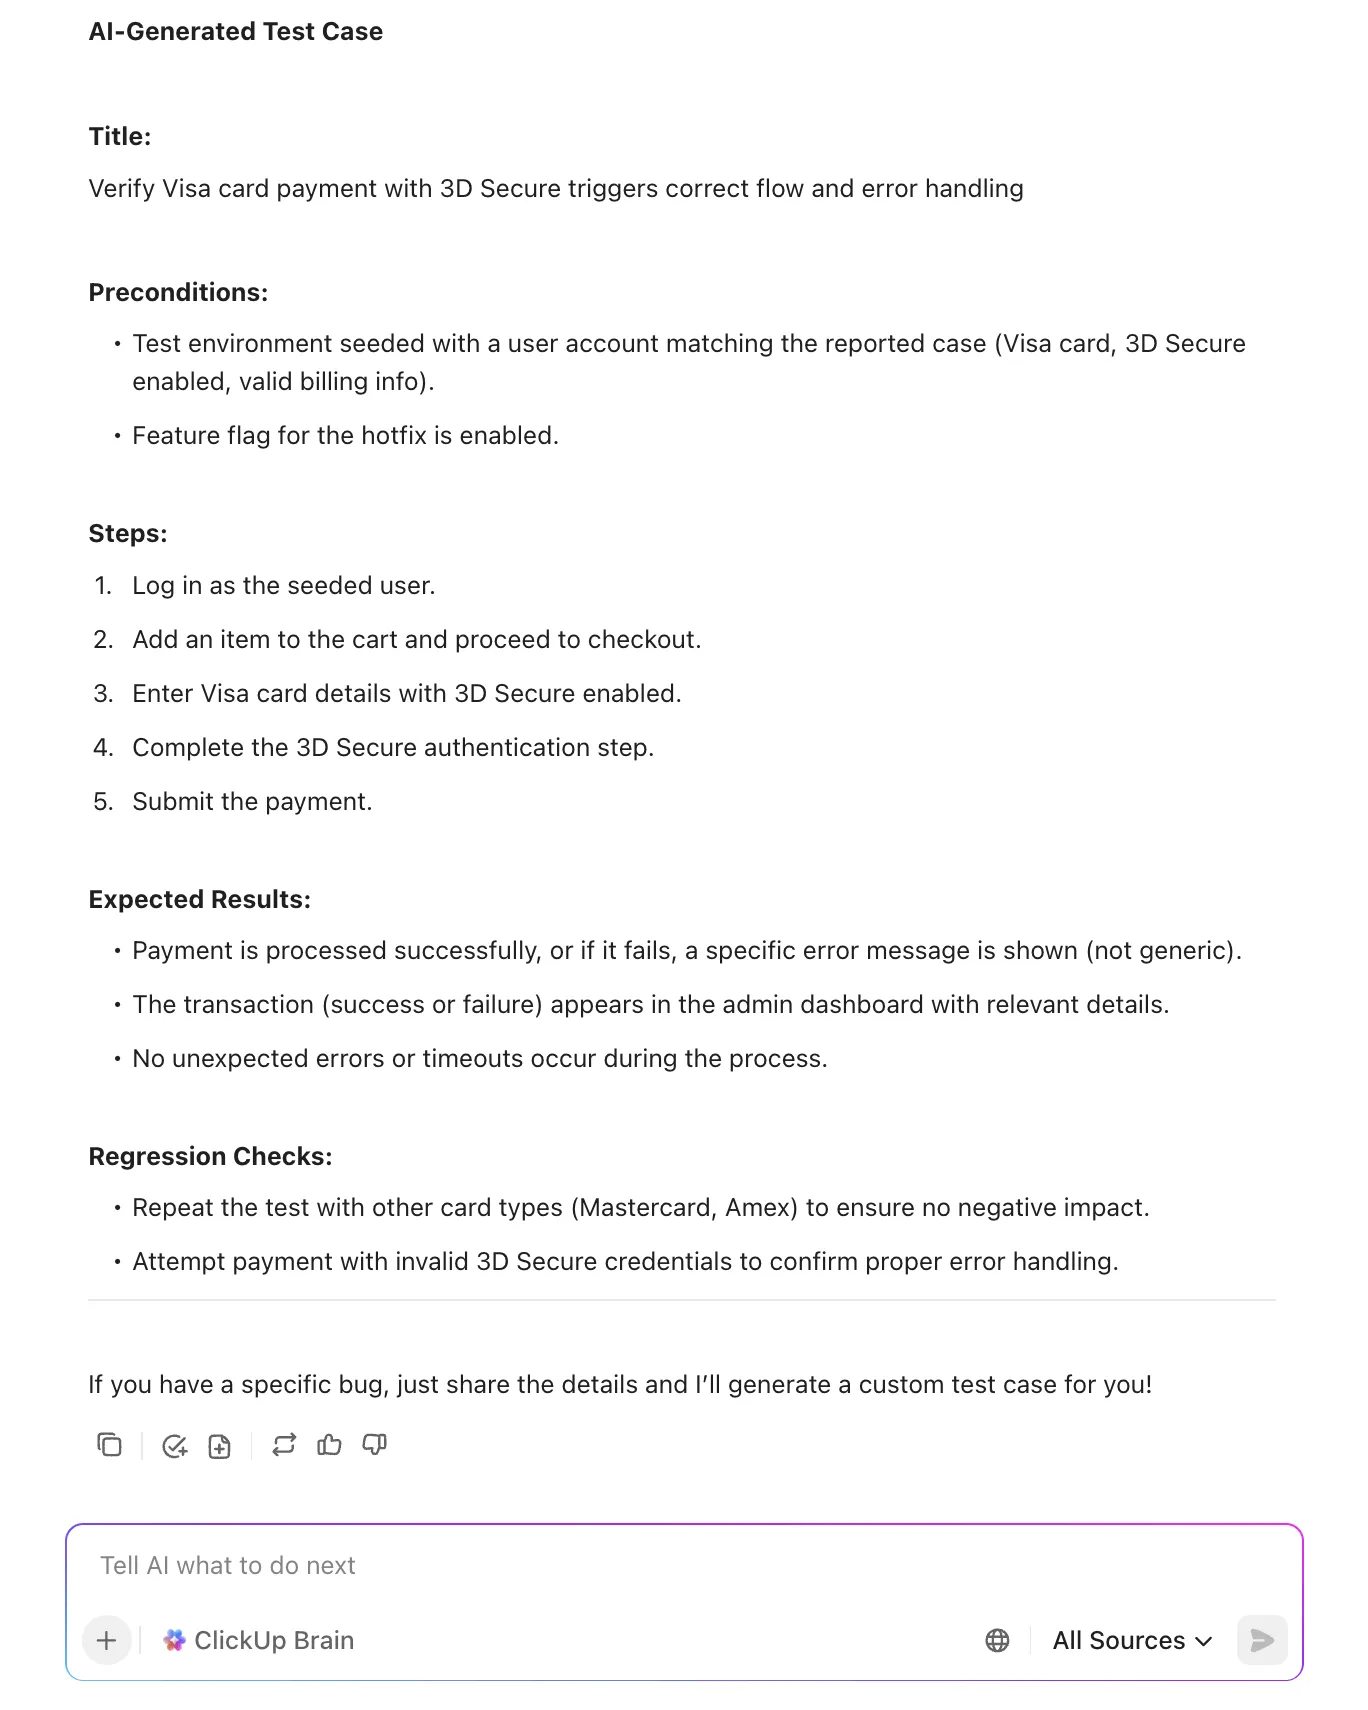
📖 Прочетете още: Как да напишете ефективни тестови случаи
7. Комуникирайте статуса ясно и кратко, за да намалите разходите за координация
Една добра актуализация предотвратява три запитвания за състоянието и едно ескалиране.
Третирайте актуализациите като продукт: кратки, конкретни и съобразени с аудиторията (поддръжка, ръководство, клиенти). Установете ритъм за P0/P1 (например, на всеки час, докато проблемът не бъде отстранен, след което на всеки четири часа) и поддържайте единен източник на информация.
Изкуственият интелект може да изготвя актуализации, безопасни за клиентите, и вътрешни обобщения въз основа на историята на задачите, включително актуален статус според степента на сериозност и екипа. За ръководители като вашия директор по продуктите, групирайте грешките по инициативи, за да могат те да видят дали критични проблеми с качеството застрашават обещанията за доставка.
Показатели, които трябва да следите: Време между актуализациите на статуса за P0/P1, удовлетвореност на заинтересованите страни (CSAT) по отношение на комуникациите.
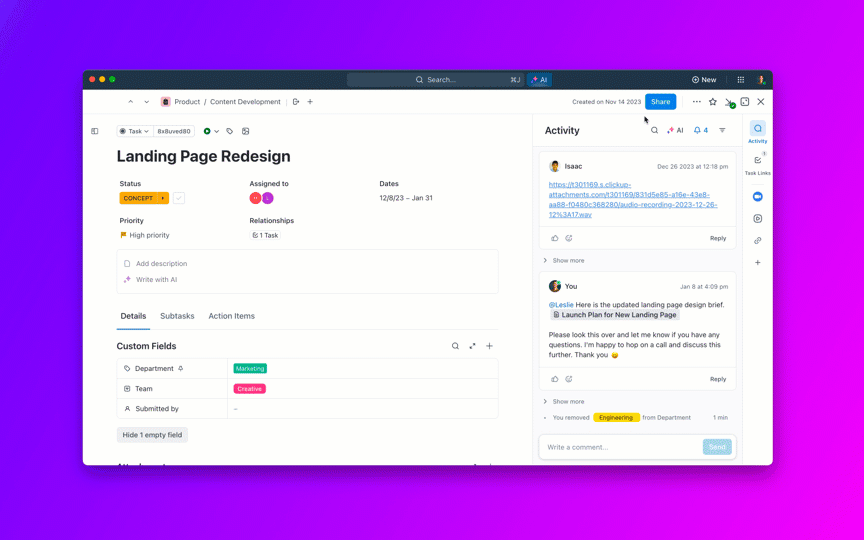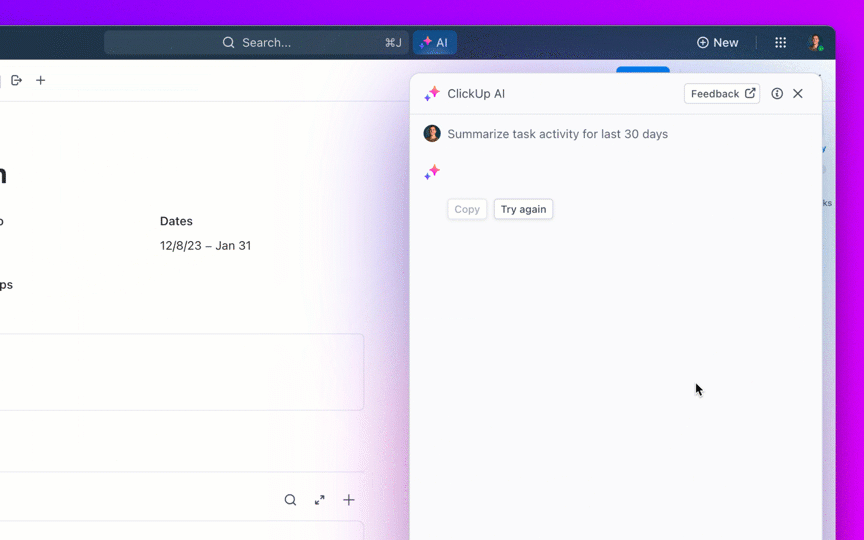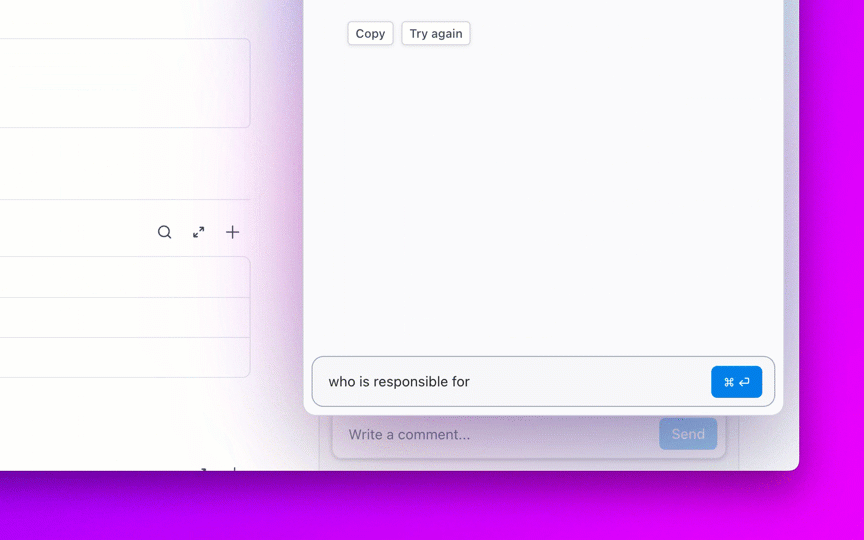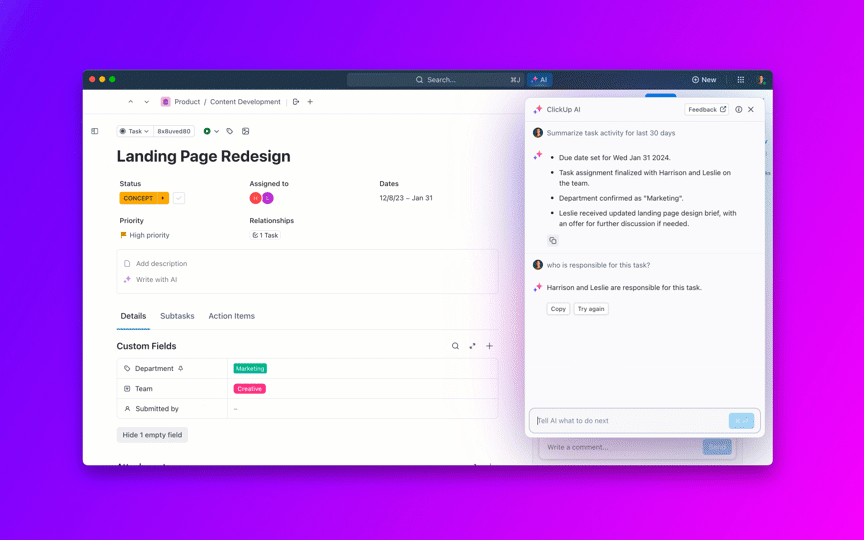
8. Контролирайте остаряването на нерешените задачи и предотвратявайте „вечно отворените“ задачи
Натрупаните задачи, които не се изпълняват, тихо затрудняват всеки спринт.
Задайте правила за стареене (например: P2 > 30 дни задейства преглед, P3 > 90 дни изисква обосновка) и планирайте седмична „сортировка по стареене“, за да обедините дублираните, да затворите остарелите доклади и да превърнете грешките с ниска стойност в елементи от списъка с задачи за продукта.
Използвайте изкуствен интелект, за да групирате натрупаните задачи по теми (например „изтичане на валидността на токена за удостоверяване“, „нестабилност при качването на изображения“), така че да можете да планирате тематични седмици за отстраняване на проблеми и да премахнете цяла категория дефекти наведнъж.
Показатели, които трябва да следите: Брой нерешени задачи по възрастови групи, процент на проблемите, затворени като дубликати/остарели, тематична скорост на изчерпване на задачите.
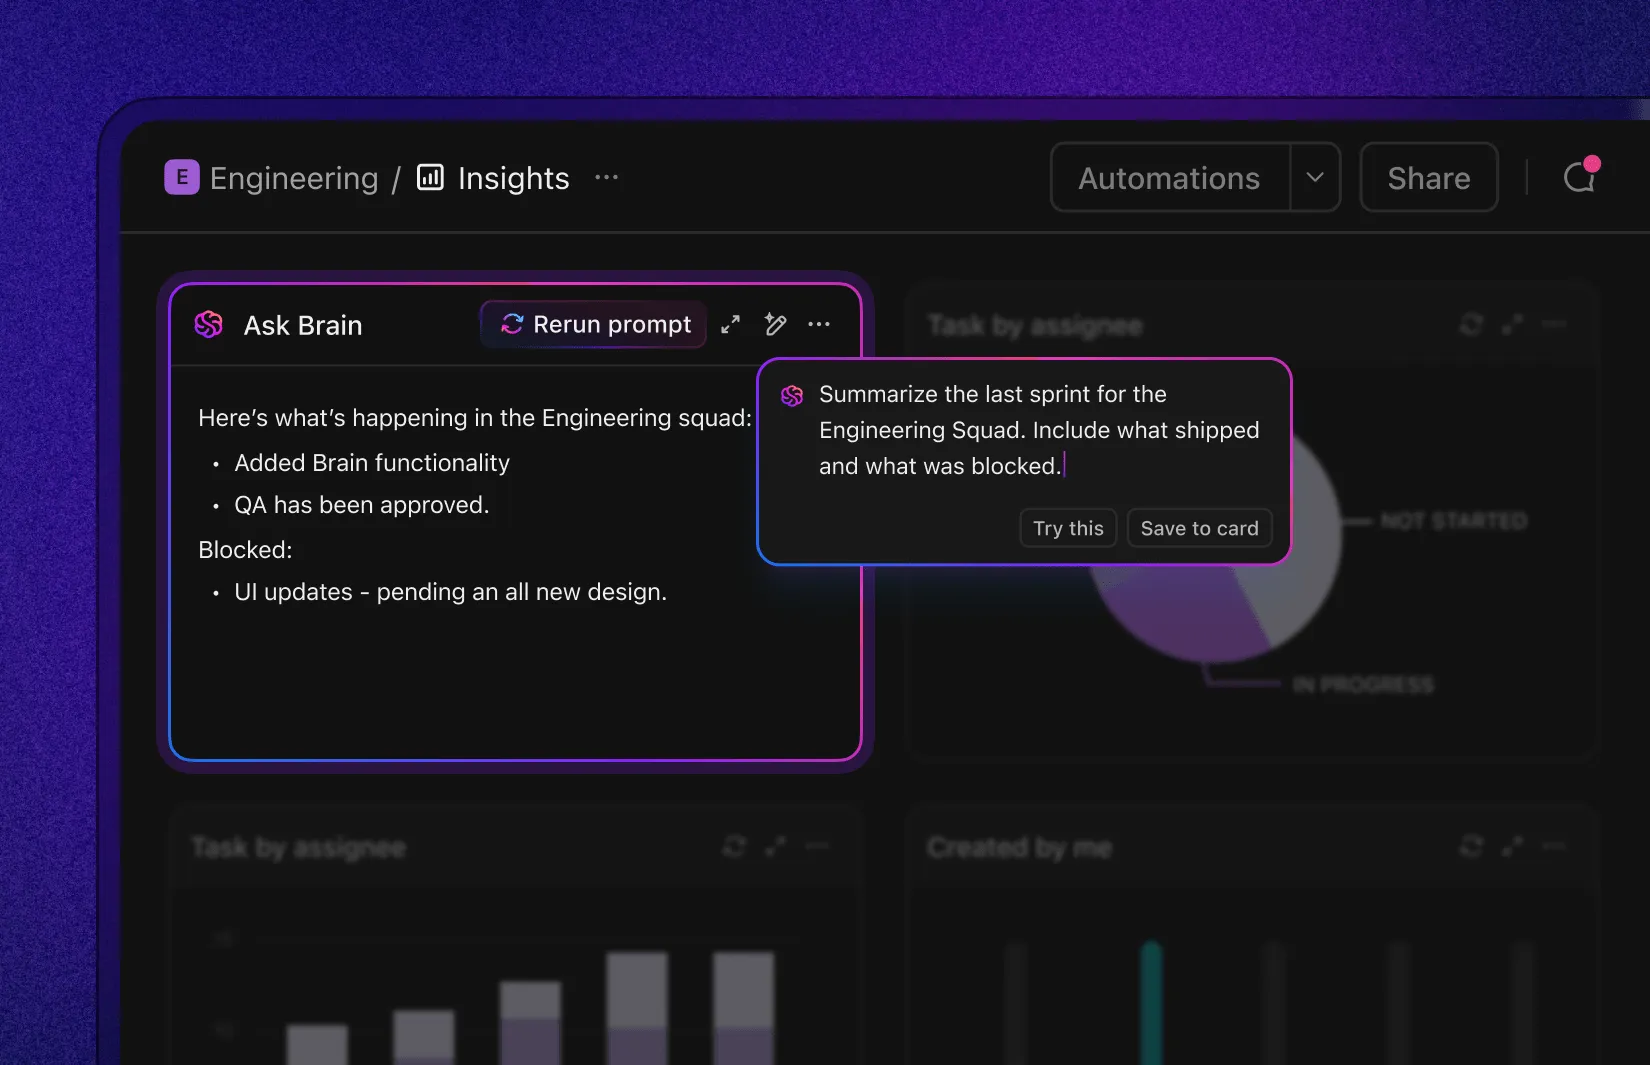
9. Завършете цикъла с установяване на основната причина и превенция
Ако един и същ тип дефекти продължава да се повтаря, подобренията ви в MTTR прикриват по-голям проблем.
Извършвайте бърз и безпристрастен анализ на основните причини при P0/P1 и често срещаните P2; маркирайте основните причини (пропуски в спецификациите, пропуски в тестовете, пропуски в инструментариума, нестабилност при интеграцията), свържете ги със засегнатите компоненти и инциденти и проследявайте последващите задачи (предпазни мерки, тестове, правила за проверка на кода) до тяхното завършване.
Изкуственият интелект може да изготвя обобщения на анализите за причините за грешките (RCA) и да предлага превантивни тестове или правила за проверка на кода въз основа на историята на промените. И така ще преминете от гасене на пожари към предотвратяване на повечето от тях.
Показатели, които трябва да следите: процент на повторно отваряне, процент на регресия, време между повторенията и процент на анализите на причините (RCA) с изпълнени превантивни мерки.
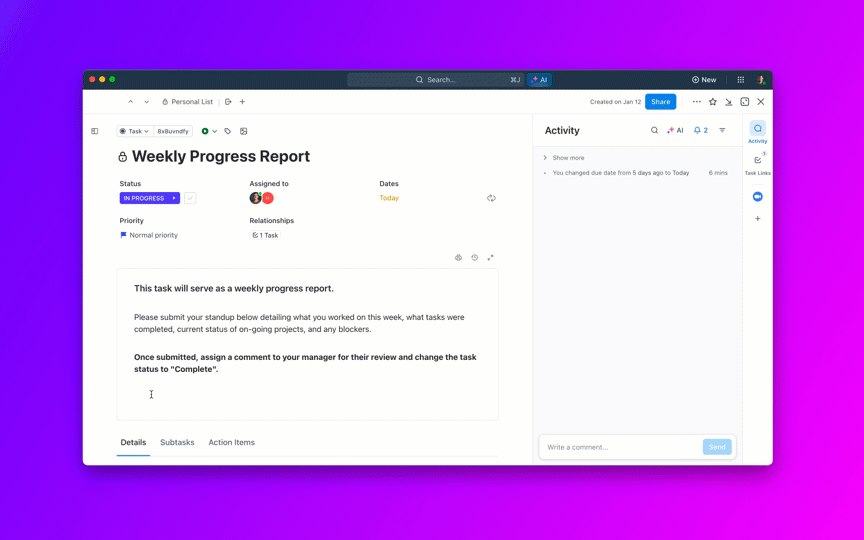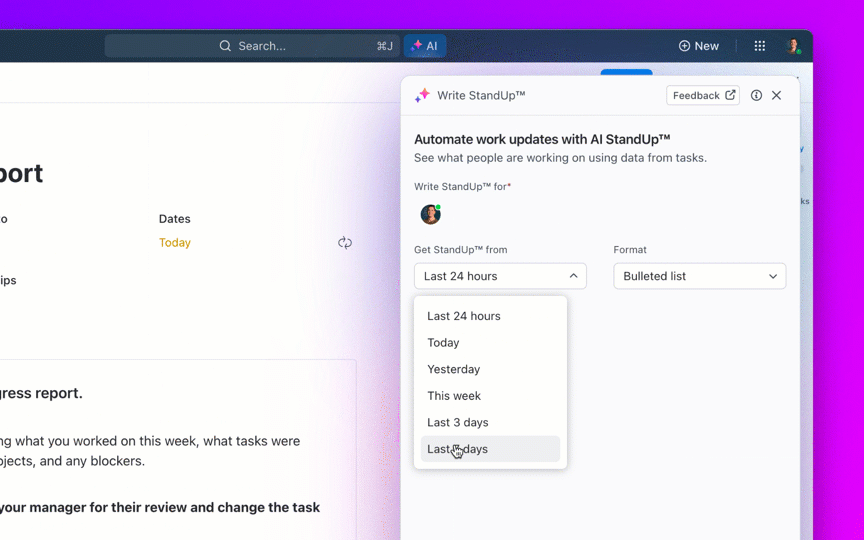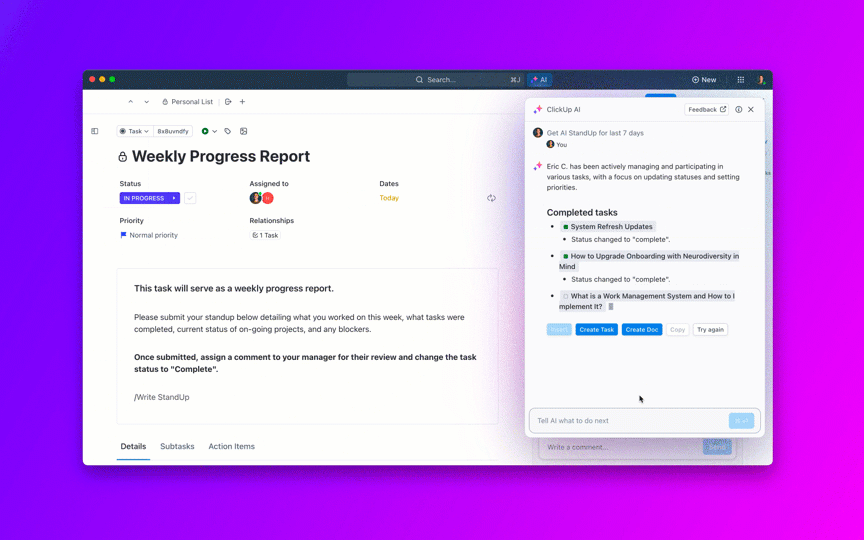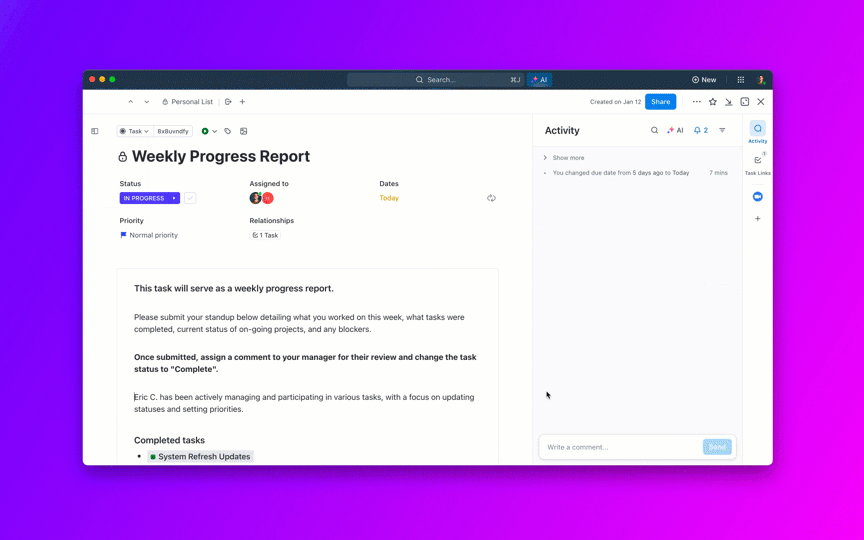
Взети заедно, тези промени съкращават целия процес: по-бързо потвърждаване, по-прецизна сортировка, по-интелигентно определяне на приоритетите, по-малко забавяния при прегледа и контрола на качеството, както и по-ясна комуникация. Ръководителите получават предвидимост, свързана с CSAT/NPS и приходите; специалистите получават по-спокойна опашка с по-малко превключване между задачи.
📖 Прочетете още: Как да извършите анализ на основните причини
Инструменти, базирани на изкуствен интелект, които помагат за съкращаване на времето за отстраняване на бъгове
Изкуственият интелект може да съкрати времето за отстраняване на грешки на всеки етап – приемане, сортиране, насочване, отстраняване и проверка.
Истинските ползи обаче се проявяват, когато инструментите разбират контекста и поддържат работата в движение без да се налага ръчно да ги направлявате.
Потърсете системи, които автоматично обогатяват отчетите (стъпки за възпроизвеждане, среда, дубликати), приоритизират по въздействие, насочват към подходящия отговорник, изготвят ясни актуализации и се интегрират плътно с вашия код, CI и наблюдаемост.
Най-добрите от тях поддържат и работни процеси, подобни на тези на операторите: ботове, които следят SLA, напомнят на рецензентите, ескалират заседналите задачи и обобщават резултатите за заинтересованите страни. Ето нашият списък с инструменти, базирани на изкуствен интелект, за по-ефективно отстраняване на бъгове:
1. ClickUp (Най-добър за контекстуален изкуствен интелект, автоматизации и агентни работни потоци)
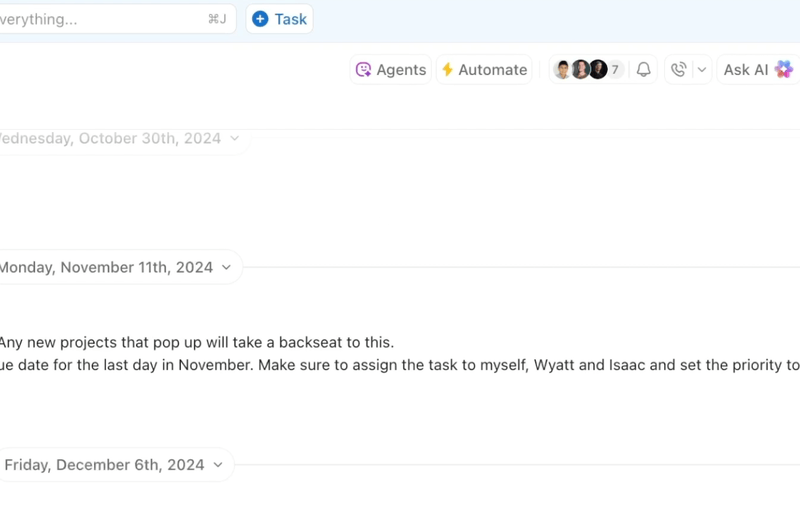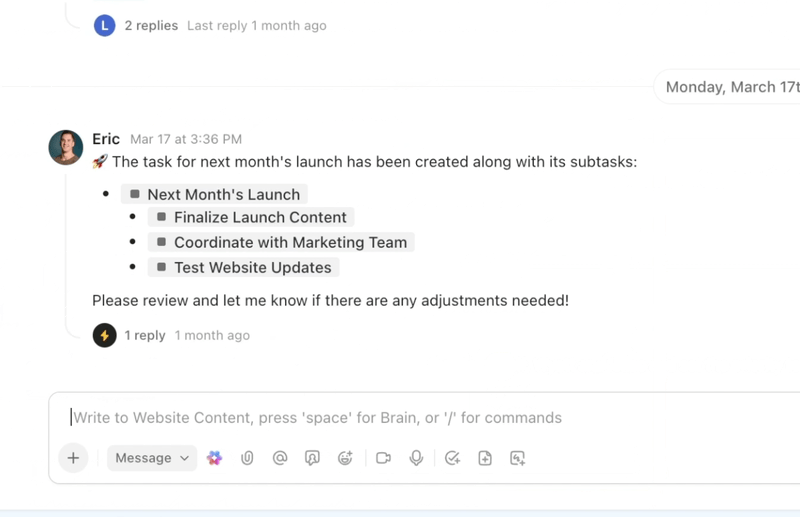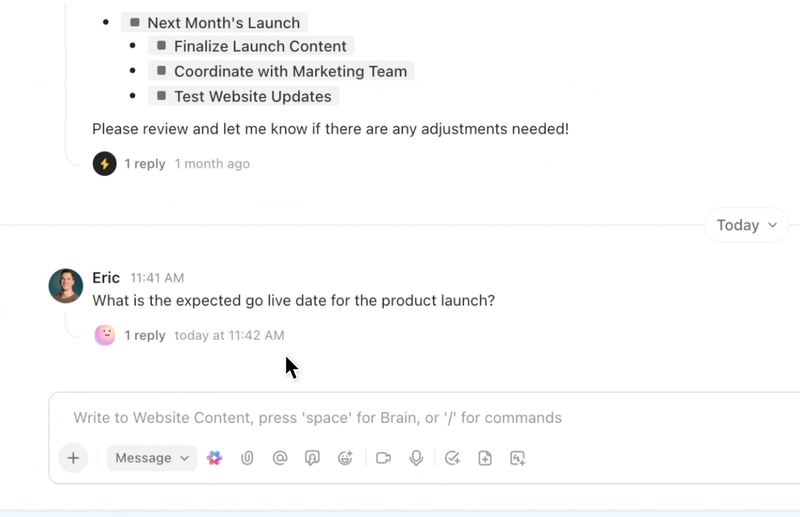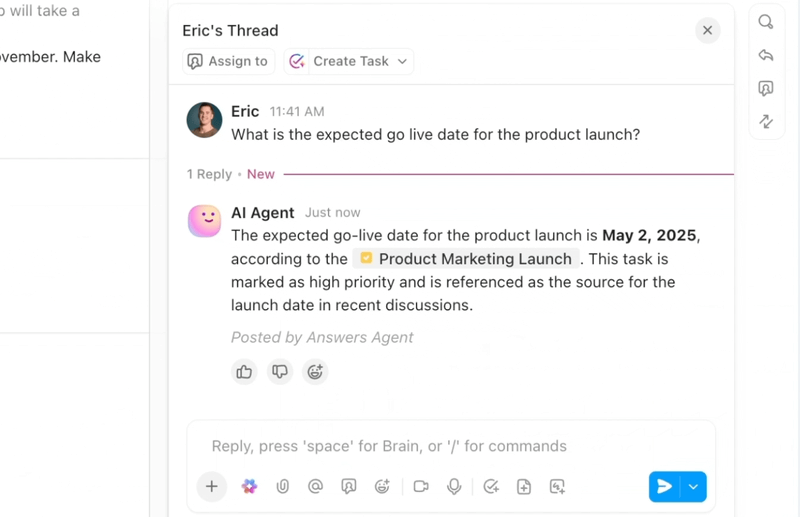
Ако искате оптимизиран и интелигентен работен процес за отстраняване на бъгове, ClickUp – приложението за всичко в работата – обединява изкуствен интелект, автоматизации и агентна помощ при работните процеси на едно място.
ClickUp Brain незабавно предоставя необходимия контекст – обобщава дългите нишки за грешки, извлича стъпките за възпроизвеждане и подробностите за средата от прикачените файлове, маркира вероятните дубликати и предлага следващи действия. Вместо да претърсват Slack, тикети и логове, екипите получават ясен и обогатен отчет, въз основа на който могат да действат незабавно.
Автоматизациите и агентите на Autopilot в ClickUp поддържат работата в ход, без да се налага постоянно ръчно управление. Грешките се пренасочват автоматично към подходящия екип, назначават се отговорни лица, определят се SLA и крайни срокове, статусите се актуализират с напредъка на работата, а заинтересованите страни получават навременни известия.
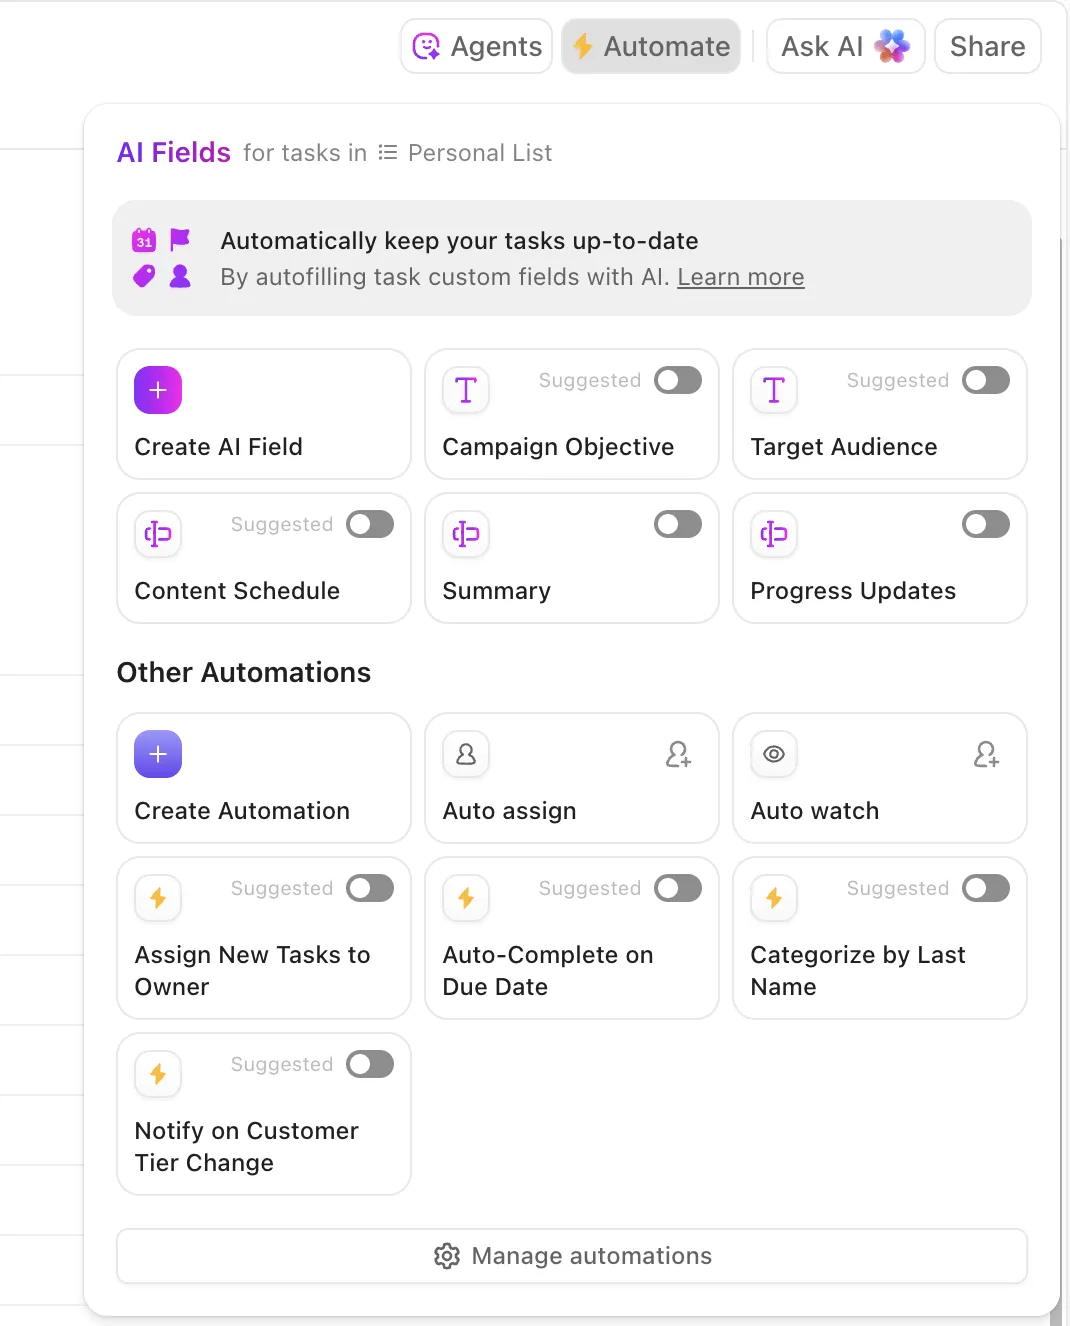
Тези агенти могат дори да сортират и категоризират проблемите, да групират сходни сигнали, да се позовават на предишни решения, за да предложат вероятни начини за действие, и да ескалират спешните случаи – така че MTTA и MTTR намаляват дори при пикове в обема.
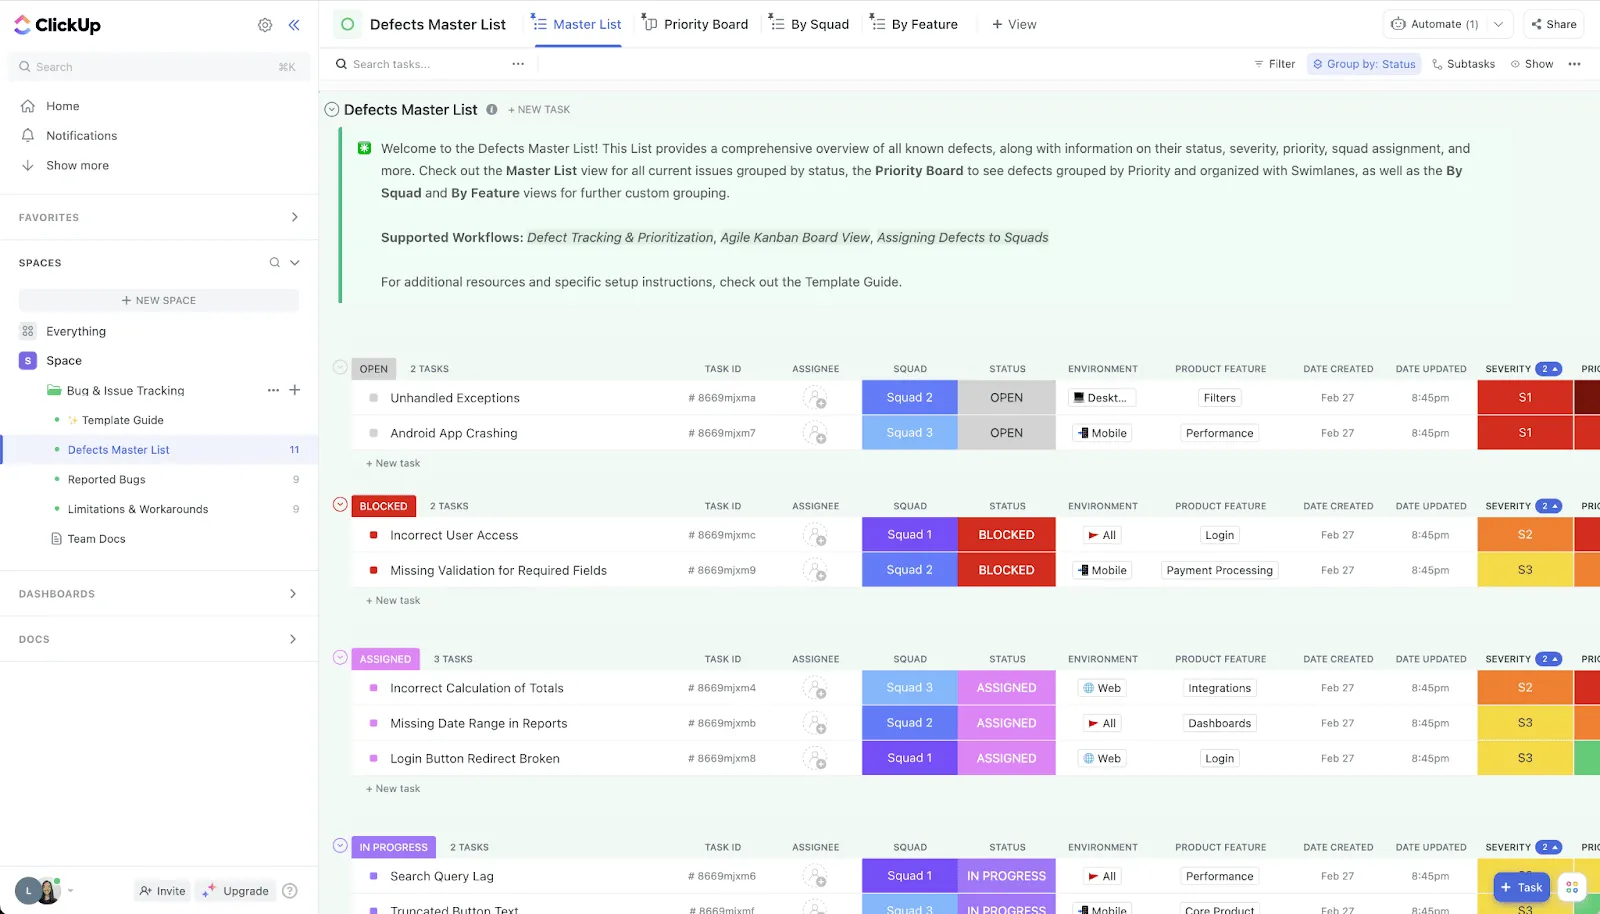
🛠️ Искате ли готов за употреба набор от инструменти? Шаблонът за проследяване на грешки и проблеми на ClickUp е мощно решение от ClickUp за софтуер, създадено да помогне на екипите по поддръжка, инженеринг и продукти да се справят с лекота със софтуерните грешки и проблеми. С персонализирани изгледи като „Списък“, „Табло“, „Работна натовареност“, „Формуляр“ и „Времева линия“ екипите могат да визуализират и управляват процеса си по проследяване на грешки по най-подходящия за тях начин.
20-те персонализирани статуса и 7-те персонализирани полета на шаблона позволяват създаването на работна процедура, съобразена с вашите нужди, като гарантират, че всеки проблем се проследява от откриването до разрешаването му. Вградените автоматизации поемат повтарящите се задачи, което ви спестява ценно време и намалява ръчния труд.
💟 Бонус: Brain MAX е вашият помощник за настолен компютър, задвижван от изкуствен интелект, създаден да ускори отстраняването на бъгове с интелигентни и практични функции.
Когато откриете грешка, просто използвайте функцията за преобразуване на реч в текст на Brain MAX, за да диктувате проблема – вашите гласови бележки се транскрибират незабавно и могат да бъдат прикачени към нов или съществуващ тикет за грешка. Функцията Enterprise Search претърсва всички ваши свързани инструменти – като ClickUp, GitHub, Google Drive и Slack – за да открие свързани доклади за грешки, логове за грешки, фрагменти от код и документация, така че да разполагате с целия необходим контекст, без да се налага да превключвате между приложенията.
Трябва ли да координирате отстраняването на грешка? Brain MAX ви позволява да възложите грешката на подходящия разработчик, да зададете автоматични напомняния за актуализации на статуса и да проследявате напредъка – всичко това от вашия компютър!
2. Sentry (Най-подходящ за засичане на грешки)
Sentry намалява MTTD и времето за възпроизвеждане на грешките, като събира грешки, трасировки и потребителски сесии на едно място. Групирането на проблеми, задвижвано от изкуствен интелект, намалява шума; функциите „Suspect Commit“ и правилата за отговорност идентифицират вероятния собственик на кода, което позволява незабавно насочване на проблема. Функцията „Session Replay“ предоставя на инженерите точния път на потребителя и подробности за конзолата/мрежата, необходими за възпроизвеждане на проблема, без безкрайни обмени на информация.
Функциите на Sentry AI могат да обобщят контекста на проблема и, в някои стекове, да предложат Autofix пачове, които сочат към проблемния код. Практическото въздействие: по-малко дублиращи се тикети, по-бързо разпределяне и по-кратък път от доклада до работещия пач.
3. GitHub Copilot (Най-подходящ за по-бърз преглед на кода)
Copilot ускорява цикъла на отстраняване на грешките в редактора. Той обяснява следите на стека, предлага целенасочени корекции, пише единични тестове за потвърждаване на поправката и създава скеле за скриптове за възпроизвеждане.
Copilot Chat може да анализира кода, който не работи, да предложи по-безопасни рефактори и да генерира коментари или описания на PR, които ускоряват прегледа на кода. В комбинация с задължителните прегледи и CI, това съкращава с часове процеса „диагностициране → имплементиране → тестване“, особено при грешки с ясно определен обхват и ясна възпроизводимост.
4. Snyk от DeepCode AI (най-подходящ за откриване на модели)
Статичният анализ на DeepCode, задвижван от изкуствен интелект, открива дефекти и несигурни модели още докато пишете код и в PR-ите. Той подчертава проблемните потоци, обяснява защо възникват и предлага сигурни поправки, които съответстват на стила на вашата кодова база.
Като откривате регресиите преди сливането и насочвате разработчиците към по-безопасни модели, намалявате честотата на появата на нови бъгове и ускорявате отстраняването на сложни логически грешки, които са трудни за откриване при прегледа. Интеграциите с IDE и PR поддържат този процес близо до мястото, където се извършва работата.
5. Watchdog и AIOps на Datadog (най-подходящи за анализ на логове)
Watchdog на Datadog използва машинно обучение (ML), за да открива аномалии в логовете, метриките, трасировките и мониторинга на реалните потребители. Той съпоставя пиковете с маркери за внедряване, промени в инфраструктурата и топологията, за да предложи вероятни основни причини.
За дефектите, които засягат клиентите, това означава откриване за минути, автоматично групиране за намаляване на излишните сигнали и конкретни насоки за това къде да търсите. Времето за сортиране се съкращава, защото започвате с „това внедряване засегна тези услуги и процентът на грешките се повиши на този краен уред“, вместо да започвате от нулата.
⚡️ Архив с шаблони: Безплатни шаблони за проследяване на проблеми и регистри в Excel и ClickUp
6. New Relic AI (Най-подходящ за идентифициране и обобщаване на тенденции)
Функцията „Errors Inbox“ на New Relic групира сходни грешки по услуги и версии, докато AI асистентът обобщава въздействието, подчертава вероятните причини и предоставя връзки към съответните трасировки/транзакции.
Връзките между версиите и аналитичните данни за промените в обектите ясно показват кога вината е наскоро пуснатата версия. При разпределените системи този контекст спестява часове на обмен на съобщения между екипите и насочва грешката към правилния отговорник, като вече е формулирана солидна хипотеза.
7. Rollbar (Най-подходящ за автоматизирани работни потоци)
Rollbar е специализирана в мониторинг на грешки в реално време с интелигентно идентифициране, което групира дублираните грешки и проследява тенденциите в тяхното възникване. Нейните обобщения, базирани на изкуствен интелект, и подсказки за основните причини помагат на екипите да разберат обхвата на проблема (засегнати потребители, засегнати версии), докато телеметрията и следите от стека дават бързи насоки за възпроизвеждане на грешката.
Правилата за работните потоци на Rollbar могат автоматично да създават задачи, да маркират сериозността на грешките и да ги насочват към отговорните лица, превръщайки хаотичните потоци от грешки в приоритизирани опашки с приложен контекст.
8. PagerDuty AIOps и автоматизация на ръководствата за действие (Най-доброто от диагностиката с минимална намеса)
PagerDuty използва корелация на събития и намаляване на шума чрез машинно обучение, за да преобразува бурите от сигнали в инциденти, по които може да се предприемат действия.
Динамичното насочване незабавно препраща проблема към подходящия дежурен специалист, докато автоматизацията на ръководствата за действие може да задейства диагностика или коригиращи мерки (рестартиране на услуги, отмяна на внедряване, превключване на флаг на функция) още преди да се намеси човек. По отношение на времето за отстраняване на грешки това означава по-кратко MTTA, по-бързи коригиращи мерки за P0 и по-малко часове, загубени поради пренасищане с предупреждения.
Основната идея е автоматизация и изкуствен интелект на всеки етап. Откривате проблемите по-рано, насочвате ги по-разумно, стигате по-бързо до кода и съобщавате статуса, без да забавяте работата на инженерите – всичко това води до значително съкращаване на времето за отстраняване на бъгове.
📖 Прочетете още: Как да използвате изкуствен интелект в DevOps
Реални примери за използване на изкуствен интелект при отстраняването на бъгове
Така че изкуственият интелект официално е излязъл от лабораторията. Той намалява времето за отстраняване на грешки в реални условия.
Нека видим как!
| Домейн / Организация | Как беше използван изкуственият интелект | Въздействие / Полза |
|---|---|---|
| Ubisoft | Разработихме Commit Assistant – инструмент, базиран на изкуствен интелект, обучен въз основа на вътрешен код, събран в продължение на десетилетие, който предвижда и предотвратява грешки още на етапа на кодиране. | Целта е да се намалят значително времето и разходите – традиционно до 70% от разходите за разработка на игри се изразходват за отстраняване на бъгове. |
| Razer (платформа Wyvrn) | Стартирахме QA Copilot, задвижван от изкуствен интелект (интегриран с Unreal и Unity), за автоматизиране на откриването на бъгове и генериране на QA отчети. | Повишава откриването на грешки с до 25% и намалява наполовина времето за QA. |
| Google / DeepMind и Project Zero | Представихме Big Sleep – инструмент, базиран на изкуствен интелект, който самостоятелно открива уязвимости в сигурността на софтуер с отворен код като FFmpeg и ImageMagick. | Идентифицирани са 20 грешки, всичките проверени от експерти и предвидени за отстраняване. |
| Изследователи от Университета на Калифорния в Бъркли | Използвайки бенчмарк, наречен CyberGym, моделите за изкуствен интелект анализираха 188 проекта с отворен код, откривайки 17 уязвимости – включително 15 неизвестни бъгове от типа „zero-day“ – и генерираха експлойти за доказване на концепцията. | Демонстрира развиващите се възможности на изкуствения интелект в откриването на уязвимости и автоматизираната защита срещу експлойти. |
| Spur (стартъп от Йейл) | Разработен е AI агент, който превръща описанията на тестовите случаи на обикновен език в автоматизирани процедури за тестване на уебсайтове — на практика това е самонаписващ се работен процес за контрол на качеството. | Позволява автономно тестване с минимална човешка намеса |
| Автоматично възпроизвеждане на доклади за грешки в Android | Използвахме NLP и усилващо обучение, за да интерпретираме езика на докладите за грешки и да генерираме стъпки за възпроизвеждане на грешките в Android. | Постигната е точност от 67%, покритие от 77% и възпроизвеждане на 74% от докладите за грешки, което надминава традиционните методи. |
Често срещани грешки при измерването на времето за отстраняване на бъгове
Ако измерването ви е неточно, планът ви за подобрение също ще бъде такъв.
Повечето „лоши показатели“ в работните процеси за отстраняване на бъгове се дължат на неясни дефиниции, непоследователни работни процеси и повърхностен анализ.
Започнете първо с основите – какво се счита за стартиране/спиране, как се справяте с изчакванията и повторното отваряне – след което разгледайте данните така, както ги възприемат вашите клиенти. Това включва:
❌ Неясни граници: Смесването на „Докладвани→Решени“ и „Докладвани→Затворени“ в един и същ дашборд (или преминаването от един към друг вариант от месец на месец) прави тенденциите безсмислени. Изберете една граница, документирайте я и я наложете във всички екипи. Ако имате нужда и от двете, публикувайте ги като отделни показатели с ясни етикети.
❌ Подход, основаващ се единствено на средни стойности: Разчитането на средната стойност скрива реалността на опашките, в които има няколко изключения с дълго време на изпълнение. Използвайте медианата (P50) за „типичното“ време, P90 за предсказуемост/SLA и запазете средната стойност за планиране на капацитета. Винаги разглеждайте разпределението, а не само едно единствено число.
❌ Липса на сегментация: Обединяването на всички бъгове в една група смесва инцидентите от категория P0 с козметичните бъгове от категория P3. Сегментирайте по степен на сериозност, източник (клиент срещу QA срещу мониторинг), компонент/екип и „нови срещу регресия“. Вашият P90 за P0/P1 е това, което усещат заинтересованите страни; вашата медиана за P2+ е това, около което инженерите планират работата си.
❌ Пренебрегване на „паузираното“ време: Чакате ли логове от клиенти, външен доставчик или прозорец за пускане на версия? Ако не проследявате статуса „Блокирано/Паузирано“ като първостепенен статус, времето за отстраняване на грешките се превръща в повод за спорове. Отчитайте както календарното, така и активното време, за да станат видими пречките и да спрат споровете.
❌ Несъответствия при нормализирането на времето: Смесването на часови зони или преминаването от работни към календарни часове по време на процеса нарушава сравненията. Нормализирайте времевите отметки към една часова зона (или UTC) и решете веднъж дали SLA се измерват в работни или календарни часове; прилагайте това последователно.
❌ Непълни данни при регистриране и дубликати: Липсващата информация за средата/версията и дублираните тикети удължават времето за разрешаване и създават объркване относно отговорността. Стандартизирайте задължителните полета при регистрирането, попълвайте ги автоматично (логове, версия, устройство) и премахвайте дубликатите, без да нулирате отчитането на времето — затваряйте дубликатите като свързани, а не като „нови“ проблеми.
❌ Непоследователни модели на статуси: Индивидуално създадените статуси („Почти готов за QA“, „В очакване на преглед 2“) скриват времето, прекарано в даден статус, и правят преходите между състоянията ненадеждни. Дефинирайте каноничен работен поток (Нов → Триажиран → В процес → В преглед → Решен → Затворен) и проверете за състояния, които се отклоняват от него.
❌ Не обръщайте внимание на времето, прекарано във всеки статус: Една единствена цифра за „общо време“ не може да ви покаже къде работата зацикля. Записвайте и анализирайте времето, прекарано в статусите „Триажиран“, „В преглед“, „Блокиран“ и „QA“. Ако прегледът на кода (P90) значително надвишава времето за имплементиране, решението не е да „кодирате по-бързо“, а да освободите капацитет за преглед.
🧠 Интересен факт: Последната AI Cyber Challenge на DARPA демонстрира революционен скок в автоматизацията на киберсигурността. В състезанието участваха системи с изкуствен интелект, проектирани да откриват, експлоатират и отстраняват уязвимости в софтуера автономно — без човешка намеса. Победителният отбор „Team Atlanta“ впечатляващо откри 77% от вмъкнатите бъгове и успешно отстрани 61% от тях, демонстрирайки способността на изкуствения интелект не само да открива недостатъци, но и активно да ги отстранява.
❌ „Слепота“ при повторно отваряне: Третирането на повторно отворените проблеми като нови грешки нулира отчитането на времето и изкривява показателя MTTR. Проследявайте процента на повторно отваряне и „времето до стабилно затваряне“ (от първоначалния доклад до окончателното затваряне през всички цикли). Нарастващият брой на повторно отворените проблеми обикновено сочи към слаба възпроизводимост, пропуски в тестването или неясна дефиниция за „завършено“.
❌ Липса на MTTA: Екипите се фокусират прекалено върху MTTR и пренебрегват MTTA (време за потвърждение/поемане на отговорност). Високата стойност на MTTA е ранен сигнал за продължително отстраняване на проблема. Измервайте го, задавайте SLA според степента на сериозност и автоматизирайте маршрутизацията/ескалацията, за да го поддържате ниско.
❌ Изкуствен интелект/автоматизация без контролни механизми: Ако позволите на изкуствения интелект да определя степента на сериозност или да затваря дублиращи се проблеми без преглед, това може да доведе до неправилна класификация на гранични случаи и незабележимо изкривяване на показателите. Използвайте изкуствения интелект за предложения, изисквайте човешко потвърждение за P0/P1 и извършвайте месечен одит на ефективността на модела, за да поддържате надеждността на данните си.
Усъвършенствайте тези аспекти и графиките ви за времето за разрешаване на проблеми най-накрая ще отразяват реалността. Оттам нататък подобренията се натрупват: по-доброто приемане на заявки намалява MTTA, по-ясните състояния разкриват истинските пречки, а сегментираните P90 дават на ръководителите обещания, които можете да изпълните.
⚡️ Архив с шаблони: 10 шаблона за тестови случаи за тестване на софтуер
Най-добри практики за по-ефективно отстраняване на грешки
Накрая, ето най-важните съвети, които трябва да имате предвид!
| 🧩 Най-добри практики | 💡 Какво означава това | 🚀 Защо е важно |
| Използвайте надеждна система за проследяване на грешки | Проследявайте всички докладвани грешки чрез централизирана система за проследяване на грешки. | Гарантира, че нито една грешка няма да бъде пропусната, и осигурява прозрачност относно статуса на грешките за всички екипи. |
| Напишете подробни доклади за грешки | Включете визуален контекст, информация за операционната система, стъпки за възпроизвеждане на проблема и степен на сериозност. | Помага на разработчиците да отстраняват грешките по-бързо, като им предоставя цялата необходима информация още в самото начало. |
| Категоризирайте и приоритизирайте грешките | Използвайте матрица за приоритети, за да сортирате грешките според спешността и въздействието им. | По този начин екипът се фокусира първо върху критичните грешки и спешните проблеми. |
| Използвайте автоматизираното тестване | Изпълнявайте тестове автоматично във вашия CI/CD пипалин. | Подпомага ранното откриване и предотвратява регресиите. |
| Определете ясни насоки за отчитане | Предоставете шаблони и обучение за това как да се докладват грешки. | Това води до точна информация и по-гладка комуникация. |
| Проследявайте ключовите показатели | Измервайте времето за отстраняване, изминалото време и времето за отговор. | Позволява проследяване и подобряване на производителността въз основа на исторически данни. |
| Прилагайте проактивен подход | Не чакайте потребителите да се оплачат – тествайте проактивно. | Повишава удовлетвореността на клиентите и намалява натоварването на отдела за поддръжка. |
| Използвайте интелигентни инструменти и машинно обучение | Използвайте машинно обучение, за да прогнозирате грешки и да предлагате решения. | Повишава ефективността при идентифицирането на основните причини и отстраняването на грешките. |
| Съобразяване със споразуменията за ниво на обслужване (SLA) | Спазвайте договорените споразумения за ниво на обслужване при отстраняването на грешките. | Изгражда доверие и отговаря на очакванията на клиентите в кратки срокове. |
| Непрекъснато преразглеждайте и подобрявайте | Анализирайте повторно отворените бъгове, събирайте обратна връзка и оптимизирайте процесите. | Насърчава непрекъснатото усъвършенстване на процеса на разработка и управлението на бъгове. |
Опростено отстраняване на бъгове с контекстуален изкуствен интелект
Екипите, които отстраняват грешките най-бързо, не разчитат на героични постъпки. Те проектират система: ясни дефиниции за начало и край, прецизно регистриране, приоритизиране според въздействието върху бизнеса, ясно разпределение на отговорностите и строги цикли на обратна връзка между отделите за поддръжка, контрол на качеството, инженеринг и пускане на версии.
ClickUp може да бъде този управляван от изкуствен интелект команден център за вашата система за отстраняване на бъгове. Централизирайте всеки доклад в една опашка, стандартизирайте контекста със структурирани полета и оставете изкуственият интелект на ClickUp да сортира, обобщава и приоритизира, докато автоматизациите налагат SLA, ескалират при закъснения и поддържат съгласуваност между заинтересованите страни. Свържете бъговете с клиенти, код и версии, за да могат ръководителите да виждат въздействието, а специалистите да продължат да работят без прекъсване.
Ако сте готови да съкратите времето за отстраняване на бъгове и да направите своя план за развитие по-предвидим, регистрирайте се в ClickUp и започнете да отчитате подобрението в рамките на дни, а не на тримесечия.
Често задавани въпроси
Какво представлява добро време за отстраняване на бъгове?
Няма едно единствено „добро“ число – то зависи от сериозността, модела на пускане и толерантността към риска. Използвайте медиани (P50) за „типичната“ производителност и P90 за обещания/SLA, и сегментирайте по сериозност и източник.
Каква е разликата между отстраняването и затварянето на грешки?
„Решаване“ е, когато поправката е приложена (например кодът е обединен, конфигурацията е приложена) и екипът счита, че дефектът е отстранен. „Затваряне“ е, когато проблемът е проверен и официално приключен (например, QA е потвърдил в целевата среда, пуснат е в употреба или е маркиран като „няма да се поправи“/„дубликат“ с обосновка). Много екипи измерват и двете: „Докладвано→Решено“ отразява скоростта на инженеринга; „Докладвано→Затворено“ отразява потока на качеството от начало до край. Използвайте последователни дефиниции, за да не се смесват етапите в таблата за управление.
Каква е разликата между времето за отстраняване на грешки и времето за откриване на грешки?
Времето за откриване (MTTD) е времето, необходимо за откриване на дефект след възникването му или пускането му в експлоатация – чрез мониторинг, контрол на качеството или от потребителите. Времето за отстраняване е времето, необходимо от откриването/докладването до прилагането на поправката (и, ако предпочитате, до валидирането/пускането ѝ). Заедно те определят прозореца на въздействието върху клиента: бързо откриване, бързо потвърждаване, бързо отстраняване и безопасно пускане. Можете също така да проследявате MTTA (време за потвърждаване/разпределяне), за да откриете закъснения в сортирането, които често предвещават по-дълго отстраняване.
Как изкуственият интелект помага при отстраняването на грешки?
Изкуственият интелект съкращава циклите, които обикновено отнемат много време: приемане, сортиране, диагностика, отстраняване и проверка.
- Приемане и сортиране: Автоматично обобщава дълги доклади, извлича стъпки за възпроизвеждане/среда, маркира дубликати и предлага степен на сериозност/приоритет, за да могат инженерите да започнат с ясен контекст (например ClickUp AI, Sentry AI).
- Маршрутизиране и SLA: Предвижда вероятния компонент/отговорен, задава таймери и ескалира, когато MTTA или времето за преглед се забавят — като по този начин намалява „времето в статус“ без дейност (ClickUp Automations и работни потоци, подобни на тези на агентите).
- Диагностика: Групира сходни грешки, свързва пиковете с последните комитове/релизи и посочва вероятните основни причини чрез следи от стека и контекста на кода (Sentry AI и подобни).
- Внедряване: Предлага промени в кода и тестове въз основа на модели от вашето репозиторий, което ускорява цикъла „написване/поправяне“ (GitHub Copilot; Snyk Code AI от DeepCode).
- Верификация и комуникации: създава тестови случаи въз основа на стъпките за възпроизвеждане, изготвя бележки към версията и актуализации за заинтересованите страни, както и обобщава състоянието за ръководството и клиентите (ClickUp AI). Когато се използват заедно — ClickUp като командно център, а Sentry/Copilot/DeepCode като част от технологичния стек — екипите съкращават времето за отстраняване на грешките (MTTA/P90), без да разчитат на героични усилия.