เมื่อคุณปล่อยอัปเดตซอฟต์แวร์ล่าสุด รายงานก็เริ่มหลั่งไหลเข้ามา
ทันใดนั้น ตัวชี้วัดเดียวก็ควบคุมทุกสิ่ง ตั้งแต่ CSAT/NPS ไปจนถึงการล่าช้าของแผนงาน: เวลาแก้ไขข้อผิดพลาด
ผู้บริหารมองว่านี่เป็นตัวชี้วัดการรักษาคำสัญญา — เราสามารถส่งมอบผลิตภัณฑ์ เรียนรู้ และปกป้องรายได้ตามกำหนดเวลาได้หรือไม่? ส่วนผู้ปฏิบัติงานจริงต้องเผชิญกับความยากลำบากในสนาม — ตั๋วที่ซ้ำซ้อน ความรับผิดชอบที่ไม่ชัดเจน การส่งต่อปัญหาที่วุ่นวาย และข้อมูลบริบทที่กระจัดกระจายอยู่ใน Slack สเปรดชีต และเครื่องมือต่าง ๆ
ความแตกแยกนี้ทำให้วงจรการทำงานยืดยาว ซ่อนสาเหตุหลัก และทำให้การกำหนดลำดับความสำคัญกลายเป็นเพียงการคาดเดา
ผลคืออะไร? การเรียนรู้ที่ช้าลง การไม่ปฏิบัติตามคำมั่นสัญญา และงานค้างที่ค่อยๆ ก่อให้เกิดความกดดันต่อทุกสปรินต์
คู่มือนี้คือคู่มือครบวงจรสำหรับการวัดผล เปรียบเทียบ และลดเวลาแก้ไขข้อผิดพลาด พร้อมทั้งแสดงให้เห็นอย่างชัดเจนว่า AI เปลี่ยนแปลงกระบวนการทำงานอย่างไรเมื่อเทียบกับกระบวนการแบบดั้งเดิมที่ทำด้วยมือ
เวลาแก้ไขข้อผิดพลาดคืออะไร?
เวลาแก้ไขข้อผิดพลาด คือระยะเวลาที่จำเป็นในการแก้ไขข้อผิดพลาด ซึ่งวัดจากช่วงเวลาที่ข้อผิดพลาดถูกรายงานจนกระทั่งได้รับการแก้ไขอย่างสมบูรณ์
ในความเป็นจริง การนับเวลาจะเริ่มขึ้นเมื่อมีปัญหาถูกรายงานหรือตรวจพบ (ผ่านผู้ใช้ ทีม QA หรือระบบการติดตาม) และจะหยุดลงเมื่อการแก้ไขถูกนำไปใช้และรวมเข้าในโค้ด พร้อมสำหรับการตรวจสอบหรือปล่อยออก — ขึ้นอยู่กับว่าทีมของคุณกำหนดคำว่า “เสร็จ” อย่างไร
ตัวอย่าง: ข้อผิดพลาดระดับ P1 ที่ถูกรายงานเมื่อเวลา 10:00 น. วันจันทร์ และแก้ไขเสร็จสิ้นเมื่อเวลา 15:00 น. วันอังคาร มีเวลาแก้ไขประมาณ 29 ชั่วโมง
สิ่งนี้ไม่เหมือนกับเวลาตรวจพบข้อผิดพลาด เวลาตรวจพบข้อผิดพลาดวัดความเร็วที่คุณสามารถระบุข้อผิดพลาดได้หลังจากที่มันเกิดขึ้น (เช่น การส่งสัญญาณเตือน,เครื่องมือทดสอบ QAตรวจพบข้อผิดพลาด, หรือลูกค้าแจ้งข้อผิดพลาด)
เวลาแก้ไขปัญหาวัดความเร็วที่คุณเคลื่อนตัวจากขั้นตอนการตรวจพบปัญหาไปยังขั้นตอนการแก้ไข — การจัดลำดับความสำคัญ การสร้างปัญหาซ้ำ การวินิจฉัย การนำไปใช้ การตรวจสอบ การทดสอบ และการเตรียมพร้อมสำหรับการปล่อยเวอร์ชันใหม่ ให้คิดว่าขั้นตอนการตรวจพบปัญหาคือ “เรารู้แล้วว่ามีปัญหา” และขั้นตอนการแก้ไขคือ “ปัญหาได้รับการแก้ไขและพร้อมใช้งานแล้ว”
ทีมต่าง ๆ ใช้ขอบเขตที่ต่างกันเล็กน้อย; เลือกหนึ่งอย่างและใช้อย่างสม่ำเสมอ เพื่อให้แนวโน้มของคุณเป็นจริง:
- รายงาน → แก้ไขแล้ว: กระบวนการสิ้นสุดเมื่อการแก้ไขโค้ดถูกรวมเข้าและพร้อมสำหรับการตรวจสอบคุณภาพ (QA) เหมาะสำหรับการวัดประสิทธิภาพการทำงานของทีมวิศวกรรม
- รายงาน → ปิด: รวมถึงการตรวจสอบคุณภาพ (QA) และการปล่อยเวอร์ชัน เหมาะที่สุดสำหรับ SLA ที่ส่งผลกระทบต่อลูกค้า
- ตรวจพบ → แก้ไข: เริ่มขึ้นเมื่อระบบการเฝ้าติดตาม/QA ตรวจพบปัญหา แม้ก่อนที่จะมีตั๋วเกิดขึ้น ใช้ได้กับทีมที่มีงานในระบบผลิตจำนวนมาก
🧠 ข้อมูลน่าสนใจ: ข้อผิดพลาดที่แปลกแต่ตลกในFinal Fantasy XIV ได้รับ คำชมเพราะความเฉพาะเจาะจงจนผู้อ่านตั้งชื่อให้มันว่า “การแก้ไขข้อผิดพลาดที่เฉพาะเจาะจงที่สุดใน MMO ปี 2025” ” ข้อผิดพลาดนี้เกิดขึ้นเมื่อผู้เล่นตั้งราคาไอเทมระหว่าง 44,442 gil ถึง 49,087 gil อย่างแม่นยำในโซนกิจกรรมเฉพาะ — ซึ่งทำให้ผู้เล่นถูกตัดการเชื่อมต่อ เนื่องจากอาจเกิดข้อผิดพลาดจากการล้นค่าจำนวนเต็ม
ทำไมเรื่องนี้จึงสำคัญ
เวลาแก้ไขข้อผิดพลาดเป็นปัจจัยสำคัญที่ส่งผลต่อความถี่ในการปล่อยเวอร์ชัน เวลาแก้ไขที่ยาวนานหรือไม่สามารถคาดการณ์ได้จะบังคับให้ต้องลดขอบเขตงาน ติดตั้งการแก้ไขด่วน (hotfixes) และหยุดการปล่อยเวอร์ชันชั่วคราว; สิ่งเหล่านี้ก่อให้เกิดหนี้การวางแผน เนื่องจากค่าผิดปกติ (outliers) ส่งผลกระทบต่อสปรินต์มากกว่าที่ค่าเฉลี่ยบ่งชี้
เรื่องนี้ยังเกี่ยวข้องโดยตรงกับความพึงพอใจของลูกค้า ลูกค้าจะยอมรับปัญหาได้หากปัญหาได้รับการรับรู้อย่างรวดเร็วและแก้ไขได้อย่างคาดการณ์ได้ การแก้ไขที่ล่าช้า — หรือที่แย่กว่านั้น คือการแก้ไขที่ไม่สม่ำเสมอ — จะทำให้ปัญหาถูกส่งต่อระดับสูงขึ้น ส่งผลให้คะแนน CSAT/NPS ลดลง และทำให้การต่ออายุบริการมีความเสี่ยง
สรุปแล้ว หากคุณสามารถวัดเวลาแก้ไขข้อผิดพลาดได้อย่างชัดเจนและลดมันลงอย่างเป็นระบบ แผนงานและสัมพันธ์ภาพของคุณจะดีขึ้น
📖 อ่านเพิ่มเติม: วิธีจัดลำดับความสำคัญของข้อผิดพลาดเพื่อแก้ไขปัญหาอย่างมีประสิทธิภาพ
วิธีวัดเวลาแก้ไขข้อผิดพลาด?
ก่อนอื่น ให้กำหนดจุดเริ่มต้นและจุดสิ้นสุดของช่วงเวลา
ทีมส่วนใหญ่จะเลือกใช้หนึ่งในสองตัวเลือกต่อไปนี้: Reported → Resolved (การแก้ไขได้ถูกรวมเข้าโค้ดและพร้อมสำหรับการตรวจสอบ) หรือ Reported → Closed (ทีม QA ได้ตรวจสอบและยืนยันแล้ว และการเปลี่ยนแปลงได้ถูกปล่อยออกหรือปิดลงด้วยเหตุผลอื่น)
เลือกนิยามหนึ่งและใช้มันอย่างสม่ำเสมอ เพื่อให้แนวโน้มของคุณมีความหมาย
ตอนนี้คุณต้องการตัวชี้วัดที่สามารถสังเกตได้ มาดูรายละเอียดกัน:
ตัวชี้วัดการติดตามข้อผิดพลาดสำคัญที่ควรติดตาม:
| 📊 ตัวชี้วัด | 📌 ความหมาย | 💡 ประโยชน์ | 🧮 สูตร (หากมี) |
|---|---|---|---|
| จำนวนข้อผิดพลาด 🐞 | จำนวนข้อผิดพลาดที่รายงานทั้งหมด | ให้ภาพรวมของสภาพระบบจากมุมมองสูง หากตัวเลขสูง ก็ถึงเวลาต้องตรวจสอบแล้ว | จำนวนข้อผิดพลาดทั้งหมด = ข้อผิดพลาดทั้งหมดที่บันทึกในระบบ {เปิด + ปิด} |
| ข้อผิดพลาดที่ยังไม่ได้รับการแก้ไข 🚧 | ข้อผิดพลาดที่ยังไม่ได้รับการแก้ไข | แสดงปริมาณงานปัจจุบัน ช่วยในการกำหนดลำดับความสำคัญ | ข้อผิดพลาดที่เปิด = ข้อผิดพลาดทั้งหมด - ข้อผิดพลาดที่ปิด |
| ข้อผิดพลาดที่ปิดแล้ว ✅ | ข้อผิดพลาดที่ได้รับการแก้ไขและตรวจสอบแล้ว | ติดตามความก้าวหน้าและงานที่เสร็จสิ้น | ข้อผิดพลาดที่ปิดแล้ว = จำนวนข้อผิดพลาดที่มีสถานะ "ปิด" หรือ "แก้ไขแล้ว" |
| ระดับความรุนแรงของข้อผิดพลาด 🔥 | ระดับความสำคัญของข้อผิดพลาด (เช่น: critical, major, minor) | ช่วยจัดประเภทปัญหาตามระดับความรุนแรง | บันทึกเป็น สนามประเภท, ไม่มีสูตร ใช้ตัวกรอง/การจัดกลุ่ม |
| ระดับความสำคัญของข้อผิดพลาด 📅 | ระดับความเร่งด่วนที่ข้อผิดพลาดจำเป็นต้องได้รับการแก้ไข | ช่วยในการวางแผนสปรินต์และการปล่อยเวอร์ชัน | นอกจากนี้ยังเป็น สนามประเภท ที่มักจัดอันดับ (เช่น P0, P1, P2) |
| เวลาแก้ไข ⏱️ | เวลาตั้งแต่รายงานข้อผิดพลาดจนถึงการแก้ไข | วัดความเร็วในการตอบสนอง | เวลาแก้ไข = วันที่ปิดเรื่อง - วันที่รายงาน |
| อัตราการเปิดใหม่ 🔄 | % ของข้อผิดพลาดที่ถูกเปิดใหม่หลังจากถูกปิด | สะท้อนถึงคุณภาพการแก้ไขหรือปัญหาการกลับเป็นเดิม | อัตราการเปิดใหม่ (%) = {ข้อผิดพลาดที่เปิดใหม่ ÷ ข้อผิดพลาดที่ปิดทั้งหมด} × 100 |
| การรั่วไหลของข้อผิดพลาด 🕳️ | ข้อผิดพลาดที่หลุดเข้าสู่ระบบผลิต | แสดงถึงประสิทธิภาพของการควบคุมคุณภาพ (QA)และการทดสอบซอฟต์แวร์ | อัตราการรั่วไหล (%) = {ข้อผิดพลาดในระบบผลิต ÷ จำนวนข้อผิดพลาดทั้งหมด} × 100 |
| ความหนาแน่นของข้อบกพร่อง 🧮 | จำนวนข้อผิดพลาดต่อหน่วยขนาดของโค้ด | ชี้ให้เห็นพื้นที่รหัสที่มีความเสี่ยงสูง | ความหนาแน่นของข้อผิดพลาด = จำนวนข้อผิดพลาด ÷ KLOC {Kilo Lines of Code} |
| ข้อผิดพลาดที่ได้รับการจัดสรร vs ข้อผิดพลาดที่ยังไม่ได้รับการจัดสรร 👥 | การแบ่งประเภทข้อผิดพลาดตามผู้รับผิดชอบ | รับประกันว่าไม่มีเรื่องใดถูกละเลย | ใช้ ตัวกรอง: ยังไม่ได้รับการจัดสรร = ข้อผิดพลาด ที่ช่อง "ผู้รับผิดชอบ" เป็นค่าว่าง |
| อายุของข้อผิดพลาดที่ยังไม่ได้รับการแก้ไข 🧓 | บั๊กจะค้างอยู่นานเท่าไร | ตรวจพบความเสี่ยงจากการหยุดชะงักและงานที่ค้างอยู่ | อายุข้อผิดพลาด = วันที่ปัจจุบัน - วันที่รายงาน |
| ข้อผิดพลาดที่ซ้ำกัน 🧬 | จำนวนรายงานที่ซ้ำกัน | ชี้ให้เห็นข้อผิดพลาดในกระบวนการรับเรื่อง | อัตราความซ้ำซ้อน = จำนวนข้อผิดพลาดที่ซ้ำซ้อน ÷ จำนวนข้อผิดพลาดทั้งหมด × 100 |
| MTTD (Mean Time to Detect) 🔎 | เวลาเฉลี่ยที่ใช้ในการตรวจพบข้อผิดพลาดหรือเหตุการณ์ | วัดประสิทธิภาพการติดตามและรับรู้ | MTTD = Σ(เวลาที่ตรวจพบ - เวลาที่ข้อผิดพลาดเกิดขึ้น) ÷ จำนวนข้อผิดพลาด |
| MTTR (Mean Time to Resolve) 🔧 | เวลาเฉลี่ยที่จำเป็นเพื่อแก้ไขข้อผิดพลาดให้เสร็จสิ้นอย่างสมบูรณ์หลังจากตรวจพบ | ติดตามความรวดเร็วในการตอบสนองของทีมวิศวกรรมและเวลาที่ใช้ในการแก้ไขข้อผิดพลาด | MTTR = Σ(เวลาที่แก้ไขเสร็จ - เวลาที่ตรวจพบ) ÷ จำนวนข้อผิดพลาดที่แก้ไขเสร็จ |
| MTTA (Mean Time to Acknowledge) 📬 | เวลาตั้งแต่การตรวจพบข้อผิดพลาดจนกระทั่งมีผู้เริ่มแก้ไขข้อผิดพลาด | แสดงความสามารถในการตอบสนองของทีมและการตอบสนองต่อคำเตือน | MTTA = Σ(เวลาที่ยืนยัน - เวลาที่ตรวจพบ) ÷ จำนวนข้อผิดพลาด |
| MTBF (Mean Time Between Failures) 🔁 | เวลาที่ผ่านไประหว่างการแก้ไขข้อผิดพลาดหนึ่งครั้งจนถึงการเกิดข้อผิดพลาดครั้งต่อไป | แสดงถึงความเสถียรตามเวลา | MTBF = เวลาทำงานรวม ÷ จำนวนครั้งที่เกิดข้อผิดพลาด |
ปัจจัยที่ส่งผลต่อเวลาแก้ไขข้อผิดพลาด
เวลาแก้ไขข้อผิดพลาดมักถูกเทียบเท่ากับ “ความเร็วในการเขียนโค้ดของวิศวกร”
แต่นั่นเป็นเพียงส่วนหนึ่งของกระบวนการเท่านั้น
เวลาแก้ไขข้อผิดพลาดคือผลรวมของคุณภาพในการรับข้อผิดพลาด ความประสิทธิภาพของกระบวนการไหลผ่านระบบ และความเสี่ยงจากความพึ่งพา เมื่อมีปัจจัยใดปัจจัยหนึ่งเกิดปัญหา เวลาวงจรจะยืดยาว ความสามารถในการคาดการณ์จะลดลง และเสียงเรียกร้องให้ยกระดับปัญหาจะดังขึ้น
คุณภาพของขั้นตอนรับเรื่องกำหนดทิศทาง
รายงานที่ส่งมาโดยไม่มีขั้นตอนการจำลองปัญหาที่ชัดเจน รายละเอียดสภาพแวดล้อม บันทึก หรือข้อมูลเวอร์ชัน/บิลด์ จะทำให้ต้องมีการติดต่อไปมาเพิ่มเติม รายงานที่ซ้ำกันจากหลายช่องทาง (ฝ่ายสนับสนุน QA การเฝ้าติดตาม Slack) จะก่อให้เกิดความสับสนและทำให้ความรับผิดชอบไม่ชัดเจน
ยิ่งคุณจับข้อมูลบริบทที่ถูกต้องได้เร็วขึ้น — และกำจัดข้อมูลซ้ำ — ก็ยิ่งลดจำนวนการส่งต่องานและการติดต่อเพื่อขอข้อมูลเพิ่มเติมในขั้นตอนต่อไป
การกำหนดลำดับความสำคัญและการจัดเส้นทางจะกำหนดว่าใครจะรับผิดชอบแก้ไขข้อผิดพลาดและเมื่อใด
การจัดระดับความรุนแรงที่ไม่สอดคล้องกับผลกระทบต่อลูกค้าหรือธุรกิจ (หรือที่เปลี่ยนแปลงไปตามเวลา) จะก่อให้เกิดการไหลเวียนในคิว: ตั๋วที่มีเสียงดังที่สุดจะได้รับการจัดลำดับก่อน ในขณะที่ข้อบกพร่องที่มีผลกระทบสูงกลับถูกทิ้งไว้โดยไม่ได้รับการแก้ไข
กฎการจัดเส้นทางที่ชัดเจนตามส่วนประกอบ/ผู้รับผิดชอบ และคิวข้อมูลหลักเดียว ช่วยป้องกันไม่ให้งาน P0/P1 ถูกฝังอยู่ใต้ข้อมูล “ล่าสุดและรบกวน”
ความรับผิดชอบและการส่งต่องานคือ "ฆาตกรเงียบ"
หากไม่ชัดเจนว่าข้อผิดพลาดนั้นอยู่ในความรับผิดชอบของทีมมือถือ ทีมการตรวจสอบสิทธิ์ด้านหลัง หรือทีมแพลตฟอร์ม ข้อผิดพลาดนั้นจะถูกส่งกลับ และทุกครั้งที่ข้อผิดพลาดถูกส่งกลับ บริบทจะถูกตั้งใหม่
ความแตกต่างของเขตเวลาทำให้ปัญหานี้ยิ่งซับซ้อนขึ้น: ข้อผิดพลาดที่รายงานมาในช่วงปลายวันโดยไม่มีผู้รับผิดชอบที่ระบุชื่อ อาจสูญเวลาไป 12–24 ชั่วโมงก่อนที่ใครจะเริ่มตรวจสอบซ้ำได้ การกำหนดให้ชัดเจนว่า “ใครรับผิดชอบเรื่องอะไร” พร้อมกับการกำหนดผู้รับผิดชอบหลัก (DRI) ที่พร้อมรับมือหรือตามสัปดาห์ จะช่วยขจัดปัญหาการล่าช้านี้
ความสามารถในการทำซ้ำขึ้นอยู่กับความสามารถในการสังเกต
บันทึกที่ไม่ครบถ้วน รหัสความสัมพันธ์ที่ขาดหายไป หรือการขาดข้อมูลการติดตามการเกิดข้อผิดพลาด ทำให้การวินิจฉัยกลายเป็นเพียงการคาดเดา ข้อผิดพลาดที่ปรากฏขึ้นเฉพาะเมื่อมีแฟล็ก ผู้เช่า หรือรูปแบบข้อมูลเฉพาะ ยากที่จะจำลองขึ้นในสภาพแวดล้อมการพัฒนา
หากวิศวกรไม่สามารถเข้าถึงข้อมูลที่ผ่านการกรองและปลอดภัย ซึ่งคล้ายกับข้อมูลในสภาพแวดล้อมการผลิต ได้อย่างปลอดภัย พวกเขาจะต้องดำเนินการติดตั้งเครื่องมือวัดผล ปรับใช้ระบบใหม่ และรอคอย—เป็นเวลาหลายวันแทนที่จะเป็นเพียงไม่กี่ชั่วโมง
ความสอดคล้องของสภาพแวดล้อมและข้อมูลช่วยให้คุณทำงานอย่างโปร่งใส
“ทำงานได้บนเครื่องของฉัน” มักหมายถึง “ข้อมูลในระบบผลิตจริงนั้นต่างกัน” ยิ่งสภาพแวดล้อมการพัฒนา/ทดสอบ (dev/staging) ของคุณแตกต่างจากระบบผลิตจริง (การตั้งค่า, บริการ, เวอร์ชันของซอฟต์แวร์จากผู้พัฒนาภายนอก) มากเท่าไร คุณก็ยิ่งต้องเสียเวลาไปกับการตามหาปัญหาที่ไม่มีอยู่จริงมากขึ้นเท่านั้น การใช้สแนปช็อตข้อมูลที่ปลอดภัย สคริปต์เริ่มต้น (seed scripts) และการตรวจสอบความสอดคล้อง (parity checks) จะช่วยลดช่องว่างนั้นได้
งานที่กำลังดำเนินการ (WIP) และการมุ่งเน้นช่วยเพิ่มประสิทธิภาพการทำงานจริง
ทีมที่ทำงานเกินกำลังต้องรับมือกับข้อผิดพลาดจำนวนมากในครั้งเดียว ทำให้ความสนใจถูกแบ่งแยก และต้องสลับไปมาระหว่างงานและประชุม การเปลี่ยนบริบททำให้เวลาทำงานเพิ่มขึ้นอย่างไม่เห็นได้ชัด
การกำหนดขีดจำกัดงานที่กำลังดำเนินการ (WIP) ที่ชัดเจน และการให้ความสำคัญกับการเสร็จสิ้นงานที่เริ่มไว้ก่อนที่จะรับงานใหม่ จะช่วยลดค่ามัธยฐานได้เร็วกว่าความพยายามของบุคคลใดบุคคลหนึ่งเพียงคนเดียว
การตรวจสอบโค้ด (Code review), CI และความเร็วของ QA เป็นจุดคอขวดที่พบเห็นได้บ่อย
เวลาสร้างที่ช้า การทดสอบที่ไม่เสถียร และ SLA การตรวจสอบที่ไม่ชัดเจน ทำให้การแก้ไขที่ปกติแล้วจะรวดเร็วต้องล่าช้า แพตช์ที่ใช้เวลาเพียง 10 นาที อาจต้องรอผู้ตรวจสอบถึงสองวัน หรือต้องรอคิวในกระบวนการที่กินเวลาหลายชั่วโมง
ในทำนองเดียวกัน คิว QA ที่ทำการทดสอบแบบเป็นชุด หรือพึ่งพาการทดสอบแบบสโมคแบบแมนนวล อาจทำให้ระยะเวลาจาก “Reported → Closed” ยืดออกไปเป็นทั้งวัน แม้ระยะเวลาจาก “Reported → Resolved” จะรวดเร็วเพียงใดก็ตาม
ความพึ่งพากันทำให้คิวงานยาวขึ้น
การเปลี่ยนแปลงข้ามทีม (สคีมา การย้ายแพลตฟอร์ม การอัปเดต SDK) ข้อผิดพลาดจากผู้จัดหา หรือการตรวจสอบในแอปสโตร์ (มือถือ) จะก่อให้เกิดสถานะการรอคอย หากไม่มีการติดตามสถานะ “ถูกบล็อก/ถูกหยุดชั่วคราว” อย่างชัดเจน สถานะการรอคอยเหล่านี้จะทำให้ค่าเฉลี่ยของคุณเพิ่มขึ้นอย่างไม่เห็นได้ชัด และทำให้จุดคอขวดที่แท้จริงถูกซ่อนอยู่
แบบการปล่อยเวอร์ชันและกลยุทธ์การย้อนกลับมีความสำคัญ
หากคุณปล่อยอัปเดตเป็นชุดใหญ่ด้วยขั้นตอนการตรวจสอบแบบมือ แม้ข้อผิดพลาดที่แก้ไขแล้วก็จะถูกเก็บไว้จนกว่าชุดอัปเดตถัดไปจะปล่อยออก ฟีเจอร์แฟล็ก การปล่อยแบบคานารี และช่องทางแก้ไขด่วน (hotfix lanes) จะช่วยลดเวลาที่ค้างอยู่ — โดยเฉพาะสำหรับเหตุการณ์ระดับ P0/P1 — โดยให้คุณสามารถแยกการปรับใช้การแก้ไขออกจากวงจรการปล่อยอัปเดตเต็มรูปแบบ
สถาปัตยกรรมและหนี้ทางเทคโนโลยีกำหนดขีดจำกัดของคุณ
การเชื่อมโยงที่แน่นเกินไป การขาดจุดเชื่อมต่อสำหรับการทดสอบ และโมดูลเก่าที่ไม่โปร่งใส ทำให้การแก้ไขปัญหาที่ดูเรียบง่ายกลายเป็นเรื่องเสี่ยง ทีมต้องชดเชยด้วยการทดสอบเพิ่มเติมและการทบทวนที่ยาวนานขึ้น ซึ่งทำให้วงจรการพัฒนาล่าช้าลง ในทางตรงกันข้าม โค้ดแบบโมดูลที่มีการทดสอบสัญญาที่ดี ช่วยให้คุณสามารถดำเนินการได้อย่างรวดเร็วโดยไม่ทำให้ระบบที่อยู่ใกล้เคียงเสียหาย
การสื่อสารและการจัดการสถานะอย่างถูกต้องมีอิทธิพลต่อความสามารถในการคาดการณ์
การอัปเดตที่ไม่ชัดเจน (“กำลังตรวจสอบอยู่”) จะก่อให้เกิดงานซ้ำเมื่อผู้เกี่ยวข้องสอบถามเวลาคาดการณ์การแก้ไข (ETA), ทีมสนับสนุนต้องเปิดตั๋วใหม่ หรือฝ่ายผลิตภัณฑ์ต้องส่งเรื่องขึ้นระดับสูง การเปลี่ยนสถานะที่ชัดเจน, หมายเหตุเกี่ยวกับวิธีการสร้างปัญหาและสาเหตุหลัก รวมถึงการโพสต์เวลาคาดการณ์การแก้ไข (ETA) จะช่วยลดการสูญเสียลูกค้าและรักษาความมุ่งเน้นของทีมวิศวกรรมของคุณ
📮ClickUp Insight: ผู้ทำงานมืออาชีพใช้เวลามากกว่า 30 นาทีต่อวันในการค้นหาข้อมูลที่เกี่ยวข้องกับงาน — ซึ่งเท่ากับสูญเสียเวลามากกว่า 120 ชั่วโมงต่อปีไปกับการค้นหาในอีเมล บทสนทนาใน Slack และไฟล์ที่กระจัดกระจาย
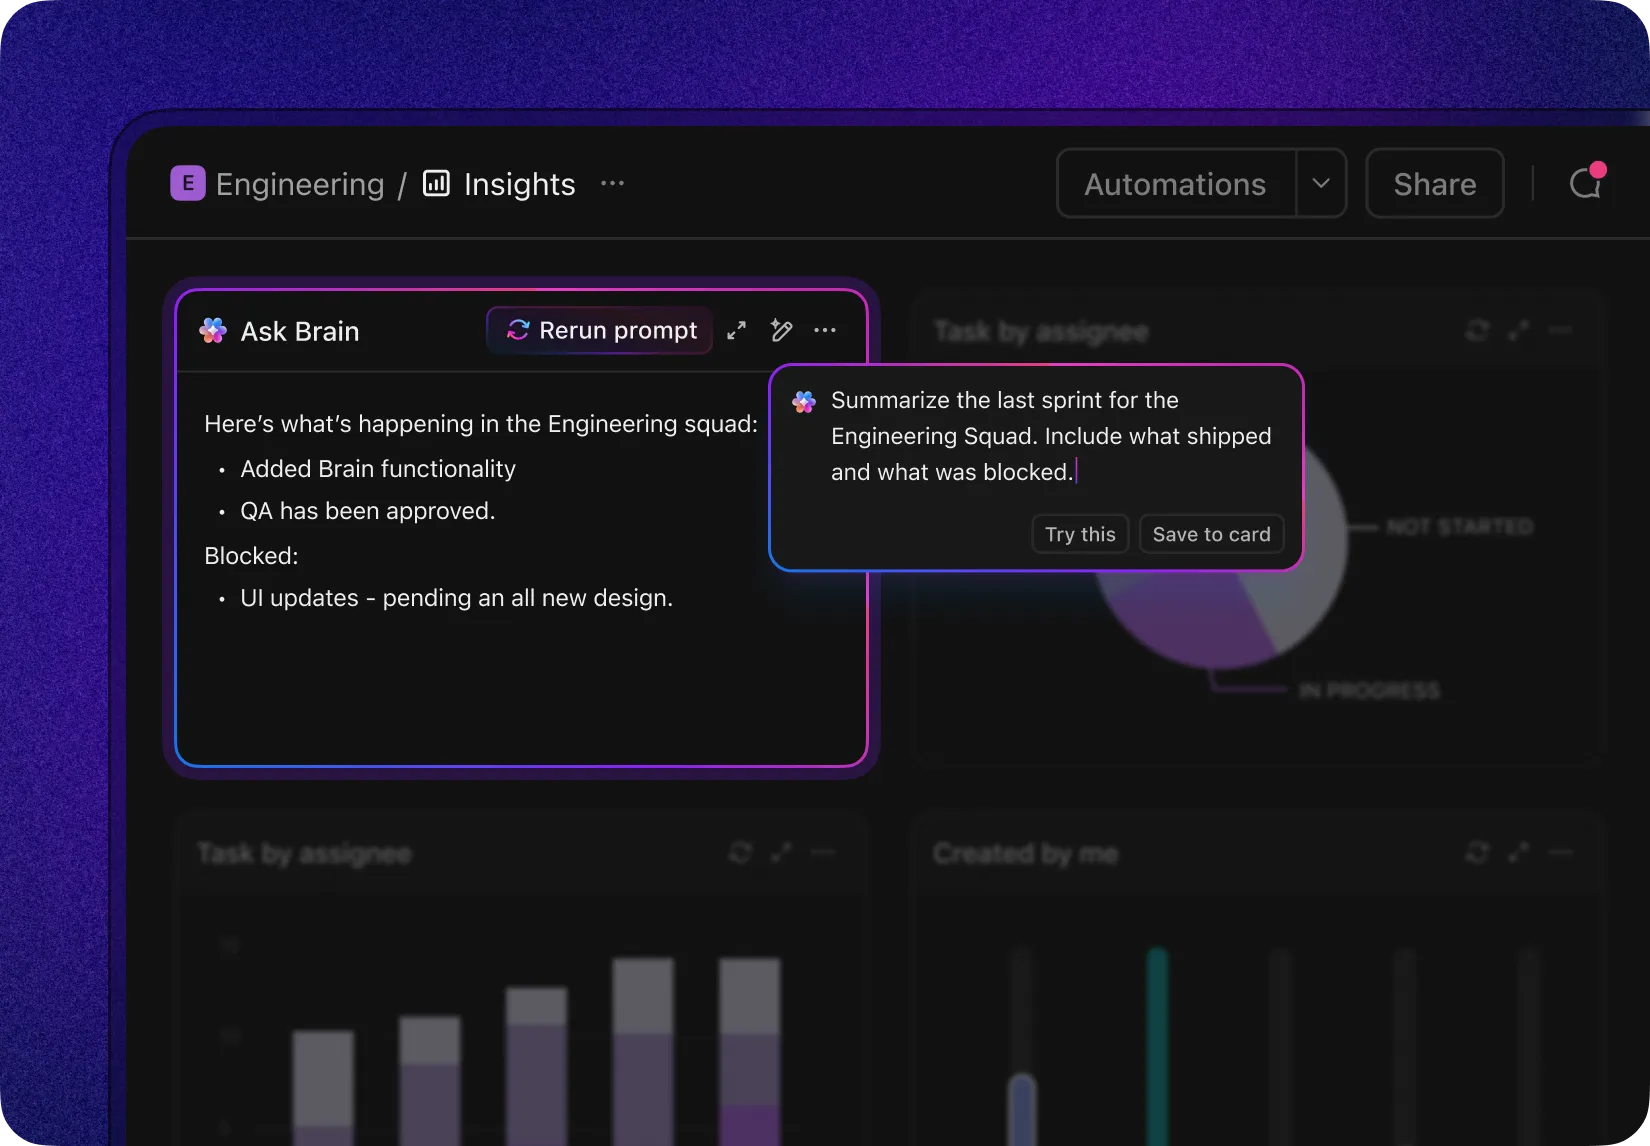
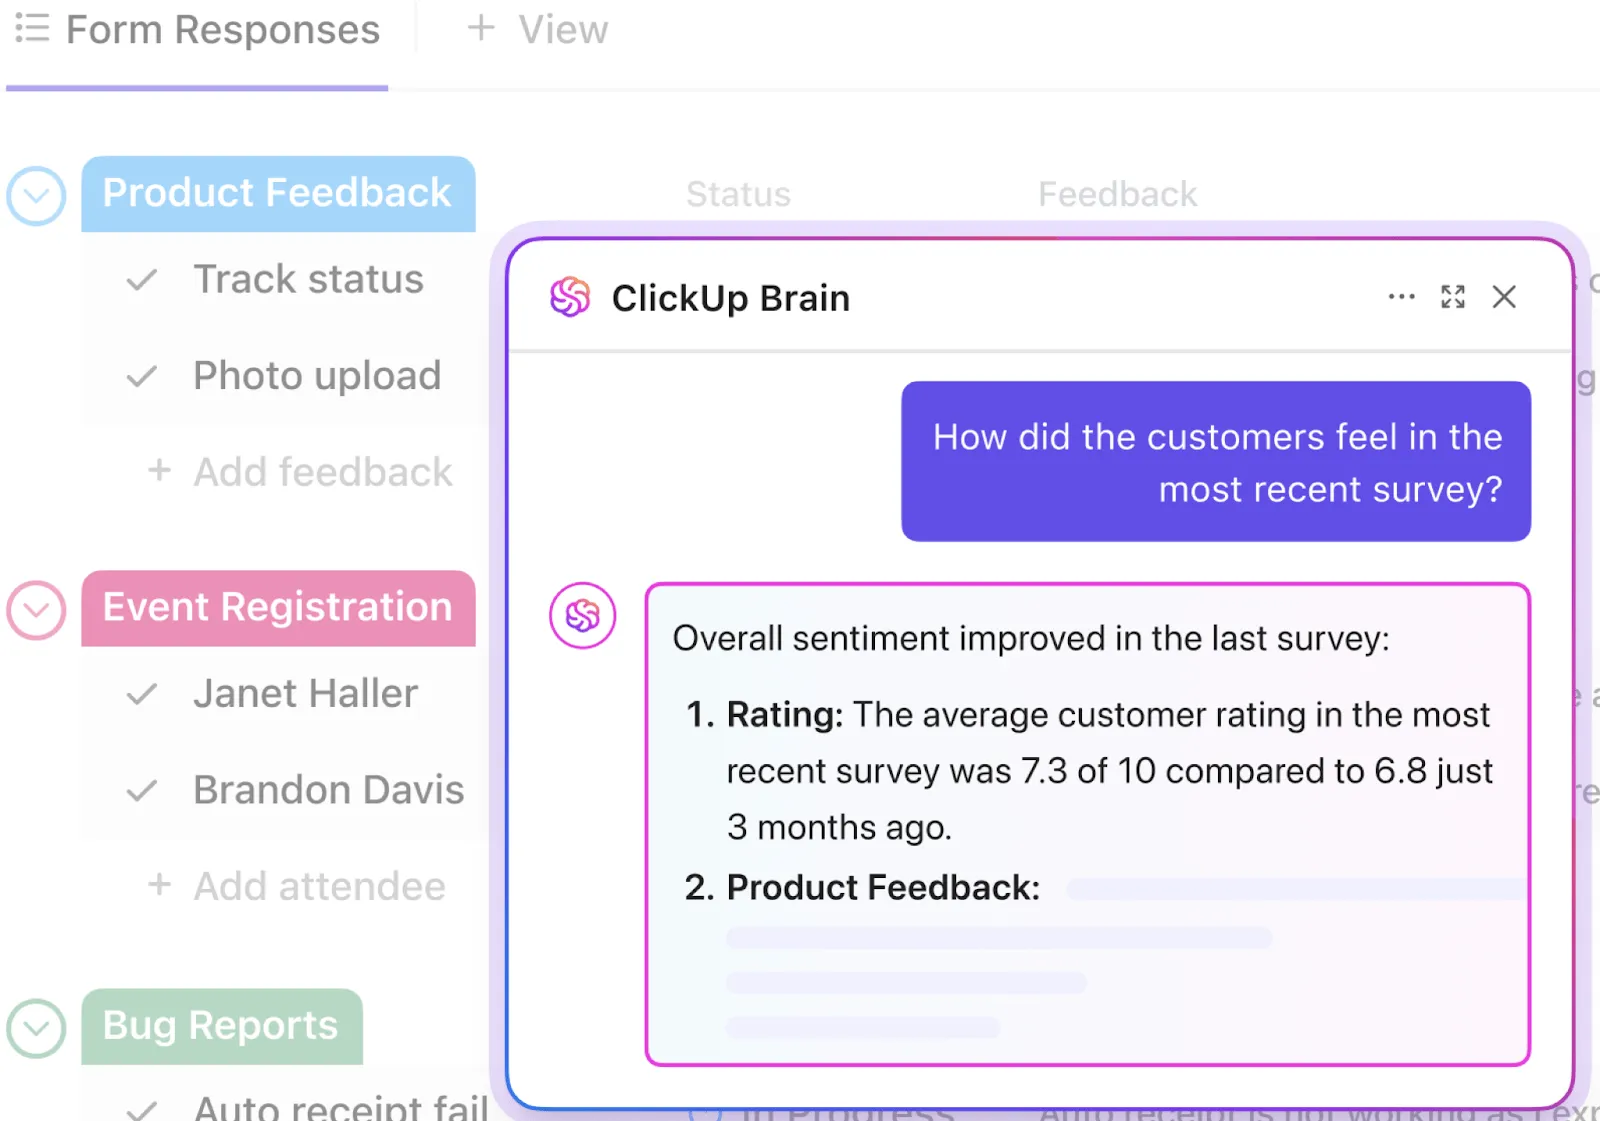
ผู้ช่วย AI อัจฉริยะที่ฝังอยู่ในพื้นที่ทำงานของคุณสามารถเปลี่ยนสิ่งนั้นได้ พบกับClickUp Brain ซึ่งให้ข้อมูลเชิงลึกและคำตอบทันที โดยแสดงเอกสาร การสนทนา และรายละเอียดงานที่ถูกต้องภายในไม่กี่วินาที — ทำให้คุณไม่ต้องเสียเวลาค้นหาอีกต่อไป และสามารถเริ่มทำงานได้ทันที
💫 ผลลัพธ์จริง: ทีมอย่าง QubicaAMF ได้ประหยัดเวลาได้มากกว่า 5 ชั่วโมงต่อสัปดาห์ด้วย ClickUp — ซึ่งเท่ากับมากกว่า 250 ชั่วโมงต่อปีต่อคน — โดยการกำจัดกระบวนการจัดการความรู้ที่ล้าสมัย ลองจินตนาการดูว่าทีมของคุณจะสามารถสร้างผลงานอะไรได้บ้าง หากมีเวลาทำงานเพิ่มอีกหนึ่งสัปดาห์ทุกไตรมาส!
ตัวชี้วัดล่วงหน้าว่าเวลาแก้ไขปัญหาของคุณจะล่าช้า
❗️“Time to Acknowledge” ที่เพิ่มขึ้น และตั๋วจำนวนมากที่ไม่มีผู้รับผิดชอบเป็นเวลามากกว่า 12 ชั่วโมง
❗️ช่วงเวลา “Time in Review/CI” ที่เพิ่มขึ้นอย่างต่อเนื่อง และผลการทดสอบที่ไม่เสถียรบ่อยครั้ง
❗️อัตราการซ้ำซ้อนสูงในขั้นตอนการรับเรื่อง และระดับความรุนแรงที่ไม่สอดคล้องกันระหว่างทีมต่างๆ
❗️มีข้อผิดพลาดหลายข้อที่อยู่ในสถานะ “Blocked” โดยไม่มีการระบุความพึ่งพาภายนอก
❗️อัตราการเปิดใหม่เพิ่มขึ้นอย่างค่อยเป็นค่อยไป (การแก้ไขไม่สามารถทำซ้ำได้ หรือนิยามของ "เสร็จสิ้น" ไม่ชัดเจน)
องค์กรต่าง ๆ มีมุมมองต่อปัจจัยเหล่านี้แตกต่างกัน ผู้บริหารมองว่าปัจจัยเหล่านี้เป็นวงจรการเรียนรู้ที่พลาดไปและการล่าช้าในการสร้างรายได้ ส่วนผู้ปฏิบัติงานมองว่าปัจจัยเหล่านี้เป็นความสับสนในการจัดลำดับความสำคัญและไม่ชัดเจนในเรื่องความรับผิดชอบ
การปรับแต่งการรับเรื่อง, กระบวนการทำงาน และความสัมพันธ์ระหว่างขั้นตอน คือวิธีที่จะช่วยลดทั้งเส้นโค้ง — ค่ามัธยฐานและ P90 — ลง
อยากรู้เพิ่มเติมเกี่ยวกับการเขียนรายงานข้อผิดพลาดให้ดีขึ้น? เริ่มจากที่นี่เลย 👇🏼
📖 อ่านเพิ่มเติม: วงจรชีวิตการทดสอบซอฟต์แวร์ (STLC): ภาพรวมและขั้นตอน
มาตรฐานอุตสาหกรรมสำหรับเวลาแก้ไขข้อผิดพลาด
เกณฑ์มาตรฐานการแก้ไขข้อผิดพลาดจะเปลี่ยนแปลงไปตามระดับความทนต่อความเสี่ยง แบบการปล่อยเวอร์ชัน และความเร็วในการส่งการเปลี่ยนแปลง
ที่นี่คุณสามารถใช้ค่ามัธยฐาน (P50) เพื่อเข้าใจกระบวนการทำงานทั่วไป และใช้ P90 เพื่อกำหนดคำสัญญาและ SLA — ตามระดับความรุนแรงและแหล่งที่มา (ลูกค้า, QA, การเฝ้าติดตาม)
มาดูรายละเอียดกันว่าสิ่งนี้หมายความว่าอย่างไร:
| 🔑 คำศัพท์ | 📝 คำอธิบาย | 💡 ทำไมเรื่องนี้จึงสำคัญ |
|---|---|---|
| P50 (ค่ามัธยฐาน) | ค่ากลาง — 50% ของการแก้ไขข้อผิดพลาดเสร็จสิ้นเร็วกว่าค่านี้ และ 50% ช้ากว่าค่านี้ | 👉 แสดงเวลาแก้ไขปัญหาแบบทั่วไปหรือที่พบบ่อยที่สุด เหมาะสำหรับการเข้าใจประสิทธิภาพการทำงานปกติ |
| P90 (เปอร์เซ็นไทล์ที่ 90) | 90% ของข้อผิดพลาดได้รับการแก้ไขภายในช่วงเวลานี้ ส่วนที่เหลือเพียง 10% เท่านั้นที่ใช้เวลานานกว่า | 👉 แสดงถึงขอบเขตกรณีที่เลวที่สุด (แต่ยังคงเป็นไปได้จริง) มีประโยชน์สำหรับการกำหนดคำมั่นสัญญาต่อฝ่ายภายนอก |
| SLA (ข้อตกลงระดับบริการ) | คำมั่นสัญญาที่คุณให้ไว้—ทั้งภายในองค์กรหรือต่อลูกค้า—เกี่ยวกับความเร็วในการแก้ไขปัญหา | 👉 ตัวอย่าง: “เราแก้ไขข้อผิดพลาดระดับ P1 ภายใน 48 ชั่วโมง ใน 90% ของกรณี” ช่วยสร้างความเชื่อมั่นและความรับผิดชอบ |
| ตามระดับความรุนแรงและแหล่งที่มา | แบ่งตัวชี้วัดของคุณตามสองมิติหลัก: • ระดับความรุนแรง (เช่น P0, P1, P2) • แหล่งที่มา (เช่น ลูกค้า, QA, การเฝ้าติดตาม) | 👉 ช่วยให้การติดตามและจัดลำดับความสำคัญเป็นไปอย่างแม่นยำยิ่งขึ้น ทำให้ข้อผิดพลาดที่สำคัญได้รับความสนใจอย่างรวดเร็ว |
ด้านล่างนี้เป็นช่วงค่าประมาณตามอุตสาหกรรมที่ทีมที่มีประสบการณ์มักตั้งเป้าหมายไว้; ให้ใช้ช่วงค่าเหล่านี้เป็นจุดเริ่มต้น แล้วปรับให้เหมาะสมกับบริบทของคุณ
SaaS
ระบบทำงานตลอดเวลาและรองรับ CI/CD จึงมีการออก hotfix บ่อยครั้ง ปัญหาสำคัญ (P0/P1) มักตั้งเป้าหมายให้ค่ามัธยฐานอยู่ภายในหนึ่งวันทำงาน โดย P90 อยู่ภายใน 24–48 ชั่วโมง ส่วนปัญหาไม่สำคัญ (P2+) มักมีค่ามัธยฐานอยู่ที่ 3–7 วัน โดย P90 อยู่ภายใน 10–14 วัน ทีมที่มี feature flags ที่แข็งแกร่งและระบบทดสอบอัตโนมัติจะมีแนวโน้มใช้เวลาแก้ไขปัญหาได้เร็วขึ้น
แพลตฟอร์มอีคอมเมิร์ซ
เนื่องจากกระบวนการแปลงเป็นลูกค้าและกระบวนการในตะกร้าสินค้ามีความสำคัญต่อรายได้ จึงมีมาตรฐานที่สูงขึ้น ปัญหา P0/P1 มักได้รับการแก้ไขเบื้องต้นภายในไม่กี่ชั่วโมง (การย้อนกลับ, การทำเครื่องหมาย, หรือการปรับตั้งค่า) และแก้ไขอย่างสมบูรณ์ภายในวันเดียวกัน; ส่วน P90 มักจะแก้ไขได้ภายในสิ้นวันหรือภายใน <12 ชั่วโมงในช่วงฤดูกาลที่มีปริมาณงานสูง ปัญหา P2+ มักจะแก้ไขได้ภายใน 2–5 วัน โดย P90 จะแก้ไขได้ภายใน 10 วัน
ซอฟต์แวร์ระดับองค์กร
กระบวนการตรวจสอบที่เข้มงวดขึ้นและช่วงเวลาที่ลูกค้าสามารถเปลี่ยนแปลงได้ทำให้ความเร็วในการดำเนินการลดลง สำหรับ P0/P1 ทีมตั้งเป้าหมายที่จะหาวิธีแก้ไขชั่วคราวภายใน 4–24 ชั่วโมง และแก้ไขปัญหาอย่างถาวรภายใน 1–3 วันทำการ ส่วน P90 ภายใน 5 วันทำการ ส่วน P2+ มักถูกรวมเป็นชุดเพื่อส่งในรอบการปล่อยเวอร์ชัน (release trains) โดยค่ามัธยฐานอยู่ที่ 2–4 สัปดาห์ ขึ้นอยู่กับกำหนดการเปิดตัวของลูกค้า
เกมและแอปมือถือ
ระบบแบ็กเอนด์ของบริการแบบเรียลไทม์ทำงานคล้ายกับ SaaS (การเปิดใช้งานฟีเจอร์และย้อนกลับการเปลี่ยนแปลงภายในไม่กี่นาทีถึงไม่กี่ชั่วโมง; P90 ภายในวันเดียวกัน) การอัปเดตฝั่งไคลเอนต์ถูกจำกัดโดยการตรวจสอบของร้านค้า: P0/P1 มักใช้กลไกฝั่งเซิร์ฟเวอร์ทันทีและปล่อยแพตช์ฝั่งไคลเอนต์ภายใน 1–3 วัน; P90 ภายในหนึ่งสัปดาห์หากผ่านการตรวจสอบแบบเร่งด่วน ส่วนการแก้ไข P2+ มักถูกจัดเข้าในสปรินต์ถัดไปหรือการปล่อยเนื้อหาครั้งต่อไป
ธนาคาร/ฟินเทค
ขั้นตอนการควบคุมความเสี่ยงและการปฏิบัติตามกฎระเบียบช่วยสร้างรูปแบบ “แก้ไขปัญหาอย่างรวดเร็ว ปรับเปลี่ยนอย่างระมัดระวัง” ปัญหา P0/P1 จะได้รับการแก้ไขอย่างรวดเร็ว (การตั้งค่าสถานะเตือน การย้อนกลับการเปลี่ยนแปลง การเปลี่ยนทิศทางการจราจรภายในไม่กี่นาทีถึงไม่กี่ชั่วโมง) และแก้ไขอย่างสมบูรณ์ภายใน 1–3 วัน; ส่วน P90 จะแก้ไขภายในหนึ่งสัปดาห์ โดยคำนึงถึงการควบคุมการเปลี่ยนแปลง ปัญหา P2+ มักใช้เวลา 2–6 สัปดาห์เพื่อผ่านการตรวจสอบด้านความปลอดภัย การตรวจสอบภายใน และการทบทวนของคณะกรรมการประเมินความเสี่ยง (CAB)
หากตัวเลขของคุณอยู่นอกช่วงเหล่านี้ ให้ตรวจสอบคุณภาพการรับเรื่อง การจัดเส้นทาง/ความรับผิดชอบ การตรวจสอบโค้ดและประสิทธิภาพการควบคุมคุณภาพ (QA) รวมถึงการอนุมัติความพึ่งพา ก่อนที่จะสันนิษฐานว่า “ความเร็วของฝ่ายวิศวกรรม” เป็นปัญหาหลัก
🌼 คุณรู้หรือไม่: ตามผลสำรวจของStack Overflow ปี 2024 นักพัฒนาใช้ AI เป็นผู้ช่วยที่เชื่อถือได้มากขึ้นเรื่อยๆ ตลอดกระบวนการเขียนโค้ด มีถึง 82% ที่ใช้ AI เพื่อเขียนโค้ดจริง ๆ — เรียกได้ว่าเป็นผู้ร่วมมือที่สร้างสรรค์! เมื่อติดขัดหรือกำลังหาทางแก้ไข 67.5% พึ่งพา AI เพื่อค้นหาคำตอบ และมากกว่าครึ่ง (56.7%) พึ่งพา AI เพื่อดีบักและขอความช่วยเหลือ
สำหรับบางคน เครื่องมือ AI ยังพิสูจน์แล้วว่ามีประโยชน์ในการบันทึกข้อมูลโครงการ (40. 1%) และแม้กระทั่งการสร้างข้อมูลหรือเนื้อหาสังเคราะห์ (34. 8%) อยากรู้เกี่ยวกับโค้ดเบสใหม่หรือไม่? เกือบหนึ่งในสาม (30. 9%) ใช้ AI เพื่อทำความเข้าใจอย่างรวดเร็ว การทดสอบโค้ดยังคงเป็นงานที่ต้องทำด้วยมือสำหรับหลายคน แต่ 27. 2% ได้นำ AI มาใช้ในด้านนี้ด้วย ส่วนด้านอื่น ๆ เช่น การตรวจสอบโค้ด การวางแผนโครงการ และการวิเคราะห์เชิงคาดการณ์ มีระดับการนำ AI มาใช้ที่ต่ำกว่า แต่ชัดเจนว่า AI กำลังค่อย ๆ แทรกซึมเข้าไปในทุกขั้นตอนของการพัฒนาซอฟต์แวร์
📖 อ่านเพิ่มเติม: วิธีใช้ AI ในการประกันคุณภาพ
วิธีลดเวลาแก้ไขข้อผิดพลาด
ความเร็วในการแก้ไขข้อผิดพลาดขึ้นอยู่กับการขจัดอุปสรรคในทุกขั้นตอนการส่งต่องาน ตั้งแต่การรับเรื่องจนถึงการปล่อยเวอร์ชัน
ผลประโยชน์ที่ใหญ่ที่สุดมาจากการทำให้ 30 นาทีแรกมีประสิทธิภาพมากขึ้น (การรับเรื่องที่ชัดเจน, กำหนดผู้รับผิดชอบที่ถูกต้อง, กำหนดลำดับความสำคัญที่ถูกต้อง) แล้วลดระยะเวลาของขั้นตอนที่ตามมา (การจำลองปัญหา, การตรวจสอบ, การยืนยัน)
นี่คือ 9 กลยุทธ์ที่ทำงานร่วมกันเป็นระบบ AI ช่วยเร่งความเร็วในแต่ละขั้นตอน และกระบวนการทำงานถูกรวมไว้ในที่เดียวอย่างเป็นระเบียบ ทำให้ผู้บริหารสามารถคาดการณ์ได้ และผู้ปฏิบัติงานสามารถทำงานได้อย่างราบรื่น
1. รวมศูนย์การรับแจ้งปัญหาและบันทึกบริบทจากแหล่งต้นทาง
เวลาแก้ไขข้อผิดพลาดจะยืดยาวขึ้นเมื่อคุณต้องสร้างบริบทใหม่จากสายสนทนาใน Slack ตั๋วสนับสนุน และสเปรดชีต รวมรายงานทุกประเภท—สนับสนุน QA การเฝ้าติดตาม—เข้าในคิวเดียวด้วยเทมเพลตที่มีโครงสร้าง ซึ่งรวบรวมข้อมูลเกี่ยวกับส่วนประกอบ ระดับความรุนแรง สภาพแวดล้อม เวอร์ชัน/บิลด์ของแอป ขั้นตอนการจำลองข้อผิดพลาด ผลที่คาดไว้เทียบกับผลจริง และไฟล์แนบ (บันทึก/HAR/ภาพหน้าจอ)
AI สามารถสรุปเนื้อหาของรายงานที่ยาวได้โดยอัตโนมัติ สกัดขั้นตอนการจำลองปัญหาและรายละเอียดสภาพแวดล้อมจากไฟล์แนบ และทำเครื่องหมายให้ทราบถึงกรณีที่อาจซ้ำกัน เพื่อให้กระบวนการคัดกรองเริ่มต้นจากข้อมูลที่ครบถ้วนและชัดเจน
ตัวชี้วัดที่ควรติดตาม: MTTA (รับทราบภายในไม่กี่นาที ไม่ใช่หลายชั่วโมง), อัตราการซ้ำซ้อน, เวลาที่แสดงว่า “ต้องการข้อมูลเพิ่มเติม”
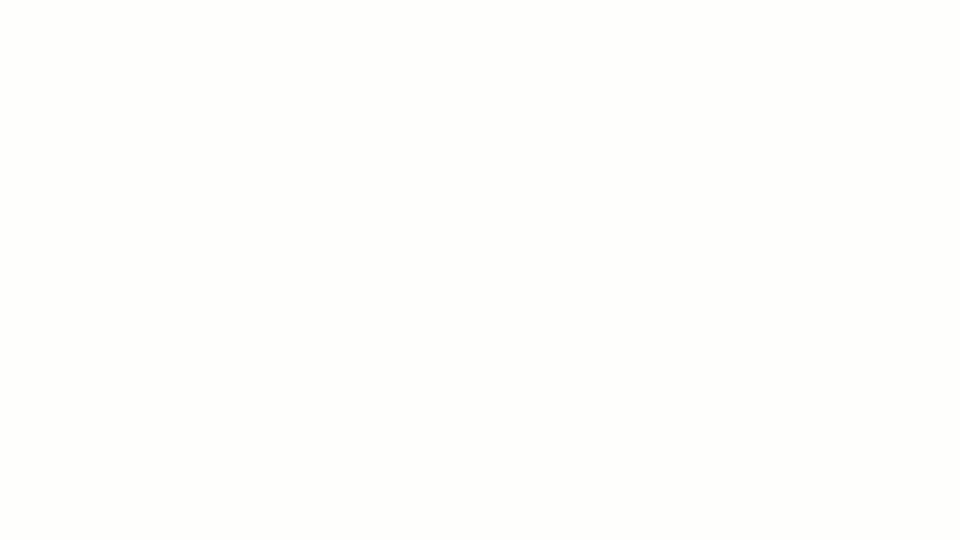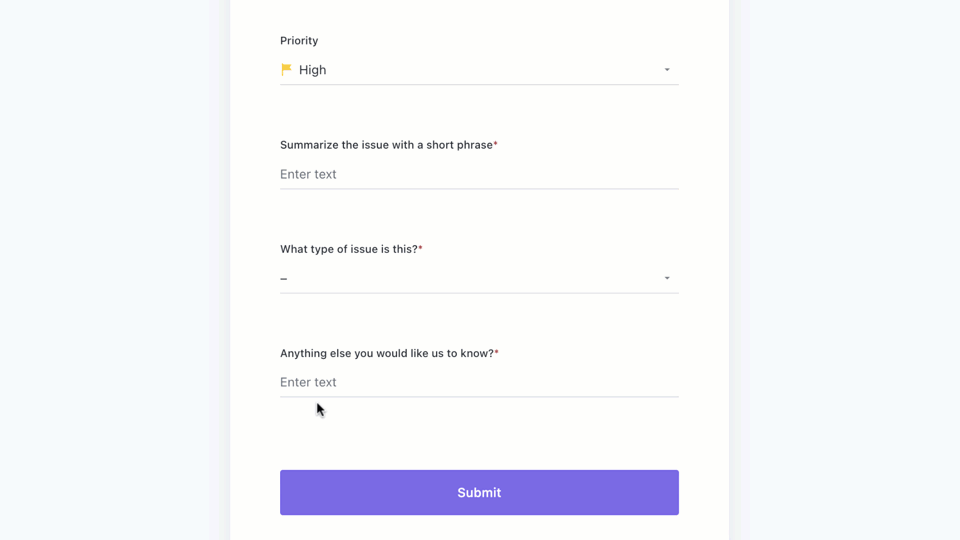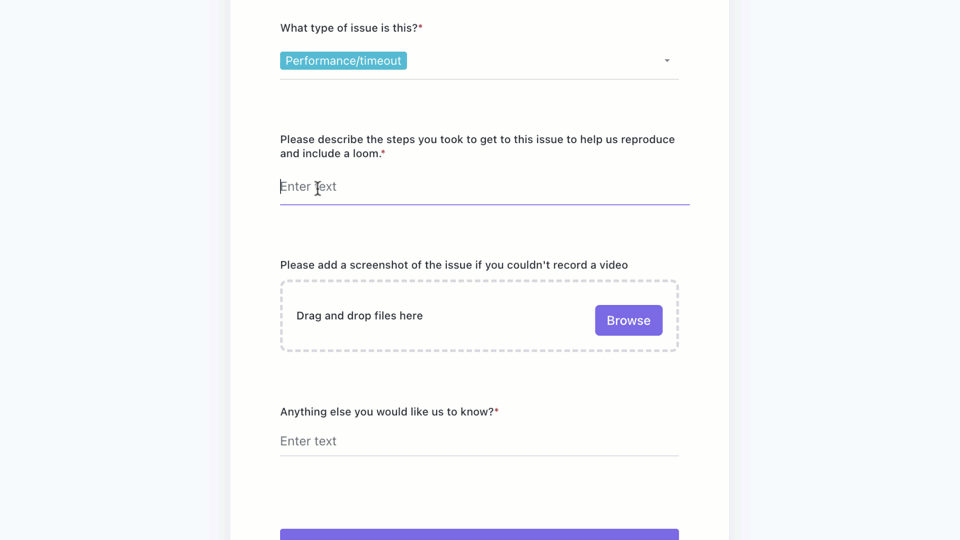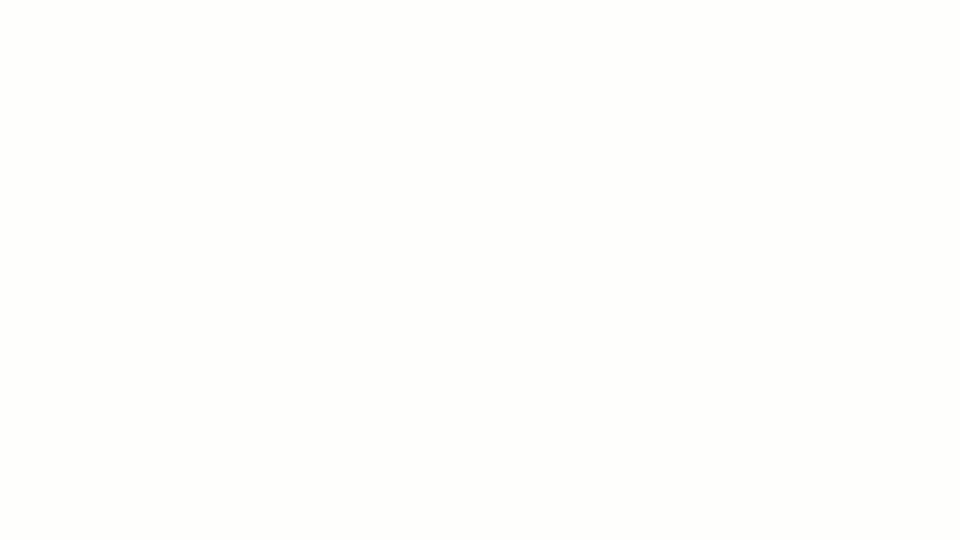
📖 อ่านเพิ่มเติม: ความสามารถของ ClickUp Forms: การปรับปรุงกระบวนการทำงานให้ราบรื่นสำหรับทีมพัฒนาซอฟต์แวร์
2. การจัดลำดับความสำคัญและการส่งต่อด้วย AI เพื่อลด MTTA อย่างมีนัยสำคัญ
การแก้ไขที่เร็วที่สุดคือกรณีที่ส่งถึงโต๊ะทำงานที่ถูกต้องทันที
ใช้กฎง่ายๆ ร่วมกับ AI เพื่อจัดประเภทความรุนแรง ระบุผู้รับผิดชอบที่อาจเกี่ยวข้องตามส่วนประกอบ/พื้นที่โค้ด และจัดสรรงานอัตโนมัติด้วยนาฬิกา SLA กำหนดช่องทางที่ชัดเจนสำหรับ P0/P1 เทียบกับงานอื่นๆ และทำให้เรื่อง “ใครเป็นผู้รับผิดชอบ” ไม่มีความคลุมเครือ
ระบบอัตโนมัติสามารถกำหนดลำดับความสำคัญจากข้อมูลในฟิลด์, ส่งต่อตามส่วนประกอบไปยังทีมเฉพาะ, เริ่มนับเวลา SLA และแจ้งเตือนวิศวกรที่รับเวร; AI สามารถเสนอระดับความรุนแรงและผู้รับผิดชอบตามรูปแบบในอดีต เมื่อการคัดกรองกลายเป็นกระบวนการที่ใช้เวลาเพียง 2–5 นาที แทนที่จะเป็นการอภิปรายที่ใช้เวลา 30 นาที MTTA ของคุณจะลดลง และ MTTR ก็จะลดลงตามไปด้วย
ตัวชี้วัดที่ควรติดตาม: MTTA, คุณภาพการตอบกลับครั้งแรก (คำขอข้อมูลในข้อความแรกมีข้อมูลที่ถูกต้องหรือไม่?), จำนวนการส่งต่อต่อข้อผิดพลาด
นี่คือตัวอย่างการใช้งานจริง:
3. จัดลำดับความสำคัญตามผลกระทบต่อธุรกิจด้วยระดับ SLA ที่ชัดเจน
หลักการ “เสียงที่ดังที่สุดคือผู้ชนะ” ทำให้คิวงานกลายเป็นสิ่งที่คาดการณ์ไม่ได้ และทำลายความเชื่อมั่นของผู้บริหารที่กำลังติดตามตัวชี้วัด CSAT/NPS และการต่อสัญญา
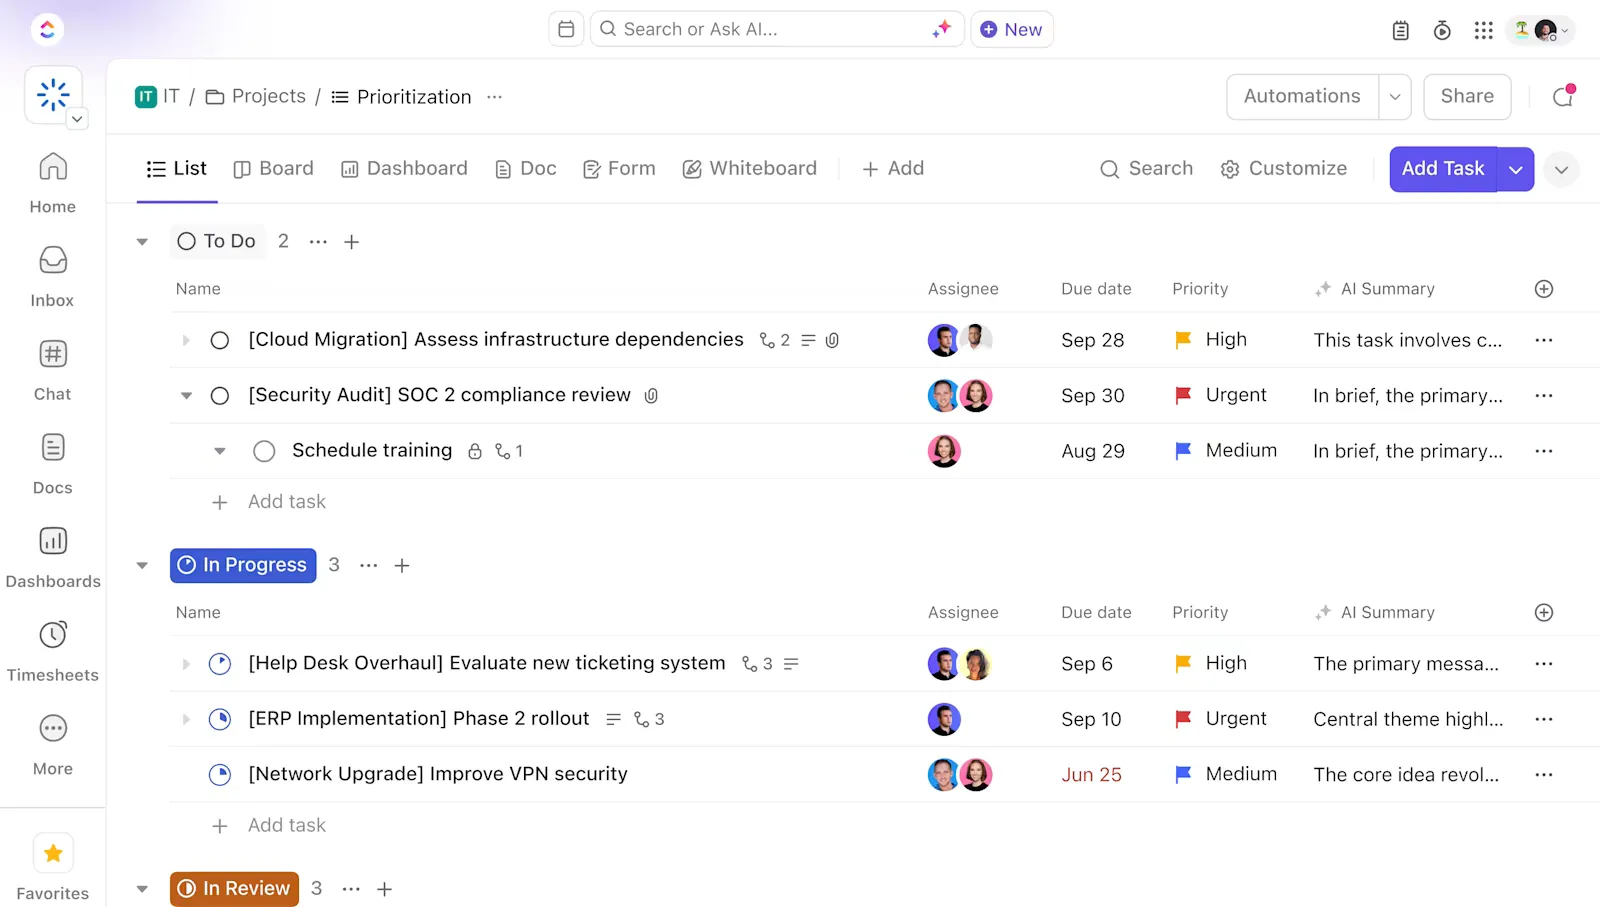
แทนที่ด้วยคะแนนที่รวมความรุนแรง ความถี่ ARR ที่ได้รับผลกระทบ ความสำคัญของฟีเจอร์ และความใกล้กับช่วงเวลาต่ออายุ/การเปิดตัว — และสนับสนุนด้วยระดับ SLA (เช่น P0: บรรเทาภายใน 1–2 ชั่วโมง แก้ไขภายในหนึ่งวัน; P1: ภายในวันเดียวกัน; P2: ภายในสปรินต์)
รักษาช่องทาง P0/P1 ให้มองเห็นได้ชัดเจนพร้อมขีดจำกัด WIP เพื่อไม่ให้งานใดถูกทิ้งไว้โดยไม่ได้รับการจัดการ
ตัวชี้วัดที่ควรติดตาม: P50/P90 การแก้ไขตามระดับ, อัตราการละเมิด SLA, ความสัมพันธ์กับ CSAT/NPS.
💡เคล็ดลับ:ฟิลด์ลำดับความสำคัญของงาน (Task Priorities),ฟิลด์ที่กำหนดเอง (Custom Fields)และฟิลด์ความสัมพันธ์ (Dependencies) ของ ClickUp ช่วยให้คุณสามารถคำนวณคะแนนผลกระทบและเชื่อมโยงข้อบกพร่องกับบัญชีผู้ใช้, ข้อเสนอแนะ หรือรายการในแผนงานได้ นอกจากนี้ เป้าหมาย (Goals) ใน ClickUpยังช่วยคุณเชื่อมโยงการปฏิบัติตาม SLA กับเป้าหมายระดับบริษัท ซึ่งช่วยตอบข้อกังวลของผู้บริหารเกี่ยวกับความสอดคล้องโดยตรง
4. ทำให้การจำลองปัญหาและการวินิจฉัยเป็นกิจกรรมที่เสร็จสิ้นในขั้นตอนเดียว
ทุกครั้งที่ถามซ้ำว่า “ส่งบันทึกการทำงานได้ไหม?” จะทำให้เวลาแก้ไขปัญหาเพิ่มขึ้น
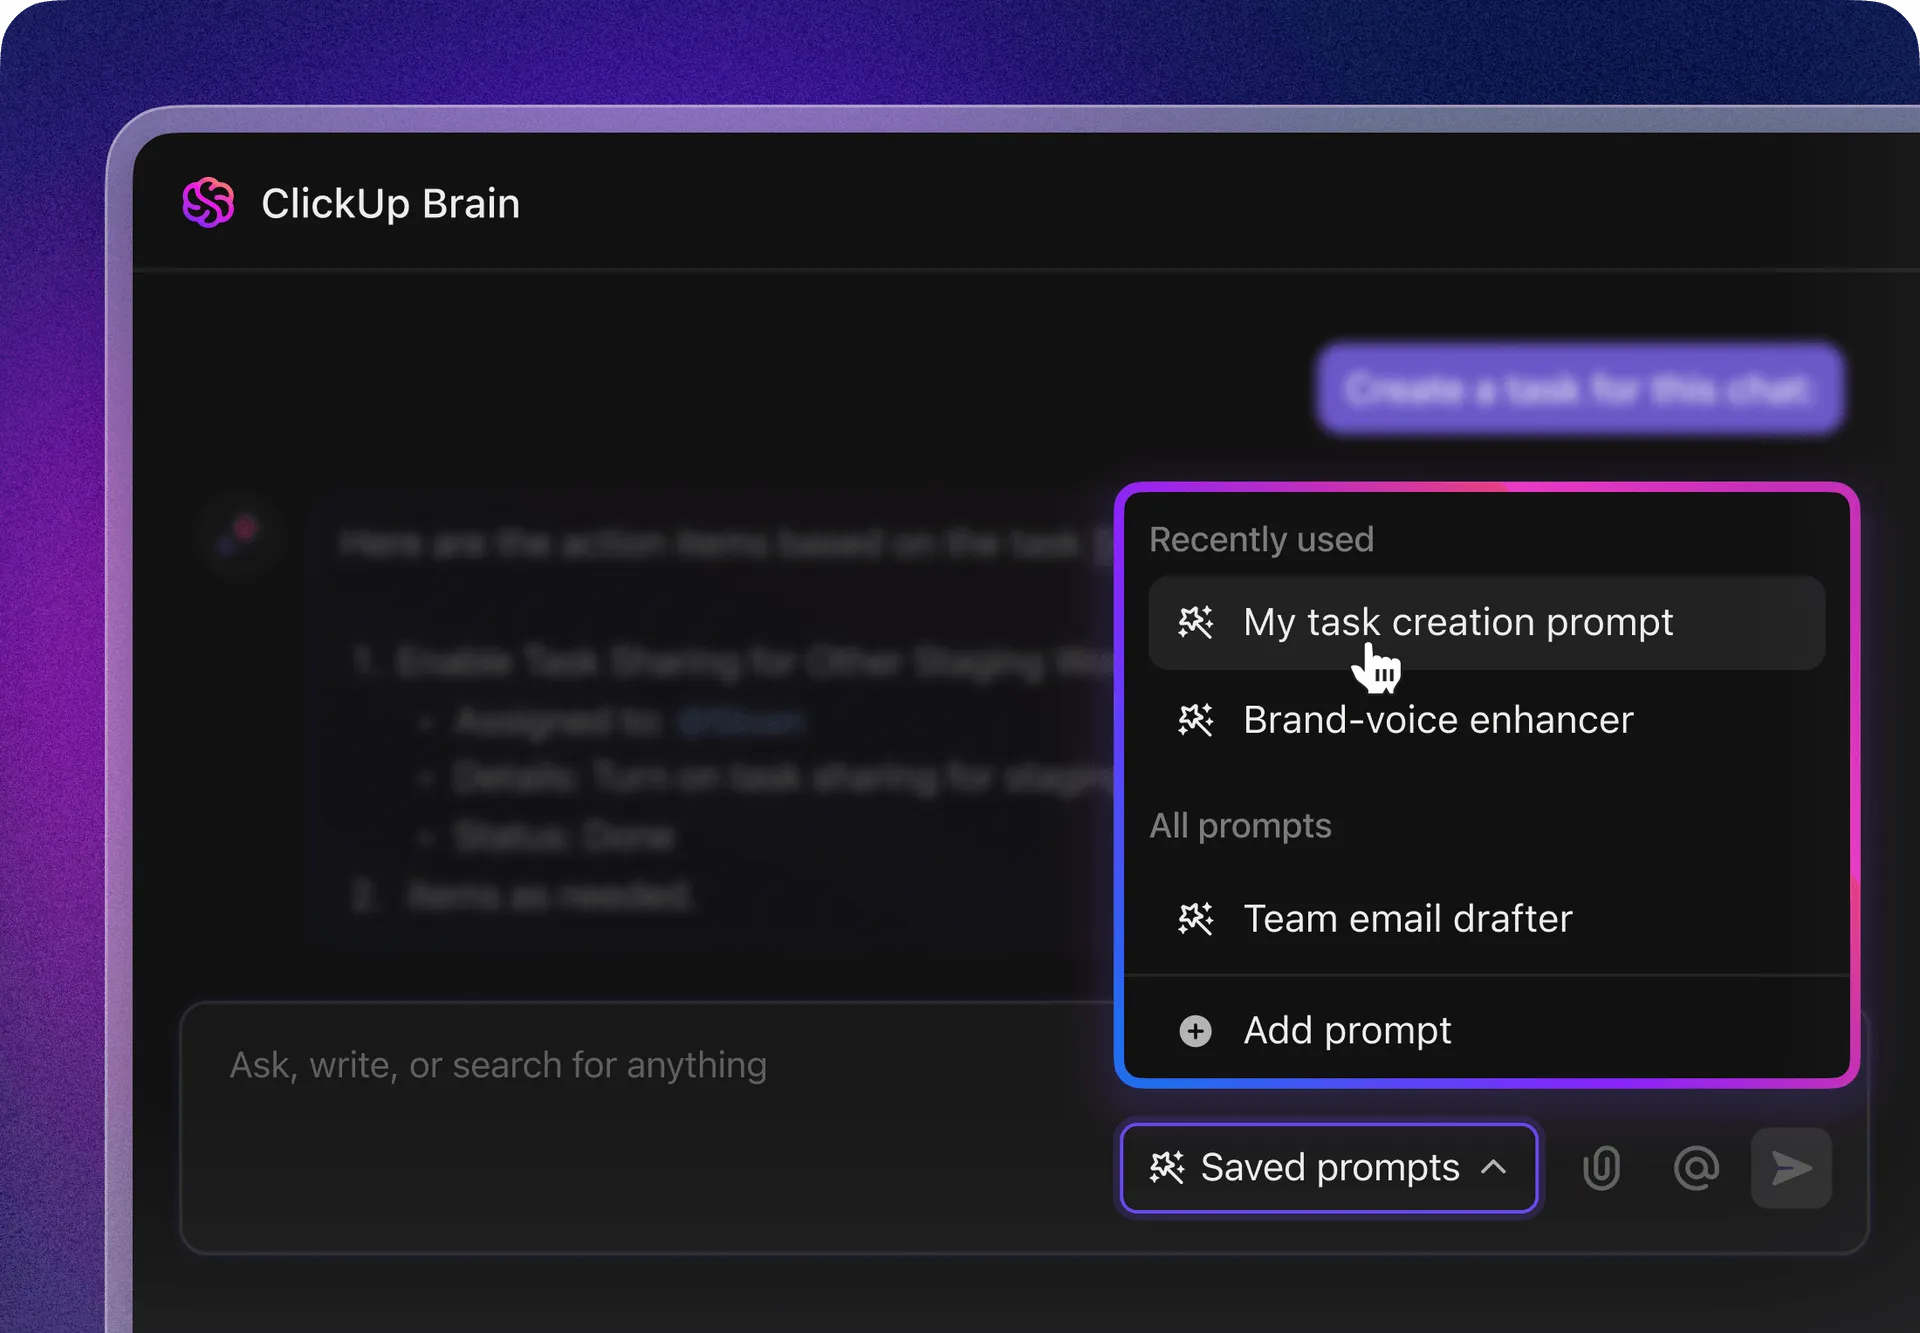
กำหนดมาตรฐานว่า “ดี” คืออะไร: สนามข้อมูลที่จำเป็นสำหรับการสร้าง/ส่งโค้ด (build/commit), สภาพแวดล้อม, ขั้นตอนการจำลองปัญหา, ผลที่คาดไว้เทียบกับผลจริง รวมถึงไฟล์แนบสำหรับบันทึก (logs), ไฟล์ crash dump และไฟล์ HAR. ติดตั้งระบบวัดผลระยะไกล (telemetry) สำหรับฝั่งไคลเอนต์/เซิร์ฟเวอร์ เพื่อให้ ID ของการเกิดข้อผิดพลาด (crash IDs) และ ID ของคำขอ (request IDs) สามารถเชื่อมโยงกับข้อมูลการติดตาม (traces) ได้
นำ Sentry (หรือเครื่องมือที่คล้ายกัน) มาใช้เพื่อติดตามรอยติดตาม (stack traces) และเชื่อมโยงปัญหานั้นโดยตรงกับข้อผิดพลาด AI สามารถอ่านบันทึกและรอยติดตามเพื่อเสนอพื้นที่ข้อผิดพลาดที่เป็นไปได้ และสร้างขั้นตอนการจำลองข้อผิดพลาดที่เรียบง่ายที่สุด ซึ่งช่วยเปลี่ยนเวลาหนึ่งชั่วโมงที่ต้องตรวจสอบด้วยตาเปล่าให้เหลือเพียงไม่กี่นาทีของการทำงานที่มุ่งเน้น
เก็บคู่มือการแก้ไข (runbooks) สำหรับประเภทข้อผิดพลาดที่พบบ่อย เพื่อไม่ให้วิศวกรต้องเริ่มต้นจากศูนย์
ตัวชี้วัดที่ควรติดตาม: เวลาที่ใช้ไปในการ “รอข้อมูล”, เปอร์เซ็นต์ที่สามารถทำซ้ำได้ในครั้งแรก, และอัตราการเปิดใหม่ที่เกี่ยวข้องกับการขาดข้อมูลการทำซ้ำ
📖 อ่านเพิ่มเติม: วิธีใช้ AI ในการพัฒนาซอฟต์แวร์ (กรณีการใช้งานและเครื่องมือ)
5. ลดระยะเวลาการตรวจสอบโค้ดและวงจรการทดสอบ
PR ขนาดใหญ่ทำให้กระบวนการหยุดชะงัก ให้มุ่งเน้นการแก้ไขแบบเฉพาะจุด การพัฒนาบน trunk และ feature flags เพื่อให้การแก้ไขสามารถส่งออกไปได้อย่างปลอดภัย กำหนดผู้ตรวจสอบล่วงหน้าตามเจ้าของโค้ดเพื่อหลีกเลี่ยงเวลาที่เสียเปล่า และใช้รายการตรวจสอบ (การอัปเดตการทดสอบ การเพิ่มข้อมูลเทเลเมทรี การตั้งค่า flag ด้วย kill switch) เพื่อให้คุณภาพถูกรวมไว้ตั้งแต่ต้น
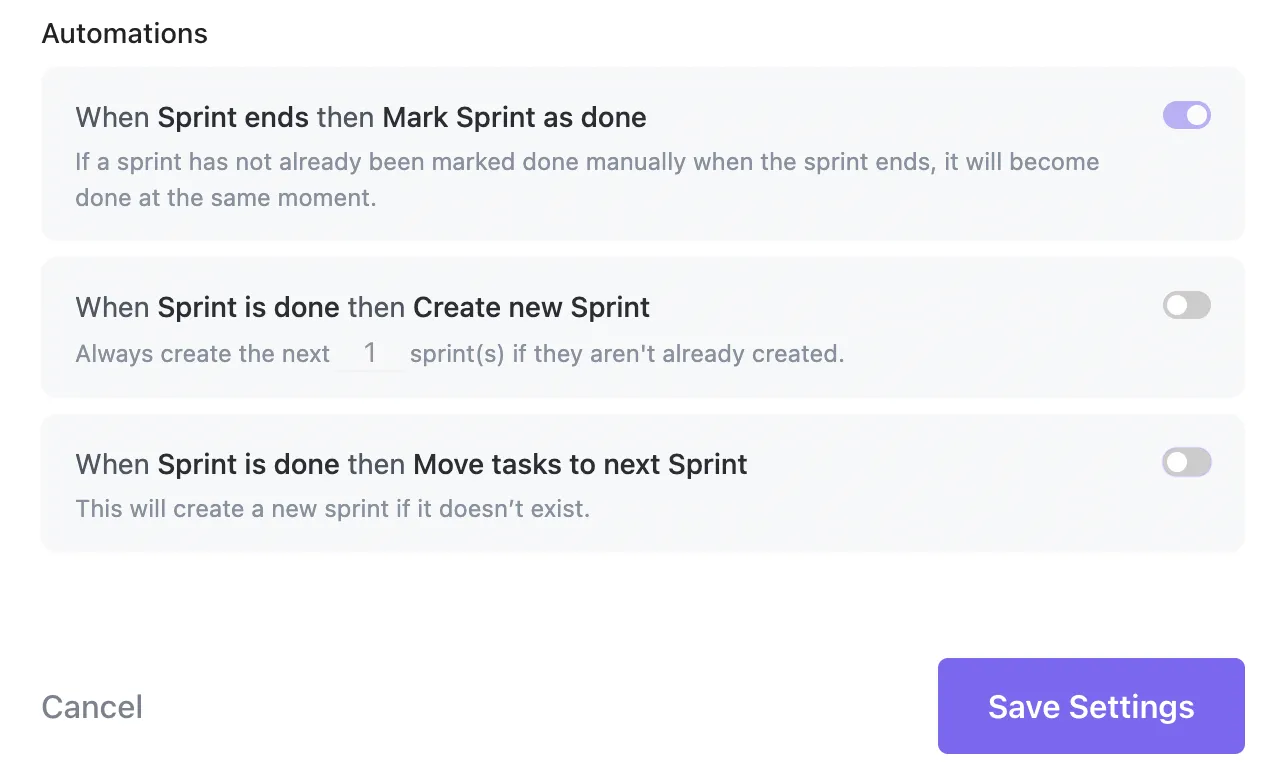
ระบบอัตโนมัติควรย้ายบั๊กไปยังสถานะ “In Review” เมื่อ pull request เปิด และไปยังสถานะ “Resolved” เมื่อทำการ merge; AI สามารถเสนอการทดสอบหน่วย (unit tests) หรือเน้นความแตกต่าง (diff) ที่มีความเสี่ยงเพื่อช่วยให้การตรวจสอบมีประสิทธิภาพมากขึ้น
ตัวชี้วัดที่ควรติดตาม: เวลาที่อยู่ในสถานะ “In Review”, อัตราความล้มเหลวในการเปลี่ยนแปลงสำหรับ PR ที่แก้ไขข้อผิดพลาด, และความล่าช้าในการตรวจสอบ P90.
คุณสามารถใช้การผสานรวมGitHub/GitLabใน ClickUpเพื่อรักษาสถานะการแก้ไขให้สอดคล้องกัน;ระบบอัตโนมัติสามารถบังคับใช้ “การกำหนดว่าเสร็จสมบูรณ์” ได้
📖 อ่านเพิ่มเติม: วิธีใช้ AI เพื่ออัตโนมัติงาน
6. ดำเนินการตรวจสอบแบบขนาน และทำให้สภาพแวดล้อม QA มีความเท่าเทียมกันจริง
การตรวจสอบไม่ควรเริ่มขึ้นหลายวันหลังจากเกิดปัญหา หรือในสภาพแวดล้อมที่ลูกค้าของคุณไม่ใช้เลย
รักษาสถานะ “พร้อมสำหรับ QA” ให้แน่น: การแก้ไขด่วนที่ขับเคลื่อนด้วยธง (flag-driven hotfixes) ได้รับการตรวจสอบความถูกต้องในสภาพแวดล้อมที่คล้ายกับการผลิตจริง ด้วยข้อมูลเริ่มต้น (seed data) ที่ตรงกับกรณีที่ถูกรายงาน
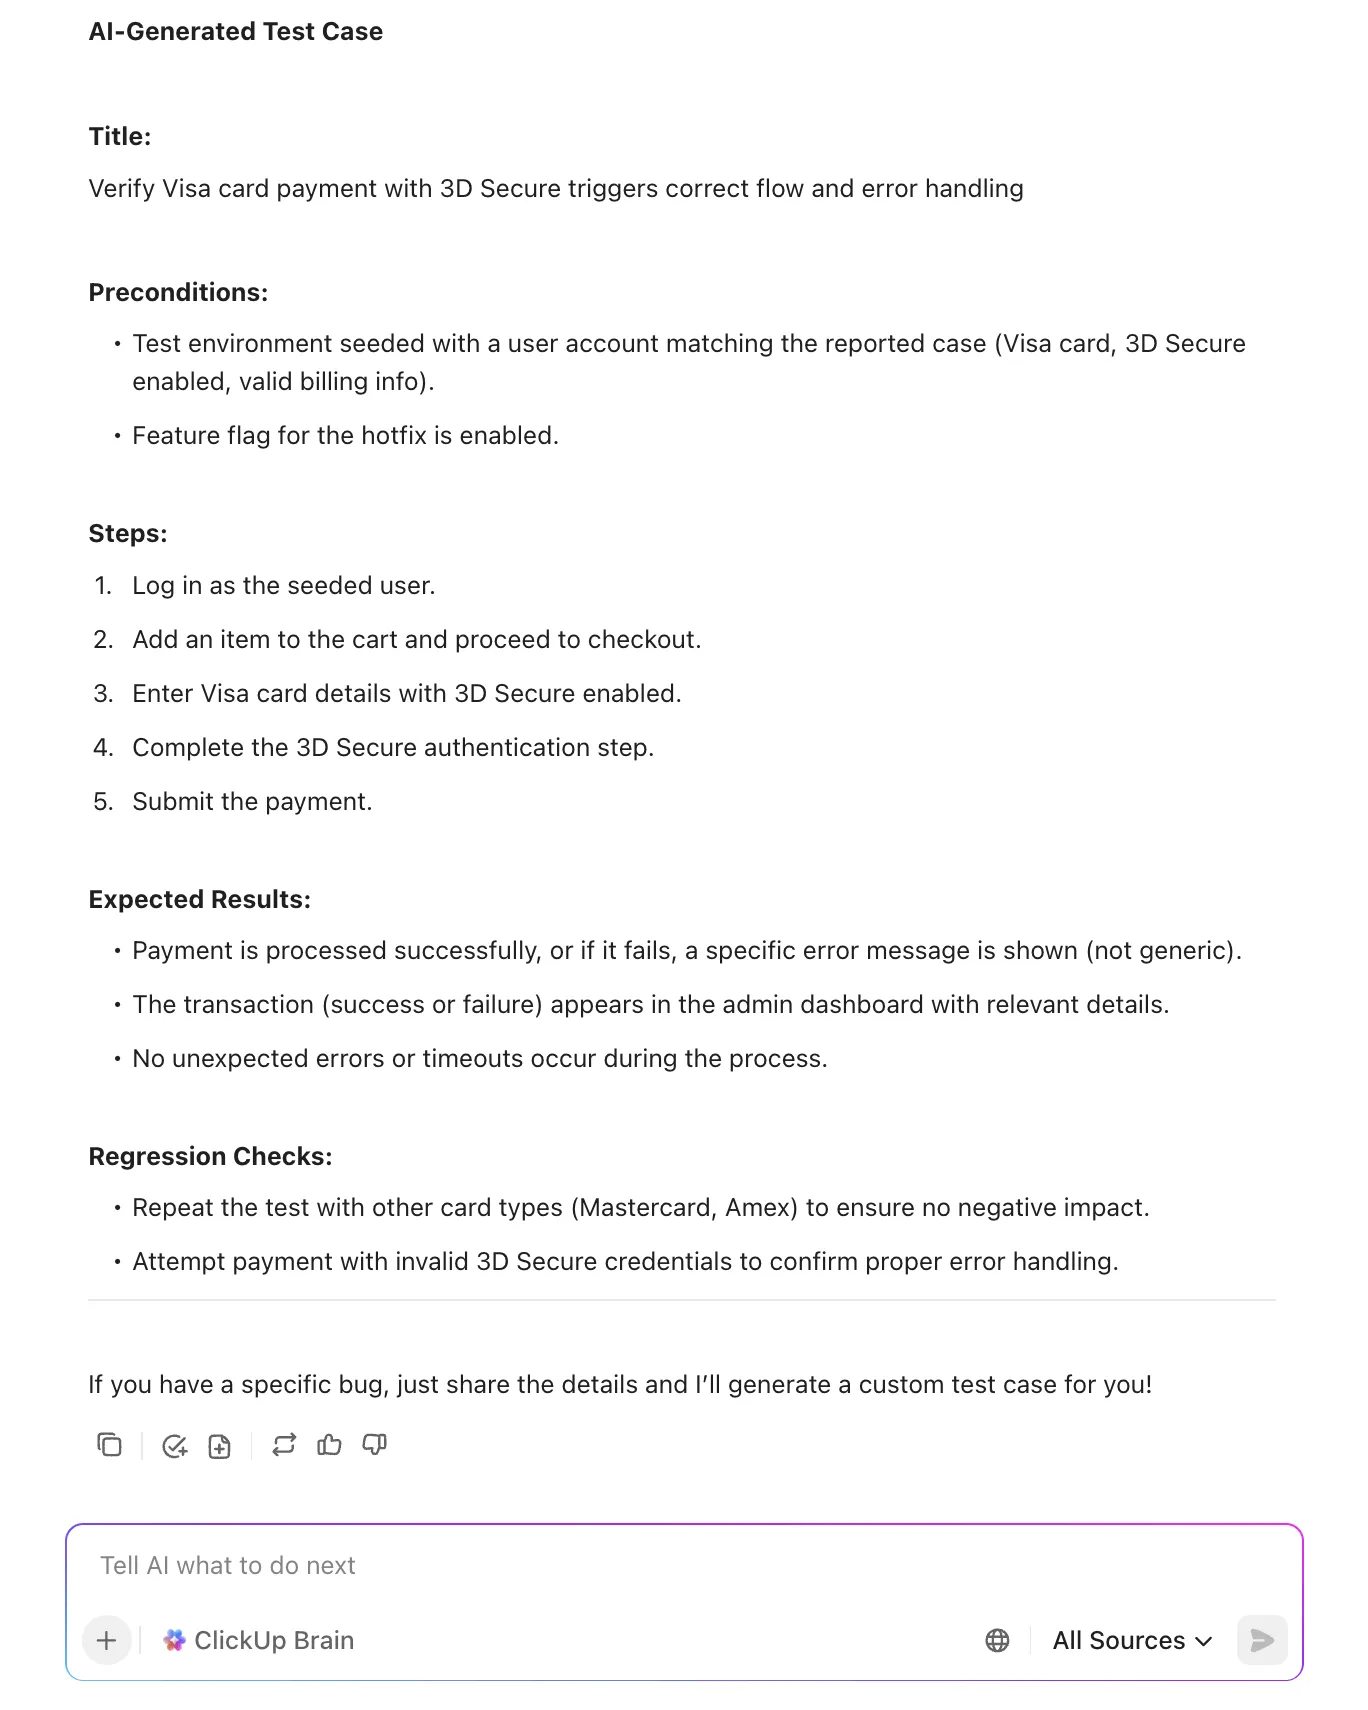
เมื่อเป็นไปได้ ให้ตั้งค่าสภาพแวดล้อมชั่วคราวจากสาขา bug เพื่อให้ทีม QA สามารถตรวจสอบได้ทันที; AI จะสามารถสร้างกรณีทดสอบจากคำอธิบายข้อผิดพลาดและข้อผิดพลาดที่เกิดขึ้นซ้ำในอดีตได้
ตัวชี้วัดที่ควรติดตาม: เวลาที่ใช้ในขั้นตอน “QA/Verification”, อัตราการส่งกลับจาก QA ไปยังทีมพัฒนา, และเวลาปิดปัญหาแบบมัธยฐานหลังการผสานโค้ด
📖 อ่านเพิ่มเติม: วิธีเขียนกรณีทดสอบที่มีประสิทธิภาพ
7. สื่อสารสถานะอย่างชัดเจนเพื่อลดภาระในการประสานงาน
การอัปเดตที่ดีจะช่วยป้องกันการแจ้งสถานะสามครั้งและการส่งต่อปัญหาหนึ่งครั้ง
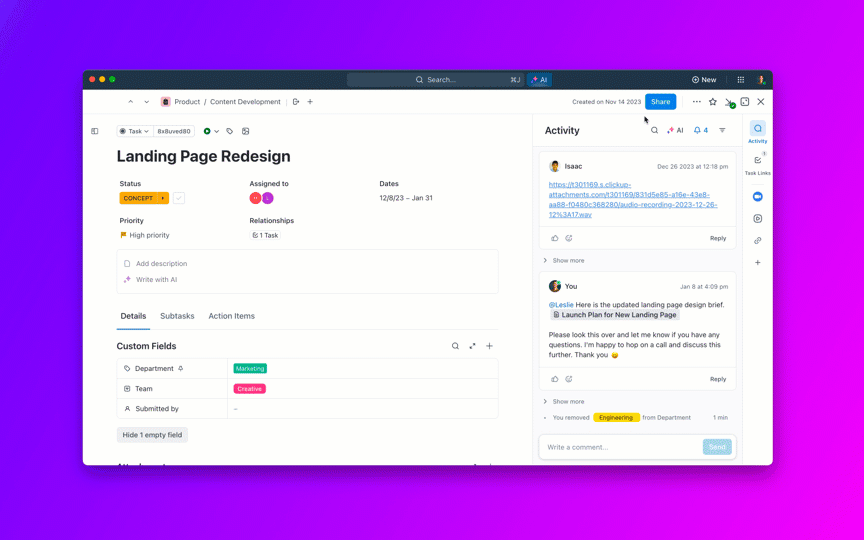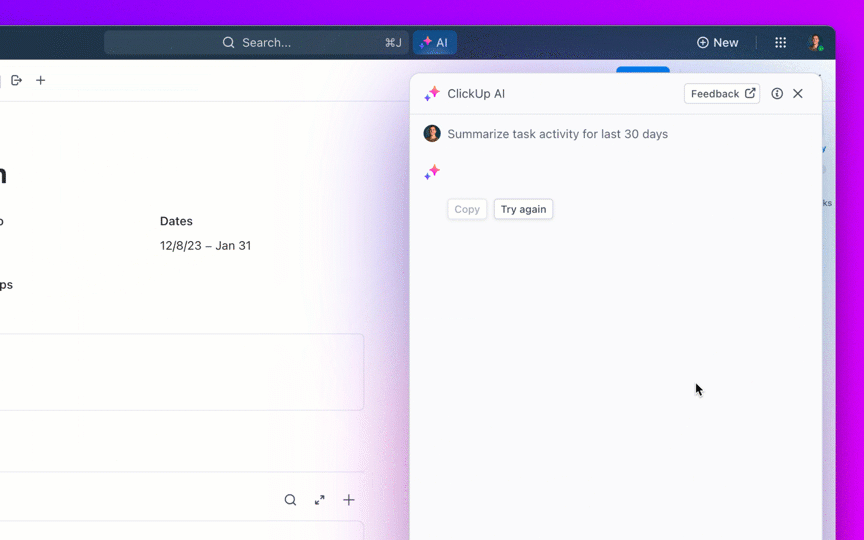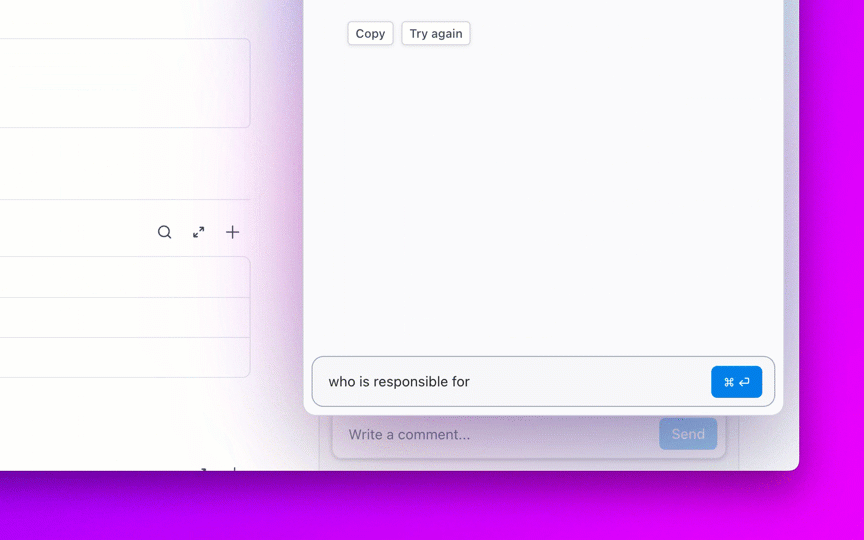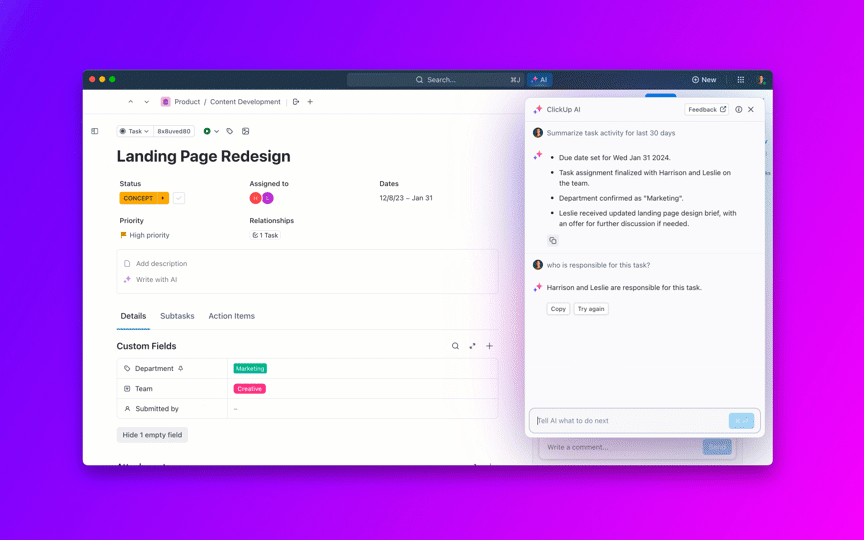
ปฏิบัติต่อการอัปเดตเหมือนผลิตภัณฑ์: สั้น กระชับ และคำนึงถึงกลุ่มเป้าหมาย (ทีมสนับสนุน ผู้บริหาร ลูกค้า) กำหนดจังหวะการอัปเดตสำหรับ P0/P1 (เช่น ทุกชั่วโมงจนกว่าปัญหาจะได้รับการแก้ไขชั่วคราว แล้วทุกสี่ชั่วโมง) และรักษาแหล่งข้อมูลที่เชื่อถือได้เพียงแหล่งเดียว
AI สามารถร่างการอัปเดตที่ปลอดภัยสำหรับลูกค้าและสรุปข้อมูลภายในจากประวัติงาน รวมถึงสถานะแบบเรียลไทม์ตามระดับความรุนแรงและทีม สำหรับผู้บริหาร เช่น ผู้อำนวยการฝ่ายผลิตภัณฑ์ ให้รวมข้อผิดพลาดเข้ากับโครงการต่าง ๆ เพื่อให้พวกเขาสามารถตรวจสอบได้ว่างานด้านคุณภาพที่สำคัญอาจส่งผลกระทบต่อคำมั่นสัญญาในการส่งมอบหรือไม่
ตัวชี้วัดที่ควรติดตาม: เวลาที่ผ่านไประหว่างการอัปเดตสถานะของ P0/P1, คะแนนความพึงพอใจของผู้มีส่วนได้ส่วนเสีย (CSAT) ต่อการสื่อสาร
8. ควบคุมอายุของงานค้างและป้องกันไม่ให้งานค้าง “เปิดอยู่ตลอดไป”
งานค้างที่เพิ่มขึ้นและไม่ได้รับการจัดการอย่างต่อเนื่อง กำลังสร้างภาระให้กับทุกสปรินต์อย่างเงียบๆ
ตั้งนโยบายการจัดการข้อบกพร่องตามระยะเวลา (เช่น P2 > 30 วัน จะทริกเกอร์การทบทวน, P3 > 90 วัน ต้องมีเหตุผลรองรับ) และกำหนดเวลา “การจัดลำดับความสำคัญตามระยะเวลา” ทุกสัปดาห์ เพื่อรวมข้อบกพร่องที่ซ้ำกัน ปิดรายงานที่ล้าสมัย และแปลงข้อบกพร่องที่มีค่าต่ำให้เป็นรายการในแบ็กล็อกผลิตภัณฑ์
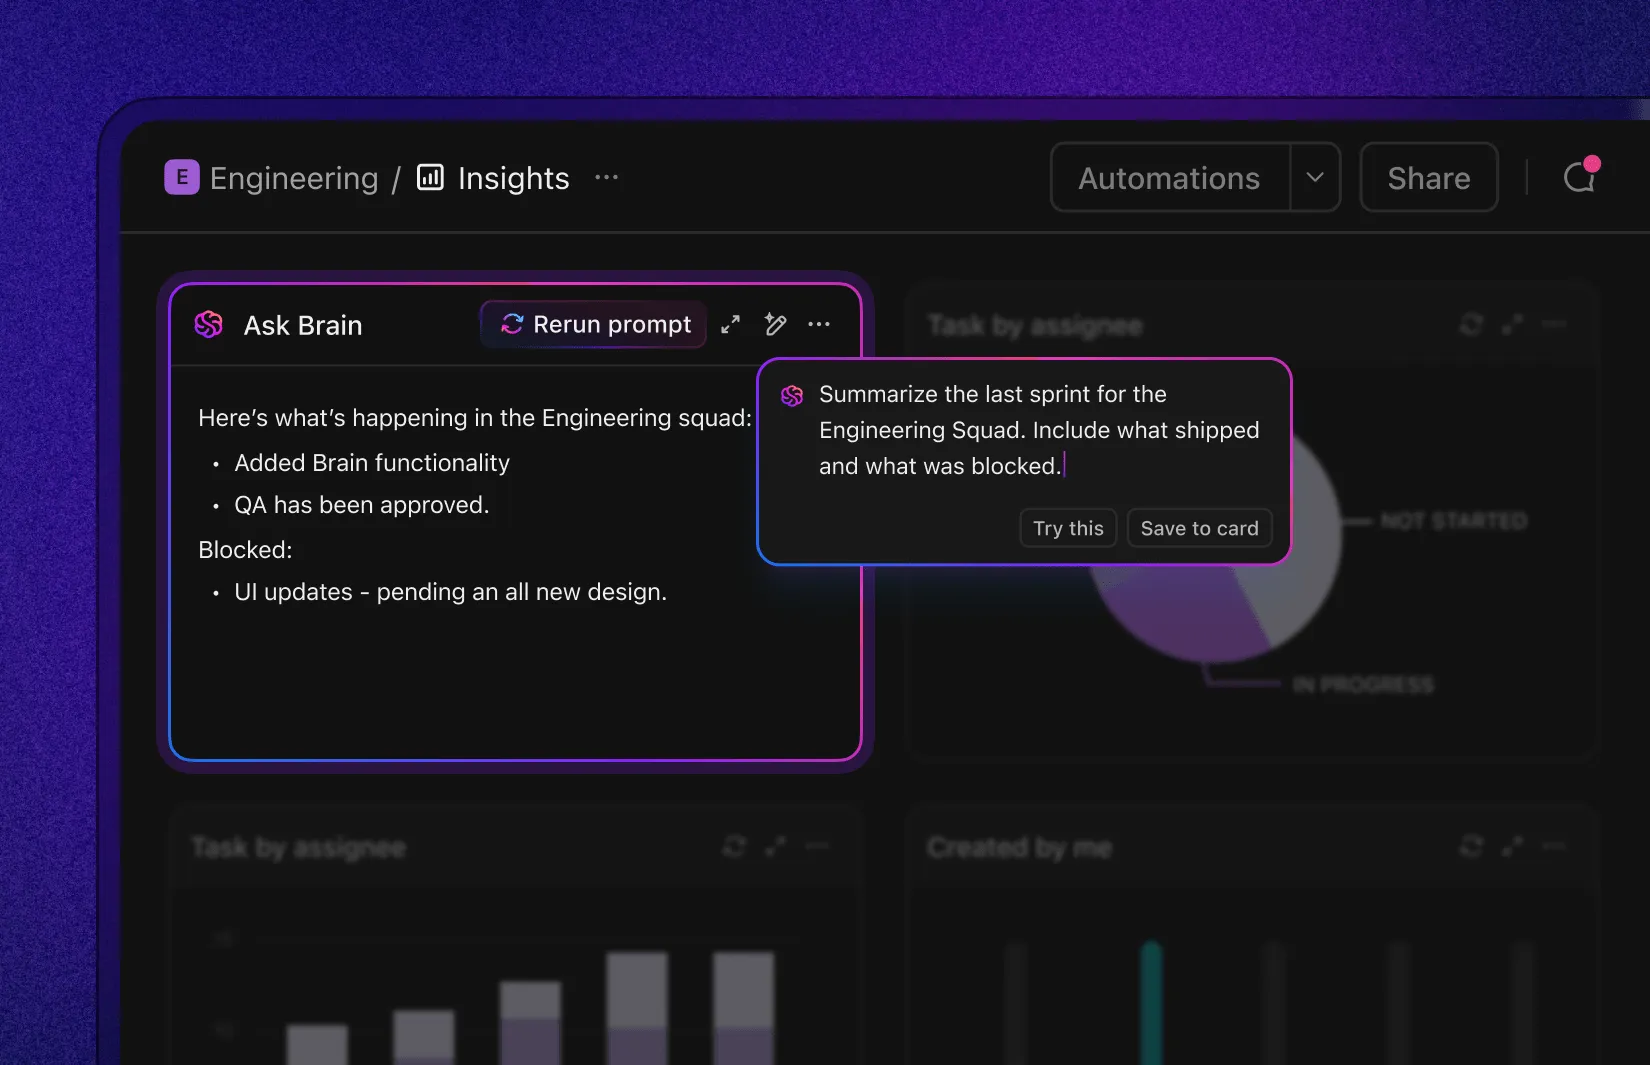
ใช้ AI เพื่อจัดกลุ่มงานค้างตามหัวข้อ (เช่น “การหมดอายุของโทเค็นการยืนยันตัวตน”, “ความไม่เสถียรในการอัปโหลดภาพ”) เพื่อให้คุณสามารถกำหนดสัปดาห์แก้ไขตามหัวข้อและแก้ไขข้อบกพร่องประเภทเดียวกันได้พร้อมกัน
ตัวชี้วัดที่ควรติดตาม: จำนวนงานค้างตามช่วงอายุ, เปอร์เซ็นต์ของปัญหาที่ปิดเนื่องจากเป็นข้อมูลซ้ำหรือล้าสมัย, ความเร็วการลดงานตามหัวข้อ
9. ปิดวงจรด้วยการระบุสาเหตุหลักและมาตรการป้องกัน
หากข้อบกพร่องประเภทเดียวกันยังคงเกิดขึ้นซ้ำๆ การปรับปรุงค่า MTTR ของคุณอาจกำลังปกปิดปัญหาที่ใหญ่กว่า
ดำเนินการวิเคราะห์สาเหตุหลักอย่างรวดเร็วและไม่โทษใคร สำหรับ P0/P1 และ P2 ที่เกิดขึ้นบ่อยครั้ง; ติดแท็กสาเหตุหลัก (ช่องว่างในข้อกำหนด ช่องว่างในการทดสอบ ช่องว่างในเครื่องมือ ความไม่เสถียรในการบูรณาการ) เชื่อมโยงกับส่วนประกอบและเหตุการณ์ที่ได้รับผลกระทบ และติดตามงานติดตามผล (การป้องกัน การทดสอบ กฎ lint) จนเสร็จสิ้น
AI สามารถร่างสรุปผลการวิเคราะห์สาเหตุ (RCA) และเสนอการทดสอบป้องกันหรือกฎ lint โดยอ้างอิงจากประวัติการเปลี่ยนแปลง และนี่คือวิธีที่คุณจะเปลี่ยนจากการแก้ปัญหาแบบฉุกเฉินไปสู่การลดจำนวนปัญหาลง
ตัวชี้วัดที่ควรติดตาม: อัตราการเปิดใหม่, อัตราการเกิดข้อผิดพลาดซ้ำ, เวลาระหว่างการเกิดข้อผิดพลาดซ้ำ, และ % ของการวิเคราะห์สาเหตุหลัก (RCA) ที่มีมาตรการป้องกันเสร็จสิ้น
เมื่อรวมกันแล้ว การเปลี่ยนแปลงเหล่านี้จะช่วยย่นระยะเวลาการแก้ไขข้อผิดพลาดตั้งแต่ต้นจนจบ: การยืนยันรับเรื่องที่เร็วขึ้น การจัดลำดับความสำคัญที่ชัดเจนขึ้น การกำหนดลำดับความสำคัญที่ชาญฉลาดขึ้น การชะลอตัวในขั้นตอนการตรวจสอบและ QA ที่น้อยลง และการสื่อสารที่ชัดเจนยิ่งขึ้น ผู้บริหารจะได้รับข้อมูลคาดการณ์ที่เชื่อมโยงกับ CSAT/NPS และรายได้ ส่วนผู้ปฏิบัติงานจะได้รับคิวงานที่สงบลง พร้อมการเปลี่ยนบริบทที่น้อยลง
📖 อ่านเพิ่มเติม: วิธีดำเนินการวิเคราะห์สาเหตุหลัก
เครื่องมือ AI ที่ช่วยลดเวลาแก้ไขข้อผิดพลาด
AI สามารถลดเวลาการแก้ไขปัญหาได้ในทุกขั้นตอน — การรับเรื่อง, การจัดประเภท, การส่งต่อ, การแก้ไข และการตรวจสอบ
อย่างไรก็ตาม ผลประโยชน์ที่แท้จริงจะเกิดขึ้นเมื่อเครื่องมือสามารถเข้าใจบริบทและรักษาให้งานดำเนินต่อไปได้โดยไม่ต้องมีการดูแลอย่างใกล้ชิด
เลือกระบบที่สามารถเสริมข้อมูลในรายงานได้อัตโนมัติ (ขั้นตอนการจำลองข้อผิดพลาด, สภาพแวดล้อม, รายการที่ซ้ำ), จัดลำดับความสำคัญตามผลกระทบ, ส่งต่อให้ผู้รับผิดชอบที่ถูกต้อง, ร่างการอัปเดตที่ชัดเจน และผสานการทำงานอย่างแน่นแฟ้นกับโค้ด, CI และระบบการสังเกตการณ์ของคุณ
เครื่องมือที่ดีที่สุดในกลุ่มนี้ยังสนับสนุนกระบวนการทำงานแบบตัวแทน: บอทที่ติดตาม SLA, แจ้งเตือนผู้ตรวจสอบ, ส่งต่อปัญหาที่ติดขัดไปยังระดับที่สูงขึ้น และสรุปผลลัพธ์ให้กับผู้เกี่ยวข้อง นี่คือรายชื่อเครื่องมือ AI ของเราเพื่อปรับปรุงการแก้ไขข้อผิดพลาด:
1. ClickUp (เหมาะที่สุดสำหรับ AI ที่เข้าใจบริบท, การอัตโนมัติ และกระบวนการทำงานแบบตัวแทน)
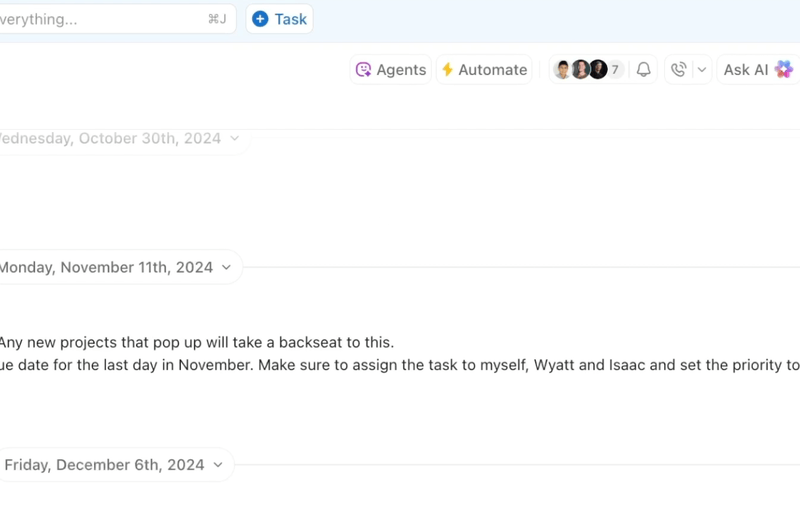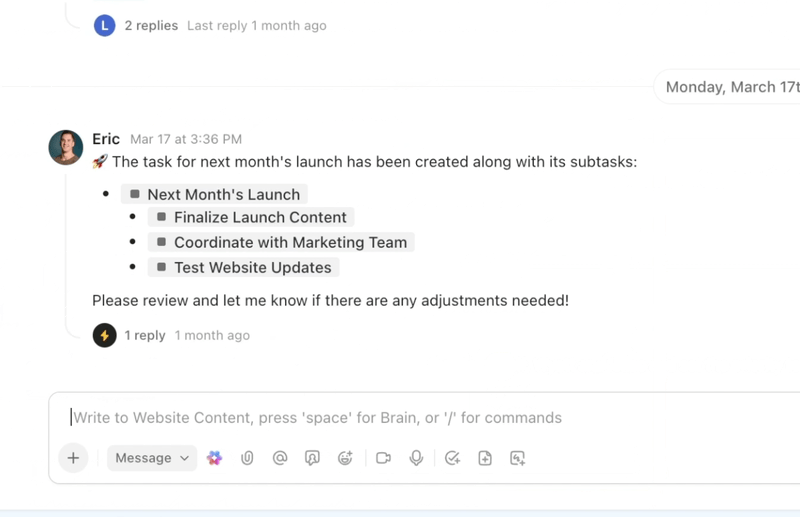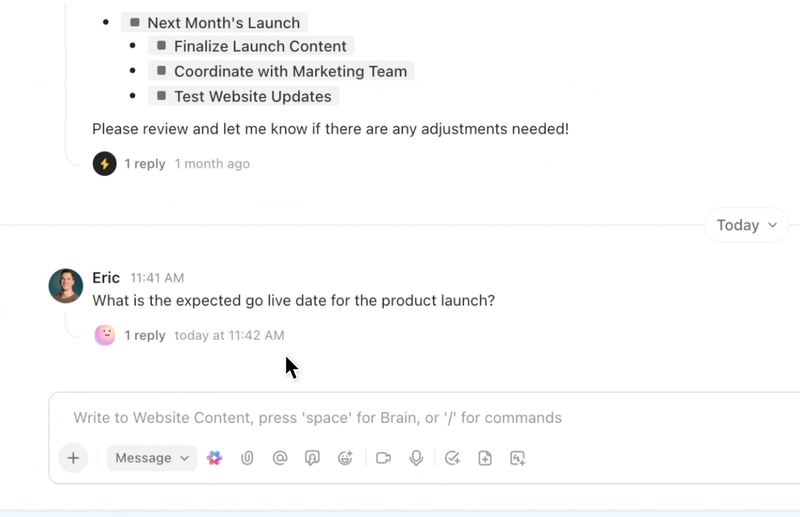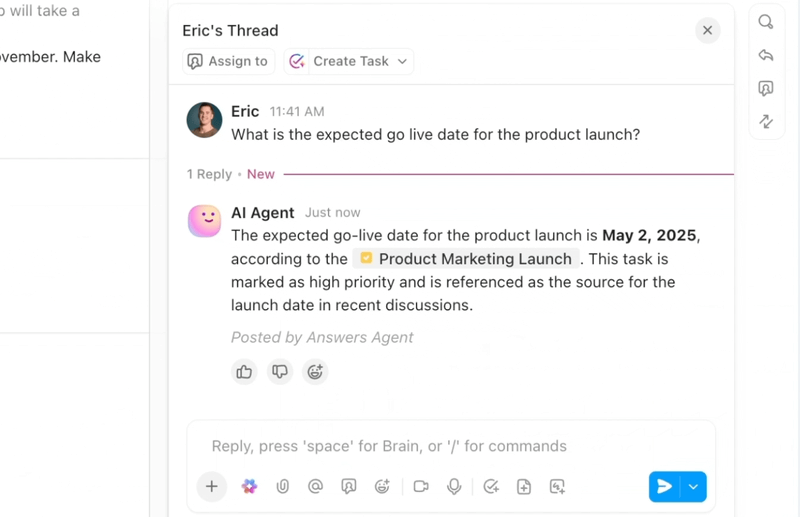
หากคุณต้องการกระบวนการแก้ไขข้อผิดพลาดที่เรียบง่ายและอัจฉริยะ ClickUp — แอปอเนกประสงค์สำหรับงาน — จะรวม AI, ระบบอัตโนมัติ และการสนับสนุนกระบวนการทำงานแบบเอเจนต์ไว้ในที่เดียว
ClickUp Brainแสดงบริบทที่ถูกต้องทันที — โดยสรุปหัวข้อการสนทนาเกี่ยวกับข้อผิดพลาดที่ยาว, สกัดขั้นตอนการจำลองข้อผิดพลาดและรายละเอียดสภาพแวดล้อมจากไฟล์แนบ, ระบุข้อผิดพลาดที่อาจซ้ำกัน และเสนอขั้นตอนต่อไปที่ควรดำเนินการ แทนที่จะต้องค้นหาข้อมูลใน Slack, ตั๋ว และบันทึก ทีมงานจะได้รับบันทึกที่ชัดเจนและครบถ้วน ซึ่งสามารถนำไปดำเนินการได้ทันที
ระบบอัตโนมัติและเอเจนต์ Autopilot ใน ClickUpช่วยให้งานดำเนินไปอย่างต่อเนื่องโดยไม่ต้องมีการดูแลอย่างใกล้ชิดตลอดเวลา ข้อผิดพลาดจะถูกส่งไปยังทีมที่เหมาะสมโดยอัตโนมัติ ผู้รับผิดชอบจะถูกกำหนด SLA และวันที่ครบกำหนดจะถูกตั้งค่า สถานะจะอัปเดตตามความคืบหน้าของงาน และผู้เกี่ยวข้องจะได้รับการแจ้งเตือนอย่างทันท่วงที
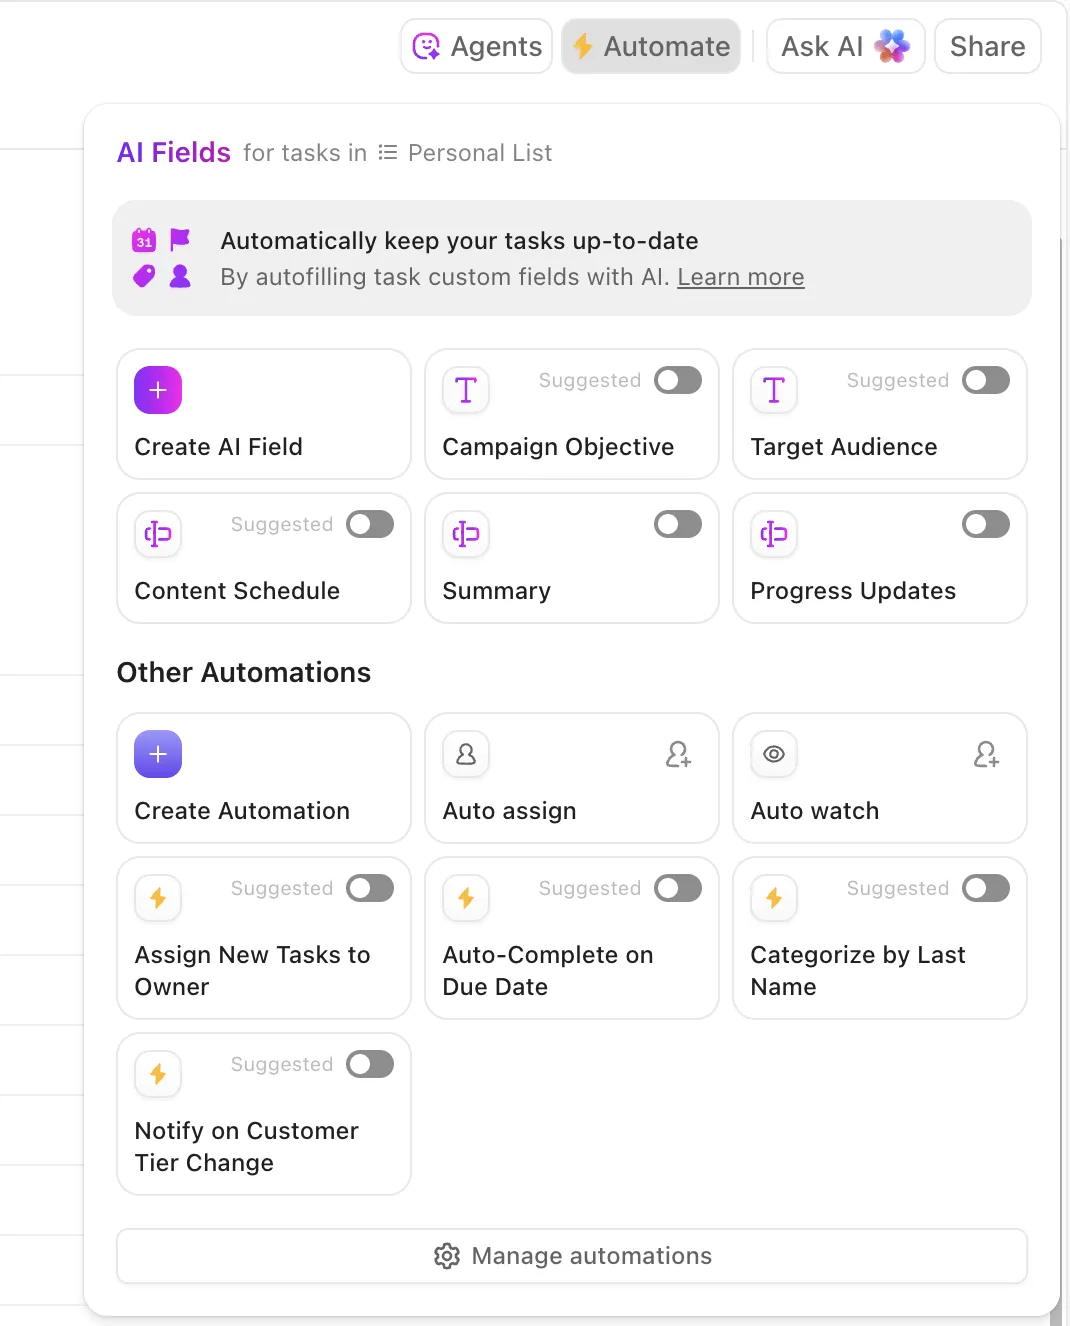
ตัวแทนเหล่านี้สามารถจัดลำดับความสำคัญและจัดประเภทปัญหาได้ รวมถึงจัดกลุ่มรายงานที่คล้ายกัน อ้างอิงการแก้ไขในอดีตเพื่อเสนอแนวทางแก้ไขที่เป็นไปได้ และส่งต่อเรื่องเร่งด่วน—ทำให้ MTTA และ MTTR ลดลงได้แม้เมื่อปริมาณงานเพิ่มขึ้นอย่างกะทันหัน
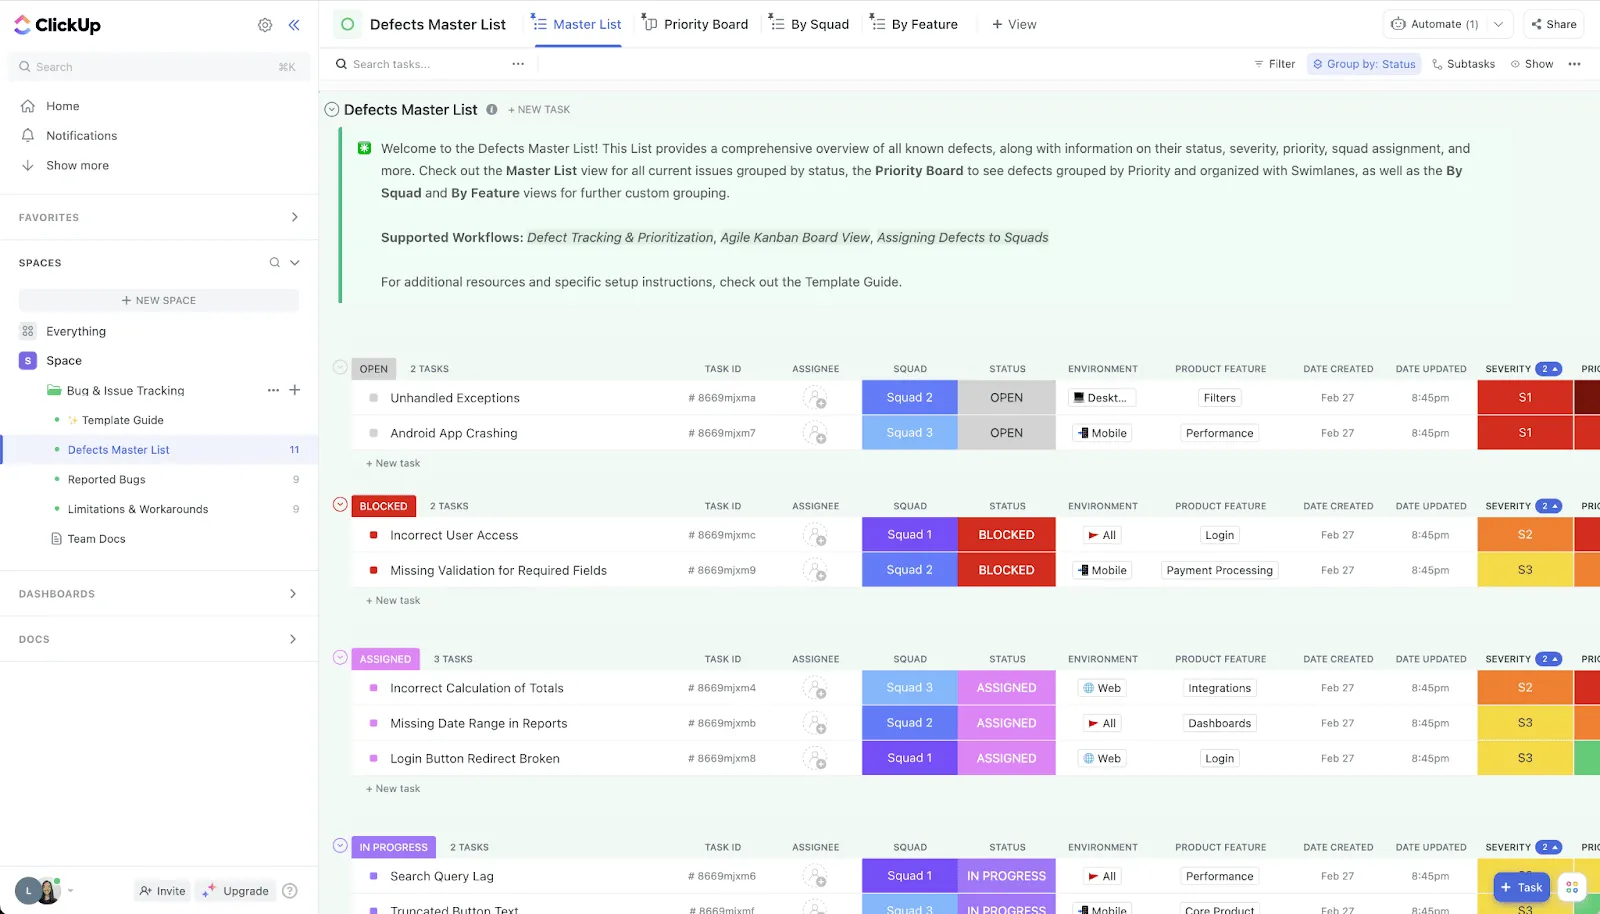
🛠️ ต้องการชุดเครื่องมือที่พร้อมใช้งานทันทีหรือไม่?แม่แบบ ClickUp Bug & Issue Trackingเป็นโซลูชันที่ทรงพลังจากClickUp สำหรับซอฟต์แวร์ ซึ่งออกแบบมาเพื่อช่วย ทีมสนับสนุน ทีมวิศวกรรม และทีมผลิตภัณฑ์ ติดตามและจัดการข้อผิดพลาดและปัญหาของซอฟต์แวร์ได้อย่างง่ายดาย ด้วยมุมมองที่ปรับแต่งได้ เช่น List, Board, Workload, Form และ Timeline ทีมสามารถแสดงภาพและจัดการกระบวนการติดตามข้อผิดพลาดด้วยวิธีที่เหมาะกับพวกเขาที่สุด
สถานะที่กำหนดเอง 20 สถานะและสนามที่กำหนดเอง 7 สนามในเทมเพลตนี้ช่วยให้สามารถปรับแต่งกระบวนการทำงานให้เหมาะสมกับความต้องการได้ โดยรับประกันว่าทุกปัญหาจะถูกติดตามตั้งแต่การค้นพบจนถึงการแก้ไข ระบบอัตโนมัติที่ติดตั้งมาพร้อมตัวช่วยจัดการงานที่ซ้ำซาก ช่วยประหยัดเวลาอันมีค่าและลดความพยายามในการทำงานด้วยมือ
💟 โบนัส: Brain MAX คือ ผู้ช่วยบนเดสก์ท็อปที่ขับเคลื่อนด้วย AI ของคุณ ซึ่งออกแบบมาเพื่อเร่งการแก้ไขข้อผิดพลาดด้วยคุณสมบัติที่ชาญฉลาดและใช้งานได้จริง
เมื่อพบข้อผิดพลาด เพียงใช้ฟังก์ชันแปลงเสียงเป็นข้อความ (talk-to-text) ของ Brain MAX เพื่อบันทึกปัญหา — ข้อความที่คุณพูดจะถูกแปลงเป็นข้อความทันที และสามารถแนบไปยังตั๋วข้อผิดพลาดใหม่หรือที่มีอยู่ได้ ระบบค้นหาระดับองค์กร (Enterprise Search) ของ Brain MAX จะค้นหาผ่านเครื่องมือทั้งหมดที่เชื่อมต่ออยู่ — เช่น ClickUp, GitHub, Google Drive และ Slack — เพื่อแสดงรายงานข้อผิดพลาดที่เกี่ยวข้อง บันทึกข้อผิดพลาด (error logs) ส่วนโค้ด (code snippets) และเอกสารประกอบ ทำให้คุณมีข้อมูลบริบททั้งหมดที่จำเป็นโดยไม่ต้องเปลี่ยนแอป
ต้องการประสานงานเพื่อแก้ไขข้อผิดพลาดหรือไม่? Brain MAX ช่วยให้คุณมอบหมายข้อผิดพลาดให้กับนักพัฒนาที่เหมาะสม ตั้งการแจ้งเตือนอัตโนมัติสำหรับการอัปเดตสถานะ และติดตามความคืบหน้า — ทั้งหมดนี้ทำได้จากเดสก์ท็อปของคุณ!
2. Sentry (เหมาะที่สุดสำหรับการบันทึกข้อผิดพลาด)
Sentry ช่วยลด MTTD และเวลาในการจำลองข้อผิดพลาดได้โดยการเก็บรวบรวมข้อผิดพลาด บันทึกการติดตาม (traces) และเซสชันของผู้ใช้ไว้ในที่เดียว การจัดกลุ่มปัญหาด้วย AI ช่วยลดข้อมูลที่ไม่เกี่ยวข้อง; “Suspect Commit” และกฎการกำหนดเจ้าของช่วยระบุผู้พัฒนาโค้ดที่น่าจะเป็นผู้รับผิดชอบ ทำให้การส่งต่อปัญหาเป็นไปอย่างรวดเร็วทันที ส่วน Session Replay ให้วิศวกรเห็นเส้นทางผู้ใช้ที่แม่นยำและรายละเอียดคอนโซล/เครือข่าย เพื่อจำลองข้อผิดพลาดได้โดยไม่ต้องส่งต่อข้อมูลไปมาอย่างไม่มีที่สิ้นสุด
คุณสมบัติของ Sentry AI สามารถสรุปบริบทของปัญหาได้ และในบางระบบยังสามารถเสนอแพตช์ Autofix ที่อ้างอิงถึงโค้ดที่ก่อให้เกิดปัญหาได้อีกด้วย ผลลัพธ์ในทางปฏิบัติคือ: ลดจำนวนตั๋วที่ซ้ำกัน การจัดสรรงานที่รวดเร็วขึ้น และลดระยะเวลาจากขั้นตอนการรายงานจนถึงแพตช์ที่ทำงานได้
3. GitHub Copilot (เหมาะที่สุดสำหรับการตรวจสอบโค้ดอย่างรวดเร็ว)
Copilot ช่วยเร่ง กระบวนการแก้ไขข้อผิดพลาดภายในตัวแก้ไขโค้ด โดยอธิบายข้อมูล stack trace, เสนอการแก้ไขที่ตรงจุด, เขียนการทดสอบหน่วย (unit tests) เพื่อยืนยันว่าการแก้ไขได้ผล และสร้างโครงสร้างสคริปต์สำหรับการจำลองข้อผิดพลาด
Copilot Chat สามารถวิเคราะห์โค้ดที่มีข้อผิดพลาด เสนอการปรับโครงสร้างโค้ดที่ปลอดภัยยิ่งขึ้น และสร้างคำอธิบายหรือคำอธิบายใน PR ที่ช่วยให้การตรวจสอบโค้ดเป็นไปอย่างรวดเร็วขึ้น เมื่อใช้ร่วมกับกระบวนการตรวจสอบที่จำเป็นและ CI จะช่วยลดเวลาในขั้นตอน “วินิจฉัย → ดำเนินการ → ทดสอบ” ได้หลายชั่วโมง โดยเฉพาะอย่างยิ่งสำหรับข้อผิดพลาดที่มีขอบเขตชัดเจนและสามารถสร้างซ้ำได้อย่างชัดเจน
4. Snyk by DeepCode AI (เหมาะที่สุดสำหรับการตรวจจับรูปแบบ)
การวิเคราะห์แบบสถิตที่ขับเคลื่อนด้วย AIของ DeepCodeจะตรวจพบข้อบกพร่องและรูปแบบที่ไม่ปลอดภัยขณะที่คุณเขียนโค้ดและใน PR โดยจะเน้นแสดงขั้นตอนที่มีปัญหา อธิบายสาเหตุที่เกิดขึ้น และเสนอวิธีแก้ไขที่ปลอดภัยซึ่งสอดคล้องกับสไตล์การเขียนโค้ดของคุณ
ด้วยการตรวจพบข้อผิดพลาดที่เกิดซ้ำก่อนการผสานโค้ด (pre-merge) และแนะนำนักพัฒนาให้ใช้รูปแบบที่ปลอดภัยยิ่งขึ้น คุณจะสามารถลดอัตราการเกิดข้อผิดพลาดใหม่ และเร่งการแก้ไขข้อผิดพลาดทางตรรกะที่ซับซ้อน ซึ่งยากต่อการตรวจพบในขั้นตอนการตรวจสอบ IDE และการผสาน PR (PR) จะช่วยให้กระบวนการนี้เกิดขึ้นใกล้กับจุดที่งานกำลังดำเนินการอยู่
5. Watchdog และ AIOps ของ Datadog (เหมาะที่สุดสำหรับการวิเคราะห์ล็อก)
Watchdog ของ Datadogใช้ ML เพื่อตรวจหาความผิดปกติในบันทึก, ตัวชี้วัด, การติดตาม และระบบติดตามผู้ใช้จริง โดยเชื่อมโยงการเพิ่มขึ้นอย่างกะทันหันกับจุดหมายการปรับใช้, การเปลี่ยนแปลงโครงสร้างพื้นฐาน และโครงสร้างเครือข่าย เพื่อเสนอสาเหตุหลักที่เป็นไปได้
สำหรับข้อบกพร่องที่ส่งผลกระทบต่อลูกค้า สิ่งนี้หมายถึงการตรวจพบภายในไม่กี่นาที การจัดกลุ่มอัตโนมัติเพื่อลดการแจ้งเตือนที่ไม่จำเป็น และแนวทางที่ชัดเจนว่าควรตรวจสอบที่ใด เวลาในการคัดกรองจะลดลง เพราะคุณเริ่มต้นด้วยข้อมูลว่า “การปรับใช้ครั้งนี้ส่งผลต่อบริการเหล่านี้ และอัตราความผิดพลาดเพิ่มขึ้นที่จุดปลายนี้” แทนที่จะเริ่มต้นจากศูนย์
⚡️ คลังแม่แบบ: แม่แบบติดตามปัญหาและบันทึกฟรีใน Excel และ ClickUp
6. New Relic AI (เหมาะที่สุดสำหรับการระบุและสรุปแนวโน้ม)
Errors Inboxของ New Relicจะจัดกลุ่มข้อผิดพลาดที่คล้ายกันตามบริการและเวอร์ชัน ส่วนผู้ช่วย AI จะสรุปผลกระทบ ชี้ให้เห็นสาเหตุที่เป็นไปได้ และเชื่อมโยงไปยังข้อมูลการติดตาม (traces) หรือธุรกรรม (transactions) ที่เกี่ยวข้อง
ความสัมพันธ์ระหว่างการปรับใช้และข้อมูลอัจฉริยะเกี่ยวกับการเปลี่ยนแปลงของเอนทิตี ช่วยให้เห็นได้ชัดเจนว่าเวอร์ชันที่ปล่อยออกเมื่อเร็วๆ นี้คือสาเหตุของปัญหา สำหรับระบบแบบกระจาย ข้อมูลบริบทดังกล่าวช่วยลดเวลาการติดต่อระหว่างทีมลงได้หลายชั่วโมง และส่งปัญหาไปยังผู้รับผิดชอบที่ถูกต้อง พร้อมด้วยสมมติฐานที่ชัดเจนแล้ว
7. Rollbar (เหมาะที่สุดสำหรับกระบวนการทำงานอัตโนมัติ)
Rollbarเชี่ยวชาญด้านการติดตามข้อผิดพลาดแบบเรียลไทม์ ด้วยเทคโนโลยี fingerprinting อัจฉริยะเพื่อจัดกลุ่มข้อผิดพลาดที่ซ้ำกันและติดตามแนวโน้มการเกิดข้อผิดพลาด รายงานสรุปที่ขับเคลื่อนด้วย AI และคำแนะนำเกี่ยวกับสาเหตุหลัก ช่วยให้ทีมเข้าใจขอบเขตของปัญหา (ผู้ใช้ที่ได้รับผลกระทบ เวอร์ชันที่ได้รับผลกระทบ) ในขณะที่ข้อมูลเทเลเมทรีและ stack traces ให้เบาะแสในการสร้างข้อผิดพลาดซ้ำได้อย่างรวดเร็ว
กฎการทำงานของ Rollbar สามารถสร้างงานอัตโนมัติ กำหนดระดับความรุนแรง และส่งต่อไปยังผู้รับผิดชอบ ได้ ทำให้กระแสข้อผิดพลาดที่วุ่นวายกลายเป็นคิวงานที่จัดลำดับความสำคัญพร้อมข้อมูลบริบทที่แนบมาด้วย
8. PagerDuty AIOps และการอัตโนมัติของ runbook (วิธีวินิจฉัยที่ดีที่สุดแบบไม่ต้องใช้มือมาก)
PagerDutyใช้การเชื่อมโยงเหตุการณ์และเทคโนโลยีลดสัญญาณรบกวนที่อิงจาก ML เพื่อรวมการแจ้งเตือนจำนวนมากให้เป็นเหตุการณ์ที่สามารถดำเนินการได้
ระบบการกำหนดเส้นทางแบบไดนามิกจะส่งปัญหาไปยังผู้รับผิดชอบเวรที่เหมาะสมทันที ส่วนระบบอัตโนมัติตามคู่มือปฏิบัติการ (runbook) สามารถเริ่มกระบวนการวินิจฉัยหรือมาตรการบรรเทา (เช่น การรีสตาร์ทบริการ การย้อนกลับการปรับใช้ หรือการเปิด/ปิดฟีเจอร์แฟล็ก) ก่อนที่มนุษย์จะเข้ามาจัดการ สำหรับเวลาแก้ไขข้อผิดพลาด สิ่งนี้หมายถึง MTTA ที่สั้นลง การบรรเทาปัญหา P0 ที่รวดเร็วขึ้น และลดชั่วโมงที่สูญเสียไปจากความเหนื่อยล้าจากการแจ้งเตือน
จุดสำคัญคือการใช้ระบบอัตโนมัติร่วมกับ AI ในทุกขั้นตอน คุณจะสามารถตรวจพบข้อผิดพลาดได้เร็วขึ้น จัดเส้นทางแก้ไขได้อย่างชาญฉลาด เข้าถึงโค้ดได้เร็วขึ้น และแจ้งสถานะให้ทีมวิศวกรทราบโดยไม่ทำให้การทำงานของพวกเขาช้าลง — ทุกสิ่งเหล่านี้รวมกันจะนำไปสู่การลดเวลาแก้ไขข้อผิดพลาดได้อย่างมีนัยสำคัญ
📖 อ่านเพิ่มเติม: วิธีใช้ AI ใน DevOps
ตัวอย่างจริงจากการใช้ AI ในการแก้ไขข้อผิดพลาด
ดังนั้น AI ได้ก้าวออกจากห้องทดลองอย่างเป็นทางการแล้ว และกำลังช่วยลดเวลาแก้ไขข้อผิดพลาดในสภาพแวดล้อมจริง
มาดูกันเลย!
| โดเมน / องค์กร | วิธีใช้ AI | ผลกระทบ / ประโยชน์ |
|---|---|---|
| Ubisoft | ได้พัฒนา Commit Assistant ซึ่งเป็นเครื่องมือ AI ที่ได้รับการฝึกอบรมจากโค้ดภายในบริษัทตลอดระยะเวลา 10 ปี เพื่อคาดการณ์และป้องกันข้อผิดพลาดตั้งแต่ขั้นตอนการเขียนโค้ด | เป้าหมายคือการลดเวลาและค่าใช้จ่ายลงอย่างน่าทึ่ง — โดยปกติแล้วค่าใช้จ่ายในการพัฒนาเกมมีถึง 70% ที่ถูกใช้ไปกับการแก้ไขข้อผิดพลาด |
| Razer (Wyvrn Platform) | เปิดตัว QA Copilotที่ขับเคลื่อนด้วย AI (ผสานรวมกับ Unreal และ Unity)เพื่ออัตโนมัติการตรวจหาข้อผิดพลาดและสร้างรายงาน QA | เพิ่มประสิทธิภาพการตรวจพบข้อผิดพลาดได้สูงสุด 25% และลดเวลาการตรวจสอบคุณภาพ (QA) ลงครึ่งหนึ่ง |
| Google / DeepMind & Project Zero | เปิดตัวBig Sleep ซึ่งเป็นเครื่องมือ AI ที่สามารถตรวจหาจุดอ่อนด้านความปลอดภัยในซอฟต์แวร์โอเพนซอร์ส เช่น FFmpeg และ ImageMagick ได้อย่างอัตโนมัติ | ได้ระบุข้อผิดพลาด 20 รายการ ซึ่งทั้งหมดได้รับการตรวจสอบโดยผู้เชี่ยวชาญและกำหนดให้แก้ไขแล้ว |
| นักวิจัยจาก UC Berkeley | โดยใช้ชุดข้อมูลอ้างอิงชื่อCyberGymโมเดล AI ได้วิเคราะห์โครงการโอเพนซอร์ส 188 โครงการ ค้นพบช่องโหว่ 17 จุด — รวมถึงข้อบกพร่อง “zero-day” ที่ยังไม่เป็นที่รู้จัก 15 จุด — และสร้างโค้ดพิสูจน์แนวคิด (proof-of-concept) สำหรับการโจมตี | แสดงให้เห็นถึงความสามารถที่พัฒนาอย่างต่อเนื่องของ AI ในการตรวจหาจุดอ่อนและป้องกันการโจมตีแบบอัตโนมัติ |
| Spur (Yale Startup) | พัฒนาเอเยนต์ AIที่สามารถแปลงคำอธิบายกรณีทดสอบในภาษาธรรมดาให้เป็นขั้นตอนการทดสอบเว็บไซต์อัตโนมัติ— ซึ่งสามารถกล่าวได้ว่าเป็นกระบวนการ QA ที่เขียนตัวเองได้ | ช่วยให้การทดสอบสามารถดำเนินการได้โดยอัตโนมัติด้วยส่วนร่วมของมนุษย์ที่น้อยที่สุด |
| การจำลองรายงานข้อผิดพลาดของ Android แบบอัตโนมัติ | ใช้ NLP + การเรียนรู้แบบเสริมแรง (reinforcement learning) เพื่อวิเคราะห์ภาษาในรายงานข้อผิดพลาดและสร้างขั้นตอนเพื่อจำลองข้อผิดพลาดบน Android | ได้ความแม่นยำ 67% ความครอบคลุม 77% และสามารถจำลองรายงานข้อผิดพลาดได้ 74% ซึ่งให้ผลลัพธ์ที่ดีกว่าวิธีการแบบดั้งเดิม |
ข้อผิดพลาดที่พบบ่อยในการวัดเวลาแก้ไขข้อผิดพลาด
หากการวัดผลของคุณไม่ถูกต้อง แผนการปรับปรุงของคุณก็จะผิดพลาดตามไปด้วย
“ตัวเลขที่ไม่ถูกต้อง” ส่วนใหญ่ในกระบวนการแก้ไขข้อผิดพลาดเกิดจากคำนิยามที่ไม่ชัดเจน กระบวนการทำงานที่ไม่สอดคล้องกัน และการวิเคราะห์ที่ผิวเผิน
ดังนั้น ให้เริ่มจากพื้นฐานก่อน — สิ่งใดนับเป็นจุดเริ่มต้น/จุดสิ้นสุด, วิธีจัดการกับการรอคอยและการเปิดใหม่ — แล้ววิเคราะห์ข้อมูลตามประสบการณ์ของลูกค้า ซึ่งรวมถึง:
❌ ขอบเขตที่ไม่ชัดเจน: การผสมผสานระหว่าง "Reported→Resolved" และ "Reported→Closed" ในแดชบอร์ดเดียวกัน (หรือเปลี่ยนไปเปลี่ยนมาระหว่างเดือน) จะทำให้แนวโน้มไม่มีความหมาย เลือกขอบเขตหนึ่ง บันทึกไว้ และบังคับใช้กับทุกทีม หากจำเป็นต้องใช้ทั้งสอง ให้เผยแพร่เป็นเมตริกแยกกันพร้อมป้ายกำกับที่ชัดเจน
❌ วิธีใช้ค่าเฉลี่ยเพียงอย่างเดียว: การพึ่งพาค่าเฉลี่ยจะทำให้ความจริงของคิวที่มีกรณีผิดปกติไม่กี่กรณีที่ใช้เวลานานถูกซ่อนไว้ ใช้ค่ามัธยฐาน (P50) สำหรับเวลา “ทั่วไป” ของคุณ P90 สำหรับความสามารถในการคาดการณ์/SLA และเก็บค่าเฉลี่ยไว้สำหรับการวางแผนความจุ ให้ดูที่การแจกแจงเสมอ ไม่ใช่เพียงตัวเลขเดียว
❌ ไม่มีการแบ่งกลุ่ม: การรวมข้อผิดพลาดทั้งหมดเข้าด้วยกันจะทำให้เหตุการณ์ P0 ผสมกับข้อผิดพลาด P3 ที่ไม่ส่งผลต่อฟังก์ชันหลัก แบ่งกลุ่มตามระดับความรุนแรง แหล่งที่มา (ลูกค้า vs. QA vs. การเฝ้าติดตาม) ส่วนประกอบ/ทีม และ “ใหม่ vs. การกลับสู่ข้อผิดพลาดเดิม” P90 ของ P0/P1 คือสิ่งที่ผู้มีส่วนได้ส่วนเสียรู้สึก ส่วนค่ามัธยฐานของ P2+ คือสิ่งที่ทีมวิศวกรรมใช้ในการวางแผน
❌ การไม่คำนึงถึงเวลา “หยุดชั่วคราว”: กำลังรอข้อมูลบันทึกของลูกค้า ผู้ให้บริการภายนอก หรือช่วงเวลาปล่อยเวอร์ชันใหม่หรือไม่? หากไม่ติดตามสถานะ “ถูกบล็อก” หรือ “หยุดชั่วคราว” ในฐานะสถานะหลัก เวลาการแก้ไขปัญหาจะกลายเป็นประเด็นโต้แย้ง ให้รายงานทั้งเวลาตามปฏิทินและเวลาที่ทำงานจริง เพื่อให้จุดคอขวดปรากฏชัดเจนและยุติการโต้แย้ง
❌ ช่องว่างในการปรับเวลาให้เป็นมาตรฐาน: การผสมผสานเขตเวลาหรือการสลับระหว่างชั่วโมงทำงานและชั่วโมงตามปฏิทินในระหว่างกระบวนการจะทำให้การเปรียบเทียบผิดเพี้ยน ปรับเวลาให้เป็นมาตรฐานในเขตเวลาเดียว (หรือ UTC) และตัดสินใจครั้งเดียวว่า SLA จะวัดเป็นชั่วโมงทำงานหรือชั่วโมงตามปฏิทิน; แล้วนำไปใช้อย่างสม่ำเสมอ
❌ ข้อมูลรับเรื่องที่ไม่ครบถ้วนและเรื่องซ้ำ: ข้อมูลสภาพแวดล้อม/การบิลด์ที่ขาดหายไปและเรื่องที่ซ้ำกันทำให้เวลาแก้ไขเพิ่มขึ้นและทำให้การกำหนดผู้รับผิดชอบสับสน ให้กำหนดมาตรฐานช่องข้อมูลที่จำเป็นเมื่อรับเรื่อง เพิ่มข้อมูลอัตโนมัติ (บันทึก, เวอร์ชัน, อุปกรณ์) และลบเรื่องซ้ำโดยไม่รีเซ็ตเวลา — ปิดเรื่องซ้ำโดยตั้งค่าเป็น “เรื่องที่เชื่อมโยง” ไม่ใช่ “เรื่องใหม่”
❌ โมเดลสถานะที่ไม่สอดคล้องกัน: สถานะที่กำหนดเอง (“QA Ready-ish,” “Pending Review 2”) ทำให้เวลาที่อยู่ในสถานะนั้นไม่ชัดเจน และทำให้การเปลี่ยนสถานะไม่น่าเชื่อถือ กำหนดเวิร์กโฟลว์มาตรฐาน (New → Triaged → In Progress → In Review → Resolved → Closed) และตรวจสอบสถานะที่อยู่นอกเส้นทางที่กำหนด
❌ ไม่เห็นเวลาในแต่ละสถานะ: ตัวเลข “เวลารวม” เพียงอย่างเดียวไม่สามารถบอกได้ว่างานติดขัดอยู่ที่ใด จับและตรวจสอบเวลาที่ใช้ในแต่ละสถานะ เช่น Triaged, In Review, Blocked และ QA หาก P90 ของการตรวจสอบโค้ดสูงกว่าการดำเนินการอย่างมาก การแก้ไขของคุณไม่ใช่ “เขียนโค้ดเร็วขึ้น” — แต่คือการปลดล็อกความจุในการตรวจสอบ
🧠 ข้อมูลน่าสนใจ: การแข่งขัน AI Cyber Challenge ล่าสุดของ DARPAได้แสดงให้เห็นถึงความก้าวหน้าอย่างก้าวกระโดดในด้านการอัตโนมัติของความปลอดภัยไซเบอร์ การแข่งขันนี้เน้นไปที่ระบบ AI ที่ออกแบบมาเพื่อตรวจหา ใช้ประโยชน์จาก และแก้ไขจุดอ่อนในซอฟต์แวร์ได้อย่างอัตโนมัติ — โดยไม่ต้องมีการแทรกแซงจากมนุษย์ ทีมผู้ชนะ “Team Atlanta” ได้ค้นพบ 77% ของข้อผิดพลาดที่ถูกฉีดเข้าไป และแก้ไข 61% ของข้อผิดพลาดเหล่านั้นได้อย่างน่าประทับใจ ซึ่งแสดงให้เห็นถึงพลังของ AI ที่ไม่เพียงแต่ค้นพบข้อบกพร่อง แต่ยังแก้ไขมันได้อย่างเชิงรุก
❌ การมองข้ามกรณีเปิดใหม่: การปฏิบัติต่อกรณีเปิดใหม่เหมือนเป็นข้อผิดพลาดใหม่จะทำให้เวลาถูกตั้งใหม่และทำให้ค่า MTTR ดูดีขึ้นอย่างผิดจริง ติดตามอัตราการเปิดใหม่และ “เวลาจนถึงการปิดอย่างมั่นคง” (ตั้งแต่รายงานครั้งแรกจนถึงการปิดครั้งสุดท้ายในทุกวงจร) การเพิ่มขึ้นของกรณีเปิดใหม่มักชี้ให้เห็นถึงการจำลองข้อผิดพลาดที่ไม่ชัดเจน ช่องว่างในการทดสอบ หรือการกำหนดเกณฑ์การเสร็จสิ้นที่ไม่ชัดเจน
❌ ไม่วัด MTTA: ทีมมักมุ่งเน้น MTTR แต่ละเลย MTTA (เวลาการรับรู้/การรับผิดชอบ) MTTA ที่สูงเป็นสัญญาณเตือนล่วงหน้าว่ากระบวนการแก้ไขจะยาวนาน วัดค่านี้ กำหนด SLA ตามระดับความรุนแรง และอัตโนมัติการส่งต่อ/การยกระดับเพื่อลดค่า MTTA ให้ต่ำลง
❌ AI/การอัตโนมัติโดยไม่มีระบบควบคุม: การให้ AI กำหนดระดับความรุนแรงหรือปิดกรณีที่ซ้ำกันโดยไม่ผ่านการตรวจสอบ อาจทำให้กรณีพิเศษถูกจัดประเภทผิดและบิดเบือนตัวชี้วัดอย่างเงียบๆ ใช้ AI เพื่อเสนอแนะ แต่ต้องมีการยืนยันจากมนุษย์สำหรับ P0/P1 และตรวจสอบประสิทธิภาพของโมเดลทุกเดือน เพื่อให้ข้อมูลของคุณยังคงน่าเชื่อถือ
เมื่อปรับให้ส่วนต่างๆ เหล่านี้แน่นขึ้น กราฟเวลาแก้ไขปัญหาของคุณจะสะท้อนความเป็นจริงได้อย่างแท้จริง จากจุดนั้น การปรับปรุงจะเกิดผลทวีคูณ: การรับเรื่องที่มีประสิทธิภาพมากขึ้นช่วยลด MTTA สถานะที่ชัดเจนขึ้นเผยให้เห็นจุดคอขวดที่แท้จริง และ P90 ที่แบ่งตามกลุ่มให้ผู้นำคำมั่นสัญญาที่คุณสามารถรักษาได้
⚡️ คลังแม่แบบ: 10 แม่แบบกรณีทดสอบสำหรับการทดสอบซอฟต์แวร์
แนวทางปฏิบัติที่ดีที่สุดเพื่อแก้ไขข้อผิดพลาดได้อย่างมีประสิทธิภาพยิ่งขึ้น
สรุปแล้ว นี่คือข้อสำคัญที่ควรจำไว้!
| 🧩 วิธีปฏิบัติที่ดีที่สุด | 💡 ความหมาย | 🚀 ทำไมเรื่องนี้จึงสำคัญ |
| ใช้ระบบติดตามข้อผิดพลาดที่เชื่อถือได้ | ติดตามข้อผิดพลาดทั้งหมดที่ถูกรายงานผ่านระบบติดตามข้อผิดพลาดแบบรวมศูนย์ | รับประกันว่าไม่มีข้อผิดพลาดใดที่ถูกละเลย และช่วยให้สามารถติดตามสถานะข้อผิดพลาดได้อย่างชัดเจนในทุกทีม |
| เขียนรายงานข้อผิดพลาดอย่างละเอียด | รวมบริบทภาพ ข้อมูลระบบปฏิบัติการ ขั้นตอนการจำลองปัญหา และระดับความรุนแรง | ช่วยนักพัฒนาแก้ไขข้อผิดพลาดได้เร็วขึ้น ด้วยข้อมูลสำคัญทั้งหมดที่จัดเตรียมไว้ล่วงหน้า |
| จัดประเภทและกำหนดลำดับความสำคัญของข้อผิดพลาด | ใช้แมทริกซ์ลำดับความสำคัญเพื่อจัดเรียงข้อผิดพลาดตามระดับความเร่งด่วนและผลกระทบ | ช่วยให้ทีมมุ่งเน้นแก้ไขข้อผิดพลาดสำคัญและปัญหาเร่งด่วนก่อน |
| ใช้ประโยชน์จากการทดสอบอัตโนมัติ | ดำเนินการทดสอบอัตโนมัติใน CI/CD pipeline ของคุณ | ช่วยตรวจพบปัญหาตั้งแต่เนิ่นๆ และป้องกันการเกิดข้อผิดพลาดซ้ำ |
| กำหนดแนวทางการรายงานที่ชัดเจน | จัดเตรียมแม่แบบและฝึกอบรมเกี่ยวกับวิธีการรายงานข้อผิดพลาด | ส่งผลให้ข้อมูลมีความแม่นยำและกระบวนการสื่อสารเป็นไปอย่างราบรื่นยิ่งขึ้น |
| ติดตามตัวชี้วัดหลัก | วัดเวลาแก้ไขปัญหา เวลาที่ผ่านไปแล้ว และเวลาตอบสนอง | ช่วยให้ติดตามและปรับปรุงประสิทธิภาพโดยใช้ข้อมูลในอดีต |
| ใช้แนวทางเชิงรุก | อย่ารอจนผู้ใช้มาบ่น—ทำการทดสอบอย่างเชิงรุก | ช่วยเพิ่มระดับความพึงพอใจของลูกค้าและลดภาระงานสนับสนุน |
| ใช้ประโยชน์จากเครื่องมืออัจฉริยะและ ML | ใช้การเรียนรู้ของเครื่องเพื่อคาดการณ์ข้อผิดพลาดและเสนอวิธีแก้ไข | ช่วยเพิ่มประสิทธิภาพในการระบุสาเหตุหลักและแก้ไขข้อผิดพลาด |
| ปรับให้สอดคล้องกับ SLA | ปฏิบัติตามข้อตกลงระดับบริการ (SLA) ที่ได้ตกลงกันไว้สำหรับการแก้ไขปัญหา | สร้างความเชื่อมั่นและตอบสนองความคาดหวังของลูกค้าได้อย่างทันท่วงที |
| ตรวจสอบและปรับปรุงอย่างต่อเนื่อง | วิเคราะห์ข้อผิดพลาดที่เปิดใหม่ รวบรวมความคิดเห็น และปรับปรุงกระบวนการ | ส่งเสริมการปรับปรุงกระบวนการพัฒนาและการจัดการข้อผิดพลาดอย่างต่อเนื่อง |
การแก้ไขข้อผิดพลาดอย่างง่ายดายด้วย AI ที่เข้าใจบริบท
ทีมแก้ไขข้อผิดพลาดที่เร็วที่สุดไม่พึ่งพาการแก้ปัญหาแบบฮีโร่ แต่พวกเขาออกแบบระบบ: การกำหนดจุดเริ่มต้นและจุดสิ้นสุดที่ชัดเจน การรับข้อผิดพลาดอย่างเป็นระบบ การจัดลำดับความสำคัญตามผลกระทบต่อธุรกิจ การกำหนดความรับผิดชอบที่ชัดเจน และวงจรการให้ข้อเสนอแนะที่แน่นหนา ระหว่างทีมสนับสนุน QA วิศวกรรม และการปล่อยเวอร์ชัน
ClickUp สามารถเป็นศูนย์ควบคุมที่ขับเคลื่อนด้วย AI สำหรับระบบแก้ไขข้อผิดพลาดของคุณได้ รวมทุกการรายงานไว้ในคิวเดียว มาตรฐานบริบทด้วยฟิลด์ที่มีโครงสร้าง และให้ AI ของ ClickUp ทำการจัดลำดับความสำคัญ สรุป และกำหนดลำดับความสำคัญ ในขณะที่ระบบอัตโนมัติบังคับใช้ SLA ยกระดับเมื่อเกินเวลาที่กำหนด และรักษาความสอดคล้องระหว่างผู้มีส่วนได้ส่วนเสีย เชื่อมโยงข้อผิดพลาดกับลูกค้า โค้ด และการปล่อยเวอร์ชัน เพื่อให้ผู้บริหารเห็นผลกระทบ และผู้ปฏิบัติงานสามารถทำงานได้อย่างต่อเนื่อง
หากคุณพร้อมที่จะลดเวลาแก้ไขข้อผิดพลาดและทำให้แผนงานของคุณคาดการณ์ได้มากขึ้นสมัครใช้ ClickUpและเริ่มวัดผลความก้าวหน้าภายในไม่กี่วัน — ไม่ใช่ภายในหลายไตรมาส
คำถามที่มักถูกถาม
เวลาแก้ไขข้อผิดพลาดที่ถือว่าดีคือเท่าไร?
ไม่มีตัวเลข “ที่ดี” เพียงตัวเลขเดียว — มันขึ้นอยู่กับระดับความรุนแรง แบบการปล่อยเวอร์ชัน และระดับความทนทานต่อความเสี่ยง ใช้ค่ามัธยฐาน (P50) สำหรับประสิทธิภาพ “ทั่วไป” และ P90 สำหรับคำสัญญา/SLA พร้อมทั้งแบ่งกลุ่มตามระดับความรุนแรงและแหล่งที่มา
ความแตกต่างระหว่างการแก้ไขข้อผิดพลาดและการปิดข้อผิดพลาดคืออะไร?
“Resolution” คือเมื่อการแก้ไขถูกนำไปใช้ (เช่น การรวมโค้ด การปรับใช้การตั้งค่า) และทีมพิจารณาว่าข้อบกพร่องได้รับการแก้ไขแล้ว “Closure” คือเมื่อปัญหาได้รับการตรวจสอบและปิดอย่างเป็นทางการ (เช่น การตรวจสอบโดย QA ในสภาพแวดล้อมเป้าหมาย การปล่อยเวอร์ชัน หรือการทำเครื่องหมายว่า “ไม่แก้ไข”/“ซ้ำ” พร้อมเหตุผล) ทีมหลายทีมวัดทั้งสองอย่าง: “Reported→Resolved” สะท้อนความเร็วของทีมวิศวกรรม; “Reported→Closed” สะท้อนกระบวนการคุณภาพแบบ end-to-end ใช้คำนิยามที่สอดคล้องกันเพื่อไม่ให้แดชบอร์ดผสมผสานขั้นตอนต่าง ๆ เข้าด้วยกัน
ความแตกต่างระหว่างเวลาแก้ไขข้อผิดพลาดกับเวลาตรวจพบข้อผิดพลาดคืออะไร?
เวลาตรวจพบ (MTTD) คือระยะเวลาที่ใช้ในการค้นพบข้อบกพร่องหลังจากที่มันเกิดขึ้นหรือถูกส่งออกไป — ผ่านระบบการเฝ้าติดตาม, QA หรือผู้ใช้ เวลาแก้ไข คือระยะเวลาที่ใช้ตั้งแต่การตรวจพบ/รายงาน จนถึงการนำการแก้ไขไปใช้ (และหากต้องการ สามารถตรวจสอบความถูกต้อง/ปล่อยออกได้) เมื่อรวมกันแล้ว ทั้งสองตัวชี้วัดนี้กำหนดช่วงเวลาที่ส่งผลกระทบต่อลูกค้า: ตรวจพบเร็ว, ยืนยันเร็ว, แก้ไขเร็ว และปล่อยออกอย่างปลอดภัย คุณยังสามารถติดตาม MTTA (เวลาในการรับทราบ/จัดสรร) เพื่อตรวจหาความล่าช้าในการจัดลำดับความสำคัญ ซึ่งมักเป็นสัญญาณบ่งชี้ว่าเวลาแก้ไขจะยาวนานขึ้น
AI ช่วยในการแก้ไขข้อผิดพลาดอย่างไร?
AI ช่วยย่นระยะเวลาในขั้นตอนต่าง ๆ ที่มักทำให้กระบวนการล่าช้า ได้แก่ การรับเรื่อง การจัดลำดับความสำคัญ การวินิจฉัย การแก้ไข และการตรวจสอบ
- การรับข้อมูลและจัดประเภท: สรุปอัตโนมัติรายงานที่ยาว, สกัดขั้นตอนการจำลองข้อผิดพลาด/สภาพแวดล้อม, ระบุข้อผิดพลาดที่ซ้ำกัน, และเสนอระดับความรุนแรง/ความสำคัญ เพื่อให้วิศวกรสามารถเริ่มทำงานด้วยบริบทที่ชัดเจน (เช่น ClickUp AI, Sentry AI)
- การจัดเส้นทางและ SLA: คาดการณ์ส่วนประกอบ/ผู้รับผิดชอบที่อาจเกี่ยวข้อง ตั้งตัวจับเวลา และส่งต่อเมื่อ MTTA หรือเวลารอการตรวจสอบเกินกำหนด — ลด “เวลาในสถานะ” ที่ไม่เกิดประโยชน์ (ClickUp Automations และกระบวนการทำงานแบบตัวแทน)
- การวินิจฉัย: จัดกลุ่มข้อผิดพลาดที่คล้ายกัน, วิเคราะห์ความสัมพันธ์ระหว่างการเพิ่มขึ้นอย่างกะทันหันกับ commit/release ล่าสุด, และชี้ให้เห็นสาเหตุหลักที่เป็นไปได้ด้วย stack traces และบริบทของโค้ด (Sentry AI และเครื่องมือที่คล้ายกัน)
- การนำไปใช้: เสนอการปรับเปลี่ยนโค้ดและการทดสอบโดยอ้างอิงจากรูปแบบในรีโพสิตอรีของคุณ เพื่อเร่งความเร็วของวงจร “เขียน/แก้ไข” (GitHub Copilot; Snyk Code AI by DeepCode).
- การตรวจสอบและการสื่อสาร: เขียนกรณีทดสอบจากขั้นตอนการจำลองปัญหา, ร่างบันทึกการปล่อยเวอร์ชันและอัปเดตสำหรับผู้มีส่วนได้ส่วนเสีย, และสรุปสถานะสำหรับผู้บริหารและลูกค้า (ClickUp AI) เมื่อใช้ร่วมกัน—ClickUp เป็นศูนย์บัญชาการร่วมกับ Sentry/Copilot/DeepCode ในระบบ—ทีมสามารถลดเวลา MTTA/P90 ได้โดยไม่ต้องพึ่งพาความพยายามแบบฮีโร่