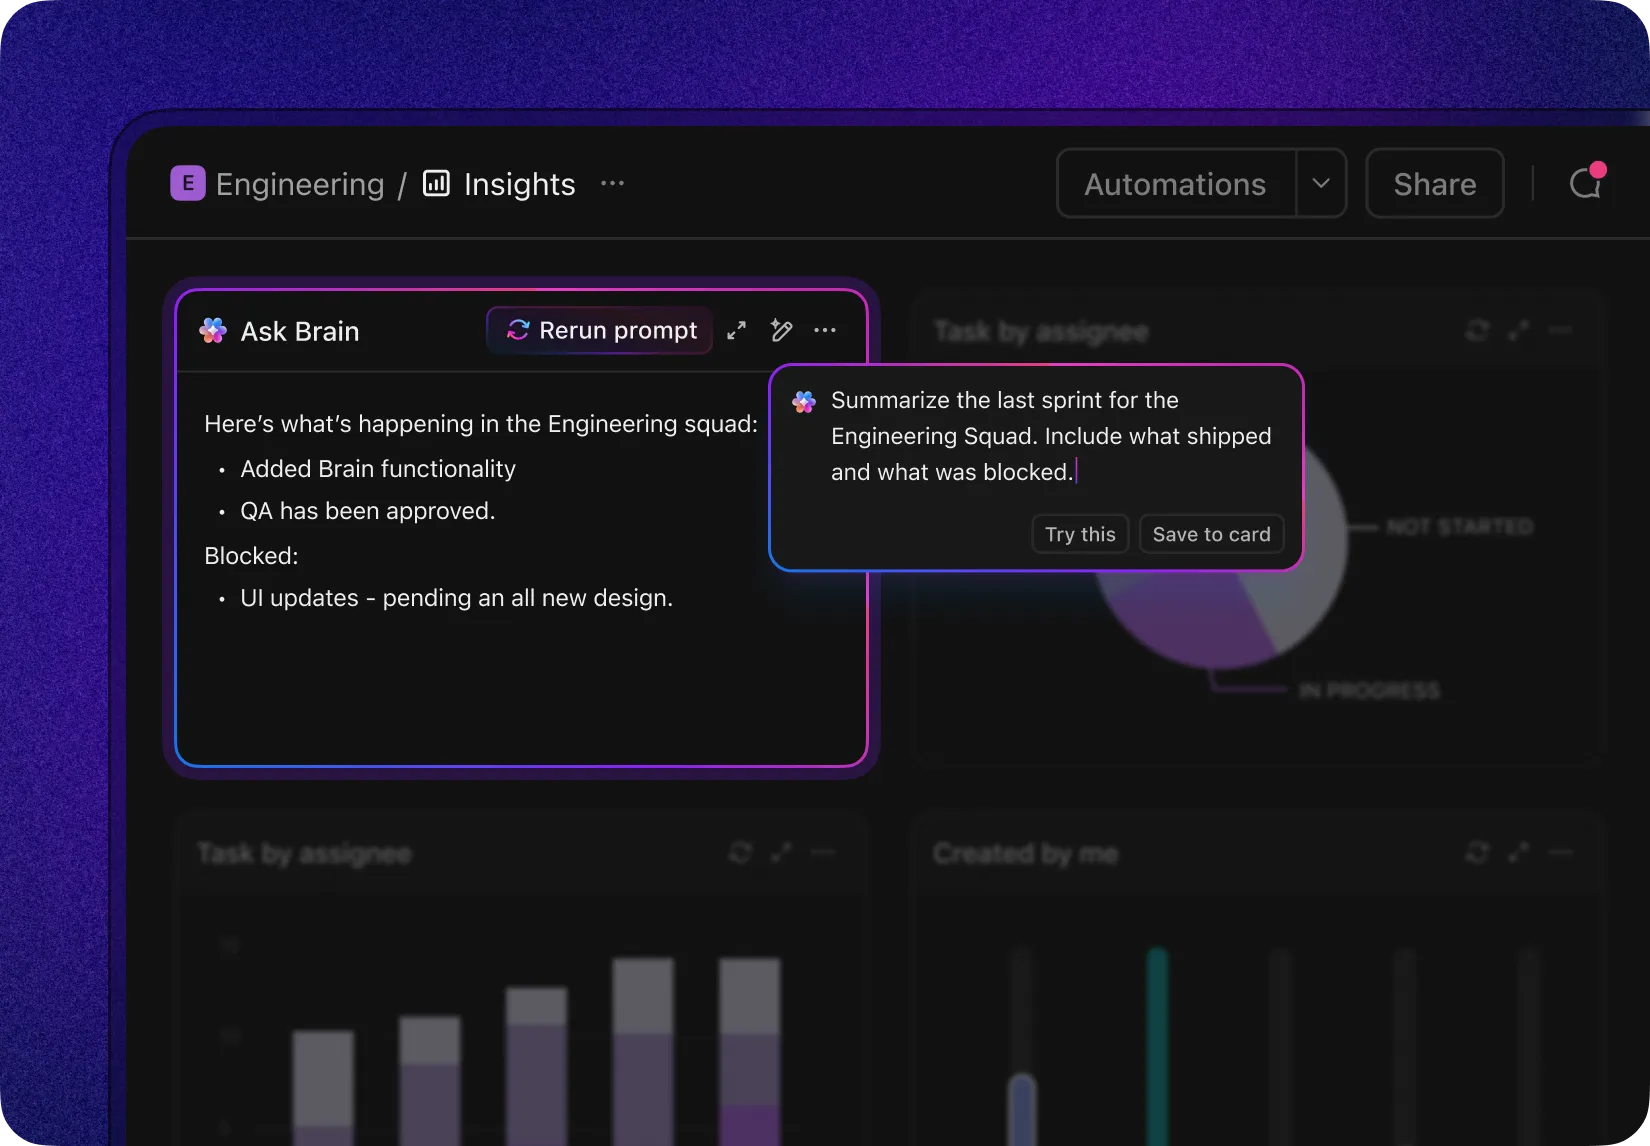
Du släpper den senaste programuppdateringen, och rapporterna börjar strömma in.
Plötsligt styr ett enda mått allt från kundnöjdhet (CSAT)/NPS till förseningar i utvecklingsplanen: felhanteringstiden.
Ledningen ser det som ett mått på hur väl löften uppfylls – kan vi leverera, lära oss och säkra intäkterna enligt tidsplanen? De som arbetar i det dagliga arbetet känner av problemen på nära håll – dubbla ärenden, oklart ansvar, onödiga eskaleringar och information utspridd över Slack, kalkylark och separata verktyg.
Denna fragmentering förlänger hanteringscyklerna, döljer de bakomliggande orsakerna och gör prioriteringen till en gissningslek.
Resultatet? Långsammare inlärning, missade åtaganden och en backlog som i det tysta belastar varje sprint.
Den här guiden är din heltäckande handbok för att mäta, jämföra och förkorta tiden för felhantering, och visar konkret hur AI förändrar arbetsflödet jämfört med traditionella, manuella processer.
Vad är felhanteringstid?
Felsättningstiden är den tid det tar att åtgärda ett fel, mätt från det ögonblick felet rapporteras till dess att det är helt åtgärdat.
I praktiken börjar klockan ticka när ett problem rapporteras eller upptäcks (via användare, kvalitetssäkring eller övervakning) och stannar när korrigeringen har implementerats och sammanfogats, redo för verifiering eller release – beroende på hur ditt team definierar ”klar”.
Exempel: en P1-krasch som rapporterades kl. 10.00 på måndagen, med en korrigering som införlivades kl. 15.00 på tisdagen, har en lösningstid på cirka 29 timmar.
Det är inte samma sak som felupptäckningstiden. Upptäckningstiden mäter hur snabbt du upptäcker ett fel efter att det har inträffat (larm utlöses, QA-testverktyg upptäcker det, kunder rapporterar det).
Åtgärdstiden mäter hur snabbt du går från att upptäcka ett fel till att åtgärda det – prioritering, reproduktion, diagnostik, implementering, granskning, testning och förberedelse inför release. Tänk på upptäckten som ”vi vet att det är fel” och åtgärden som ”det är fixat och klart”.
Olika team använder något olika gränsvärden; välj ett och håll dig till det så att dina trender blir representativa:
- Rapporterad → Löst: Avslutas när kodkorrigeringen har sammanfogats och är klar för kvalitetsgranskning. Bra för utvecklingsgenomströmningen
- Rapporterad → Avslutad: Inkluderar kvalitetskontroll och release. Passar bäst för SLA:er som påverkar kunderna
- Upptäckt → Löst: Processen inleds när övervakning/kvalitetssäkring upptäcker problemet, redan innan ett ärende har skapats. Användbart för team med hög produktionsbelastning
🧠 Rolig fakta: Ett udda men samtidigt roligt fel i Final Fantasy XIV fick beröm för att det var så specifikt att läsarna döpte det till ”Den mest specifika felkorrigeringen i ett MMO 2025”. ” Den uppstod när spelare prissatte föremål till exakt mellan 44 442 gil och 49 087 gil i en viss evenemangszon – vilket orsakade avbrott i anslutningen på grund av vad som kan ha varit ett fel i samband med heltalöverskridning.
Varför det är viktigt
Åtgärdstiden är en faktor som påverkar releasetakten. Långa eller oförutsägbara åtgärdstider tvingar fram nedskärningar i omfattningen, snabbkorrigeringar och frysta releaser; de skapar planeringsskuld eftersom de långa svansarna (avvikelserna) stör sprinten mer än genomsnittet antyder.
Det har också en direkt koppling till kundnöjdheten. Kunderna accepterar problem om de snabbt bekräftas och löses på ett förutsägbart sätt. Långsamma lösningar – eller ännu värre, varierande lösningar – leder till eskaleringar, försämrar CSAT/NPS och äventyrar förnyelserna.
Kort sagt: om du mäter tiden för felhantering på ett tydligt sätt och systematiskt minskar den kommer dina roadmap och relationer att förbättras.
Hur mäter man tiden för felhantering?
Bestäm först var din tidräkning börjar och slutar.
De flesta team väljer antingen Rapporterad → Löst (korrigeringen har slås samman och är klar för verifiering) eller Rapporterad → Stängd (QA har validerat och ändringen har släppts eller på annat sätt stängts).
Välj en definition och använd den konsekvent så att dina trender blir meningsfulla.
Nu behöver du några mätbara nyckeltal. Låt oss gå igenom dem:
Viktiga nyckeltal för felhantering att hålla koll på:
| 📊 Mätvärde | 📌 Vad det står för | 💡 Så här hjälper det | 🧮 Formel (om tillämpligt) |
|---|---|---|---|
| Antal buggar 🐞 | Totalt antal rapporterade fel | Ger en översikt över systemets hälsa. Högt värde? Dags att undersöka saken. | Totalt antal fel = Alla fel som registrerats i systemet {Öppna + Stängda} |
| Öppna fel 🚧 | Fel som ännu inte har åtgärdats | Visar aktuell arbetsbelastning. Hjälper till med prioritering. | Öppna fel = Totalt antal fel – Stängda fel |
| Åtgärdade fel ✅ | Fel som har åtgärdats och verifierats | Spårar framsteg och utfört arbete. | Stängda fel = Antal fel med statusen ”Stängd” eller ”Löst” |
| Felets allvarlighetsgrad 🔥 | Feletens allvarlighetsgrad (t.ex. kritiskt, större, mindre) | Underlättar prioritering utifrån påverkan. | Spåras som kategorifält, ingen formel. Använd filter/gruppering. |
| Felförstöring 📅 | Hur brådskande det är att åtgärda ett fel | Underlättar planeringen av sprintar och releaser. | Även ett kategorifält, vanligtvis rangordnat (t.ex. P0, P1, P2). |
| Tid till lösning ⏱️ | Tid från felanmälan till åtgärd | Mäter responsivitet. | Åtgärdstid = Datum för avslutning – Datum för rapportering |
| Andel återöppnade ärenden 🔄 | Procentandel fel som återöppnats efter att ha stängts | Återspeglar kvaliteten på korrigeringar eller regressionsproblem. | Återöppningsgrad (%) = {Återöppnade fel ÷ Totalt antal avslutade fel} × 100 |
| Bug Leakage 🕳️ | Fel som smugit sig in i produktionen | Visar effektiviteten inom kvalitetssäkring och mjukvarutestning. | Läckagefrekvens (%) = {Produktionsfel ÷ Totalt antal fel} × 100 |
| Felintensitet 🧮 | Fel per storleksenhet av kod | Markerar riskbenägna kodområden. | Feltäthet = Antal fel ÷ KLOC {Kilo Lines of Code} |
| Tilldelade vs. icke tilldelade fel 👥 | Fördelning av fel efter ansvarig | Säkerställer att inget faller mellan stolarna. | Använd ett filter: Ej tilldelade = Fel där "Tilldelad till" är tomt |
| Ålder på öppna fel 🧓 | Hur länge ett fel förblir olöst | Upptäck risker för stagnation och arbetsstockning. | Fels ålder = dagens datum – datum då felet rapporterades |
| Dubbletter av fel 🧬 | Antal dubbletter | Belyser fel i intagsprocesserna. | Andel dubbletter = Antal dubbletter ÷ Totalt antal fel × 100 |
| MTTD (Mean Time to Detect) 🔎 | Genomsnittlig tid för att upptäcka fel eller incidenter | Mäter effektiviteten i övervakning och medvetenhet. | MTTD = Σ(Upptäcktstid – Introduktionstid) ÷ Antal fel |
| MTTR (Mean Time to Resolve) 🔧 | Genomsnittlig tid för att helt åtgärda ett fel efter upptäckt | Spårar teknikteamets respons och tiden det tar att åtgärda fel. | MTTR = Σ(Tid för åtgärd – Tid för upptäckt) ÷ Antal åtgärdade fel |
| MTTA (Mean Time to Acknowledge) 📬 | Tiden från upptäckt till dess att någon börjar arbeta med felet | Visar teamets reaktionsförmåga och hur snabbt man svarar på varningar. | MTTA = Σ(Tid för bekräftelse – Tid för upptäckt) ÷ Antal fel |
| MTBF (Mean Time Between Failures) 🔁 | Tiden mellan ett åtgärdat fel och nästa fel som inträffar | Indikerar stabilitet över tid. | MTBF = Total drifttid ÷ Antal fel |
Faktorer som påverkar tiden för felhantering
Åtgärdstiden likställs ofta med ”hur snabbt utvecklare kodar”.
Men det är bara en del av processen.
Felsättningstiden är summan av kvaliteten vid mottagandet, flödeseffektiviteten genom ditt system och beroenderisken. När någon av dessa faktorer sviktar förlängs cykeltiden, förutsägbarheten minskar och klagomålen blir allt fler.
Kvaliteten på ärendehanteringen sätter tonen
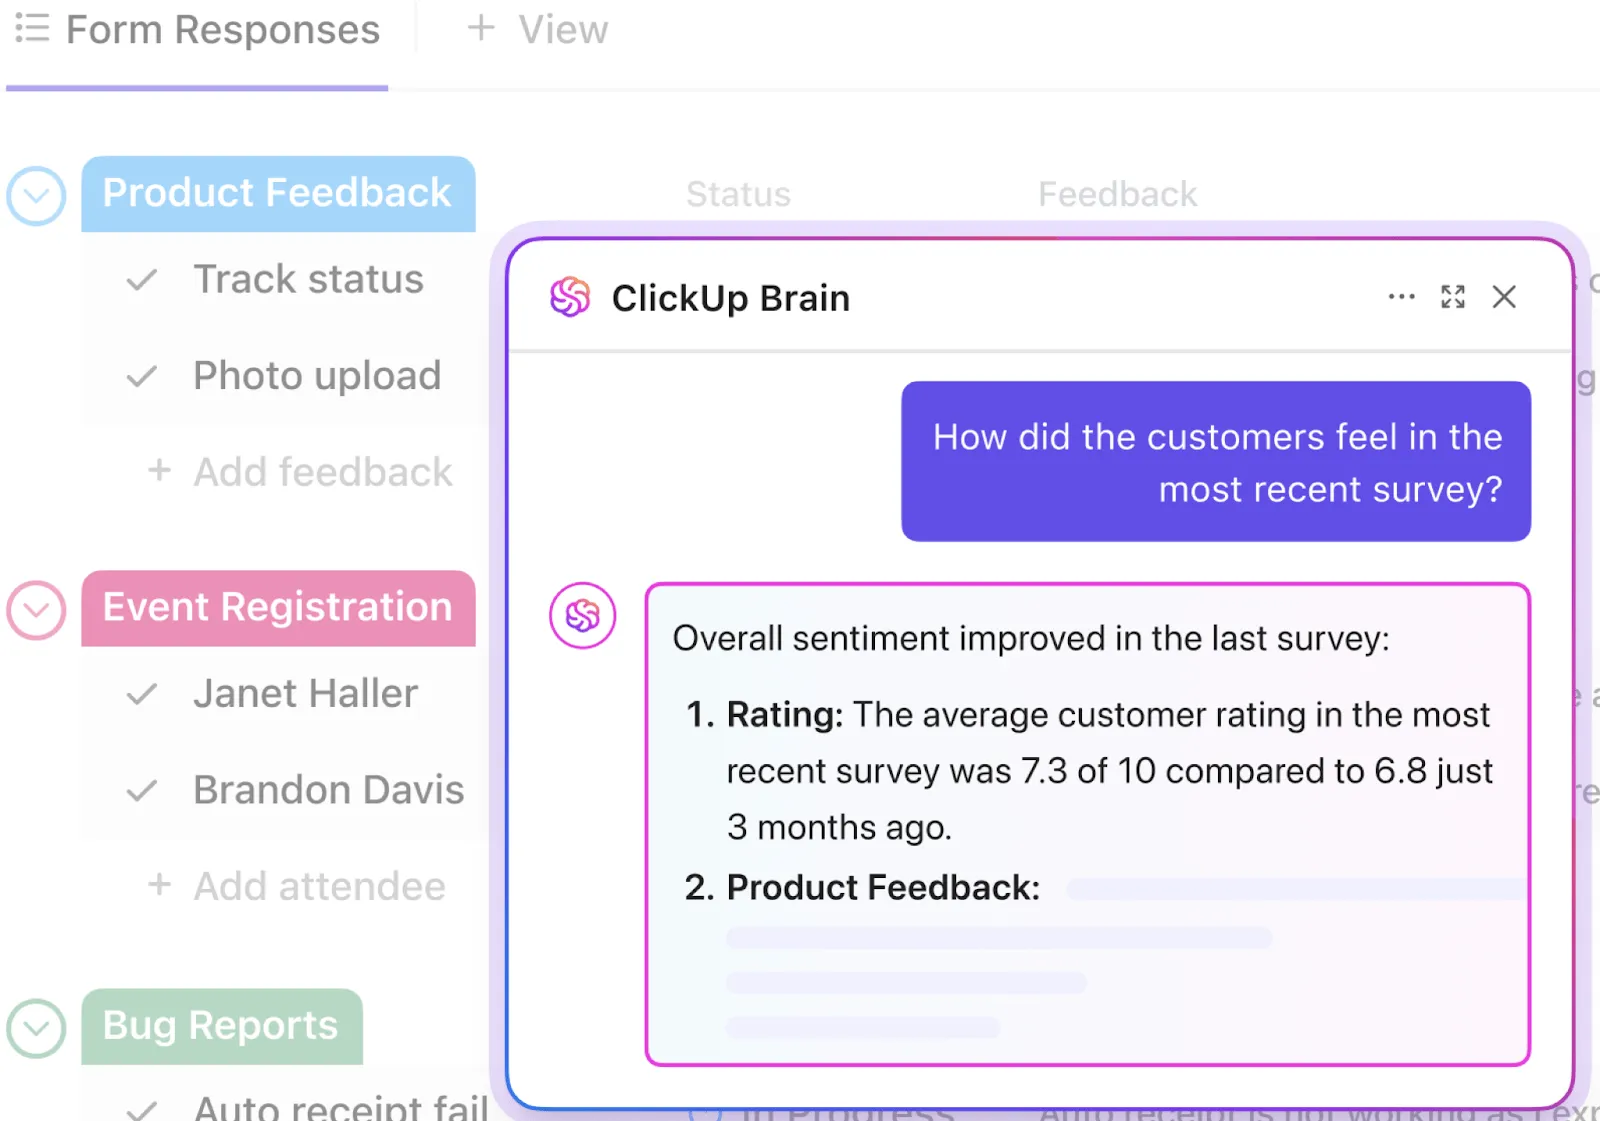
Rapporter som saknar tydliga steg för att återskapa felet, miljöuppgifter, loggar eller versions-/bygginformation leder till onödigt fram och tillbaka. Dubbletter av rapporter från flera kanaler (support, kvalitetssäkring, övervakning, Slack) skapar oordning och splittrar ansvaret.
Ju tidigare du fångar upp rätt sammanhang – och eliminerar dubbletter – desto färre överlämningar och förtydliganden behöver du senare.
Prioritering och vidarebefordran avgör vem som hanterar felet och när
Allvarlighetsgrader som inte motsvarar påverkan på kunder eller verksamheten (eller som förändras över tid) orsakar kaos i köerna: de mest högljudda ärendena tränger sig före i kön medan fel med stor påverkan lämnas åt sidan.
Tydliga vidarebefordringsregler per komponent/ansvarig och en enda ”sanningskö” förhindrar att P0/P1-ärenden begravs under ”nya och högljudda” ärenden.
Ansvarsfördelning och överlämningar är tysta mördare
Om det är oklart om en bugg tillhör mobil-, backend-autentiserings- eller plattformsteamet, skickas den vidare. Varje vidarebefordran återställer sammanhanget.
Tidszoner förvärrar situationen: ett fel som rapporteras sent på dagen utan någon namngiven ansvarig kan gå 12–24 timmar innan någon ens börjar återskapa felet. Tydliga definitioner av ”vem som ansvarar för vad”, med en jourhavande eller en veckovis DRI, eliminerar den fördröjningen.
Reproducerbarheten beror på observerbarheten
Glesa loggar, saknade korrelations-ID:n eller avsaknad av kraschspår gör felsökningen till en gissningslek. Fel som endast uppträder med specifika flaggor, kunder eller datastrukturer är svåra att återskapa i utvecklingsmiljön.
Om utvecklare inte kan få säker åtkomst till rensade, produktionsliknande data tvingas de till slut att instrumentera, distribuera om och vänta – i dagar istället för timmar.
Miljö- och dataparitet säkerställer tillförlitlighet
”Det fungerar på min dator” betyder oftast ”produktionsdata är annorlunda”. Ju mer din utvecklings- och testmiljö skiljer sig från produktionsmiljön (konfiguration, tjänster, versioner från tredjepartsleverantörer), desto mer tid kommer du att lägga på att jaga spöken. Säkra datamomentbilder, seed-skript och paritetskontroller minskar den skillnaden.
Pågående arbete (WIP) och fokus driver den faktiska genomströmningen
Överbelastade team tar sig an för många buggar samtidigt, splittrar sin uppmärksamhet och rusar mellan uppgifter och möten. Att byta mellan olika sammanhang lägger till osynliga timmar.
En synlig gräns för pågående arbete och en inställning att avsluta det man påbörjat innan man tar sig an nya uppgifter kommer att sänka din median snabbare än någon enskild hjältes insats.
Kodgranskning, CI och QA-hastighet är klassiska flaskhalsar
Långa byggtider, opålitliga tester och otydliga SLA:er för granskning fördröjer annars snabba korrigeringar. En 10-minuterspatch kan ta två dagar att vänta på en granskare eller att få plats i en flera timmar lång pipeline.
På samma sätt kan QA-köer som använder batchtestning eller förlitar sig på manuella rökprov lägga till hela dagar till processen ”Rapporterad → Stängd”, även när ”Rapporterad → Löst” går snabbt.
Beroenden förlänger köerna
Förändringar som berör flera team (schema, plattformsmigreringar, SDK-uppdateringar), leverantörsfel eller granskningar i appbutiker (mobil) skapar väntetider. Utan explicit spårning av ”Blockerad/Pausad” blåser dessa väntetider upp dina genomsnitt på ett osynligt sätt och döljer var den verkliga flaskhalsen finns.
Release-modell och återgångsstrategi är viktiga
Om du levererar i stora release-tåg med manuella kontrollpunkter får även åtgärdade buggar vänta tills nästa tåg avgår. Feature flags, canary-releaser och hotfix-banor förkortar väntetiden – särskilt för P0/P1-incidenter – genom att du kan separera distributionen av korrigeringar från de fullständiga releasecyklerna.
Arkitekturen och den tekniska skulden sätter gränsen för vad du kan uppnå
Tät koppling, brist på testgränssnitt och ogenomskinliga äldre moduler gör enkla korrigeringar riskfyllda. Team kompenserar detta med extra testning och längre granskningar, vilket förlänger utvecklingscyklerna. Omvänt gör modulär kod med bra kontraktstester att du kan agera snabbt utan att störa angränsande system.
Kommunikation och statushantering påverkar förutsägbarheten
Vaga uppdateringar (”vi tittar på det”) leder till omarbete när intressenter frågar efter beräknad tid, supporten återöppnar ärenden eller produktteamet eskalerar ärendet. Tydliga statusändringar, anteckningar om hur felet kan återskapas och dess grundorsak samt en angiven beräknad tid minskar avhopp och hjälper ditt teknikteam att behålla fokus.
📮ClickUp Insight: En genomsnittlig yrkesverksam person lägger över 30 minuter om dagen på att söka efter arbetsrelaterad information – det innebär över 120 timmar om året som går förlorade på att leta igenom e-postmeddelanden, Slack-trådar och utspridda filer.
En intelligent AI-assistent integrerad i din arbetsmiljö kan ändra på det. Upptäck ClickUp Brain. Den ger omedelbara insikter och svar genom att på några sekunder visa rätt dokument, konversationer och uppgiftsdetaljer – så att du kan sluta söka och börja arbeta.
💫 Konkreta resultat: Team som QubicaAMF har sparat mer än 5 timmar per vecka med hjälp av ClickUp – det motsvarar över 250 timmar per år och person – genom att eliminera föråldrade processer för kunskapshantering. Tänk vad ditt team skulle kunna åstadkomma med en extra veckas produktivitet varje kvartal!
Tidiga tecken på att din åtgärdstid kommer att förlängas
❗️Ökande ”tid till bekräftelse” och många ärenden utan ansvarig i mer än 12 timmar
❗️Allt längre tidsintervall för ”Time in Review/CI” och ofta förekommande testinstabilitet
❗️Hög andel dubbletter vid registrering och inkonsekventa allvarlighetsgrader mellan olika team
❗️Flera fel som ligger i statusen ”Blockerad” utan angiven extern beroende
❗️Andelen återöppnade ärenden ökar (korrigeringarna går inte att återskapa eller definitionerna av ”klar” är otydliga)
Olika organisationer upplever dessa faktorer på olika sätt. Ledningen upplever dem som förlorade inlärningscykler och förseningar i förhållande till intäktsmöjligheter, medan operatörerna upplever dem som störande triage och otydligt ansvar.
Genom att finjustera intag, flöde och beroenden kan du sänka hela kurvan – både medianen och P90.
Vill du lära dig mer om hur man skriver bättre felrapporter? Börja här. 👇🏼
Branschriktlinjer för felhanteringstid
Jämförelsetalen för felhantering varierar beroende på risktolerans, releasemodell och hur snabbt du kan leverera ändringar.
Här kan du använda medianvärden (P50) för att förstå ditt typiska flöde och P90 för att fastställa löften och SLA:er – efter allvarlighetsgrad och källa (kund, kvalitetssäkring, övervakning).
Låt oss gå igenom vad det innebär:
| 🔑 Term | 📝 Beskrivning | 💡 Varför det är viktigt |
|---|---|---|
| P50 (median) | Medelvärdet – 50 % av felkorrigeringarna går snabbare än så, och 50 % går långsammare | 👉 Speglar din typiska eller vanligaste lösningstid. Bra för att förstå normal prestanda |
| P90 (90:e percentilen) | 90 % av felen åtgärdas inom denna tid. Endast 10 % tar längre tid | 👉 Representerar en värsta tänkbara (men ändå realistisk) gräns. Användbart för att fastställa externa löften |
| SLA:er (servicenivåavtal) | De åtaganden du gör – internt eller gentemot kunder – om hur snabbt problem kommer att åtgärdas | 👉 Exempel: ”Vi löser P1-fel inom 48 timmar i 90 % av fallen.” Bidrar till att bygga upp förtroende och ansvarskänsla |
| Efter allvarlighetsgrad och källa | Segmentera dina mätvärden efter två viktiga dimensioner: • Allvarlighetsgrad (t.ex. P0, P1, P2) • Källa (t.ex. kund, kvalitetssäkring, övervakning) | 👉 Möjliggör mer exakt spårning och prioritering, så att kritiska fel får uppmärksamhet snabbare |
Nedan visas riktvärden baserade på branscher som erfarna team ofta riktar in sig på; betrakta dem som utgångspunkter och anpassa dem sedan efter din specifika situation.
SaaS
Systemet är alltid i drift och anpassat för CI/CD, vilket innebär att snabbkorrigeringar är vanliga. För kritiska problem (P0/P1) är målet ofta en median på mindre än en arbetsdag, med P90 inom 24–48 timmar. Icke-kritiska problem (P2+) har vanligtvis en median på 3–7 dagar, med P90 inom 10–14 dagar. Team med robusta funktionsflaggor och automatiserade tester tenderar att ligga i den snabbare änden av skalan.
E-handelsplattformar
Eftersom konverterings- och kundvagnsflöden är avgörande för intäkterna är kraven högre. P0/P1-problem åtgärdas vanligtvis inom några timmar (återställning, flaggning eller konfiguration) och löses helt samma dag; P90 vid slutet av dagen eller inom <12 timmar är vanligt under högsäsong. P2+-problem löses ofta inom 2–5 dagar, med P90 inom 10 dagar.
Företagsprogramvara
Mer omfattande validering och kundernas ändringsfönster saktar ner takten. För P0/P1 siktar teamen på en tillfällig lösning inom 4–24 timmar och en permanent lösning inom 1–3 arbetsdagar; P90 inom 5 arbetsdagar. P2+-ärenden samlas ofta i releasetåg, med medianvärden på 2–4 veckor beroende på kundernas lanseringsscheman.
Spel och mobilappar
Backend-system för live-tjänster fungerar som SaaS (flaggor och återställningar på några minuter till timmar; P90 samma dag). Klientuppdateringar begränsas av granskningar i appbutiken: P0/P1 använder ofta serverbaserade åtgärder omedelbart och släpper en klientpatch inom 1–3 dagar; P90 inom en vecka med påskyndad granskning. P2+-korrigeringar planeras vanligtvis in i nästa sprint eller innehållsrelease.
Bank/Fintech
Risk- och efterlevnadskontroller driver ett mönster där man ”åtgärdar snabbt, ändrar försiktigt”. P0/P1 åtgärdas snabbt (varningsflaggor, återställningar, trafikomdirigeringar inom några minuter till timmar) och åtgärdas fullständigt inom 1–3 dagar; P90 inom en vecka, med hänsyn till ändringskontroll. P2+ tar ofta 2–6 veckor att genomgå säkerhets-, revisions- och CAB-granskningar.
Om dina siffror ligger utanför dessa intervall bör du granska kvaliteten på ärendehanteringen, ärendefördelning/ansvar, kodgranskning och QA-genomströmning samt godkännanden av beroenden innan du antar att ”teknisk hastighet” är kärnproblemet.
🌼 Visste du att: Enligt en undersökning från Stack Overflow från 2024 använde utvecklare i allt högre grad AI som sin pålitliga medhjälpare under hela kodningsprocessen. Hela 82 % använde AI för att faktiskt skriva kod – snacka om en kreativ medarbetare! När de fastnade eller letade efter lösningar förlitade sig 67,5 % på AI för att söka efter svar, och över hälften (56,7 %) använde det för felsökning och för att få hjälp.
För vissa visade sig AI-verktyg också vara praktiska för att dokumentera projekt (40,1 %) och till och med för att snabbt skapa syntetiska data eller innehåll (34,8 %). Nyfiken på en ny kodbas? Nästan en tredjedel (30,9 %) använder AI för att snabbt sätta sig in i den. Att testa kod är fortfarande ett manuellt slit för många, men 27,2 % har anammat AI även här. Andra områden som kodgranskning, projektplanering och prediktiv analys uppvisar en lägre AI-användning, men det är tydligt att AI stadigt väver sig in i varje steg av mjukvaruutvecklingen.
📖 Läs mer: Hur man använder AI för kvalitetssäkring
Så här minskar du tiden för felhantering
Snabbhet i felhanteringen handlar om att eliminera friktion vid varje överlämning, från mottagande till release.
De största vinsterna uppnås genom att effektivisera de första 30 minuterna (tydlig inrapportering, rätt ansvarig, rätt prioritet) och sedan förkorta de efterföljande stegen (återupprepa, granska, verifiera).
Här är nio strategier som fungerar tillsammans som ett system. AI påskyndar varje steg, och arbetsflödet samlas överskådligt på ett ställe, så att ledningen får förutsägbarhet och medarbetarna får ett smidigt arbetsflöde.
1. Centralisera mottagningen och samla in sammanhanget direkt vid källan
Felsättningstiden blir längre när du måste rekonstruera sammanhanget utifrån Slack-trådar, supportärenden och kalkylblad. Samla alla rapporter – support, kvalitetssäkring, övervakning – i en enda kö med en strukturerad mall som samlar in uppgifter om komponent, allvarlighetsgrad, miljö, appversion/build, steg för att återskapa felet, förväntat kontra faktiskt samt bilagor (loggar/HAR/skärmdumpar).
AI kan automatiskt sammanfatta långa rapporter, extrahera steg för att återskapa felet och miljöinformation från bilagor samt markera troliga dubbletter, så att triageringen kan inledas med en sammanhängande och utökad dokumentation.
Viktiga nyckeltal: MTTA (bekräftelse inom några minuter, inte timmar), andel dubbletter, tid för ”Behöver information”.
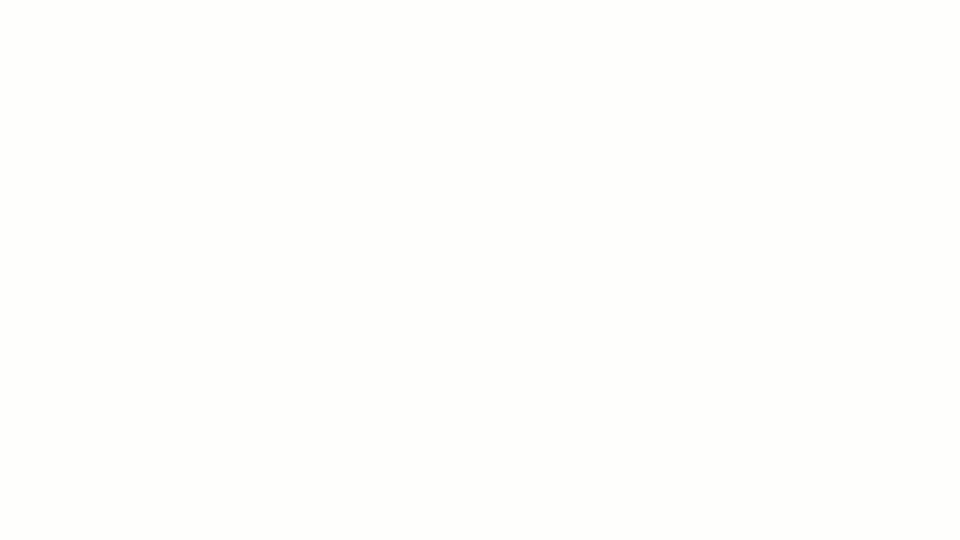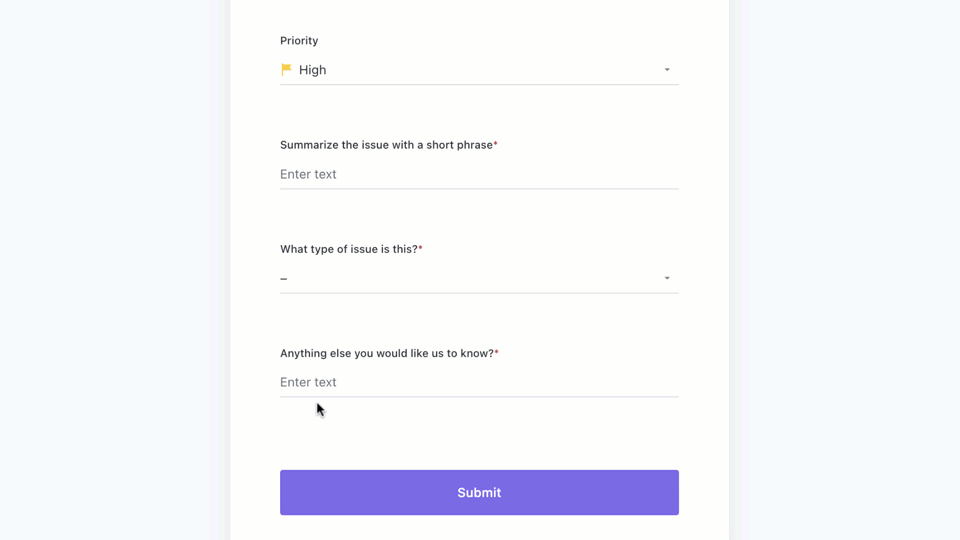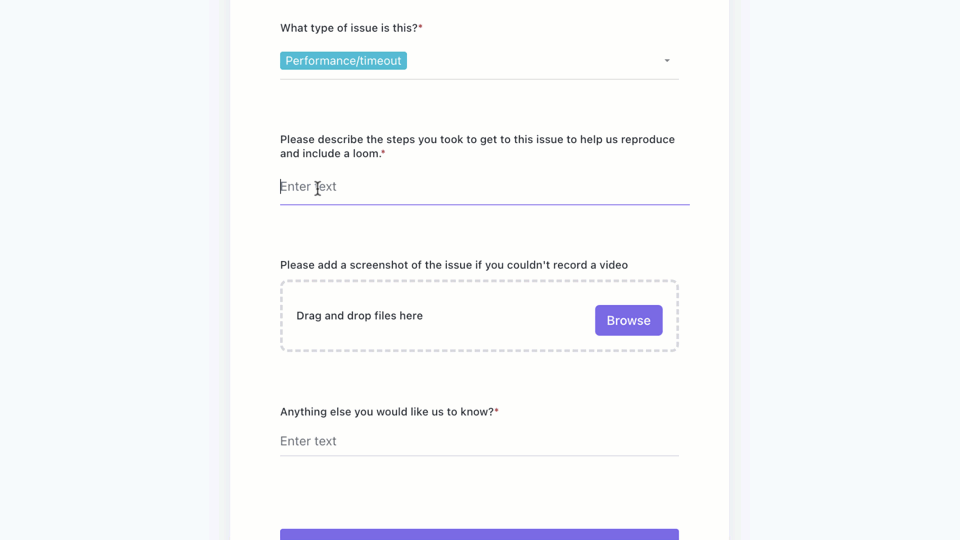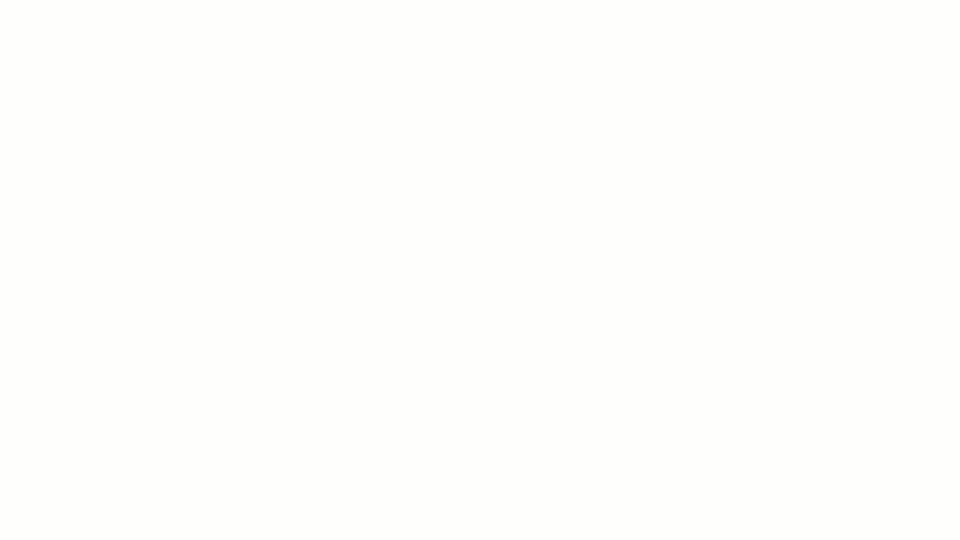
2. AI-stödd prioritering och vidarebefordran för att drastiskt minska MTTA
De snabbaste lösningarna är de som omedelbart hamnar på rätt skrivbord.
Använd enkla regler i kombination med AI för att klassificera allvarlighetsgraden, identifiera troliga ansvariga per komponent/kodområde och automatiskt tilldela ansvar med en SLA-klocka. Ställ in tydliga kategorier för P0/P1 jämfört med allt annat och gör det helt entydigt vem som ansvarar för vad.
Automatiseringar kan fastställa prioritet utifrån fält, vidarebefordra ärenden till ett team utifrån komponent, starta en SLA-timer och meddela en jourhavande tekniker; AI kan föreslå allvarlighetsgrad och ansvarig utifrån tidigare mönster. När triageringen blir en process på 2–5 minuter istället för en 30-minutersdiskussion, sjunker din MTTA och din MTTR följer efter.
Viktiga mätvärden: MTTA, kvaliteten på det första svaret (begärs rätt information i den första kommentaren?), antal överlämningar per fel.
Så här ser det ut i praktiken:
3. Prioritera efter affärspåverkan med tydliga SLA-nivåer
”Den som ropar högst vinner” gör köerna oförutsägbara och urholkar förtroendet hos ledningen, som följer CSAT/NPS och förnyelserna.
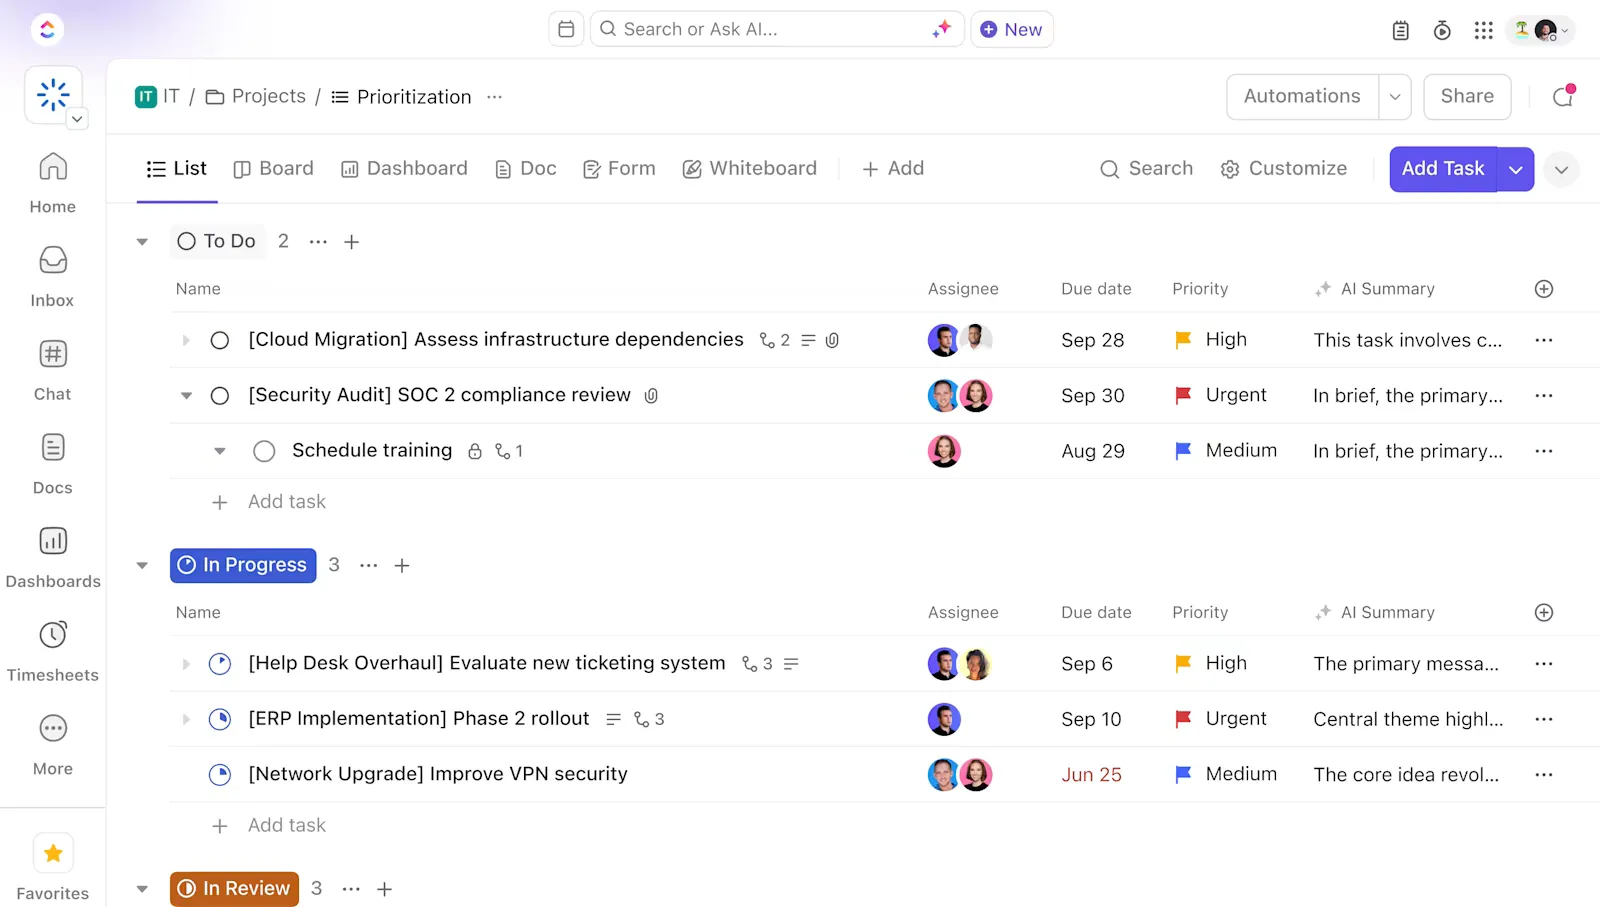
Ersätt det med ett poängsystem som väger samman allvarlighetsgrad, frekvens, påverkad ARR, funktionskritikalitet och närhet till förnyelser/lanseringar – och koppla det till SLA-nivåer (t.ex. P0: avhjälpa inom 1–2 timmar, lösa inom en dag; P1: samma dag; P2: inom en sprint).
Håll en synlig P0/P1-kö med WIP-gränser så att inget hamnar i vänteläge.
Viktiga nyckeltal: P50/P90-lösningsgrad per nivå, andel SLA-överträdelser, korrelation med CSAT/NPS.
💡Proffstips: Med ClickUps fält för uppgiftsprioriteringar, anpassade fält och beroenden kan du beräkna en påverkanpoäng och koppla buggar till konton, feedback eller roadmap-poster. Dessutom hjälper målen i ClickUp dig att koppla efterlevnaden av SLA till mål på företagsnivå, vilket direkt bemöter ledningens oro kring samordning.
4. Gör reproduktion och diagnos till en engångsåtgärd
Varje extra steg med frågan ”kan du skicka loggar?” förlänger hanteringstiden.
Standardisera vad som anses vara ”bra”: obligatoriska fält för build/commit, miljö, återskapningssteg, förväntat kontra faktiskt, samt bilagor för loggar, kraschdumps och HAR-filer. Implementera telemetri mellan klient och server så att krasch-ID:n och förfrågnings-ID:n kan kopplas till spårningar.
Använd Sentry (eller liknande) för stacktraces och koppla problemet direkt till felet. AI kan läsa loggar och spår för att föreslå en trolig feldomän och generera en minimal reproduktion, vilket förvandlar en timmes manuell granskning till några minuters fokuserat arbete.
Spara handböcker för vanliga typer av fel så att teknikerna inte behöver börja från noll.
Nyckeltal att hålla koll på: Tid som läggs på att ”vänta på information”, andel ärenden som kan reproduceras vid första försöket, andel återupptagna ärenden på grund av att reproduktionen misslyckats.
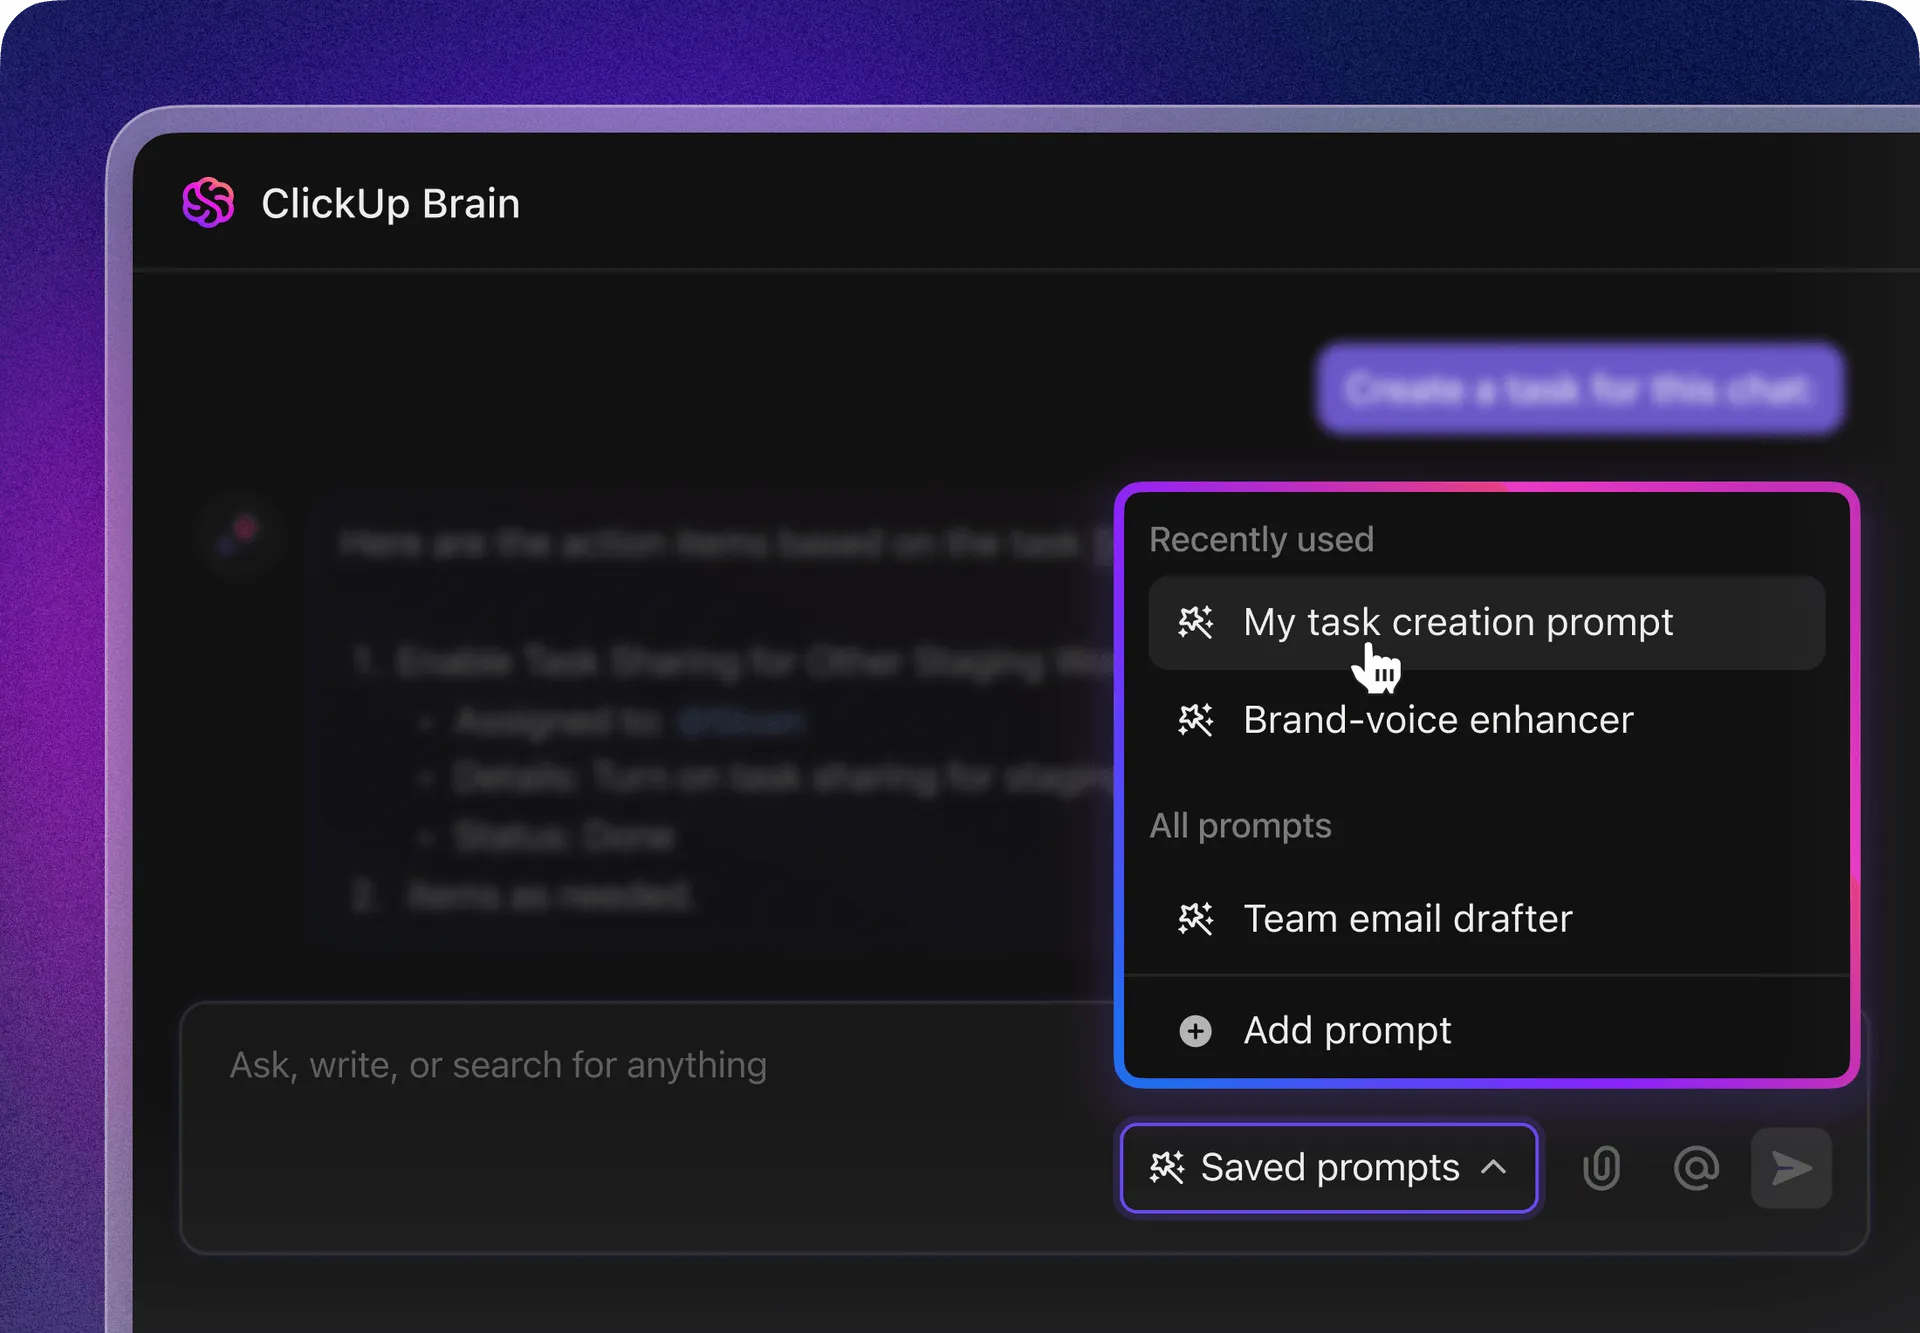
5. Förkorta kodgranskningen och testcykeln
Stora PR:er fastnar. Satsa på precisa korrigeringar, trunk-baserad utveckling och funktionsflaggor så att korrigeringar kan släppas säkert. Tilldela granskare i förväg utifrån kodansvar för att undvika stilleståndstid, och använd checklistor (uppdaterade tester, tillagd telemetri, flagga bakom en kill switch) så att kvaliteten blir inbyggd.
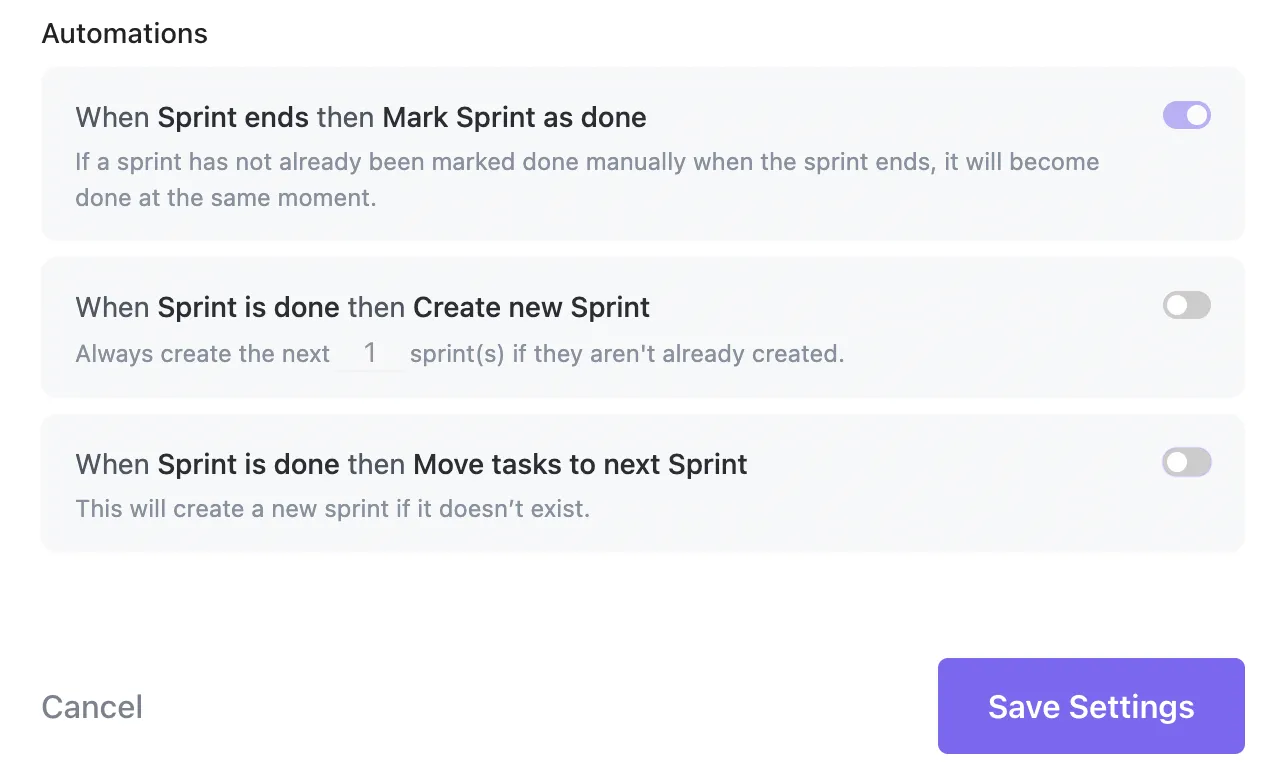
Automatiseringen bör flytta felet till statusen ”Under granskning” när en pull-request öppnas och till ”Löst” vid sammanfogning; AI kan föreslå enhetstester eller markera riskfyllda skillnader för att fokusera granskningen.
Viktiga nyckeltal: Tid i statusen ”Under granskning”, andel misslyckade ändringar för PR:er som avser buggfixar samt P90-granskningsfördröjning.
Du kan använda GitHub-/GitLab-integrationer i ClickUp för att hålla din lösningsstatus synkroniserad; automatiseringar kan säkerställa att ”definitionen av färdig” efterlevs.
6. Parallellisera verifieringen och uppnå verklig paritet i QA-miljön
Verifieringen bör inte påbörjas flera dagar senare eller i en miljö som ingen av dina kunder använder.
Håll ”redo för QA” strikt: flaggstyrda snabbkorrigeringar som valideras i produktionsliknande miljöer med utgångsdata som matchar de rapporterade fallen.
När det är möjligt, skapa tillfälliga miljöer från felgrenen så att QA kan validera omedelbart; AI kan sedan generera testfall utifrån felbeskrivningen och tidigare regressioner.
Viktiga nyckeltal: Tid i ”QA/verifiering”, andel ärenden som skickas tillbaka från QA till utvecklingsavdelningen, medianvärde för tid till avslut efter sammanfogning.
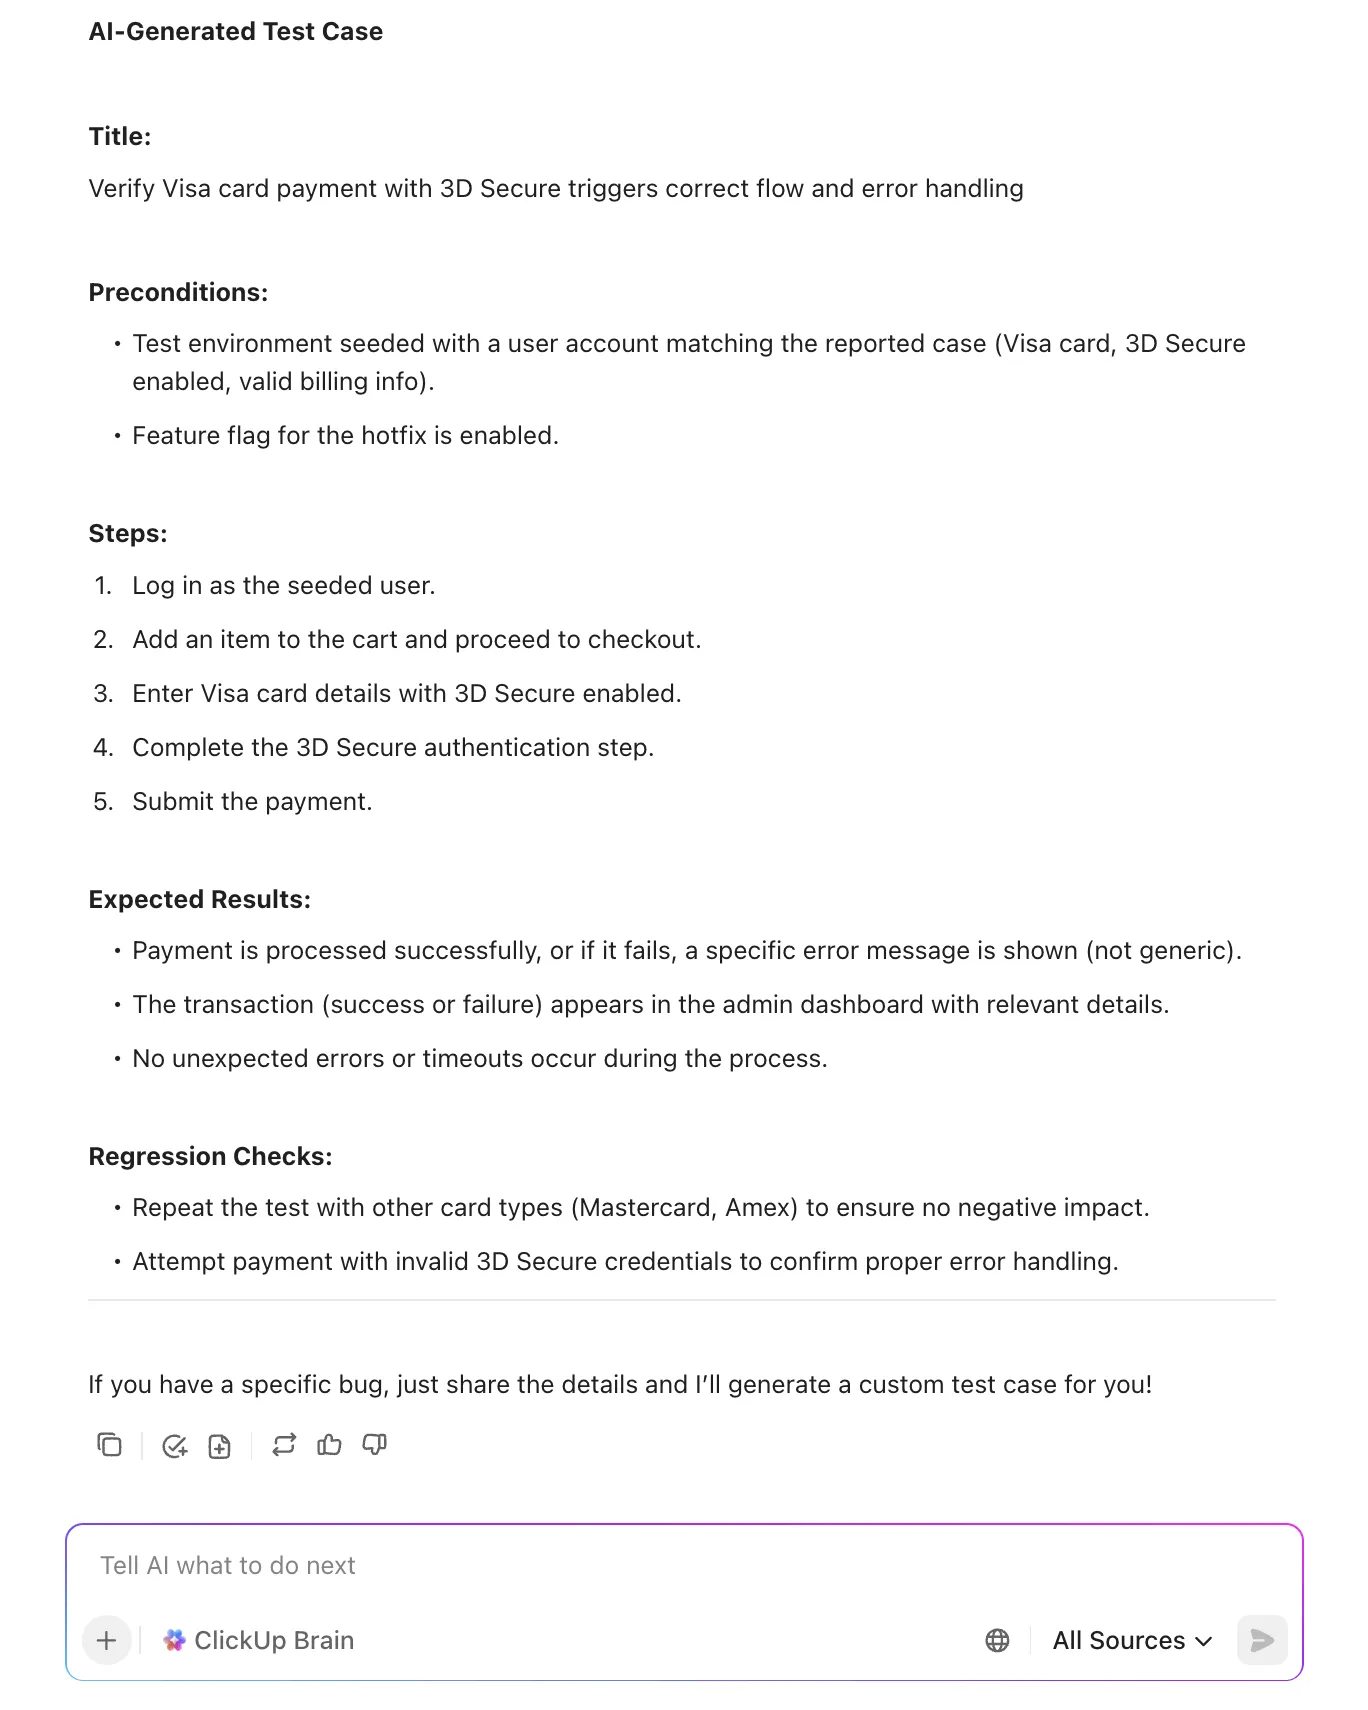
📖 Läs mer: Hur man skriver effektiva testfall
7. Kommunicera statusen tydligt för att minska samordningsbördan
En bra uppdatering förhindrar tre statusförfrågningar och en eskalering.
Behandla uppdateringar som en produkt: korta, specifika och anpassade efter målgruppen (support, ledning, kunder). Fastställ en uppdateringsfrekvens för P0/P1 (t.ex. varje timme tills problemet är åtgärdat, därefter var fjärde timme) och se till att det finns en enda källa till sanning.
AI kan skapa kundsäkra uppdateringar och interna sammanfattningar utifrån uppgiftshistoriken, inklusive realtidsstatus uppdelad efter allvarlighetsgrad och team. För chefer som din produktchef kan du sammanställa fel till initiativ så att de kan se om kritiska kvalitetsproblem hotar leveranslöftena.
Nyckeltal att hålla koll på: Tiden mellan statusuppdateringar för P0/P1, intressenternas kundnöjdhet (CSAT) när det gäller kommunikation.
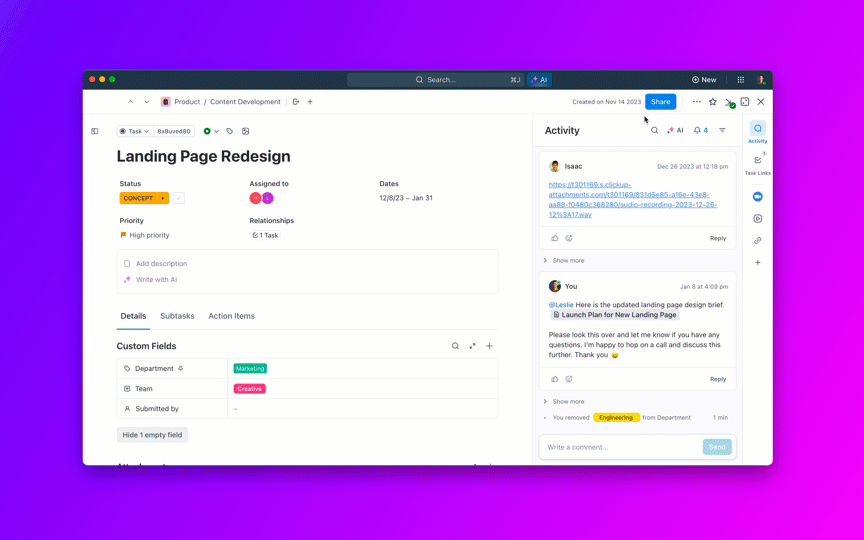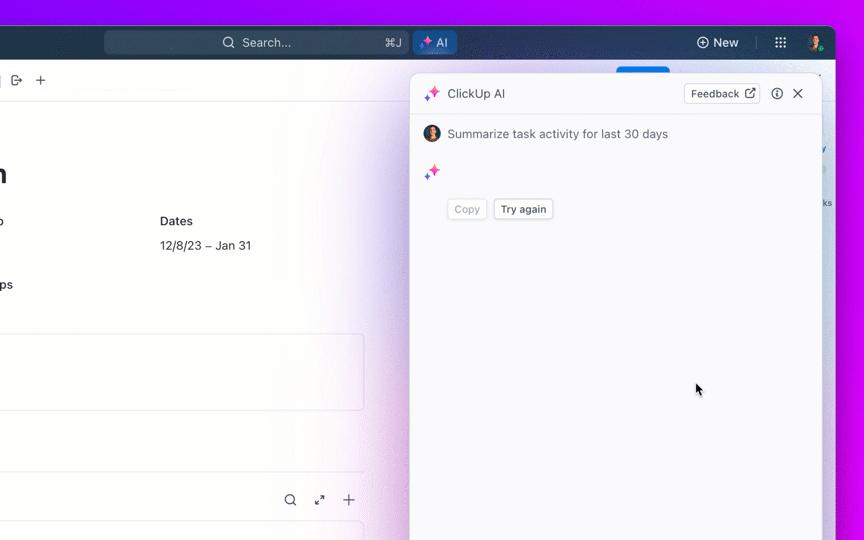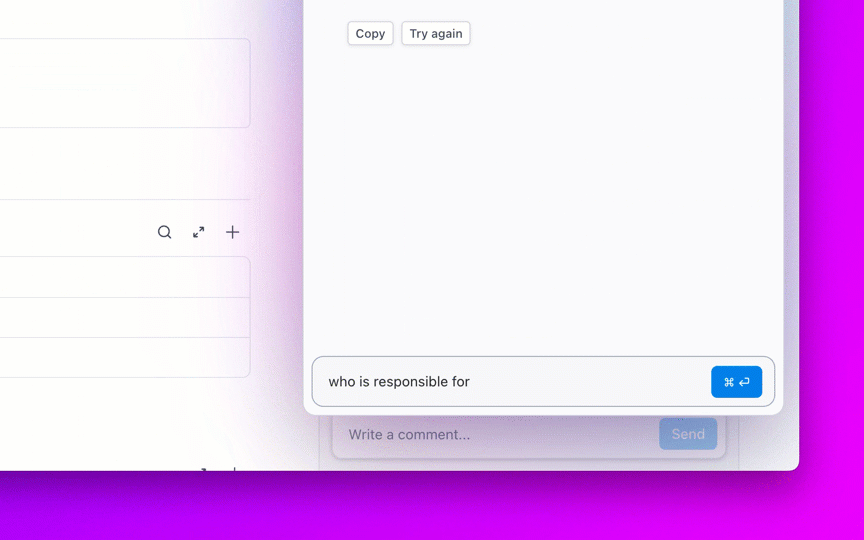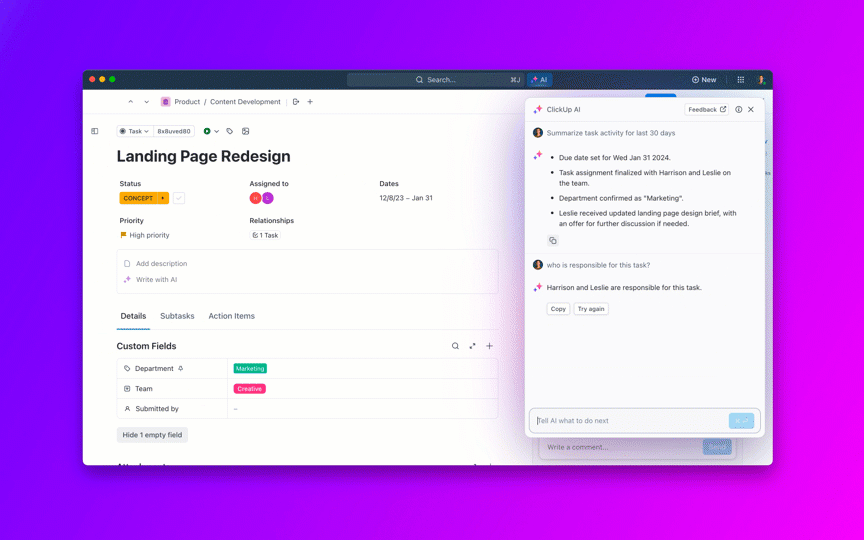
8. Kontrollera hur länge ärenden ligger kvar i backloggen och förhindra att de förblir ”öppna för alltid”
En växande, inaktuell backlog belastar i det tysta varje sprint.
Ställ in åldringsregler (t.ex. P2 > 30 dagar utlöser granskning, P3 > 90 dagar kräver motivering) och schemalägg en veckovis ”åldringssortering” för att slå ihop dubbletter, stänga föråldrade rapporter och omvandla buggar av lågt värde till poster i produktbackloggen.
Använd AI för att gruppera backloggen efter tema (t.ex. ”utgångna autentiseringstoken”, ”instabil bilduppladdning”) så att du kan planera in tematiska åtgärdsveckor och eliminera en hel kategori av fel på en gång.
Nyckeltal att hålla koll på: Antal ärenden i backloggen per åldersgrupp, andel ärenden som stängts som dubbletter/föråldrade, tematisk burn-down-hastighet.
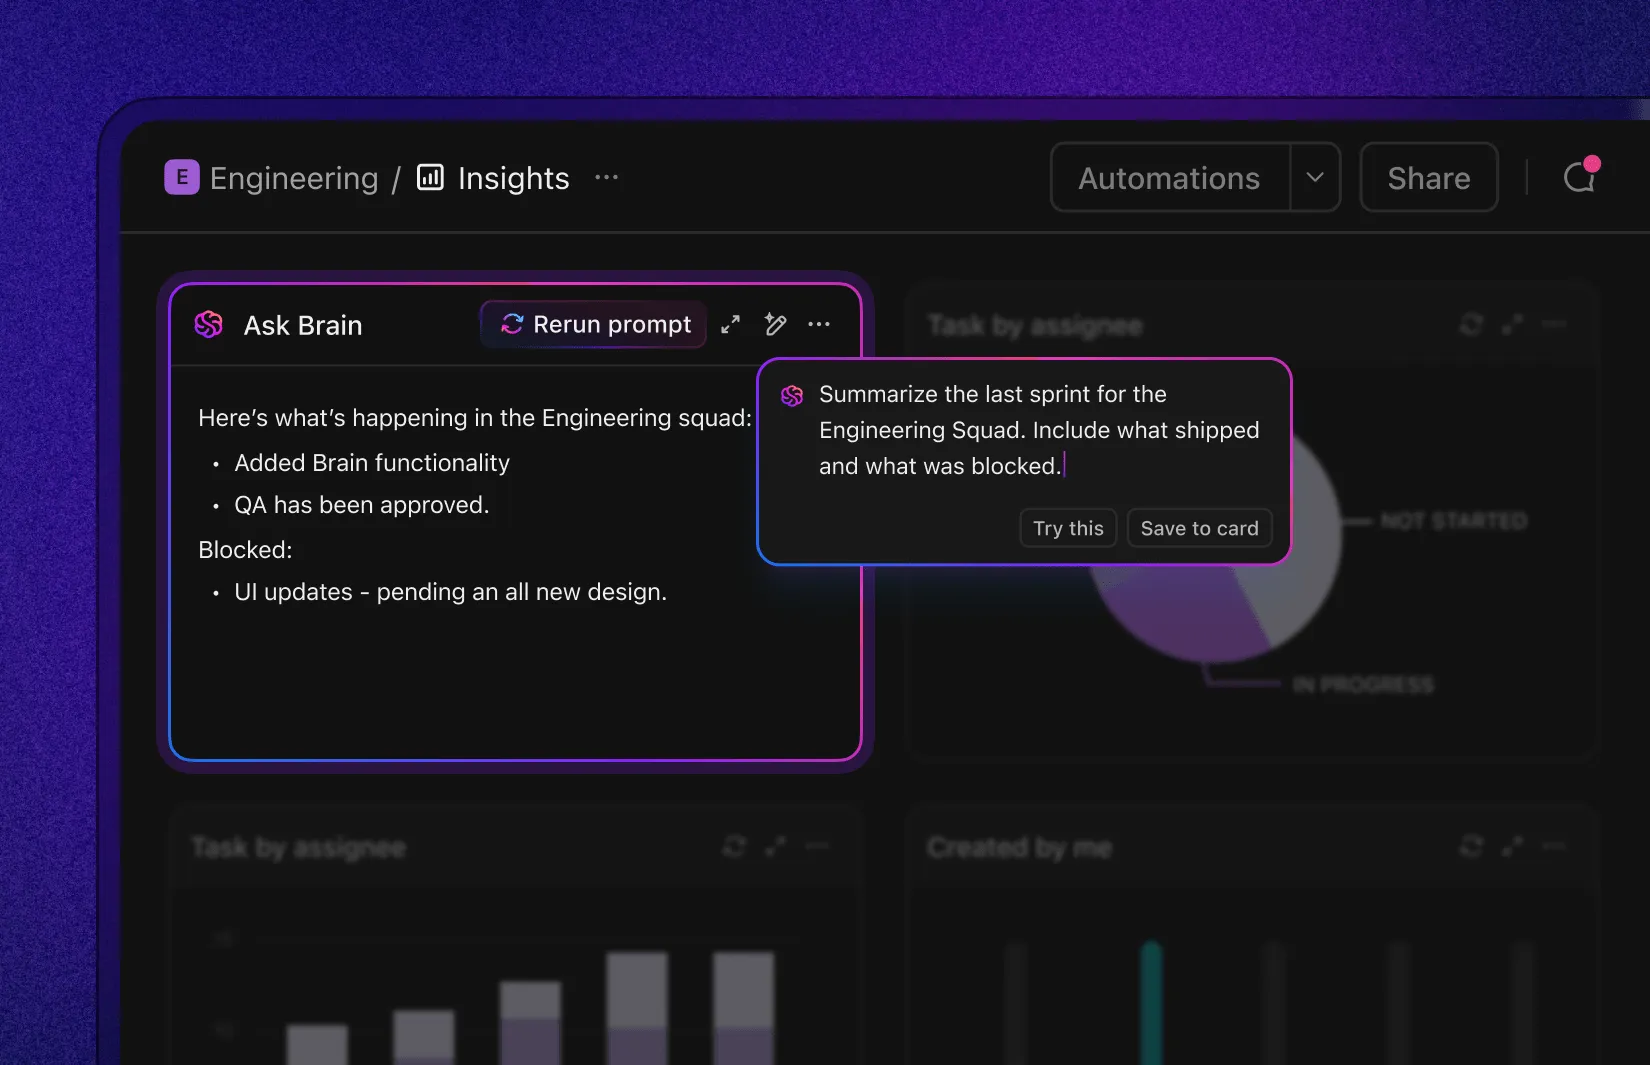
9. Slut cirkeln med grundorsaksanalys och förebyggande åtgärder
Om samma typ av fel återkommer gång på gång döljer dina förbättringar av MTTR ett större problem.
Gör snabba, ansvarsfria grundorsaksanalyser av P0/P1-fel och ofta förekommande P2-fel; märk grundorsakerna (brister i specifikationer, tester eller verktyg samt instabil integration), länka till berörda komponenter och incidenter samt följ uppföljningsuppgifter (skyddsåtgärder, tester, lint-regler) tills de är slutförda.
AI kan utarbeta sammanfattningar av orsaksanalyser (RCA) och föreslå förebyggande tester eller lint-regler baserat på ändringshistoriken. Och det är så du går från att släcka bränder till att få färre bränder.
Viktiga nyckeltal: Andel återöppnade ärenden, andel återfall, tid mellan återfall och andel RCA:er där förebyggande åtgärder har genomförts.
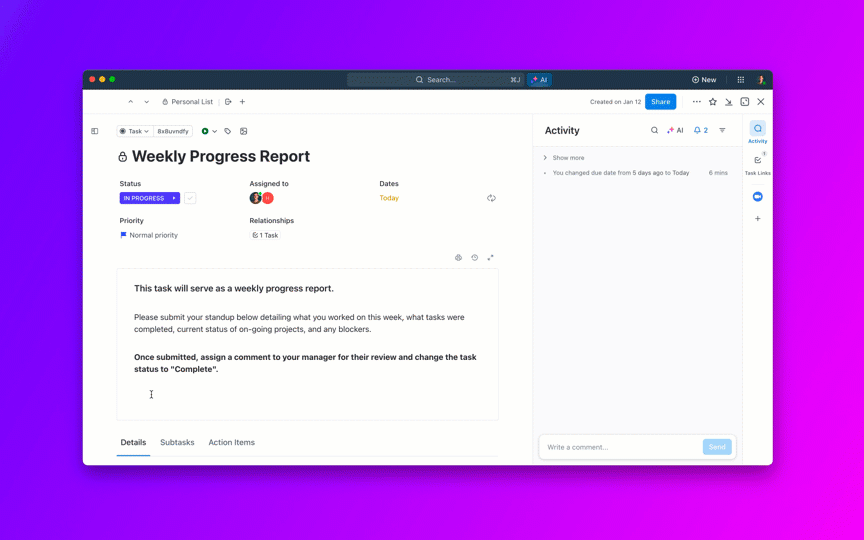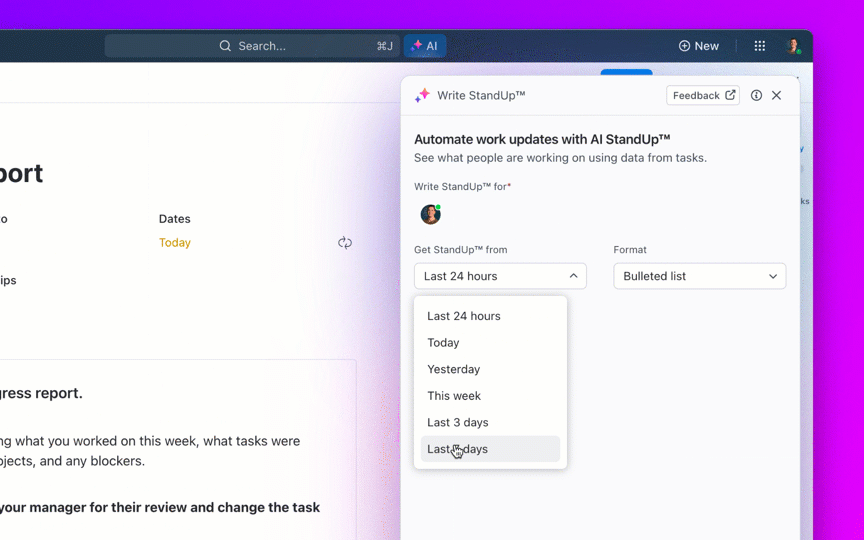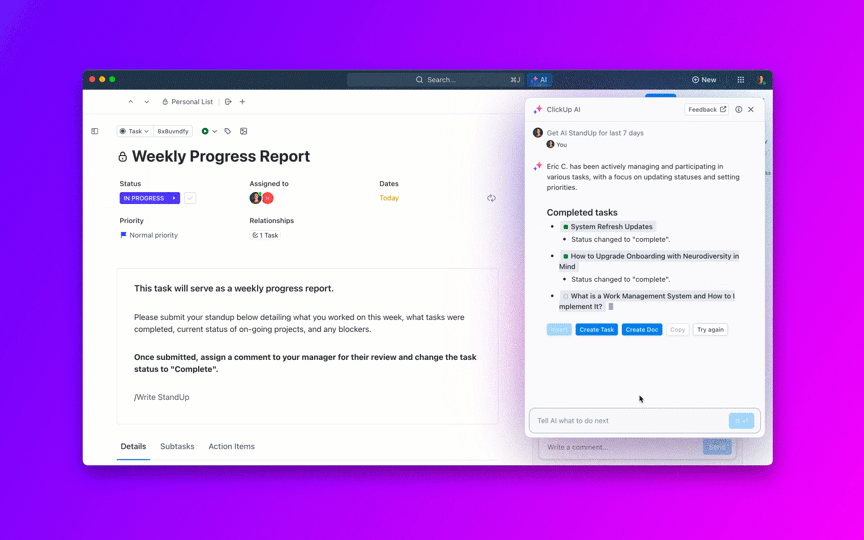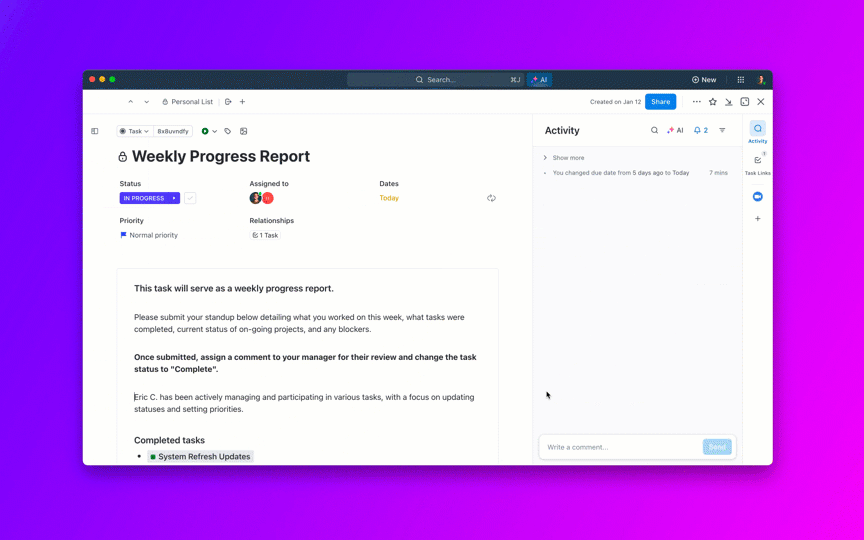
Sammantaget förkortar dessa förändringar hela processen: snabbare bekräftelse, tydligare triagering, smartare prioritering, färre fördröjningar i granskning och kvalitetssäkring samt tydligare kommunikation. Ledningen får förutsägbarhet kopplad till CSAT/NPS och intäkter; medarbetarna får en lugnare kö med färre kontextbyten.
📖 Läs mer: Hur man utför en grundorsaksanalys
AI-verktyg som hjälper till att minska tiden för felhantering
AI kan förkorta åtgärdstiden i varje steg – mottagning, prioritering, vidarebefordran, åtgärd och verifiering.
De verkliga vinsterna uppnås dock när verktygen förstår sammanhanget och håller arbetet igång utan att man behöver styra varje steg.
Leta efter system som automatiskt berikar rapporterna (steg för att återskapa felet, miljö, dubbletter), prioriterar efter påverkan, vidarebefordrar till rätt ansvarig, skapar tydliga uppdateringar och integreras tätt med din kod, CI och observabilitet.
De bästa verktygen stöder dessutom agentliknande arbetsflöden: botar som övervakar SLA:er, påminner granskare, eskalerar fastnade ärenden och sammanfattar resultaten för intressenterna. Här är vår sammanställning av AI-verktyg för bättre felhantering:
1. ClickUp (Bäst för kontextuell AI, automatiseringar och agentbaserade arbetsflöden)
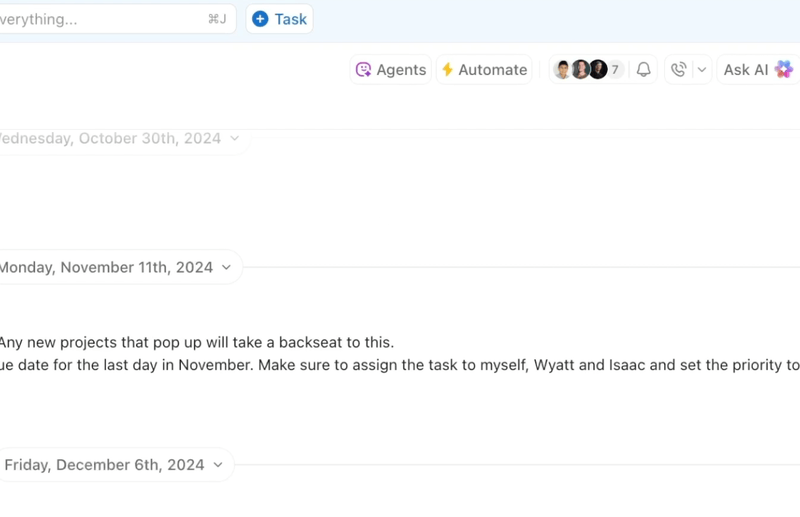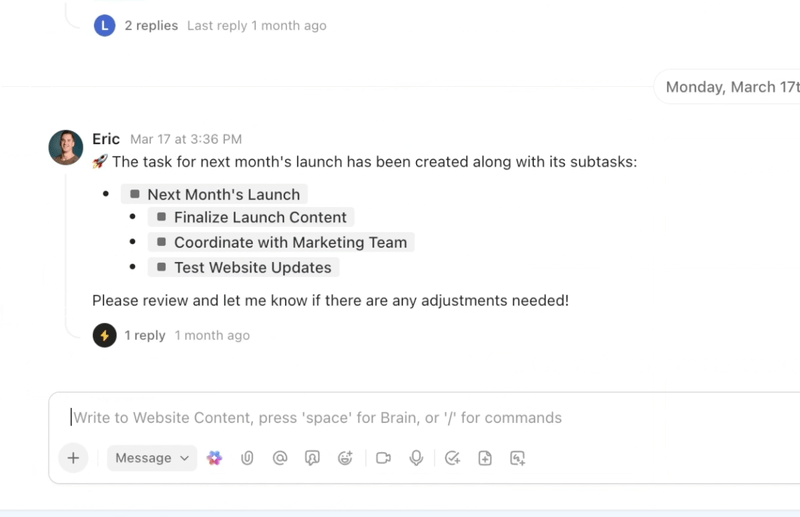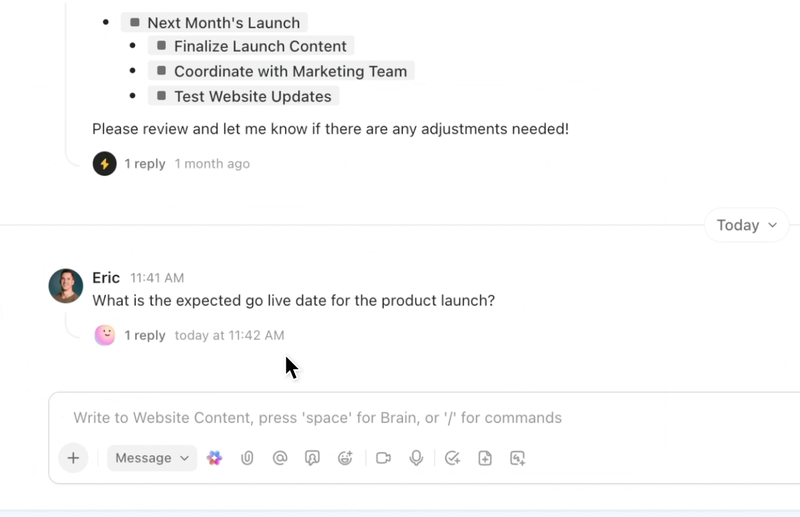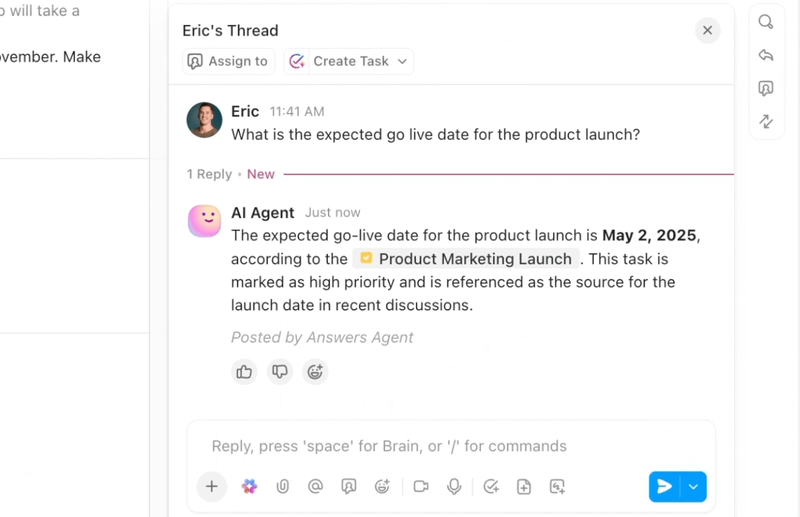
Om du vill ha ett smidigt och intelligent arbetsflöde för felhantering erbjuder ClickUp, den universella arbetsappen, AI, automatiseringar och agentbaserad arbetsflödesstöd på ett och samma ställe.
ClickUp Brain visar rätt sammanhang direkt – sammanfattar långa felrapporter, extraherar steg för att återskapa felet och miljöinformation från bilagor, markerar troliga dubbletter och föreslår nästa åtgärder. Istället för att behöva bläddra igenom Slack, ärenden och loggar får teamen en överskådlig och utökad dokumentation som de kan agera på omedelbart.
Automatiseringar och Autopilot-agenter i ClickUp håller arbetet igång utan att du behöver vara med hela tiden. Fel dirigeras automatiskt till rätt team, ansvariga tilldelas, SLA:er och förfallodatum fastställs, status uppdateras allteftersom arbetet fortskrider och berörda parter får meddelanden i rätt tid.
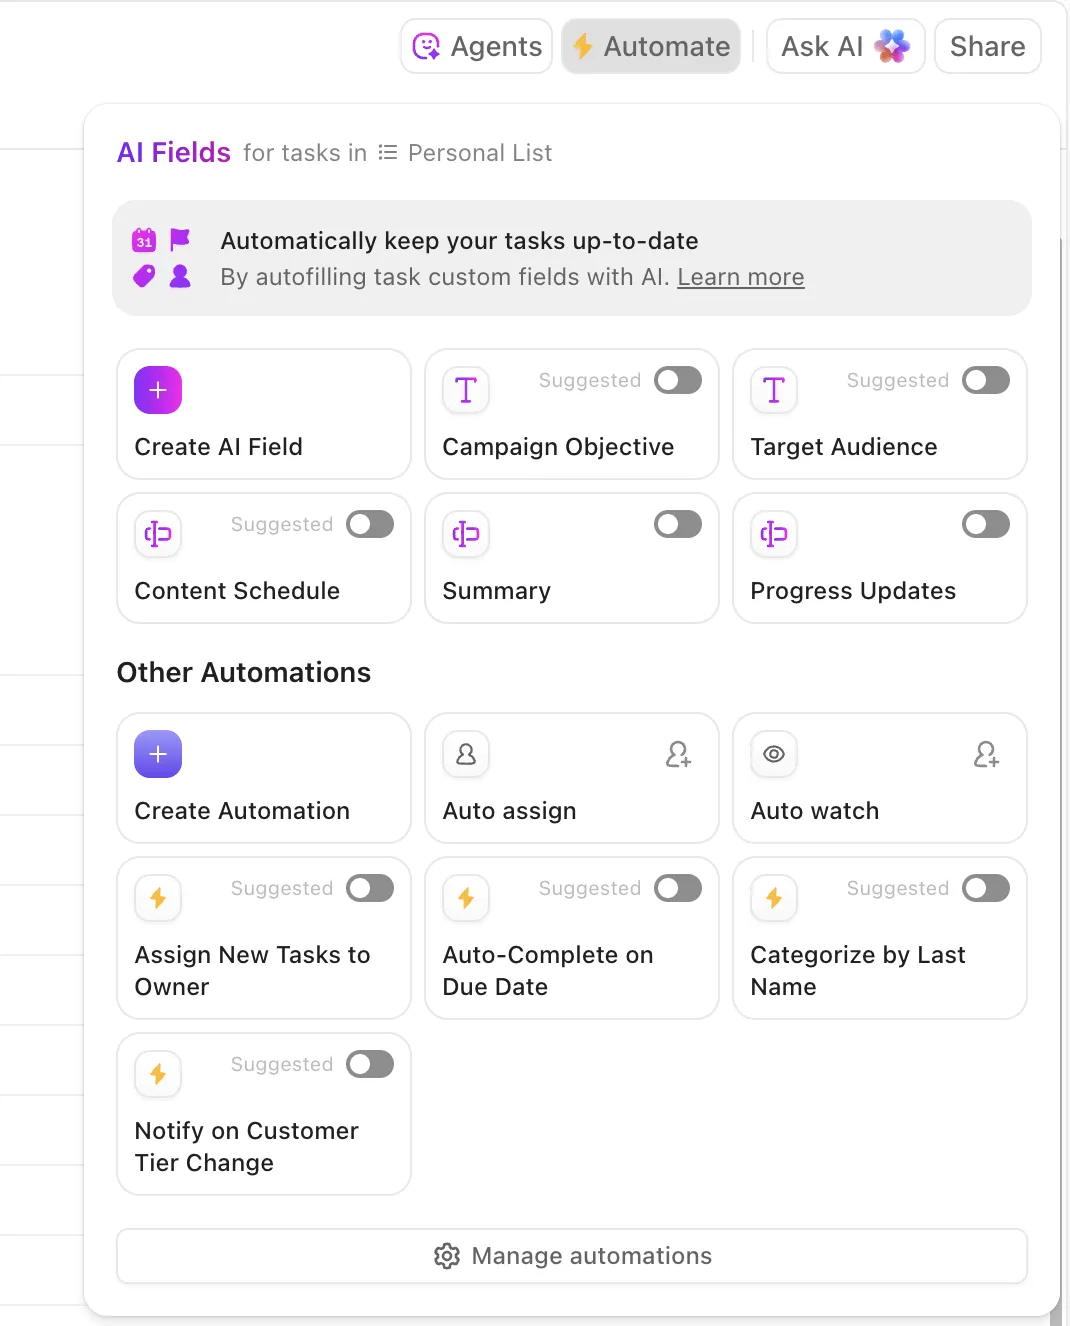
Dessa agenter kan till och med prioritera och kategorisera ärenden, gruppera liknande rapporter, hänvisa till tidigare lösningar för att föreslå troliga vägar framåt och eskalera brådskande ärenden – så att MTTA och MTTR sjunker även när volymen ökar kraftigt.
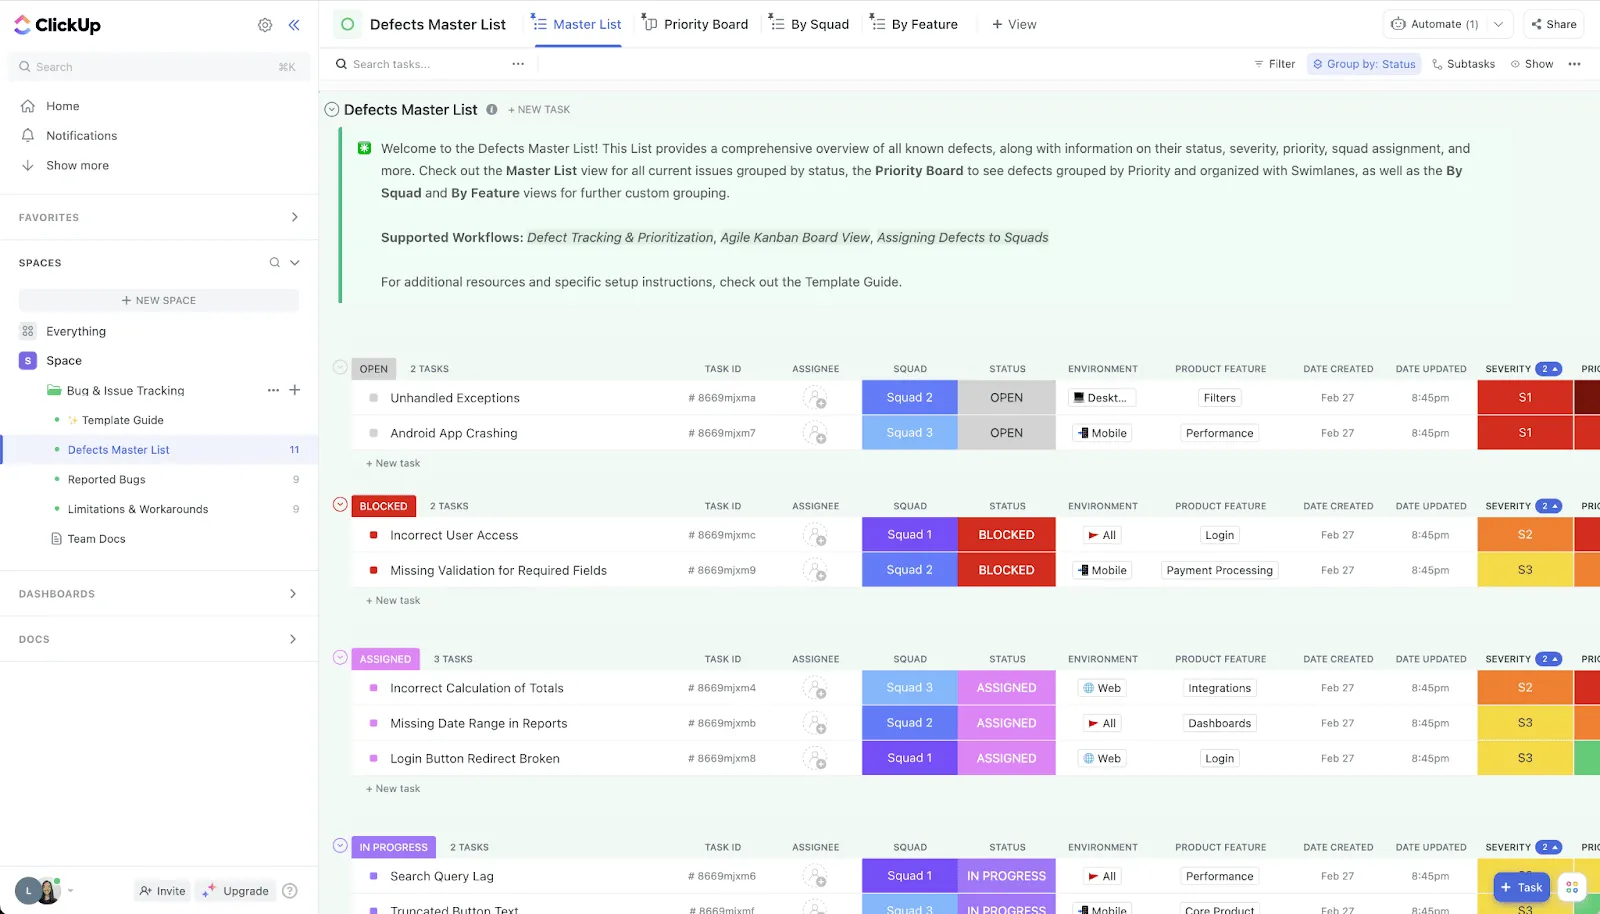
🛠️ Vill du ha ett färdigt verktygskit? Mallen för fel- och problemhantering från ClickUp är en kraftfull lösning från ClickUp for Software, utformad för att hjälpa support-, utvecklings- och produktteam att enkelt hålla koll på programvarufel och problem. Med anpassningsbara vyer som Lista, Tavla, Arbetsbelastning, Formulär och Tidslinje kan teamen visualisera och hantera sin felspårningsprocess på det sätt som passar dem bäst.
Mallens 20 anpassade statusar och 7 anpassade fält möjliggör ett skräddarsytt arbetsflöde, vilket säkerställer att varje ärende spåras från upptäckt till lösning. Inbyggda automatiseringar sköter repetitiva uppgifter, vilket frigör värdefull tid och minskar manuellt arbete.
💟 Bonus: Brain MAX är din AI-drivna hjälpreda på skrivbordet, utformad för att påskynda felhanteringen med smarta och praktiska funktioner.
När du stöter på ett fel använder du helt enkelt Brain MAX:s tal-till-text-funktion för att diktera problemet – dina muntliga anteckningar transkriberas omedelbart och kan bifogas till ett nytt eller befintligt felärende. Funktionen Enterprise Search söker igenom alla dina anslutna verktyg – som ClickUp, GitHub, Google Drive och Slack – för att hitta relaterade felrapporter, felloggar, kodsnuttar och dokumentation, så att du har all kontext du behöver utan att behöva byta mellan appar.
Behöver du samordna en åtgärd? Med Brain MAX kan du tilldela felet till rätt utvecklare, ställa in automatiska påminnelser om statusuppdateringar och följa upp framstegen – allt från din dator!
2. Sentry (Bäst för att registrera fel)
Sentry minskar MTTD och reproduktionstiden genom att samla in fel, spår och användarsessioner på ett och samma ställe. AI-driven gruppering av problem minskar bruset; ”Suspect Commit” och ägarskapsregler identifierar den troliga kodägaren, vilket gör att vidarebefordran sker omedelbart. Session Replay ger ingenjörerna den exakta användarvägen och konsol-/nätverksdetaljer för att återskapa felet utan ändlösa turer fram och tillbaka.
Sentry AI:s funktioner kan sammanfatta problemets sammanhang och, i vissa stackar, föreslå Autofix-korrigeringar som hänvisar till den felaktiga koden. Den praktiska effekten: färre dubbla ärenden, snabbare tilldelning och en kortare väg från rapport till fungerande korrigering.
3. GitHub Copilot (Bäst för snabbare granskning av kod)
Copilot påskyndar felsökningsprocessen direkt i redigeraren. Det förklarar stacktraces, föreslår riktade korrigeringar, skriver enhetstester för att säkerställa att felet är åtgärdat och skapar skript för att återskapa felet.
Copilot Chat kan gå igenom felaktig kod, föreslå säkrare omstruktureringar och generera kommentarer eller PR-beskrivningar som gör kodgranskningen snabbare. I kombination med obligatoriska granskningar och CI sparar det timmar i processen ”diagnostisera → implementera → testa”, särskilt för väl avgränsade fel som går att återskapa tydligt.
4. Snyk by DeepCode AI (Bäst för att upptäcka mönster)
DeepCodes AI-drivna statiska analys upptäcker fel och osäkra mönster medan du kodar och i PR:er. Den markerar problematiska flöden, förklarar varför de uppstår och föreslår säkra korrigeringar som passar din kodbas.
Genom att upptäcka regressioner före sammanfogning och vägleda utvecklare mot säkrare mönster minskar du frekvensen av nya buggar och påskyndar åtgärdandet av knepiga logikfel som är svåra att upptäcka vid granskning. IDE- och PR-integrationer ser till att detta sker nära där arbetet utförs.
5. Datadogs Watchdog och AIOps (bäst för logganalys)
Datadogs Watchdog använder maskininlärning för att upptäcka avvikelser i loggar, mätvärden, spårningar och övervakning av verkliga användare. Det korrelerar toppar med driftsättningsmarkörer, infrastrukturförändringar och topologi för att föreslå troliga grundorsaker.
För fel som påverkar kunderna innebär det att det tar bara några minuter att upptäcka dem, automatisk gruppering för att minska antalet falska larm och konkreta ledtrådar om var man ska leta. Triage-tiden minskar eftersom du utgår från ”den här driftsättningen påverkade dessa tjänster och felfrekvensen ökade på den här slutpunkten” istället för att börja från noll.
6. New Relic AI (Bäst för att identifiera och sammanfatta trender)
New Relics Errors Inbox grupperar liknande fel över olika tjänster och versioner, medan dess AI-assistent sammanfattar konsekvenserna, lyfter fram troliga orsaker och länkar till de berörda spåren/transaktionerna.
Korrelationer mellan distributioner och information om ändringar i enheter gör det tydligt när en ny release är orsaken till felet. För distribuerade system sparar den kontexten timmar av kommunikation mellan teamen och ser till att felet hamnar hos rätt ansvarig med en redan utarbetad, välgrundad hypotes.
7. Rollbar (Bäst för automatiserade arbetsflöden)
Rollbar är specialiserat på felövervakning i realtid med intelligent fingeravtrycksanalys för att gruppera dubbletter och spåra trender i förekomsten. Dess AI-drivna sammanfattningar och tips om grundorsaker hjälper teamen att förstå omfattningen (berörda användare, påverkade versioner), medan telemetri och stacktraces ger snabba ledtrådar för att återskapa felet.
Rollbars arbetsflödesregler kan automatiskt skapa uppgifter, märka allvarlighetsgraden och vidarebefordra till ansvariga, vilket omvandlar oöverskådliga felströmmar till prioriterade köer med tillhörande sammanhang.
8. PagerDuty AIOps och automatisering av runbooks (Det bästa inom diagnostik med minimal mänsklig inblandning)
PagerDuty använder händelsekorrelation och ML-baserad brusreducering för att omvandla larmstormar till hanterbara incidenter.
Dynamisk vidarebefordran skickar ärendet direkt till rätt jourhavande, medan automatisering via runbooks kan sätta igång diagnostik eller avhjälpande åtgärder (starta om tjänster, återställa en distribution, växla en funktionsflagga) innan en människa behöver ingripa. När det gäller felfelsökningstiden innebär det en kortare MTTA, snabbare avhjälpande åtgärder för P0-fel och färre timmar som går förlorade på grund av larmtrötthet.
Den röda tråden är automatisering i kombination med AI i varje steg. Du upptäcker fel tidigare, dirigerar dem smartare, kommer snabbare fram till koden och kommunicerar status utan att bromsa utvecklarna – allt detta bidrar till en betydande minskning av tiden det tar att lösa buggar.
📖 Läs mer: Hur man använder AI i DevOps
Praktiska exempel på hur AI används för felhantering
Så nu har AI officiellt lämnat laboratoriet. Det minskar tiden för felhantering i praktiken.
Låt oss se hur!
| Domän / Organisation | Hur AI användes | Effekt/fördel |
|---|---|---|
| Ubisoft | Utvecklade Commit Assistant, ett AI-verktyg som tränats på ett decennium av intern kod och som förutsäger och förebygger buggar redan i kodningsfasen. | Syftet är att drastiskt minska både tid och kostnader – upp till 70 % av kostnaderna för spelutveckling går traditionellt till felkorrigeringar. |
| Razer (Wyvrn Platform) | Lanserade den AI-drivna QA Copilot (integrerad med Unreal och Unity) för att automatisera felupptäckt och generera QA-rapporter. | Ökar feldetekteringen med upp till 25 % och halverar tiden för kvalitetssäkring. |
| Google / DeepMind & Project Zero | Lanserade Big Sleep, ett AI-verktyg som självständigt upptäcker säkerhetsbrister i öppen källkodsprogramvara som FFmpeg och ImageMagick. | 20 fel har identifierats, alla verifierade av mänskliga experter och planerade att åtgärdas. |
| Forskare vid UC Berkeley | Med hjälp av ett jämförelsetest vid namn CyberGym analyserade AI-modeller 188 open source-projekt, upptäckte 17 sårbarheter – däribland 15 okända ”zero-day”-fel – och genererade proof-of-concept-exploater. | Visar AI:s växande förmåga när det gäller att upptäcka sårbarheter och automatiskt skydda mot utnyttjande av dessa. |
| Spur (startup från Yale) | Utvecklade en AI-agent som översätter testfallsbeskrivningar i klartext till automatiserade testrutiner för webbplatser – i praktiken ett självskrivande QA-arbetsflöde. | Möjliggör autonom testning med minimal mänsklig inblandning |
| Automatisk reproduktion av felrapporter för Android | Använde NLP och förstärkningsinlärning för att tolka språket i felrapporter och generera steg för att återskapa Android-fel. | Uppnådde 67 % precision, 77 % återhämtning och reproducerade 74 % av felrapporterna, vilket överträffade traditionella metoder. |
Vanliga misstag vid mätning av felhanteringstiden
Om dina mätningar är felaktiga kommer även din förbättringsplan att bli det.
De flesta ”dåliga siffrorna” i arbetsflödena för felhantering beror på vaga definitioner, inkonsekventa arbetsflöden och ytlig analys.
Börja alltså med grunderna först – vad som räknas som start/stopp, hur du hanterar väntetider och återupptagna ärenden – och läs sedan av data utifrån hur dina kunder upplever det. Det innefattar:
❌ Otydliga gränser: Att blanda ”Rapporterade→Lösta” och ”Rapporterade→Stängda” i samma dashboard (eller växla mellan dem från månad till månad) gör trenderna meningslösa. Välj en gräns, dokumentera den och se till att den följs av alla team. Om du behöver båda, publicera dem som separata mätvärden med tydliga etiketter.
❌ Metoden som endast bygger på medelvärden: Att förlita sig på medelvärdet döljer verkligheten i köer med några få utstickande värden som tar lång tid att hantera. Använd medianen (P50) för din ”typiska” tid, P90 för förutsägbarhet/SLA:er och behåll medelvärdet för kapacitetsplanering. Titta alltid på fördelningen, inte bara på ett enda tal.
❌ Ingen segmentering: Att slå ihop alla fel gör att P0-incidenter blandas ihop med kosmetiska P3-fel. Segmentera efter allvarlighetsgrad, källa (kund vs. QA vs. övervakning), komponent/team och ”nytt vs. regression”. Ditt P0/P1 P90 är vad intressenterna upplever; din P2+-median är vad utvecklingsavdelningen planerar utifrån.
❌ Att bortse från ”pausad” tid: Väntar du på kundloggar, en extern leverantör eller ett releasefönster? Om du inte spårar ”Blockerad/Pausad” som en fullvärdig status blir din åtgärdstid en källa till diskussion. Rapportera både kalendertid och aktiv tid så att flaskhalsar synliggörs och diskussionerna upphör.
❌ Brister i tidsnormalisering: Att blanda tidszoner eller växla mellan arbetstid och kalendertid mitt i processen förvränger jämförelserna. Normalisera tidsstämplarna till en tidszon (eller UTC) och bestäm en gång för alla om SLA:er ska mätas i arbetstid eller kalendertid; tillämpa detta konsekvent.
❌ Ofullständiga ärenden och dubbletter: Saknad information om miljö/build och dubbletter av ärenden förlänger hanteringstiden och skapar oklarheter kring ansvaret. Standardisera obligatoriska fält vid registrering, fyll i information automatiskt (loggar, version, enhet) och ta bort dubbletter utan att nollställa hanteringstiden – stäng dubbletter som länkade ärenden, inte som ”nya” ärenden.
❌ Inkonsekventa statusmodeller: Skräddarsydda statusar (”QA Ready-ish”, ”Pending Review 2”) döljer tiden i respektive status och gör statusövergångarna opålitliga. Definiera ett standardiserat arbetsflöde (Nytt → Sorterat → Pågår → Under granskning → Löst → Avslutat) och granska för avvikande statusar.
❌ Att bortse från tiden i olika status: Ett enda tal för ”total tid” kan inte visa var arbetet fastnar. Registrera och granska tiden som spenderas i statusarna Triagerad, Under granskning, Blockerad och QA. Om P90 för kodgranskning är betydligt längre än implementeringstiden handlar din lösning inte om att ”koda snabbare” – utan om att frigöra granskningskapacitet.
🧠 Rolig fakta: DARPA:s senaste AI Cyber Challenge visade upp ett banbrytande framsteg inom automatisering av cybersäkerhet. Tävlingen presenterade AI-system utformade för att självständigt upptäcka, utnyttja och åtgärda sårbarheter i programvara – utan mänsklig inblandning. Det vinnande laget, ”Team Atlanta”, upptäckte imponerande nog 77 % av de insprutade buggarna och lyckades åtgärda 61 % av dem, vilket visade på AI:s förmåga att inte bara hitta brister utan också aktivt åtgärda dem.
❌ Blindhet kring återöppnade ärenden: Att behandla återöppnade ärenden som nya fel nollställer klockan och förskönar MTTR. Spåra återöppningsfrekvensen och ”tiden till stabil avslutning” (från första rapporten till slutlig avslutning över alla cykler). En ökning av återöppnade ärenden pekar vanligtvis på svag reproducerbarhet, luckor i testningen eller en vag definition av vad som räknas som klart.
❌ Ingen MTTA: Team fokuserar alltför mycket på MTTR och bortser från MTTA (tid för bekräftelse/ansvarstagande). En hög MTTA är en tidig varningssignal för lång lösningstid. Mät den, fastställ SLA:er efter allvarlighetsgrad och automatisera vidarebefordran/eskalering för att hålla den nere.
❌ AI/automatisering utan säkerhetsåtgärder: Att låta AI fastställa allvarlighetsgraden eller stänga dubbletter utan granskning kan leda till felklassificering av gränsfall och i det tysta snedvrida mätvärdena. Använd AI för förslag, kräv mänsklig bekräftelse för P0/P1 och granska modellens prestanda varje månad så att dina data förblir tillförlitliga.
Stram upp dessa delar, så kommer dina diagram över lösningstider äntligen att spegla verkligheten. Därifrån kommer förbättringarna att förstärka varandra: bättre ärendehantering minskar MTTA, tydligare statusar avslöjar verkliga flaskhalsar och segmenterade P90-värden ger ledningen löften som du kan hålla.
⚡️ Mallarkiv: 10 mallar för testfall för programvarutestning
Bästa praxis för bättre felhantering
Sammanfattningsvis är här de viktigaste punkterna att tänka på!
| 🧩 Bästa praxis | 💡 Vad det innebär | 🚀 Varför det är viktigt |
| Använd ett robust felhanteringssystem | Spåra alla rapporterade buggar med hjälp av ett centraliserat buggspårningssystem. | Säkerställer att inga fel går förlorade och ger insyn i felstatusen för alla team. |
| Skriv detaljerade felrapporter | Inkludera visuellt sammanhang, information om operativsystemet, steg för att återskapa felet samt allvarlighetsgrad. | Hjälper utvecklare att åtgärda buggar snabbare genom att all viktig information finns tillgänglig redan från början. |
| Kategorisera och prioritera fel | Använd en prioriteringsmatris för att sortera fel efter brådskandehet och påverkan. | Fokuserar teamet på kritiska buggar och brådskande problem först. |
| Utnyttja automatiserad testning | Kör tester automatiskt i din CI/CD-pipeline. | Underlättar tidig upptäckt och förhindrar regressioner. |
| Fastställ tydliga riktlinjer för rapportering | Tillhandahåll mallar och utbildning i hur man rapporterar fel. | Detta leder till korrekt information och smidigare kommunikation. |
| Spåra nyckeltal | Mät hanteringstid, förfluten tid och svarstid. | Möjliggör prestandauppföljning och förbättring med hjälp av historiska data. |
| Använd en proaktiv strategi | Vänta inte på att användarna ska klaga – testa proaktivt. | Ökar kundnöjdheten och minskar supportbelastningen. |
| Utnyttja smarta verktyg och maskininlärning | Använd maskininlärning för att förutsäga fel och föreslå lösningar. | Förbättrar effektiviteten när det gäller att identifiera grundorsaker och åtgärda buggar. |
| Anpassa efter SLA:er | Uppfyll överenskomna servicenivåavtal för felhantering. | Skapar förtroende och uppfyller kundernas förväntningar i rätt tid. |
| Granska och förbättra kontinuerligt | Analysera återupptagna fel, samla in feedback och finjustera processerna. | Främjar kontinuerlig förbättring av din utvecklingsprocess och felhantering. |
Enkel felsökning med kontextuell AI
De team som löser fel snabbast förlitar sig inte på enskilda hjältar. De utformar ett system: tydliga definitioner av när något ska påbörjas och avslutas, en strukturerad inrapportering, prioritering utifrån affärspåverkan, tydligt ansvar och snäva återkopplingsloopar mellan support, kvalitetssäkring, utveckling och release.
ClickUp kan fungera som den AI-drivna kommandocentralen för ditt felhanteringssystem. Samla alla rapporter i en enda kö, standardisera sammanhanget med strukturerade fält och låt ClickUp AI sortera, sammanfatta och prioritera, samtidigt som automatiseringar säkerställer att SLA:er efterlevs, eskalerar när tidsfrister överskrids och håller alla berörda parter på samma sida. Koppla fel till kunder, kod och releaser så att ledningen ser effekterna och medarbetarna kan fortsätta arbeta smidigt.
Om du är redo att minska tiden för felhantering och göra din roadmap mer förutsägbar, registrera dig på ClickUp och börja mäta förbättringen inom några dagar – inte kvartal.
Vanliga frågor
Vad är en bra tid för felhantering?
Det finns inget enskilt ”bra” värde – det beror på allvarlighetsgrad, releasemodell och risktolerans. Använd medianvärden (P50) för ”typisk” prestanda och P90 för löften/SLA:er, och segmentera efter allvarlighetsgrad och källa.
Vad är skillnaden mellan att lösa ett fel och att stänga ett fel?
Lösning innebär att åtgärden har implementerats (t.ex. kod sammanfogad, konfiguration tillämpad) och att teamet anser att felet är åtgärdat. Avslut innebär att ärendet har verifierats och formellt avslutats (t.ex. validerat av QA i målmiljön, släppt eller markerat som ”kommer inte att åtgärdas”/”duplikat” med motivering). Många team mäter båda: Rapporterat→Löst återspeglar utvecklingshastigheten; Rapporterat→Avslutat återspeglar kvalitetsflödet från början till slut. Använd enhetliga definitioner så att instrumentpanelerna inte blandar ihop olika stadier.
Vad är skillnaden mellan felhanteringstid och feldetekteringstid?
Detektionstid (MTTD) är den tid det tar att upptäcka ett fel efter att det har uppstått eller levererats – via övervakning, kvalitetssäkring eller användare. Åtgärdstid är den tid det tar från upptäckt/rapportering till att åtgärden implementeras (och, om du föredrar det, valideras/släpps). Tillsammans definierar de tidsfönstret för kundpåverkan: upptäck snabbt, bekräfta snabbt, åtgärda snabbt och släpp säkert. Du kan också spåra MTTA (tid till bekräftelse/tilldelning) för att upptäcka förseningar i prioriteringen som ofta innebär att det tar längre tid att lösa felet.
Hur hjälper AI till vid felhantering?
AI effektiviserar de steg som vanligtvis tar lång tid: mottagning, prioritering, diagnos, åtgärd och verifiering.
- Intag och triagering: Sammanfattar automatiskt långa rapporter, extraherar steg för att återskapa felet och felmiljö, markerar dubbletter och föreslår allvarlighetsgrad och prioritet så att utvecklare kan börja med ett överskådligt sammanhang (t.ex. ClickUp AI, Sentry AI).
- Routning och SLA: Förutsäger sannolika komponenter/ansvariga, ställer in tidsgränser och eskalerar när MTTA eller granskningsväntetider överskrids – vilket minskar inaktiv ”tid i status” (ClickUp-automatiseringar och agentliknande arbetsflöden).
- Diagnos: Grupperar liknande fel, kopplar ihop toppar med senaste commit/releaser och pekar ut troliga grundorsaker med hjälp av stacktraces och kodkontext (Sentry AI och liknande).
- Implementering: Föreslår kodändringar och tester baserat på mönster från ditt repo, vilket påskyndar ”skriv/korrigera”-cykeln (GitHub Copilot; Snyk Code AI från DeepCode).
- Verifiering och kommunikation: skriver testfall utifrån steg för att återskapa fel, utarbetar releaseanteckningar och uppdateringar till intressenter samt sammanfattar status för ledningen och kunderna (ClickUp AI). När dessa verktyg används tillsammans – med ClickUp som kommandocentral och Sentry/Copilot/DeepCode i stacken – kan teamen minska MTTA- och P90-tiderna utan att behöva förlita sig på enskilda hjältar.