
Proyek pelatihan AI jarang gagal pada tingkat model. Proyek tersebut mengalami kendala ketika eksperimen, dokumentasi, dan pembaruan bagi pemangku kepentingan tersebar di terlalu banyak alat.
Panduan ini akan memandu Anda melalui proses melatih model dengan Databricks DBRX—sebuah LLM yang hingga dua kali lebih efisien dalam hal komputasi dibandingkan model-model terkemuka lainnya—sambil menjaga agar pekerjaan terkait tetap terorganisir di ClickUp.
Mulai dari pengaturan dan penyempurnaan hingga dokumentasi dan pembaruan lintas tim, Anda akan melihat bagaimana satu ruang kerja terpadu membantu menghilangkan penyebaran konteks dan membuat tim Anda tetap fokus pada pengembangan, bukan pada pencarian. 🛠
Apa itu DBRX?
DBRX adalah model bahasa besar (LLM) open-source yang kuat, yang dirancang khusus untuk pelatihan dan inferensi model AI di tingkat perusahaan. Karena bersifat open-source di bawah Lisensi Model Terbuka Databricks, tim Anda memiliki akses penuh ke bobot dan arsitektur model, sehingga Anda dapat memeriksa, memodifikasi, dan menerapkannya sesuai kebutuhan Anda.
Tersedia dalam dua varian: DBRX Base untuk pra-pelatihan mendalam dan DBRX Instruct untuk tugas mengikuti instruksi yang siap pakai.
Arsitektur DBRX dan desain campuran ahli
DBRX menyelesaikan tugas menggunakan arsitektur Mixture-of-Experts (MoE). Berbeda dengan model bahasa besar tradisional yang menggunakan seluruh miliaran parameternya untuk setiap perhitungan, DBRX hanya mengaktifkan sebagian kecil dari total parameternya (para ahli yang paling relevan) untuk setiap tugas tertentu.
Bayangkan sistem ini sebagai tim ahli yang terspesialisasi; alih-alih setiap orang menangani setiap masalah, sistem ini secara cerdas mengarahkan setiap tugas ke parameter yang paling sesuai dan paling kompeten.
Hal ini tidak hanya mempersingkat waktu respons, tetapi juga menghasilkan kinerja dan hasil terbaik sekaligus secara signifikan mengurangi biaya komputasi.
Berikut ini sekilas tentang spesifikasi utamanya:
- Jumlah parameter: 132 miliar di seluruh model ahli
- Parameter aktif: 36 miliar per putaran maju
- Jumlah ahli: total 16 (MoE Top-4 routing), dengan 4 ahli aktif untuk setiap token
- Jendela konteks: 32K token
Spesifikasi data pelatihan dan token DBRX
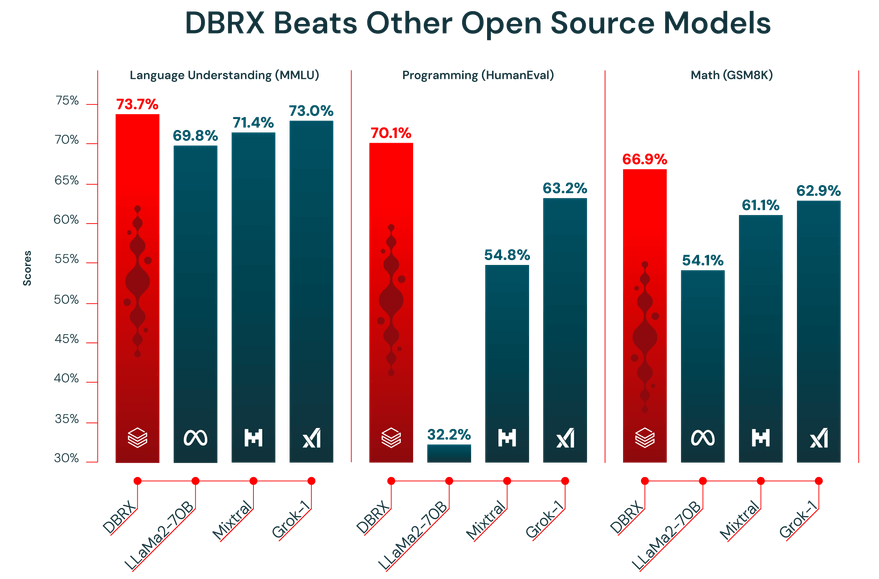
Kinerja LLM bergantung sepenuhnya pada kualitas data yang digunakan untuk melatihnya. DBRX telah dilatih sebelumnya menggunakan dataset besar berukuran 12 triliun token yang dikurasi dengan cermat oleh tim Databricks menggunakan alat pemrosesan data canggih mereka. Inilah alasan mengapa DBRX menunjukkan kinerja yang sangat baik pada tolok ukur industri.
Selain itu, DBRX dilengkapi dengan jendela konteks sebesar 32.000 token. Ini adalah jumlah teks yang dapat dipertimbangkan oleh model dalam satu waktu. Jendela konteks yang besar sangat membantu untuk tugas-tugas kompleks seperti merangkum laporan panjang, menelusuri dokumen hukum yang panjang, atau membangun sistem Retrieval-Augmented Generation (RAG) tingkat lanjut, karena memungkinkan model mempertahankan konteks tanpa memotong atau melupakan informasi.
🎥 Tonton video ini untuk melihat bagaimana koordinasi proyek yang efisien dapat mengubah alur kerja pelatihan AI Anda dan menghilangkan hambatan saat berpindah antar alat yang tidak terintegrasi. 👇🏽
Cara Mengakses dan Menyiapkan DBRX
DBRX menawarkan dua jalur akses utama, yang keduanya memberikan akses penuh ke bobot model berdasarkan ketentuan komersial yang fleksibel. Anda dapat menggunakan Hugging Face untuk fleksibilitas maksimal atau mengaksesnya langsung melalui Databricks untuk pengalaman yang lebih terintegrasi.
Akses DBRX melalui Hugging Face
Bagi tim yang mengutamakan fleksibilitas dan sudah terbiasa dengan ekosistem Hugging Face, mengakses DBRX melalui Hub adalah pilihan yang ideal. Hal ini memungkinkan Anda mengintegrasikan model tersebut ke dalam alur kerja berbasis Transformer yang sudah ada.
Berikut cara memulainya:
- Buat atau masuk ke akun Hugging Face Anda
- Buka kartu model DBRX di Hub dan setujui persyaratan lisensi
- Instal pustaka transformers beserta dependensi yang diperlukan seperti accelerate
- Gunakan kelas `AutoModelForCausalLM` dalam skrip Python Anda untuk memuat model DBRX
- Konfigurasikan pipeline inferensi Anda, dengan mengingat bahwa DBRX memerlukan memori GPU (VRAM) yang cukup besar agar dapat beroperasi secara efektif
📖 Baca Selengkapnya: Cara Mengonfigurasi Suhu LLM
Akses DBRX melalui Databricks
Jika tim Anda sudah menggunakan Databricks untuk rekayasa data atau pembelajaran mesin, mengakses DBRX melalui platform tersebut adalah cara termudah. Hal ini menghilangkan kendala pengaturan dan memberi Anda semua alat yang Anda butuhkan untuk MLOps tepat di tempat Anda sudah bekerja.
Ikuti langkah-langkah berikut di ruang kerja Databricks Anda untuk memulai:
- Buka bagian Model Garden atau Mosaic AI
- Pilih DBRX Base atau DBRX Instruct, sesuai dengan kebutuhan Anda
- Konfigurasikan titik akhir layanan untuk akses API atau siapkan lingkungan notebook untuk penggunaan interaktif
- Mulailah menguji inferensi dengan prompt contoh untuk memastikan semuanya berfungsi dengan benar sebelum meningkatkan skala pelatihan atau penerapan model AI Anda
Pendekatan ini memberi Anda akses yang lancar ke alat-alat seperti MLflow untuk pelacakan eksperimen dan Unity Catalog untuk tata kelola model.
📮 Wawasan ClickUp: Rata-rata profesional menghabiskan lebih dari 30 menit sehari untuk mencari informasi terkait pekerjaan—itu berarti lebih dari 120 jam per tahun terbuang percuma hanya untuk menelusuri email, utas Slack, dan berkas-berkas yang tersebar.
Asisten AI cerdas yang terintegrasi dalam ruang kerja Anda dapat mengubah hal itu. Perkenalkan ClickUp Brain.
ClickUp memberikan wawasan dan jawaban instan dengan menampilkan dokumen, percakapan, dan detail tugas yang tepat dalam hitungan detik—sehingga Anda tidak perlu lagi mencari-cari dan bisa langsung mulai bekerja.
Cara Menyesuaikan DBRX dan Melatih Model AI Kustom
Model siap pakai, sekuat apa pun, tidak akan pernah memahami nuansa unik bisnis Anda. Karena DBRX bersifat open source, Anda dapat menyempurnakannya untuk membuat model khusus yang memahami bahasa perusahaan Anda atau menjalankan tugas spesifik yang ingin Anda tangani.
Berikut adalah tiga cara umum yang dapat Anda lakukan:
1. Sesuaikan DBRX dengan dataset Hugging Face
Bagi tim yang baru memulai atau sedang mengerjakan tugas-tugas umum, dataset publik dari Hugging Face Hub merupakan sumber daya yang sangat berguna. Data tersebut sudah diformat sebelumnya dan mudah dimuat, sehingga Anda tidak perlu menghabiskan berjam-jam untuk mempersiapkan data.
Prosesnya cukup sederhana:
- Temukan dataset di Hub yang sesuai dengan tugas Anda (misalnya, mengikuti instruksi, merangkum)
- Muat data tersebut menggunakan pustaka dataset
- Pastikan data diformat menjadi pasangan instruksi-respons
- Konfigurasikan skrip pelatihan Anda dengan hiperparameter seperti laju pembelajaran dan ukuran batch
- Jalankan tugas pelatihan, pastikan untuk menyimpan titik pemeriksaan secara berkala
- Evaluasi model yang telah disempurnakan pada kumpulan data validasi yang disisihkan untuk mengukur peningkatan
2. Sesuaikan DBRX dengan dataset lokal
Anda biasanya akan mendapatkan hasil terbaik dengan melakukan penyempurnaan menggunakan data eksklusif milik Anda sendiri. Hal ini memungkinkan Anda mengajarkan model tersebut terminologi, gaya, dan pengetahuan domain khusus perusahaan Anda. Perlu diingat bahwa hal ini hanya akan membuahkan hasil jika data Anda bersih, dipersiapkan dengan baik, dan memiliki volume yang memadai.
Ikuti langkah-langkah berikut untuk mempersiapkan data internal Anda:
- Pengumpulan data: Kumpulkan contoh-contoh berkualitas tinggi dari wiki internal, dokumen, dan basis data Anda
- Konversi format: Susun data Anda ke dalam format instruksi-respons yang konsisten, biasanya berupa baris JSON
- Penyaringan kualitas: Hapus contoh-contoh yang berkualitas rendah, duplikat, atau tidak relevan
- Pembagian data validasi: Sisihkan sebagian kecil data Anda (biasanya 10–15%) untuk mengevaluasi kinerja model
- Tinjauan privasi: Hapus atau samarkan informasi yang dapat mengidentifikasi pribadi (PII) atau data sensitif
3. Menyesuaikan DBRX dengan StreamingDataset
Jika dataset Anda ternyata terlalu besar untuk muat di memori mesin Anda, jangan khawatir, Anda dapat menggunakan pustaka Streaming Dataset dari Databricks. Pustaka ini memungkinkan Anda mengalirkan data langsung dari penyimpanan cloud saat model sedang dilatih, alih-alih memuat semuanya ke dalam memori sekaligus.
Berikut cara melakukannya:
- Persiapan data: Bersihkan dan susun data pelatihan Anda, lalu simpan dalam format yang dapat dialirkan seperti JSONL atau CSV di penyimpanan cloud
- Konversi format streaming: Konversikan dataset Anda ke format yang ramah streaming, seperti Mosaic Data Shard (MDS), agar dapat dibaca secara efisien selama pelatihan
- Pengaturan loader pelatihan: Konfigurasikan loader pelatihan Anda agar mengarah ke dataset jarak jauh dan tentukan cache lokal untuk penyimpanan data sementara
- Inisialisasi model: Mulailah proses penyempurnaan model DBRX menggunakan kerangka kerja pelatihan yang mendukung StreamingDataset, seperti LLM Foundry
- Pelatihan berbasis streaming: Jalankan tugas pelatihan sambil data dialirkan secara bertahap selama proses pelatihan, alih-alih dimuat seluruhnya ke dalam memori
- Pencadangan dan pemulihan: Lanjutkan pelatihan tanpa hambatan jika proses pelatihan terputus, tanpa menduplikasi atau melewatkan data
- Evaluasi dan penerapan: Validasi kinerja model yang telah disempurnakan dan terapkan model tersebut menggunakan pengaturan serving atau inferensi pilihan Anda
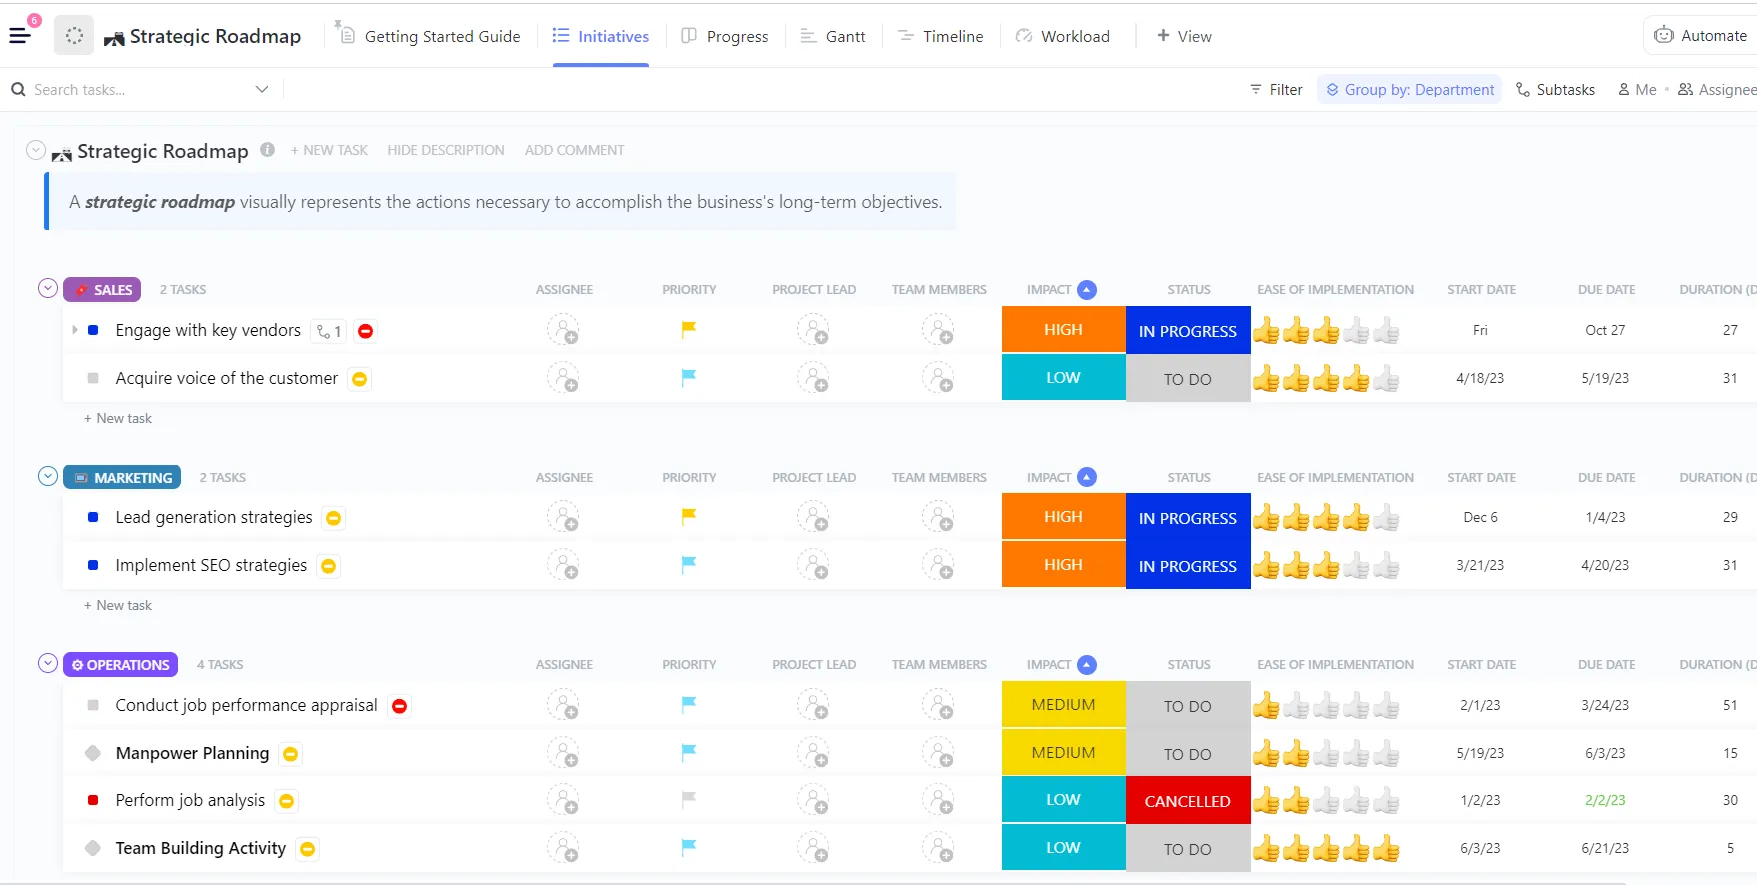
💡Kiat pro: Daripada membuat rencana pelatihan DBRX dari awal, mulailah dengan Templat Peta Jalan Proyek AI dan Pembelajaran Mesin dari ClickUp, lalu sesuaikan dengan kebutuhan tim Anda. Templat ini menyediakan struktur yang jelas untuk merencanakan kumpulan data, fase pelatihan, evaluasi, dan penerapan, sehingga Anda dapat fokus pada pengorganisasian pekerjaan daripada menyusun alur kerja.
Kasus Penggunaan DBRX untuk Pelatihan Model AI
Memiliki model yang kuat adalah satu hal, tetapi mengetahui dengan tepat di mana keunggulannya adalah hal lain.
Jika Anda tidak memiliki gambaran yang jelas mengenai kelebihan suatu model, Anda mudah menghabiskan waktu dan sumber daya untuk mencoba menggunakannya di tempat yang sebenarnya tidak sesuai. Hal ini berujung pada hasil yang kurang memuaskan dan rasa frustrasi.
Arsitektur unik dan data pelatihan DBRX menjadikannya sangat cocok untuk beberapa kasus penggunaan utama di lingkungan perusahaan. Memahami keunggulan ini akan membantu Anda menyelaraskan model dengan tujuan bisnis Anda dan memaksimalkan pengembalian investasi (ROI).
Pembuatan teks dan pembuatan konten
DBRX Instruct dirancang secara khusus untuk mengikuti instruksi dan menghasilkan teks berkualitas tinggi. Hal ini menjadikannya alat yang ampuh untuk mengotomatisasi berbagai tugas terkait konten. Jendela konteksnya yang luas merupakan keunggulan signifikan, sehingga memungkinkan model ini menangani dokumen panjang tanpa kehilangan alur cerita.
Anda dapat menggunakannya untuk:
- Dokumentasi teknis: Buat dan sempurnakan manual produk, referensi API, dan panduan pengguna
- Konten pemasaran: Draf postingan blog, buletin email, dan pembaruan media sosial
- Pembuatan laporan: Rangkum temuan data yang kompleks dan buat ringkasan eksekutif yang padat
- Penerjemahan dan pelokalan: Sesuaikan konten yang sudah ada untuk pasar dan audiens baru
Tugas pembuatan kode dan debugging
Sebagian besar data pelatihan DBRX mencakup kode, sehingga menjadikannya dukungan LLM yang mumpuni bagi para pengembang. DBRX dapat membantu mempercepat siklus pengembangan dengan mengotomatiskan tugas-tugas pengkodean yang berulang dan membantu dalam pemecahan masalah yang kompleks.
Berikut adalah beberapa cara tim teknik Anda dapat memanfaatkannya:
- Penyelesaian kode: Secara otomatis menghasilkan badan fungsi dari komentar atau docstring
- Deteksi bug: Analisis potongan kode untuk mengidentifikasi potensi kesalahan atau kelemahan logis
- Penjelasan kode: Terjemahkan algoritma kompleks atau kode warisan ke dalam bahasa Inggris yang mudah dipahami
- Pembuatan tes: Buat tes unit berdasarkan tanda tangan fungsi dan perilaku yang diharapkan
RAG dan aplikasi dengan konteks panjang
Retrieval-Augmented Generation (RAG) adalah teknik yang sangat efektif yang mendasarkan respons model pada data internal perusahaan Anda. Namun, sistem RAG sering kali mengalami kesulitan dengan model yang memiliki jendela konteks kecil, sehingga memaksa pemotongan data secara agresif yang dapat menghilangkan konteks penting. Jendela konteks 32K DBRX menjadikannya fondasi yang sangat baik untuk aplikasi RAG yang andal.
Hal ini memungkinkan Anda membangun alat internal yang canggih, seperti:
- Pencarian perusahaan: Buat chatbot yang menjawab pertanyaan karyawan menggunakan basis pengetahuan internal Anda
- Dukungan pelanggan: Buat agen yang menghasilkan tanggapan dukungan berdasarkan dokumentasi produk Anda
- Bantuan penelitian: Kembangkan alat yang dapat mensintesis informasi dari ratusan halaman makalah penelitian
- Pemeriksaan kepatuhan: Secara otomatis memverifikasi teks pemasaran sesuai dengan pedoman merek internal atau dokumen regulasi
Cara Mengintegrasikan Pelatihan DBRX dengan Alur Kerja Tim Anda
Proyek pelatihan model AI yang sukses tidak hanya sekadar soal kode dan komputasi. Ini merupakan upaya kolaboratif yang melibatkan insinyur ML, ilmuwan data, manajer produk, dan pemangku kepentingan.
Ketika kolaborasi ini tersebar di berbagai Jupyter notebook, saluran Slack, dan alat manajemen proyek yang terpisah, Anda menciptakan context sprawl, yaitu situasi di mana informasi proyek yang penting tersebar di terlalu banyak alat.
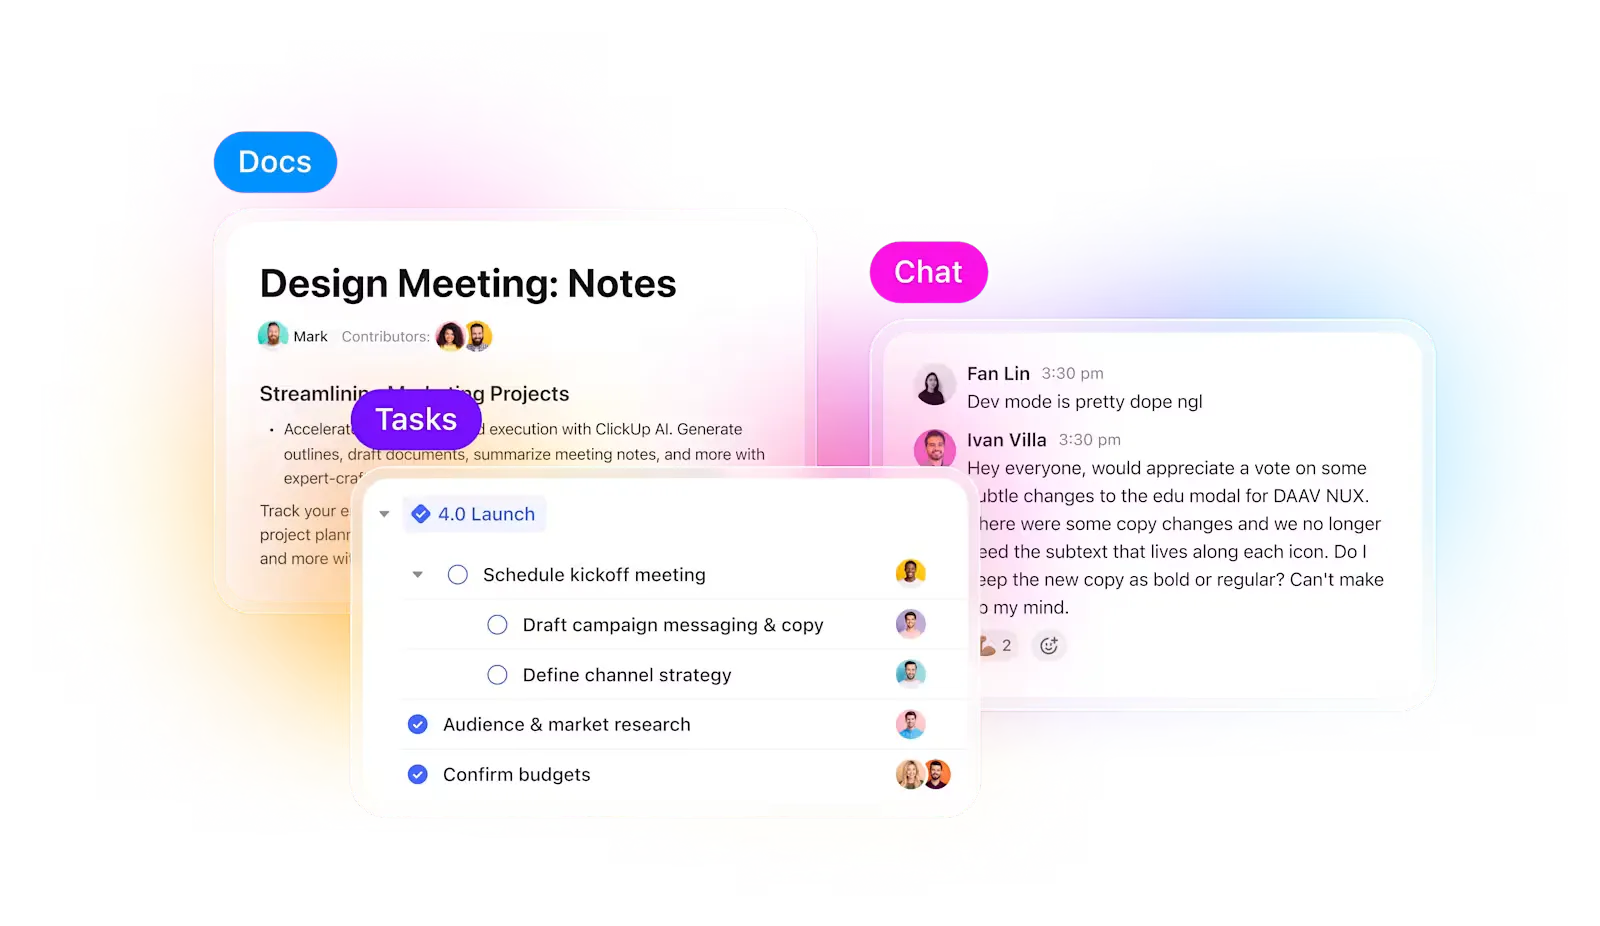
ClickUp memecahkan masalah tersebut. Alih-alih harus berganti-ganti antara berbagai alat, Anda mendapatkan satu Ruang Kerja AI Terintegrasi di mana manajemen proyek, dokumentasi, dan komunikasi berada dalam satu tempat—sehingga eksperimen Anda tetap terhubung mulai dari perencanaan, pelaksanaan, hingga evaluasi.
Jangan sampai kehilangan jejak eksperimen dan kemajuannya
Saat menjalankan beberapa eksperimen, bagian tersulit bukanlah melatih model; melainkan melacak apa saja yang berubah selama proses tersebut. Versi dataset mana yang digunakan, nilai learning rate mana yang memberikan hasil terbaik, atau run mana yang telah diterapkan?
ClickUp membuat proses ini sangat mudah bagi Anda. Anda dapat melacak setiap sesi pelatihan secara terpisah di ClickUp Tasks, dan di dalam tugas tersebut, Anda dapat menggunakan Bidang Kustom untuk mencatat:
- Versi dataset
- Hiperparameter
- Varian model (DBRX Base vs DBRX Instruct)
- Status pelatihan (Dalam antrian, Sedang berjalan, Sedang dievaluasi, Telah diterapkan)
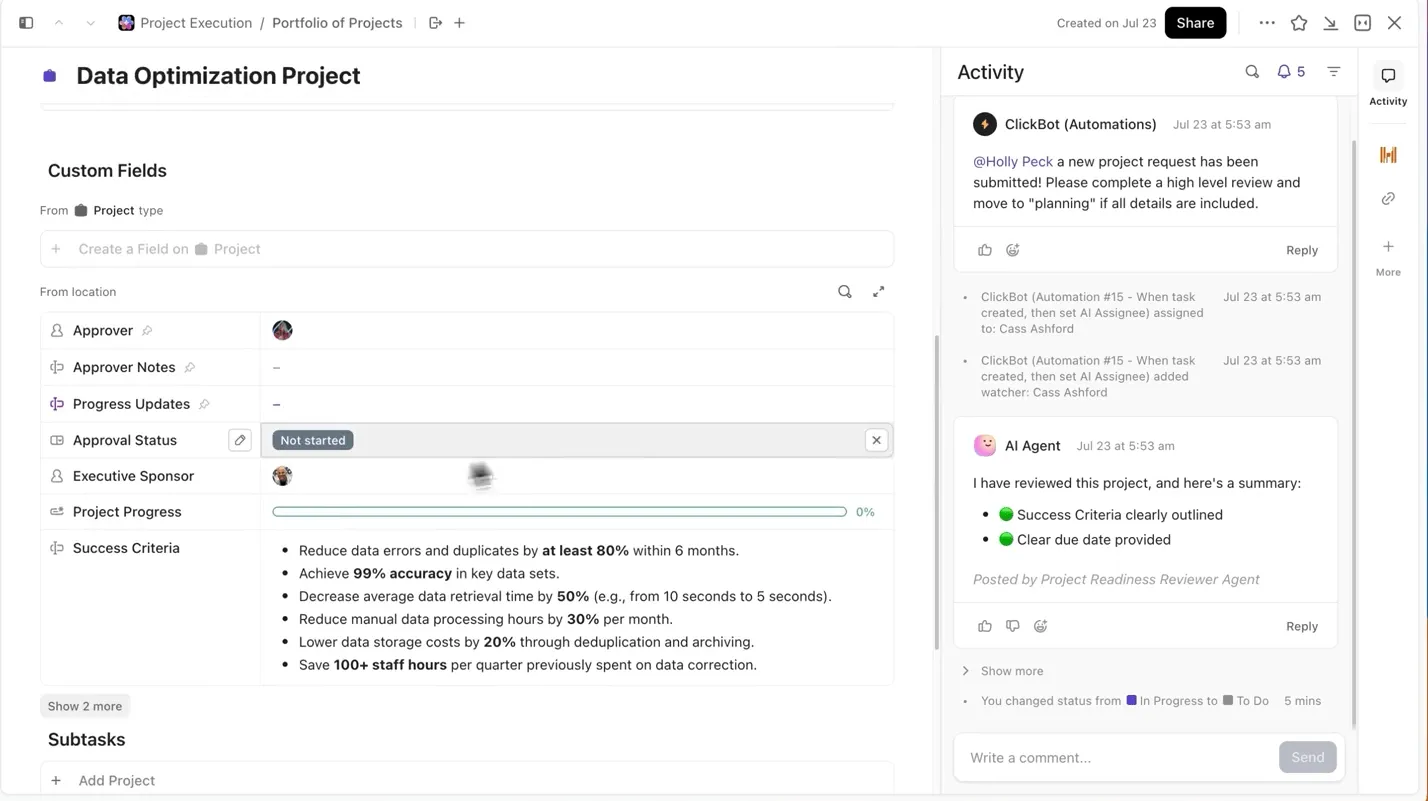
Dengan demikian, setiap eksperimen yang didokumentasikan dapat dicari, mudah dibandingkan dengan eksperimen lain, dan dapat direproduksi.
Pastikan dokumentasi model tetap terintegrasi dengan pekerjaan
Anda tidak perlu berpindah-pindah antara Jupyter notebook, berkas README, atau utas obrolan di Slack untuk memahami konteks tugas suatu eksperimen.
Dengan ClickUp Docs, Anda dapat mengatur arsitektur model, skrip persiapan data, atau metrik evaluasi agar tetap terorganisir dan mudah diakses dengan mendokumentasikannya dalam dokumen yang dapat dicari dan tertaut langsung ke tugas eksperimen asalnya.
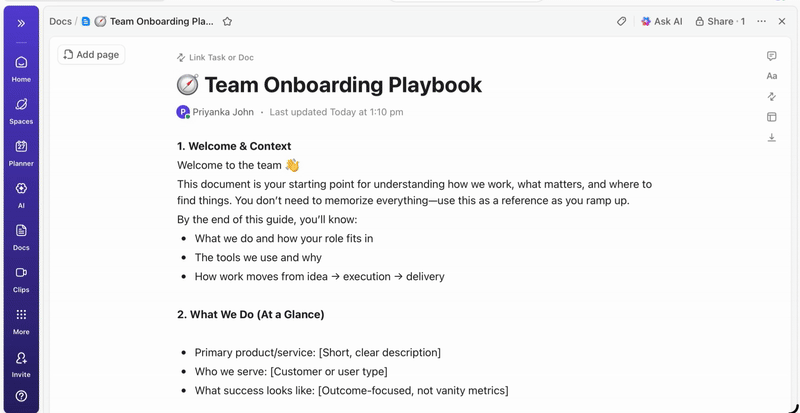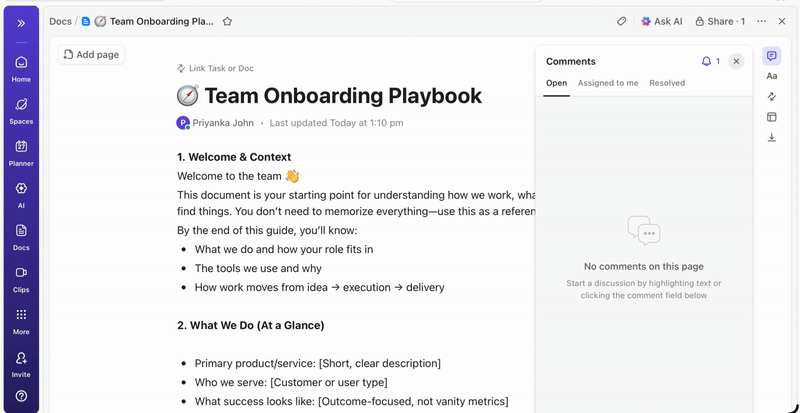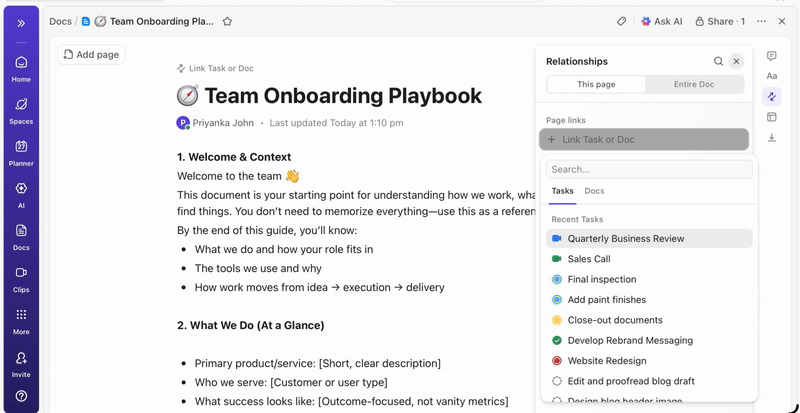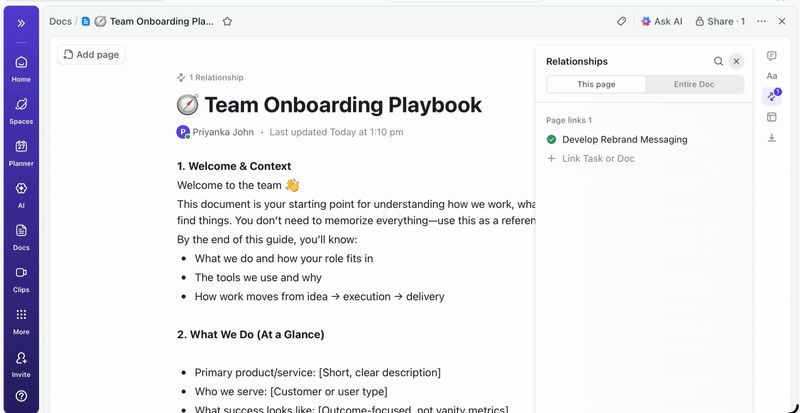
💡Tips Pro: Buat dan perbarui ringkasan proyek secara berkala di ClickUp Docs yang merinci setiap keputusan, mulai dari arsitektur hingga implementasi, sehingga anggota tim baru selalu dapat memahami detail proyek tanpa harus menelusuri percakapan lama
Berikan visibilitas secara real-time kepada para pemangku kepentingan
Dasbor ClickUp menampilkan kemajuan eksperimen dan beban kerja tim secara real-time. I
Alih-alih mengompilasi pembaruan secara manual atau mengirim email, dasbor akan diperbarui secara otomatis berdasarkan data dalam tugas Anda. Dengan demikian, pemangku kepentingan dapat memeriksa perkembangan kapan saja, melihat kondisi terkini, dan tidak perlu lagi mengganggu Anda dengan pertanyaan seperti “bagaimana statusnya?”.
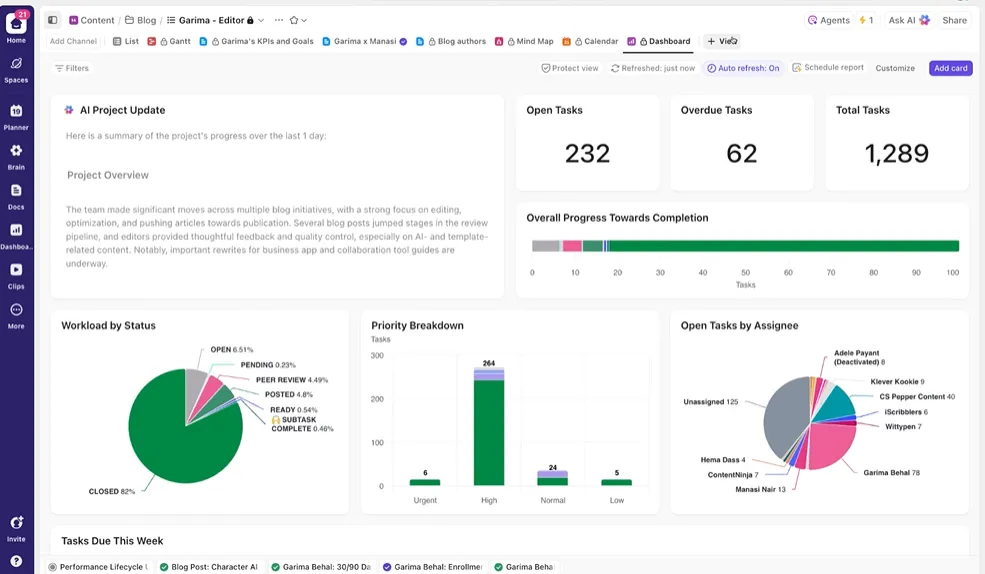
Dengan cara ini, Anda dapat fokus pada pelaksanaan eksperimen daripada harus terus-menerus membuat laporan secara manual.
Jadikan AI sebagai asisten cerdas untuk proyek Anda
Anda tidak perlu secara manual menelusuri data pelatihan selama berminggu-minggu untuk mendapatkan ringkasan eksperimen yang telah dilakukan sejauh ini. Cukup sebutkan @Brain di komentar tugas mana pun, dan ClickUp Brain akan memberikan bantuan yang Anda butuhkan dengan konteks lengkap mengenai proyek-proyek Anda yang telah selesai maupun yang sedang berjalan.
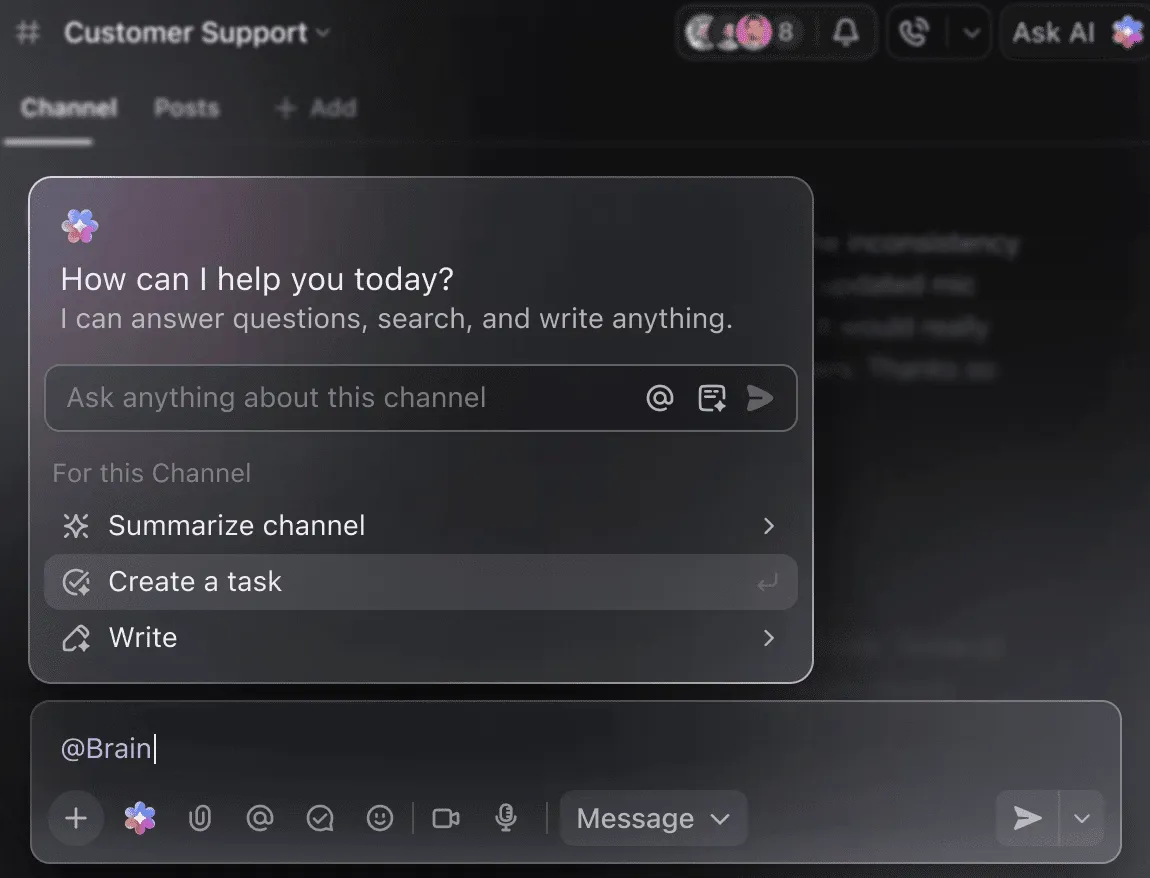
Anda dapat meminta Brain untuk ‘Merangkum eksperimen minggu lalu dalam 5 poin’ atau ‘Menyusun draf dokumen dengan hasil hiperparameter terbaru,’ dan langsung mendapatkan hasil yang rapi.
🧠 Keunggulan ClickUp: Super Agent ClickUp membawa hal ini lebih jauh—mereka dapat mengotomatiskan seluruh alur kerja berdasarkan pemicu yang Anda tentukan, bukan sekadar menjawab pertanyaan Anda. Dengan Super Agents, Anda dapat secara otomatis membuat tugas pelatihan DBRX baru setiap kali dataset diunggah, memberi tahu tim Anda, dan menautkan dokumen yang relevan saat proses pelatihan selesai atau mencapai titik pemeriksaan, serta menghasilkan ringkasan kemajuan mingguan dan mengirimkannya ke pemangku kepentingan tanpa Anda perlu melakukan apa pun.
Kesalahan Umum yang Harus Dihindari
Memulai proyek pelatihan DBRX memang menarik, tetapi beberapa kendala umum dapat menghambat kemajuan Anda. Menghindari kesalahan-kesalahan ini akan menghemat waktu, uang, dan banyak frustrasi.
- Meremehkan persyaratan perangkat keras: DBRX memang sangat kuat, tetapi ukurannya juga besar. Mencoba menjalankannya pada perangkat keras yang tidak memadai akan menyebabkan kesalahan kehabisan memori dan kegagalan proses pelatihan. Perlu diingat bahwa DBRX (132B) membutuhkan setidaknya 264GB VRAM untuk inferensi 16-bit, atau sekitar 70GB–80GB saat menggunakan kuantisasi 4-bit
- Melewatkan pemeriksaan kualitas data: Data masukan yang buruk akan menghasilkan keluaran yang buruk. Melakukan penyempurnaan pada dataset yang berantakan dan berkualitas rendah hanya akan mengajarkan model untuk menghasilkan keluaran yang berantakan dan berkualitas rendah.
- Mengabaikan batasan panjang konteks: Meskipun jendela konteks 32K DBRX tergolong luas, namun tidaklah tak terbatas. Memberikan masukan model yang melebihi batas ini akan mengakibatkan pemotongan tanpa pemberitahuan dan kinerja yang buruk
- Kapan sebaiknya menggunakan DBRX Base daripada DBRX Instruct: DBRX Base adalah model mentah yang telah dilatih sebelumnya dan ditujukan untuk pelatihan lanjutan berskala besar. Untuk sebagian besar tugas yang memerlukan pemenuhan instruksi, sebaiknya Anda memulai dengan DBRX Instruct, yang telah disesuaikan secara khusus untuk tujuan tersebut.
- Memisahkan pekerjaan pelatihan dari koordinasi proyek: Ketika pelacakan eksperimen Anda berada di satu alat dan rencana proyek di alat lain, Anda menciptakan silo informasi. Gunakan platform terintegrasi seperti ClickUp untuk menjaga agar pekerjaan teknis dan koordinasi proyek tetap selaras
- Mengabaikan evaluasi sebelum penerapan: Model yang berkinerja baik pada data pelatihan Anda mungkin akan gagal total di dunia nyata. Selalu validasi model yang telah disempurnakan pada kumpulan data uji yang disisihkan sebelum menerapkannya ke produksi
- Mengabaikan kompleksitas penyempurnaan: Karena DBRX merupakan model Mixture-of-Experts, skrip penyempurnaan standar mungkin memerlukan pustaka khusus seperti Megatron-LM atau PyTorch FSDP untuk menangani pembagian parameter di beberapa GPU
DBRX vs. Platform Pelatihan AI Lainnya
Memilih platform pelatihan AI melibatkan pertimbangan mendasar: kontrol versus kemudahan. Model eksklusif yang hanya dapat diakses melalui API memang mudah digunakan, tetapi mengikat Anda ke dalam ekosistem vendor tersebut.
Model dengan bobot terbuka seperti DBRX menawarkan kendali penuh, tetapi membutuhkan keahlian teknis dan infrastruktur yang lebih mumpuni. Pilihan ini dapat membuat Anda merasa buntu, tidak yakin jalur mana yang sebenarnya mendukung tujuan jangka panjang Anda—sebuah tantangan yang dihadapi banyak tim selama proses adopsi AI.
Tabel ini merinci perbedaan utama untuk membantu Anda membuat keputusan yang tepat.
| Bobot | Buka (Kustom) | Hak Cipta | Buka (Kustom) | Hak Cipta |
| Penyesuaian lanjutan | Kontrol Penuh | Berbasis API | Kontrol Penuh | Berbasis API |
| Penghostingan mandiri | Ya | Tidak | Ya | Tidak |
| Lisensi | DB Open Model | Ketentuan OpenAI | Komunitas Llama | Istilah-istilah Anthropic |
| Konteks | 32K | 128 ribu – 1 juta | 128K | 200 ribu – 1 juta |
DBRX adalah pilihan yang tepat jika Anda membutuhkan kendali penuh atas model, harus menghosting sendiri demi keamanan atau kepatuhan, atau menginginkan fleksibilitas dari lisensi komersial yang permisif. Jika Anda tidak memiliki infrastruktur GPU khusus—atau lebih mengutamakan kecepatan peluncuran produk daripada penyesuaian mendalam—alternatif berbasis API mungkin lebih cocok.
Mulailah Melatih Model AI dengan Lebih Cerdas Bersama ClickUp
DBRX memberikan fondasi yang siap untuk skala perusahaan dalam membangun aplikasi AI kustom, dengan transparansi dan kontrol yang tidak Anda dapatkan dari model berpemilik. Arsitektur MoE-nya yang efisien menekan biaya inferensi, dan desainnya yang terbuka memudahkan penyesuaian. Namun, teknologi yang kuat hanyalah setengah dari persamaan.
Kesuksesan sejati berasal dari menyelaraskan pekerjaan teknis Anda dengan alur kerja kolaboratif tim. Pelatihan model AI adalah upaya tim, dan menjaga agar eksperimen, dokumentasi, serta komunikasi dengan pemangku kepentingan tetap selaras sangatlah penting. Ketika Anda menggabungkan semuanya ke dalam satu ruang kerja terpadu dan mengurangi penyebaran konteks, Anda dapat menghasilkan model yang lebih baik dengan lebih cepat.
Mulailah secara gratis dengan ClickUp untuk mengoordinasikan proyek pelatihan AI Anda dalam satu ruang kerja. ✨
Pertanyaan yang Sering Diajukan
Bagaimana cara memantau kemajuan pelatihan di DBRX?
Anda dapat memantau proses pelatihan menggunakan alat ML standar seperti TensorBoard, Weights & Biases, atau MLflow. Jika Anda melakukan pelatihan di dalam ekosistem Databricks, MLflow terintegrasi secara native untuk pelacakan eksperimen yang lancar.
Apakah saya dapat mengintegrasikan DBRX dengan CI/CD dan pipeline deployment?
Ya, DBRX dapat diintegrasikan ke dalam pipeline MLOps standar. Dengan mengontainerisasi model, Anda dapat mengimplementasikannya menggunakan platform orkestrasi seperti Kubeflow atau alur kerja CI/CD kustom.
Apa perbedaan antara DBRX Base dan DBRX Instruct?
DBRX Base adalah model dasar yang telah dilatih sebelumnya, dirancang untuk tim yang ingin melakukan pelatihan lanjutan khusus domain atau penyempurnaan arsitektur mendalam. DBRX Instruct adalah versi yang telah disempurnakan dan dioptimalkan untuk mengikuti instruksi, sehingga menjadi titik awal yang lebih baik untuk sebagian besar pengembangan aplikasi.
Bagaimana perbandingan DBRX dengan GPT-4 untuk proyek AI perusahaan?
Perbedaan utamanya terletak pada kontrol. DBRX memberi Anda akses penuh ke bobot model untuk penyesuaian mendalam dan hosting mandiri, sedangkan GPT-4 adalah layanan berbasis API saja.
Apakah DBRX dapat digunakan secara gratis?
Bobot model DBRX tersedia secara gratis di bawah Lisensi Model Terbuka Databricks. Namun, Anda bertanggung jawab atas biaya infrastruktur komputasi yang diperlukan untuk menjalankan atau menyempurnakan model tersebut.