Am 22. September 2026 veröffentlichte Anthropic Claude Opus 5.5, während OpenAI die GPT-6-Familie um Sol und Luna erweiterte. Dieser Zeitpunkt löste eine weitere Runde von Benchmark-Vergleichen zwischen den tools aus.
Das Problem ist jedoch, dass weder Claude noch ChatGPT noch ein einziges Modell sind.
Claude umfasst mittlerweile Fable, Opus, Sonnet und Haiku, während ChatGPT unterschiedliche Arbeiten auf seine eigenen GPT-Modelle und -Modi verteilt. In Benchmark-Tabellen werden oft verschiedene Mitglieder dieser Modellfamilien unter unterschiedlichen Einstellungen verglichen, was eine eindeutige Aussage wie „Claude erzielte X, ChatGPT erzielte Y“ erschwert.
So sieht die tatsächliche Situation bei der Entscheidung zwischen Claude und ChatGPT im Jahr 2026 aus.
Zwar spielt die reine Leistungsfähigkeit nach wie vor eine Rolle, doch die Leistungsdaten allein sind kein aussagekräftiges Kaufkriterium. Zu den praktischen Unterschieden zählen die verfügbaren Modelle, Features, Limite und die Kosten für Upgrades. In diesem Blogbeitrag haben wir alles aufgeschlüsselt, was Sie wissen müssen – von der Zielgruppe bis hin zu den jeweiligen Schwachstellen.
TL;DR: Claude und ChatGPT liegen hinsichtlich ihrer reinen Leistungsfähigkeit nahe beieinander. Die wirklichen Unterschiede zeigen sich im Workflow, bei den tools und bei den Limiten.
- Lassen Sie sich bei Ihrer Entscheidung nicht von Benchmarks leiten. Die Anbieter testen die Modelle des jeweils anderen unter unterschiedlichen Einstellungen. Testen Sie zunächst Ihre eigene Arbeit mit beiden kostenlosen Tarifen.
- Behalten Sie beide nur, wenn sich die Unterschiede jede Woche in Ihrer Arbeit bemerkbar machen.
- Entscheiden Sie sich für Claude bei langen Programmier-Sitzungen, umfangreichen Dokumenten und Texten, die einem detaillierten Briefing über viele Überarbeitungsrunden hinweg folgen müssen.
- Entscheiden Sie sich für ChatGPT, wenn Sie einen einzigen Assistenten für Recherchen, Dateien, Bilder, Sprache und Code suchen und zudem den günstigsten kostenpflichtigen Eintrag nutzen möchten (8 $/Monat für „Go“ in den USA).
- Beim Programmieren hat Claude Code bei umfangreichen Refactorings und Migrationen die Nase vorn. Codex ist die bessere Wahl, wenn Sie zwischen Desktop, CLI, IDE, Cloud und Mobilgeräten wechseln.
- Claude kann keine Bilder generieren. ChatGPT kann das, und das ist der Unterschied, den Benutzer am häufigsten erwähnen.
❗️Die meisten KI-Agenten erzielten weniger als 65 Punkte.
Wir haben 6 KI-Tools anhand einer realen Aufgabe getestet: die Erstellung eines umsetzbaren Plans für ein Projekt auf der Grundlage eines Briefings. Der Gewinner war nicht der beste Texter, sondern derjenige, der Zugriff auf echte Arbeitsdaten hatte. 👇🏼
Claude vs. ChatGPT auf einen Blick
| Kategorie | Claude | ChatGPT |
|---|---|---|
| Am besten geeignet für | Lange Sitzungen zum Code-Schreiben, umfangreiche Dokumente, Recherche und anleitungslastiges Schreiben | Recherche, Texterstellung, Bilder, Code, Dateien, Sprache und Workflows mit mehreren Formaten |
| Preis für das Einstiegsabonnement | 20 $/Monat für Pro oder 200 $/Jahr (~17 $/Monat) | 8 $/Monat für „Go“ in den USA; 20 $/Monat für „Plus“ |
| Besondere Stärke | Komplexe, kontextintensive Arbeiten, die viele Schritte umfassen | Umfangreiche Tools und Formate in einem Produkt |
| Programmierung | Besser geeignet für umfangreiche Refactorings, Migrationen, Audits und repositoryintensive Arbeiten | Bessere Eignung für die Ausführung in der Cloud und den Wechsel zwischen Desktop, IDE, CLI und Mobilgeräten |
| Verfassen | Eignet sich besser für das Verfassen langer Texte, die Bearbeitung von Texten mit vielen Quellenangaben und detaillierte Stilregeln | Eignet sich besser für strukturiertes Schreiben, das mit Recherchen, Dateien, Bildern und anderen Formaten eine Verbindung herstellt |
| Limitierungen | Gemeinsames Kontingent für Claude, Desktop und Claude Code mit Fünf-Stunden- und wöchentlichen Limits | Die Limits variieren je nach Modell und Feature, wobei für Chat, Arbeit, Codex, Voice und andere tools jeweils eigene Kontingente gelten. |
| Native Bildgenerierung | Nein | Ja |
| Preise für die Top-Modell-API | Opus 5.5: 4 $/20 $; Fable 5.1: 10 $/50 $ pro 1 Million Eingabe-/Ausgabe-Token | GPT-6 Astra: 10 $/50 $ pro 1 Million Eingabe-/Ausgabe-Token |
| Wichtigster Kompromiss | Eingeschränkter Funktionsumfang und Einschränkungen bei bestimmten Arbeiten in den Bereichen Cybersicherheit und Biowissenschaften | Komplizierterer Zugriff auf Modelle und unterschiedliche Limits in verschiedenen Bereichen des Produkts |
So bewerten wir Software bei ClickUp
Unser Team verfolgt einen transparenten, wissenschaftlich fundierten und herstellerneutralen Prozess, sodass Sie darauf vertrauen können, dass unsere Empfehlungen auf dem tatsächlichen Wert des Produkts basieren.
Hier finden Sie eine detaillierte Übersicht darüber, wie wir bei ClickUp Software bewerten.
Claude vs. ChatGPT – Benchmarks: Warum die Ergebnisse nicht die ganze Wahrheit widerspiegeln
Benchmark-Ergebnisse entscheiden nicht mehr über die Frage „Claude oder ChatGPT“. Die Testversion, die Einstellungen für das logische Schlussfolgern, Sicherheitsvorkehrungen, Fallback-Modelle und die Testumgebung können das Ergebnis beeinflussen.
AutomationBench, entwickelt von Zapier, testet, ob ein Agent echte Geschäfts-Workflows über verbundene Apps abschließen kann. In der Ankündigung von OpenAI zu GPT-6 Astra erreicht GPT-5.6 Sol 18,1 %. Nur 19 Tage später meldet Anthropic in seiner Ankündigung zu Opus 5.5 28,8 % für GPT-5.6 Sol, basierend auf den Ergebnissen der Zapier-Rangliste.
Das ist eine Differenz von 10,7 Punkten für dasselbe Modell beim gleichen Benchmark-Test. Zapier macht eine Notiz dazu, dass sich sein interner Testdatensatz zwischen verschiedenen Benchmark-Versionen ändern kann und dass unterschiedliche Agent-Setups zu unterschiedlichen Ergebnissen führen können. Die Punktzahl muss daher im Zusammenhang mit den jeweiligen Testbedingungen betrachtet werden.
Die Benchmarks zeigen zudem, dass OpenAI und Anthropic Claude nicht immer unter denselben Bedingungen getestet haben:
- OpenAI verwendete zeitweise ein weniger eingeschränktes Claude-Modell. Für ScreenSpot-Pro und ExploitGym gibt OpenAI an, dass seine Fable-Ergebnisse von Mythos stammen, das das Unternehmen als „Fable mit weniger Sicherheitsvorkehrungen“ beschreibt .
- Anthropic hat die Produktionssicherheitsvorkehrungen von Opus 5.5 beibehalten. Wenn diese Sicherheitsvorkehrungen griffen, mussten einige Cyber-Aufgaben an Opus 4.8 und einige Aufgaben aus den Bereichen Biologie und „Frontier-LLM“ an Opus 5 weitergeleitet werden. Bei AutomationBench gab es kein Fallback-Modell, sodass ein Eingriff als fehlgeschlagene Aufgabe gewertet wurde.
Auch das Ablehnungsverhalten fließt in den Vergleich ein. OpenAI hat Claude Fable 5 und 5.1 bei LifeSciBench Gold v1, GeneBench Pro v13 und MedChemBench nicht berücksichtigt, da die Modelle die meisten Fragen abgelehnt haben. Bei HealthBench Professional setzte OpenAI Opus 5 als Ausweichlösung ein, wenn Fable 5.1 eine Frage ablehnte.
Es versteht sich von selbst, dass ein Modell zwar über die zugrunde liegenden Fähigkeiten verfügen kann, aber dennoch schlecht in einen Workflow passt, wenn man nicht zuverlässig darauf zugreifen kann. Anthropic räumt das übergeordnete Problem selbst ein und erklärt, dass „Benchmark-Abstände zu einem weniger verlässlichen Anhaltspunkt für Unterschiede in der Praxis geworden sind. “
Wo Claude Opus 5.5 und GPT-6 Astra besser abschneiden
Die Tabelle von Anthropic vom September 2026 liefert uns fünf direkte Vergleiche zwischen Claude Opus 5.5 und GPT-6 Astra.
| Benchmark | Claude Opus 5.5 | GPT-6 Astra | Höhere Punktzahl |
|---|---|---|---|
| Terminal-Bench 4.0 (agentic coding) | 66,4 % | 57,9 % | Opus 5,5 |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1846 | 1542 | Opus 5,5 |
| Die letzte Prüfung der Menschheit (mit tools) | 67,7 % | 57,2 % | Opus 5,5 |
| AutomationBench (Workflows im Geschäft) | 40,0 % | 41,4 % | GPT-6 Astra |
| Terminal-Bench-Science 0.1 | 58,7 % | 64,6 % | GPT-6 Astra |
Anthropic gibt an, dass Opus 5.5 – sofern nicht anders angegeben – adaptives Denken mit maximaler Auslastung des Aufwands einsetzte.
Stellen Sie sich „Aufwand“ als die Zeit vor, die der KI zur Überprüfung ihrer Arbeit zur Verfügung steht. Anthropic ließ Opus bei fast jedem Test die maximale Denkzeit nutzen. Bei einem Programmiertest, Terminal-Bench 4.0, lief keines der Modelle mit der maximalen Einstellung: Opus lief einen Schritt darunter, und Astras Ergebnis stammt aus OpenAIs eigenem Bericht bei einer niedrigeren Einstellung. Anthropic erklärt, dass dies die Einstellungen waren, bei denen die jeweiligen Modelle die besten Ergebnisse erzielten. Genau wie Menschen kann auch eine KI ein Problem überdenken, sodass mehr Denkzeit nicht immer ein besseres Ergebnis bedeutet.
Insgesamt schneidet Opus 5.5 bei der agentischen Programmierung, bei Wissensarbeit und bei „Humanity’s Last Exam“ mit tools besser ab. Astra erzielt höhere Werte bei Workflows und agentischer wissenschaftlicher Forschung.
Claude (Stärken, beste Anwendungsfälle und Limits)
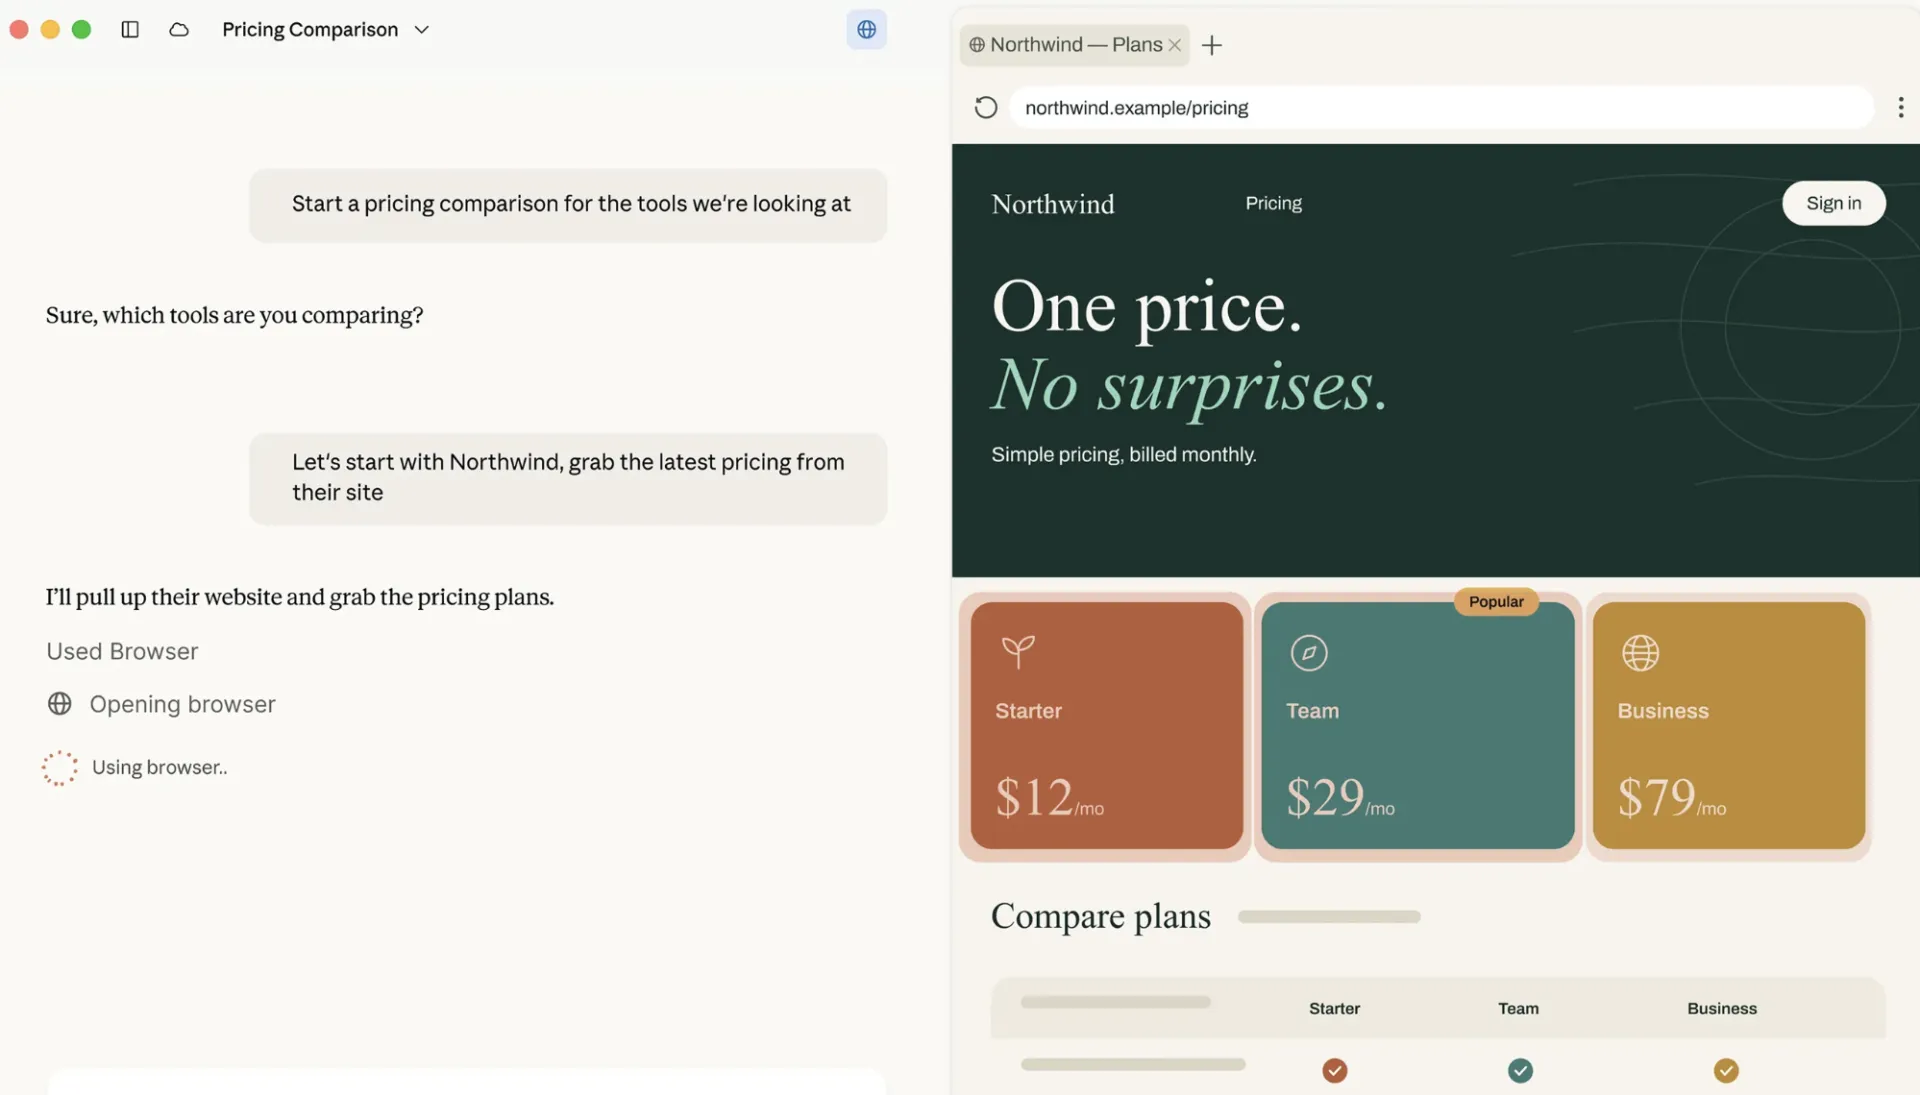
Claude ist die Familie von KI-Modellen von Anthropic. Das aktuelle LineUp umfasst Fable 5.1, Opus 5.5, Sonnet 5 und Haiku 4.5.
Fable 5.1, Opus 5.5 und Sonnet 5 unterstützen jeweils ein Kontextfenster von 1 Million Token, während Haiku 4.5 200.000 Token unterstützt. Anthropic positioniert Fable für anspruchsvolle Schlussfolgerungen und lang andauernde Arbeiten, Opus für Programmierung und Wissensarbeit, Sonnet als ausgewogenes Verhältnis zwischen Geschwindigkeit und Intelligenz und Haiku für schnellere Aufgaben mit hohem Datenvolumen.
Für wen ist Claude gedacht?
Claude eignet sich besonders gut für Menschen, die der KI große, komplexe Aufgaben anvertrauen, anstatt nur einmalige Eingaben zu machen. Dazu gehören Entwickler, die an umfangreichen Codebasen arbeiten, Analysten, die sich durch lange Dokumente wühlen, Forscher, die Beweismaterial zusammenstellen, sowie Autoren oder Editors, die mit detaillierten Vorgaben und Stilrichtlinien arbeiten.
Einfach ausgedrückt: Claude eignet sich am besten für Aufgaben, die viel Kontext, mehrere Schritte oder eine lange Sitzung erfordern. Das gilt für große Dateien, lange Unterhaltungen und Projekte, die auf früheren Arbeiten aufbauen.
Besondere Stärken
- Lang andauernde Programmier- und Agentaufgaben. Opus 5.5 ist für Aufgaben wie codebasisweite Migrationen, Audits und mehrstufige Agentaufgaben konzipiert. Anthropic berichtet, dass ein früher Tester die Prüfung und Korrektur einer Codebasis mit 200.000 Zeilen in weniger als drei Stunden abgeschlossen hat, während Opus 5 dafür mehr als 20 Stunden benötigte. Der unabhängige Gutachter METR äußerte sich zurückhaltender: Er stellte fest, dass Opus 5.5 bei schwierigen Aufgaben mit langem Zeithorizont eine bescheidene Verbesserung gegenüber Fable 5.1 darstellt, und erwartet, dass es einige Bereiche der KI-Forschung und -Entwicklung beschleunigen wird.
- Große, quellmaterialintensive Projekte. Mit Claude Projects können Sie Dokumente, Code und Anleitungen in einem Workspace zusammenfassen. Bei kostenpflichtigen Plänen kann Projects automatisch auf den Abrufmodus umschalten, wenn die Wissensdatenbank wächst, und dabei relevantes Material aus bis zu zehnmal mehr Projekten abrufen.
- Recherche und Dokumentenbearbeitung. Claude kann mit umfangreichen Quelldatensätzen arbeiten und dabei das Originalmaterial griffbereit halten. Fable 5.1 wurde speziell für mehrstufige Recherchen sowie die Bearbeitung von Dokumenten, Tabellen und Präsentationen entwickelt, während Opus 5.5 auf Wissensarbeit in Verbindung mit Code und Agenten ausgerichtet ist.
- Der folgende Text basiert auf einer kurzen Vorgabe. Anthropic hat Opus 5.5 so optimiert, dass wichtige Informationen an erster Stelle stehen, Fachjargon vermieden wird und die Schreibregeln genauer befolgt werden. Das ist nützlich für Arbeiten, bei denen Tonfall, Struktur und Anweisungen mehrere Entwurfsrunden überstehen müssen.
Bewertungen
- G2: 4,6/5 (über 470 Bewertungen)
- Capterra: 4,4/5 (über 50 Bewertungen)
Ein G2-Benutzer sagte:
Von den vielen verfügbaren KI-Chat- und agentenbasierten Programmierwerkzeugen finde ich die Leistung und Genauigkeit von Claude äußerst beeindruckend – insbesondere, wenn es darum geht, komplexe Probleme zu bewältigen, den Kontext zu verstehen und durchweg zuverlässige, qualitativ hochwertige Ergebnisse zu liefern. Claude Code ist zudem äußerst hilfreich bei der Entwicklung von Features, der Durchführung von Tests und der Behebung von Fehlern sowie bei der Automatisierung und Bereitstellung. Insgesamt scheint es anderen Programmierwerkzeugen dieser Art in puncto Genauigkeit, Leistung und der Zeit, die benötigt wird, um zu einem soliden Ergebnis zu gelangen, weit voraus zu sein.
Von den vielen verfügbaren KI-Chat- und agentenbasierten Programmiertools finde ich die Leistung und Genauigkeit von Claude außerordentlich beeindruckend – insbesondere wenn es darum geht, komplexe Probleme zu bewältigen, den Kontext zu verstehen und durchweg zuverlässige, hochwertige Ergebnisse zu liefern. Claude Code ist zudem äußerst hilfreich bei der Entwicklung von Features, der Durchführung von Tests und der Behebung von Fehlern sowie bei der Automatisierung und Bereitstellung. Insgesamt scheint es anderen Programmiertools dieser Art in puncto Genauigkeit, Leistung und der Zeit, die benötigt wird, um zu einem soliden Ergebnis zu gelangen, weit voraus zu sein.
Wo es an seine Grenzen stößt
Claude generiert nach wie vor keine Fotos oder Illustrationen. Es kann hochgeladene Bilder analysieren und mit HTML und SVG Grafiken, Diagramme und interaktive Visualisierungen erstellen, verfügt jedoch nicht über einen nativen Bildgenerator. Wenn Sie möchten, dass dasselbe KI-Tool sowohl Kampagnentexte verfasst als auch die dazugehörigen Grafiken erstellt, benötigen Sie für die Bilder ein weiteres tool.
Die Sicherheitsvorkehrungen können sich auch auf anspruchsvolle Arbeiten in den Bereichen Cybersicherheit und Biowissenschaften auswirken. Opus 5.5 leitet möglicherweise markierte Cybersicherheitsanfragen an Opus 4.8 weiter, während Fable 5.1 bei einigen Cyber- und Biologieanfragen auf Opus-Modelle zurückgreifen kann. Anthropic bietet Programme für die Überprüfung von legitimen Forschungszwecken an, allerdings ist der Zugang zur Cyber-Überprüfung für Opus 5.5 noch in Bearbeitung.
Am besten geeignet für: Lange Sitzungen zum Code-Schreiben und zum Agenten-Schreiben, die Analyse umfangreicher Dokumente, Recherche und das Verfassen von Texten, bei denen Sie dem Modell detaillierte Stil- oder Formatierungsregeln vorgeben.
Überspringen Sie diesen Abschnitt, wenn: Sie native Bildgenerierung benötigen oder Ihre tägliche Arbeit stark von strengen Cybersicherheits- oder Life-Sciences-Aufgaben abhängt.
ChatGPT (Stärken, beste Anwendungsfälle und Limite)
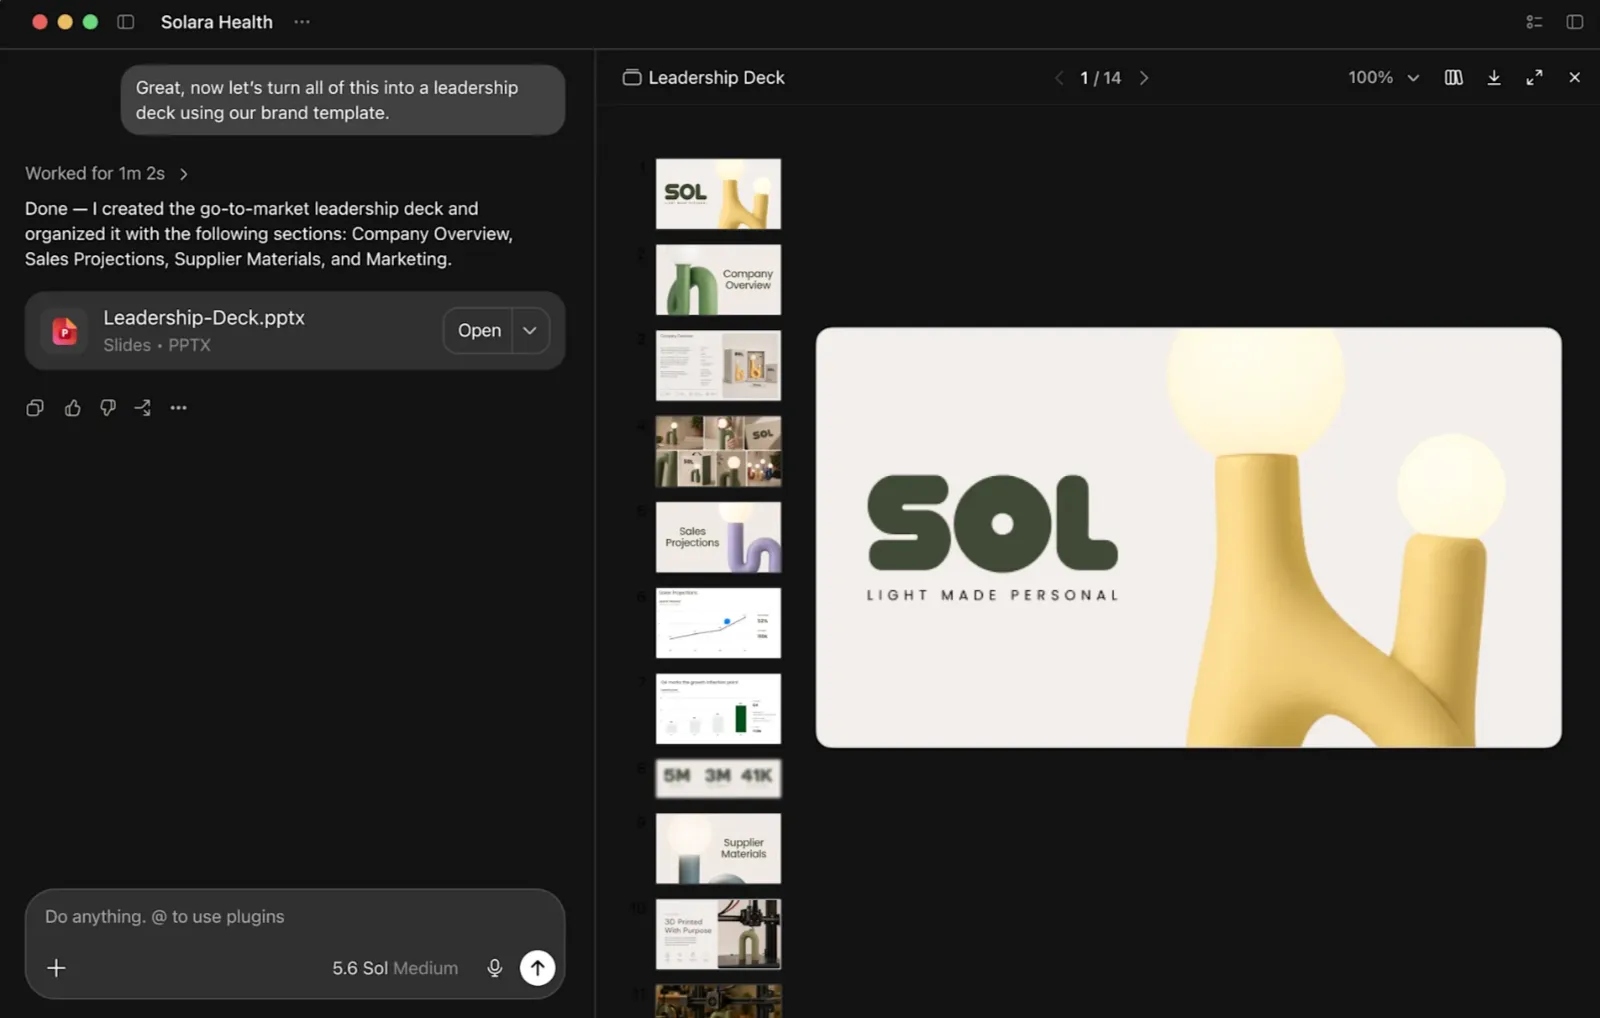
ChatGPT ist der KI-Assistent von OpenAI, der über separate Modelle und Modi für verschiedene Arten von Arbeit verfügt.
GPT-5.6 Sol bildet die Grundlage für das kostenpflichtige Chat-Erlebnis, während ein schlankeres GPT-Modell für Free- und Go-Nutzer zum Einsatz kommt. GPT-6 Pro, das auf GPT-6 Astra basiert, bildet das Spitzenmodell für berechtigte Pro-, Business- und Enterprise-Nutzer. Work und Codex bieten je nach Plan Zugriff auf Modelle wie GPT-6 Astra, Sol und Luna.
Für wen ist ChatGPT gedacht?
ChatGPT richtet sich an Menschen, die einen einzigen Assistenten für verschiedene Arten von Aufgaben nutzen möchten. Ein Marketingmitarbeiter kann neben Texten auch Bilder erstellen, ein Forscher kann mit „Deep Research“ zitierte Berichte erstellen, ein Analyst kann PDF-Dateien und Tabellenkalkulationen bearbeiten und ein Entwickler kann auf „Codex“ umsteigen. Außerdem deckt es alltägliche Aufgaben wie Suche, Planung, Dateianalyse und kurze Fragen ab.
Besondere Stärken
- Zitierte Recherchen aus verschiedenen Quellen. Deep Research greift auf das Internet, hochgeladene Dateien und verbundene Apps zurück und liefert anschließend einen zitierten Bericht. Sie können die Suche auf bestimmte Websites limitieren, den Recherche-Plan bearbeiten und die Suche während der Ausführung umleiten.
- Bildgenerierung und -bearbeitung. Ein spezieller „Images“-Workspace speichert die generierten Bilder an einem Ort, sodass Sie diese bearbeiten, speichern und wiederverwenden können. Laden Sie ein vorhandenes Bild hoch und beschreiben Sie die Änderung in einfacher Sprache, oder nutzen Sie eine Vorlage für Plakate und Logos als Ausgangspunkt.
- Websites und schlanke Apps. Zu den Beispielen von OpenAI für „Sites“ gehören Dashboards, Projekt-Tracker, Startkalender, Prototypen und interne Portale, die alle mit ChatGPT erstellt, in der Vorschau angezeigt und veröffentlicht werden. „Sites“ befindet sich derzeit in der Beta-Phase für die Tarife „Plus“, „Pro“ und berechtigte Workspaces.
- Geplante und vernetzte Aufgaben. Eine neue E-Mail, eine Slack-Nachricht oder ein GitHub-Pull Request können bereits ausreichen, um eine Aufgabe auszulösen. Über diese Auslöser hinaus führt ChatGPT einmalige oder wiederholende Aufgaben aus und arbeitet nahtlos mit Gmail, Slack, GitHub, Google Drive und anderen verbundenen Apps zusammen.
Bewertungen
- G2: 4,6/5 (über 3.000 Bewertungen)
- Capterra: 4,4/5 (über 400 Bewertungen)
Ein G2-Benutzer sagte:
Ich nutze ChatGPT sehr gerne wegen seiner erstaunlichen Fähigkeiten zur Bilderzeugung, die ich für das beste Feature der KI halte. Die Interaktivität ist für mich ein weiterer herausragender Aspekt. Es hilft mir, viele Probleme zu lösen, beispielsweise dabei, dringende Aufgaben zu identifizieren, und unterstützt mich bei der Erstellung von Inhalten, beim Verfassen von Skripten und sogar beim Schreiben von E-Mails. Ich schätze es sehr, wie es mich sowohl im beruflichen als auch im privaten Bereich unterstützt. Außerdem war das Setup sehr einfach: einfach einloggen und die Unterhaltung beginnen.
Ich nutze ChatGPT sehr gerne wegen seiner erstaunlichen Fähigkeiten zur Bilderzeugung, die ich für das beste Feature der KI halte. Die Interaktivität ist für mich ein weiterer herausragender Aspekt. Es hilft mir, viele Probleme zu lösen, beispielsweise zu erkennen, welche Aufgaben dringend sind, und unterstützt mich bei der Erstellung von Inhalten, beim Verfassen von Skripten und sogar bei E-Mails. Ich schätze es sehr, wie es mich sowohl im beruflichen als auch im privaten Bereich unterstützt. Außerdem war das Setup sehr einfach: einfach einloggen und die Unterhaltung beginnen.
Wo es an seine Grenzen stößt
Die Modellpalette von ChatGPT kann verwirrend sein. GPT-6 Pro, das auf Astra basiert, ist im regulären Chat in den Tarifen Pro, Business und Enterprise verfügbar, jedoch nicht in Plus. Plus-Benutzer erhalten Astra über Work und Codex. GPT-6 Sol und Luna sind ebenfalls in Work und Codex statt im regulären Chat zu finden. Welches Modell Sie nutzen können, hängt sowohl von Ihrem Plan als auch von der Plattform ab, mit der Sie arbeiten.
Die zusätzlichen Sicherheitsprüfungen von Astra können manchmal legitime Arbeitsabläufe unterbrechen, darunter auch defensive Cybersicherheitsmaßnahmen. Bei ChatGPT und Codex wird eine als verdächtig markierte Aufgabe möglicherweise zur Überprüfung angehalten, bevor Sie fortfahren können. In der API wird die Aufgabe gestoppt.
Am besten geeignet für: Personen, die einen einzigen KI-Workspace für Recherchen, Dateien, Bilder, Programmierung, Sprachfunktionen, Websites und wiederholende Aufgaben wünschen.
Überspringen Sie diesen Abschnitt, wenn: Ihre Arbeit hauptsächlich aus lang andauernden Programmieraufgaben oder dokumentenintensiven Analysen besteht und Sie eher auf eine tiefgreifende Kontinuität als auf eine breite Palette an tools setzen möchten.
Claude vs. ChatGPT für die Programmierung des Codes
Sowohl Claude Code als auch Codex können Repositorys überprüfen, Dateien bearbeiten, Befehle ausführen, Änderungen testen und mehrstufige technische Aufgaben bewältigen. Der deutlichste Unterschied liegt im Workflow rund um das Modell.
In den von Anthropic veröffentlichten Benchmarks erreicht Opus 5.5 bei Terminal-Bench 4.0 66,4 % gegenüber 57,9 % bei Astra, während FrontierCode mit 54,4 % gegenüber 53,3 % deutlich näher liegt.
Unabhängige Ergebnisse sind weniger einseitig.
Artificial Analysis hat Opus 5.5 bei Terminal-Bench 4.0 mit 59,6 % gemessen, was dem Niveau von Astra entspricht, während Endor Labs feststellte, dass Codex mit Astra bei der Generierung von sicherem Code leicht vor Claude Code mit Opus 5.5 liegt (34,6 % gegenüber 33,5 %).
Claude zum Programmieren des Codes
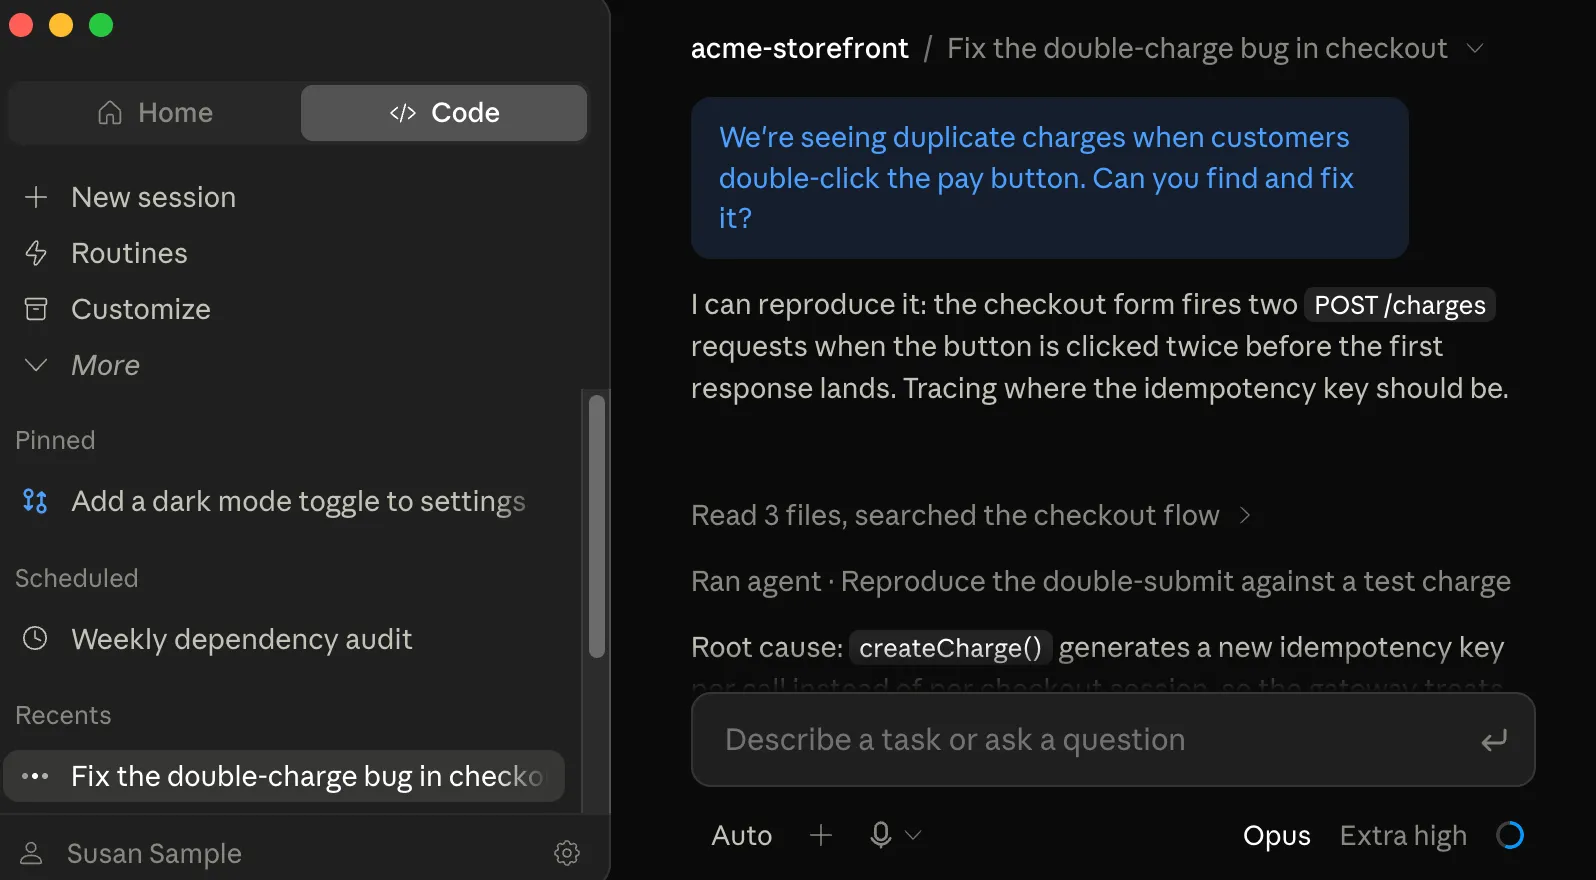
Claude Code basiert auf der Arbeit auf Repository-Ebene. CLAUDE.md sorgt dafür, dass Projektkonventionen über mehrere Sitzungen hinweg verfügbar bleiben, während „Skills“ wiederholbare Workflows und Referenzmaterial speichern. Subagenten können in ihren eigenen Kontexten an separaten Aufgaben arbeiten, und dynamische Workflows können größere Aufgaben wie Audits oder Migrationen auf mehrere Agenten aufteilen.
Hooks geben Entwicklern eine bessere Kontrolle darüber, was rund um diese Agenten geschieht. Sie können nach Änderungen Tests oder Linter ausführen, bestimmte Befehle vor der Ausführung blockieren oder Skripte und andere Tools an definierten Punkten im Workflow als Auslöser verwenden. Claude Code unterstützt außerdem die Integration von Sprachservern für die Symbolnavigation und Live-Typfehler sowie MCP-Verbindungen für externe Tools und Daten.
Checkpoints sind nützlich, wenn bei einer umfangreichen Änderung etwas schiefgeht. Claude Code kann protokollierte Bearbeitungen und den Status der Unterhaltung auf einen früheren Zeitpunkt zurücksetzen, was beim Testen verschiedener Ansätze oder bei der Behebung einer fehlerhaften Änderung hilfreich ist.
Opus 5.5 ist bei den API-Tarifen ebenfalls günstiger als Astra: 4 US-Dollar pro Million Eingabe-Token und 20 US-Dollar pro Million Ausgabe-Token gegenüber 10 US-Dollar bzw. 50 US-Dollar bei Astra. Anthropic gibt an, dass Opus 5.5 die „Terminal-Bench“-Leistung von Astra bei etwa 40 % der Kosten pro Aufgabe erreichen kann, wobei dieser Kostenvergleich auf eigenen Tests von Anthropic basiert.
ChatGPT für die Programmierung des Codes
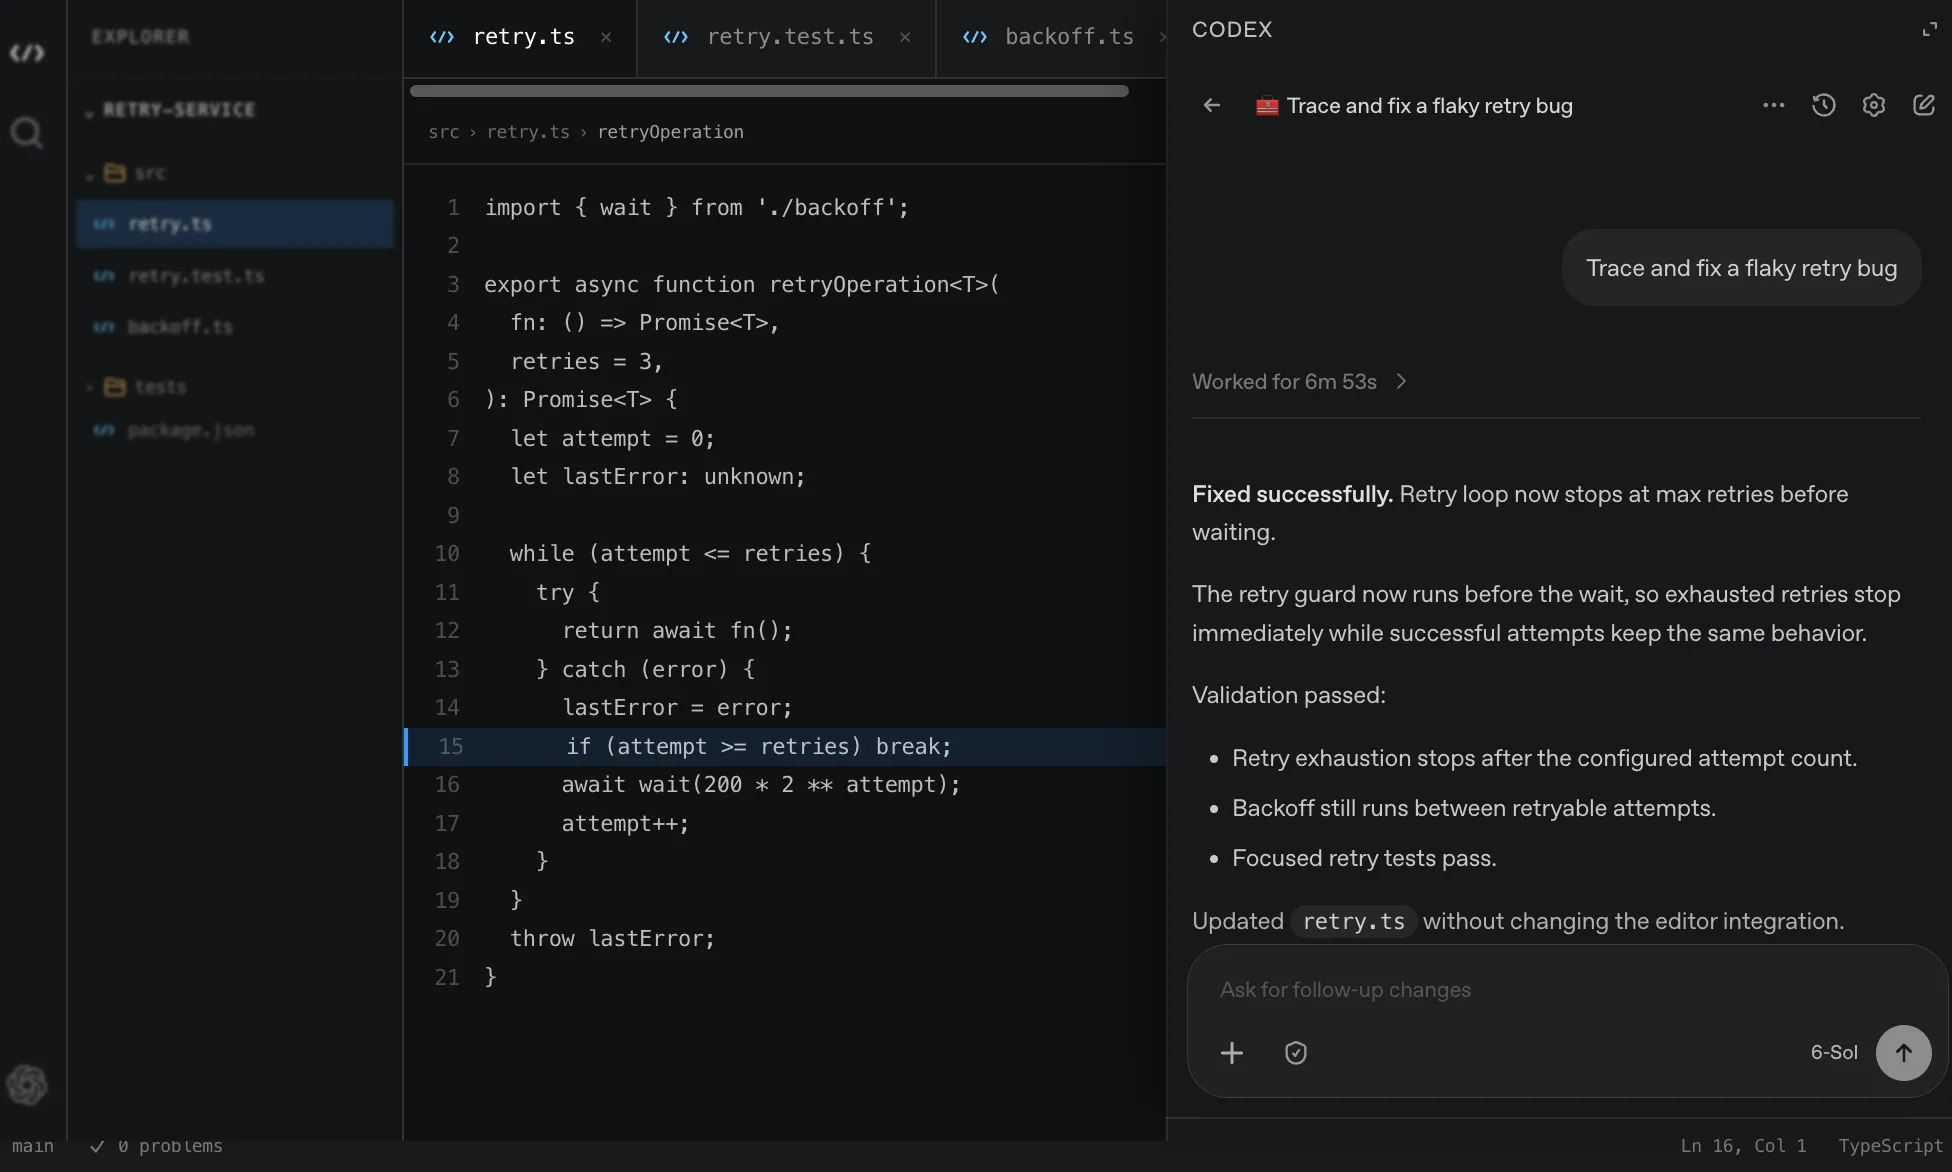
Codex legt mehr Wert auf geräte- und umgebungsübergreifendes Arbeiten. Es ist über die Desktop-App, die Befehlszeilenschnittstelle (CLI), die integrierte Entwicklungsumgebung (IDE) und die Cloud verfügbar, während „Remote“ in der ChatGPT-App für Mobilgeräte es Entwicklern ermöglicht, auf einem anderen Rechner ausgeführte Aufgaben zu starten, zu steuern, zu überprüfen und zu organisieren. „Remote“ unterstützt außerdem Worktrees, Side-Chats, Inline-Reviews, Prompts in der Warteschlange und die Steuerung von Aufgaben.
Ziele sind ein weiterer nützlicher Bestandteil des Workflows. Ein Ziel gibt Codex ein Ergebnis vor, auf das es über mehrere Runden hinweg hinarbeiten soll, mit einer klaren Bedingung für den Abschluss. OpenAI empfiehlt ihre Verwendung für Aufgaben wie die Migration von Abhängigkeiten, Leistungsoptimierung, die Untersuchung unzuverlässiger Tests, mehrstufige Refactorings und die Fehlersuche, bei denen der nächste Schritt davon abhängt, was Codex findet.
Astra verändert zudem die Art und Weise, wie Codex mit sehr langen Sitzungen umgeht. Wenn das Kontextfenster voll ist, kann es Notizen fensterübergreifend speichern, während frühere Nachrichten und Tool-Ergebnisse weiterhin durchsuchbar bleiben. So kann Codex eine alte Anforderung, eine fehlgeschlagene Korrektur oder ein Testergebnis abrufen, ohne sich ausschließlich auf eine komprimierte Zusammenfassung verlassen zu müssen. OpenAI gibt derzeit für dieses Feature die Beschreibung „experimental“ an.
Codex verfügt ebenfalls über eigene Projektanleitungen und wiederverwendbare Skills, und der Agent-Stack von OpenAI unterstützt nun Subagenten und verwaltete Orchestrierung. Damit wird ein Teil der Lücke bei den Tools geschlossen, die die beiden Produkte einst voneinander trennte.
Für welche Lösung sollten Sie sich entscheiden?
Insgesamt hat Claude Code beim Programmieren die Nase vorn, insbesondere bei umfangreichen Refactorings, Migrationen, Audits und anderen Repository-intensiven Arbeiten. Seine Projektregeln, Hooks, Checkpoints, Subagenten und dynamischen Workflows geben Entwicklern eine starke Kontrolle über den Code selbst, während Opus 5.5 bei den API-Tarifen zudem weniger kostet als Astra.
Codex eignet sich besser für Entwickler, denen Mobilität und die Ausführung in der Cloud besonders wichtig sind. Dank seiner Desktop-, CLI-, IDE-, Cloud- und Remote-Workflows können Sie Ihre Arbeit an einem Ort beginnen und an einem anderen Ort fortsetzen oder überprüfen.
Für Debugging-Workflows eignen sich beide gut. Wenn jedoch das Programmieren heute der Hauptgrund für die Wahl zwischen Claude und ChatGPT ist, hat Claude Code insgesamt die besseren Argumente.
Claude vs. ChatGPT zum Schreiben
Sowohl Claude als auch ChatGPT können einen soliden Entwurf erstellen. Der Unterschied zeigt sich erst, wenn das Briefing länger wird, sich das Quellenmaterial häuft und man bereits die fünfte Runde der Bearbeitung in Auftrag gibt.
Sehen Sie unten, wo die jeweiligen Stärken und Schwächen liegen:
Claude zum Schreiben
Claude ist eine gute Wahl für lange Artikel, aufwendige Bearbeitungen oder alles, was einem strengen redaktionellen Leitfaden unterliegt.
Es verarbeitet die Art von Anweisungen, die Editors geben: Diese Struktur beibehalten, diese Begriffe beibehalten, diesen Abschnitt nicht ändern, diesen Stil beibehalten, diese Quellen verwenden und diese Regeln bei einer weiteren Überarbeitung beibehalten.
ChatGPT zum Schreiben
ChatGPT ist sinnvoller, wenn der Entwurf nur ein Teil der Aufgabe ist
Sie können das Thema recherchieren, Begleitdokumente durcharbeiten, den Text entwerfen, ihn für ein anderes Format umgestalten und passende Grafiken erstellen, ohne mehrere Tools miteinander kombinieren zu müssen. Nutzen Sie diese Funktion, wenn aus einer Quelle mehrere Ergebnisse entstehen sollen, beispielsweise ein Bericht, eine E-Mail, eine Präsentation und eine kürzere Zusammenfassung.
Für welches Angebot sollten Sie sich entscheiden?
- Entscheiden Sie sich für Claude, wenn Sie längere Texte verfassen und bearbeiten und dabei mit einem umfangreichen Briefing, viel Quellenmaterial oder mehreren Überarbeitungsrunden arbeiten.
- Entscheiden Sie sich für ChatGPT, wenn Ihre Texte regelmäßig Recherche, Analysen, Bilder, Präsentationen und andere Formate umfassen.
Und wenn Sie als Autor oder Editor zwischen den beiden entscheiden müssen, lassen Sie den allgemeinen Prompt-Test weg. Geben Sie beiden die gleiche chaotische Aufgabe, die Sie auch bei der Arbeit erledigen würden, und schauen Sie dann, welcher Entwurf Ihnen die Arbeit erleichtert.
Lesen Sie auch: Claude-Funktionen zum Schreiben
Preise von Claude und ChatGPT im Jahr 2026
ChatGPT bietet einen günstigeren Einstieg in die kostenpflichtige Nutzung. Der „Go“-Tarif kostet in den USA 8 US-Dollar pro Monat, während der erste kostenpflichtige Plan bei Claude der „Pro“-Tarif für 20 US-Dollar pro Monat ist. Claude bietet den „Pro“-Tarif auch für 200 US-Dollar pro Jahr an, was etwa 17 US-Dollar pro Monat entspricht.
| Plan | Claude | ChatGPT |
|---|---|---|
| Free | Kostenlose Nutzungsstufe verfügbar | Free-Stufe verfügbar |
| Bezahlter Eintrag | Keine | Go, 8 $/Monat in den USA |
| Standard-Einzelabonnement | Pro, 20 $/Monat oder 200 $/Jahr (effektiv 17 $/Monat) | Außerdem: 20 $/Monat |
| Privatnutzer mit hohem Nutzungsaufkommen | Max. 5x, 100 $/Monat; Max. 20x, 200 $/Monat | Pro 5x, 100 $/Monat; Pro 20x, 200 $/Monat |
| Team/Geschäft | Standard: 20 $ pro Platz und Monat bei jährlicher Zahlung oder 25 $ monatlich; Premium: 100 $ jährlich oder 125 $ monatlich | Standard: 20 $ pro Platz und Monat im Jahresabo oder 25 $ monatlich; Premium: 100 $ im Jahresabo oder 125 $ monatlich |
| Teamgröße | 2–150 Benutzer | 2–200 Benutzer |
| Enterprise | 20 $ pro Platz und Monat bei jährlicher Abrechnung + Nutzung zu API-Tarifen | Kontaktieren Sie den Vertrieb |
| Vergleich der API-Modelle | Opus 5.5: 4 $ Input / 20 $ Output; Fable 5.1: 10 $ Input / 50 $ Output pro 1 Mio. Token | GPT-6 Astra: 10 $ für Eingaben / 50 $ für Ausgaben pro 1 Million Token |
| Zwischengespeicherte Eingabe | 0,20 $ pro 1 Mio. Token | 1 US-Dollar pro 1 Million Token |
| Cache schreibt | 5 $ pro 1 Mio. Token | 12,50 $ pro 1 Mio. Token |
Für Benutzer liegt der größte Preisunterschied im unteren Preissegment. Auf Team-Ebene sind die Preise für Standard- und Premium-Plätze identisch.
Die API-Preise variieren je nach Modell. Opus 5.5 kostet 4 US-Dollar pro Million Eingabe-Token und 20 US-Dollar pro Million Ausgabe-Token. GPT-6 Astra kostet 10 US-Dollar pro Million Eingabe-Token und 50 US-Dollar pro Million Ausgabe-Token. Cache-Lesevorgänge kosten bei Opus 5.5 0,20 US-Dollar pro Million Token und bei Astra 1 US-Dollar.
Das bedeutet jedoch nicht, dass Claude über seinen gesamten Bereich der Modellpalette hinweg günstiger ist. Fable 5.1 kostet 10 $ bzw. 50 $ pro Million Eingabe-/Ausgabe-Token, während GPT-6 Sol 2 $ bzw. 10 $ und GPT-6 Luna 0,10 $ bzw. 0,50 $ kostet. Die API-Kosten hängen stark von dem Modell ab, das Sie verwenden.
Wichtig: Die Preise für diese Modelle ändern sich häufig, und die Anbieter passen regelmäßig die Limits der Pläne, die Token-Preise und die Zugriffsstufen an. Behalten Sie die aktuellen Seiten mit den Preisen im Auge, bevor Sie sich für ein Modell für den produktiven Einsatz entscheiden.
Limitierungen von Claude und ChatGPT im Jahr 2026
Nutzungslimits lassen sich schwerer vergleichen als die Preise der Pläne, da keines der beiden Produkte eine einfache Obergrenze hat. Im Folgenden haben wir die Limite entschlüsselt, auf die Sie bei Claude und ChatGPT stoßen werden, darunter Chat, Programmierung, Premium-Modelle und andere Tools.
Limit für die Nutzung bei Claude
Bei Claude wird ein gemeinsames Kontingent für Claude, Claude Desktop und den interaktiven Claude Code genutzt. Wie schnell dieses aufgebraucht ist, hängt von der Länge der Unterhaltung, den Anhängen, der Modellauswahl, den Features und dem Aufwand für die Schlussfolgerungen ab. Die Tarife „Pro“ und „Max“ haben ein Limit für jede Sitzung von fünf Stunden sowie ein wöchentliches Limit; die Nachverfolgung beider Limite erfolgt unter Einstellungen > Nutzung.
Ein Detail ist wichtig, wenn Sie die Top-Modelle von Claude intensiv nutzen. Fable 5 und 5.1 sind nicht im regulären Kontingent der Pro- oder Standard-Team-Plätze enthalten, sodass sie von Anfang an kostenpflichtige Guthaben verbrauchen. Bei Max- und Premium-Team-Plätzen ist Fable zwar enthalten, das Modell kann jedoch bis zu 50 % Ihres wöchentlichen Kontingents verbrauchen.
Anthropic hat die Limits im Jahr 2026 mehrfach angehoben. Im Mai verdoppelte das Unternehmen die Fünf-Stunden-Limits von Claude Code für die Tarife „Pro“, „Max“, „Team“ und den lizenzbasierten „Enterprise“-Plan und erhöhte die Fünf-Stunden-Limits im September mit Opus 5.5 erneut. Benutzer erhalten zudem eine Zurücksetzung des Ratenlimits, die sie aufbewahren können, bis sie sie benötigen.
Limit bei ChatGPT
ChatGPT unterteilt die Limits nach Modell und Feature. Die Tarife „Free“ und „Go“ beinhalten unbegrenzte alltägliche Text-Chats, während für Schlussfolgerungen, Datei-Uploads, Bilder, Sprache und andere Tools separate Limits gelten.
Auch die Modelle der höheren Preisklasse haben ihre eigenen Obergrenzen. Im 100-Dollar-Pro-Plan teilen sich GPT-6 Pro und GPT-5.6 Sol Pro ein wöchentliches Kontingent von 50 Nachrichten.
Arbeit und Codex verwenden wiederum ein anderes System. Die Nutzung hängt vom Modell, der Größe der Aufgabe, dem Aufwand für die Schlussfolgerungen, dem Kontext und den verwendeten tools ab. Lange Programmier- oder Agenten-Aufgaben können mehr von Ihrem Kontingent verbrauchen als kurze.
Wie Claude und ChatGPT mit den Limits umgehen
Beide Produkte ermöglichen es intensiven Benutzern, auch nach Ausschöpfung des inbegriffenen Kontingents weiterzuarbeiten. Claude bietet Guthaben an, die zu den Standard-API-Tarifen abgerechnet werden, während berechtigte ChatGPT Plus- und Pro-Benutzer Guthaben für unterstützte Features wie „Work“ und „Codex“ erwerben können.
Der Hauptunterschied liegt in der Art und Weise, wie die Limits organisiert sind. Claude nutzt einen einheitlicheren Pool für alle seine Hauptprodukte, während ChatGPT die Limits auf Chat, Premium-Modelle, Work, Codex, Voice und andere tools verteilt.
Was Redditoren über Claude und ChatGPT sagen
Aktuelle Reddit-Threads können sich nicht auf ein einziges Tool festlegen. Die Meinungsverschiedenheiten drehen sich hauptsächlich um die Arbeit: Claude wird vor allem dafür gelobt, dass es die Arbeit hinter einer Eingabeaufforderung besser versteht, während ChatGPT für präziseres Schreiben in bestimmten Workflows und ein breiteres Spektrum an Alltagswerkzeugen geschätzt wird.
Redditoren zu Claude
Ein ChatGPT-Benutzer, der für Opus 5.5 zu Claude gewechselt ist – Funny-Strawberry-168 – berichtete:
Ich habe Claude abonniert, weil mein Codex-Abonnement für mich ehrlich gesagt ziemlich unbrauchbar geworden war und ich außerdem Opus einmal ausprobieren wollte. Ich bin wirklich beeindruckt. Es fühlt sich tatsächlich fast wie Zauberei an.
Es bemerkt ständig Dinge im Code, nach denen ich gar nicht gefragt habe, weist auf potenzielle Probleme hin, versteht, wie diese mit meiner aktuellen Arbeit zusammenhängen, und bietet sogar an, sie separat in einem anderen Arbeitszweig zu beheben. Es liest buchstäblich meine Gedanken – es folgt nicht einfach nur der Eingabeaufforderung. Es fühlt sich an, als würde es tatsächlich ein mentales Modell der Codebasis und Alles rund um die Aufgabe erstellen.
Ich probiere Claude seit Sonnet 3.5 immer wieder mal aus, und diese Modelle haben schon immer etwas an sich, das schwer zu beschreiben ist. Das Situationsbewusstsein ist einfach wahnsinnig gut.
GPT-Modelle kamen mir schon immer etwas „lobotomisiert“ und übermäßig promptgesteuert vor.
Ich habe Claude abonniert, weil mein Codex-Abonnement für mich ehrlich gesagt ziemlich unbrauchbar geworden war und ich außerdem Opus einmal ausprobieren wollte. Ich bin wirklich beeindruckt. Es fühlt sich tatsächlich fast magisch an.
Es bemerkt ständig Dinge im Code, nach denen ich gar nicht gefragt habe, weist auf potenzielle Probleme hin, versteht, wie diese mit meiner aktuellen Arbeit zusammenhängen, und bietet sogar an, sie separat in einem anderen Arbeitszweig zu beheben. Es liest buchstäblich meine Gedanken – es folgt nicht nur der Eingabeaufforderung. Es fühlt sich an, als würde es tatsächlich ein mentales Modell der Codebasis und Alles rund um die Aufgabe aufbauen.
Ich probiere Claude seit Sonnet 3.5 immer wieder aus, und diese Modelle haben schon immer etwas an sich, das schwer zu beschreiben ist. Das Situationsbewusstsein ist einfach wahnsinnig gut.
GPT-Modelle kamen mir schon immer eher wie „lobotomisiert“ und übermäßig promptgesteuert vor.
Sie fügten hinzu, dass es den Anschein habe, als würde Claude über die bloße Befolgung der Eingabeanweisung hinaus „ein mentales Modell der Codebasis aufbauen“. Das deckt sich mit einem häufig wiederkehrenden Thema in den Claude-Threads: Benutzer geben dem Wert dafür Rechnung, dass das Modell Abhängigkeiten und damit verbundene Probleme erkennt, ohne dass jeder Schritt ausdrücklich genannt werden muss.
Dieses Lob ist nicht unumstritten, selbst innerhalb von r/ClaudeAI. Ein Reddit-Benutzer, der die neuesten Modelle testete, schrieb:
Ich finde, dass sie sich für unterschiedliche Aufgaben gut eignen. Astra und GPT 5.6 punkten beim Schreiben, was einen großen Teil meines Workflows ausmacht. Sie halten sich besser an die Markenvorgaben und Spezifikationen. Opus 5.5 ist großartig, aber ich kann den Hype darum nicht ganz nachvollziehen. Das könnte daran liegen, dass mein Anwendungsfall nichts mit Code zu tun hat.
Ich finde, sie eignen sich für unterschiedliche Aufgaben. Astra und GPT 5.6 punkten beim Schreiben, was einen großen Teil meines Workflows ausmacht. Sie halten sich besser an die Markenvorgaben und Spezifikationen. Opus 5.5 ist großartig, aber ich kann den Hype darum nicht ganz nachvollziehen. Das könnte daran liegen, dass mein Anwendungsfall nichts mit Code zu tun hat.
Redditoren zu ChatGPT
Das umfangreichere Toolset von ChatGPT wird oft genannt, wenn Benutzer erklären, warum sie es weiterhin nutzen. In einem aktuellen Thread von jemandem, der von Claude gewechselt ist, nannte der Reddit-Benutzer salmanhameed13 die Bildbearbeitung als einfaches Beispiel:
ChatGPT kann das Bild tatsächlich direkt in der Unterhaltung generieren und schrittweise bearbeiten.
Claude kann sich Ihr hochgeladenes Foto ansehen, es analysieren, beschreiben, die perfekte Bildanweisung verfassen usw. – aber es generiert derzeit noch nicht von sich aus das fertige Bild.
Das ist wahrscheinlich die einfachste 60-Sekunden-Demonstration dessen, was ChatGPT zu erledigen im Stande ist und Claude einfach nicht.
ChatGPT kann das Bild tatsächlich direkt im Verlauf der Unterhaltung generieren und schrittweise bearbeiten.
Claude kann sich Ihr hochgeladenes Foto ansehen, es analysieren, beschreiben, die perfekte Bildanweisung verfassen usw. – aber es generiert derzeit noch nicht von sich aus das fertige Bild.
Das ist wahrscheinlich die einfachste 60-Sekunden-Demonstration dessen, was ChatGPT zu erledigen im Stande ist und Claude einfach nicht.
Claude kann dasselbe Bild analysieren und beim Verfassen einer Eingabeaufforderung helfen, ist jedoch nach wie vor nicht in der Lage, das fertige Bild nativ zu generieren. Für Benutzer, deren Arbeitsalltag zwischen Text- und Bildarbeit wechselt, ist diese Lücke wichtiger als ein kleiner Vorsprung bei den Benchmark-Ergebnissen.
Und manche Benutzer betrachten diese Entscheidung gar nicht als endgültig. In einem viel diskutierten Vergleichsthread beschrieb Spontanous_cat ihren Workflow folgendermaßen:
Meine unschlagbare Kombination besteht darin, Claude für die Arbeit zu verwenden und ChatGPT zur Kritik heranzuziehen. Anschließend lässt man Claude die Korrekturen vornehmen. Claude kann zwar manchmal ein Ja-Sager sein, aber seine Arbeit ist gut genug. ChatGPT ist dafür der perfekte Kritiker.
Meine unschlagbare Kombination besteht darin, Claude für die Arbeit zu nutzen und ChatGPT zur Kritik daran. Anschließend lässt man Claude die Korrekturen vornehmen. Claude kann zwar manchmal ein Ja-Sager sein, aber seine Arbeit ist gut genug. ChatGPT ist dafür der perfekte Kritiker.
Andere Kommentatoren im selben Thread beschrieben ähnliche Unterscheidungen zwischen Claude Code und Codex, wobei das eine zur Implementierung und das andere zum Debuggen oder zur Überprüfung verwendet wird.
Fazit der Redaktion: Auf Reddit lässt sich kein eindeutiger Konsens zugunsten von Claude oder ChatGPT erkennen. Claude-Benutzer heben immer wieder den Kontext, die Befolgbarkeit von Anweisungen und die Fähigkeit zu tiefergehender Arbeit hervor. ChatGPT-Benutzer verweisen auf Bilder, Recherche, multimodale Tools und Fälle, in denen die aktuellen Modelle strengere Vorgaben einhalten. Und unter intensiven Benutzern ist der parallele Einsatz beider Dienste so verbreitet, dass er bereits einen eigenständigen Workflow darstellt.
Betrachten Sie dies jedoch als Benutzermeinung. Die Modelle und ihre Limite ändern sich zu schnell, als dass ein Reddit-Thread als dauerhafter Maßstab dienen könnte.
So entscheiden Sie sich zwischen Claude und ChatGPT
An dieser Stelle geht es weniger darum, welches Modell bei mehr Benchmarks besser abschneidet, sondern vielmehr darum, welche Art von Arbeit den größten Teil Ihres Tages in Anspruch nimmt.
| Ihre Priorität | Bessere Eignung | Warum |
|---|---|---|
| Lange Programmier-Sitzungen, Refactorings, Migrationen oder repository-intensive Arbeiten | Claude | Claude Code bietet Ihnen umfassende Kontrolle über lang andauernde technische Arbeiten – mit Projekt-Regeln, Hooks, Checkpoints, Subagenten und dynamischen Workflows. |
| Recherchen, Dateien, Bilder, Code, Sprache und andere Arbeiten an einem Ort | ChatGPT | ChatGPT deckt in einem einzigen Workspace ein breiteres Spektrum an Arbeiten ab, darunter Recherche, Dateianalyse, Bilderzeugung, Code-Programmierung und integrierte Tools |
| Lange Dokumente, aufwendige Bearbeitungen oder detaillierte Schreibvorgaben | Claude | Claude neigt dazu, Quellmaterial, redaktionelle Vorgaben und Überarbeitungsanweisungen auch über längere Sitzungen hinweg gut beizubehalten |
| Strukturierte Texte, die sich auch in Präsentationen, Bilder, Analysen oder andere Formate umwandeln lassen | ChatGPT | Mit ChatGPT ist es einfacher, Entwürfe in andere Formate zu übertragen, ohne die Tools wechseln zu müssen |
| Ausführung in der Cloud, mobiler Zugriff und der Wechsel zwischen Desktop, CLI, IDE und Remote-Programmier-Workflows | ChatGPT | Codex ist darauf ausgelegt, geräte- und umgebungsübergreifend zu funktionieren |
| Kostengünstigster kostenpflichtiger Eintrag | ChatGPT Go | ChatGPT Go kostet in den USA ab 8 US-Dollar pro Monat, während Claude Pro ab 20 US-Dollar pro Monat kostet – bei jährlicher Abrechnung sind es etwa 17 US-Dollar pro Monat. |
| Regelmäßige Nutzung von Claude für Deep Work und von ChatGPT wegen seines breiteren Funktionsumfangs | Beide | Beide zu behalten, kann sinnvoll sein, wenn die Unterschiede in Ihrem tatsächlichen Workflow häufig genug auftreten, um zwei Abonnements zu rechtfertigen. |
Wenn Sie sich immer noch unsicher sind, testen Sie zunächst Ihre tatsächliche Arbeit. Lassen Sie dieselben Dokumente, Aufgaben mit Code, Forschungsfragen und alltäglichen Eingabeaufforderungen einige Tage lang in beiden kostenlosen Tarifen durchlaufen. Die Unterschiede bei den Benchmark-Ergebnissen hängen zu sehr von den Einstellungen und Bedingungen ab, um eine Entscheidung für Sie zu treffen.
Wenn ein Tool fast alle Aufgaben bewältigt, die Sie regelmäßig zu erledigen haben, gibt es kaum einen Grund, für das zweite zu bezahlen. Argumente dafür, beide beizubehalten, werden erst dann stärker, wenn sich ihre Unterschiede wiederholt in Ihrem tatsächlichen Workflow zeigen.
Weiterlesen: Anwendungsfälle für ChatGPT
So wechseln Sie von ChatGPT zu Claude
Der Setup-Aufwand ist geringer als zuvor. Claude verfügt nun über eine integrierte Funktion, um Speicher von einem anderen KI-Assistenten zu übernehmen.
- Testen Sie Claude, bevor Sie ChatGPT kündigen. Probieren Sie es zunächst mit Ihrer üblichen Arbeit aus, insbesondere mit den Aufgaben, die wichtig genug sind, um ein kostenpflichtiges Abonnement zu rechtfertigen.
- Übertragen Sie den Kontext, den sich Claude merken soll. Gehen Sie zu Claude > Einstellungen > Speicher > Import starten. Fügen Sie den aus Ihrem aktuellen KI-Assistenten exportierten Speicher ein, und Claude extrahiert relevante Details in Einträge, die Sie überprüfen können. Dadurch werden Erinnerungen und Einstellungen übertragen, jedoch nicht Ihre vollständige Unterhaltungshistorie.
- Exportieren Sie Ihre ChatGPT-Daten, um ein Archiv zu erstellen. Gehen Sie bei berechtigten Privatkunden-Tarifen zu Einstellungen > Datensteuerung > Daten exportieren. Die heruntergeladene ZIP-Datei enthält Ihren Chat-Verlauf und andere Daten des Kontos. Selbstbedienungsexporte sind für Business-, Unternehmen- oder Healthcare-Workspaces nicht verfügbar.
- Verlagern Sie aktive Arbeit in Claude-Projekte. Laden Sie die Dokumente, Dateien oder den Code hoch, die Sie noch verwenden, und erstellen Sie wichtige Regeln als Projektanweisungen neu. Claude bietet außerdem Profilanweisungen für kontoweite Einstellungen sowie „Skills“ für wiederverwendbare Verhaltensweisen und Workflows.
- Achten Sie in der ersten Woche mit hohem Nutzeraufkommen auf Ihre Limits. Bei Claude wird die Nutzung unter Einstellungen > Nutzung angezeigt. Bezahlte Benutzer können außerdem Guthaben aktivieren und weiterarbeiten, nachdem ihr inbegriffenes Kontingent aufgebraucht ist; die zusätzliche Nutzung wird zu den Standard-API-Tarifen abgerechnet.
- Kündigen Sie erst, wenn Claude bewiesen hat, dass es echte Arbeit leisten kann. Unser Leitfaden zur Kündigung eines ChatGPT-Abonnements behandelt die Abrechnungsschritte. Ein kostenloses ChatGPT-Konto kann für die einfache native Bildgenerierung weiterhin sinnvoll sein. Claude kann hochgeladene Bilder analysieren und Diagramme, Grafiken sowie interaktive Visualisierungen erstellen, generiert jedoch nach wie vor keine Fotos oder Illustrationen.
Notiz: Wenn Sie noch einen allgemeineren Vergleich anstellen möchten: Der Vergleich zwischen Perplexity und ChatGPT befasst sich mit der Alternative, bei der die Suche im Vordergrund steht, während unser Leitfaden zu KI-Suchmaschinen die breitere Kategorie beleuchtet.
Wie ClickUp bei der Entscheidung zwischen Claude und ChatGPT ins Spiel kommt
Claude und ChatGPT leisten in ihren jeweiligen Bereichen gute Arbeit. Claude kann komplexe Zusammenhänge in langen Dokumenten und Codebasen erfassen. ChatGPT kann recherchieren, Bilder generieren, Websites erstellen, Code schreiben und eine Vielzahl von tools bedienen.
Doch die Ergebnisse, die man mit diesen tools erhält, bleiben oft ungenutzt, da es keinen Ort gibt, an dem man sie speichern oder – schlimmer noch – darauf reagieren kann.
Nehmen wir eine einfache Frage wie: „Was ist aus dem Phoenix-Projekt geworden?“ Eine hilfreiche Antwort hängt von den aktuellen Aufgaben, Eigentümern, Kommentaren, Entscheidungen, Abhängigkeiten, Fristen und Änderungen ab. Claude und ChatGPT können über verbundene Tools auf einen Teil dieser Informationen zugreifen, aber das Projekt benötigt dennoch ein System, um diesen Kontext auf dem neuesten Stand zu halten.
In diesem Fall sollten Sie eine Plattform wie ClickUp in Betracht ziehen, die alle Ihre Arbeitsprojekte an einem Ort bündelt und zusätzlich kontextbezogene KI bietet.
Brain²: KI, die auf Ihrer Arbeit basiert
Brain² ist die kontextbezogene KI von ClickUp für die Arbeit. Sie kann Projekte zusammenfassen, Inhalte entwerfen, Themen recherchieren, Daten analysieren sowie Aufgaben und Dokumente erstellen. Darüber hinaus erstellt sie nun auch interaktive Prototypen, Dashboards, Präsentationen, Bilder, Videos und andere Inhalte.
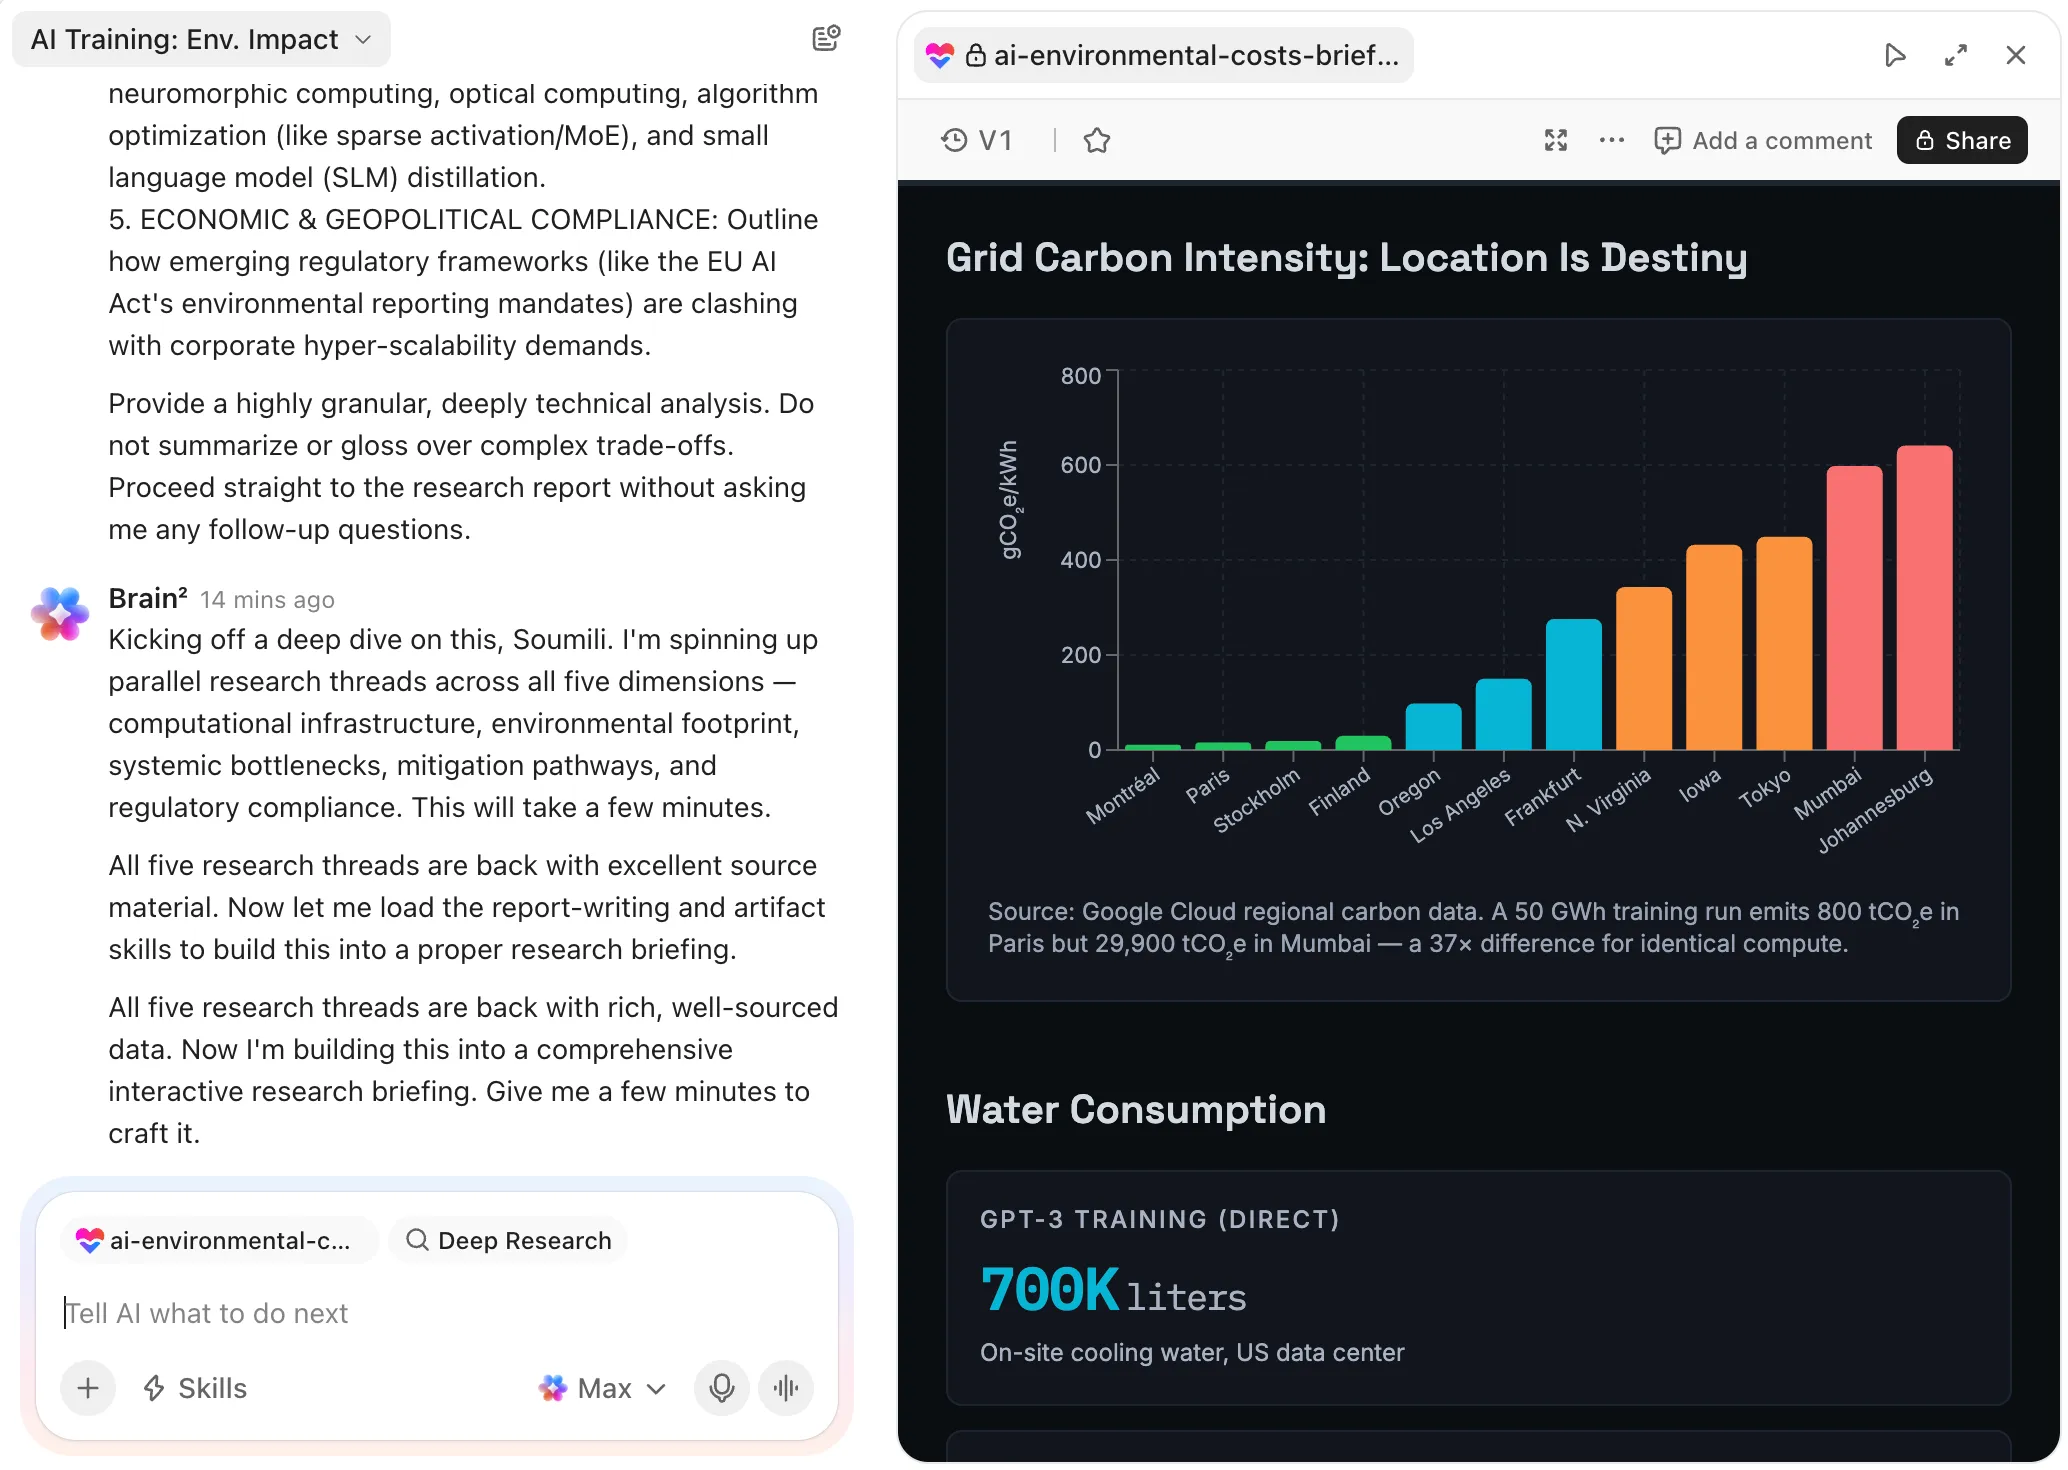
Was den Unterschied ausmacht, ist der Kontext hinter diesen Ausgaben. Brain² kann auf der Grundlage der Aufgaben, Dokumente, Chats, Entscheidungen, Eigentümer, Hindernisse und Aktualisierungen arbeiten, die sich bereits in Ihrem Workspace befinden, sodass Sie diesen Kontext nicht bei jeder Eingabe neu aufbauen müssen. Wenn die Antwort an anderer Stelle zu finden ist, kann die ClickUp Enterprise Search verbundene Tools wie Google Drive, Figma, GitHub und Gmail durchsuchen.
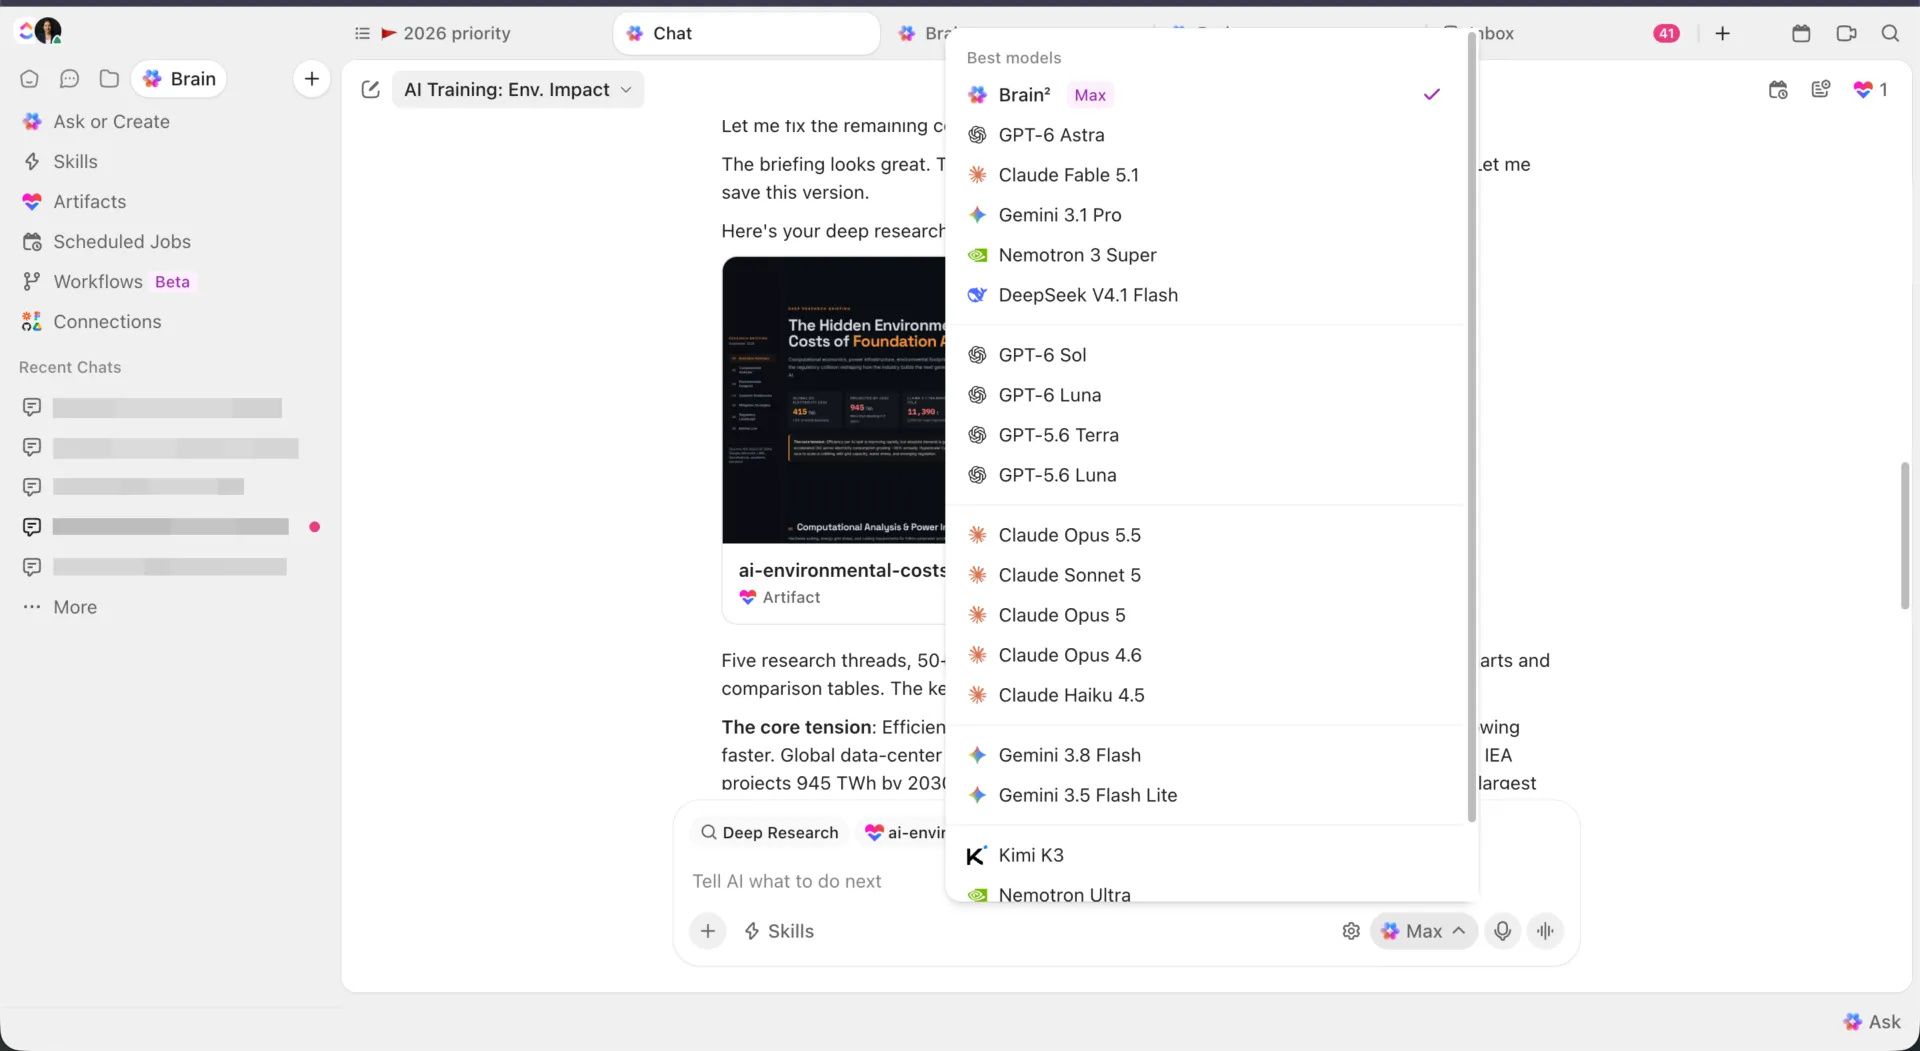
Brain² bietet Teams zudem an einem Ort Zugriff auf die neuesten Modelle von OpenAI, Anthropic, Google und anderen Anbietern. Sie können zwischen Claude, GPT-Modellen, Gemini und anderen Modellen wechseln, ohne den Arbeitskontext zu verlieren – und das, ohne separate Abonnements abschließen zu müssen, nur um zwischen den Modellfamilien zu wechseln.
ClickUp Super Agents: Kontext in laufende Arbeiten umwandeln
ClickUp Super Agents gehen noch einen Schritt weiter. Diese KI-Teamkollegen können mehrstufige Workflows unter Verwendung der Tools und Daten ausführen, auf die Sie ihnen Zugriff gewähren – mit Auslösern, Speicher und menschlicher Freigabe für kritische Aktionen.
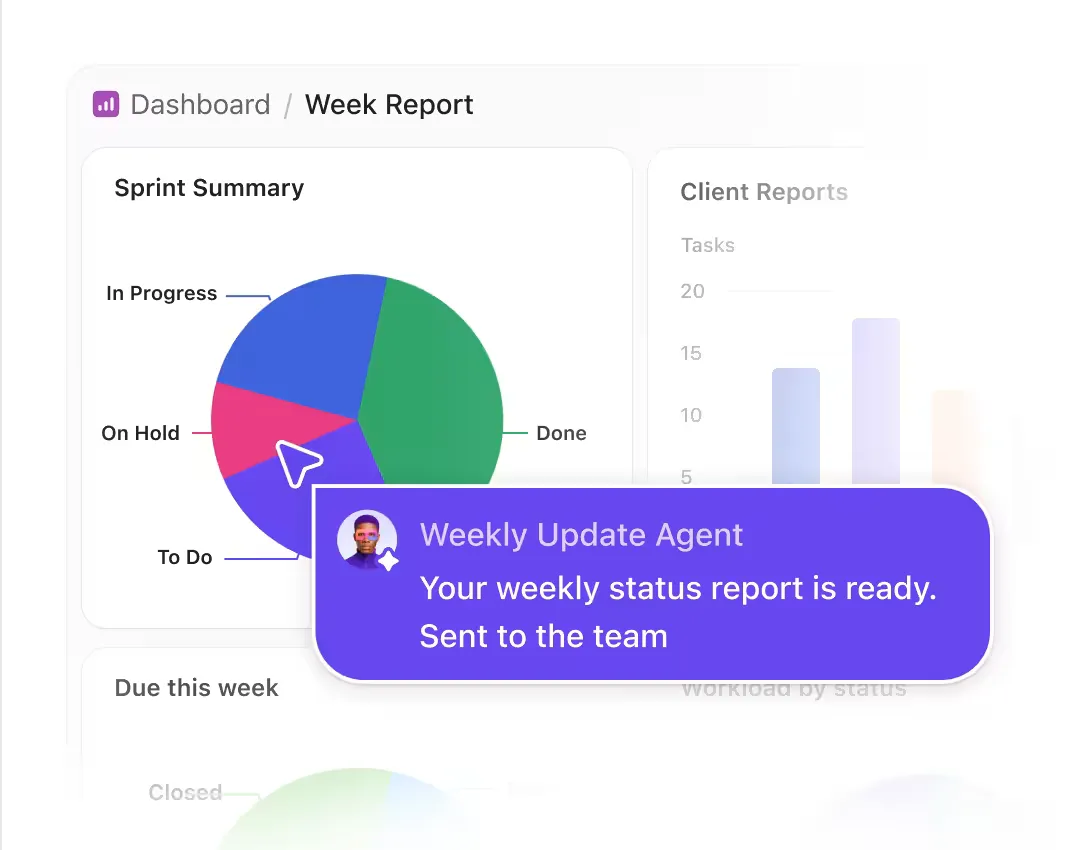
Ein Projekt-Agent könnte beispielsweise ein Problem recherchieren, in Verzug geratene Arbeiten kennzeichnen, Aufgaben aktualisieren oder die richtigen Personen benachrichtigen, ohne dass jemand bei jedem Schritt den Kontext neu aufbauen muss. Noch besser: Teams können ihre eigenen Agenten mithilfe eines Natural-Language-Builders erstellen oder auf einer vorgefertigten Agenten-Vorlage aufbauen.
Codegen von ClickUp: Bringen Sie den technischen Kontext in die Implementierung ein
Für Software-Teams verbindet „Codegen by ClickUp “ die technische Aufgabe mit dem daraus resultierenden Code.
Weisen Sie dem Codegen-Agenten eine Aufgabe zu, und er kann anhand der Aufgabenbeschreibung, der verknüpften Dokumente, der Abnahmekriterien, der Abhängigkeiten und der bereits an die Arbeit angehängten Diskussionen arbeiten. Teams können den Agenten auch per @mention für nachträgliche Änderungen ansprechen oder ihn als Auslöser verwenden, wenn eine Aufgabe einen bestimmten Status erreicht. Codegen erledigt all das, während ein Mensch die Überprüfung übernimmt und den resultierenden Code zusammenführt.
Anleitung: Wenn Sie von einem eigenständigen KI-Assistenten zu einer auf Ihr Team zugeschnittenen Arbeits-KI wechseln, ist die größte Veränderung die Kontinuität. Die KI kann auf der Grundlage gemeinsamer Projekte, Entscheidungen und Eigentümer arbeiten und dann dabei helfen, diesen Kontext in die nächste Aufgabe, den nächsten Auftrag oder den nächsten Workflow umzusetzen, während das Team wächst.
Am besten geeignet für: Teams, die bereits Projekte, Dokumente, Entscheidungen und die Zusammenarbeit in ClickUp verwalten und möchten, dass die KI Fragen beantwortet, Aufgaben erstellt und auf diesen gemeinsamen Unternehmenskontext reagiert, ohne ihn bei jeder Eingabe neu aufbauen zu müssen.
Überspringen Sie diesen Abschnitt, wenn: Sie hauptsächlich einen persönlichen KI-Assistenten für eigenständiges Schreiben, Recherchieren, Programmieren oder die Bildgenerierung benötigen und kein gemeinsames System zur Verwaltung der damit verbundenen Arbeitsabläufe benötigen.
Sie müssen sich nicht für Alles auf eine einzige KI verlassen
Für die meisten Menschen hängt die Wahl zwischen Claude und ChatGPT von der Form ihrer Arbeit ab.
Claude schneidet bei langen, kontextintensiven Aufgaben wie großen Codebasen, umfangreichen Dokumenten und Briefings, die mehrere Überarbeitungsrunden durchlaufen müssen, besser ab. ChatGPT deckt an einer Stelle ein breiteres Spektrum ab – von Recherche und Bildern bis hin zu Sprachausgabe und geplanten Aufgaben – und ist in der Einstiegsphase kostengünstiger.
Keiner der beiden Vorsprünge ist von Dauer. Beide Unternehmen bringen alle paar Monate neue Modelle auf den Markt, und eine Lücke, die heute noch ausschlaggebend für Ihre Entscheidung ist, kann sich bis zur nächsten Veröffentlichung bereits wieder schließen. Wenn Sie Ihre eigenen Arbeiten mit den tools testen, erfahren Sie mehr als aus jeder Benchmark-Tabelle – auch aus den in diesem Artikel aufgeführten.
Falls Ihr Team letztendlich beide nutzt, besteht die größere Herausforderung darin, die damit verbundene Arbeit zu organisieren: die Aufgaben, Entscheidungen und Dateien, in die die einzelnen Antworten einfließen. ClickUp bietet Ihnen einen zentralen Ort für diese Arbeit, an dem die Modelle Claude, GPT und Gemini zur Verfügung stehen.
Häufig gestellte Fragen zu Claude vs. ChatGPT
Kann ich meine Claude- oder ChatGPT-Unterhaltungen vom Modelltraining ausschließen?
Ja, bei privaten Konten haben Sie bei beiden Diensten die Kontrolle darüber. Deaktivieren Sie in ChatGPT unter „Einstellungen“ > „Datenschutz-Einstellungen“ die Option „Modell für alle verbessern“. Neue Unterhaltungen werden dann nicht mehr zum Trainieren der OpenAI-Modelle verwendet, können aber weiterhin in Ihrem Verlauf verbleiben. Wenn Sie Feedback zu einer Antwort geben, kann die entsprechende Unterhaltung dennoch für das Training verwendet werden. Claude verfügt über eine ähnliche Einstellung zur Modellverbesserung in seinen Einstellungen zum Datenschutz. Durch das Deaktivieren dieser Funktion wird verhindert, dass neue Chats und Programmier-Sitzungen in zukünftigen Modelltrainingsläufen verwendet werden. Anthropic weist auf Ausnahmen hin, beispielsweise bei Unterhaltungen, die zur Sicherheitsüberprüfung markiert wurden, oder bei Daten, die Sie ausdrücklich freigeben. Bei Unternehmenskonten unterscheiden sich die Standards. OpenAI trainiert standardmäßig keine Daten aus ChatGPT Business, Enterprise, Edu, Healthcare oder der API, und Anthropic gibt dasselbe für Claude for Work und dessen API an.
Behalten Claude und ChatGPT Informationen zwischen den Unterhaltungen im Gedächtnis?
Ja, obwohl sich keiner der beiden an jedes Detail erinnert, das Sie jemals freigegeben haben. ChatGPT Memory kann auf vergangene Chats, gespeicherte Informationen, Dateien und verbundene Apps zurückgreifen, sofern diese Features verfügbar und aktiviert sind. Was dabei herangezogen werden kann, hängt vom Tarif, der Region und den Workspace-Einstellungen ab. Auch Claude kann aus früheren Chats ein Gedächtnis aufbauen. Memory ist derzeit standardmäßig für Free-, Pro- und Max-Konten aktiviert, während Team- und Enterprise-Eigentümer selbst entscheiden können, ob es in ihren Workspaces verfügbar ist. Claude unterhält zudem separate Speicherbereiche für einzelne Projekte.
Kann ich Claude oder ChatGPT nutzen, ohne die Unterhaltung im Speicher abzulegen?
Ja. Der „Temporary Chat“ von ChatGPT erscheint nicht im Chatverlauf, erstellt oder aktualisiert keine Erinnerungen und trainiert keine Modelle von OpenAI. OpenAI behält aus Sicherheitsgründen möglicherweise bis zu 30 Tage lang eine Kopie. Claude verfügt über „Incognito-Chats“, die weder Ihrem Chatverlauf noch dem Speicher von Claude hinzugefügt werden. Beachten Sie, dass „Incognito-Chats“ in den Team- und Enterprise-Tarifen dennoch in den Datenexporten der Organisation erscheinen können und den Aufbewahrungsrichtlinien der Organisation unterliegen.
Kann ich bei beiden Assistenten Sprachsteuerung, Kamerafreigabe oder Bildschirmfreigabe nutzen?
Beide bieten Unterhaltungen mit Sprache an. Claude Voice ist in den Tarifen Free, Pro, Max, Team und Enterprise auf Mobilgeräten, am Desktop und im Web verfügbar. Es kann während der Unterhaltung auch die Websuche und verbundene Tools wie Gmail, Google Kalender, Google Docs und Slack nutzen. ChatGPT verfügt derzeit über mehrere Sprachmodi. Live unterstützt natürliche Unterhaltungen, jedoch keine Video- oder Bildschirmfreigabe. Berechtigte Abonnenten können auf iOS oder Android zu Advanced wechseln, wenn sie Live-Video oder Bildschirmfreigabe benötigen. Wenn die Kamera- oder Bildschirmfreigabe für Ihren Workflow wichtig ist, prüfen Sie vor der Auswahl, welchen ChatGPT-Sprachmodus Ihr Plan und Ihr Gerät unterstützen.
Entspricht das angegebene Kontextfenster der Menge an Text, die ich hochladen kann?
Nein. Ein Kontextfenster ist die Gesamtmenge an Informationen, mit der das Modell gleichzeitig arbeiten kann. Je nach Modell kann dieses Kontingent Ihre Eingabeaufforderung, den Verlauf der Unterhaltung, Tool-Ergebnisse, Argumentationstoken und die Antwort des Modells umfassen. Es ist nicht dasselbe wie ein Limit für Datei-Uploads. Der Wert kann sich zudem je nach Einsatzort des Modells ändern. Claude veröffentlicht beispielsweise unterschiedliche Angaben zum Kontextfenster für Chat, Claude Code und Cowork. OpenAI unterscheidet in einigen ChatGPT-Modi ebenfalls zwischen Gesamtkontext und nutzbarer Eingabe. So beschreibt das Unternehmen beispielsweise ein Gesamtfenster von 256K für manuell ausgewähltes „Thinking“ als 128K Eingabe plus bis zu 128K Ausgabe.
Es hängt von der jeweiligen Arbeit ab. Claude ist die bessere Wahl für lange Programmier-Sessions, umfangreiche Dokumente und das Verfassen von Texten, die einem detaillierten Briefing folgen und mehrere Überarbeitungsrunden durchlaufen. ChatGPT ist die bessere Wahl, wenn Sie einen einzigen Assistenten für Recherche, Dateianalyse, Bildgenerierung, Sprachausgabe und Code-Programmierung suchen; zudem bietet es mit 8 US-Dollar pro Monat für Go in den USA den günstigeren Einstiegspreis. Benchmark-Ergebnisse geben keine endgültige Antwort, da Anthropic und OpenAI die Modelle des jeweils anderen unter unterschiedlichen Einstellungen testen. Führen Sie dieselben realen Aufgaben einige Tage lang in beiden kostenlosen Tarifen aus und entscheiden Sie sich für den Anbieter, der Ihnen mehr Zeit spart.