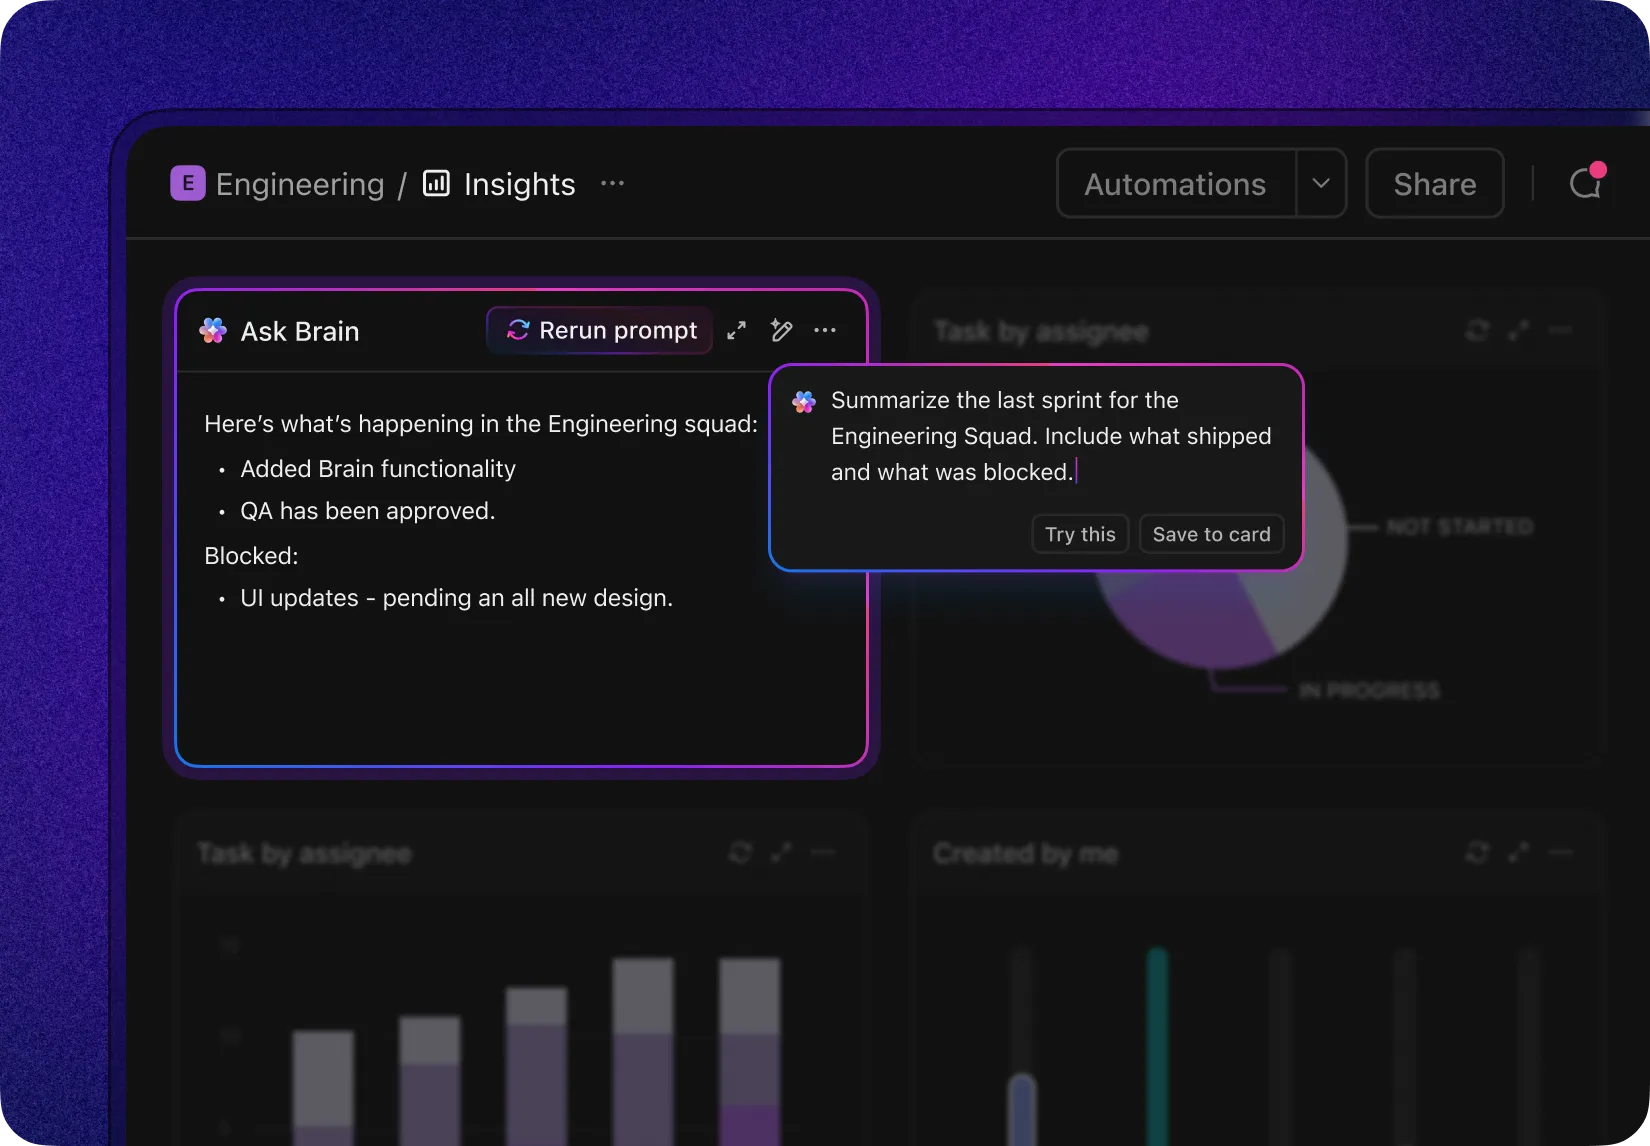
Vydáte nejnovější aktualizaci softwaru a začnou se hromadit hlášení.
Najednou vše, od CSAT/NPS až po zpoždění v plnění plánu, určuje jediná metrika: doba řešení chyb.
Vedení to vnímá jako ukazatel plnění slibů – dokážeme dodávat, učit se a chránit tržby podle plánu? Praktici pociťují potíže v každodenní praxi – duplicitní tikety, nejasné rozdělení odpovědnosti, rušivé eskalace a informace roztříštěné napříč aplikacemi jako Slack, tabulkami a samostatnými nástroji.
Tato roztříštěnost prodlužuje cykly, zakrývá skutečné příčiny problémů a mění stanovování priorit v hádání.
Výsledek? Pomalejší učení, nesplněné závazky a nevyřízené úkoly, které tiše zatěžují každý sprint.
Tato příručka je vaším komplexním návodem pro měření, srovnávání a zkracování doby řešení chyb a konkrétně ukazuje, jak umělá inteligence mění pracovní postupy ve srovnání s tradičními, manuálními procesy.
Co je doba řešení chyb?
Doba řešení chyby je čas, který je zapotřebí k opravě chyby, měřený od okamžiku nahlášení chyby až do jejího úplného vyřešení.
V praxi se čas začíná počítat v okamžiku, kdy je chyba nahlášena nebo detekována (uživateli, týmem QA nebo monitorovacím systémem), a končí v okamžiku, kdy je oprava implementována a začleněna do kódu a je připravena k ověření nebo vydání – v závislosti na tom, jak váš tým definuje pojem „hotovo“.
Příklad: selhání s prioritou P1 nahlášené v pondělí v 10:00, jehož oprava byla začleněna v úterý v 15:00, má dobu vyřešení přibližně 29 hodin.
Není to totéž jako doba detekce chyb. Doba detekce měří, jak rychle rozpoznáte vadu poté, co nastane (spuštění alarmů, zjištění pomocí nástrojů pro testování kvality, nahlášení zákazníky).
Doba řešení měří, jak rychle se dostanete od zjištění problému k jeho nápravě – třídění, reprodukce, diagnostika, implementace, kontrola, testování a příprava k vydání. Detekci si představte jako „víme, že to nefunguje“ a řešení jako „je to opravené a připravené“.
Týmy používají mírně odlišná kritéria; vyberte si jedno a držte se ho, aby vaše trendy byly reálné:
- Nahlášeno → Vyřešeno: Končí v okamžiku, kdy je oprava kódu začleněna a připravena k testování QA. Vhodné pro měření výkonnosti vývojového týmu
- Nahlášeno → Uzavřeno: Zahrnuje validaci QA a vydání. Ideální pro SLA s dopadem na zákazníky
- Zjištěno → Vyřešeno: Proces začíná v okamžiku, kdy monitorování nebo oddělení kontroly kvality (QA) zjistí problém, a to ještě předtím, než je vytvořen ticket. Vhodné pro týmy s intenzivním provozem.
🧠 Zajímavost: Podivná, ale zároveň velmi vtipná chyba ve hře Final Fantasy XIV sklidila chválu za to, že byla tak specifická, že ji čtenáři označili za „Nejkonkrétnější opravu chyby v MMO roku 2025“. “ Projevovala se tehdy, když hráči v určité eventové zóně nastavili cenu předmětů přesně mezi 44 442 a 49 087 gilů – což způsobovalo odpojení pravděpodobně kvůli chybě způsobené přetečením celočíselné hodnoty.
Proč je to důležité
Doba řešení je klíčovým faktorem pro frekvenci vydávání verzí. Dlouhé nebo nepředvídatelné doby řešení nutí k omezování rozsahu, vydávání hotfixů a pozastavení vydávání verzí; vytvářejí plánovací dluh, protože „dlouhý ocas“ (odlehlé hodnoty) narušuje sprinty více, než by naznačoval průměr.
To také přímo souvisí se spokojeností zákazníků. Zákazníci jsou ochotni tolerovat problémy, pokud jsou rychle uznány a předvídatelně vyřešeny. Pomalé opravy – nebo ještě hůře, nekonzistentní opravy – vedou k eskalacím, snižují hodnocení CSAT/NPS a ohrožují prodloužení smluv.
Stručně řečeno, pokud budete dobu řešení chyb přesně měřit a systematicky ji zkracovat, zlepší se vaše plány i vztahy.
📖 Přečtěte si více: Jak stanovit priority chyb pro efektivní řešení problémů
Jak měřit dobu řešení chyb?
Nejprve si určete, kdy se měření spouští a kdy končí.
Většina týmů volí buď stav Nahlášeno → Vyřešeno (oprava je začleněna a připravena k ověření), nebo stav Nahlášeno → Uzavřeno (oddělení QA provedlo ověření a změna je vydána nebo jinak uzavřena).
Vyberte si jednu definici a používejte ji důsledně, aby vaše trendy měly smysl.
Nyní potřebujete některé měřitelné metriky. Pojďme si je nastínit:
Klíčové metriky sledování chyb, na které je třeba dbát:
| 📊 Metrika | 📌 Co to znamená | 💡 Jak to pomáhá | 🧮 Vzorec (pokud je k dispozici) |
|---|---|---|---|
| Počet chyb 🐞 | Celkový počet nahlášených chyb | Poskytuje přehled o stavu systému z ptačí perspektivy. Vysoké číslo? Je čas to prošetřit. | Celkový počet chyb = všechny chyby zaznamenané v systému {otevřené + uzavřené} |
| Otevřené chyby 🚧 | Chyby, které dosud nebyly opraveny | Zobrazuje aktuální pracovní vytížení. Pomáhá při stanovování priorit. | Otevřené chyby = Celkový počet chyb – Uzavřené chyby |
| Uzavřené chyby ✅ | Chyby, které byly vyřešeny a ověřeny | Sleduje pokrok a odvedenou práci. | Uzavřené chyby = počet chyb se stavem „Uzavřeno“ nebo „Vyřešeno“ |
| Závažnost chyby 🔥 | Závažnost chyby (např. kritická, závažná, méně závažná) | Pomáhá při třídění podle dopadu. | Sledujte jako kategorické pole, bez vzorce. Použijte filtry/seskupení. |
| Priorita chyb 📅 | Jak naléhavě je třeba chybu opravit | Pomáhá při plánování sprintů a vydávání nových verzí. | Jedná se také o kategorické pole, které je obvykle seřazeno podle priority (např. P0, P1, P2). |
| Doba řešení ⏱️ | Doba od nahlášení chyby po opravu | Měří rychlost reakce. | Doba vyřešení = datum uzavření – datum nahlášení |
| Míra opětovného otevření 🔄 | Procento chyb znovu otevřených po uzavření | Odráží kvalitu oprav nebo problémy s regresí. | Míra opětovného otevření (%) = {Opětovně otevřené chyby ÷ Celkový počet uzavřených chyb} × 100 |
| Únik chyb 🕳️ | Chyby, které se vkradly do produkčního prostředí | Ukazuje efektivitu kontroly kvality (QA) a testování softwaru. | Míra úniku (%) = {Chyby v produkčním prostředí ÷ Celkový počet chyb} × 100 |
| Hustota chyb 🧮 | Chyby na jednotku velikosti kódu | Zvýrazňuje oblasti kódu náchylné k rizikům. | Hustota chyb = počet chyb ÷ KLOC {kilorádky kódu} |
| Přiřazené vs. nepřidělené chyby 👥 | Rozložení chyb podle odpovědnosti | Zajistěte, aby nic neuniklo pozornosti. | Použijte filtr: Nepřiřazené = chyby, u kterých je pole „Přiřazeno“ prázdné |
| Stáří otevřených chyb 🧓 | Jak dlouho zůstává chyba nevyřešená | Odhaluje rizika stagnace a hromadění nevyřízených úkolů. | Stáří chyby = aktuální datum – datum nahlášení |
| Duplicitní chyby 🧬 | Počet duplicitních hlášení | Zvýrazňuje chyby v procesech přijímání požadavků. | Míra duplicit = počet duplicit ÷ celkový počet chyb × 100 |
| MTTD (průměrná doba detekce) 🔎 | Průměrná doba potřebná k detekci chyb nebo incidentů | Měří efektivitu monitorování a informovanosti. | MTTD = Σ(čas detekce – čas vzniku) ÷ počet chyb |
| MTTR (průměrná doba řešení) 🔧 | Průměrná doba potřebná k úplnému odstranění chyby po jejím zjištění | Sleduje rychlost reakce vývojářů a dobu opravy. | MTTR = Σ(čas vyřešení – čas detekce) ÷ počet vyřešených chyb |
| MTTA (průměrná doba potvrzení) 📬 | Doba od zjištění chyby do okamžiku, kdy někdo začne na její opravě pracovat | Ukazuje reaktivitu týmu a rychlost reakce na výstrahy. | MTTA = Σ(čas potvrzení – čas detekce) ÷ počet chyb |
| MTBF (průměrná doba mezi poruchami) 🔁 | Doba mezi vyřešením jedné poruchy a výskytem další | Ukazuje stabilitu v čase. | MTBF = Celková doba provozuschopnosti ÷ Počet poruch |
⚡️ Archiv šablon: 15 bezplatných šablon a formulářů pro hlášení chyb a jejich sledování
Faktory ovlivňující dobu řešení chyb
Doba řešení je často ztotožňována s „rychlostí, s jakou inženýři programují“.
To je však jen jedna část celého procesu.
Doba řešení chyb je součtem kvality při přijetí, efektivity toku v systému a rizika závislostí. Pokud některý z těchto faktorů selže, prodlužuje se doba cyklu, klesá předvídatelnost a stoupá počet eskalací.
Kvalita přijetí udává tón
Hlášení, která přicházejí bez jasných kroků k reprodukci, podrobností o prostředí, protokolů nebo informací o verzi/sestavení, vyžadují zbytečnou výměnu zpráv. Duplicitní hlášení z více kanálů (podpora, kontrola kvality, monitorování, Slack) zvyšují zátěž a rozptylují odpovědnost.
Čím dříve zachytíte správný kontext – a odstraníte duplicity –, tím méně předávání a upřesňujících dotazů budete později potřebovat.
Prioritizace a směrování určují, kdo se chybou bude zabývat a kdy
Štítky závažnosti, které neodpovídají dopadu na zákazníky či podnikání (nebo se v průběhu času mění), způsobují nepořádek ve frontě: nejhlasitější tikety se dostávají na začátek fronty, zatímco chyby s velkým dopadem zůstávají neřešeny.
Jasná pravidla směrování podle komponenty/vlastníka a jednotná „frontu pravdy“ zabraňují tomu, aby práce s prioritou P0/P1 zapadla pod „aktuálními a rušivými“ úkoly.
Odpovědnost a předávání úkolů jsou tichými zabijáky
Pokud není jasné, zda chyba spadá do působnosti týmu pro mobilní aplikace, backendové autentizace nebo platformy, je odeslána dál. Každé takové přesunutí vynuluje kontext.
Časová pásma tento problém ještě zhoršují: chyba nahlášená pozdě večer bez určení odpovědné osoby může ztratit 12–24 hodin, než se někdo vůbec začne zabývat jejím reprodukováním. Přesné definice toho, „kdo za co odpovídá“, s pohotovostním režimem nebo týdenním DRI, tento problém odstraňují.
Reprodukovatelnost závisí na pozorovatelnosti
Nedostatečné protokoly, chybějící korelační ID nebo nedostatek trasování pádů proměňují diagnostiku v hádání. Chyby, které se objevují pouze u konkrétních příznaků, nájemců nebo tvarů dat, je obtížné reprodukovat ve vývoji.
Pokud inženýři nemají bezpečný přístup k očištěným datům podobným produkčním, skončí tím, že provádějí instrumentaci, opakované nasazení a čekají – celé dny místo hodin.
Díky jednotnému prostředí a datům budete mít vždy přesný přehled
„Na mém počítači to funguje“ obvykle znamená „produkční data jsou jiná“. Čím více se vaše vývojové a testovací prostředí liší od produkčního (konfigurace, služby, verze třetích stran), tím déle budete ztrácet čas hledáním příčin neznámých problémů. Bezpečné snímky dat, inicializační skripty a kontroly shody tuto mezeru zmenšují.
Skutečnou propustnost určují rozpracované úlohy (WIP) a zaměření
Přetížené týmy řeší příliš mnoho chyb najednou, jejich pozornost se rozptyluje a přeskakují mezi úkoly a schůzkami. Přepínání mezi úkoly přidává skryté hodiny práce.
Viditelný limit rozpracovaných úkolů a snaha dokončit započaté úkoly před přijetím nových sníží vaši mediánovou hodnotu rychleji než jakékoli jednotlivé hrdinské úsilí.
Rychlost revize kódu, CI a QA představuje klasická úzká místa
Pomalé sestavování, nespolehlivé testy a nejasné SLA pro revize brzdí jinak rychlé opravy. Oprava, která by trvala 10 minut, může strávit dva dny čekáním na revizora nebo zařazením do pipeline trvajícího několik hodin.
Podobně i fronty QA, které provádějí testování v dávkách nebo se spoléhají na ruční testy funkčnosti, mohou prodloužit dobu od „Nahlášeno → Uzavřeno“ o celé dny, i když proces „Nahlášeno → Vyřešeno“ probíhá rychle.
Závislosti prodlužují fronty
Změny napříč týmy (schémata, migrace platforem, aktualizace SDK), chyby dodavatelů nebo kontroly v obchodech s aplikacemi (mobilní zařízení) způsobují čekací stavy. Bez explicitního sledování stavů „Zablokováno/Pozastaveno“ tyto čekací doby neviditelně navyšují vaše průměry a zakrývají, kde se nachází skutečné úzké místo.
Důležitý je model vydávání verzí a strategie vrácení změn
Pokud vydáváte velké série verzí s manuálními kontrolními body, i vyřešené chyby čekají, dokud nevyjde další série. Funkční příznaky, testovací vydání a kanály pro hotfixy zkracují čekací dobu – zejména u incidentů P0/P1 – tím, že vám umožňují oddělit nasazení oprav od plných cyklů vydávání verzí.
Architektura a technologický dluh určují vaše limity
Úzká provázanost, nedostatek testovacích rozhraní a neprůhledné starší moduly činí i jednoduché opravy riskantními. Týmy to kompenzují dodatečným testováním a delšími revizemi, což prodlužuje vývojové cykly. Naopak modulární kód s kvalitními testy smluvních vztahů vám umožňuje postupovat rychle, aniž byste narušili sousední systémy.
Komunikace a přehlednost stavu ovlivňují předvídatelnost
Nejasné aktualizace („prověřujeme to“) vedou k zbytečné práci, když zainteresované strany žádají o odhadované termíny vyřešení, podpora znovu otevírá tikety nebo produktový tým eskaluje problém. Jasné změny stavu, poznámky k reprodukci a příčině problému a zveřejněný odhadovaný termín vyřešení snižují fluktuaci a chrání soustředění vašeho vývojového týmu.
📮ClickUp Insight: Průměrný profesionál stráví více než 30 minut denně hledáním informací souvisejících s prací – to je přes 120 hodin ročně ztracených prohledáváním e-mailů, konverzací na Slacku a roztříštěných souborů.
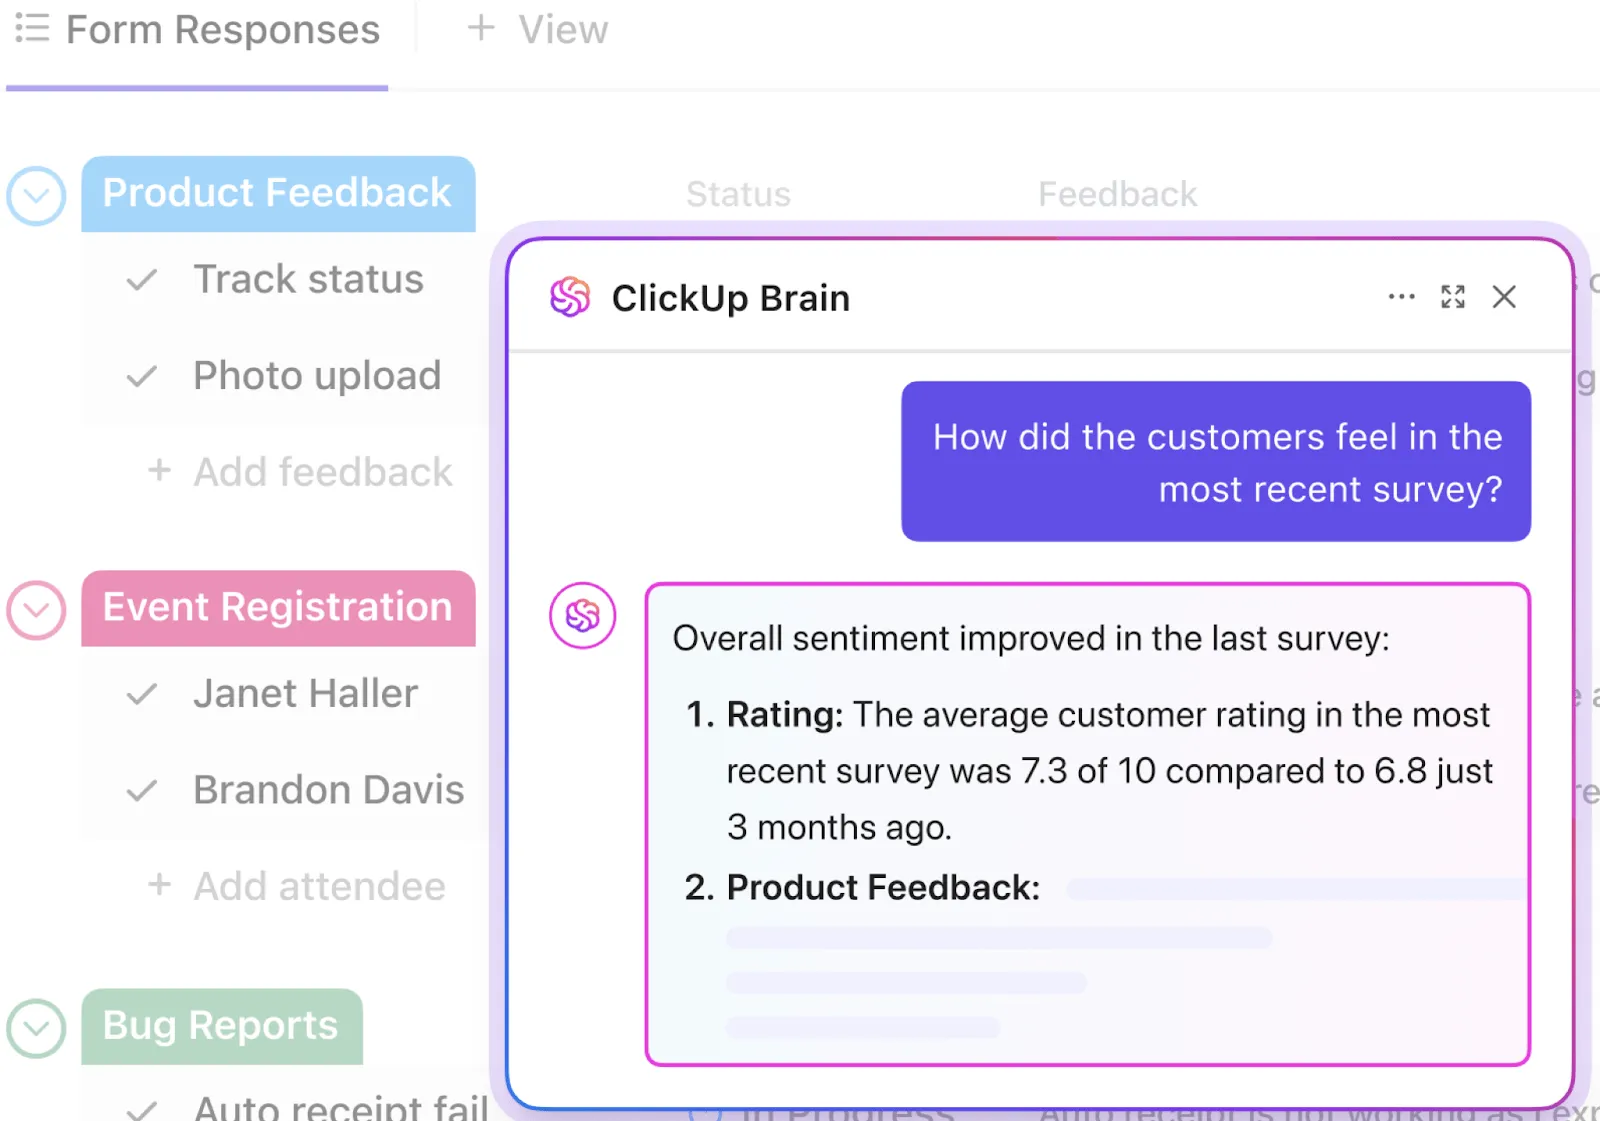
Inteligentní AI asistent integrovaný do vašeho pracovního prostředí to může změnit. Seznamte se s ClickUp Brain. Poskytuje okamžité přehledy a odpovědi tím, že během několika sekund vyhledá správné dokumenty, konverzace a podrobnosti o úkolech – takže můžete přestat hledat a začít pracovat.
💫 Skutečné výsledky: Týmy jako QubicaAMF ušetřily díky ClickUp více než 5 hodin týdně – to je přes 250 hodin ročně na osobu – tím, že odstranily zastaralé procesy správy znalostí. Představte si, co by váš tým mohl vytvořit s jedním týdnem produktivity navíc každé čtvrtletí!
Předběžné ukazatele, že se doba řešení prodlouží
❗️Prodlužující se „doba potvrzení“ a velké množství ticketů bez přiděleného vlastníka po dobu delší než 12 hodin
❗️Prodlužující se úseky „Time in Review/CI“ a častá nestabilita testů
❗️Vysoký podíl duplicit při přijímání hlášení a nejednotné označení závažnosti napříč týmy
❗️Několik chyb zůstává ve stavu „Blokováno“ bez uvedení konkrétní externí závislosti
❗️Míra opětovného otevření se postupně zvyšuje (opravy nelze reprodukovat nebo definice dokončení jsou nejasné)
Různé organizace vnímají tyto faktory odlišně. Vedení je vnímá jako zmeškané cykly učení a zpoždění ve vztahu k příležitostem k výnosům; operátoři je vnímají jako rušivé prvky při třídění a nejasné rozdělení odpovědnosti.
Optimalizací přijímání, toku a závislostí můžete snížit celou křivku – medián i P90.
Chcete se dozvědět více o tom, jak psát lepší hlášení o chybách? Začněte zde. 👇🏼
📖 Přečtěte si více: Životní cyklus testování softwaru (STLC): přehled a fáze
Odvětvové standardy pro dobu řešení chyb
Srovnávací hodnoty pro řešení chyb se liší v závislosti na toleranci rizika, modelu vydávání verzí a tom, jak rychle dokážete změny nasadit.
Právě zde můžete využít mediány (P50) k pochopení typického toku a P90 ke stanovení slibů a smluv o úrovni služeb (SLA) – podle závažnosti a zdroje (zákazník, kontrola kvality, monitorování).
Podívejme se, co to přesně znamená:
| 🔑 Termín | 📝 Popis | 💡 Proč je to důležité |
|---|---|---|
| P50 (medián) | Střední hodnota – 50 % oprav chyb je rychlejších než tato hodnota a 50 % je pomalejších | 👉 Odráží vaši typickou nebo nejčastější dobu řešení. Vhodné pro pochopení běžného výkonu |
| P90 (90. percentil) | 90 % chyb je opraveno v tomto časovém rámci. Pouze 10 % trvá déle. | 👉 Představuje nejhorší možný (ale stále realistický) případ. Užitečné pro stanovení externích slibů |
| SLA (smlouvy o úrovni služeb) | Závazky, které přijímáte – ať už interně, nebo vůči zákazníkům – ohledně rychlosti řešení problémů | 👉 Příklad: „Chyby P1 vyřešíme do 48 hodin v 90 % případů.“ Pomáhá budovat důvěru a posilovat zodpovědnost |
| Podle závažnosti a zdroje | Segmentujte své metriky podle dvou klíčových dimenzí: • Závažnost (např. P0, P1, P2) • Zdroj (např. zákazník, QA, monitorování) | 👉 Umožňuje přesnější sledování a stanovení priorit, takže kritické chyby jsou řešeny rychleji |
Níže jsou uvedeny orientační rozsahy založené na odvětvích, na která se často zaměřují zkušené týmy; berte je jako výchozí hodnoty a poté je přizpůsobte vašim podmínkám.
SaaS
Systém je neustále v provozu a podporuje CI/CD, takže hotfixy jsou běžnou praxí. U kritických problémů (P0/P1) se často usiluje o medián kratší než jeden pracovní den, přičemž P90 se pohybuje v rozmezí 24–48 hodin. U nekritických problémů (P2+) je medián obvykle 3–7 dní, přičemž P90 se pohybuje v rozmezí 10–14 dní. Týmy s robustními funkčními příznaky a automatizovanými testy se obvykle pohybují na rychlejší straně tohoto spektra.
E-commerce platformy
Vzhledem k tomu, že konverzní a nákupní procesy mají zásadní vliv na tržby, jsou na ně kladeny vyšší nároky. Problémy s prioritou P0/P1 se obvykle zmírní během několika hodin (vrácení změn, označení nebo konfigurace) a zcela vyřeší ještě týž den; P90 do konce dne nebo do <12 hodin je běžné v období špičky. Problémy s prioritou P2+ se často vyřeší za 2–5 dní, přičemž P90 je vyřešeno do 10 dnů.
Podnikový software
Náročnější validace a časová okna pro změny u zákazníků zpomalují tempo. U chyb P0/P1 se týmy snaží najít dočasné řešení do 4–24 hodin a trvalou opravu do 1–3 pracovních dnů; u P90 do 5 pracovních dnů. Chyby P2+ se často sdružují do release trainů, přičemž medián trvání je 2–4 týdny v závislosti na harmonogramech zavádění u zákazníků.
Hry a mobilní aplikace
Backendy živých služeb fungují jako SaaS (aktivace a vrácení změn trvá od několika minut do několika hodin; P90 ještě týž den). Aktualizace na straně klienta jsou omezeny procesem schvalování: u problémů P0/P1 se často okamžitě využijí opatření na straně serveru a oprava pro klienta je vydána za 1–3 dny; u P90 do týdne s urychleným schvalováním. Opravy P2+ se obvykle plánují do dalšího sprintu nebo vydání nového obsahu.
Bankovnictví/Fintech
Kontroly rizik a dodržování předpisů podporují model „rychlé zmírnění, pečlivá změna“. Chyby P0/P1 jsou rychle zmírněny (označení, vrácení změn, přesměrování provozu v řádu minut až hodin) a zcela opraveny za 1–3 dny; chyby P90 do týdne, s přihlédnutím ke kontrole změn. Chyby P2+ často trvají 2–6 týdnů, než projdou bezpečnostními, auditními a CAB kontrolami.
Pokud se vaše čísla nacházejí mimo tyto rozsahy, podívejte se na kvalitu přijímání požadavků, směrování/přiřazení odpovědnosti, průchodnost revize kódu a kontroly kvality a schvalování závislostí, než budete předpokládat, že hlavním problémem je „rychlost vývoje“.
🌼 Věděli jste, že: Podle průzkumu Stack Overflow z roku 2024 vývojáři stále častěji využívali AI jako svého spolehlivého pomocníka při programování. Až 82 % z nich používalo AI přímo k psaní kódu – to je tedy kreativní spolupracovník! Když narazili na problém nebo hledali řešení, 67,5 % se při hledání odpovědí spoléhalo na AI a více než polovina (56,7 %) ji využívala k ladění a získávání pomoci.
Pro některé se nástroje umělé inteligence osvědčily také při dokumentaci projektů (40,1 %) a dokonce i při vytváření syntetických dat nebo obsahu (34,8 %). Zajímá vás nová kódová základna? Téměř třetina (30,9 %) využívá AI k rychlému seznámení se s ní. Testování kódu je pro mnohé stále ruční dřinou, ale 27,2 % přijalo AI i v této oblasti. V jiných oblastech, jako je revize kódu, plánování projektů a prediktivní analytika, je míra přijetí AI nižší, ale je zřejmé, že se AI postupně prosazuje ve všech fázích vývoje softwaru.
📖 Přečtěte si více: Jak využít umělou inteligenci pro zajištění kvality
Jak zkrátit dobu řešení chyb
Rychlost řešení chyb závisí na odstranění překážek při každém předání, od přijetí až po vydání.
Největších zlepšení dosáhnete tím, že zefektivníte prvních 30 minut (přesné zachycení, správný vlastník, správná priorita) a následně zkrátíte následující cykly (reprodukce, kontrola, ověření).
Zde je devět strategií, které společně fungují jako ucelený systém. Umělá inteligence urychluje každý krok a pracovní postup je přehledně soustředěn na jednom místě, takže vedení získává předvídatelnost a odborníci plynulý pracovní tok.
1. Centralizujte příjem hlášení a zachyťte kontext přímo u zdroje
Doba řešení chyb se prodlužuje, když musíte rekonstruovat kontext z konverzací ve Slacku, ticketů podpory a tabulek. Směrujte všechny hlášení – z podpory, kontroly kvality i monitoringu – do jedné fronty pomocí strukturované šablony, která shromažďuje údaje o komponentě, závažnosti, prostředí, verzi/buildu aplikace, krocích k reprodukci, porovnání očekávaného a skutečného stavu a přílohách (protokoly/HAR/snímky obrazovky).
Umělá inteligence dokáže automaticky shrnout dlouhé zprávy, extrahovat kroky pro reprodukci chyby a podrobnosti o prostředí z příloh a označit pravděpodobné duplicity, takže třídění začíná na základě uceleného a obohaceného záznamu.
Ukazatele, které je třeba sledovat: MTTA (potvrzení do několika minut, nikoli hodin), míra duplicit, doba strávená u položek „Potřebuji informace“.
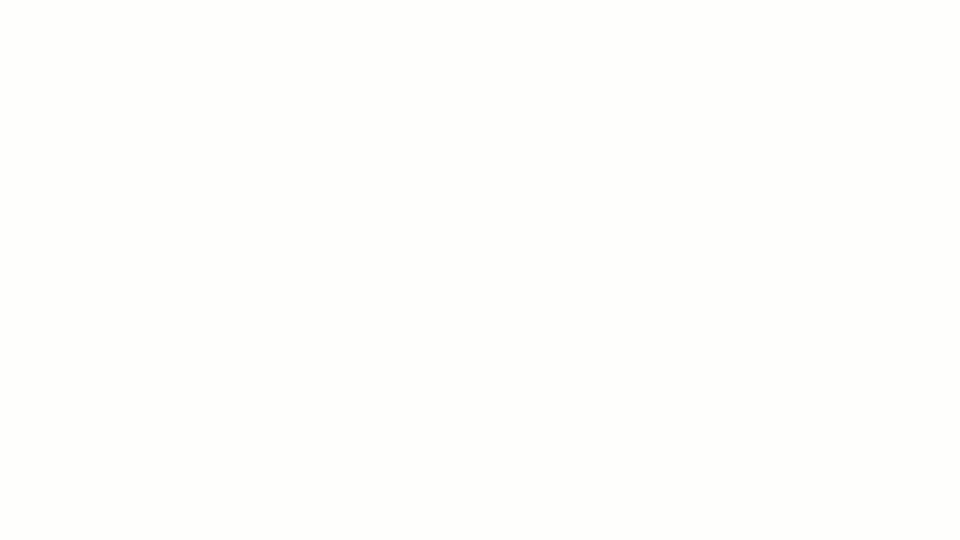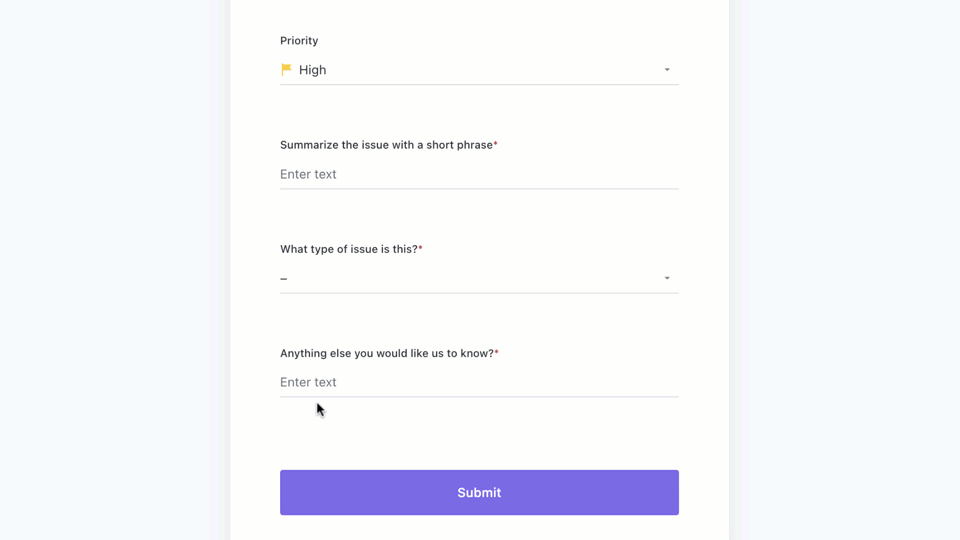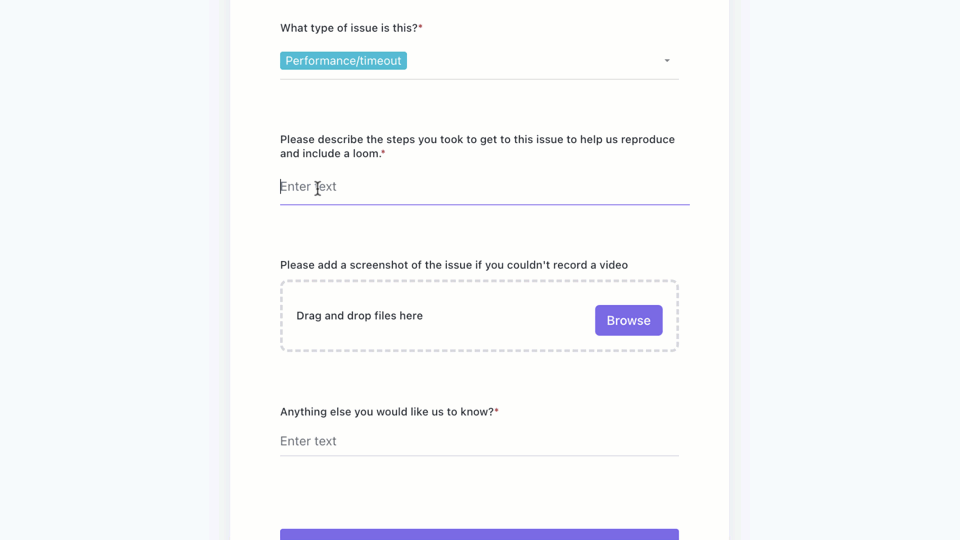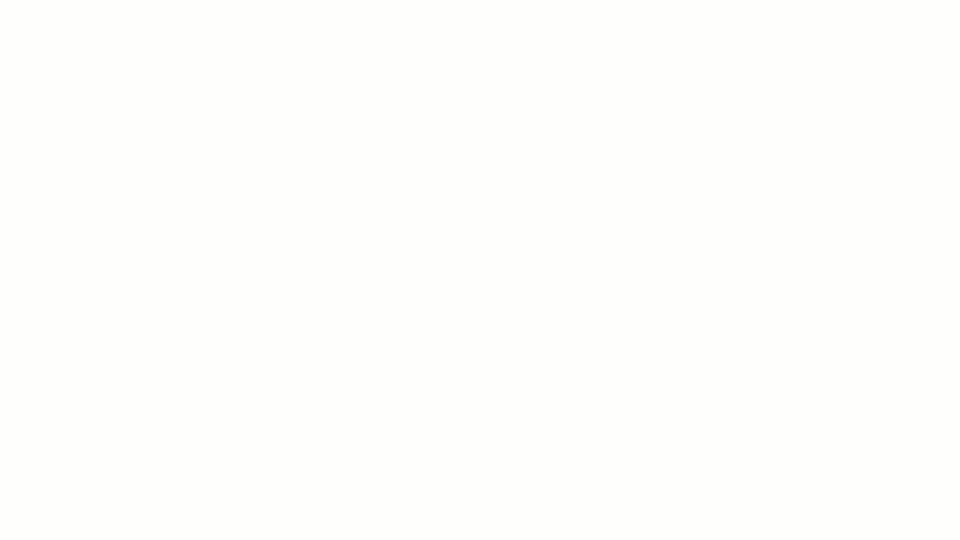
📖 Přečtěte si více: Síla formulářů ClickUp: Zefektivnění práce softwarových týmů
2. Třídění a směrování s podporou umělé inteligence pro výrazné zkrácení MTTA
Nejrychlejší opravy jsou ty, které se okamžitě dostanou na správný stůl.
Pomocí jednoduchých pravidel a umělé inteligence klasifikujte závažnost, identifikujte pravděpodobné vlastníky podle komponenty nebo oblasti kódu a automaticky přiřazujte úkoly s časovým limitem podle SLA. Stanovte jasné rozdělení mezi P0/P1 a vším ostatním a zajistěte, aby bylo zcela jasné, kdo je za daný úkol zodpovědný.
Automatizace mohou nastavit prioritu na základě polí, směrovat úkoly podle komponenty k příslušnému týmu, spustit časovač SLA a upozornit technika v pohotovosti; umělá inteligence může navrhnout závažnost a odpovědnou osobu na základě minulých vzorců. Když se třídění stane záležitostí trvající 2–5 minut namísto 30minutové debaty, klesne vaše MTTA a následně i MTTR.
Ukazatele, které je třeba sledovat: MTTA, kvalita první reakce (požaduje první komentář správné informace?), počet předání na jednu chybu.
Takto to vypadá v praxi:
3. Stanovte priority podle dopadu na podnikání pomocí jasně definovaných úrovní SLA
Princip „vyhraje ten, kdo křičí nejhlasitěji“ způsobuje nepředvídatelnost front a podkopává důvěru u vedoucích pracovníků, kteří sledují ukazatele CSAT/NPS a míru obnovení smluv.
Nahraďte to skóre, které zohledňuje závažnost, frekvenci, ovlivněný ARR, kritičnost funkce a blízkost termínů obnovení/spuštění – a podložte ho úrovněmi SLA (např. P0: zmírnit během 1–2 hodin, vyřešit do jednoho dne; P1: ještě týž den; P2: v rámci sprintu).
Udržujte přehledný kanál P0/P1 s limity rozpracovaných úloh (WIP), aby nic nezůstalo bez pozornosti.
Ukazatele, které je třeba sledovat: P50/P90 vyřešení podle úrovně, míra porušení SLA, korelace s CSAT/NPS.
💡Tip pro profesionály: Díky funkcím „Priority úkolů“, „Vlastní pole“ a „Závislosti“ v ClickUp můžete vypočítat skóre dopadu a propojit chyby s účty, zpětnou vazbou nebo položkami v roadmapě; navíc vám „Cíle“ v ClickUp pomohou propojit dodržování SLA s cíli na úrovni společnosti, což přímo odpovídá obavám vedení ohledně sladění činností.
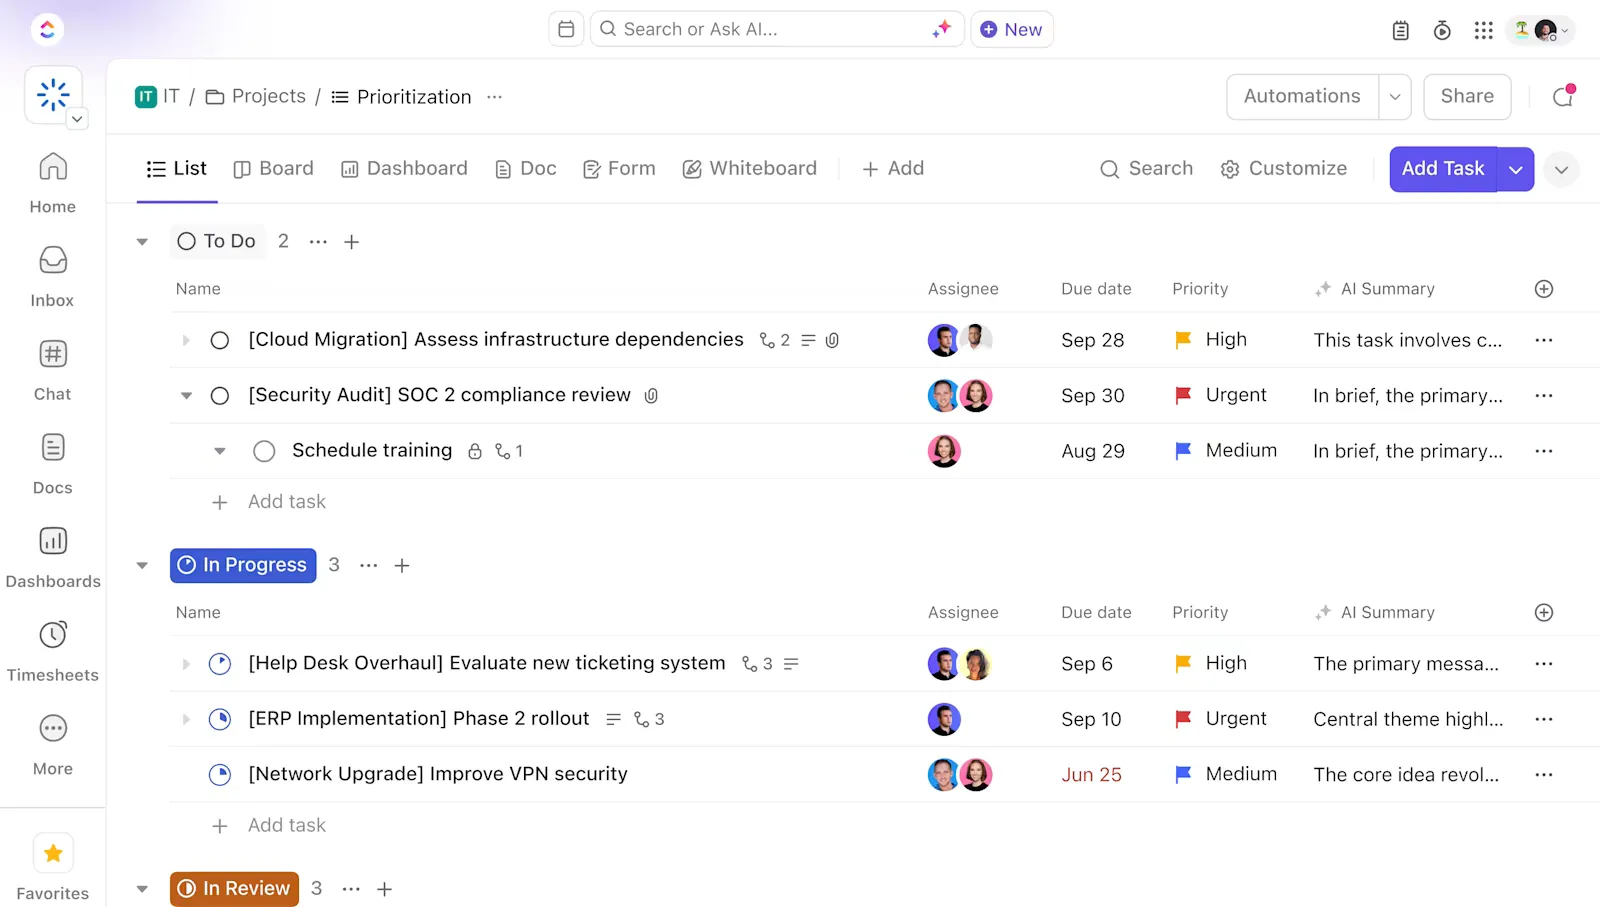
4. Zajistěte, aby reprodukce a diagnostika proběhly v jediném kroku
Každá další otázka typu „můžete poslat protokoly?“ prodlužuje dobu řešení.
Standardizujte, co znamená „správné“: povinná pole pro sestavení/commit, prostředí, kroky k reprodukci, očekávané versus skutečné hodnoty, plus přílohy pro protokoly, výpisy paměti při pádu a soubory HAR. Nastavte telemetrii klient/server tak, aby bylo možné propojit ID pádů a ID požadavků s trasami.
Využijte nástroj Sentry (nebo podobný) pro získání stopy zásobníku a propojte daný problém přímo s chybou. Umělá inteligence dokáže číst protokoly a stopy, navrhnout pravděpodobnou oblast poruchy a vygenerovat minimální reprodukci, čímž promění hodinu ručního prohledávání na několik minut cílené práce.
Ukládejte si postupy pro běžné typy chyb, aby inženýři nemuseli začínat od nuly.
Ukazatele, které je třeba sledovat: Čas strávený „čekáním na informace“, procento reprodukovatelnosti při prvním pokusu, míra opětovného otevření související s chybějící reprodukcí.
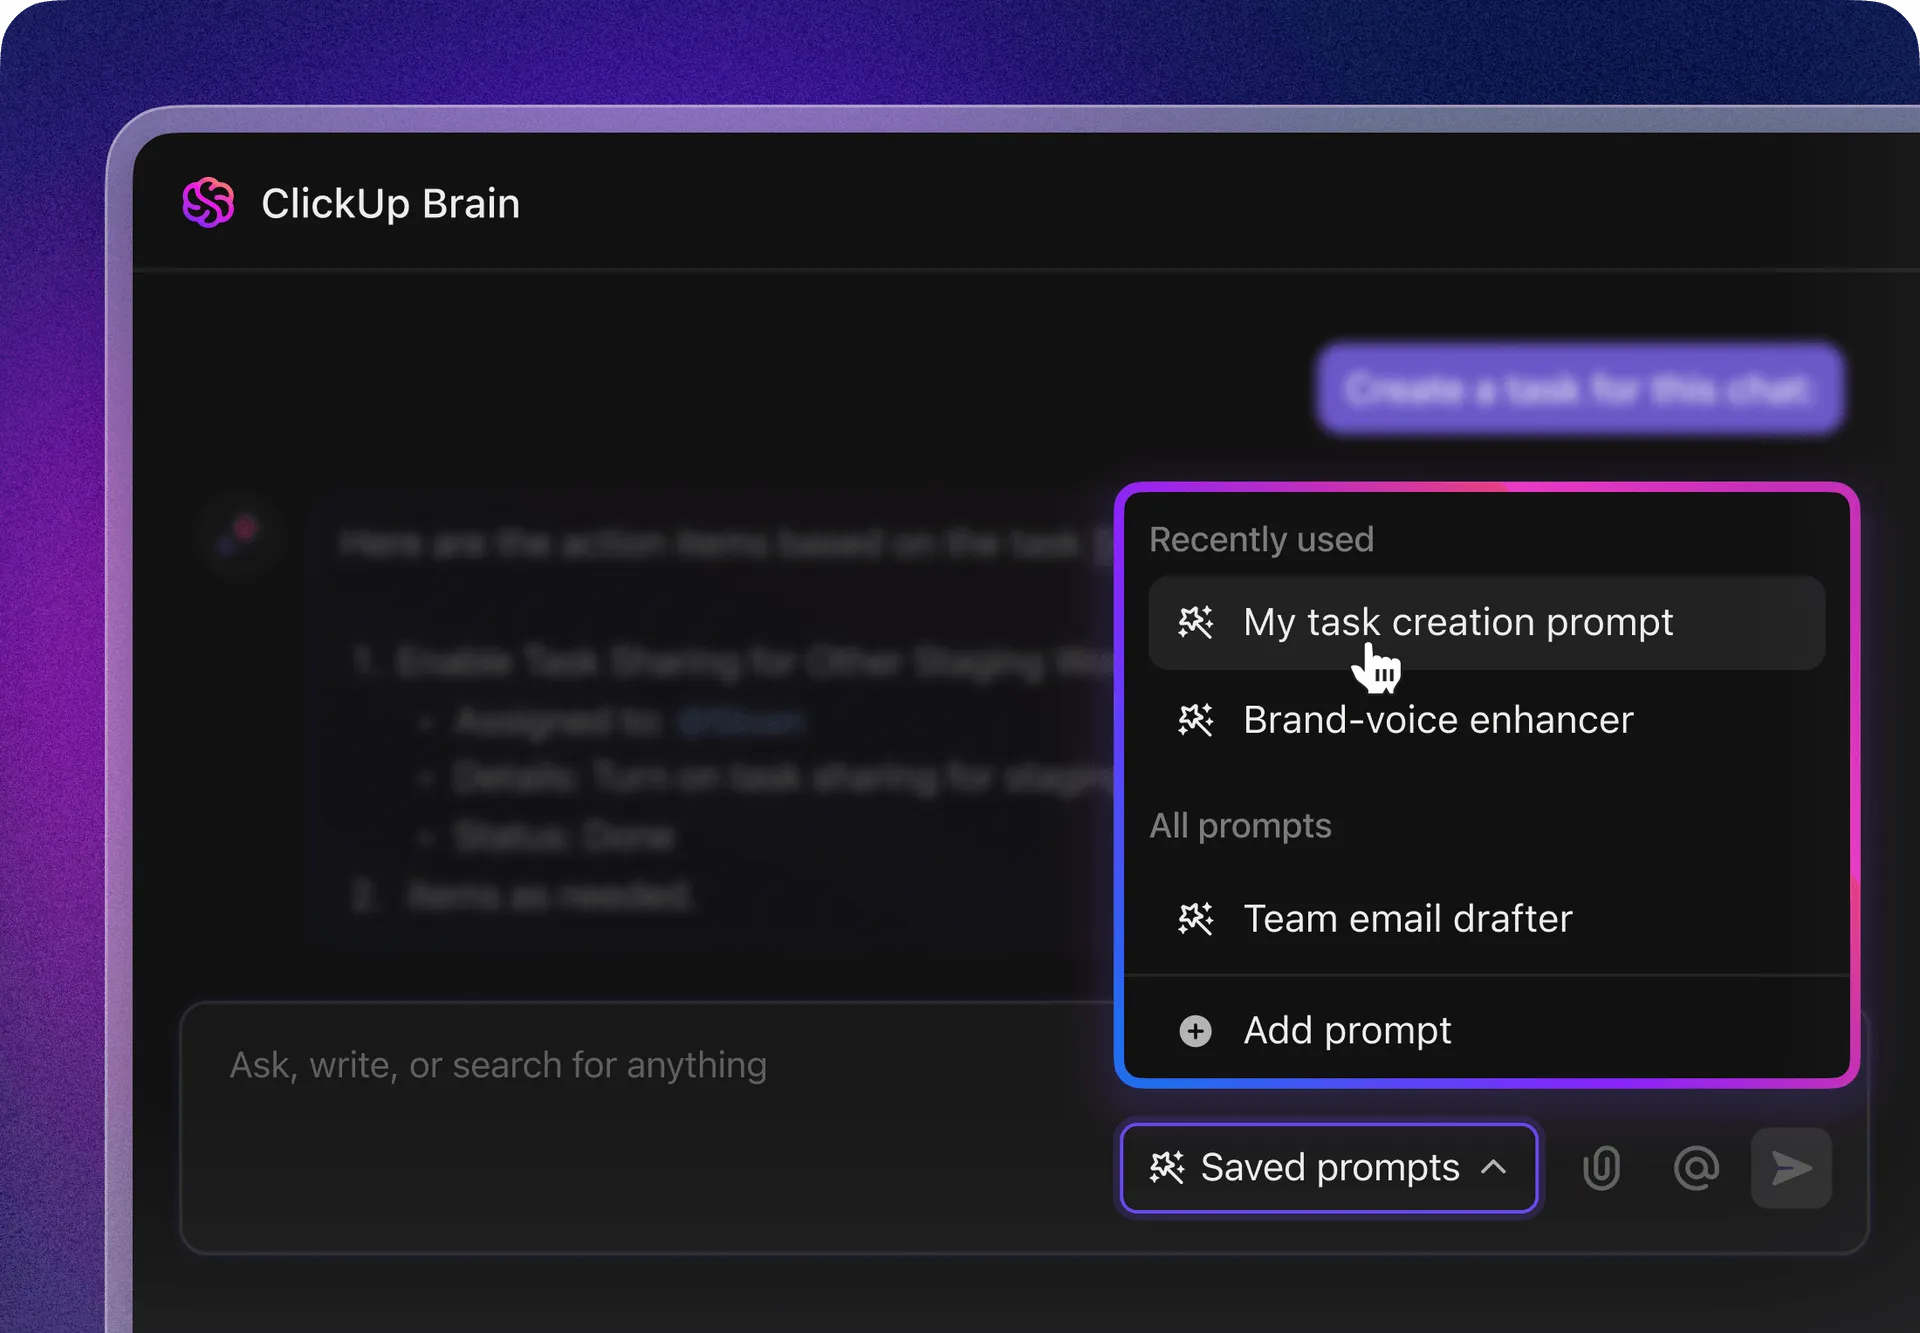
📖 Další informace: Jak využít AI ve vývoji softwaru (případy použití a nástroje)
5. Zkraťte cyklus revize kódu a testování
Velké PR se zadrhávají. Zaměřte se na precizní opravy, vývoj založený na trunkové větvi a funkční příznaky, aby bylo možné opravy bezpečně nasadit. Předem přiřaďte revizory podle vlastnictví kódu, abyste zabránili prostojům, a používejte kontrolní seznamy (aktualizované testy, přidaná telemetrie, příznak za kill switch), aby byla kvalita zaručena.
Automatizace by měla při otevření pull requestu přesunout chybu do stavu „Ve revizi“ a při sloučení do stavu „Vyřešeno“; umělá inteligence může navrhnout jednotkové testy nebo upozornit na rizikové rozdíly, na které je třeba se při revizi zaměřit.
Ukazatele, které je třeba sledovat: Doba strávená ve stavu „In Review“, míra neúspěšnosti změn u pull requestů na opravu chyb a latence revize P90.
V ClickUp můžete využít integrace s GitHubem a GitLabem, abyste udrželi stav řešení v synchronizaci; automatizace mohou zajistit dodržování „definice dokončení“.
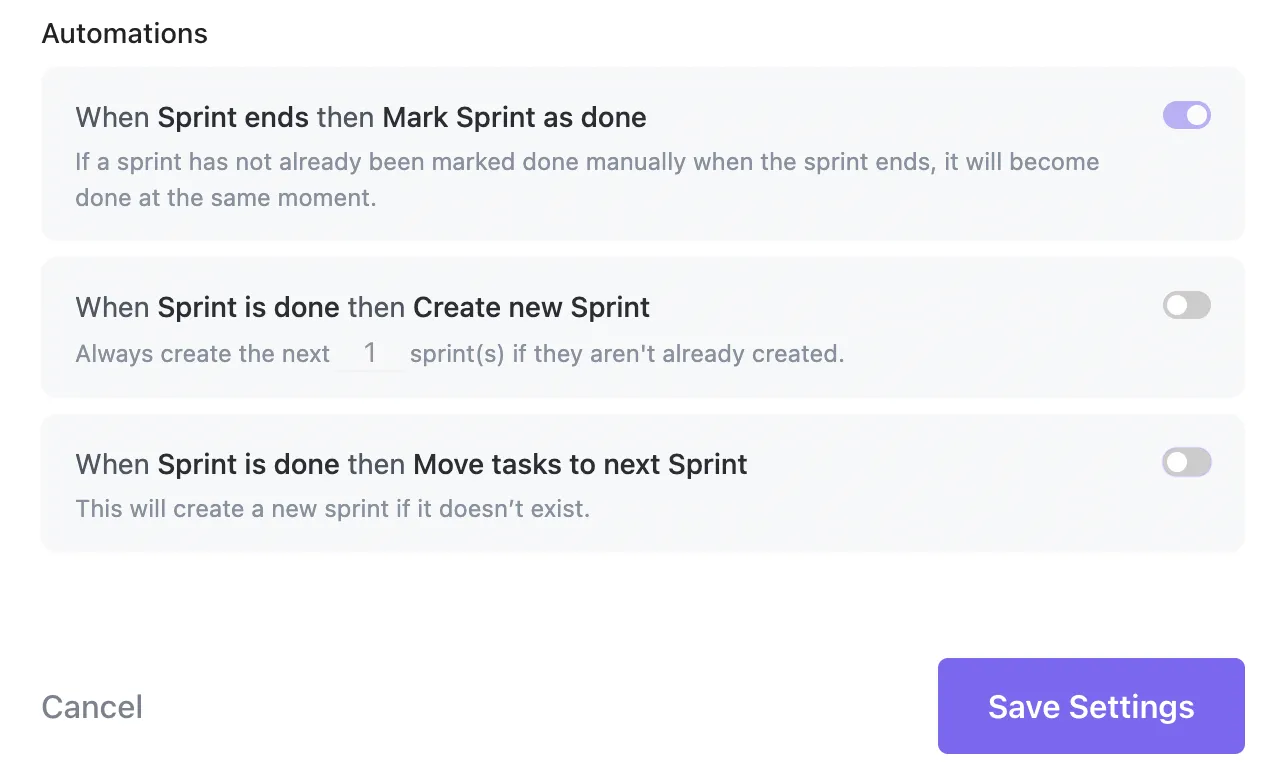
📖 Přečtěte si více: Jak využít umělou inteligenci k automatizaci úkolů
6. Paralelizujte ověřování a zajistěte skutečnou paritu prostředí QA
Ověřování by nemělo začínat až o několik dní později nebo v prostředí, které žádný z vašich zákazníků nepoužívá.
Dbejte na to, aby byly opravy „připravené pro QA“: hotfixy založené na označeních, ověřené v prostředích podobných produkčním s výchozími daty, která odpovídají nahlášeným případům.
Pokud je to možné, nastavte dočasná prostředí z větve chyb, aby je tým QA mohl okamžitě ověřit; AI pak může generovat testovací případy na základě popisu chyby a předchozích regresí.
Ukazatele, které je třeba sledovat: Doba strávená ve fázi „QA/ověřování“, míra vrácení z QA zpět do vývoje, medián doby do uzavření po sloučení.
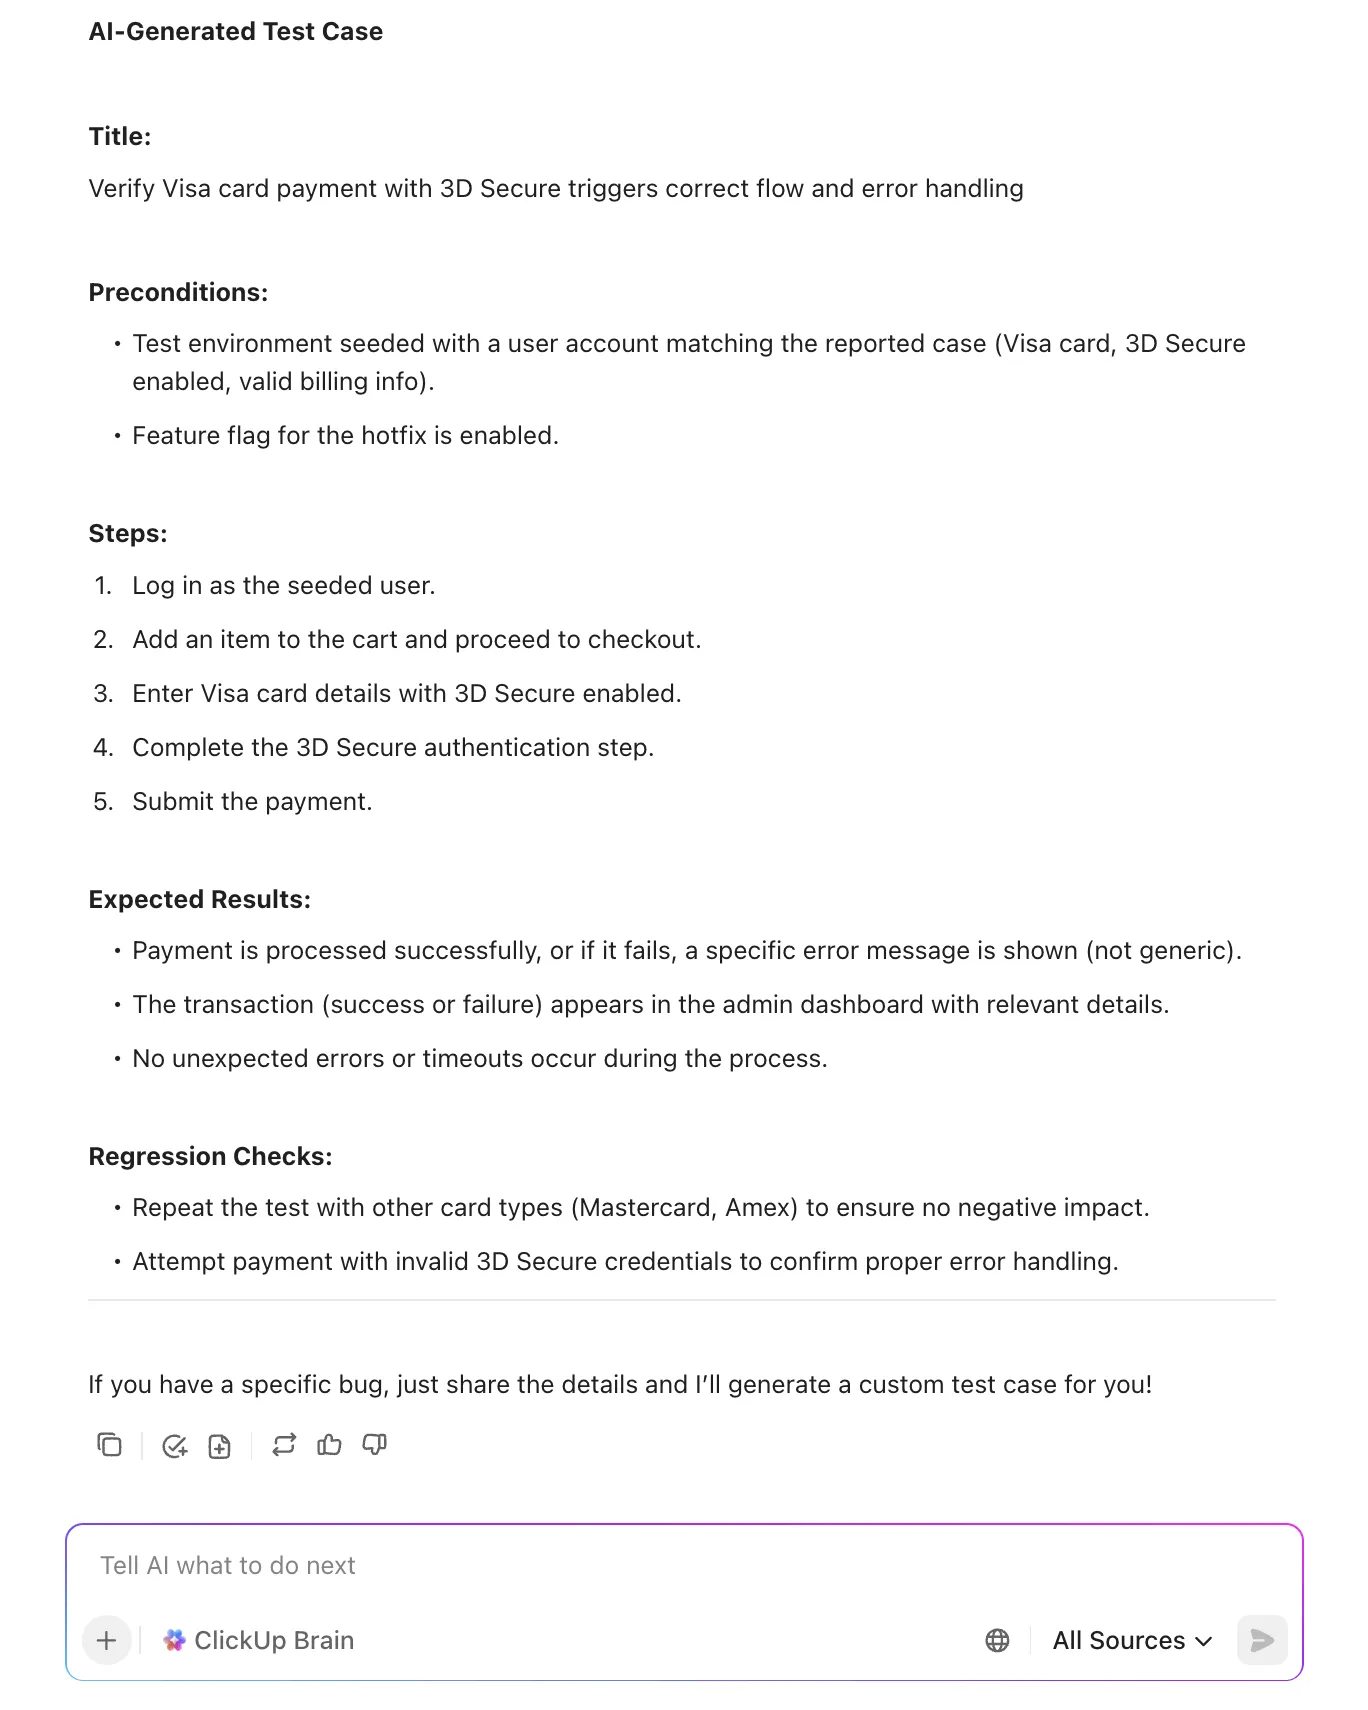
📖 Přečtěte si více: Jak psát efektivní testovací případy
7. Jasně informujte o stavu, abyste snížili náklady na koordinaci
Jedna kvalitní aktualizace zabrání třem dotazům na stav a jedné eskalaci.
K aktualizacím přistupujte jako k produktu: krátké, konkrétní a s ohledem na cílovou skupinu (podpora, vedení, zákazníci). Stanovte frekvenci pro chyby P0/P1 (např. každou hodinu, dokud nebude problém vyřešen, poté každé čtyři hodiny) a udržujte jediný zdroj pravdivých informací.
Umělá inteligence dokáže na základě historie úkolů vypracovat aktualizace bezpečné pro zákazníky a interní souhrny, včetně aktuálního stavu podle závažnosti a týmu. Pro vedoucí pracovníky, jako je váš produktový ředitel, seskupujte chyby do iniciativ, aby mohli posoudit, zda kritické problémy s kvalitou ohrožují dodržování slibů ohledně termínů dodání.
Ukazatele, které je třeba sledovat: Doba mezi aktualizacemi stavu u chyb P0/P1, spokojenost zainteresovaných stran (CSAT) s komunikací.
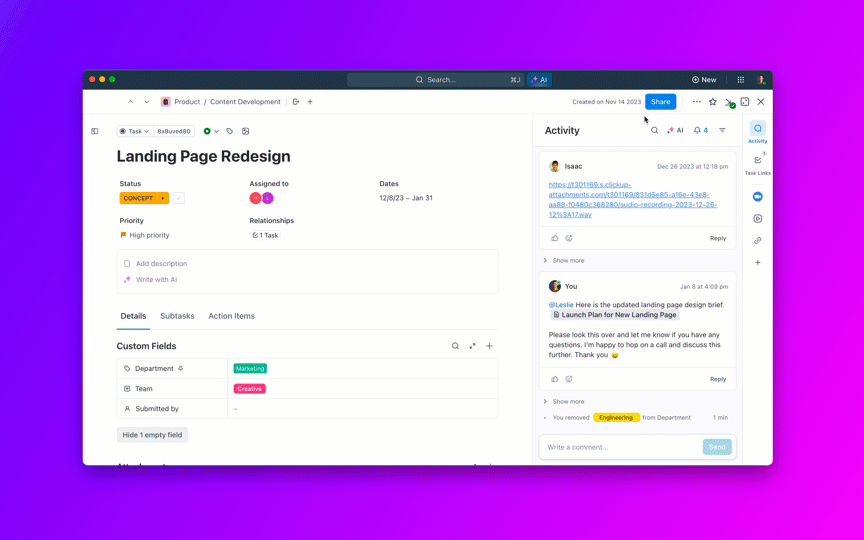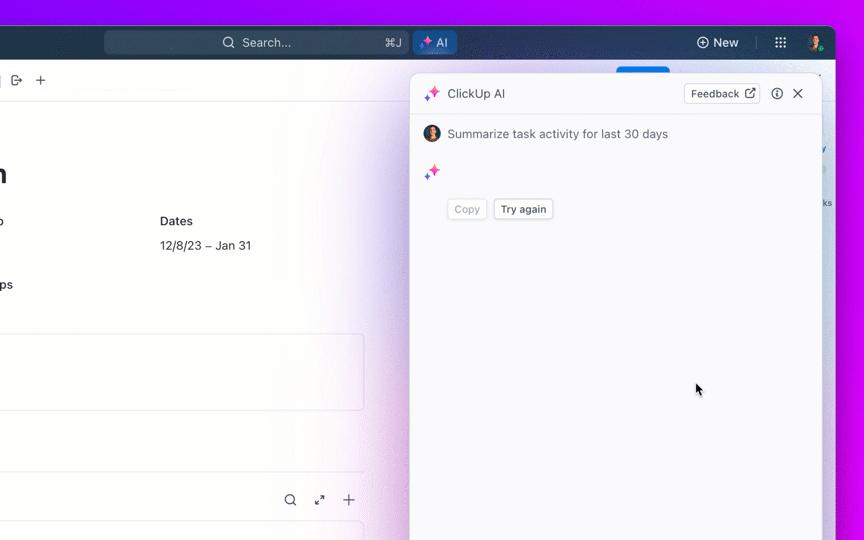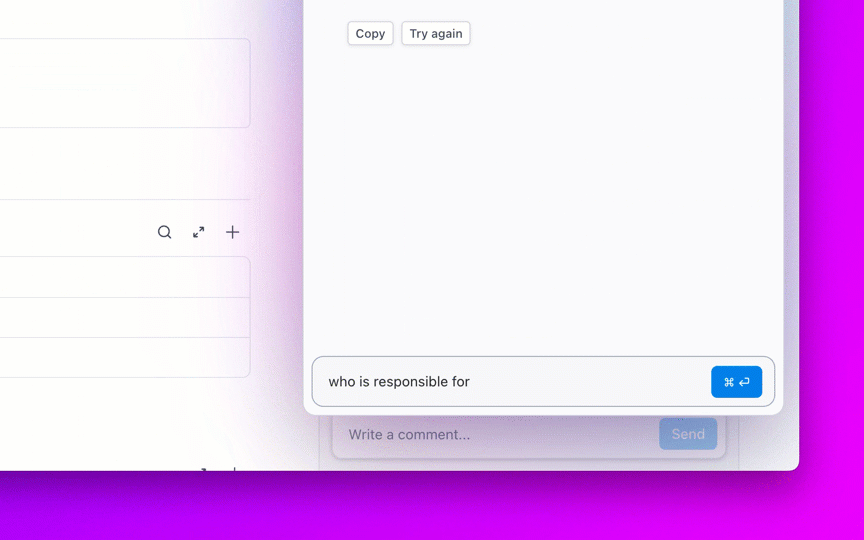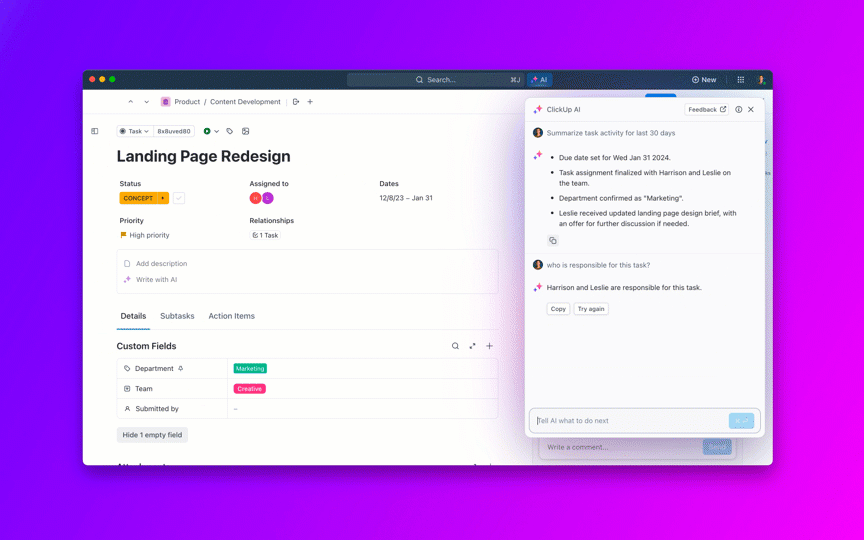
8. Řízení stáří nevyřízených úkolů a prevence „navždy otevřených“ úkolů
Rostoucí a neřešený backlog tiše zatěžuje každý sprint.
Nastavte pravidla pro stárnutí (např. P2 > 30 dní spustí přezkoumání, P3 > 90 dní vyžaduje zdůvodnění) a naplánujte si týdenní „třídění podle stáří“, abyste sloučili duplicity, uzavřeli zastaralé hlášení a převedli chyby s nízkou prioritou na položky produktového backlogu.
Využijte umělou inteligenci k seskupení nevyřízených úkolů podle témat (např. „vypršení platnosti autentizačního tokenu“, „nestabilita nahrávání obrázků“), abyste mohli naplánovat tematické týdny oprav a vyřešit celou skupinu chyb najednou.
Ukazatele, které je třeba sledovat: Počet nevyřešených úkolů podle věkového rozmezí, % problémů uzavřených jako duplicity/zastaralé, rychlost vyřizování úkolů podle témat.
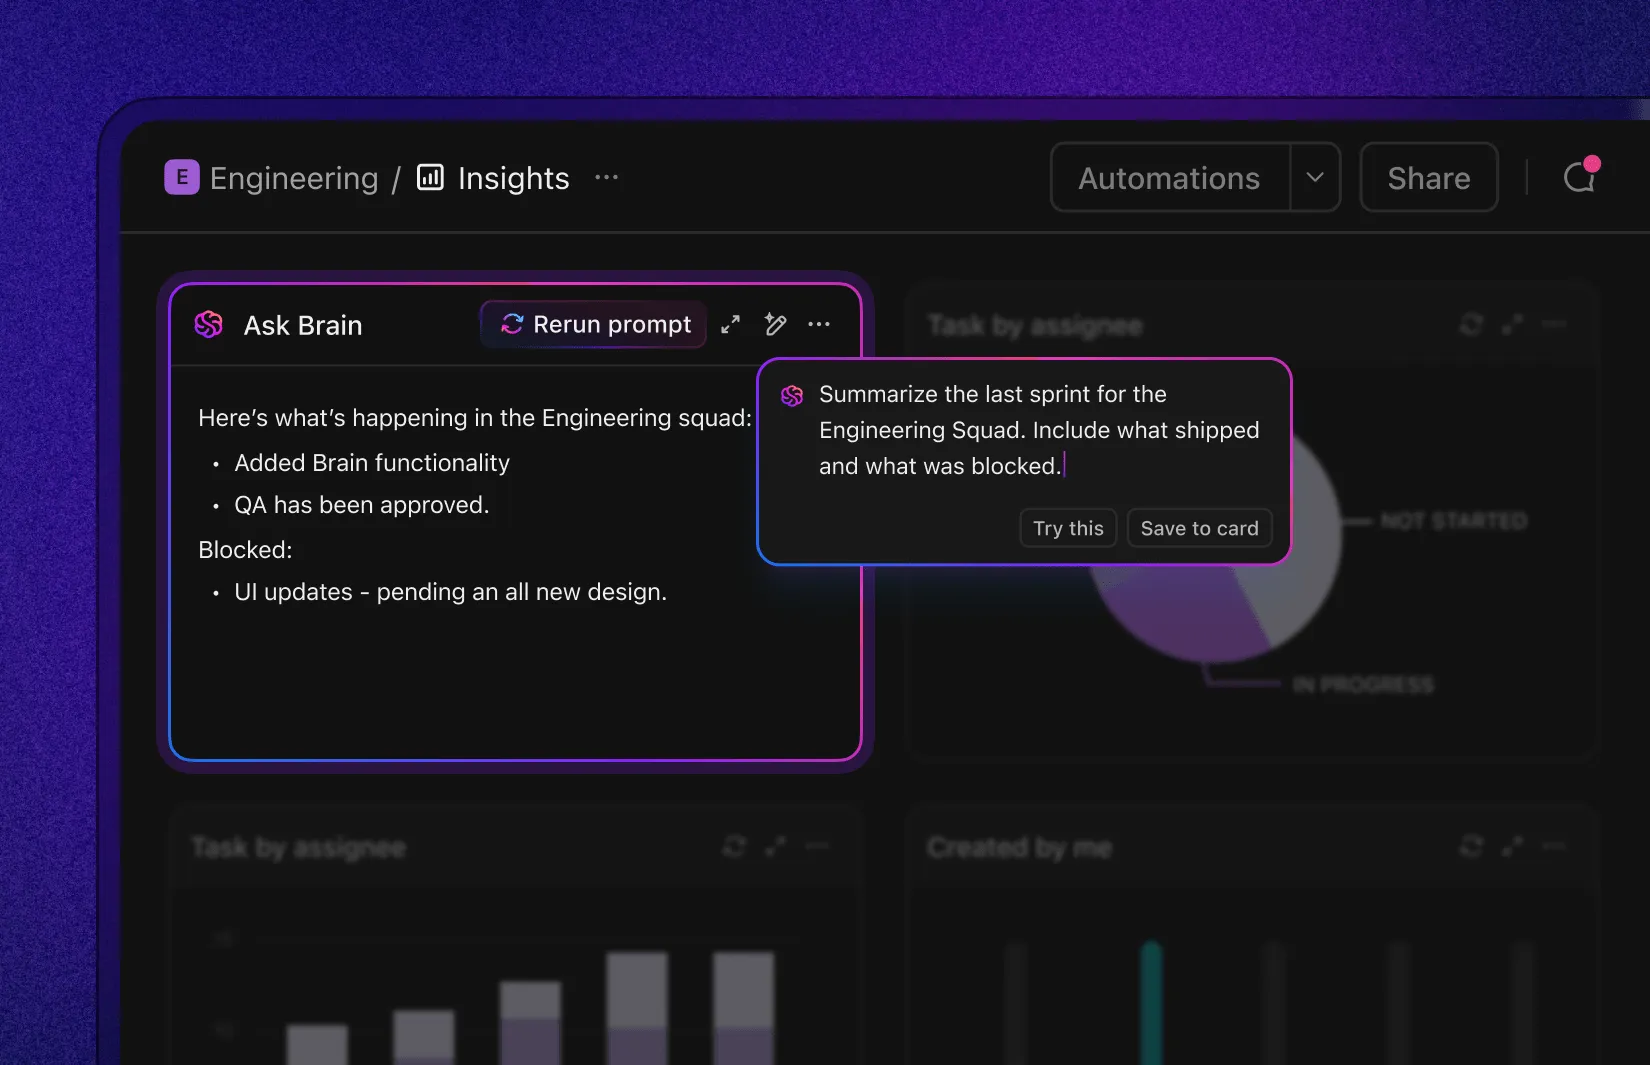
9. Uzavřete cyklus identifikací příčiny a prevencí
Pokud se stále opakuje stejný typ závady, vaše zlepšení v oblasti MTTR zakrývají větší problém.
Provádějte rychlou a objektivní analýzu kořenových příčin u chyb P0/P1 a často se vyskytujících chyb P2; označujte kořenové příčiny (mezery ve specifikacích, mezery v testování, mezery v nástrojích, nestabilita integrace), propojujte je s ovlivněnými komponentami a incidenty a sledujte následné úkoly (kontrolní mechanismy, testy, pravidla lint) až do jejich dokončení.
Umělá inteligence dokáže vypracovat souhrny analýzy příčin (RCA) a na základě historie změn navrhnout preventivní testy nebo pravidla pro kontrolu kódu. A právě tak se dostanete od hašení požárů k situaci, kdy jich bude méně.
Ukazatele, které je třeba sledovat: Míra opětovného otevření, míra regrese, doba mezi opakovanými výskytem a procentuální podíl analýz příčin (RCA) s dokončenými preventivními opatřeními.
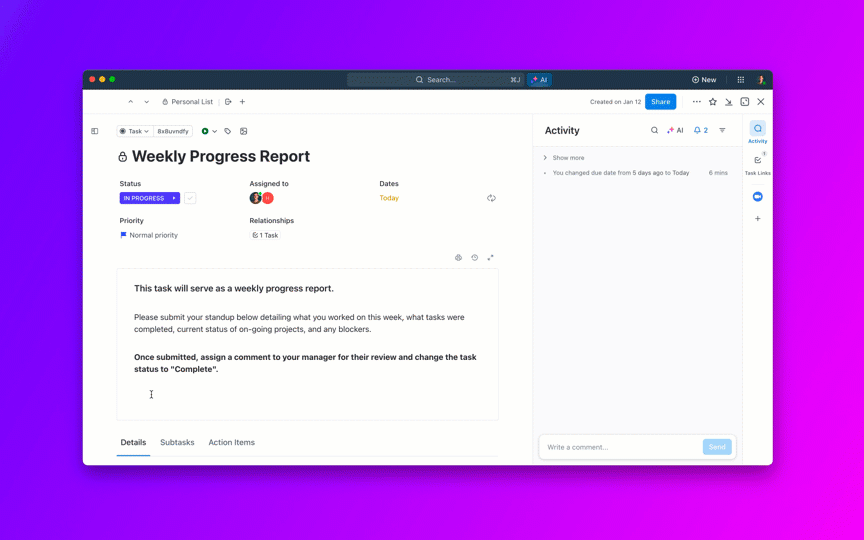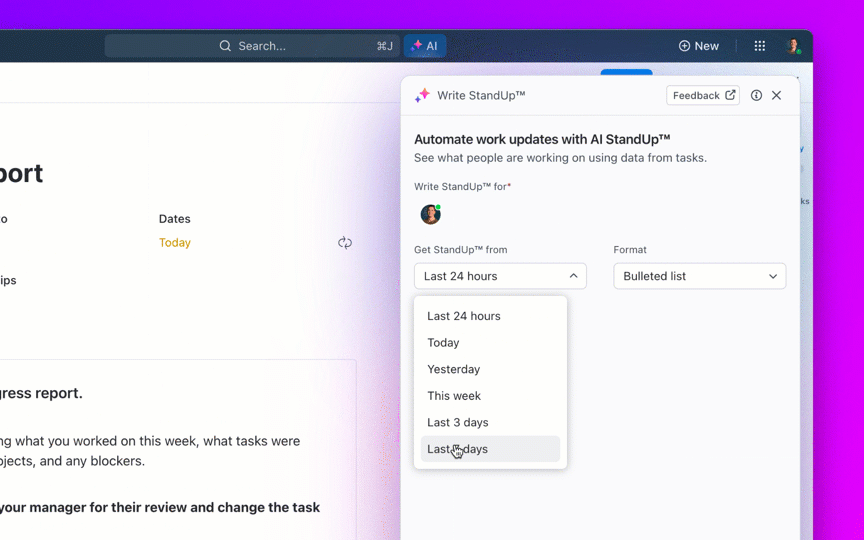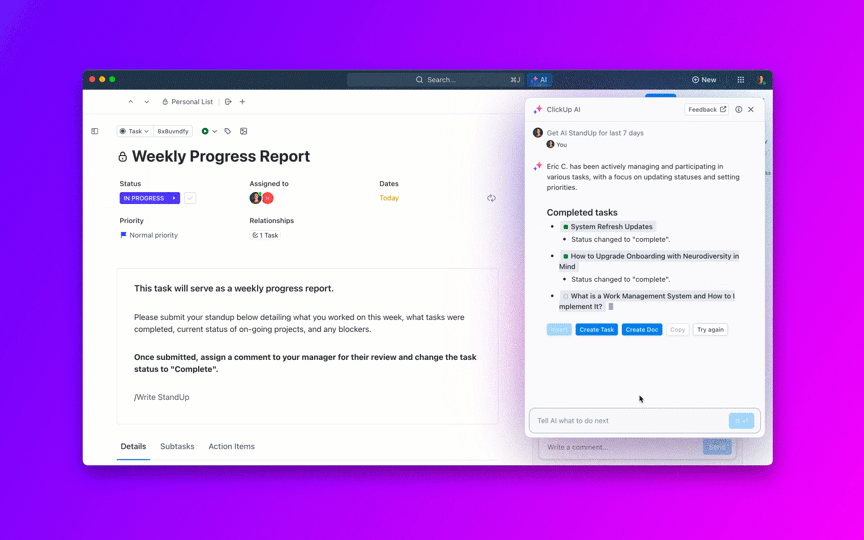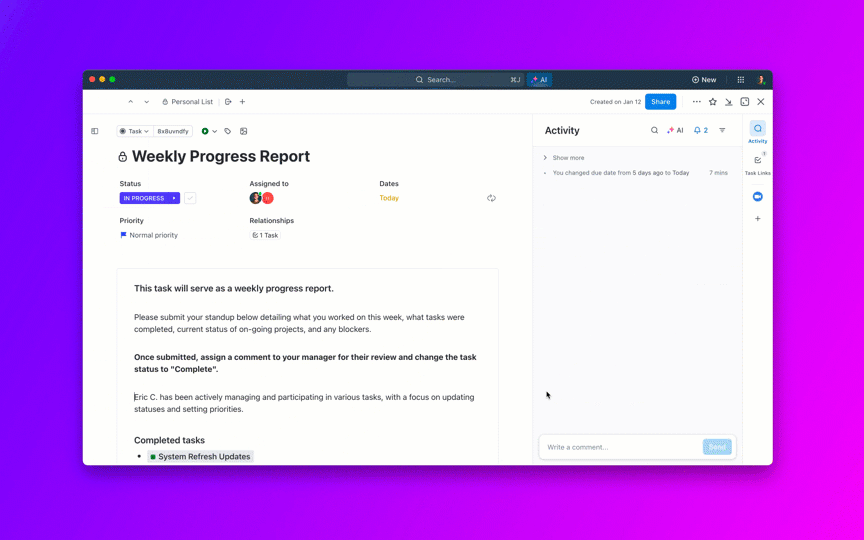
V souhrnu tyto změny zkracují celou cestu od začátku do konce: rychlejší potvrzení přijetí, přehlednější třídění, chytřejší stanovení priorit, méně zpoždění při kontrole a testování kvality a jasnější komunikace. Vedení získá předvídatelnost spojenou s CSAT/NPS a tržbami; pracovníci získají přehlednější frontu s menším počtem změn kontextu.
📖 Přečtěte si více: Jak provést analýzu příčin
Nástroje založené na umělé inteligenci, které pomáhají zkrátit dobu řešení chyb
Umělá inteligence může zkrátit dobu řešení v každé fázi – při přijetí, třídění, směrování, opravě i ověření.
Skutečné výhody však přinášejí až ty nástroje, které rozumějí kontextu a udržují práci v chodu bez nutnosti neustálého dohledu.
Hledejte systémy, které automaticky obohacují zprávy (kroky k reprodukci, prostředí, duplicity), řadí je podle dopadu, směrují je správnému vlastníkovi, vytvářejí jasné aktualizace a úzce se integrují s vaším kódem, CI a observabilitou.
Ty nejlepší z nich navíc podporují pracovní postupy podobné těm, jaké používají agenti: boti, kteří sledují SLA, upomínají recenzenty, eskalují zaseknuté položky a shrnují výsledky pro zainteresované strany. Zde je náš výběr nástrojů s umělou inteligencí pro lepší řešení chyb:
1. ClickUp (nejlepší pro kontextovou umělou inteligenci, automatizace a agentní pracovní postupy)
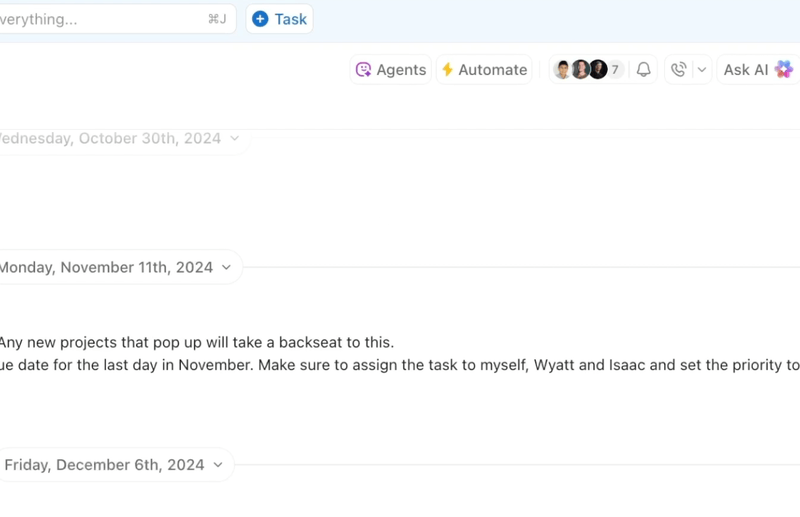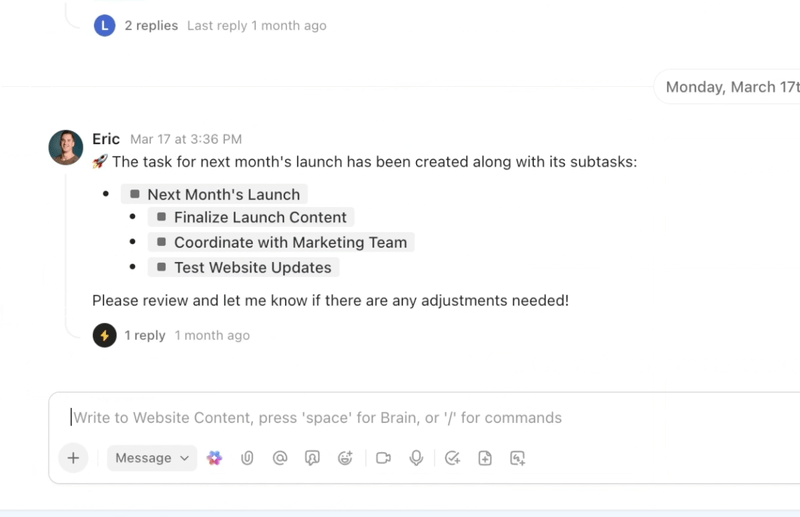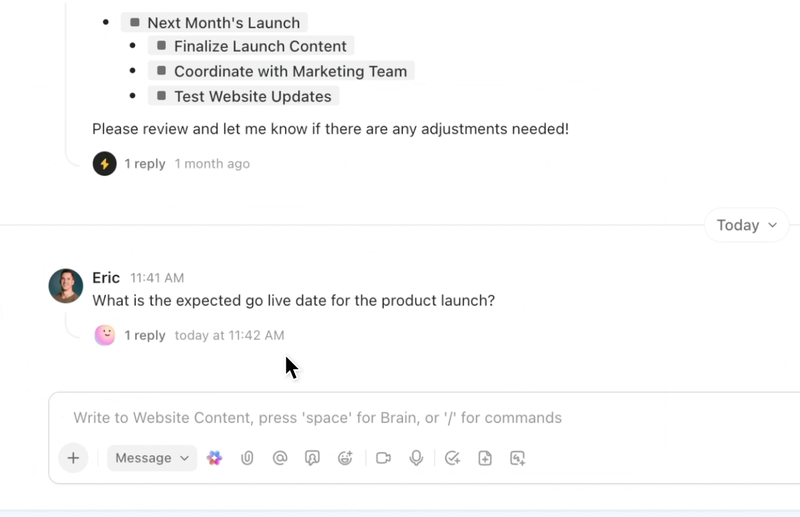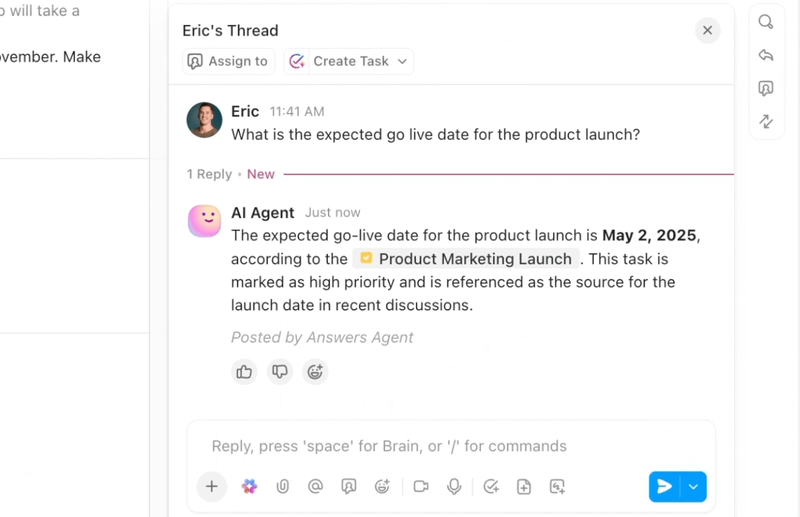
Pokud chcete efektivní a inteligentní pracovní postup pro řešení chyb, ClickUp, univerzální aplikace pro práci, spojuje umělou inteligenci, automatizace a asistenci při pracovních postupech na jednom místě.
ClickUp Brain okamžitě poskytuje správný kontext – shrnuje dlouhé vlákna týkající se chyb, extrahuje kroky k reprodukci a podrobnosti o prostředí z příloh, označuje pravděpodobné duplikáty a navrhuje další kroky. Místo toho, aby se týmy musely prohrabávat Slackem, tikety a protokoly, získají přehledný a obohacený záznam, na jehož základě mohou okamžitě jednat.
Automatizace a agenti Autopilot v ClickUp udržují práci v chodu bez nutnosti neustálého dohlížení. Chyby jsou automaticky směrovány do správného týmu, jsou jim přiřazeni vlastníci, nastaveny SLA a termíny, stavy se aktualizují podle postupu práce a zúčastněné strany dostávají včasná oznámení.
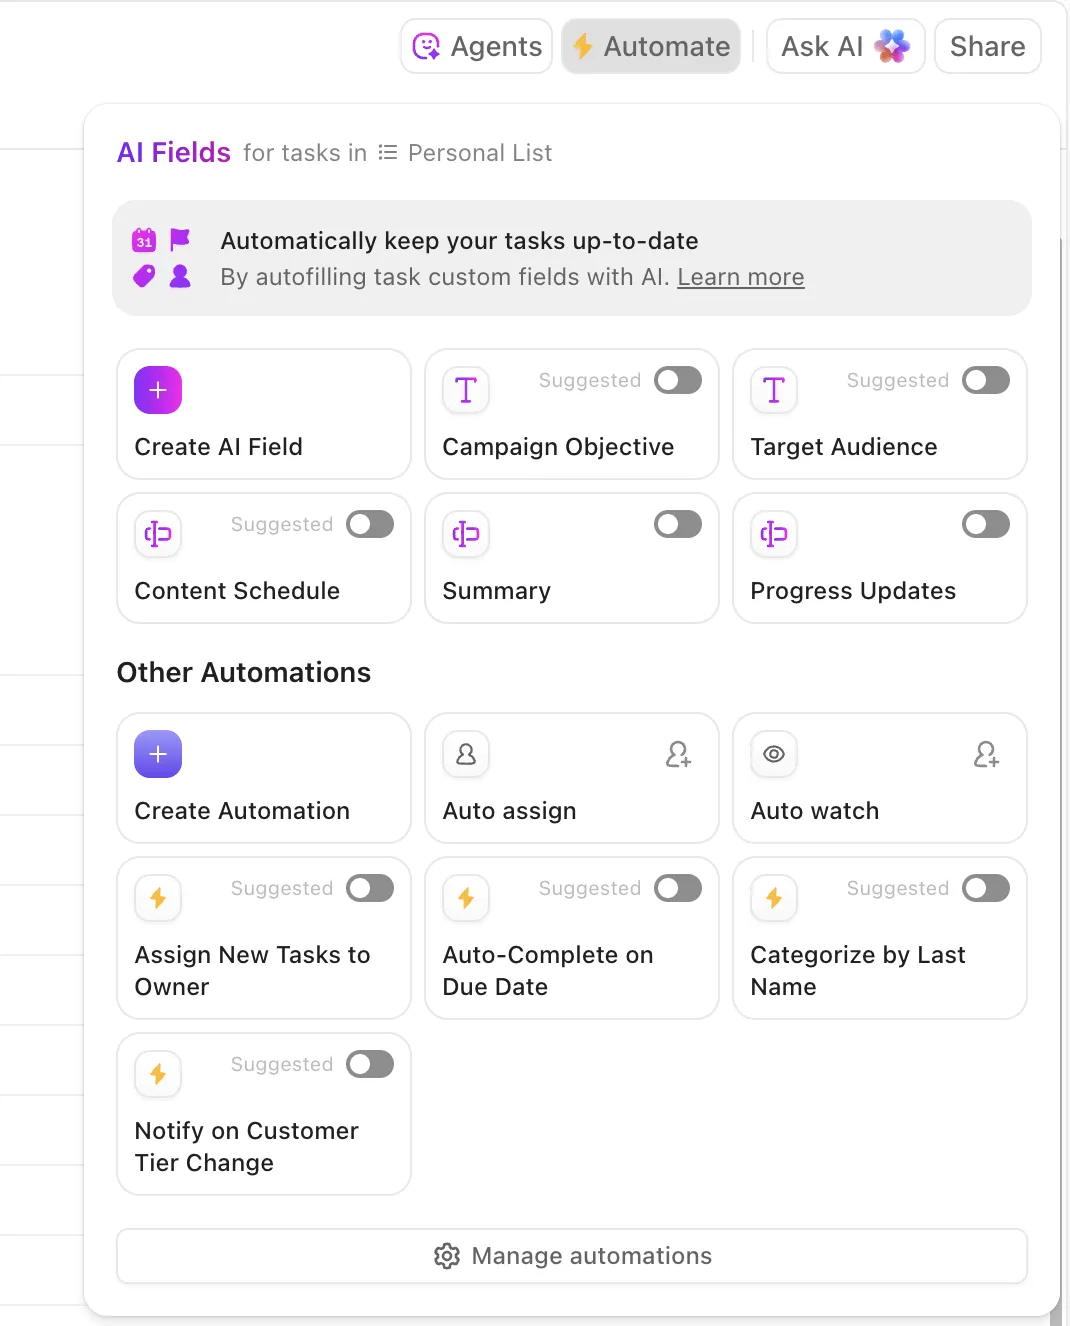
Tito agenti dokážou dokonce třídit a kategorizovat problémy, seskupovat podobná hlášení, vycházet z historických oprav a navrhovat pravděpodobné postupy řešení a eskalovat urgentní případy – takže hodnoty MTTA a MTTR klesají i při náhlém nárůstu objemu.
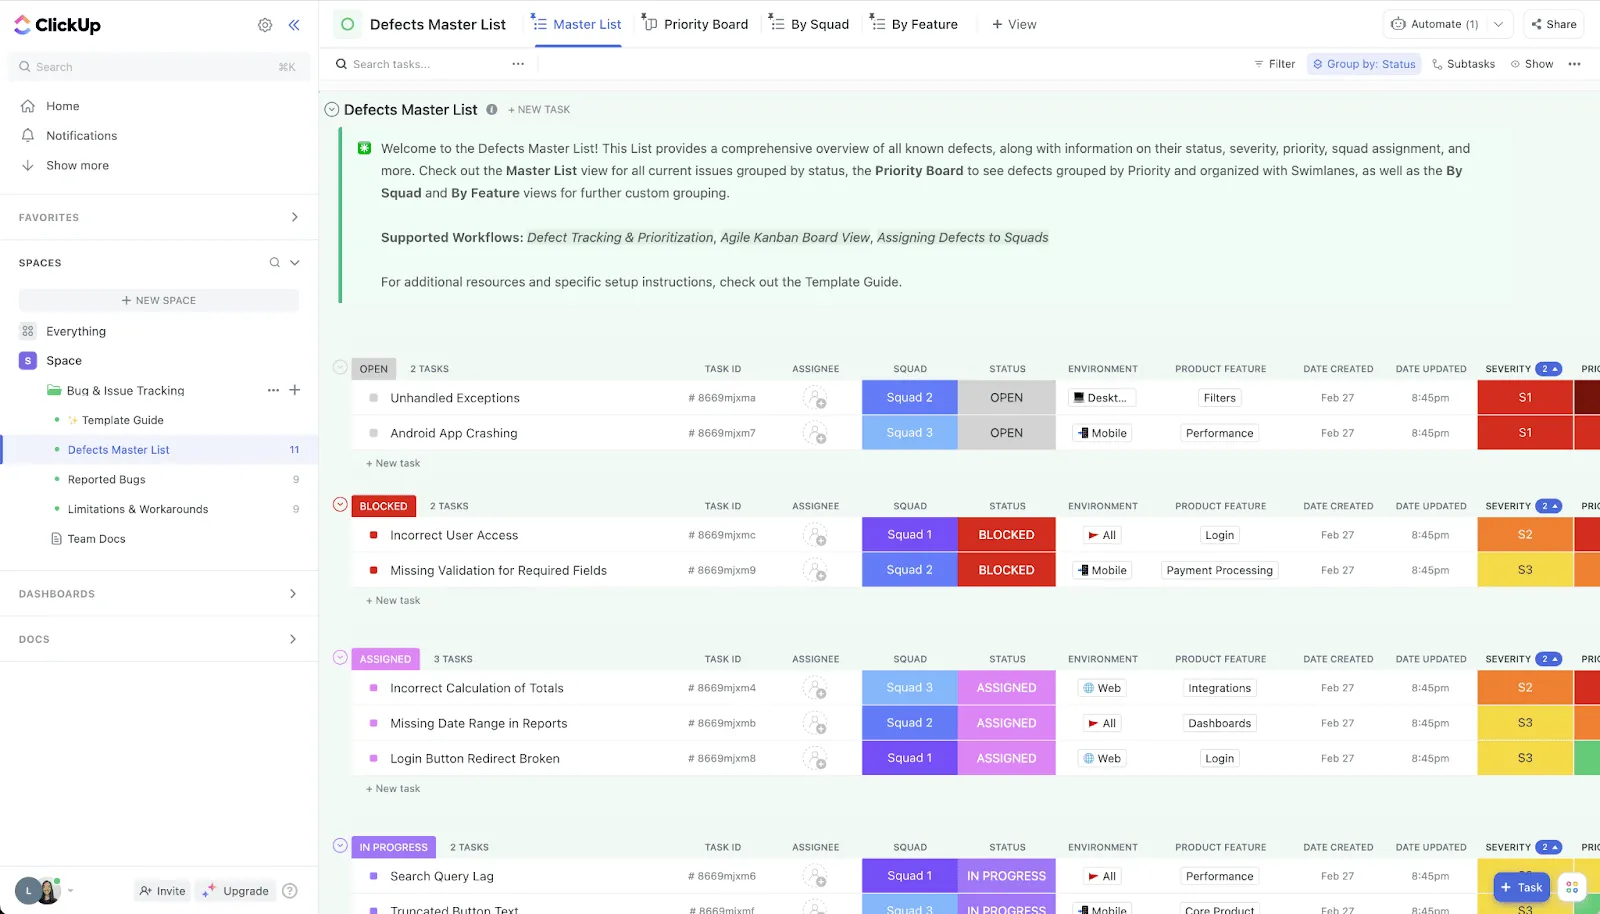
🛠️ Chcete sadu nástrojů připravenou k okamžitému použití? Šablona ClickUp pro sledování chyb a problémů je výkonné řešení od ClickUp for Software, které je navrženo tak, aby pomohlo týmům podpory, vývoje a produktovým týmům snadno udržet přehled o softwarových chybách a problémech. Díky přizpůsobitelným zobrazením, jako jsou Seznam, Tabule, Pracovní zátěž, Formulář a Časová osa, mohou týmy vizualizovat a spravovat svůj proces sledování chyb způsobem, který jim nejlépe vyhovuje.
Díky 20 vlastním stavům a 7 vlastním polím v této šabloně můžete vytvořit pracovní postup na míru a zajistit tak sledování každého problému od jeho zjištění až po vyřešení. Integrované automatizace se postarají o opakující se úkoly, čímž ušetříte drahocenný čas a snížíte manuální práci.
💟 Bonus: Brain MAX je váš desktopový pomocník s umělou inteligencí, který byl navržen tak, aby urychlil řešení chyb díky chytrým a praktickým funkcím.
Když narazíte na chybu, stačí použít funkci převodu řeči na text v Brain MAX a problém nadiktovat – vaše hlasové poznámky se okamžitě přepíší a lze je připojit k novému nebo stávajícímu tiketu s chybou. Funkce Enterprise Search prohledává všechny vaše propojené nástroje – jako ClickUp, GitHub, Google Drive a Slack – a vyhledává související hlášení o chybách, protokoly chyb, úryvky kódu a dokumentaci, takže máte k dispozici veškerý potřebný kontext, aniž byste museli přepínat mezi aplikacemi.
Potřebujete koordinovat opravu? Brain MAX vám umožní přiřadit chybu správnému vývojáři, nastavit automatická připomenutí pro aktualizace stavu a sledovat průběh – to vše přímo z vašeho počítače!
2. Sentry (nejlepší pro zachycování chyb)
Sentry zkracuje dobu MTTD a dobu potřebnou k reprodukci chyby tím, že shromažďuje chyby, trasování a uživatelské relace na jednom místě. Seskupování problémů pomocí umělé inteligence omezuje šum; funkce „Suspect Commit“ a pravidla pro přiřazování odpovědnosti identifikují pravděpodobného vlastníka kódu, takže směrování je okamžité. Funkce Session Replay poskytuje inženýrům přesnou uživatelskou cestu a podrobnosti o konzoli a síti, které umožňují reprodukci chyby bez nekonečného přeposílání.
Funkce Sentry AI dokážou shrnout kontext problému a v některých technologiích navrhnout opravy Autofix, které odkazují na problematický kód. Praktický dopad: méně duplicitních ticketů, rychlejší přiřazování a kratší cesta od nahlášení k funkční opravě.
3. GitHub Copilot (nejlepší pro rychlejší kontrolu kódu)
Copilot urychluje cyklus oprav přímo v editoru. Vysvětluje záznamy o zásobníku, navrhuje cílené opravy, píše jednotkové testy k ověření opravy a vytváří kostry skriptů pro reprodukci chyby.
Copilot Chat dokáže provést analýzu chybného kódu, navrhnout bezpečnější refaktoring a generovat komentáře nebo popisy pull requestů, které urychlují revizi kódu. V kombinaci s povinnými revizemi a CI zkracuje proces „diagnostika → implementace → testování“ o celé hodiny, zejména u chyb s jasně vymezeným rozsahem a s jasnou reprodukovatelností.
4. Snyk od DeepCode AI (nejlepší pro odhalování vzorců)
Statická analýza DeepCode založená na umělé inteligenci odhaluje chyby a nezabezpečené vzorce již během psaní kódu i v žádostech o pull (PR). Zvýrazňuje problematické toky, vysvětluje, proč k nim dochází, a navrhuje bezpečné opravy, které odpovídají idiomům vaší kódové základny.
Díky odhalování regresí ještě před sloučením a nasměrování vývojářů k bezpečnějším postupům snížíte počet nových chyb a urychlíte nápravu složitých logických chyb, které je při revizi obtížné odhalit. Díky integraci s IDE a PR se vše odehrává přímo tam, kde se pracuje.
5. Datadog Watchdog a AIOps (nejlepší pro analýzu protokolů)
Nástroj Watchdog od společnosti Datadog využívá strojové učení k odhalování anomálií v protokolech, metrikách, trasách a monitorování skutečných uživatelů. Koreluje výkyvy s ukazateli nasazení, změnami infrastruktury a topologií, aby navrhl pravděpodobné příčiny.
U chyb, které mají dopad na zákazníky, to znamená detekci během několika minut, automatické seskupování pro omezení nadměrného počtu upozornění a konkrétní vodítka k tomu, kde hledat. Doba třídění se zkracuje, protože začínáte s informacemi typu „tato implementace ovlivnila tyto služby a míra chybovosti na tomto koncovém bodě vzrostla“ namísto toho, abyste začínali s prázdným listem.
⚡️ Archiv šablon: Bezplatné šablony pro sledování problémů a protokolů v Excelu a ClickUp
6. New Relic AI (nejvhodnější pro identifikaci a shrnutí trendů)
Funkce Errors Inbox od New Relic seskupuje podobné chyby napříč službami a verzemi, zatímco její AI asistent shrnuje dopad, upozorňuje na pravděpodobné příčiny a poskytuje odkazy na příslušné trasování a transakce.
Díky korelacím nasazení a analýze změn entit je zřejmé, kdy je na vině nedávná verze. U distribuovaných systémů tento kontext šetří hodiny komunikace mezi týmy a zajišťuje, že se chyba dostane ke správnému vlastníkovi již s jasně formulovanou hypotézou.
7. Rollbar (nejlepší pro automatizované pracovní postupy)
Společnost Rollbar se specializuje na monitorování chyb v reálném čase s využitím inteligentního identifikování otisků, které umožňuje seskupovat duplicity a sledovat trendy výskytu. Její souhrny založené na umělé inteligenci a tipy na příčiny pomáhají týmům pochopit rozsah problému (postižení uživatelé, dotčené verze), zatímco telemetrie a záznamy o stavu zásobníku poskytují rychlé vodítka k reprodukci chyby.
Pravidla pracovních postupů Rollbaru mohou automaticky vytvářet úkoly, označovat závažnost a směrovat je k odpovědným osobám, čímž proměňují nepřehledné toky chyb v prioritní fronty s připojeným kontextem.
8. PagerDuty AIOps a automatizace runbooků (to nejlepší z diagnostiky s minimálními zásahy)
PagerDuty využívá korelaci událostí a redukci šumu založenou na strojovém učení k tomu, aby z velkého množství výstrah vytvořil konkrétní incidenty, na které lze reagovat.
Dynamické směrování okamžitě předá problém správnému pracovníkovi v pohotovosti, zatímco automatizace podle runbooků může spustit diagnostiku nebo nápravná opatření (restartovat služby, vrátit nasazení do předchozího stavu, přepnout příznak funkce) ještě předtím, než se do procesu zapojí člověk. Pokud jde o dobu řešení chyb, znamená to kratší MTTA, rychlejší nápravná opatření u chyb P0 a méně hodin ztracených kvůli únavě z výstrah.
Hlavním principem je automatizace a využití umělé inteligence v každém kroku. Chyby odhalíte dříve, chytřeji je nasměrujete, rychleji se dostanete ke kódu a budete informovat o stavu, aniž byste zpomalovali práci vývojářů – to vše přispívá k významnému zkrácení doby řešení chyb.
📖 Přečtěte si více: Jak využívat umělou inteligenci v DevOps
Příklady z praxe využití umělé inteligence při řešení chyb
Umělá inteligence tedy oficiálně opustila laboratoře. Ve skutečném prostředí zkracuje dobu řešení chyb.
Podívejme se, jak na to!
| Obor / Organizace | Jak byla využita umělá inteligence | Dopad / Přínos |
|---|---|---|
| Ubisoft | Vyvinuli jsme Commit Assistant, nástroj založený na umělé inteligenci, který byl vycvičen na základě interního kódu z uplynulého desetiletí a který předpovídá a předchází chybám již ve fázi programování. | Cílem je výrazně snížit časovou náročnost a náklady – až 70 % výdajů na vývoj her se tradičně vynakládá na opravy chyb. |
| Razer (platforma Wyvrn) | Spustili jsme nástroj QA Copilot využívající umělou inteligenci (integrovaný s Unreal a Unity) pro automatizaci detekce chyb a generování zpráv o kontrole kvality. | Zvyšuje detekci chyb až o 25 % a zkracuje dobu kontroly kvality na polovinu. |
| Google / DeepMind & Project Zero | Představili jsme Big Sleep, nástroj založený na umělé inteligenci, který autonomně detekuje bezpečnostní chyby v open-source softwaru, jako jsou FFmpeg a ImageMagick. | Bylo identifikováno 20 chyb, všechny ověřené lidskými odborníky a určené k opravě. |
| Výzkumníci z UC Berkeley | Pomocí benchmarku s názvem CyberGym analyzovaly modely umělé inteligence 188 open-source projektů, odhalily 17 zranitelností – včetně 15 dosud neznámých chyb typu „zero-day“ – a vygenerovaly exploity pro ověření koncepce. | Ukazuje, jak se umělá inteligence neustále zdokonaluje v detekci zranitelností a automatizovaném testování proti zneužití. |
| Spur (startup z Yale) | Vyvinuli jsme agenta využívajícího umělou inteligenci, který převádí popisy testovacích případů v běžném jazyce na automatizované testovací rutiny webových stránek – v podstatě se jedná o samopíšící pracovní postup kontroly kvality. | Umožňuje autonomní testování s minimálním zásahem člověka |
| Automatická reprodukce hlášení chyb v systému Android | Využili jsme NLP a posilovací učení k interpretaci jazyka hlášení chyb a generování kroků k reprodukci chyb v systému Android. | Dosáhli jsme 67 % přesnosti, 77 % recallu a reprodukovali jsme 74 % hlášení chyb, čímž jsme překonali tradiční metody. |
Časté chyby při měření doby řešení chyb
Pokud vaše měření nebude přesné, nebude přesný ani váš plán zlepšení.
Většina „špatných čísel“ v pracovních postupech řešení chyb pramení z nejasných definic, nekonzistentních pracovních postupů a povrchní analýzy.
Začněte tedy nejprve se základy – co se považuje za zahájení/ukončení, jak zacházet s čekáním a opětovným otevřením případů – a poté interpretujte data tak, jak je vnímají vaši zákazníci. To zahrnuje:
❌ Nejasné hranice: Kombinace kategorií „Nahlášené → Vyřešené“ a „Nahlášené → Uzavřené“ na stejném dashboardu (nebo jejich střídání z měsíce na měsíc) činí trendy bezvýznamnými. Vyberte si jednu hranici, zdokumentujte ji a prosazujte ji napříč týmy. Pokud potřebujete obě, zveřejněte je jako samostatné metriky s jasnými popisky.
❌ Přístup založený pouze na průměrech: Spoléhání se na průměr zakrývá skutečnost, že ve frontách se vyskytuje několik dlouhodobých výjimek. Pro „typickou“ dobu použijte medián (P50), pro předvídatelnost a SLA použijte P90 a průměr si ponechte pro plánování kapacity. Vždy se zaměřte na rozložení, ne jen na jedno číslo.
❌ Žádná segmentace: Slučování všech chyb dohromady mísí incidenty P0 s kosmetickými chybami P3. Segmentujte podle závažnosti, zdroje (zákazník vs. QA vs. monitorování), komponenty/týmu a „nové vs. regrese“. Vaše P0/P1 P90 odráží to, co vnímají zainteresované strany; vaše mediánová hodnota P2+ je základem pro plánování vývoje.
❌ Ignorování „pozastaveného“ času: Čekáte na protokoly od zákazníků, externího dodavatele nebo termín vydání? Pokud nesledujete stavy „Blokováno“/„Pozastaveno“ jako plnohodnotné stavy, stane se doba řešení předmětem sporů. Uvádějte jak kalendářní čas, tak aktivní čas, aby byly viditelné úzká místa a debaty ustaly.
❌ Rozdíly v normalizaci času: Kombinování časových pásem nebo přepínání mezi pracovními a kalendářními hodinami v průběhu procesu zkresluje srovnání. Normalizujte časová razítka na jedno časové pásmo (nebo UTC) a jednou se rozhodněte, zda se SLA měří v pracovních nebo kalendářních hodinách; tento přístup pak důsledně dodržujte.
❌ Nesprávné zadání a duplicity: Chybějící informace o prostředí či sestavení a duplicitní tikety prodlužují dobu řešení a znesnadňují určení odpovědnosti. Standardizujte povinná pole při zadání, automaticky doplňujte údaje (protokoly, verzi, zařízení) a odstraňujte duplicity bez resetování doby řešení – duplicitní tikety uzavírejte jako propojené, nikoli jako „nové“ problémy.
❌ Nekonzistentní modely stavů: Vlastní stavy („Téměř připraveno pro QA“, „Čeká na kontrolu 2“) zakrývají dobu setrvání ve stavu a činí přechody mezi stavy nespolehlivými. Definujte standardní pracovní postup (Nové → Tříděno → Probíhá → V kontrole → Vyřešeno → Uzavřeno) a provádějte audity stavů mimo tento postup.
❌ Ignorování doby strávené v jednotlivých stavech: Jediný údaj o „celkové době“ vám neřekne, kde dochází ke zpoždění práce. Sledujte a vyhodnocujte čas strávený ve stavech „Tříděno“, „Ve revizi“, „Blokováno“ a „QA“. Pokud 90. percentil revize kódu výrazně převyšuje implementaci, řešením není „rychlejší programování“, ale uvolnění kapacit pro revizi.
🧠 Zajímavost: Nejnovější soutěž DARPA AI Cyber Challenge předvedla průlomový pokrok v automatizaci kyberbezpečnosti. V soutěži se představily systémy umělé inteligence navržené tak, aby autonomně detekovaly, zneužily a opravily zranitelnosti v softwaru – bez lidského zásahu. Vítězný tým „Team Atlanta“ působivě odhalil 77 % vložených chyb a 61 % z nich úspěšně opravil, čímž demonstroval schopnost umělé inteligence nejen nacházet chyby, ale také je aktivně opravovat.
❌ „Slepota“ vůči znovu otevřeným chybám: Pokud se znovu otevřené chyby považují za nové, resetuje se čas a zkracuje se MTTR. Sledujte míru znovu otevření a „čas do stabilního uzavření“ (od prvního nahlášení po konečné uzavření napříč všemi cykly). Rostoucí počet znovu otevřených chyb obvykle poukazuje na špatnou reprodukovatelnost, mezery v testování nebo nejasnou definici „hotovo“.
❌ Chybí MTTA: Týmy se příliš soustředí na MTTR a ignorují MTTA (doba potvrzení/převzetí odpovědnosti). Vysoká hodnota MTTA je včasným varováním, že řešení bude trvat dlouho. Měřte ji, nastavte SLA podle závažnosti a automatizujte směrování a eskalaci, abyste ji udrželi na nízké úrovni.
❌ AI/automatizace bez kontrolních mechanismů: Pokud necháte AI určovat závažnost nebo uzavírat duplicitní hlášení bez kontroly, může dojít k nesprávné klasifikaci okrajových případů a k nepozorovanému zkreslení metrik. Využijte AI k navrhování řešení, vyžadujte lidské potvrzení u chyb P0/P1 a každý měsíc provádějte audit výkonu modelu, aby vaše data zůstala důvěryhodná.
Zlepšete tyto procesy a vaše grafy doby řešení budou konečně odrážet skutečnost. Odtud se zlepšení znásobí: lepší přijímání případů zkracuje MTTA, přehlednější stavy odhalují skutečná úzká místa a segmentované hodnoty P90 poskytují vedoucím pracovníkům sliby, které můžete splnit.
⚡️ Archiv šablon: 10 šablon testovacích případů pro testování softwaru
Osvědčené postupy pro lepší řešení chyb
Závěrem zde uvádíme klíčové body, které je třeba mít na paměti!
| 🧩 Osvědčené postupy | 💡 Co to znamená | 🚀 Proč je to důležité |
| Využijte robustní systém pro sledování chyb | Sledujte všechny nahlášené chyby pomocí centralizovaného systému pro sledování chyb. | Zajišťuje, že žádná chyba nezůstane bez povšimnutí, a umožňuje přehled o stavu chyb napříč týmy. |
| Vytvářejte podrobné zprávy o chybách | Uveďte vizuální kontext, informace o operačním systému, kroky k reprodukci a závažnost. | Pomáhá vývojářům opravovat chyby rychleji díky tomu, že mají všechny podstatné informace k dispozici hned na začátku. |
| Kategorizujte a určujte priority chyb | Pomocí matice priorit třídte chyby podle naléhavosti a dopadu. | Díky tomu se tým nejprve soustředí na kritické chyby a naléhavé problémy. |
| Využijte automatizované testování | Spouštějte testy automaticky ve vašem CI/CD pipeline. | Podporuje včasnou detekci a předchází regresím. |
| Stanovte jasné pokyny pro podávání zpráv | Poskytněte šablony a školení o tom, jak hlásit chyby. | Výsledkem jsou přesné informace a plynulejší komunikace. |
| Sledujte klíčové ukazatele | Měřte dobu vyřešení, uplynulý čas a dobu odezvy. | Umožňuje sledování a zlepšování výkonu na základě historických dat. |
| Zvolte proaktivní přístup | Nečekejte, až si uživatelé začnou stěžovat – testujte proaktivně. | Zvyšuje spokojenost zákazníků a snižuje zátěž podpory. |
| Využijte chytré nástroje a strojové učení | Využijte strojové učení k předpovídání chyb a navrhování oprav. | Zvyšuje efektivitu při identifikaci příčin a opravě chyb. |
| Dodržujte SLA | Dodržujte dohodnuté smlouvy o úrovni služeb (SLA) týkající se řešení problémů. | Budujte důvěru a včas splňujte očekávání klientů. |
| Neustále provádějte revize a vylepšujte | Analyzujte znovu otevřené chyby, sbírejte zpětnou vazbu a vylepšujte procesy. | Podporuje neustálé zlepšování vašeho vývojového procesu a správy chyb. |
Snadné řešení chyb díky kontextové umělé inteligenci
Nejrychlejší týmy pro řešení chyb nespoléhají na hrdinské výkony. Navrhují systém: jasné definice začátku a konce, přehledné přijímání hlášení, prioritizaci podle dopadu na podnikání, jasné určení odpovědnosti a těsné zpětné vazby mezi podporou, kontrolou kvality, vývojem a vydáváním verzí.
ClickUp může být tím řídicím centrem poháněným umělou inteligencí pro váš systém řešení chyb. Centralizujte všechny hlášení do jedné fronty, standardizujte kontext pomocí strukturovaných polí a nechte umělou inteligenci ClickUp třídit, shrnovat a stanovovat priority, zatímco automatizace zajistí dodržování SLA, eskalují v případě zpoždění a udržují všechny zúčastněné strany v obraze. Propojte chyby se zákazníky, kódem a verzemi, aby vedoucí pracovníci viděli dopad a odborníci mohli pokračovat v práci.
Pokud jste připraveni zkrátit dobu řešení chyb a zvýšit předvídatelnost svého plánu, zaregistrujte se na ClickUp a začněte měřit zlepšení v řádu dnů, nikoli čtvrtletí.
Často kladené otázky
Jaká je přijatelná doba řešení chyb?
Neexistuje jediná „správná“ hodnota – záleží na závažnosti, modelu vydávání verzí a toleranci rizika. Pro „typický“ výkon použijte mediány (P50) a pro sliby/SLA hodnotu P90, a data rozdělte podle závažnosti a zdroje.
Jaký je rozdíl mezi vyřešením chyby a uzavřením chyby?
O vyřešení se jedná v momentě, kdy je implementována oprava (např. sloučen kód, aplikována konfigurace) a tým považuje chybu za odstraněnou. O uzavření se jedná v momentě, kdy je problém ověřen a formálně dokončen (např. ověřen týmem QA v cílovém prostředí, vydán nebo označen jako „nebude opraven“/„duplikát“ s odůvodněním). Mnoho týmů měří obojí: poměr „nahlášených → vyřešených“ odráží rychlost vývoje; poměr „nahlášených → uzavřených“ odráží kvalitu celého procesu. Používejte jednotné definice, aby se ve přehledech nemíchaly jednotlivé fáze.
Jaký je rozdíl mezi dobou řešení chyb a dobou jejich detekce?
Doba detekce (MTTD) udává, jak dlouho trvá odhalení chyby po jejím vzniku nebo vydání – ať už prostřednictvím monitorování, kontroly kvality nebo uživatelů. Doba řešení udává, jak dlouho trvá od detekce/nahlášení až po implementaci opravy (a případně i její ověření/vydání). Společně definují časové okno dopadu na zákazníka: rychlá detekce, rychlé potvrzení, rychlé řešení a bezpečné vydání. Můžete také sledovat MTTA (doba do potvrzení/přiřazení), abyste odhalili zpoždění při třídění, která často předznamenávají delší dobu řešení.
Jak umělá inteligence pomáhá při řešení chyb?
Umělá inteligence zkracuje cykly, které obvykle proces zpomalují: přijetí, třídění, diagnostiku, opravu a ověření.
- Příjem a třídění: Automaticky shrnuje dlouhé zprávy, extrahuje kroky k reprodukci chyby a popis prostředí, označuje duplicity a navrhuje závažnost a prioritu, aby inženýři mohli začít s přehledným kontextem (např. ClickUp AI, Sentry AI).
- Směrování a SLA: Předpovídá pravděpodobnou komponentu/vlastníka, nastavuje časovače a eskaluje, když dojde k prodlení s MTTA nebo čekáním na kontrolu – čímž se snižuje nečinný „čas ve stavu“ (ClickUp Automations a pracovní postupy podobné práci agentů).
- Diagnostika: Seskupuje podobné chyby, přiřazuje výkyvy k nedávným commitům/vydáním a poukazuje na pravděpodobné příčiny pomocí trasování zásobníku a kontextu kódu (Sentry AI a podobné nástroje).
- Implementace: Navrhuje změny v kódu a testy na základě vzorců z vašeho repozitáře, čímž urychluje cyklus „napsat/opravit“ (GitHub Copilot; Snyk Code AI od DeepCode).
- Ověřování a komunikace: vytváří testovací případy na základě kroků k reprodukci chyby, připravuje poznámky k vydání a aktualizace pro zainteresované strany a shrnuje stav pro vedení a zákazníky (ClickUp AI). Při společném použití – ClickUp jako řídicí centrum ve spojení s nástroji Sentry, Copilot a DeepCode – týmy zkracují časy MTTA a P90, aniž by se musely spoléhat na hrdinské výkony jednotlivých členů.