
Bot pro zákaznický servis, který se učí z každé interakce. Prodejní asistent, který přizpůsobuje svou strategii na základě poznatků v reálném čase. Nejedná se pouze o koncepty – díky učícím se agentům v oblasti umělé inteligence jsou realitou.
V ClickUp se tento stejný koncept objevuje jako Super Agents , AI spolupracovníci, kteří využívají učící smyčky k dosažení výsledků v rámci vícestupňových pracovních postupů, místo aby se zastavili u jediné odpovědi.
Co však činí tyto agenty jedinečnými a jak funguje učící se agent, aby dosáhl této přizpůsobivosti?
Na rozdíl od tradičních systémů umělé inteligence, které fungují na základě pevného programování, se učící agenti vyvíjejí.
V průběhu času se přizpůsobují, zdokonalují a vylepšují své činnosti, což z nich činí nepostradatelné prvky v odvětvích, jako jsou autonomní vozidla a zdravotnictví, kde jsou flexibilita a přesnost nezbytnou podmínkou.
Představte si je jako umělou inteligenci, která se díky zkušenostem stává chytřejší, stejně jako lidé.
V tomto blogu se podíváme na klíčové komponenty, procesy, typy a aplikace učících se agentů v oblasti umělé inteligence. 🤖
⏰ 60sekundové shrnutí
Zde je stručný úvod do učících se agentů v oblasti umělé inteligence:
Co dělají: Přizpůsobují se prostřednictvím interakcí, např. boti v zákaznickém servisu vylepšují své odpovědi.
Hlavní oblasti využití: robotika, personalizované služby a inteligentní systémy, jako jsou domácí zařízení.
Základní komponenty:
- Vzdělávací prvek: Shromažďuje znalosti za účelem zlepšení výkonu
- Prvek výkonu: Provádí úkoly na základě nabytých znalostí
- Kritik: Vyhodnocuje akce a poskytuje zpětnou vazbu
- Generátor problémů: Identifikuje příležitosti pro další učení
Metody učení:
- Učení s dohledem: Rozpoznává vzorce pomocí označených dat
- Učení bez dohledu: Identifikuje struktury v neoznačených datech
- Posilovací učení: Učí se metodou pokusů a omylů
Dopad v praxi: Zvyšuje přizpůsobivost, efektivitu a zlepšuje rozhodování v různých odvětvích.
⚙️ Bonus: Cítíte se zahlceni odbornou terminologií z oblasti umělé inteligence? Prohlédněte si náš obsáhlý slovníček pojmů z oblasti umělé inteligence, díky kterému snadno porozumíte základním konceptům i pokročilé terminologii.
Co jsou to učící se agenti v oblasti umělé inteligence?
Učící se agenti v oblasti umělé inteligence jsou systémy, které se v průběhu času zdokonalují tím, že se učí ze svého prostředí. Přizpůsobují se, činí chytřejší rozhodnutí a optimalizují své akce na základě zpětné vazby a dat.
Na rozdíl od tradičních systémů umělé inteligence, které zůstávají neměnné, se učící agenti neustále vyvíjejí. Díky tomu jsou nepostradatelní v robotice a při personalizovaných doporučeních, kde jsou podmínky nepředvídatelné a neustále se mění.
🔍 Věděli jste, že... Učící se agenti fungují na principu zpětné vazby – vnímají prostředí, učí se ze zpětné vazby a zdokonalují své akce. Tento přístup je inspirován způsobem, jakým se lidé učí ze zkušeností.
Klíčové komponenty učících se agentů
Učící se agenti se obvykle skládají z několika propojených komponent, které spolupracují, aby zajistily přizpůsobivost a postupné zdokonalování.
Zde jsou některé klíčové součásti tohoto procesu učení. 📋
Vzdělávací prvek
Hlavním úkolem agenta je získávat znalosti a zlepšovat výkon prostřednictvím analýzy dat, interakcí a zpětné vazby.
Pomocí technik umělé inteligence, jako je učení s dohledem, učení s posilováním a učení bez dohledu, agent přizpůsobuje a aktualizuje své chování s cílem zlepšit svou funkčnost.
📌 Příklad: Virtuální asistent, jako je Siri, se postupem času učí preference uživatele, například často používané příkazy nebo specifické přízvuky, aby mohl poskytovat přesnější a personalizovanější odpovědi.
Prvek výkonu
Tato součást provádí úkoly tím, že interaguje s prostředím a přijímá rozhodnutí na základě dostupných informací. Jedná se v podstatě o „akční rameno“ agenta.
📌 Příklad: V autonomních vozidlech prvek výkonu zpracovává dopravní data a podmínky okolí, aby mohl v reálném čase přijímat rozhodnutí, jako je zastavení na červenou nebo vyhýbání se překážkám.
Kritika
Kritik vyhodnocuje akce provedené výkonovým prvkem a poskytuje zpětnou vazbu. Tato zpětná vazba pomáhá učícímu se prvku identifikovat, co fungovalo dobře a co je třeba zlepšit.
📌 Příklad: V doporučovacím systému analyzuje hodnotitel interakce uživatelů (například kliknutí nebo přeskočení) s cílem určit, která doporučení byla úspěšná, a pomáhá učiícímu se prvku vylepšovat budoucí doporučení.
Generátor problémů
Tato součást podporuje zkoumání tím, že navrhuje nové scénáře nebo akce, které může agent vyzkoušet.
To agenta posouvá za hranice jeho komfortní zóny a zajišťuje tak jeho neustálé zdokonalování. Agent také předchází neoptimálním výsledkům tím, že rozšiřuje rozsah svých zkušeností.
📌 Příklad: V oblasti umělé inteligence v e-commerce může generátor problémů navrhovat personalizované marketingové strategie nebo simulovat vzorce chování zákazníků. To pomáhá umělé inteligenci zdokonalit její přístup a poskytovat doporučení přizpůsobená různým preferencím uživatelů.
Učební proces v učících se agentech
Učící se agenti se při přizpůsobování a zdokonalování opírají především o tři klíčové kategorie. Ty jsou popsány níže. 👇
1. Učení s dohledem
Agent se učí z označených datových sad, kde každý vstup odpovídá konkrétnímu výstupu.
Tato metoda vyžaduje pro trénování velké množství přesně označených dat a je široce využívána v aplikacích, jako je rozpoznávání obrazu, překlad jazyků a odhalování podvodů.
📌 Příklad: Systém filtrování e-mailů se na základě historických dat učí klasifikovat e-maily jako spam nebo ne. Učící se prvek identifikuje vzorce mezi vstupy (obsah e-mailů) a výstupy (klasifikační štítky), aby mohl provádět přesné předpovědi.
2. Učení bez dohledu
Při analýze informací bez explicitních štítků se v datech objevují skryté vzorce nebo vztahy. Tento přístup se osvědčuje při detekci anomálií, vytváření doporučovacích systémů a optimalizaci komprese dat.
Pomáhá také identifikovat poznatky, které nemusí být na základě označených dat okamžitě zřejmé.
📌 Příklad: Segmentace zákazníků v marketingu umožňuje seskupovat uživatele na základě jejich chování za účelem navrhování cílených kampaní. Důraz je kladen na pochopení struktury a vytváření klastrů či asociací.
3. Posilovací učení
Na rozdíl od výše uvedeného zahrnuje posilovací učení (RL) agenty, kteří provádějí akce v daném prostředí s cílem maximalizovat kumulativní odměny v průběhu času.
Agent se učí metodou pokusů a omylů a získává zpětnou vazbu prostřednictvím odměn nebo trestů.
🔔 Pamatujte: Volba metody učení závisí na daném problému, dostupnosti dat a složitosti prostředí. Posilovací učení je zásadní pro úkoly bez přímého dohledu, protože k přizpůsobení akcí využívá zpětnovazební smyčky.
Techniky posilovacího učení
- Iterace politiky: Optimalizuje očekávané odměny přímým učením se politiky, která přiřazuje stavy k akcím
- Iterace hodnoty: Určuje optimální akce výpočtem hodnoty každé dvojice stav-akce
- Metody Monte Carlo: Simulují různé budoucí scénáře za účelem předpovědi odměn za akce; jsou užitečné zejména v dynamických a pravděpodobnostních prostředích.
Příklady reálných aplikací RL
- Autonomní řízení: Algoritmy RL učí vozidla bezpečně navigovat, optimalizovat trasy a přizpůsobovat se dopravní situaci tím, že se neustále učí ze simulovaných prostředí.
- AlphaGo a herní AI: Díky posilovacímu učení dokázal program AlphaGo od Googlu porazit lidské šampiony tím, že se naučil optimální strategie pro složité hry, jako je Go.
- Dynamické stanovování cen: E-commerce platformy využívají RL k přizpůsobování cenových strategií na základě vzorců poptávky a kroků konkurence s cílem maximalizovat tržby
🧠 Zajímavost: Učící se agenti porazili lidské šampiony v hrách jako šachy a Starcraft, čímž prokázali svou přizpůsobivost a inteligenci.
Přístupy založené na Q-učení a neuronových sítích
Q-learning je široce používaný algoritmus učení z výkonu (RL), při kterém se agenti učí hodnotu každé dvojice stav-akce prostřednictvím průzkumu a zpětné vazby. Agent vytváří Q-tabulku, což je matice, která přiřazuje očekávané odměny dvojicím stav-akce.
Vybere akci s nejvyšší hodnotou Q a iterativně vylepšuje svou tabulku, aby zvýšil přesnost.
📌 Příklad: Dron poháněný umělou inteligencí, který se učí efektivně doručovat balíčky, využívá k vyhodnocování tras metodu Q-learning. Činí tak tím, že přiřazuje odměny za včasná doručení a tresty za zpoždění nebo kolize. Postupem času vylepšuje svou Q-tabulku, aby si vybral nejúčinnější a nejbezpečnější doručovací trasy.
Q-tabulky se však v komplexních prostředích s vysokorozměrnými stavovými prostory stávají nepraktickými.
Zde vstupují do hry neuronové sítě, které Q-hodnoty aproximují, místo aby je explicitně ukládaly. Tato změna umožňuje posilovacímu učení řešit složitější problémy.
Deep Q-networks (DQN) jdou ještě dál a využívají hluboké učení ke zpracování surových, nestrukturovaných dat, jako jsou obrázky nebo vstupy ze senzorů. Tyto sítě dokážou přímo mapovat smyslové informace na akce, čímž obcházejí potřebu rozsáhlého feature engineeringu.
📌 Příklad: V samořídících autech zpracovávají sítě DQN data ze senzorů v reálném čase, aby se naučily strategie řízení, jako je změna jízdního pruhu nebo vyhýbání se překážkám, a to bez předem naprogramovaných pravidel.
Tyto pokročilé metody umožňují agentům přizpůsobit své učební schopnosti úkolům vyžadujícím vysoký výpočetní výkon a přizpůsobivost.
⚙️ Bonus: Naučte se, jak vytvořit a zdokonalit znalostní bázi umělé inteligence, která zefektivní správu informací, zlepší rozhodování a zvýší produktivitu týmu.
Učební proces agentů klade důraz na vytváření strategií pro inteligentní rozhodování v reálném čase. Zde jsou klíčové aspekty, které napomáhají rozhodování:
- Průzkum vs. využití: Agenti vyvažují průzkum nových akcí za účelem nalezení lepších strategií a využití známých akcí k maximalizaci odměn.
- Rozhodování s využitím více agentů: V rámci spolupráce i soutěže agenti vzájemně interagují a přizpůsobují své strategie na základě společných cílů nebo soupeřivých taktik.
- Strategické kompromisy: Agenti se také učí stanovovat priority cílů na základě kontextu, například vyvažovat rychlost a přesnost v doručovacím systému.
🎤 Tip na podcast: Projděte si náš pečlivě sestavený seznam oblíbených podcastů o umělé inteligenci a prohlubte si tak své znalosti o fungování učících se agentů.
Typy agentů umělé inteligence
Učící se agenti v oblasti umělé inteligence se vyskytují v různých podobách, z nichž každá je přizpůsobena konkrétním úkolům a výzvám.
Pojďme prozkoumat jejich mechanismy fungování, jedinečné vlastnosti a příklady z praxe. 👀
Jednoduché reflexní agenty
Tito agenti reagují přímo na podněty na základě předem definovaných pravidel. Využívají mechanismus „podmínka-akce“ (if-then) k výběru akcí na základě aktuálního prostředí, aniž by brali v úvahu minulost či budoucnost.
Charakteristika
- Funguje na základě logického systému „podmínka–akce“
- Nepřizpůsobuje se změnám ani se nepoučuje z minulých akcí
- Funguje nejlépe v transparentních a předvídatelných prostředích
Příklad
Termostat funguje jako jednoduchý reflexní agent tím, že zapíná topení, když teplota klesne pod nastavenou prahovou hodnotu, a vypíná ho, když teplota stoupne. Rozhoduje se výhradně na základě aktuálních hodnot teploty.
🧠 Zajímavost: V některých experimentech jsou učícím se agentům přiřazovány simulované potřeby, jako je hlad nebo žízeň, což je motivuje k rozvoji chování zaměřeného na cíl a k tomu, aby se naučili tyto „potřeby“ efektivně uspokojovat.
Reflexní agenti založení na modelech
Tito agenti udržují interní model světa, který jim umožňuje zohledňovat důsledky svých akcí. Dále odvozují stav prostředí i nad rámec toho, co mohou bezprostředně vnímat.
Charakteristika
- K rozhodování využívá uložený model prostředí
- Odhaduje aktuální stav za účelem zvládnutí částečně pozorovatelných prostředí
- Nabízí větší flexibilitu a přizpůsobivost ve srovnání s jednoduchými reflexními agenty
Příklad
Autonomní vozidlo Tesla využívá k navigaci na silnicích agenta založeného na modelu. Pomocí pokročilých senzorů a dat v reálném čase detekuje viditelné překážky a předpovídá pohyb okolních vozidel, včetně těch v mrtvých úhlech. To umožňuje vozidlu činit přesná a informovaná rozhodnutí při řízení, čímž se zvyšuje bezpečnost a efektivita.
🔍 Věděli jste, že? Koncept učících se agentů často napodobuje chování pozorované u zvířat, jako je učení metodou pokusů a omylů nebo učení založené na odměnách.
Přečtěte si více: Prozkoumání role modelově založených reflexních agentů v oblasti umělé inteligence
Funkce softwarového agenta a virtuálního asistenta
Tito agenti působí v digitálním prostředí a samostatně vykonávají konkrétní úkoly.
Virtuální asistenti, jako jsou Siri nebo Alexa, zpracovávají uživatelské vstupy pomocí zpracování přirozeného jazyka (NLP) a provádějí akce, jako je odpovídání na dotazy nebo ovládání chytrých zařízení.
Charakteristika
- Zjednodušuje každodenní úkoly, jako je plánování, nastavování připomínek nebo ovládání zařízení
- Neustále se zdokonaluje pomocí učících se algoritmů a dat o interakci s uživatelem
- Funguje asynchronně, reaguje v reálném čase nebo po spuštění
Příklad
Alexa umí přehrávat hudbu, nastavovat připomenutí a ovládat zařízení chytré domácnosti tím, že interpretuje hlasové příkazy, připojuje se k cloudovým systémům a provádí příslušné akce.
🔍 Věděli jste, že? Agenti založení na užitku, kteří se zaměřují na maximalizaci výsledků prostřednictvím vyhodnocování různých akcí, často v oblasti umělé inteligence spolupracují s učícími se agenty. Učící se agenti v průběhu času zdokonalují své strategie na základě zkušeností a mohou využívat rozhodování založené na užitku k tomu, aby činili chytřejší volby.
Víceagentové systémy a aplikace teorie her
Tyto systémy se skládají z více interagujících agentů, kteří spolupracují, soutěží nebo pracují nezávisle, aby dosáhli individuálních či kolektivních cílů.
Kromě toho se jejich chování v soutěžních scénářích často řídí principy teorie her.
Charakteristika
- Vyžaduje koordinaci nebo vyjednávání mezi agenty
- Funguje dobře v dynamických a distribuovaných prostředích
- Simuluje nebo řídí komplexní systémy, jako jsou dodavatelské řetězce nebo městský provoz
Příklad
V systému automatizace skladů společnosti Amazon roboti (agenti) spolupracují při vychystávání, třídění a přepravě zboží. Tito roboti mezi sebou komunikují, aby se vyhnuli kolizím a zajistili plynulý provoz. Principy teorie her pomáhají řídit konkurenční priority, jako je vyvážení rychlosti a zdrojů, a zajistit tak efektivní fungování systému.
Aplikace učících se agentů
Učící se agenti proměnili řadu odvětví tím, že zlepšili efektivitu a rozhodování.
Zde je několik klíčových aplikací. 📚
Robotika a automatizace
Učící se agenti tvoří jádro moderní robotiky a umožňují robotům autonomní a adaptivní fungování v dynamických prostředích.
Na rozdíl od tradičních systémů, které vyžadují podrobné programování pro každý úkol, umožňují učící se agenti robotům samovzdělávání prostřednictvím interakce a zpětné vazby.
Jak to funguje
Roboti vybavení učícími se agenty využívají techniky, jako je posilovací učení, k interakci se svým okolím a k vyhodnocování výsledků svých akcí. Postupem času zdokonalují své chování, přičemž se zaměřují na maximalizaci odměn a vyhýbání se trestům.
Neuronové sítě jdou ještě dál a umožňují robotům zpracovávat komplexní data, jako jsou vizuální vstupy nebo prostorová uspořádání, což usnadňuje sofistikované rozhodování.
Příklady
- Autonomní vozidla: V zemědělství pohánějí učící se agenti autonomní traktory, které se pohybují po polích, přizpůsobují se měnícím se půdním podmínkám a optimalizují procesy výsadby či sklizně. Využívají data v reálném čase ke zvýšení efektivity a snížení plýtvání.
- Průmyslové roboty: Ve výrobě robotická ramena vybavená učícími se agenty jemně ladí své pohyby, aby zvýšila přesnost, efektivitu a bezpečnost, například na montážních linkách automobilů.
📖 Přečtěte si také: Triky s umělou inteligencí, díky kterým budete rychlejší, chytřejší a lepší
Simulace a modely založené na agentech
Učící se agenti pohánějí simulace, které nabízejí nákladově efektivní a bezrizikový způsob studia složitých systémů.
Tyto systémy napodobují dynamiku reálného světa, předpovídají výsledky a optimalizují strategie prostřednictvím modelování agentů s odlišným chováním a adaptivními schopnostmi.
Jak to funguje
Učící se agenti v simulacích pozorují své prostředí, testují akce a přizpůsobují své strategie tak, aby maximalizovali účinnost. Neustále se učí a v průběhu času se zdokonalují, což jim umožňuje optimalizovat výsledky.
Simulace jsou vysoce účinné v oblasti řízení dodavatelského řetězce, urbanistického plánování a vývoje robotiky.
Příklady
- Řízení dopravy: Simulovaní agenti modelují dopravní toky ve městech. To umožňuje výzkumníkům testovat opatření, jako jsou nové silnice nebo poplatky za vjezd do centra, ještě před jejich zavedením.
- Epidemiologie: V simulacích pandemie napodobují učící se agenti lidské chování za účelem posouzení šíření nemocí. Pomáhají také vyhodnotit účinnost opatření k omezení šíření, jako je sociální distancování.
💡 Tip od odborníka: Optimalizujte předzpracování dat v rámci strojového učení v oblasti umělé inteligence, abyste zvýšili přesnost a efektivitu učících se agentů. Kvalitní vstupní data zajišťují spolehlivější rozhodování.
Inteligentní systémy
Učící se agenti řídí inteligentní systémy tím, že umožňují zpracování dat v reálném čase a přizpůsobení se chování a preferencím uživatelů.
Od chytrých spotřebičů až po autonomní úklidová zařízení – tyto systémy mění způsob, jakým uživatelé interagují s technologií, a díky nim jsou každodenní úkoly efektivnější a přizpůsobené na míru.
Jak to funguje
Zařízení jako Roomba využívají vestavěné senzory a učící se agenty k mapování dispozic domácnosti, vyhýbání se překážkám a optimalizaci tras úklidu. Neustále shromažďují a analyzují data – například o oblastech vyžadujících častý úklid nebo o rozmístění nábytku – a s každým použitím tak zlepšují svůj výkon.
Příklady
- Zařízení pro chytrou domácnost: Termostaty jako Nest se učí rozvrhy uživatelů a jejich teplotní preference. Automaticky upravují nastavení tak, aby šetřily energii a zároveň zachovaly pohodlí.
- Robotické vysavače: Roomba shromažďuje mnoho datových bodů za sekundu. Díky tomu se učí pohybovat se kolem nábytku a identifikovat místa s vysokou frekvencí pohybu, aby mohl efektivně uklízet.
Tyto inteligentní systémy zdůrazňují praktické využití učících se agentů v každodenním životě, jako je zefektivnění pracovních postupů a automatizace opakujících se úkolů za účelem zvýšení efektivity.
🔍 Věděli jste, že... Roomba shromažďuje více než 230 400 datových bodů za sekundu, aby zmapovala váš domov.
Internetová fóra a virtuální asistenti
Učící se agenti hrají klíčovou roli při zlepšování online interakcí a digitální asistence. Umožňují fórům a virtuálním asistentům poskytovat personalizované zážitky.
Jak to funguje
Učící se agenti moderují diskuze na fórech a identifikují a odstraňují spam či škodlivý obsah. Zajímavé je, že uživatelům také doporučují relevantní témata na základě jejich historie prohlížení.
Virtuální asistenti využívající umělou inteligenci, jako jsou Alexa a Google Assistant, používají učící se agenty ke zpracování vstupů v přirozeném jazyce, čímž v průběhu času zlepšují své kontextové porozumění.
Příklady
- Internetová fóra: Moderovací boti na Redditu využívají učící se agenty k prohledávání příspěvků za účelem odhalení porušení pravidel nebo urážlivého jazyka. Taková údržba založená na umělé inteligenci zajišťuje bezpečnost a atraktivitu online komunit.
- Virtuální asistenti: Alexa se učí uživatelské preference, jako jsou oblíbené playlisty nebo často používané příkazy pro chytrou domácnost, aby mohla poskytovat personalizovanou a proaktivní pomoc
⚙️ Bonus: Naučte se, jak využít umělou inteligenci na svém pracovišti k zvýšení produktivity a zefektivnění úkolů pomocí inteligentních agentů.
Výzvy při vývoji učících se agentů
Vývoj učících se agentů s sebou nese technické, etické i praktické výzvy, včetně návrhu algoritmů, výpočetních nároků a implementace v reálném světě.
Podívejme se na některé klíčové výzvy, kterým čelí vývoj umělé inteligence v průběhu svého vývoje. 🚧
Rovnováha mezi průzkumem a využitím
Učící se agenti čelí dilematu, jak najít rovnováhu mezi průzkumem a využíváním.
Ačkoli mohou pomoci algoritmy jako epsilon-greedy, dosažení správné rovnováhy do značné míry závisí na kontextu. Navíc nadměrné prozkoumávání může vést k neefektivitě, zatímco přílišné spoléhání se na využití může vést k suboptimálním řešením.
Řešení vysokých výpočetních nákladů
Trénování sofistikovaných učících se agentů často vyžaduje rozsáhlé výpočetní zdroje. To platí zejména v prostředích se složitou dynamikou nebo s rozsáhlými prostory stavů a akcí.
Mějte na paměti, že algoritmy, jako je učení s posilováním pomocí neuronových sítí (například Deep Q-Learning), vyžadují značný výpočetní výkon a paměť. Budete potřebovat pomoc s tím, jak zajistit praktické využití učení v reálném čase v aplikacích s omezenými zdroji.
Překonání problémů se škálovatelností a přenosem učení
Škálování učících se agentů tak, aby efektivně fungovali ve velkých, vícerozměrných prostředích, zůstává i nadále výzvou. Transferové učení, při kterém agenti aplikují znalosti z jedné oblasti do druhé, je stále ještě v plenkách.
To omezilo jejich schopnost generalizovat napříč úkoly nebo prostředími.
📌 Příklad: Agent umělé inteligence vycvičený pro šachy by měl potíže s hrou Go kvůli výrazně odlišným pravidlům a cílům, což poukazuje na výzvu, kterou představuje přenos znalostí mezi různými obory.
Kvalita a dostupnost dat
Výkon učících se agentů do značné míry závisí na kvalitě a rozmanitosti trénovacích dat.
Nedostatečná nebo zkreslená data mohou vést k neúplnému nebo chybnému učení a mít za následek neoptimální či neetická rozhodnutí. Navíc může být sběr reálných dat pro trénování nákladný a časově náročný.
⚙️ Bonus: Prozkoumejte kurzy o umělé inteligenci a prohlubte si tak své znalosti o dalších typech agentů.
Nástroje a zdroje pro učící se agenty
Vývojáři a výzkumníci se při vytváření a trénování učících se agentů opírají o různé nástroje. Rámce jako TensorFlow, PyTorch a OpenAI Gym nabízejí základní infrastrukturu pro implementaci algoritmů strojového učení.
Tyto nástroje také pomáhají vytvářet simulovaná prostředí. Některé aplikace umělé inteligence tento proces navíc zjednodušují a vylepšují.
Pro tradiční přístupy k strojovému učení zůstávají nástroje jako Scikit-learn spolehlivé a účinné.
Pro řízení projektů v oblasti výzkumu a vývoje umělé inteligence nabízí ClickUp více než jen správu úkolů – funguje jako centralizované centrum pro organizaci úkolů, sledování pokroku a umožnění plynulé spolupráce mezi týmy.
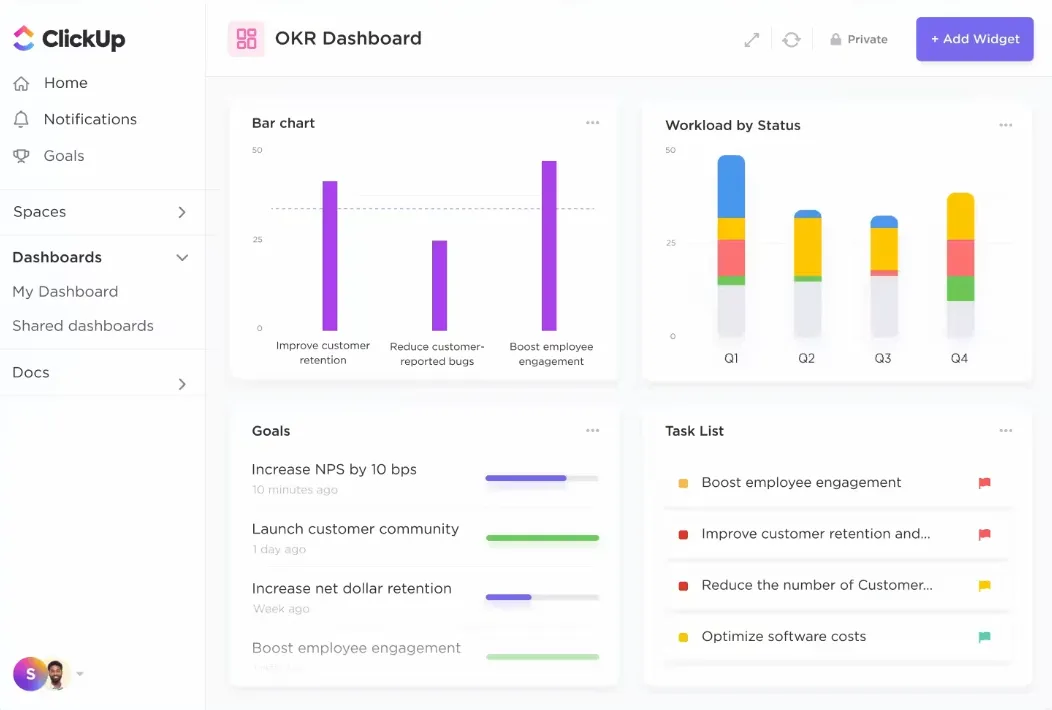
ClickUp pro řízení projektů v oblasti umělé inteligence snižuje manuální úsilí vynaložené na vyhodnocování stavu úkolů a přidělování povinností.
Místo toho, abyste ručně kontrolovali každý úkol nebo zjišťovali, kdo je k dispozici, tuto náročnou práci za vás převezme umělá inteligence. Umí automaticky aktualizovat stav prací, identifikovat úzká místa a navrhnout nejvhodnější osobu pro každý úkol na základě jejího pracovního vytížení a dovedností.
Díky tomu strávíte méně času zdlouhavou administrativou a více času tím, na čem záleží – posunem vašich projektů vpřed.
Zde je několik funkcí využívajících umělou inteligenci, které stojí za pozornost. 🤩
ClickUp Brain
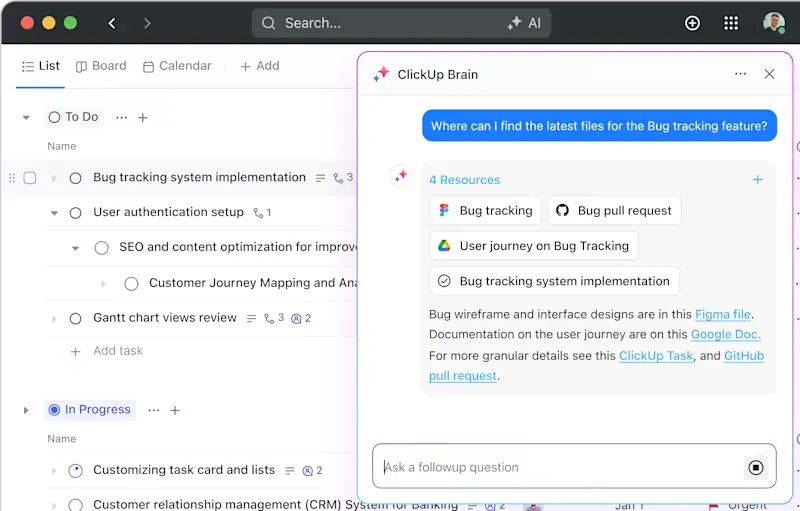
ClickUp Brain, asistent využívající umělou inteligenci, který je integrován do platformy, zjednodušuje i ty nejsložitější projekty. Rozděluje rozsáhlé studie na zvládnutelné úkoly a podúkoly, což vám pomáhá udržet pořádek a držet se plánu.
Potřebujete rychlý přístup k výsledkům experimentů nebo dokumentaci? Stačí zadat dotaz a ClickUp Brain vám během několika sekund vyhledá vše, co potřebujete. Dokonce vám umožní klást navazující otázky na základě stávajících dat, takže budete mít pocit, jako byste měli svého osobního asistenta.
Navíc automaticky propojuje úkoly s relevantními zdroji, čímž vám šetří čas a námahu.
Řekněme, že provádíte studii o tom, jak se agenti s posilovacím učením v průběhu času zdokonalují.
Čeká vás několik fází – rešerše literatury, sběr dat, experimentování a analýza. S ClickUp Brain stačí zadat příkaz „Rozděl tuto studii na úkoly“ a nástroj automaticky vytvoří dílčí úkoly pro každou fázi.
Poté ho můžete požádat, aby vyhledal relevantní články o Q-učení nebo načítal datové sady týkající se výkonu agentů, což provede okamžitě. Při práci na úkolech může ClickUp Brain propojit konkrétní výzkumné články nebo výsledky experimentů přímo s úkoly, čímž zajistí přehlednost a organizaci.
Ať už se zabýváte výzkumnými rámci nebo každodenními projekty, ClickUp Brain vám zajistí, že budete pracovat chytřeji, nikoli tvrději.
Automatizace v ClickUp
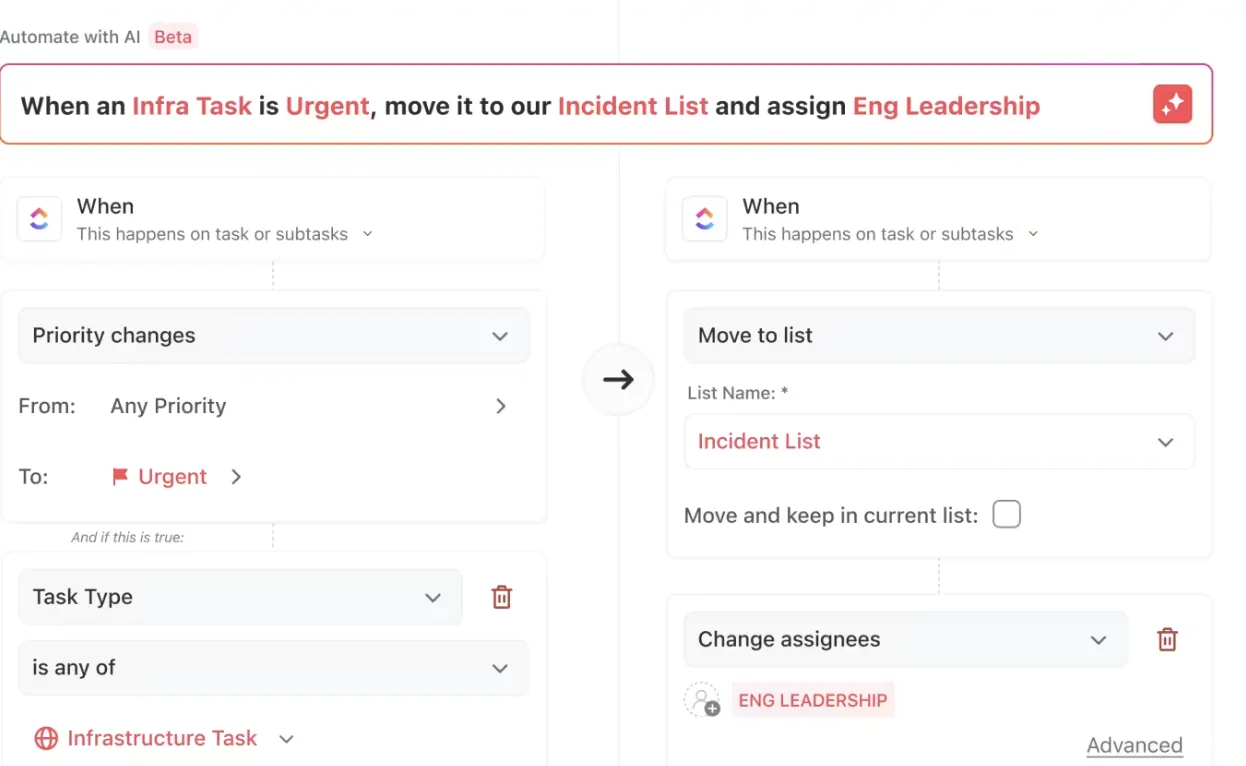
ClickUp Automations je jednoduchý, ale výkonný způsob, jak zefektivnit váš pracovní postup.
Umožňuje okamžité přidělování úkolů po splnění předpokladů, informuje zúčastněné strany o milnících v postupu a upozorňuje na zpoždění – to vše bez ručního zásahu.
Můžete také používat příkazy v přirozeném jazyce, což ještě více usnadňuje správu pracovních postupů. Není třeba se zabývat složitými nastaveními ani technickým žargonem – stačí ClickUp sdělit, co potřebujete, a on za vás automatizaci vytvoří.
Ať už jde o „přesunout úkoly do další fáze, jakmile jsou označeny jako dokončené“, nebo „přiřadit úkol Sarah, pokud má vysokou prioritu“, ClickUp vašemu požadavku porozumí a automaticky jej nastaví.
📖 Přečtěte si také: Jak využít umělou inteligenci ke zvýšení produktivity (příklady použití a nástroje)
Vytvářejte učící se agenty jako profesionál s ClickUp
K vytvoření učících se agentů v oblasti umělé inteligence budete potřebovat odbornou kombinaci strukturovaných pracovních postupů a adaptivních nástrojů. Zvýšená poptávka po technických znalostech činí tento úkol o to náročnějším, zejména s ohledem na statistickou a datově podloženou povahu těchto úkolů.
Zvažte využití nástroje ClickUp k zefektivnění těchto projektů. Tento nástroj nejen pomáhá s organizací, ale také podporuje inovace vašeho týmu tím, že odstraňuje zbytečné neefektivnosti.
ClickUp Brain pomáhá rozdělit složité úkoly na menší části, okamžitě vyhledat relevantní zdroje a nabízí poznatky založené na umělé inteligenci, díky nimž budou vaše projekty organizované a budou postupovat podle plánu. ClickUp Automations mezitím zvládá opakující se úkoly, jako je aktualizace stavů nebo přidělování nových úkolů, takže se váš tým může soustředit na celkový přehled.
Tyto funkce společně odstraňují neefektivitu a umožňují vašemu týmu pracovat chytřeji, díky čemuž jsou inovace a pokrok hračkou.
Zaregistrujte se ještě dnes zdarma na ClickUp. ✅