
Проектите за обучение на ИИ рядко се провалят на ниво модел. Те срещат затруднения, когато експериментите, документацията и актуализациите за заинтересованите страни са разпръснати в прекалено много инструменти.
Това ръководство ви води стъпка по стъпка през процеса на обучение на модели с Databricks DBRX — LLM, който е до два пъти по-ефективен от гледна точка на изчислителната мощност в сравнение с други водещи модели — като същевременно поддържате работата по него организирана в ClickUp.
От настройката и фината настройка до документацията и актуализациите между екипите, ще видите как едно единно, конвергентно работно пространство помага да се елиминира разпръскването на контекста и поддържа екипа ви фокусиран върху създаването, а не върху търсенето. 🛠
Какво е DBRX?
DBRX е мощен езиков модел с голям обем (LLM) с отворен код, проектиран специално за обучение и извличане на заключения от модели за изкуствен интелект в корпоративна среда. Тъй като е с отворен код съгласно лиценза Databricks Open Model License, вашият екип има пълен достъп до теглата и архитектурата на модела, което ви позволява да го проверявате, модифицирате и внедрявате по свой собствен начин.
Предлага се в два варианта: DBRX Base за задълбочено предварително обучение и DBRX Instruct за готови за употреба задачи, свързани със следване на инструкции.
Архитектура на DBRX и дизайн на „смесица от експерти“
DBRX решава задачи, използвайки архитектура от типа „смесица от експерти“ (Mixture-of-Experts, MoE). За разлика от традиционните големи езикови модели, които използват всичките си милиарди параметри за всяко едно изчисление, DBRX активира само част от общия брой параметри (най-подходящите експерти) за всяка конкретна задача.
Представете си го като екип от специализирани експерти; вместо всеки да работи по всеки проблем, системата интелигентно насочва всяка задача към най-подходящите параметри.
Това не само съкращава времето за реакция, но и осигурява първокласна производителност и резултати, като същевременно значително намалява разходите за изчислителни ресурси.
Ето кратък преглед на основните му характеристики:
- Общ брой параметри: 132B за всички експерти
- Активни параметри: 36B на всеки цикъл на преминаване
- Брой експерти: общо 16 (MoE Top-4 маршрутизация), като 4 от тях са активни за всеки даден токен
- Прозорец „Контекст“: 32 000 токена
Данни за обучение с DBRX и спецификации на токените
Ефективността на един LLM зависи изцяло от качеството на данните, върху които е обучен. DBRX е предварително обучен върху огромен набор от данни от 12 трилиона токена, внимателно подбран от екипа на Databricks с помощта на техните усъвършенствани инструменти за обработка на данни. Именно затова той постигна отлични резултати в сравнителните тестове в бранша.
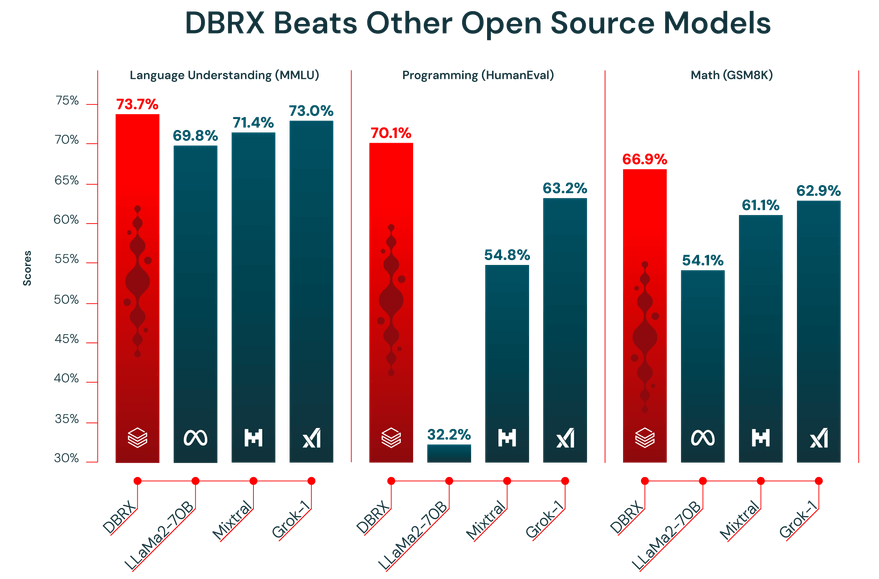
Освен това DBRX разполага с контекстен прозорец от 32 000 токена. Това е количеството текст, което моделът може да обработи наведнъж. Големият контекстен прозорец е изключително полезен за сложни задачи като обобщаване на дълги доклади, преглед на обемни правни документи или изграждане на усъвършенствани системи за генериране, подсилено с извличане на информация (RAG), тъй като позволява на модела да запази контекста, без да съкращава или забравя информация.
🎥 Гледайте това видео, за да видите как оптимизираната координация на проектите може да преобрази работния ви процес по обучение на ИИ и да елиминира неудобството от превключването между несвързани инструменти. 👇🏽
Как да получите достъп до DBRX и да го настроите
DBRX предлага два основни начина за достъп, като и двата осигуряват пълен достъп до теглата на моделите при либерални търговски условия. Можете да използвате Hugging Face за максимална гъвкавост или да получите достъп директно чрез Databricks за по-интегрирано преживяване.
Достъп до DBRX чрез Hugging Face
За екипи, които ценят гъвкавостта и вече са запознати с екосистемата на Hugging Face, достъпът до DBRX чрез Hub е идеалният вариант. Той ви позволява да интегрирате модела в съществуващите си работни потоци, базирани на трансформатори.
Ето как да започнете:
- Създайте или влезте в профила си в Hugging Face
- Преминете към картата на модела DBRX в Hub и приемете условията на лиценза
- Инсталирайте библиотеката transformers заедно с необходимите зависимости, като например accelerate
- Използвайте класа AutoModelForCausalLM във вашия Python скрипт, за да заредите модела на DBRX
- Конфигурирайте своя инферентен пайплайн, като имате предвид, че DBRX изисква значителен обем памет на графичния процесор (VRAM) за ефективна работа
📖 Прочетете още: Как да конфигурирате температурата на LLM
Достъп до DBRX чрез Databricks
Ако вашият екип вече използва Databricks за инженеринг на данни или машинно обучение, достъпът до DBRX чрез платформата е най-лесният начин. Това елиминира трудностите при настройката и ви предоставя всички инструменти, от които се нуждаете за MLOps, точно там, където вече работите.
Следвайте тези стъпки в работното си пространство в Databricks, за да започнете:
- Преминете към раздела „Model Garden“ или „Mosaic AI“
- Изберете DBRX Base или DBRX Instruct, в зависимост от вашите нужди
- Конфигурирайте крайна точка за обслужване за достъп до API или настройте среда за бележници за интерактивна употреба
- Започнете да тествате извличането на заключения с примерни подсказки, за да се уверите, че всичко работи коректно, преди да разширите обучението или внедряването на вашия модел за изкуствен интелект
Този подход ви осигурява безпроблемен достъп до инструменти като MLflow за проследяване на експерименти и Unity Catalog за управление на моделите.
📮 ClickUp Insight: Средностатистическият професионалист прекарва над 30 минути на ден в търсене на информация, свързана с работата — това са над 120 часа годишно, загубени в претърсване на имейли, нишки в Slack и разпръснати файлове.
Един интелигентен AI асистент, вграден в работното ви пространство, може да промени това. Запознайте се с ClickUp Brain.
Той предоставя незабавни анализи и отговори, като извежда на преден план подходящите документи, разговори и подробности за задачите за секунди – така че можете да спрете да търсите и да започнете да работите.
Как да настроите DBRX и да обучавате персонализирани модели за изкуствен интелект
Готовият модел, колкото и мощен да е, никога няма да разбере уникалните нюанси на вашия бизнес. Тъй като DBRX е с отворен код, можете да го настроите прецизно, за да създадете персонализиран модел, който „говори“ на езика на вашата компания или изпълнява конкретна задача, с която бихте искали да се заеме.
Ето три често използвани начина, по които можете да направите това:
1. Настройте DBRX с набори от данни на Hugging Face
За екипи, които тепърва започват или работят по обичайни задачи, публичните набори от данни от Hugging Face Hub са чудесен ресурс. Те са предварително форматирани и лесни за зареждане, което означава, че не е нужно да прекарвате часове в подготовка на данните си.
Процесът е доста прост:
- Намерете набор от данни в Hub, който отговаря на вашата задача (например, следване на инструкции, обобщаване)
- Заредете го, като използвате библиотеката с набори от данни
- Уверете се, че данните са форматирани като двойки „инструкция-отговор“
- Конфигурирайте скрипта си за обучение с хиперпараметри като скорост на обучение и размер на партидата
- Стартирайте задачата за обучение, като не забравяйте да запазвате контролните точки периодично
- Оценете фино настроения модел върху запазен валидационен набор, за да измерите подобрението
2. Настройте DBRX с локални набори от данни
Обикновено най-добри резултати се постигат чрез фина настройка с ваши собствени данни. Това ви позволява да научите модела на специфичната терминология, стил и експертни познания на вашата компания. Просто имайте предвид, че това се отплаща само ако данните ви са чисти, добре подготвени и в достатъчен обем.
Следвайте тези стъпки, за да подготвите вътрешните си данни:
- Събиране на данни: Съберете висококачествени примери от вашите вътрешни уики страници, документи и бази данни
- Преобразуване на формат: Структурирайте данните си в единен формат „инструкция-отговор“, често под формата на JSON редове
- Филтриране по качество: Премахнете всички примери с ниско качество, дубликати или нерелевантни примери
- Разделяне за валидиране: Отделете малка част от данните си (обикновено 10–15%), за да оцените ефективността на модела
- Проверка за защита на личните данни: Премахнете или маскирайте всякаква лична информация (PII) или чувствителни данни
3. Фина настройка на DBRX с StreamingDataset
Ако наборът ви от данни се окаже прекалено голям, за да се побере в паметта на вашия компютър, не се притеснявайте – можете да използвате библиотеката Streaming Dataset на Databricks. Тя ви позволява да предавате данни директно от облачното хранилище по време на обучението на модела, вместо да ги зареждате всички наведнъж в паметта.
Ето как можете да го направите:
- Подготовка на данните: Почистете и структурирайте данните си за обучение, след което ги съхранете в подходящ за стрийминг формат, като JSONL или CSV, в облачно хранилище
- Конвертиране на формат за стрийминг: Конвертирайте набора си от данни във формат, подходящ за стрийминг, като например Mosaic Data Shard (MDS), за да може да се чете ефективно по време на обучението
- Настройка на зарядното устройство за обучение: Конфигурирайте зарядното устройство за обучение така, че да сочи към отдалечения набор от данни, и дефинирайте локален кеш за временно съхранение на данни
- Инициализиране на модела: Започнете процеса на фино настройване на DBRX, като използвате платформа за обучение, която поддържа StreamingDataset, като например LLM Foundry
- Обучение на базата на поточно предаване: Изпълнете задачата за обучение, докато данните се предават на потоци на партиди по време на обучението, вместо да се зареждат изцяло в паметта
- Контролни точки и възстановяване: Възобновявайте обучението безпроблемно, ако изпълнението бъде прекъснато, без да дублирате или пропускате данни
- Оценка и внедряване: Проверете ефективността на фино настроения модел и го внедрете, като използвате предпочитаната от вас конфигурация за обслужване или извличане на заключения
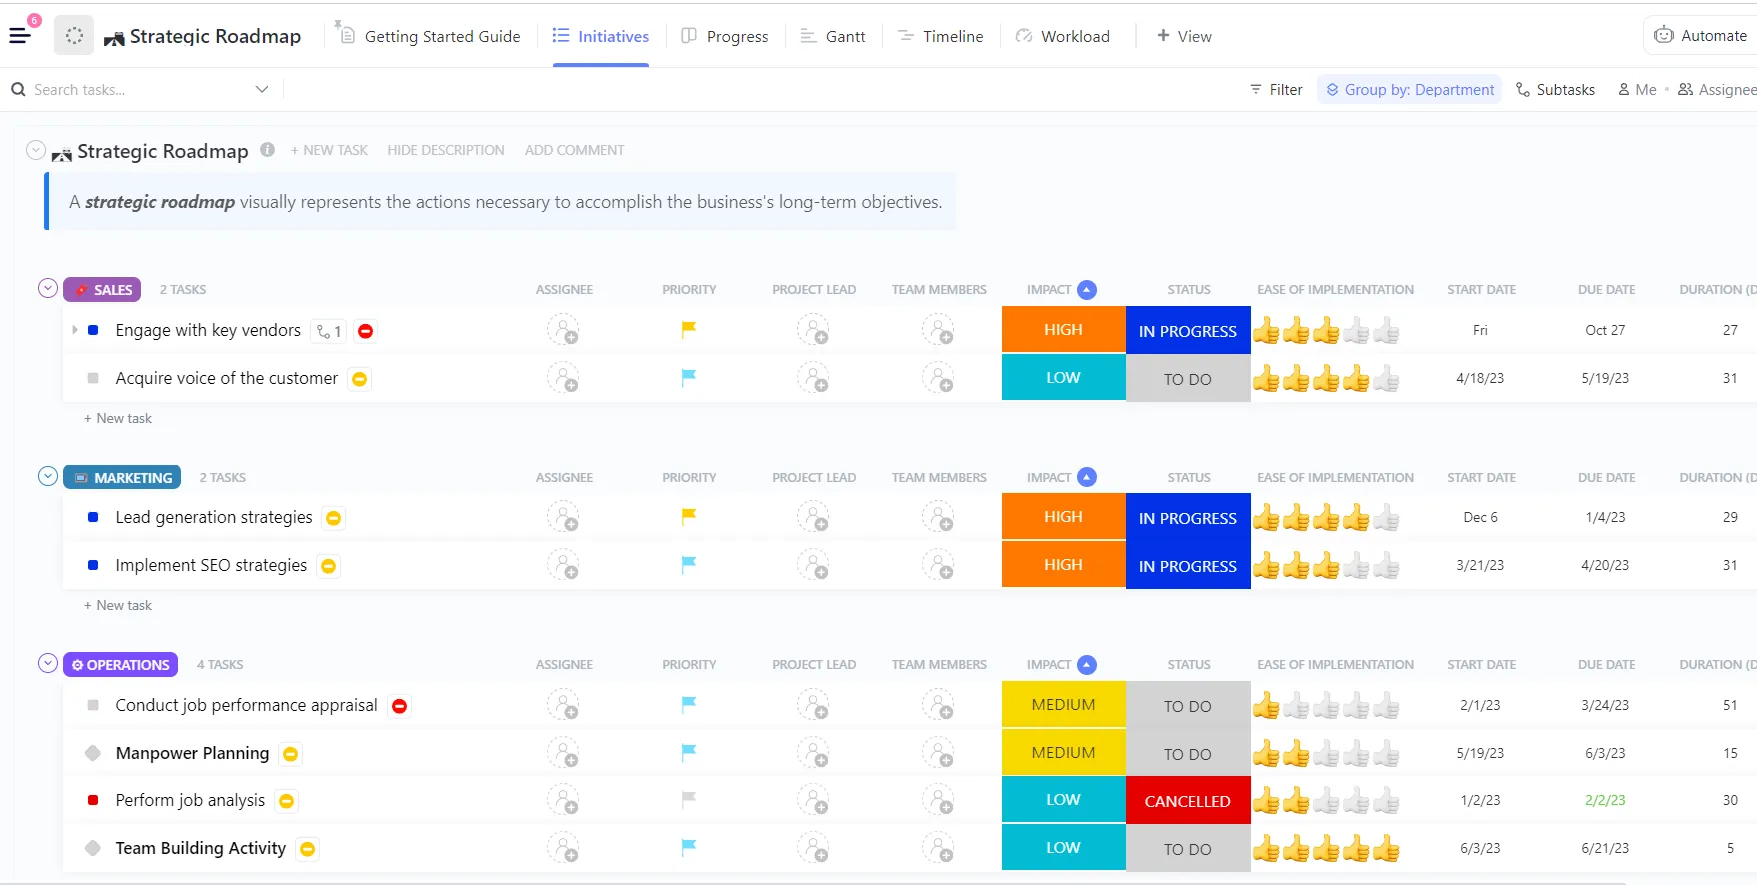
💡Съвет от професионалист: Вместо да създавате план за обучение с DBRX от нулата, започнете с шаблона за пътна карта на проекти за изкуствен интелект и машинно обучение на ClickUp и го адаптирайте според нуждите на вашия екип. Той осигурява ясна структура за планиране на набори от данни, фази на обучение, оценка и внедряване, така че да можете да се съсредоточите върху организирането на работата си, вместо върху структурирането на работния процес.
Примери за използване на DBRX при обучението на модели за изкуствен интелект
Едно е да разполагате с мощен модел, но съвсем друго е да знаете точно в какво се проявява неговата сила.
Когато нямате ясна представа за силните страни на даден модел, лесно е да хабите време и ресурси, опитвайки се да го приложите там, където той просто не е подходящ. Това води до незадоволителни резултати и разочарование.
Уникалната архитектура и данните за обучение на DBRX го правят изключително подходящ за няколко ключови приложения в предприятията. Познаването на тези предимства ви помага да съгласувате модела с вашите бизнес цели и да максимизирате възвръщаемостта на инвестицията си.
Генериране на текст и създаване на съдържание
DBRX Instruct е прецизно настроен да следва инструкции и да генерира висококачествен текст. Това го превръща в мощен инструмент за автоматизиране на широк спектър от задачи, свързани със съдържанието. Големият му контекстен прозорец е значително предимство, което му позволява да обработва дълги документи, без да губи нишката.
Можете да го използвате за:
- Техническа документация: Създавайте и усъвършенствайте ръководства за продукти, справки за API и ръководства за потребители
- Маркетингово съдържание: Чернови на публикации в блога, имейл бюлетини и актуализации в социалните медии
- Създаване на отчети: Обобщавайте сложни данни и създавайте кратки изпълнителни резюмета
- Превод и локализация: Адаптирайте съществуващото съдържание за нови пазари и аудитории
Задачи по генериране на код и отстраняване на грешки
Значителна част от данните за обучение на DBRX включваше код, което го превръща в мощна LLM поддръжка за разработчиците. Той може да ускори циклите на разработка чрез автоматизиране на повтарящи се задачи по кодиране и подпомагане при решаването на сложни проблеми.
Ето няколко начина, по които вашият инженерен екип може да се възползва от това:
- Автоматично попълване на код: Автоматично генериране на тялото на функции от коментари или docstrings
- Откриване на грешки: Анализирайте фрагменти от код, за да идентифицирате потенциални грешки или логически несъответствия
- Обяснение на кода: Превеждайте сложни алгоритми или стар код на прост английски език
- Генериране на тестове: Създавайте единични тестове въз основа на сигнатурата на функцията и очакваното й поведение
RAG и приложения с дълъг контекст
Retrieval-Augmented Generation (RAG) е мощна техника, която основава отговорите на модела на частните данни на вашата компания. Въпреки това, RAG системите често се сблъскват с проблеми при модели с малки контекстни прозорци, което налага агресивно разделяне на данните на части, при което може да се загуби важен контекст. Контекстният прозорец от 32K на DBRX го превръща в отлична основа за стабилни RAG приложения.
Това ви позволява да създавате мощни вътрешни инструменти, като например:
- Търсене в предприятието: Създайте чатбот, който отговаря на въпросите на служителите, като използва вашата вътрешна база от знания
- Поддръжка на клиенти: Създайте агент, който генерира отговори за поддръжка, основани на документацията на вашия продукт
- Помощ при научни изследвания: Разработете инструмент, който може да синтезира информация от стотици страници научни статии
- Проверка за съответствие: Автоматично сравнявайте маркетинговите текстове с вътрешните насоки за бранда или нормативните документи
Как да интегрирате обучението с DBRX в работния процес на вашия екип
Един успешен проект за обучение на модели за изкуствен интелект е нещо повече от просто код и изчислителна мощност. Това е съвместна работа, в която участват инженери по машинно обучение, специалисти по данни, продуктови мениджъри и заинтересовани страни.
Когато това сътрудничество е разпръснато из Jupyter бележници, канали в Slack и отделни инструменти за управление на проекти, се създава разпръскване на контекста – ситуация, при която критичната информация за проекта е разпръсната в прекалено много инструменти.
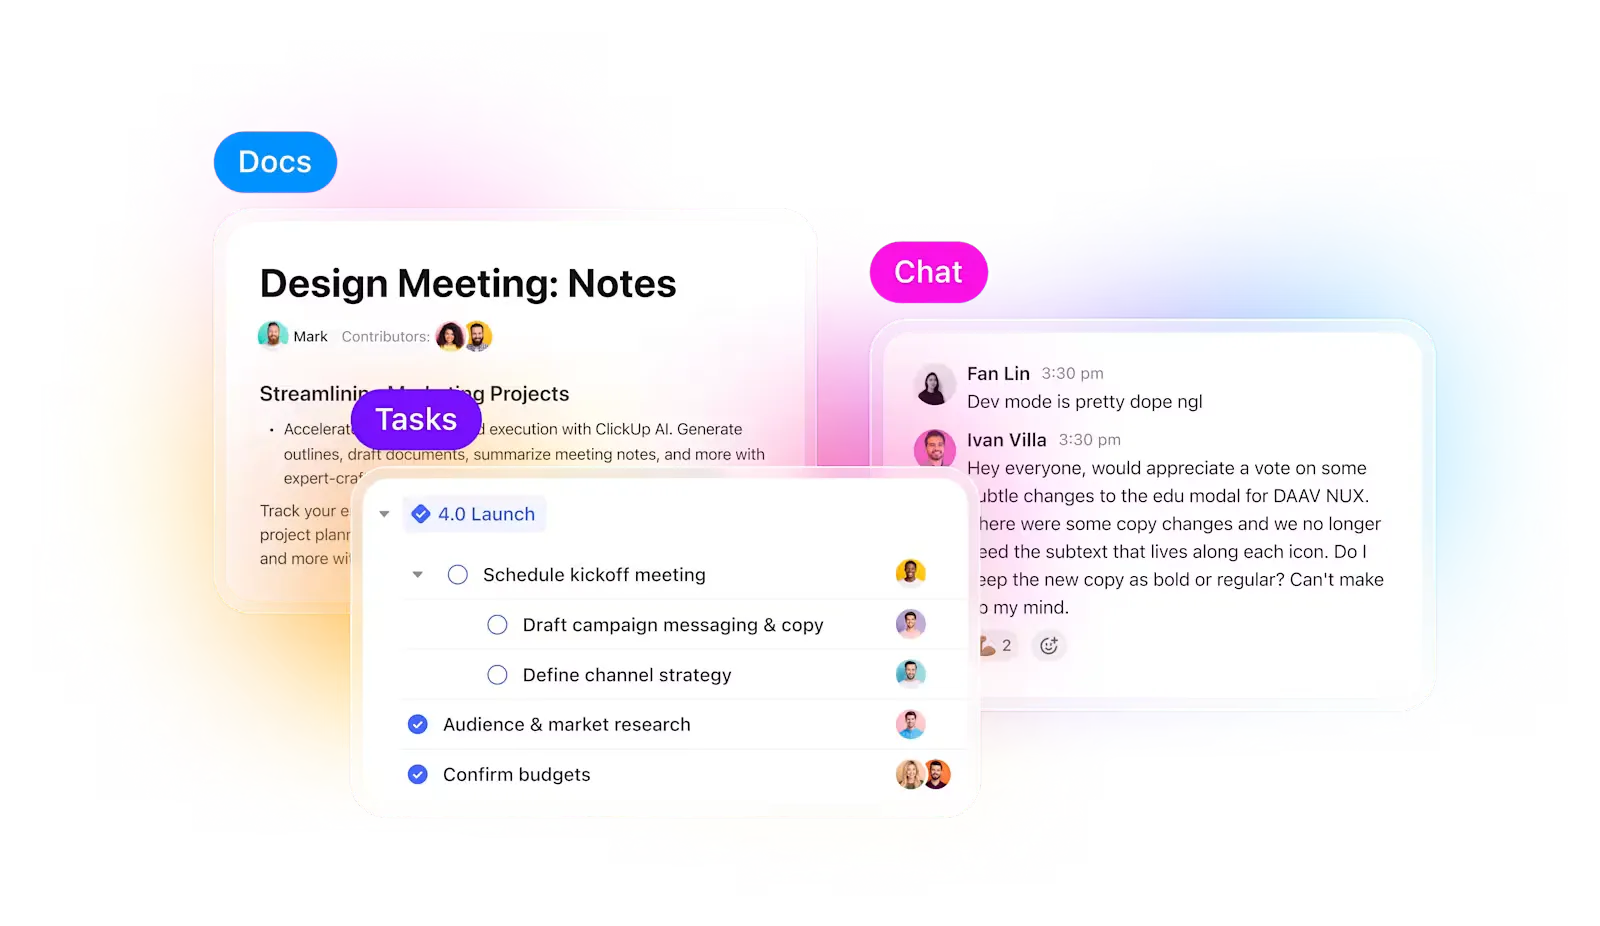
ClickUp решава този проблем. Вместо да се налага да използвате множество инструменти, получавате едно конвергентно работно пространство за изкуствен интелект, в което управлението на проекти, документацията и комуникацията са обединени – така вашите експерименти остават свързани от планирането през изпълнението до оценката.
Никога не губете преглед върху експериментите и напредъка
Когато се провеждат множество експерименти, най-трудното не е обучението на модела, а проследяването на промените, настъпили по време на процеса. Коя версия на набора от данни е била използвана, коя скорост на обучение е дала най-добри резултати или коя серия е била пусната в производство?
ClickUp прави този процес изключително лесен за вас. Можете да проследявате всеки цикъл на обучение поотделно в задачите на ClickUp, а в рамките на задачите можете да използвате персонализирани полета, за да записвате:
- Версия на набора от данни
- Хиперпараметри
- Вариант на модела (DBRX Base срещу DBRX Instruct)
- Статус на обучението (В опашката, В процес, В оценка, Разгърнато)
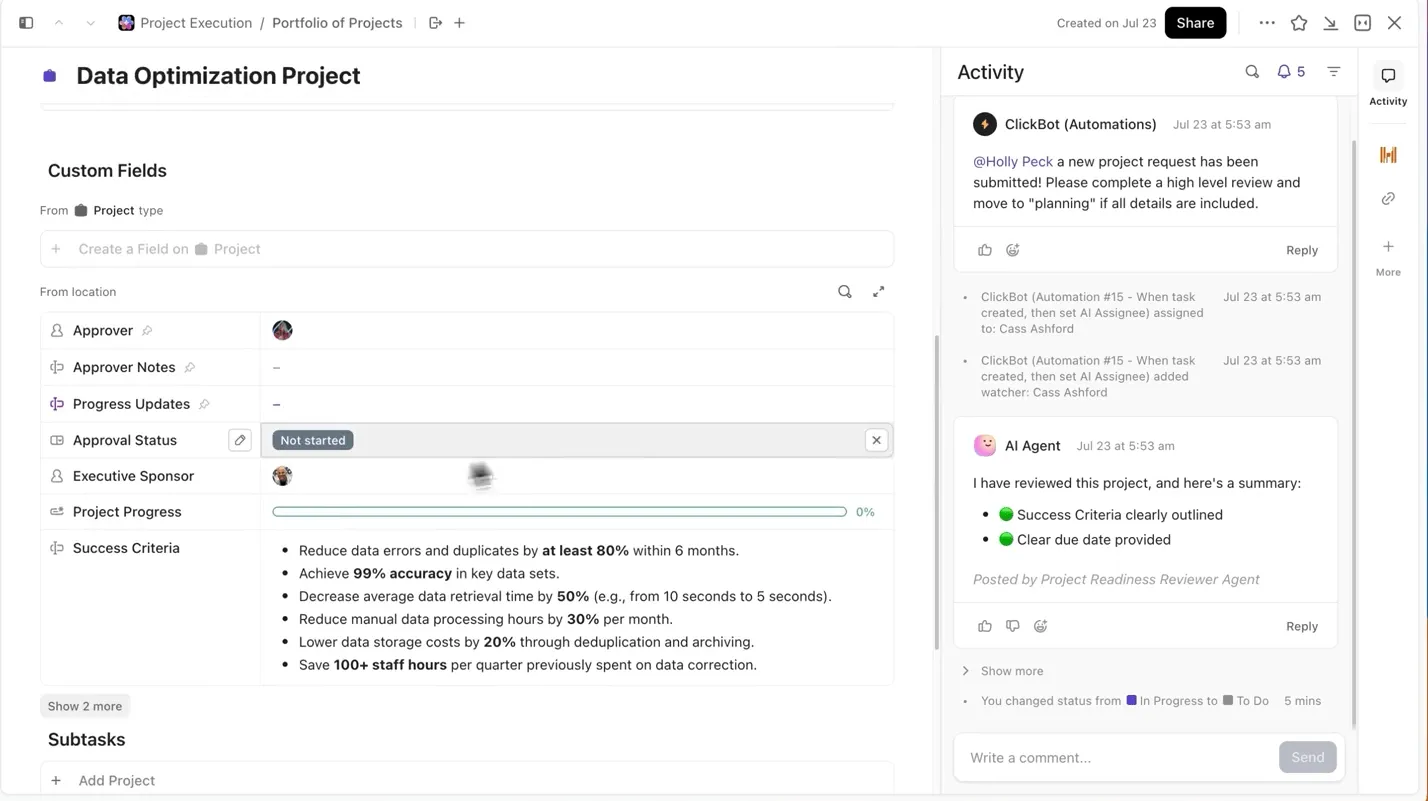
По този начин всеки документиран експеримент може да бъде намерен чрез търсене, лесно се сравнява с другите и е възпроизводим.
Свържете документацията на модела с работата
Няма нужда да прескачате между Jupyter бележници, README файлове или нишки в Slack, за да разберете контекста на задачата на даден експеримент.
С ClickUp Docs можете да поддържате архитектурата на модела, скриптовете за подготовка на данни или показателите за оценка организирани и достъпни , като ги документирате в документ с възможност за търсене , който се свързва директно със задачите от експеримента, от които произхождат.
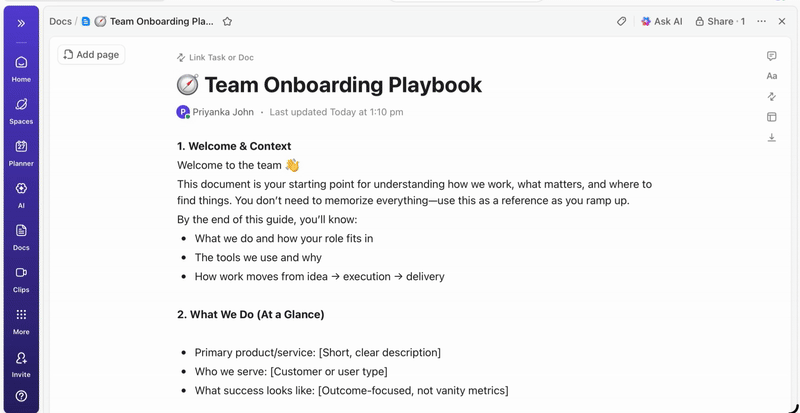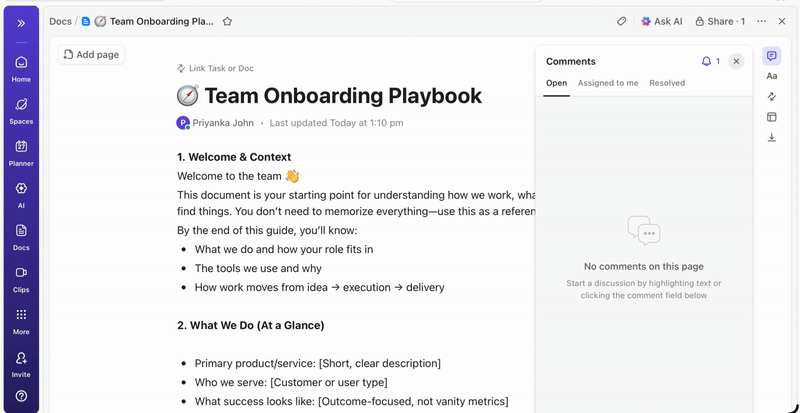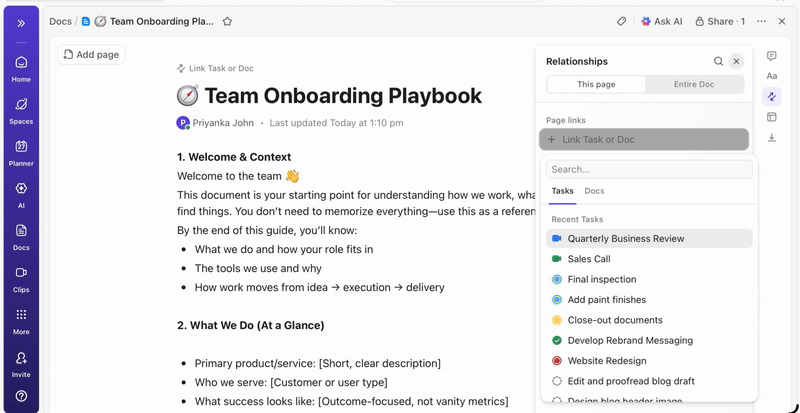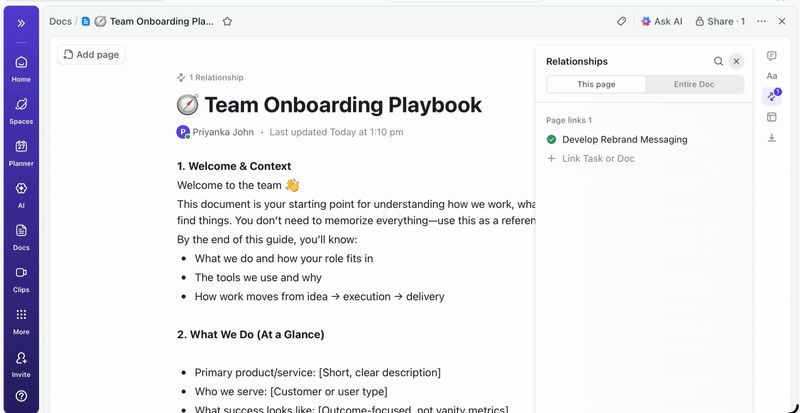
💡Съвет от професионалист: Поддържайте актуален проектен бриф в ClickUp Docs, в който подробно се описва всяко решение – от архитектурата до внедряването, така че новите членове на екипа винаги да могат да се запознаят с подробностите по проекта, без да се налага да претърсват стари дискусии
Осигурете на заинтересованите страни прозрачност в реално време
Таблото на ClickUp показва напредъка на експериментите и натоварването на екипа в реално време. I
Вместо ръчно да събирате актуализации или да изпращате имейли, таблата за управление се актуализират автоматично въз основа на данните във вашите задачи. Така заинтересованите страни могат да проверяват състоянието по всяко време, да виждат как вървят нещата и никога да не се налага да ви прекъсват с въпроси от типа „Какъв е статутът?“.
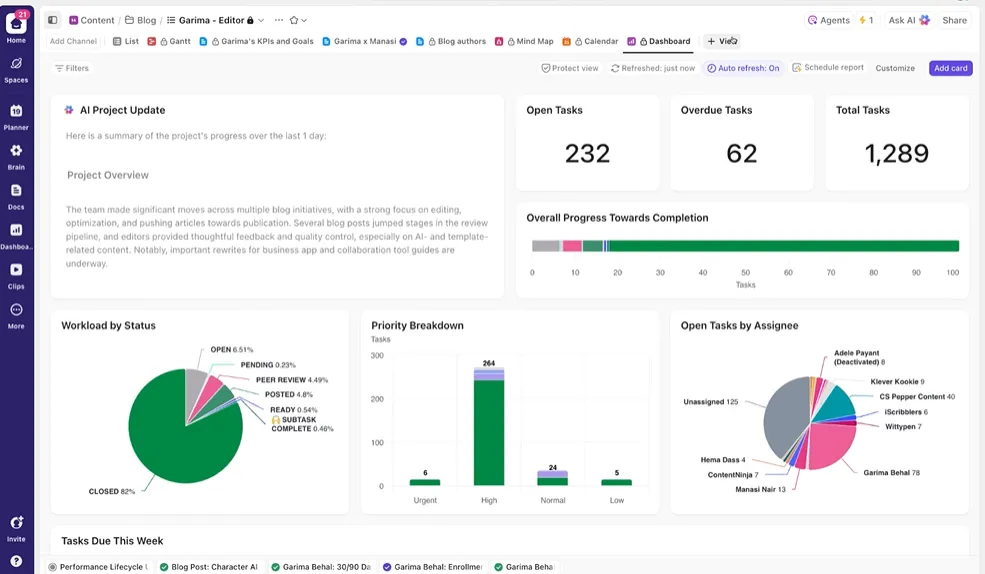
По този начин можете да се съсредоточите върху провеждането на експерименти, вместо постоянно да се налага да изготвяте ръчно отчети за тях.
Превърнете изкуствения интелект в своя интелигентен помощник по проектите
Няма нужда ръчно да претърсвате седмици наред данни за обучение, за да получите обобщение на проведените досега експерименти. Просто споменете @Brain в коментар към която и да е задача, и ClickUp Brain ще ви предостави необходимата помощ с пълен контекст за вашите минали и текущи проекти.
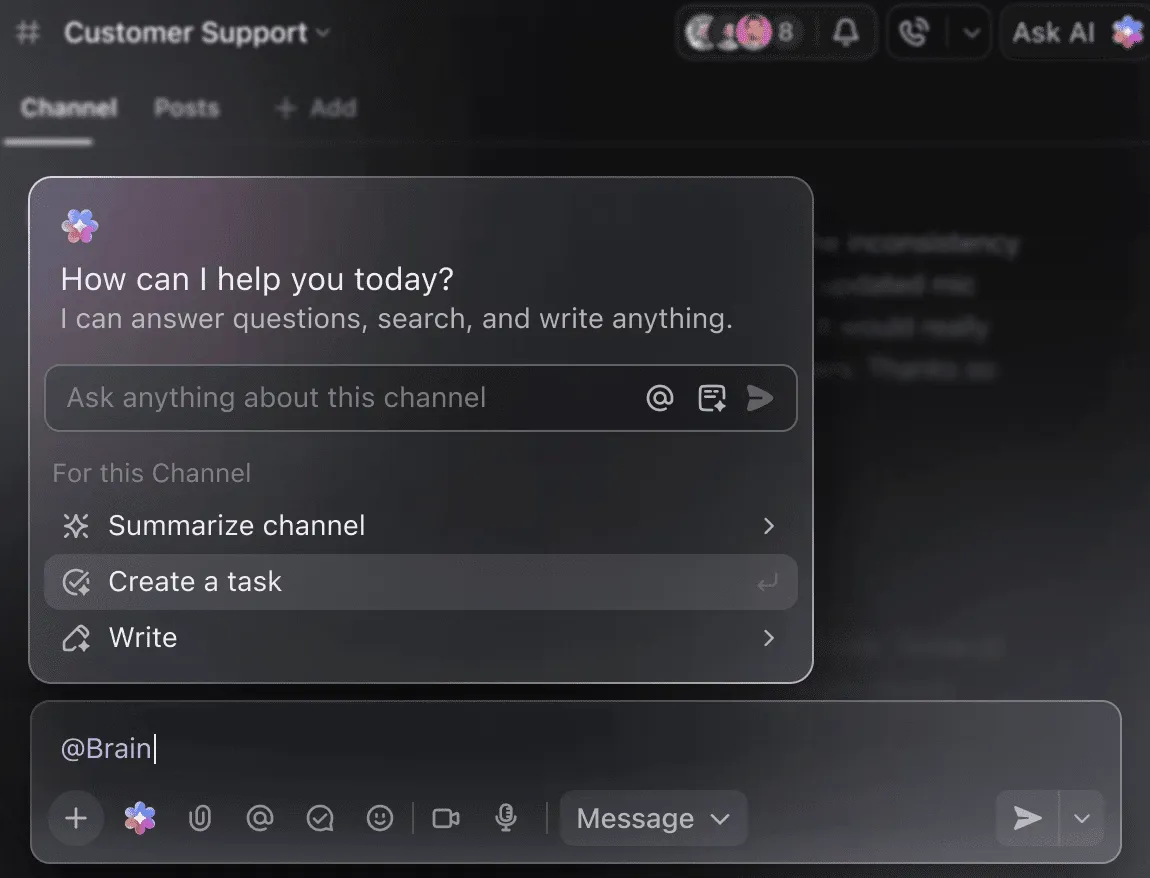
Можете да помолите Brain да „обобщи експериментите от миналата седмица в 5 точки“ или да „състави документ с най-новите резултати за хиперпараметрите“ и веднага да получите изпипан резултат.
🧠 Предимството на ClickUp: Супер агентите на ClickUp отиват още по-далеч — те могат да автоматизират цели работни потоци въз основа на тригери, които вие дефинирате, а не само да отговарят на вашите въпроси. С помощта на супер агентите можете автоматично да създавате нова задача за обучение в DBRX при всяко качване на набор от данни, да уведомявате екипа си и да свързвате съответните документи, когато цикълът на обучение приключи или достигне контролна точка, както и да генерирате седмичен отчет за напредъка и да го изпращате на заинтересованите страни, без да се налага да правите нищо.
Често срещани грешки, които трябва да се избягват
Започването на проект за обучение с DBRX е вълнуващо, но няколко често срещани капана могат да попречат на напредъка ви. Избягването на тези грешки ще ви спести време, пари и много разочарования.
- Подценяване на хардуерните изисквания: DBRX е мощен, но и заема много място. Опитът да го стартирате на неподходящ хардуер ще доведе до грешки за недостиг на памет и неуспешни задачи за обучение. Имайте предвид, че DBRX (132B) изисква поне 264 GB VRAM за 16-битова инференция или приблизително 70–80 GB при използване на 4-битова квантизация.
- Пропускане на проверките за качество на данните: Каквото влезе, такова излиза. Фината настройка на хаотичен набор от данни с ниско качество само ще научи модела да генерира хаотични резултати с ниско качество.
- Пренебрегване на ограниченията за дължината на контекста: Въпреки че прозорецът за контекст на DBRX от 32K е достатъчно голям, той не е безкраен. Подаването на входни данни към модела, които надвишават този лимит, ще доведе до незабележимо съкращаване и ниска производителност
- Кога е подходящо да използвате Base вместо Instruct: DBRX Base е необработен, предварително обучен модел, предназначен за по-нататъшно обучение в голям мащаб. За повечето задачи, свързани със следване на инструкции, трябва да започнете с DBRX Instruct, който вече е фино настроен за тази цел
- Разделяне на работата по обучението от координацията на проекта: Когато проследяването на експериментите ви се извършва в един инструмент, а планът на проекта – в друг, създавате информационни силози. Използвайте интегрирана платформа като ClickUp, за да синхронизирате техническата си работа с координацията на проекта
- Пренебрегване на оценката преди внедряване: Модел, който се представя добре с вашите тренировъчни данни, може да се провали катастрофално в реалния свят. Винаги валидирайте фино настроения си модел върху запазен тестов набор, преди да го внедрите в производствена среда.
- Пренебрегване на сложността при фината настройка: Тъй като DBRX е модел от типа „Mixture-of-Experts“, стандартните скриптове за фина настройка може да изискват специализирани библиотеки като Megatron-LM или PyTorch FSDP, за да се справи с разпределянето на параметрите между няколко графични процесора (GPU)
DBRX в сравнение с други платформи за обучение на ИИ
Изборът на платформа за обучение на ИИ предполага фундаментален компромис: контрол срещу удобство. Закритите модели, достъпни само чрез API, са лесни за използване, но ви обвързват с екосистемата на даден доставчик.
Моделите с отворени тегла като DBRX предлагат пълен контрол, но изискват повече технически опит и инфраструктура. Този избор може да ви накара да се почувствате в задънена улица, без да сте сигурни кой път всъщност подкрепя дългосрочните ви цели – предизвикателство, пред което се изправят много екипи при внедряването на изкуствен интелект.
Тази таблица представя основните разлики, за да ви помогне да вземете информирано решение.
| Тежести | Отворете (по избор) | Собственост | Отворете (по избор) | Собственост |
| Фино настройване | Пълен контрол | Базирано на API | Пълен контрол | Базирано на API |
| Самостоятелно хостинг | Да | Не | Да | Не |
| Лиценз | DB Open Model | Условия на OpenAI | Общност на Llama | Термини на Anthropic |
| Контекст | 32K | 128 000 – 1 млн. | 128K | 200 000 – 1 млн. |
DBRX е правилният избор, когато се нуждаете от пълен контрол над модела, трябва да го хоствате самостоятелно поради съображения за сигурност или съответствие с нормативните изисквания, или искате гъвкавостта на либерална търговска лицензия. Ако не разполагате със специализирана GPU инфраструктура — или цените бързото пускане на пазара повече от дълбоката персонализация — алтернативите, базирани на API, може да са по-подходящи за вас.
Започнете да обучавате по-умно с ClickUp
DBRX ви предоставя основа, готова за корпоративно използване, за създаване на персонализирани AI приложения, с прозрачност и контрол, каквито не получавате от патентовани модели. Ефективната му MoE архитектура поддържа ниски разходи за извличане на заключения, а отвореният му дизайн улеснява фината настройка. Но мощната технология е само половината от уравнението.
Истинският успех идва от съгласуването на техническата ви работа с работния процес на екипа ви, основан на сътрудничество. Обучението на модели за изкуствен интелект е екипна дейност и е от решаващо значение да се поддържа синхрон между експериментите, документацията и комуникацията със заинтересованите страни. Когато обедините всичко в едно конвергентно работно пространство и намалите разпръскването на контекста, можете да създавате по-добри модели по-бързо.
Започнете безплатно с ClickUp, за да координирате проектите си за обучение на ИИ в едно работно пространство. ✨
Често задавани въпроси
Как да следя напредъка на обучението в DBRX?
Можете да наблюдавате обучението, като използвате стандартни инструменти за машинно обучение като TensorBoard, Weights & Biases или MLflow. Ако провеждате обучение в екосистемата на Databricks, MLflow е интегриран по подразбиране за безпроблемно проследяване на експериментите.
Мога ли да интегрирам DBRX с CI/CD и пипалините за внедряване?
Да, DBRX може да бъде интегриран в стандартни MLOps пипалини. Чрез контейнеризиране на модела можете да го внедрите, като използвате платформи за оркестриране като Kubeflow или персонализирани CI/CD работни потоци.
Каква е разликата между DBRX Base и DBRX Instruct?
DBRX Base е основният предварително обучен модел, предназначен за екипи, които искат да извършват продължително предварително обучение в конкретна област или дълбока архитектурна фина настройка. DBRX Instruct е фино настроена версия, оптимизирана за следване на инструкции, което я прави по-добра отправна точка за разработката на повечето приложения.
Как се сравнява DBRX с GPT-4 при корпоративни проекти за изкуствен интелект?
Основната разлика е в контрола. DBRX ви предоставя пълен достъп до теглата на модела за дълбока персонализация и самостоятелно хостинг, докато GPT-4 е услуга, достъпна само чрез API.
Може ли да се използва DBRX безплатно?
Тегловете на модела DBRX са достъпни безплатно съгласно лиценза Databricks Open Model License. Вие обаче поемате разходите за изчислителната инфраструктура, необходима за изпълнението или фината настройка на модела.