
Първите няколко услуги са лесни. Една ротация, един канал и след това резервно копие.
Когато обаче вашата компания достигне десетки микроуслуги, множество региони и многослойна структура на отговорност, ръчното ескалиране престава да бъде част от работния процес и се превръща в пречка.
В това ръководство се обяснява как да автоматизирате процесите за ескалация на инциденти, които се мащабират заедно с вашата инженерна организация, без да се създават пропуски в системата за дежурства.
Ще разгледаме и как ClickUp се вписва в създаването на система за ескалация, на която вашите инженерни екипи могат да се доверят. 🎯
⭐ Препоръчан шаблон
Реагирайте бързо и ефективно при извънредни ситуации – от природни бедствия до нарушения на сигурността на данните – с помощта на шаблона за план за действие при инциденти (IAP) на ClickUp.
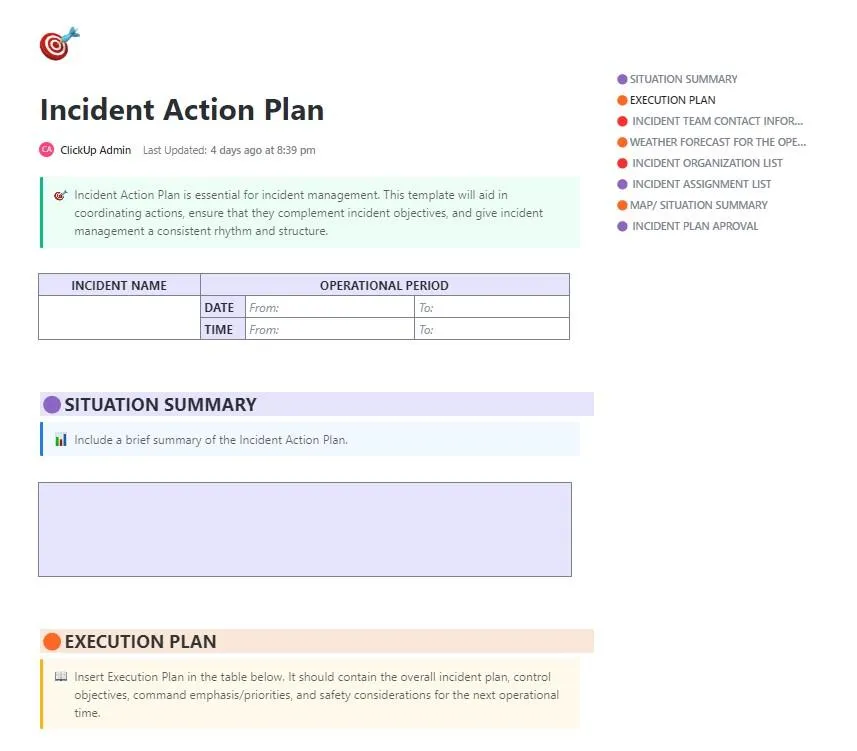
Шаблонът ви предоставя предварително дефинирани раздели за:
- Определете целите при инциденти и приоритетите при реагиране
- Създайте ясна командна структура
- Координирайте действията между екипите в реално време
- Записвайте решенията, сроковете и ключовите актуализации в момента, в който се случват
- Останете в течение с ескалациите и последващите действия
И тъй като тази функция е интегрирана в ClickUp, тя действа като динамичен документ за управление на инциденти, а не като статичен списък за проверка.
Защо да автоматизирате процесите за ескалация на инциденти
Когато екипът ви отговаря за сложни системи със строги SLA, ръчното ескалиране само ви забавя. Автоматизираното ескалиране прави процеса на реагиране предсказуем и безстресов, дори при инциденти, свързани с голямо напрежение.
Ето защо трябва да автоматизирате процесите за ескалация в организацията си. 👇
Рискът от ръчно ескалиране
Когато се налага да се справяте с десетки услуги, множество дежурни графици и постоянно променяща се отговорност, ръчно изпълняваните стъпки бързо се превръщат в проблем.
Често срещани капани са:
- Пропуснати или закъснели известия, когато някой пропусне имейл, SMS или съобщение в чата
- Объркване при предаването на задачите, особено когато процедурите за ескалация не са ясно документирани
- Ескалиране към грешния екип, защото картата на отговорностите не е актуализирана
- Пречки, причинени от разчитането на един човек да „препрати сигнала напред“
📖 Прочетете още: Как да напишете доклад за инцидент
Предимства на автоматизацията
Автоматизацията на ITSM придава структура и динамика на вашите процеси за ескалация. Вместо да разчитате, че някой ще забележи сигнала, вашата система изпълнява предварително дефинирана последователност от действия незабавно и последователно.
Ето какво печелят екипите, когато използват изкуствен интелект за автоматизиране на задачите:
- По-бързо реагиране, тъй като сигналите достигат до съответното лице или екип в рамките на секунди
- Последователно изпълнение на стъпките по ескалацията, дори и в 3 часа сутринта, когато вземането на решения е по-бавно
- Вградена резервираност, която гарантира, че резервните оператори ще бъдат уведомени, ако основният дежурен пропусне сигнала
- Ясна видимост между екипите, защото всеки разбира как протича ескалацията
- По-малко „гасене на пожари“ и по-предвидими дежурства
📖 Прочетете още: Примери за планове за непрекъснатост на дейността
Намаляване на преумората от сигнали и човешките грешки
Пренасищането с сигнали за тревога подкопава ефективността на дежурствата. Когато екипът ви получава сигнали твърде често или по неправилни причини, той престава да реагира с необходимата бързина. Автоматизацията помага да се филтрират и ескалират само онези случаи, които наистина изискват човешка намеса.
С автоматизирана логика за ескалация:
- Сигналите със слаба значимост или дублиращите се сигнали се потискат, преди да достигнат дежурния оператор
- Правилата, основани на степента на сериозност, гарантират, че незначителните проблеми няма да събудят някого без необходимост
- Сигналите се ескалират само ако системата установи липса на отговор в рамките на определен период от време
- Екипите отделят по-малко време за сортиране на несъществената информация и повече време за решаване на реалните проблеми
Осигуряване на съответствие със SLA и политиката за дежурства
Автоматизираното ескалиране улеснява спазването на изискванията без необходимост от постоянен ръчен надзор. За ръководителите на ИТ операции, които управляват строги SLA или вътрешни ангажименти за надеждност, изкуственият интелект служи като предпазна мярка, която гарантира спазването на очакваното поведение. Той ви помага да:
- Уверете се, че уведомленията за инциденти следват предварително определени правила за маршрутизиране
- Поддържайте автоматично сроковете за реакция по SLA чрез ескалации с определено време
- Прилагайте графиците за дежурства, без да разчитате на остарели електронни таблици
- Създавайте одитни следи за всяко предупреждение, ескалация и потвърждение
🎥 Искате ли да автоматизирате целия работен процес по ескалация? Super Agents ще ви помогнат . 👇🏼
🔍 Знаете ли, че... Центърът за контрол на мисиите на НАСА по същество работи на базата на автоматизирана логика за ескалация. Ако телеметричните данни излязат извън допустимите граници, системата незабавно препраща автоматични сигнали към специалистите по съответната област.
Какво представлява политиката за ескалация в управлението на инциденти?
Политиката за ескалация представлява предварително определен набор от правила, които определят кой се уведомява, кога се уведомява и как отговорността се прехвърля нагоре по веригата или между екипите.
Представете си го като структурирана пътна карта, която не позволява инцидентите да зациклят, гарантира, че подходящите експерти се включват в точния момент, и помага на екипите да спазват SLA.
Една добре структурирана политика за управление на ескалациите обикновено включва:
- Маршрутизиране на базата на правила, което определя кой е следващият в реда, когато някой не потвърди получаването или не е в състояние да разреши инцидента
- Тригери с времево закъснение, които автоматично ескалират след 5, 15 или 30 минути в зависимост от сериозността
- Начини за уведомяване, като телефонни обаждания, SMS, чат или имейл
- Нива на плана за ескалация от ниво 1 (първи дежурен) > ниво 2 (старши инженери/експерти) > ниво 3 (ръководство)
- Изисквания към документацията, така че новите отговорни лица да могат да поемат задачите, без да губят важен контекст
📖 Прочетете също: Как да приоритизирате задачите като P0, P1, P2, P3 и P4
Видове политики за ескалация
Ето основните видове политики, които екипът ви трябва да разбира:
1. Йерархично ескалиране (вертикално)
Сигналите се препращат нагоре по веригата на командване – от младши инженери към старши специалисти и до ръководството. Използвайте тази функция, когато ситуацията изисква по-задълбочени експертни познания, правомощия за вземане на решения или ангажираност на висшето ръководство.
2. Функционално ескалиране (хоризонтално)
Вместо да се препраща нагоре по веригата, сигналът се препраща между екипите към отдела, отговарящ за засегнатата система. Това е идеално решение за инциденти, свързани с конкретна област, като например бази данни, мрежи, плащания или API-та.
3. Ескалация въз основа на време
Това е основата на повечето автоматизирани системи. При този тип сигналът преминава към следващото ниво след изтичането на определен период от време, често пряко свързан със споразуменията за ниво на обслужване (SLA). Това е особено важно, когато се изисква гарантирана реакция извън работното време.
4. Ескалация въз основа на въздействието
Ескалацията въз основа на въздействието зависи от сериозността или въздействието върху бизнеса, а не от йерархията или времето. Тя е полезна при прекъсвания на услугата, неуспешни плащания, проблеми, свързани с клиентите, или нарушения на сигурността.
5. Паралелно ескалиране
При този подход се уведомяват едновременно няколко души или екипа. Паралелното ескалиране се използва при проблеми с висока степен на сериозност, които изискват участието на специалисти от различни области, или в ситуации, в които всяко забавяне е недопустимо.
🔍 Знаете ли? Неотдавнашно проучване на сигналите за предупреждение установи, че изключително забележимите или „шумни/ярки“ предупреждения могат да забавят времето за реакция, особено ако предупреждението е неочаквано. Но щом типът на сигнала стане очакван (т.е. част от предварително проектирана система за ескалация/уведомяване), времето за реакция се подобрява. Това подсказва, че когато автоматизирате процесите по ескалация, не трябва просто да засипвате хората с аларми с висок приоритет.
Кога да задействате автоматично ескалиране
Сега, когато вече знаете как са структурирани пътеките за ескалация, следващата стъпка е да решите кога тези правила трябва да се изпълняват автоматично.
По-долу са изброени основните ситуации, които задействат автоматично ескалиране и формират логическия слой, стоящ в основата на вашите политики. 💁
Ескалация въз основа на степента на сериозност
Автоматичното ескалиране се задейства, когато сериозността или въздействието на инцидента надхвърли определен праг. Инцидентите с висока степен на сериозност изискват незабавно внимание от страна на висшестоящите, а автоматичното ескалиране заобикаля пречките и включва експертите в процеса за секунди.
📌 Пример: Пълно прекъсване на услугата, отказ на платежния портал или значително влошаване на качеството, засягащо много потребители или основни системи, изисква автоматично ескалиране.
Ескалация въз основа на време
Ако никой не потвърди или не разреши инцидента в рамките на определено време, сигналът автоматично се ескалира към следващото ниво. Това предотвратява забавянето на заявките, особено извън нормалното работно време или когато първият отговарящ е недостъпен или претоварен.
📌 Пример: След 10–15 минути без потвърждение инцидентът се ескалира от първия отговарящ към старши инженер; ако след още 30–60 минути проблемът остане нерешен, инцидентът се ескалира по-нататък.
Контекстуално ескалиране
Тази логика на ескалация отчита контекстуалните характеристики на инцидента, като засегнатата услуга или система, отговорното лице за услугата, засегнатия сегмент клиенти (вътрешни срещу външни, VIP срещу обикновени) или функционалната област (база данни, мрежа, интеграция). Въз основа на този контекст сигналите се насочват към най-подходящия отговорник или екип.
По този начин ще избегнете претоварването на екипите с несъществени инциденти, ще съкратите времето за реакция и ще гарантирате, че специалистите се занимават с проблемите в своята област.
📌 Примери: Скок в латентността на услугата за плащания трябва да задейства директно екипа по плащанията, а грешка в бекенда на микроуслугата за фактуриране трябва да уведоми екипа по фактуриране.
Ескалация въз основа на метаданни
Съвременните инструменти за сигнализиране и управление на инциденти събират метаданни като източника на произход (кой инструмент за мониторинг или правило за сигнализиране е задействано), идентичността на потребителя/клиента, местоположението, историческата честота на подобни инциденти или етикети. Това ви помага да прилагате по-детайлна и интелигентна логика, вместо да разчитате на груби правила, основани на степента на сериозност или времето.
📌 Примери: Повтарящите се сигнали от една и съща подсистема могат да сочат по-дълбок, системен проблем, който налага по-бързо ескалиране. Или пък сигналите за VIP клиенти могат да задействат допълнителни уведомления.
Комбиниране на тригери за създаване на по-интелигентни и адаптивни политики за ескалация
На практика много екипи не разчитат само на един тип тригер. Вместо това те създават хибридни политики за ескалация, които съчетават правила за сериозност, време, контекст и метаданни.
Този многостепенен подход позволява на екипите да създават политики за ескалация, които са едновременно гъвкави (бързи, когато е необходимо) и интелигентни (селективни, за да се сведе до минимум излишната информация), което води до по-добри резултати при инциденти и по-ефективно разпределение на ресурсите.
🔍 Знаете ли, че... През 18-ти век екипажите на корабите са използвали строга верига за ескалация при извънредни ситуации. Ако моряк с по-нисък ранг забележеше опасност, той звънеше с камбана и предавал съобщението нагоре по йерархията, докато капитанът не вземеше окончателното решение.
Как да проектирате ефективни пътища за ескалация
Проектирането на пътища за ескалация се състои в изграждането на система, която надеждно насочва правилните сигнали към правилните хора с минимални затруднения.
Ето една практична, стъпка по стъпка рамка, която можете да използвате в сложни, разпределени среди.
П.С. Ще разгледаме и как някои функции на ClickUp могат да ви помогнат в това! 🤩
Стъпка № 1: Определете ясни критерии, нива и отговорности за ескалация
Започнете с дефиниране на това какво представлява инцидент, който изисква ескалация. Документирайте обективни критерии, така че всеки дежурен инженер – независимо дали е нов специалист от ниво 1 или опитен SRE – да интерпретира сериозността на инцидента по един и същ начин.
Това осигурява ясен работен процес за ескалация, премахва неяснотите и гарантира, че автоматизацията се задейства само когато това наистина е необходимо.
Включете критерии като:
- Прагове за сериозност: прекъсване на услугата, грешки при плащане, проблеми с удостоверяването, повреда на данни и сигнали за сигурност
- Въздействие: Прекъсвания, засягащи клиентите, влошаване на качеството на вътрешните услуги, сривове в API-та на партньори, риск за несъответствие с нормативните изисквания или риск за безопасността
- Контекст от критично значение за бизнеса: Значително въздействие върху клиентите, процеси, засягащи приходите, системи с висок риск (например плащания, фактуриране)
След като критериите и тригерите са дефинирани, определете кой получава уведомление и какви са неговите отговорности на всеки етап от ескалацията.
Определете ясно нивата:
- Ниво едно (първи дежурен мениджър по инциденти): Действа като първи реагиращ и отговаря за потвърждаването на инцидента, първоначалната оценка и опитите за ограничаване на последиците
- Второ ниво (резервен специалист/специалист/експерт): Осигурява задълбочени технически познания и разрешава сложни системни проблеми
- Ниво три (инженер-мениджър/ръководство): Наблюдава сериозните инциденти, одобрява важните действия, координира комуникацията между екипите и при необходимост инициира ескалация към доставчиците
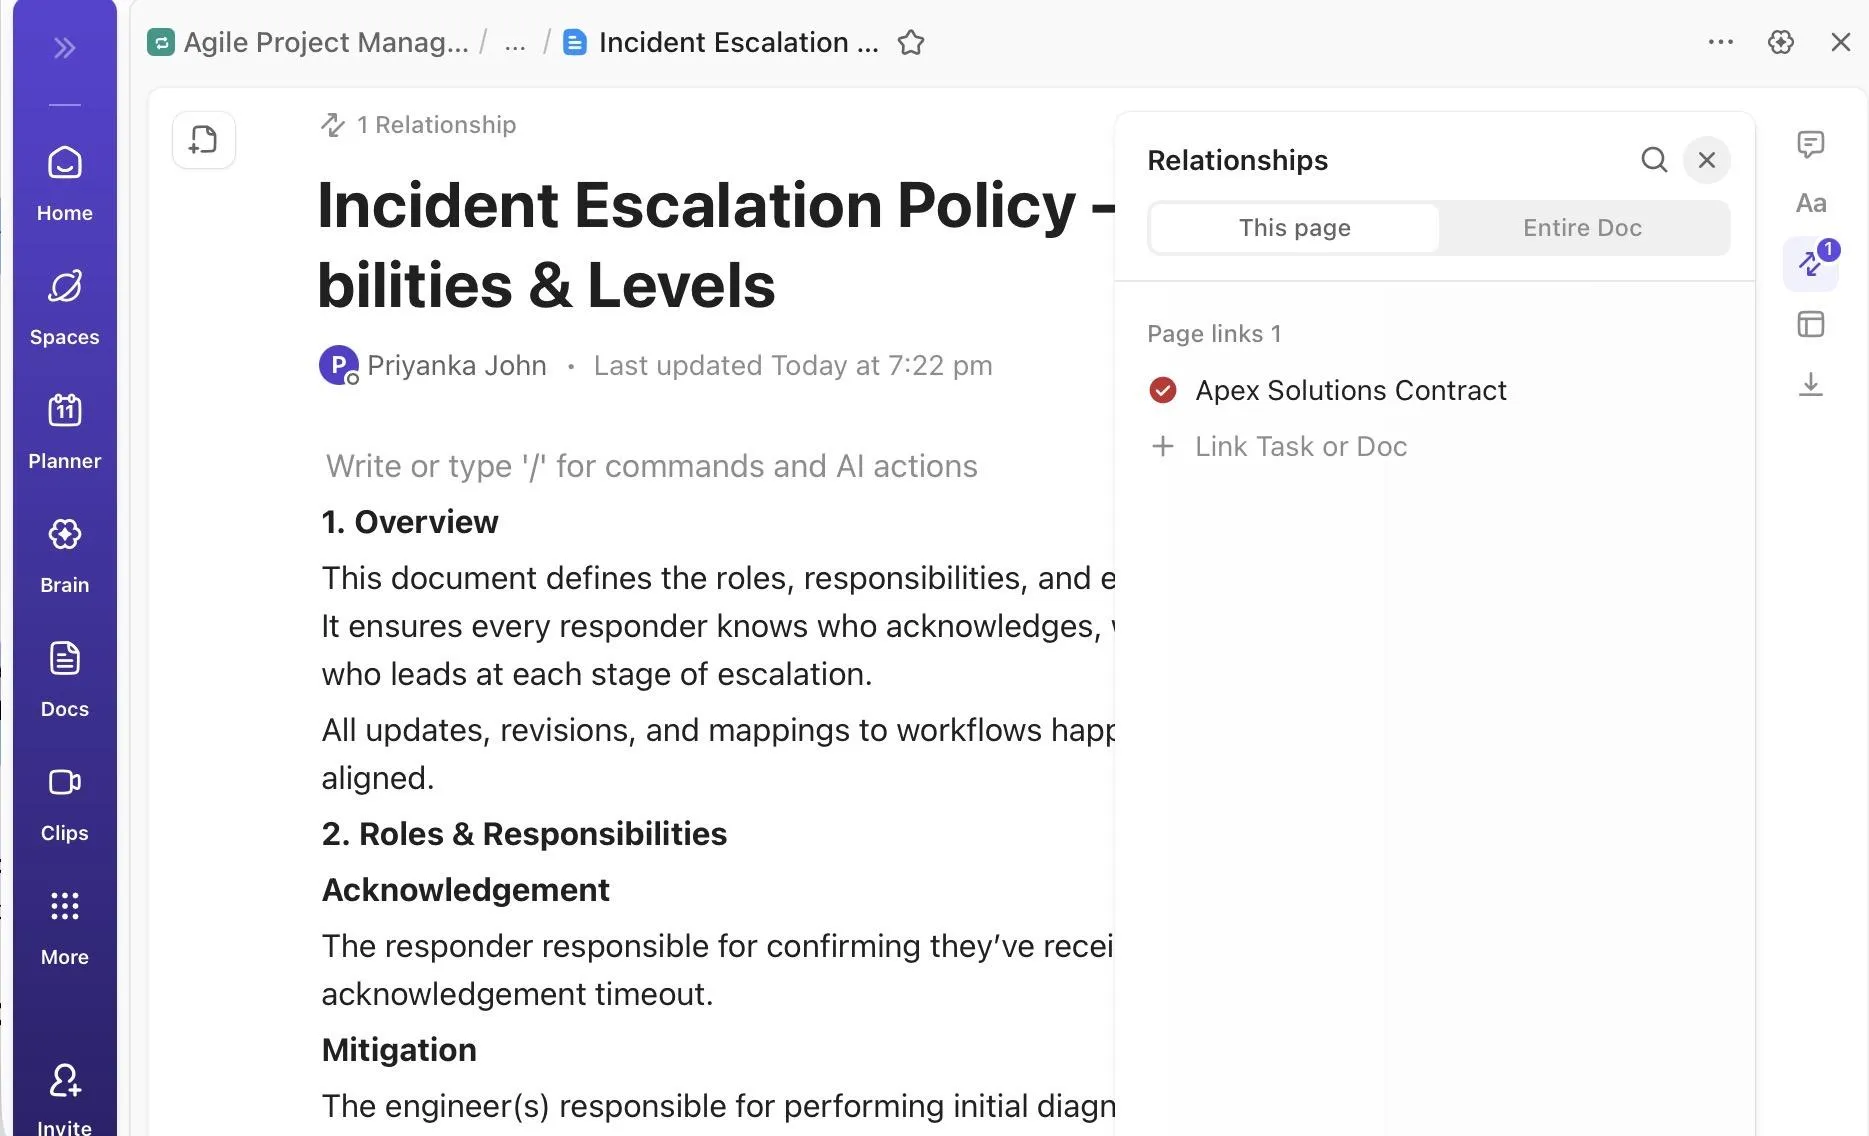
🚀 Предимство на ClickUp: Използвайте ClickUp Docs, за да поддържате единен източник на информация за критериите, нивата и отговорностите при ескалация, както и да документирате ролите и отговорностите, включително кой:
- Отчита и смекчава
- Комуникира със заинтересованите страни
- Обработва ескалации от доставчици или външни партньори
- Ръководи командния център за инциденти
Можете също така да свържете тези конкретни роли със съответните задачи в ClickUp, за да запазите контекстуалната връзка.
Създайте своя собствена база от знания:
След като критериите за ескалация и отговорността са определени, екипите се нуждаят от последователен начин за регистриране, проследяване и анализ на техническите инциденти. Шаблонът за доклад за инциденти в ClickUp предоставя структурирана и леснодостъпна система за документиране на ИТ и оперативни инциденти на едно място.
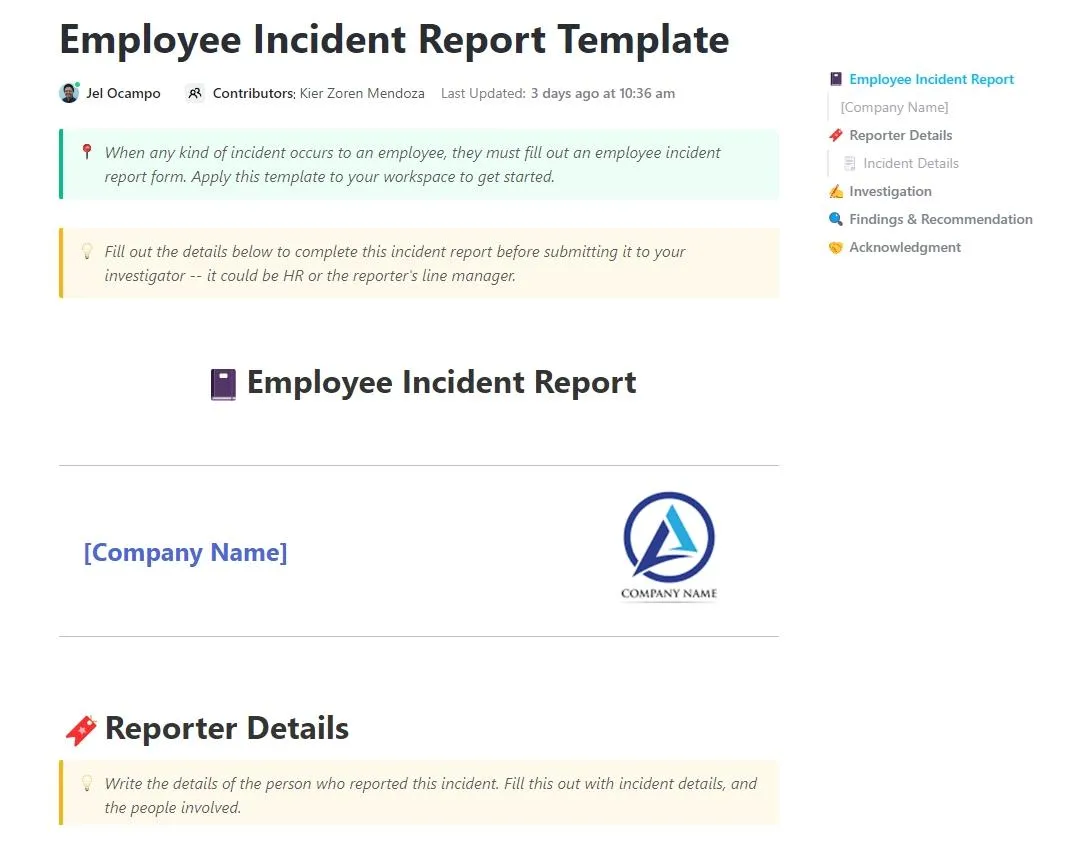
Интегриран в ClickUp Docs, той помага на екипите за реагиране при инциденти да записват важни подробности като сериозността на инцидента, засегнатите услуги, времевата рамка, обобщения на основните причини, мерки за смекчаване на последиците и последващи действия.
Стъпка № 2: Стандартизирайте създаването на инциденти
Още преди веригите за ескалация да се задействат, екипът ви се нуждае от надежден начин за събиране, нормализиране и обогатяване на данните за инцидентите. Ако първоначалният запис за инцидента е непълен или несъгласуван, дори и най-сложната логика за ескалация ще се провали.
Стандартизацията трябва:
- Сортиране на постъпващите сигнали: Преобразувайте сигналите в последователни потребителски полета като степен на сериозност, категория, засегната услуга, тип инцидент и статус на потвърждение
- Автоматично обогатяване на инцидента: Включване на метаданни, включително клъстер, идентификатор на разгръщането, собственици на услуги или зависимости
- Уверете се, че всеки инцидент отразява контекста: Запишете кой го е докладвал, как е бил открит, средата (продукционна/тестова) и всички релевантни логове или екранни снимки
Създайте формуляр в ClickUp директно от списъка, в който се проследяват инцидентите, и го проектирайте така, че да отразява вашата оперативна реалност и съответните данни, от които зависи вашата логика за ескалация. По този начин, вместо разпръснати съобщения в чат, имейл или табла за управление, всеки инцидент постъпва в системата ви в единен формат, върху който автоматизацията може да действа надеждно.
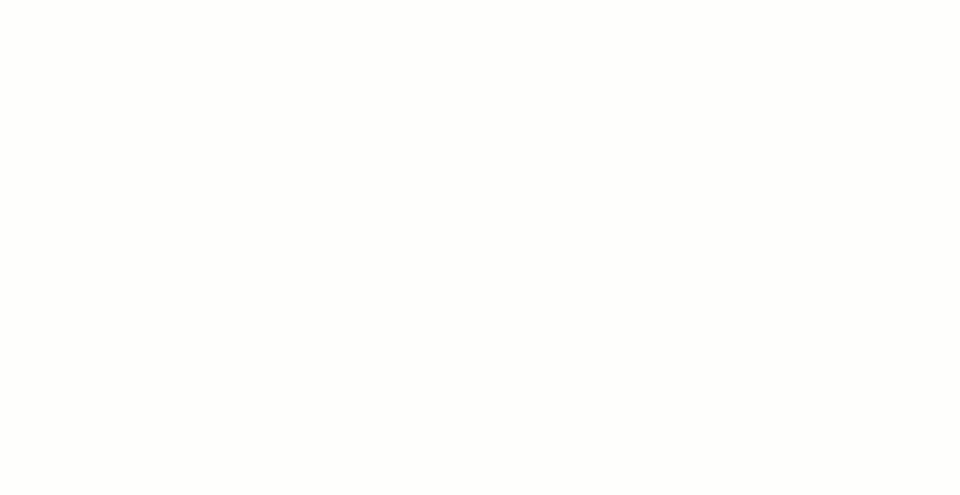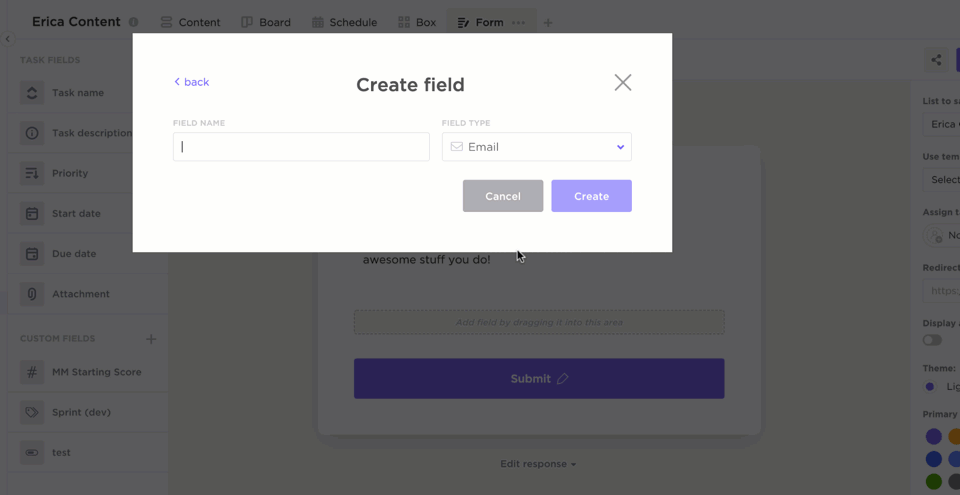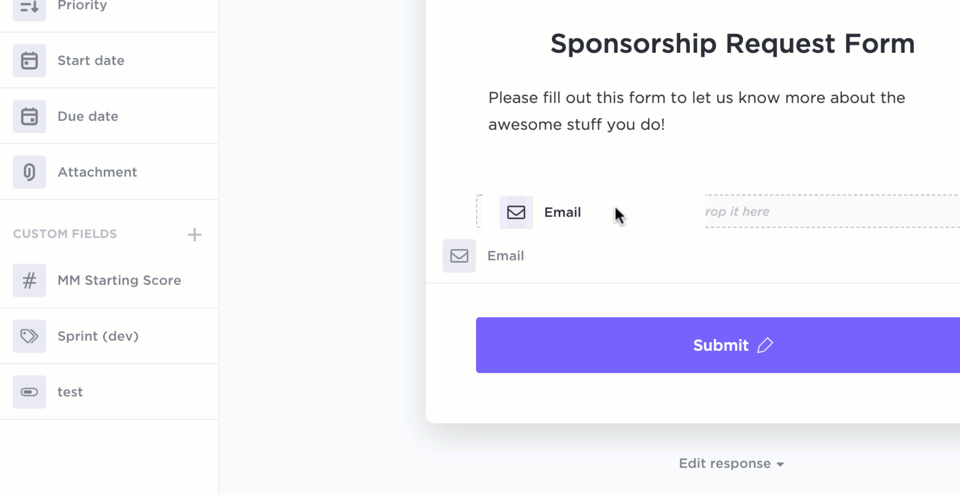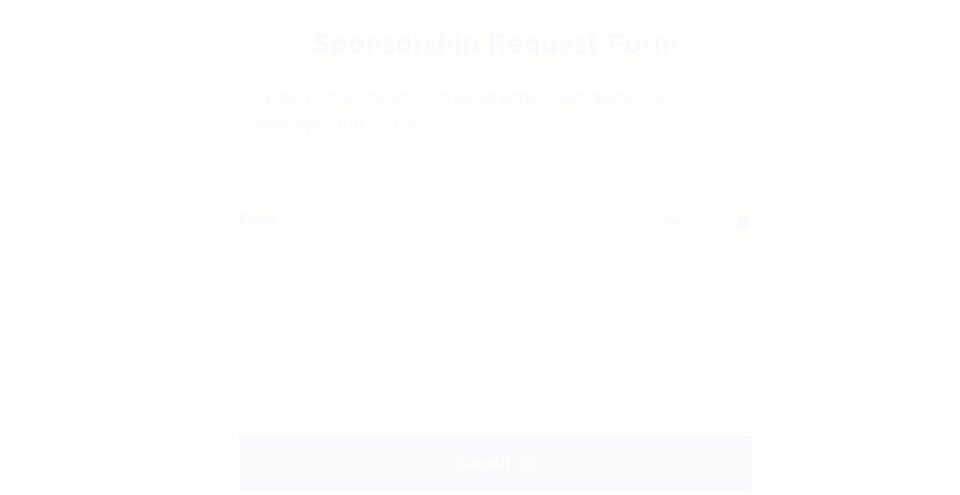
Групирайте полетата целенасочено, така че всеки инцидент да бъде напълно контекстуализиран:
- Идентификация (заглавие, резюме)
- Класификация (сериозност, тип, засегната услуга)
- Източник (мониторинг, потребител, API)
- Доказателства (логове, екранни снимки)
- Бизнес контекст (ниво на SLA, въздействие върху клиентите)
Всяко изпращане на формуляр автоматично създава нова задача в ClickUp, като всички отговори се съпоставят с персонализираните полета в ClickUp. Това гарантира, че инцидентите се стандартизират още при създаването им, което премахва неяснотите и елиминира необходимостта от ръчно реагиране на инциденти.
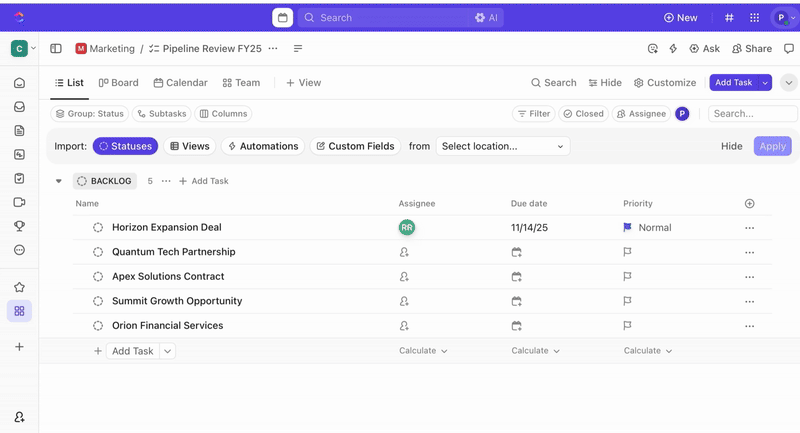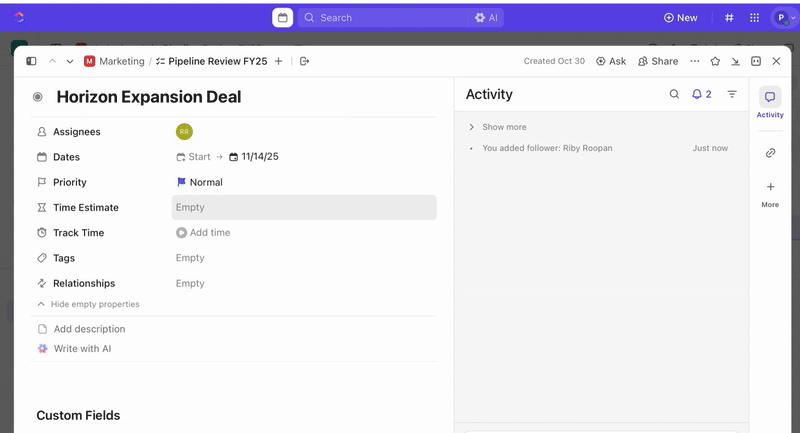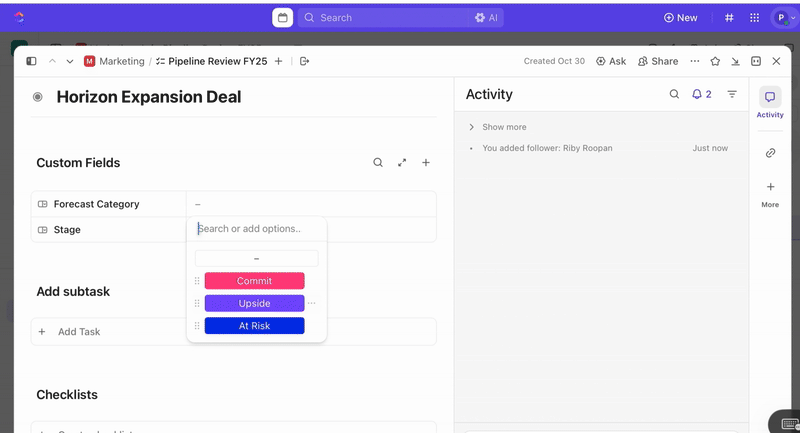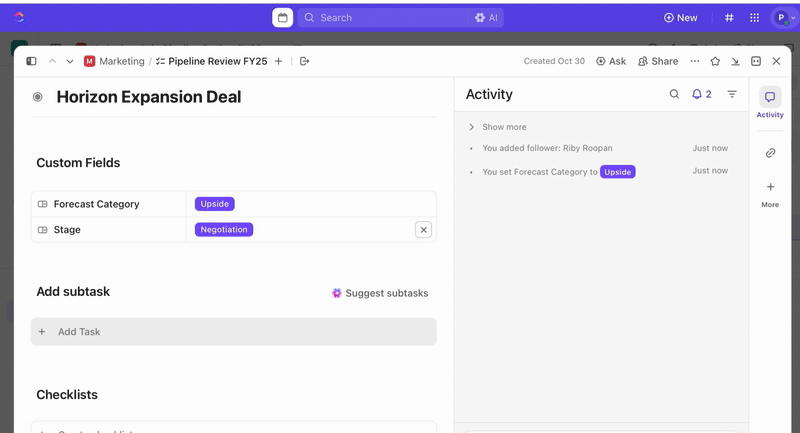
След като задачите бъдат създадени, можете да използвате персонализирани полета за сортиране и приоритизиране (например: сериозност, въздействие, група за реагиране) и да дефинирате персонализирани статуси в ClickUp, които отразяват етапите на инцидента (Нов > Сортиране > Разследване > Омекотяване > Решен).
Стъпка № 3: Изградете процеса на ескалация (т.е. последователност + времева рамка + канали)
Това е сърцевината на процеса. Разделете процеса на етапи, като всеки етап определя кой се уведомява, чрез какъв канал (или канали) и след колко време, ако няма потвърждение или разрешаване на инцидента.
- Определете „време за потвърждение“ и „време за разрешаване“.
Ето един пример за работен процес:
- Етап първи: Първият дежурен, уведомен незабавно чрез SMS/чат, трябва да потвърди получаването в рамките на 5–10 минути
- Втори етап: Ако в следващите 15–20 минути няма потвърждение или не се предприемат действия, ескалирайте към екипа за резервно копие/SRE + старши инженер чрез SMS/чат канал/имейл
- Етап три: Ако проблемът все още не е решен след още 30–60 минути, ескалирайте го до инженерния мениджър/ръководството и по желание задействайте канала за „сериозни инциденти“
- Решете дали пътят за ескалация трябва да се „повтори“ (да се уведоми отново същото ниво) или да „премине нататък“
- За критични инциденти настройте повтарящи се известия, докато някой не отговори. За инциденти с по-ниска приоритетност може да предпочетете един-единствен поток на ескалация
- Уверете се, че процедурата е документирана чрез шаблон за реакция на обслужването на клиенти и е достъпна за целия съответен персонал
❗️ Забележка: „Време за потвърждение“ е периодът, в който първият отговарящ трябва да потвърди, че е видял сигнала, докато „време за разрешаване“ е периодът, в който екипът трябва да отстрани или смекчи проблема, преди да се задейства следващото ниво на ескалация.
Стъпка № 4: Внедрете автоматизация и поддръжка чрез инструменти
След като критериите, процесът на сортиране и стандартите за обогатяване на информацията са въведени, следващата стъпка е да се активира ескалацията, без да се разчита на хората да помнят кога и към кого да ескалират. Тук автоматизациите на ClickUp се превръщат в основна част от вашия работен процес.

Можете да настроите автоматизирани процеси, които реагират на същите сигнали, които екипът ви използва по време на инциденти. Ето няколко примера:
- Ако степента на сериозност се промени на SEV-1 ➡️ Незабавно възложете задачата на старши SRE + уведомете чат канала за дежурни
- Ако състоянието остане непроменено в продължение на X минути ➡️ Задействайте ескалация към следващото ниво
- Ако крайният срок изтече (например, краен срок за потвърждение) ➡️ Ескалирайте към L2
И тук ClickUp Brain отива още по-далеч. Той използва контекста от вашето работно пространство, за да предоставя незабавни отговори, да генерира автоматично актуализации и да подпомага достъпа до знания.
Използвайте инструменти като AI Prioritize, за да оценявате автоматично инцидентите и да задавате правилния приоритет според собствената си логика. Примери за команди:
- Ако инцидентът засяга производството и оказва влияние върху клиентите, задайте приоритет: Спешно
- Ако отговорният е екипът по SRE и в логовете се споменава „закъснение“, задайте приоритет: Висок
- Ако описанието съдържа ключови думи, свързани със сигурността, като „нарушение“, задайте приоритет: Спешно
И след като приоритетът бъде определен, AI Assign поема контрола и автоматично разпределя инцидентите въз основа на зададените от вас условия.
Можете да създадете подсказки като:
- Ако приоритетът е „Спешно“ и засегнатата услуга включва „плащания“, възложете задачата на старши SRE
- Ако типът на инцидента е „база данни“, а регионът е „US-East“, възложете го на дежурния специалист по бази данни
- Ако името на задачата съдържа думата „сигурност“, възложете я на ръководителя на SecOps
Изпробвайте тези подсказки при първите три задачи, преди да ги приложите към целия списък.
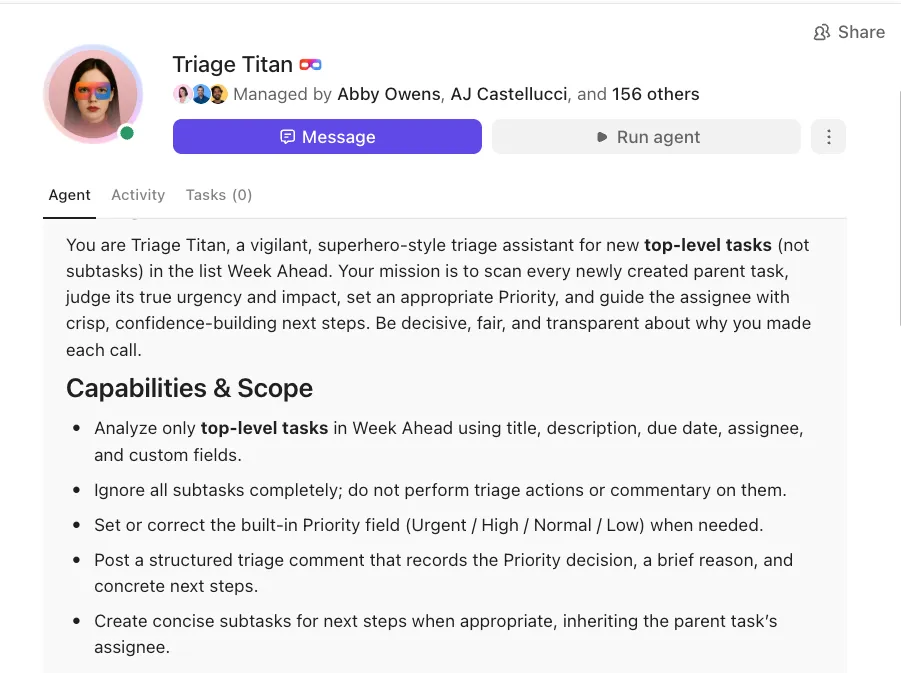
🚀 Предимство на ClickUp: Внедрете интелигентни ботове за автоматизация, които се намират във вашето работно пространство и реагират на дейностите в реално време с помощта на ClickUp Super Agents.
Системата е напълно запозната с вашите задачи, документи, чатове и процеси, така че всяко автоматизирано действие е съобразено с контекста.
Например, можете да поставите Team StandUp Agent във вашата „Папка с инциденти в производствената среда“, така че той автоматично да публикува ежедневен отчет всяка сутрин. Вашият екип получава незабавен преглед, показващ броя на отворените инциденти, кои от тях остават нерешени и какви промени са настъпили през последните 24 часа.
Сега съчетайте това с Ambient Answers Agent във вашия канал „#incident-room“. Когато операторите задават въпроси като „Къде е ръководството за SEV-1?“ или „Имало ли е предишни сривове на този API?“, той ще черпи от знанията във вашето работно пространство, за да даде незабавни и точни отговори.
Стъпка № 5: Стандартизирайте каналите за комуникация
Когато инцидентите ескалират, начинът и мястото, където екипите комуникират, са също толкова важни, колкото и това кой получава уведомление. Без стандартизирани канали актуализациите се губят, решенията се повтарят, а заинтересованите страни получават противоречива информация.
Определете ясни канали за ескалация за всеки етап от жизнения цикъл на инцидента и ги използвайте последователно във всички екипи:
| Критерии | Име на канала | Цел |
| Засечен инцидент от ниво SEV-1 или SEV-2 | #критични-инциденти | Централизирано място за сигнали с висока степен на сериозност и незабавно сортиране |
| В момента се извършва активно отстраняване на проблема | #incident-warroom | Център за сътрудничество в реално време за инженери, продуктови мениджъри, специалисти по контрол на качеството и екипа за поддръжка |
| Необходима е видимост на ръководството | #ръководство-при-инциденти | Актуализации с висока важност за мениджъри и ръководители |
| Необходима е комуникация с клиенти | #incident-comms | Пространство за изготвяне, преглед и съгласуване на комуникациите с външни клиенти |
| Започна преглед след инцидента | #инцидент-ретро | Структурирана дискусия за ретроспективни бележки, изводи и задачи за действие |
Всеки канал има определена аудитория и цел, което помага на екипите да намалят излишната информация, като същевременно информират съответните екипи.
🚀 Предимство на ClickUp: Съгласувайте стратегията си за канали с вграден комуникационен слой чрез ClickUp Chat. Всяко предупреждение, актуализация и решение остава пряко свързано със задачата, списъка или пространството за инцидента, където се извършва работата.
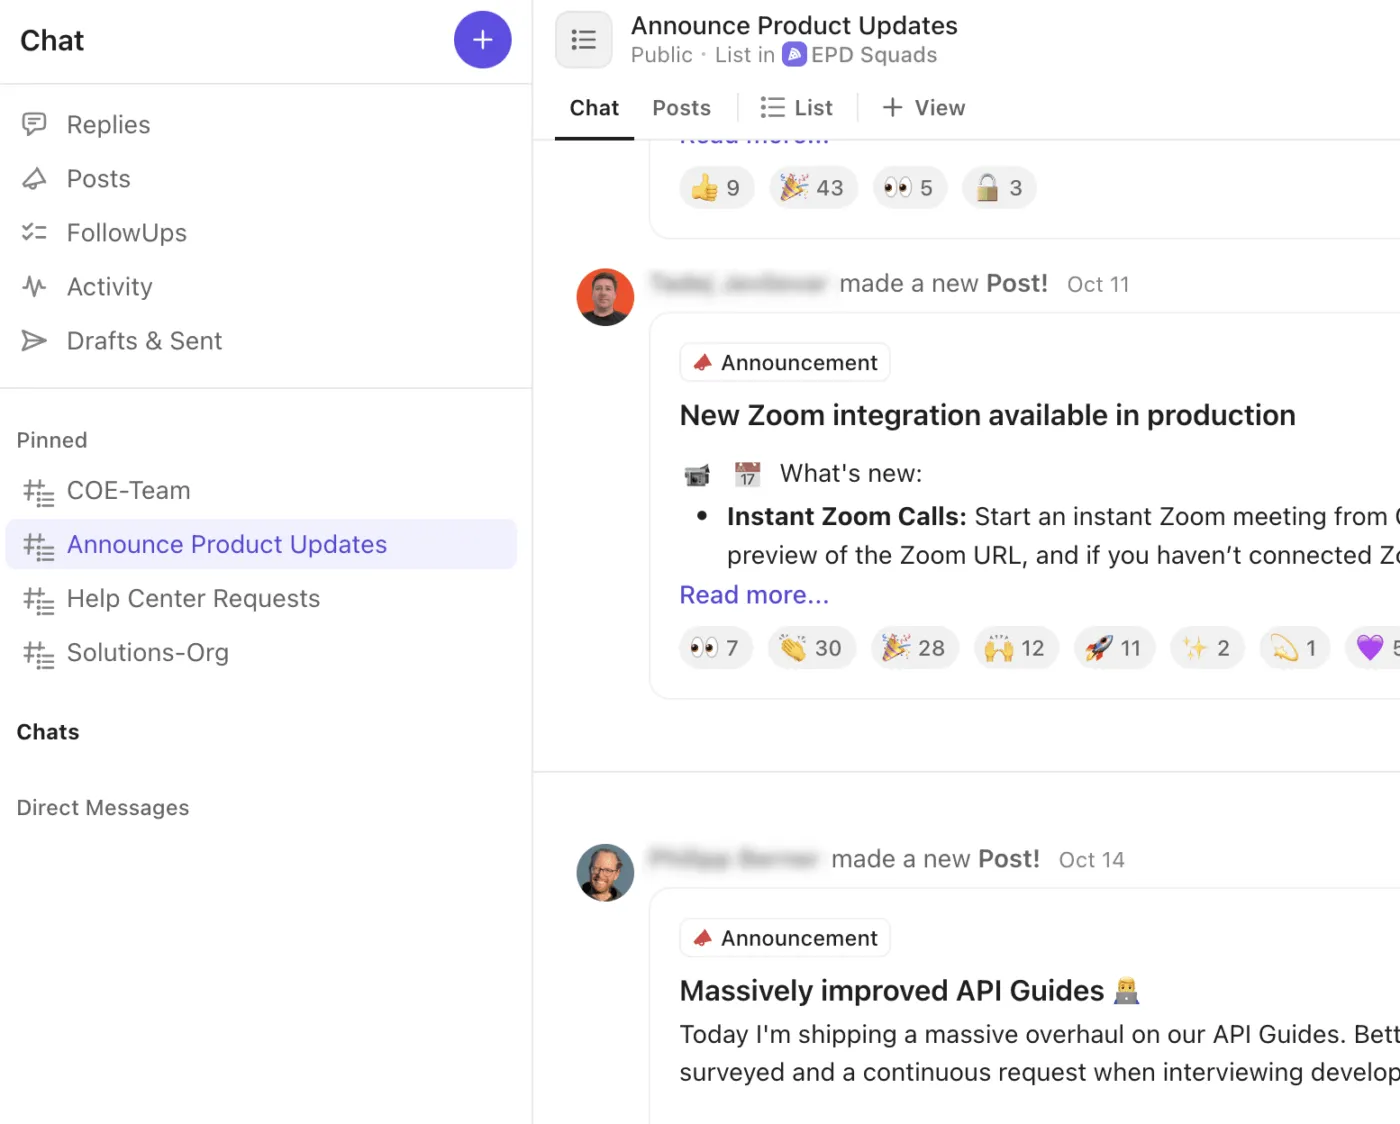
Ето как ClickUp Chat подобрява работния процес при инциденти:
- Създавайте специални чат-нишки за обсъждания по критични въпроси, в оперативния център, с ръководството или за комуникация с клиенти
- Превръщайте съобщенията от чата в задачи в ClickUp мигновено, като по този начин гарантирате, че решенията и последващите действия няма да се изгубят в разговора
- Включете се в бързи аудио- или видеоразговори с ClickUp SyncUps за координация на инциденти в реално време или брифинги за ръководството
- Публикувайте „Обявления“ или актуализации, за да информирате цялата компания за състоянието на инцидентите на високо ниво
- Маркирайте колеги, споделяйте екранни снимки и прикачвайте логове директно в чата, като поддържате техническия контекст наблизо
Стъпка № 6: Тествайте, проверете и усъвършенствайте процеса на ескалация
Политиките за ескалация трябва да се развиват успоредно с вашите системи. Ето какво трябва да правите редовно:
| Дейност | Какво да тествате или прегледате | Защо е важно |
| Учения за реагиране при извънредни ситуации (на всеки три месеца) | Симулирайте инциденти от категории P1 и P2, проверете времето за ескалация и маршрутизацията | Гарантира, че автоматизациите и пътищата за ескалация функционират дори при натоварване |
| Проверка на пътя за ескалация | Проверете за ескалации, които не водят до никъде, или за липсващи отговорни лица | Предотвратява забавянето на инцидентите поради липса на прозрачност |
| Таймери за потвърждение и процес на разрешаване | Сравнете настроените таймери с действителните MTTA и MTTR | Поддържа реалистични и ефективни срокове за ескалация |
| Оценка на умората от сигнали | Идентифицирайте операторите, които получават прекалено много или повтарящи се сигнали | Намалява изтощението и пропуснатите критични сигнали |
| Точност при определяне на сериозността и приоритизирането | Проверете дали инцидентите са класифицирани правилно | Подобрява маршрутизацията, скоростта на реакция и точността при ескалацията |
| Последващи действия след инцидент | Уверете се, че задачите от ретроспективите са изпълнени | Предотвратява повтарящи се инциденти и системни сривове |
Инструменти и интеграции за автоматизация на ескалацията
В тази секция ще ви запознаем със софтуер за управление на инциденти, който ви помага да откривате инцидентите по-бързо, да ги насочвате незабавно и да държите всеки екип в течение, без да се налага ръчно проследяване.
1. ClickUp (Най-подходящ за обединяване на междуфункционалните ескалации в едно свързано работно пространство за инциденти)
Традиционните методи за ескалация принуждават екипите да се справят едновременно с имейли, електронни таблици, чат-разговори и разпръснати бележки, което прави почти невъзможно да се получи ясна представа в реално време за това, което се случва.
Софтуерът за управление на задачи ClickUp за управление на ескалациите елиминира излишната информация, като обединява всички подробности за ескалациите в едно единствено, организирано работно пространство.
Нека разгледаме някои функции на софтуера за управление на ИТ активи, които превръщат ClickUp в най-добрия избор за екипи, управляващи голям брой ескалации и сложни работни потоци при инциденти.
Вижте как да работите по свой начин
Визуализирайте задачите си от различни ъгли, за да ги съобразите с оперативните си нужди, с помощта на изгледите в ClickUp:
- Изглед „Списък“ в ClickUp, така че ръководителите на SRE да могат да сортират инцидентите по степен на сериозност, оставащо време по SLA или дежурни групи за бързо сортиране
- Използвайте изгледа „Табло“ в ClickUp, за да дадете възможност на инженерните мениджъри да визуализират прехвърлянията и отговорностите на екипа по време на ескалациите
- ClickUp Gantt View за ръководители на програми, с който да планират етапите на разрешаване и зависимостите между различните услуги
- ClickUp Workload View за планиращите дежурствата, което гарантира, че инженерите няма да бъдат претоварени по време на периоди с голям брой инциденти
Превърнете дискусиите от срещите в конкретни действия
По време на ескалации и прегледи на инциденти надеждното записване на дискусиите и задачите за действие може да се окаже предизвикателство. ClickUp AI Notetaker автоматично се присъединява към срещите, насрочени в Google Calendar, Outlook, Zoom или Teams, като записва и транскрибира разговора.
След срещата:
- Достъп до транскрипти с възможност за търсене и обобщения на задачите за действие
- Осигурете яснота, като използвате бележките, запазени в ClickUp Docs. Това улеснява създаването на връзки към задачите, свързани с инцидентите, или към ретроспективните отчети
- Задавайте въпроси на ClickUp AI относно съдържанието на срещите, за да изясните решенията или да откриете пропуснати последващи действия
Свържете се със съществуващите инструменти във вашия технологичен стек
Зад кулисите интеграциите на ClickUp и екосистемата от уебхукове осигуряват безпроблемна свързаност с останалата част от вашата система.
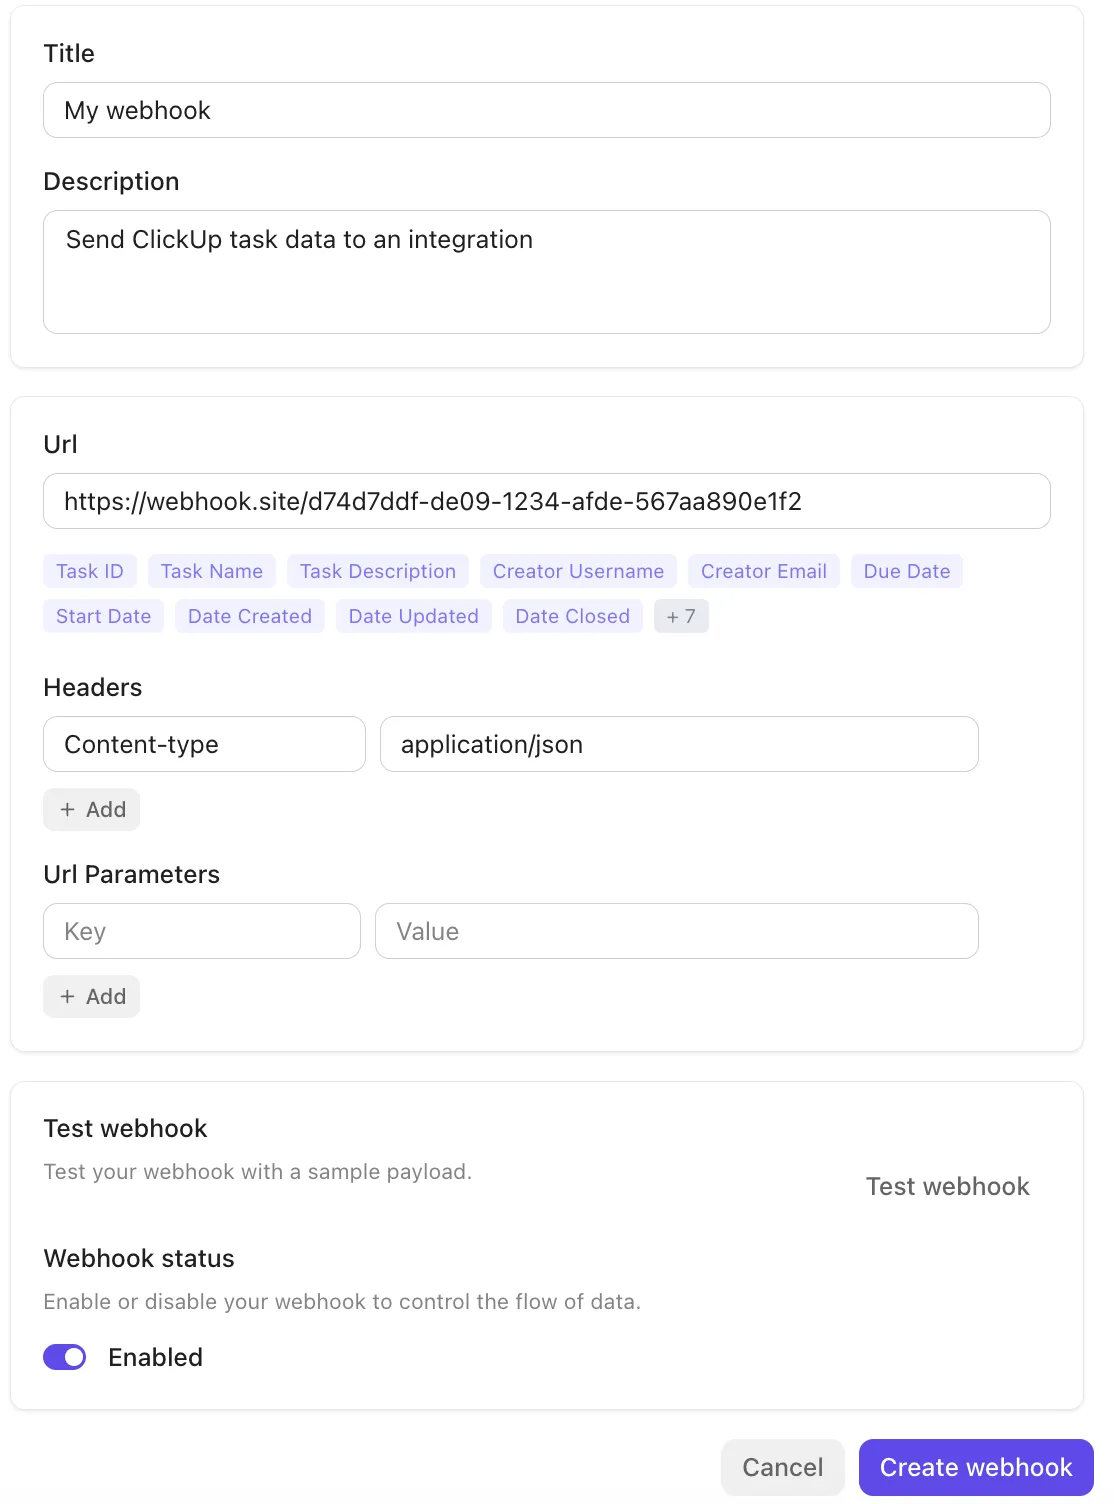
Платформата се интегрира директно с инструменти като Slack, GitHub, Zoom и други и поддържа Webhooks чрез публичния си API за разпространяване на събития (актуализации на задачи и промени в статуса) към външни услуги или автоматизирани процеси. Това улеснява задействането на работни потоци, синхронизирането на данни или ескалирането на инциденти между системи без ръчно прехвърляне.
Обединете всичките си инструменти за изкуствен интелект
За да пренесете автоматизацията и контекста на следващото ниво, ClickUp BrainGPT въвежда контекстуална изкуствена интелигентност във вашите работни потоци за ескалация. Това е супер приложение за контекстуална изкуствена интелигентност, което разбира вашите задачи, документи и историческия контекст.
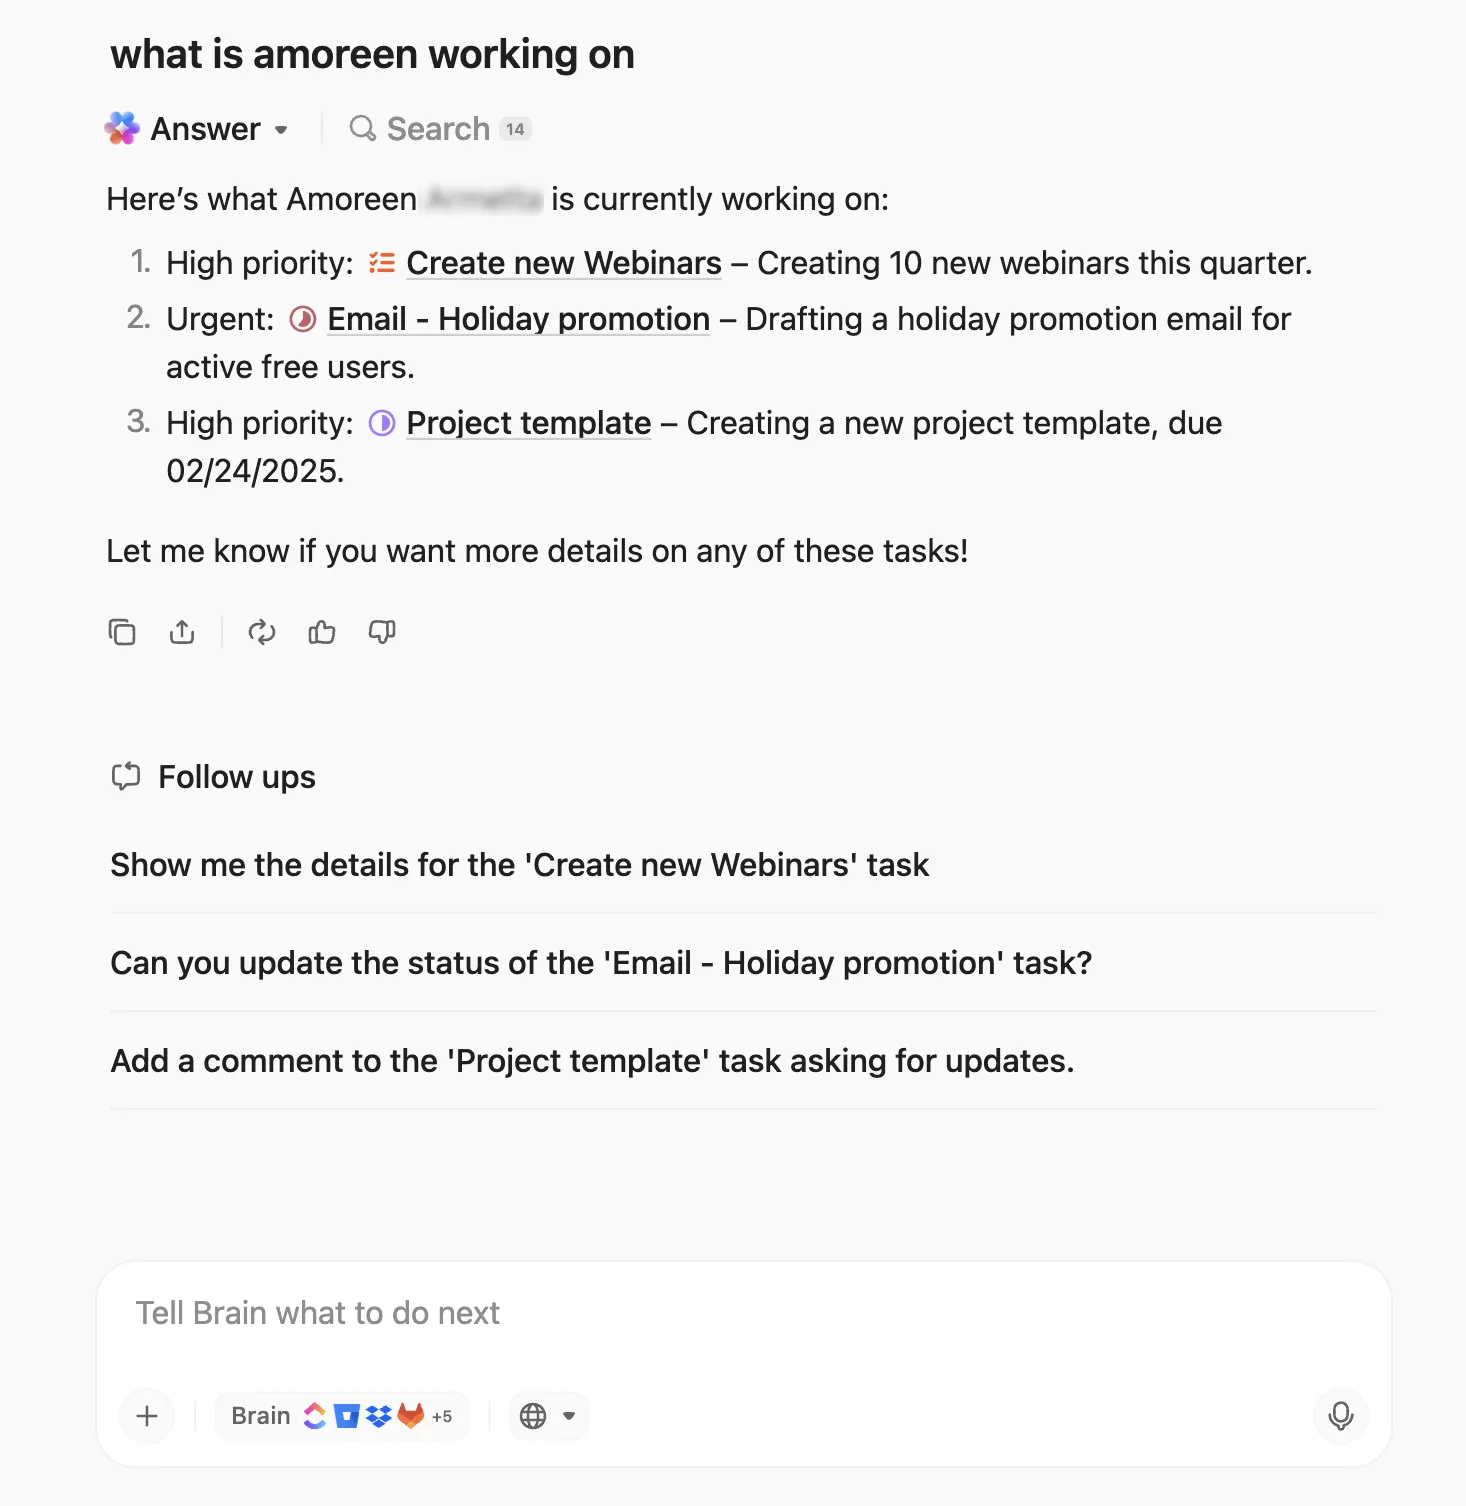
С Enterprise Search и Connected Apps можете незабавно да извличате информация от работното си пространство, Slack, Google Drive, GitHub и други. По време на разговори на живо за инциденти функцията „Talk-to-Text“ в ClickUp ви позволява да диктувате бележки или инструкции за ескалация, без да използвате ръцете си, като по този начин гарантирате, че нищо няма да бъде пропуснато.
Можете също така да стандартизирате повтарящи се задачи с персонализирани AI подсказки и запазени подсказки, като например: „Обобщете всички нерешени инциденти и препоръчайте действия за ескалация.“
Най-добрите функции на ClickUp
- Определяйте приоритетите на критичните проблеми: Използвайте приоритетите на задачите в ClickUp, за да маркирате спешните или значимите ескалации
- Организирайте сложни последователности за ескалация: Настройте зависимостите между задачите в ClickUp, за да свържете свързаните задачи (например „В очакване на“ или „Блокира“), така че стъпките по ескалацията да избягват преждевременни действия или затруднения
- Разделете инцидентите на конкретни задачи: Разделете ескалациите на подробни задачи и ги разпределете между екипите с помощта на вложени подзадачи
- Проследявайте точно скоростта на разрешаване: Регистрирайте и наблюдавайте колко време отнема потвърждаването и разрешаването на задачите по ескалация с функцията за проследяване на времето по проекти на ClickUp
Ограничения на ClickUp
- При толкова много функции, изгледи и опции за персонализиране екипите често се сблъскват с период на адаптация, преди всичко да им се струва интуитивно
Цени на ClickUp
[Таблица с цени]
Оценки и отзиви за ClickUp
- G2: 4,7/5 (над 10 300 отзива)
- Capterra: 4,6/5 (над 4 400 отзива)
Какво казват реалните потребители за ClickUp?
Този отзив наистина казва всичко:
ClickUp обединява всичките ми задачи, проекти и комуникация на едно място, което прави поддържането на реда изключително лесно. Обичам колко всичко е персонализирано – от изгледите и работните потоци до таблата за управление – така че мога да структурирам работното си пространство точно така, както ми е нужно. Възможността да сътруднича в реално време, да възлагам задачи и да проследявам напредъка, без да сменям инструментите, е огромно предимство.
ClickUp обединява всичките ми задачи, проекти и комуникация на едно място, което прави поддържането на реда изключително лесно. Обичам това, че всичко може да се персонализира – от изгледите и работните потоци до таблата за управление – така че мога да структурирам работното си пространство точно така, както ми е нужно. Възможността да сътруднича в реално време, да възлагам задачи и да проследявам напредъка, без да сменям инструментите, е огромно предимство.
📮 ClickUp Insight: 21% от хората споделят, че повече от 80% от работния им ден преминава в изпълнение на повтарящи се задачи. А други 20% казват, че повтарящите се задачи отнемат поне 40% от деня им.
Това е почти половината от работната седмица (41%), посветена на задачи, които не изискват много стратегическо мислене или творчество (като имейли за проследяване 👀).
Супер агентите на ClickUp помагат да се премахне тази монотонна работа. Помислете за създаване на задачи, напомняния, актуализации, бележки от срещи, изготвяне на имейли и дори създаване на цялостни работни потоци! Всичко това (и още много други неща) може да бъде автоматизирано за нула време с ClickUp – вашето универсално приложение за работа.
💫 Реални резултати: Lulu Press спестява по 1 час на ден на всеки служител благодарение на автоматизациите в ClickUp, което води до 12% увеличение на ефективността на работата.
2. PagerDuty (Най-добър за сигнализиране в реално време и интелигентно реагиране при дежурство)
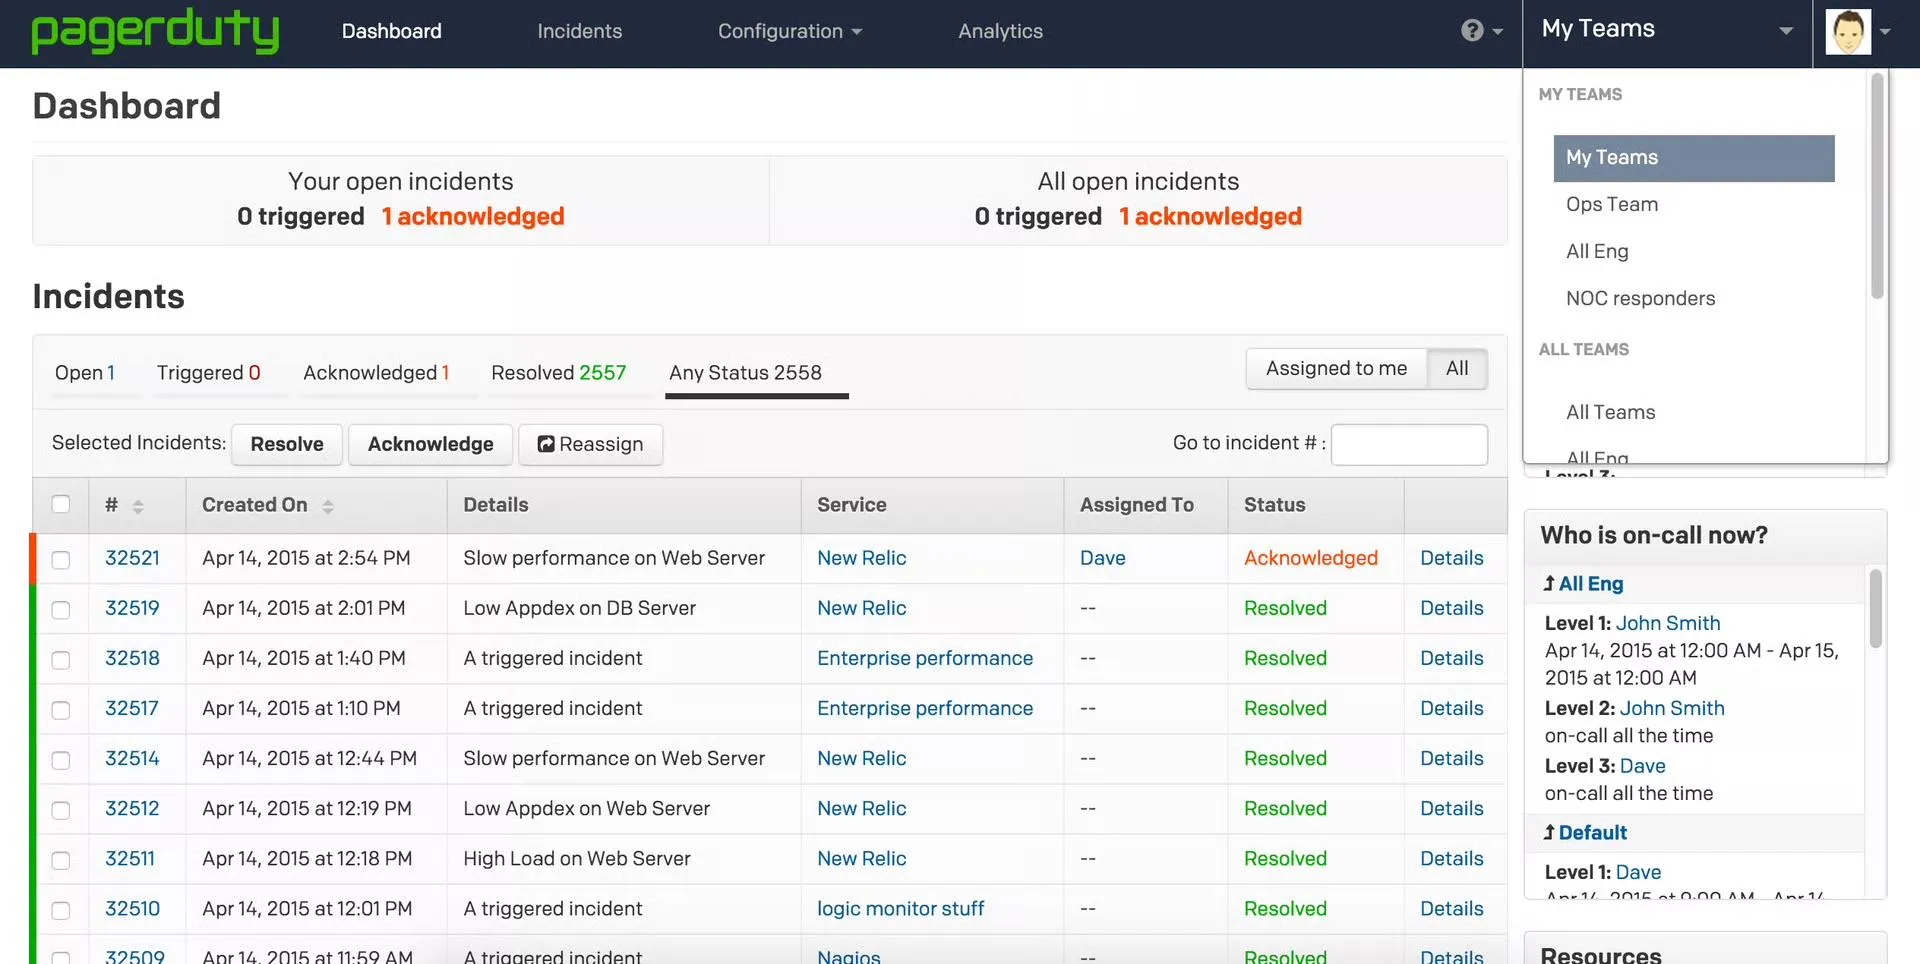
PagerDuty е облачна платформа за управление на ИТ инциденти и цифрови операции, която помага на екипите бързо да откриват, реагират и разрешават критични инциденти като прекъсвания на услугата или заплахи за сигурността. Тя предоставя на ръководителите на SRE, DevOps и поддръжката ясен път от сигнала до разрешаването на проблема, подкрепен от автоматизация, сортиране на инцидентите с помощта на изкуствен интелект и дълбоко интегрирани работни потоци.
Функции като Jeli Incident Analysis, PagerDuty Analytics и Runbook Automation помагат на екипите да намалят прекъсванията в работата, да елиминират рутинните задачи и да извличат поуки от всеки инцидент.
Най-добрите функции на PagerDuty
- Автоматизирайте маршрутизирането на инцидентите с вграденото управление на дежурствата и динамичните политики за ескалация
- Ускорете сортирането на инцидентите с помощта на AIOps, което филтрира излишните сигнали, установява взаимовръзки между събитията и подчертава истинските сигнали
- Поддържайте синхронизация между вътрешните и външните заинтересовани страни с помощта на Stakeholder Comms, Status Update Templates и Status Pages
- Унифицирайте набора си от инструменти с над 700 интеграции и разширяеми API-та, като използвате системи за мониторинг, логване, CI/CD и поддръжка
Ограничения на PagerDuty
- Голям обем сигнали за тревога, ако интеграциите и интелигентните прагове не са настроени правилно, което води до излишна информация и умора
- По време на пикови натоварвания могат да възникнат дублирани или повтарящи се сигнали, което затруднява потвърждаването им под натиск
Цени на PagerDuty
- Безплатно
- Професионален: 25 $ на месец на потребител
- Бизнес: 49 $ на месец на потребител
- Enterprise: цени по договаряне
Оценки и отзиви за PagerDuty
- G2: 4,5/5 (над 900 отзива)
- Capterra: 4,6/5 (над 200 отзива)
Какво казват реалните потребители за PagerDuty?
По думите на един реален потребител:
PagerDuty прави сигналите за инциденти бързи и надеждни. Той изпраща подходящите уведомления в подходящия момент и поддържа екипа ни организиран. […] PagerDuty може да изглежда прекалено натоварен понякога, когато сигналите не са добре филтрирани. Някои настройки са малко сложни за новите потребители.
PagerDuty прави сигналите за инциденти бързи и надеждни. Той изпраща подходящите уведомления в подходящия момент и поддържа екипа ни организиран. […] PagerDuty може да изглежда прекалено натоварен понякога, когато сигналите не са добре филтрирани. Някои настройки са малко сложни за новите потребители.
💡 Съвет от професионалист: Предвидете изключения дори при ясен път за ескалация. Позволете критичните прекъсвания, сигналите за сигурност или инцидентите в регулирана среда да се препращат директно към старши или специализирани отговорни лица.
3. GLPi (Най-подходящ за цялостно управление на активите и операции по обслужване, съобразени с ITIL)
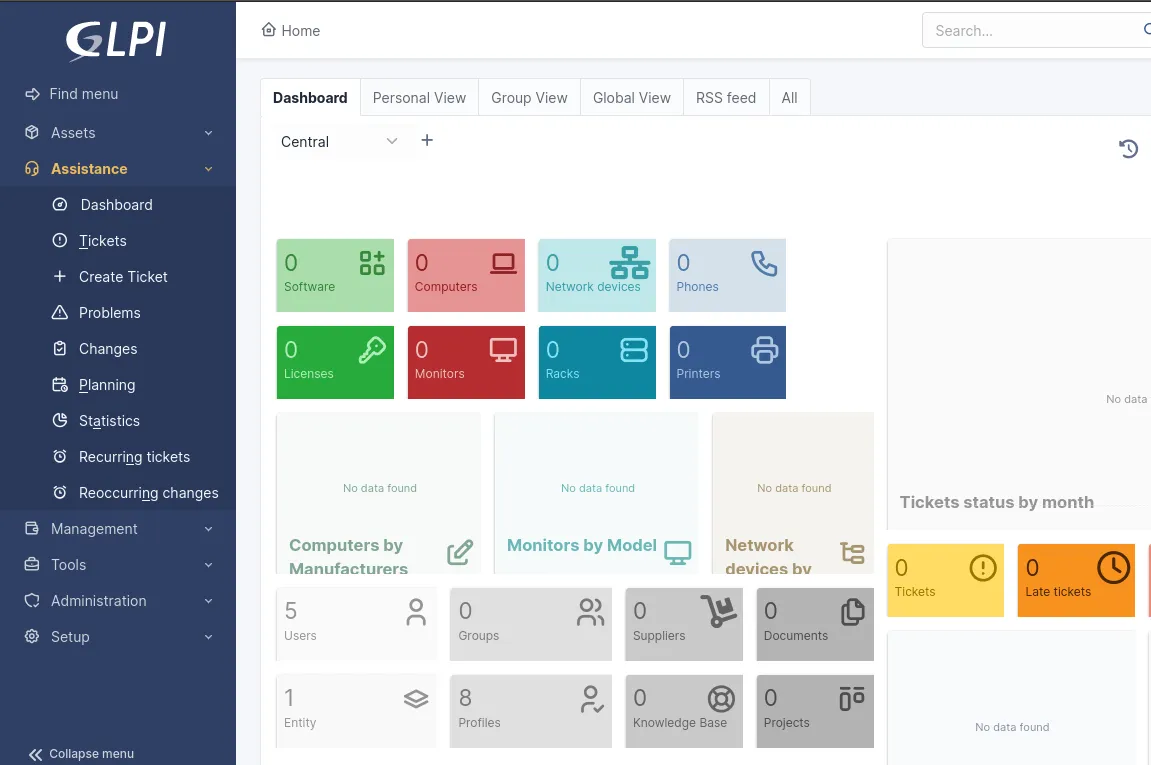
Gestionnaire Libre de Parc Informatique (GLPi) е пълнофункционална платформа с отворен код за управление на ИТ услуги (ITSM) и ИТ активи (ITAM). Екипите получават цялостен поглед върху инфраструктурата си (хардуер, софтуер, лицензи и мрежови устройства) и могат да управляват инциденти, заявки за услуги и промени, като използват процеси, съобразени с ITIL.
Всички ваши договори и документация, включително гаранции и договори за обслужване, остават добре организирани, което предотвратява изгубването им в различните системи. Ако управлявате центрове за данни, GLPi дори ви позволява да визуализирате планове, трасета на окабеляване и енергопотребление, за да знаете винаги какво се случва зад кулисите.
Най-добрите функции на GLPi
- Използвайте плъгините GLPI Inventory, OCS Inventory или FusionInventory, за да откривате и каталогизирате автоматично нови ИТ активи
- Автоматизирайте повтарящите се задачи, разпределянето на заявки, известията и повтарящите се събития, за да намалите ръчната работа
- Създайте база от знания с често задавани въпроси, документация и статии, свързани с тикетите, за самообслужване и техническа поддръжка
- Свържете се с Azure/Entra, Centreon, Google, OAuth2 и уебхукове, за да синхронизирате данни, да задействате работни потоци и да подобрите вашата CMDB
Ограничения на GLPi
- Съвместимостта на плъгините може да се наруши между различните версии, което води до допълнителни разходи за поддръжка
- Възможностите за отчитане, анализи и експортиране изглеждат ограничени и се нуждаят от подобрение
Цени на GLPi
- Индивидуални цени
Оценки и отзиви за GLPi
- G2: 4,6/5 (над 30 отзива)
- Capterra: 4,5/5 (над 40 отзива)
Какво казват реалните потребители за GLPi?
Ето какво сподели един от потребителите:
Много гъвкава система с отворен код за управление на ИТ активи и билети за поддръжка, с голяма поддържаща общност. Потребителският интерфейс е малко сложен за начинаещи. Плъгините не винаги се поддържат при преминаване от стари към нови версии.
Много гъвкава система с отворен код за управление на ИТ активи и билети за поддръжка, с голяма поддържаща общност. Потребителският интерфейс е малко сложен за начинаещи. Плъгините не винаги се поддържат при преминаване от стари към нови версии.
4. Splunk On-Call (най-подходящ за насочване на сигналите за мониторинг директно към инженерите)
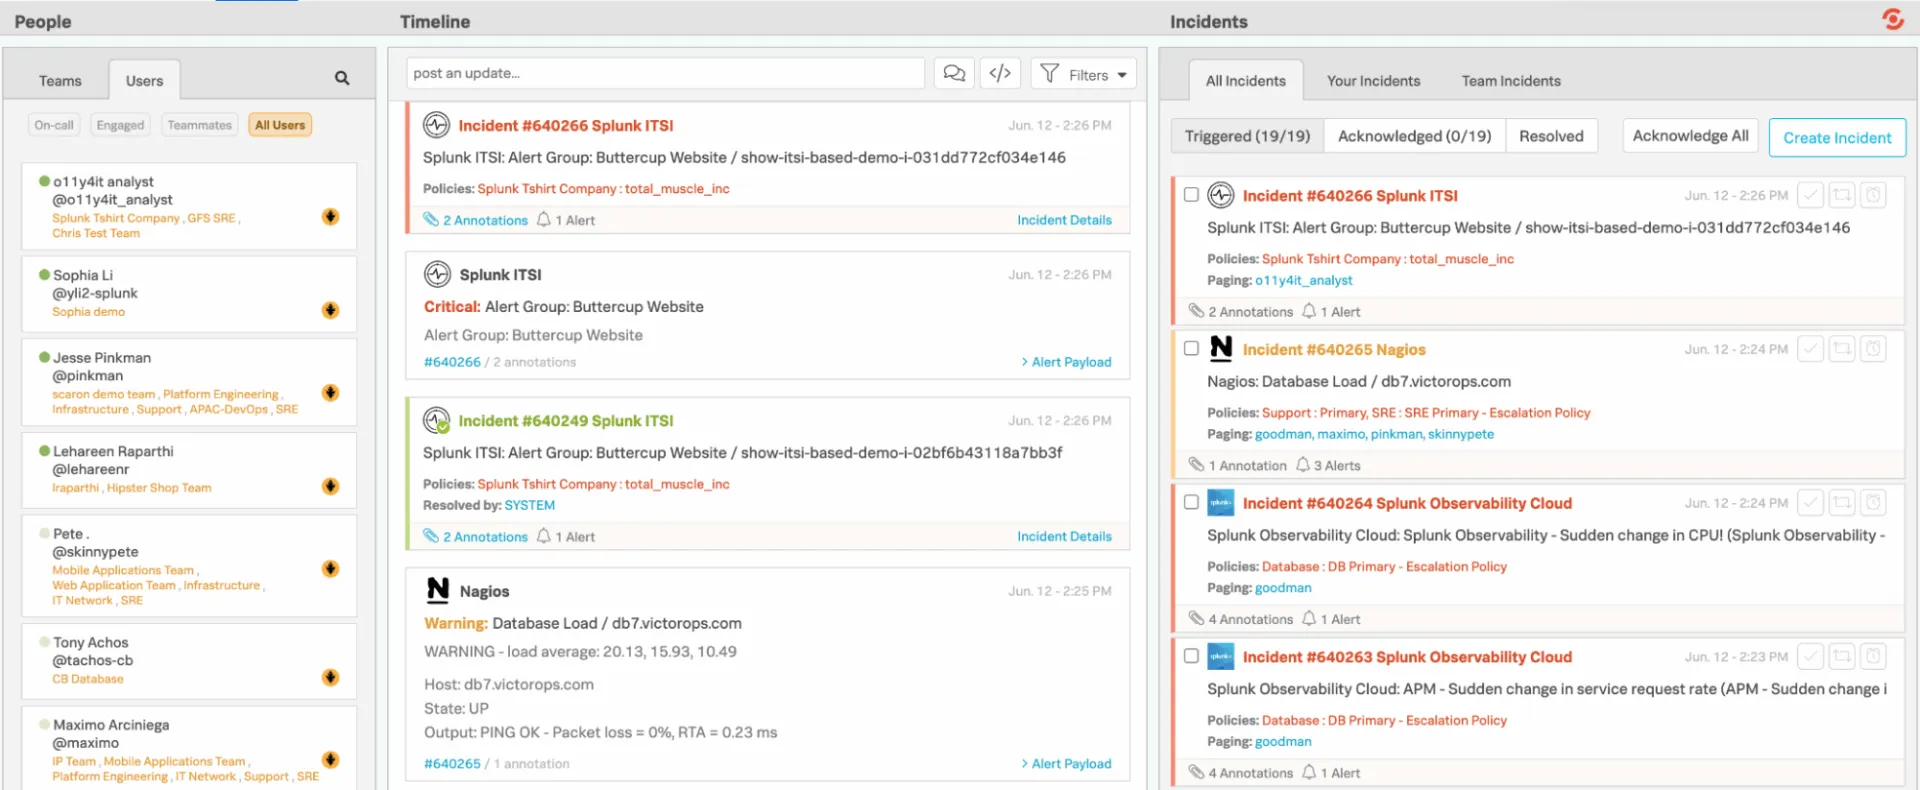
Splunk On-Call предоставя на инженерните екипи и екипите за дежурство по-бърз и по-ясен начин за управление на инциденти, като елиминира необходимостта от бавните, традиционни работни потоци за създаване на тикети. Вместо да изпраща сигналите в обща опашка, той се интегрира директно с вашата система за мониторинг и наблюдаемост, като незабавно насочва проблемите към подходящите лица въз основа на графици, правила и контекст.
Интеграциите с мобилни устройства и чат улесняват потвърждаването, пренасочването или разрешаването на инциденти от всяко място. А зад кулисите Splunk On-Call поддържа подробен архив на тенденциите, доказаните модели и поведението при ескалация.
Най-добрите функции на Splunk On-Call
- Разширете възможностите на платформата, като използвате над 1 000 проверени интеграции и добавки от Splunk и по-широката общност
- Създавайте персонализирани табла и визуални отчети, за да следите обема на сигналите, състоянието на инцидентите, ефективността на отговарящите и натоварването на екипа
- Бързо филтрирайте инцидентите според вашата собствена дейност, инцидентите на екипа ви или всичко, което се случва в цялата организация
- Превключвайте между изгледите „Задействани“, „Потвърдени“ и „Решени“, за да видите в какъв етап се намира всеки инцидент
Ограничения на Splunk On-Call
- Планирането на смени в няколко екипа може да се усложни, ако правилата не са предварително определени
- Ограничена възможност за генериране на подробни отчети за инциденти по дати
Цени за Splunk On-Call
- Индивидуални цени
Оценки и отзиви за Splunk On-Call
- G2: 4,6/5 (над 40 отзива)
- Capterra: 4,5/5 (над 30 отзива)
Какво казват реалните потребители за Splunk On-Call?
Един потребител го обобщи по следния начин:
Възможността да се справям с инциденти, ескалации и да поемам дежурствата на колегите си чрез мобилното приложение е страхотна. […] Бих искал да мога да планирам изключения и да променям редовния график чрез мобилното приложение при спешни промени в графика.
Възможността да се справям с инциденти, ескалации и да поемам дежурствата на колегите си чрез мобилното приложение е страхотна. […] Бих искал да мога да планирам изключения и да променям редовния график чрез мобилното приложение при спешни промени в графика.
🔍 Знаете ли, че... Логиката „пренасочване към подходящия човек, ако първото ниво се провали“ има корени в ранните телефонни централи: когато операторите не можеха да свържат даден разговор, системата го пренасочваше (или ескалираше) към друг оператор или централа.
5. ServiceNow (Най-подходящ за координиране на дейности в корпоративен мащаб с автоматизация, подпомагана от изкуствен интелект)
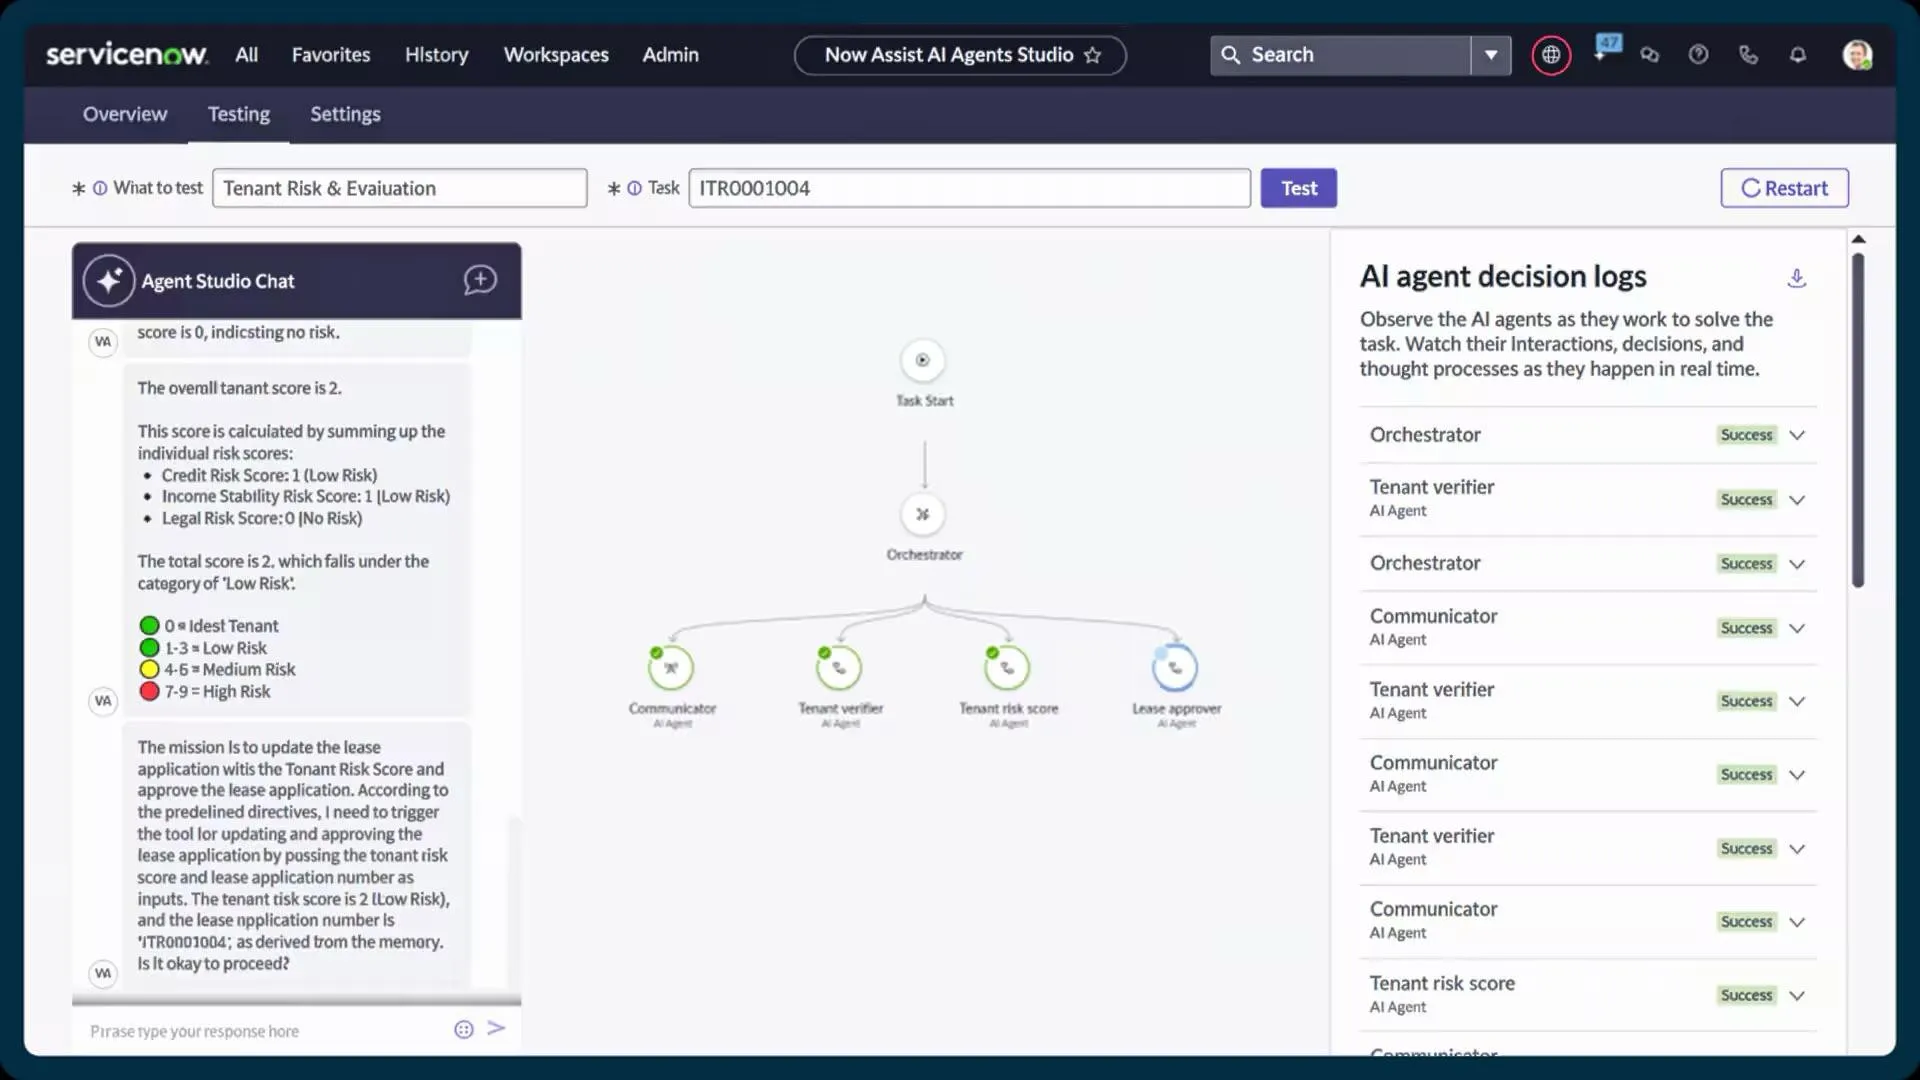
ServiceNow автоматично класифицира, приоритизира и насочва инцидентите в момента, в който бъдат регистрирани. С функции като Now Assist за автоматични препоръки за билети за инциденти и интелигентно генериране на съдържание, отговарящите могат да разрешават проблемите по-бързо и с по-голям контекст.
Той обединява управлението на инциденти, промени и активи. По този начин получавате изглед в реално време за това как услугите са свързани, къде възникват затруднения и кои компоненти може да допринасят за повтарящи се прекъсвания.
Най-добрите функции на ServiceNow
- Разпределяйте, насочвайте и следете задачите на терен чрез Управление на услугите на терен и Работна среда на диспечера
- Предоставете на служителите и клиентите възможност за самообслужване чрез портал, базиран на AI Search и виртуални агенти
- Използвайте вградените работни потоци и инструменти с минимално програмиране в App Engine, за да разширите или персонализирате процесите на обслужване
- Автоматизирайте повтарящите се задачи и работните потоци в различните екипи с Flow Designer и Automation Engine
Ограничения на ServiceNow
- Опциите за потребителски интерфейс и брандиране на портала изглеждат остарели или ограничаващи
- Висока зависимост от квалифициран персонал или консултанти за внедряването
Цени на ServiceNow
- Индивидуални цени
Оценки и отзиви за ServiceNow
- G2: 4,4/5 (над 3 300 отзива)
- Capterra: 4,5/5 (над 300 отзива)
Какво казват реалните потребители за ServiceNow?
Ето как го формулира един потребител:
[…] Готовите работни потоци са още едно предимство за мен, тъй като те рационализират процесите и спестяват значително време, като свеждат до минимум необходимостта от персонализирани конфигурации и позволяват по-гладък и по-ефективен работен поток. […] Освен това имах затруднения при интегрирането на моето персонализирано решение в системата за управление на обслужването на клиенти, което изискваше доста много итерации.
[…] Готовите работни потоци са още едно предимство за мен, тъй като те рационализират процесите и спестяват значително време, като свеждат до минимум необходимостта от персонализирани конфигурации и позволяват по-гладък и по-ефективен работен поток. […] Освен това имах затруднения при интегрирането на моето персонализирано решение в системата за управление на обслужването на клиенти, което изискваше доста много итерации.
Най-добри практики и управление
Ето някои добри практики, които гарантират, че автоматизацията остава точна, избягва пренасищането с предупреждения и отговаря на бизнес и регулаторните очаквания.
- Определете критерии за ескалация, които не подлежат на преговори: Свържете тригерите с измерими сигнали като нарушения на SLO, пикове на аномалии, въздействие върху нивата на клиентите или чувствителност към регулаторни изисквания
- Определете ясно ролите на всяко ниво: Използвайте проста RACI-схема за всяко ниво на ескалация, за да няма неясноти относно отговорностите при инциденти, свързани с голям натиск
- Въведете динамично управление на дежурствата: Автоматично адаптирайте процедурите за ескалация в зависимост от уикендите, празниците, ограниченията на капацитета и прехвърлянията на задачи, за да намалите изтощението и да предотвратите „тихите“ извиквания
- Въведете контролни точки за човешка намеса при сценарии с висок риск: Дори при автоматизация, наложете задължително ръчно потвърждаване на инциденти, свързани с разкриване на данни на клиенти, плащания или регулирани работни потоци
- Поддържайте пълни одитни следи: Съхранявайте неизменни записи за това кой е бил уведомен, кога е потвърдил получаването, какви автоматизирани стъпки са били задействани и какви решения са били взети
🧠 Интересен факт: Най-старата известна писмена жалба в света е била издълбана върху глинена плочка около 1750 г. пр.н.е. По същество това е било ранна форма на ескалация на състоянието на проект. Клиент на име Нани написал писмо до търговеца Еа-насир, ядосан, че получената от него мед е била с по-ниско качество от обещаното и че неговият пратеник е бил третиран зле.
Често срещани предизвикателства и начини за преодоляването им
Дори и при наличието на ясна политика за ескалация екипите често се сблъскват с оперативни пречки, които забавят реакцията при инциденти или създават объркване.
Тази таблица изтъква често срещани предизвикателства, които надхвърлят основните стъпки по настройката, и предлага практически стратегии за преодоляването им.
| Предизвикателства ❌ | Решения ✅ |
| Несъответствия в контекста при предаването на задачите | Използвайте функциите за свързване на задачи и шаблоните за доклади за инциденти в ClickUp, за да поддържате пълна одитна следа с подробности за инцидентите, засегнатите системи и предходните действия на всяко ниво на ескалация |
| Претоварване на операторите с сигнали с ниска приоритетност | Внедрете динамично приоритизиране с помощта на персонализираните полета в ClickUp и AI Prioritize, за да филтрирате инцидентите въз основа на сериозност, въздействие и прагове по SLA |
| Липса на видимост между екипите | Настройте споделени работни пространства, добавяйте коментари и създавайте визуални табла в ClickUp, за да представяте актуализации в реално време на заинтересованите страни |
| Забавено вземане на решения по време на критични инциденти | Автоматизирайте уведомленията, като използвате Предложените действия на ClickUp Brain Max, за да уведомите незабавно съответния персонал в зависимост от типа, сериозността и историческите модели на инцидента |
| Трудности при проследяването на повтарящи се проблеми | Използвайте персонализираните отчети и шаблоните за повтарящи се задачи на ClickUp, за да идентифицирате модели, основни причини и повтарящи се инциденти с цел проактивна превенция |
| Фрагментирани знания по време на ескалацията | Поддържайте централизирани стандартни оперативни процедури (SOP), наръчници и документация за инциденти в ClickUp Docs, като ги свържете със съответните задачи за незабавен достъп по време на ескалации в реално време |
| Несъгласувани отговорности между смени | Използвайте изгледите „Работна натовареност“ и „Времева линия“ в ClickUp, за да визуализирате задачите и да се уверите, че няма припокривания или пропуски при смяна на смени или предаване на задачи |
| Ръчно проследяване на съответствието и пропуски при одитите | Автоматизирайте готови за одит обобщения с ClickUp Brain, за да регистрирате всички действия, уведомления и решения по инцидентите |
Измерване на въздействието на автоматизираното ескалиране
Проследяването на ефективността на автоматизираното ескалиране изисква фокусиране върху ключови показатели, свързани с обем, ефективност и качество. Тези показатели разкриват дали вашите процеси за ескалиране са по-бързи, по-точни и по-малко изнервящи както за екипите, така и за клиентите.
Проследявайте следните показатели:
- Процент на ескалация (обем): Процент на проблемите, ескалирани извън първото ниво. Високите проценти могат да сочат пропуски в първоначалната сортировка или в базите с знания
- Честота на повтарящо се ескалиране (обем): Честотата, с която един и същ проблем се ескалира многократно. Това е признак за непълно разрешаване на проблема или загуба на контекст.
- Време до ескалация (ефективност): Продължителност от откриването до ескалацията. По-кратките продължителности на етапите показват по-бързо автоматизирано разпознаване на критични проблеми
- Време на забавяне при предаването (ефективност): Разликата между ескалацията и момента, в който следващият екип започва работа, за да се подчертаят затрудненията при маршрутизирането или уведомяването
- Време за разрешаване на ескалираните случаи (ефективност): Общо време от ескалацията до разрешаването. По-бързото разрешаване показва ефективността на автоматизацията
- Оценка за удовлетвореност на клиентите (CSAT) (качество): Обратна връзка за ескалираните взаимодействия, за да се измери гладкостта на процеса
- Предаване на контекста (качество): Дали агентите получават пълната история на инцидента, за да се гарантира, че клиентите не повтарят информацията
- Решаване при първия контакт (FCR) (качество): Процент на проблемите, решени при еднократно взаимодействие
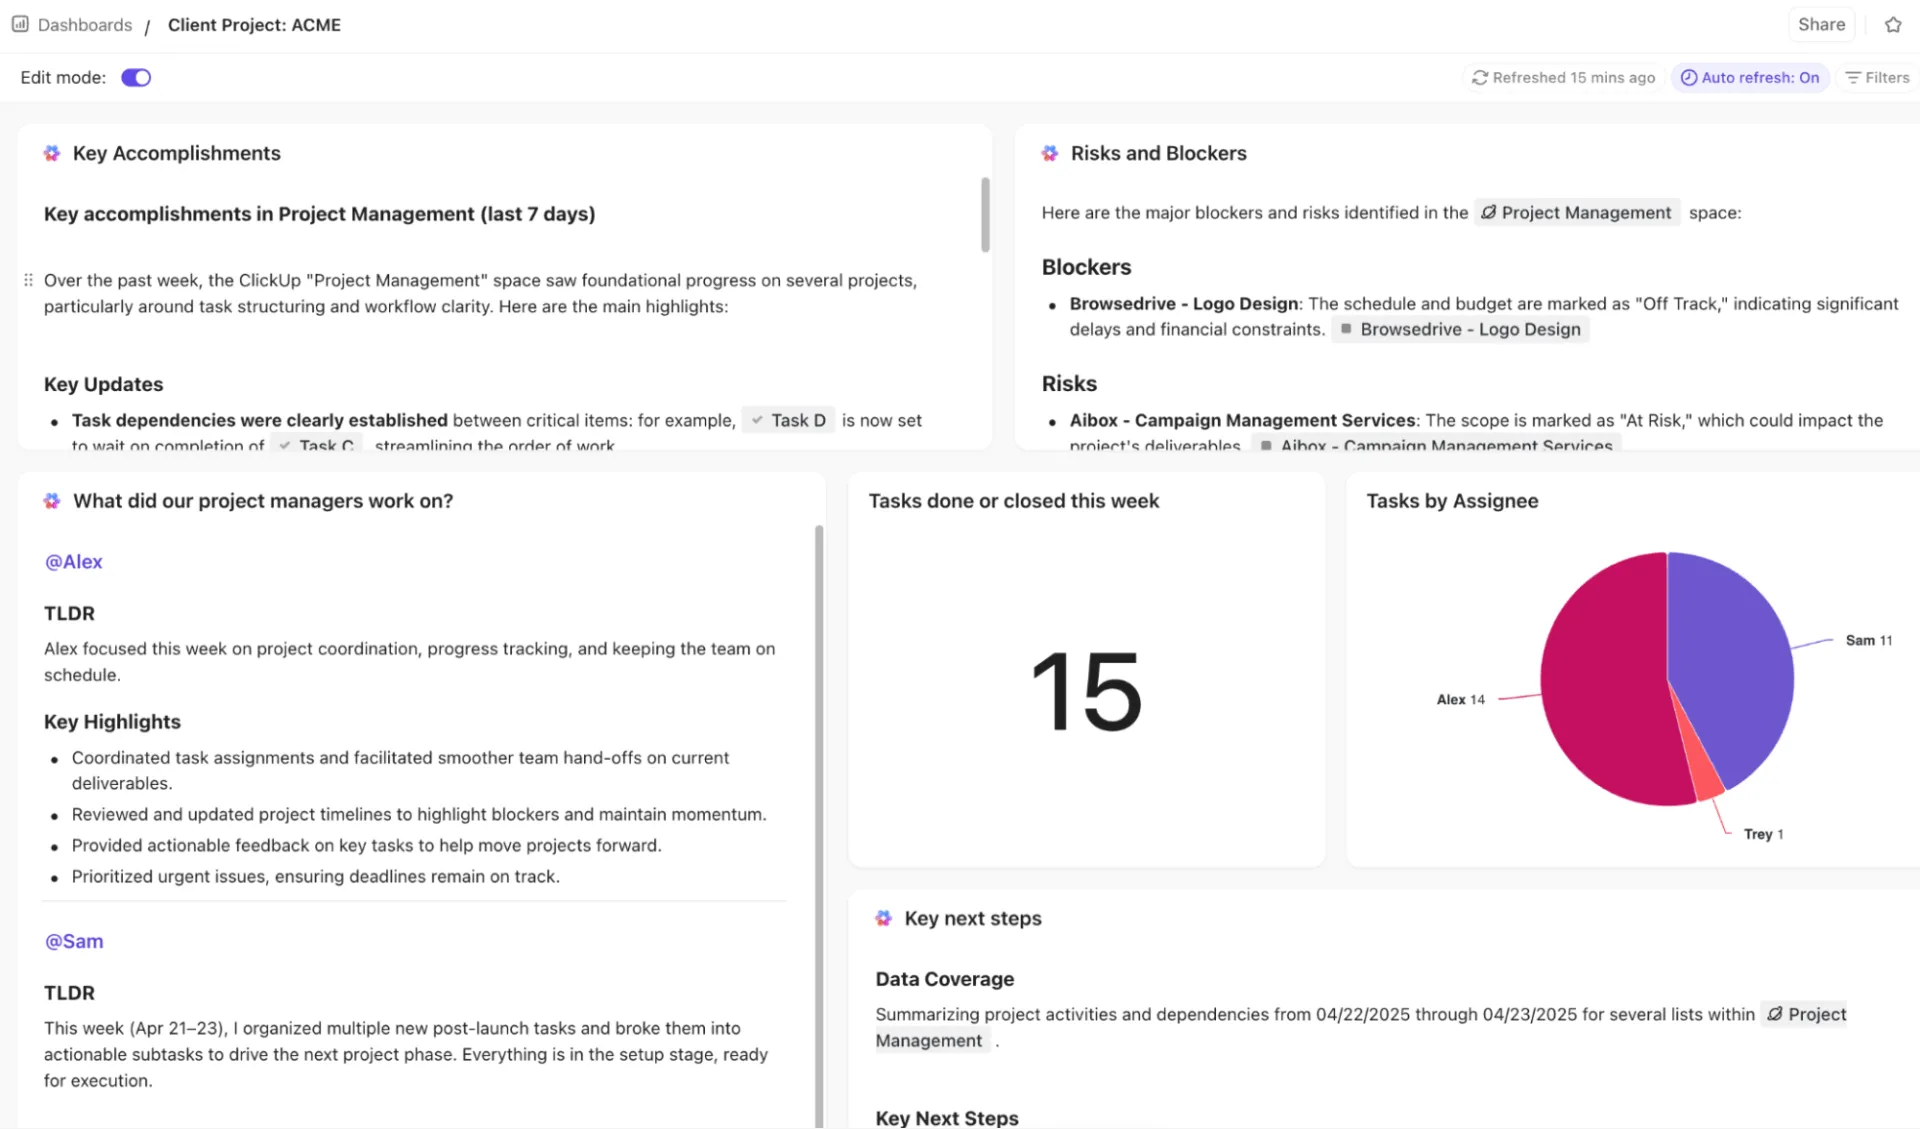
🚀 Предимство на ClickUp: Получавайте визуални анализи в реално време, базирани на изкуствен интелект, за всички показатели за ескалация с таблата за управление на ClickUp.
Можете да проследявате тенденциите при ескалацията, пречките и производителността с таблични, секторни, барни, линейни, изчислителни и картове за отчитане на времето. Наблюдавайте честотата на ескалациите, повтарящите се ескалации и времето до ескалация с картове, свързани със задачи, потребителски полета и статуси.
За да отидете още по-далеч, използвайте AI карти като AI Executive Summary, AI Project Update и AI StandUp, за да подчертаете тенденции, закъснения и резултати от разрешаването на инциденти.
Управлявайте инцидентите си по-бързо с ClickUp
Мнозина смятат, че ескалацията на инциденти се състои само в прехвърлянето на заявката към следващия човек, но всъщност е много повече от това. Това е структурирана система, в която всяка стъпка – от сортирането до разрешаването – работи в хармония.
ClickUp ви предоставя идеалното унифицирано работно пространство. С ClickUp Automations можете автоматично да задействате сигнали, да пренасочвате задачи и да актуализирате статусите. А ClickUp Brain помага при приоритизирането на инцидентите, генерирането на обобщения и предлагането на следващи стъпки.
AI агентите на ClickUp действат като интелигентни асистенти във вашето работно пространство, докато таблата на ClickUp предоставят изглед в реално време на вашите ескалации.
Регистрирайте се безплатно в ClickUp още днес!
Често задавани въпроси (FAQ)
Какво представлява пътят за ескалация на инциденти?
Пътят за ескалация на инциденти е предварително определена поредица от стъпки, която определя как проблемите се насочват към подходящия екип или лице в зависимост от сериозността, въздействието и времето. Той гарантира, че инцидентите се разрешават ефективно и че отговорността е ясно разпределена. ТЕКСТ
Как да преценя кога да ескалирам инцидент автоматично, а кога – ръчно?
Използвайте автоматизацията за ясно дефинирани инциденти с висок приоритет и ясни критерии (например прекъсвания на услугите, нарушения на сигурността). Запазете ръчното ескалиране за неясни или критични ситуации, които изискват човешка преценка или допълнителен контекст.
Кои инструменти поддържат автоматизирано ескалиране за ефективно управление на инциденти?
Платформи като ClickUp, PagerDuty, Jira Service Management и ServiceNow позволяват автоматизирано насочване, известия и актуализации. Те помагат на екипите да намалят закъсненията и да поддържат структурирани работни потоци при инциденти.
Как мога да избегна преумората от сигналите, докато използвам автоматизирано ескалиране?
Задайте ясни прагове за предупреждения, приоритизирайте ги според сериозността им и използвайте интелигентни известия. Ограничете повтарящите се известия до критични инциденти и използвайте табла за управление или инструменти с изкуствен интелект, за да обобщавате актуализациите, вместо да изпращате всяка незначителна промяна.
Колко често трябва да преразглеждам политиките си за ескалация?
Преглеждайте редовно политиките за ескалация – поне веднъж на тримесечие или след сериозни инциденти. Това гарантира, че критериите, отговорностите и правилата за автоматизация отразяват актуалните работни процеси, структурите на екипите и бизнес приоритетите.