
โครงการฝึก AI แทบจะไม่ล้มเหลวในระดับโมเดล แต่จะเกิดปัญหาเมื่อการทดลอง เอกสาร และข้อมูลอัปเดตสำหรับผู้เกี่ยวข้องถูกกระจายอยู่ทั่วเครื่องมือต่าง ๆ มากเกินไป
คู่มือนี้จะนำคุณผ่านขั้นตอนการฝึกโมเดลด้วย Databricks DBRX — LLM ที่มีประสิทธิภาพการคำนวณสูงกว่าโมเดลชั้นนำอื่น ๆถึงสองเท่า— พร้อมทั้งจัดระเบียบงานที่เกี่ยวข้องไว้ในClickUp
ตั้งแต่การตั้งค่าและการปรับแต่งไปจนถึงการบันทึกเอกสารและการอัปเดตข้ามทีม คุณจะได้เห็นว่าพื้นที่ทำงานเดียวที่รวมศูนย์ช่วยลดปัญหาการกระจายข้อมูลที่ไม่จำเป็น และทำให้ทีมของคุณมุ่งเน้นไปที่การพัฒนา แทนที่จะต้องเสียเวลาค้นหาข้อมูล 🛠
DBRX คืออะไร?
DBRX เป็นโมเดลภาษาขนาดใหญ่ (LLM) ที่ทรงพลังและเปิดซอร์ส ซึ่งออกแบบมาโดยเฉพาะสำหรับการฝึกและวิเคราะห์โมเดล AI ในระดับองค์กร เนื่องจากเป็นซอฟต์แวร์เปิดซอร์สภายใต้Databricks Open Model License ทีมของคุณจึงมีสิทธิ์เข้าถึงน้ำหนักและสถาปัตยกรรมของโมเดลอย่างเต็มที่ ทำให้คุณสามารถตรวจสอบ ปรับเปลี่ยน และนำไปใช้งานตามเงื่อนไขของคุณเองได้
มีสองเวอร์ชัน: DBRX Base สำหรับการฝึกอบรมล่วงหน้าแบบลึก และ DBRX Instruct สำหรับงานตามคำสั่งที่พร้อมใช้งานทันที
สถาปัตยกรรม DBRX และออกแบบแบบผสมผู้เชี่ยวชาญ
DBRX 解决任务时采用 Mixture-of-Experts (MoE) สถาปัตยกรรม ซึ่งแตกต่างจากโมเดลภาษาขนาดใหญ่แบบดั้งเดิมที่ใช้พารามิเตอร์ทั้งหมดหลายพันล้านตัวในการคำนวณทุกครั้ง DBRX จะเปิดใช้งานเพียงส่วนน้อยของพารามิเตอร์ทั้งหมด (ผู้เชี่ยวชาญที่เกี่ยวข้องมากที่สุด) สำหรับแต่ละงานที่กำหนด
ลองนึกถึงมันเหมือนทีมผู้เชี่ยวชาญเฉพาะทาง; แทนที่จะให้ทุกคนทำงานกับทุกปัญหา ระบบจะจัดสรรงานแต่ละชิ้นไปยังผู้ที่มีคุณสมบัติเหมาะสมที่สุดตามพารามิเตอร์ที่กำหนดไว้อย่างชาญฉลาด
สิ่งนี้ไม่เพียงแต่ช่วยลดเวลาตอบสนอง แต่ยังมอบประสิทธิภาพและผลลัพธ์ระดับสูงสุด พร้อมทั้งลดค่าใช้จ่ายในการคำนวณลงอย่างมีนัยสำคัญ
ต่อไปนี้คือข้อมูลสรุปเกี่ยวกับคุณสมบัติหลักของ DBRX:
- จำนวนพารามิเตอร์รวม: 132B สำหรับผู้เชี่ยวชาญทั้งหมด
- พารามิเตอร์ที่ใช้งาน: 36B ต่อรอบการประมวลผลไปข้างหน้า
- จำนวนผู้เชี่ยวชาญ: รวม 16 คน (MoE Top-4 routing), โดยมี 4 คนที่ทำงานอยู่สำหรับโทเค็นใดก็ตาม
- หน้าต่างบริบท: 32K tokens
ข้อมูลการฝึกอบรม DBRX และข้อกำหนดของโทเค็น
ประสิทธิภาพของ LLM ขึ้นอยู่กับคุณภาพของข้อมูลที่ใช้ฝึกเท่านั้น DBRX ได้รับการฝึกไว้ล่วงหน้าบนชุดข้อมูลขนาดใหญ่ถึง 12 ล้านล้านโทเคนซึ่งทีม Databricks ได้คัดสรรอย่างพิถีพิถันโดยใช้เครื่องมือประมวลผลข้อมูลขั้นสูงของพวกเขา นี่คือเหตุผลที่ DBRX แสดงประสิทธิภาพได้อย่างยอดเยี่ยมในมาตรฐานการวัดผลของอุตสาหกรรม
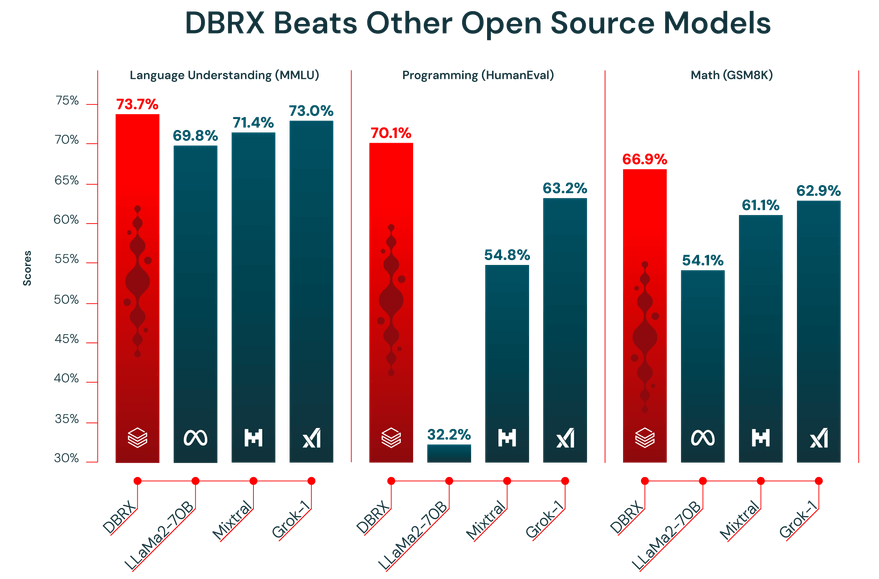
นอกจากนี้ DBRX ยังมีหน้าต่างบริบท (context window) ขนาด 32,000 โทเคน ซึ่งเป็นปริมาณข้อความที่โมเดลสามารถพิจารณาได้ในครั้งเดียว หน้าต่างบริบทที่ใหญ่มีประโยชน์อย่างยิ่งสำหรับงานที่ซับซ้อน เช่น การสรุปรายงานที่ยาว การวิเคราะห์เอกสารทางกฎหมายที่ยาว หรือการสร้างระบบ RAG (Retrieval-Augmented Generation) ขั้นสูง เนื่องจากช่วยให้โมเดลสามารถรักษาบริบทได้โดยไม่ตัดทอนหรือลืมข้อมูล
🎥 ดูวิดีโอนี้เพื่อเรียนรู้ว่าการประสานงานโครงการที่ราบรื่นสามารถเปลี่ยนกระบวนการฝึก AI ของคุณได้อย่างไร และขจัดความยุ่งยากจากการต้องสลับไปมาระหว่างเครื่องมือที่แยกกัน 👇🏽
วิธีเข้าถึงและตั้งค่า DBRX
DBRX มีสองช่องทางเข้าถึงหลัก ซึ่งทั้งสองช่องทางล้วนให้สิทธิ์เข้าถึงน้ำหนักของโมเดลอย่างเต็มรูปแบบภายใต้ เงื่อนไขเชิงพาณิชย์ที่ผ่อนปรน คุณสามารถใช้ Hugging Face เพื่อความยืดหยุ่นสูงสุด หรือเข้าถึงโดยตรงผ่าน Databricks เพื่อประสบการณ์ที่บูรณาการมากขึ้น
เข้าถึง DBRX ผ่าน Hugging Face
สำหรับทีมที่ให้ความสำคัญกับความยืดหยุ่นและคุ้นเคยกับระบบนิเวศ Hugging Face แล้ว การเข้าถึง DBRX ผ่าน Hub เป็นทางเลือกที่เหมาะสมที่สุด ซึ่งช่วยให้คุณสามารถผสานรวมโมเดลเข้ากับกระบวนการทำงานที่มีอยู่ซึ่งใช้ transformers เป็นพื้นฐานได้
นี่คือวิธีเริ่มต้น:
- สร้างหรือเข้าสู่ระบบบัญชี Hugging Face ของคุณ
- ไปที่บัตรโมเดล DBRX บน Hub และยอมรับเงื่อนไขใบอนุญาต
- ติดตั้งไลบรารี transformers พร้อมทั้ง dependencies ที่จำเป็น เช่น accelerate
- ใช้คลาส AutoModelForCausalLM ในสคริปต์ Python ของคุณเพื่อโหลดโมเดล DBRX
- กำหนดค่า pipeline การอนุมาน โดยต้องคำนึงว่า DBRX ต้องการหน่วยความจำ GPU (VRAM) ในปริมาณมาก เพื่อให้ทำงานได้อย่างมีประสิทธิภาพ
📖 อ่านเพิ่มเติม: วิธีตั้งค่า LLM Temperature
เข้าถึง DBRX ผ่าน Databricks
หากทีมของคุณใช้ Databricks อยู่แล้วสำหรับการวิศวกรรมข้อมูลหรือการเรียนรู้ของเครื่อง การเข้าถึง DBRX ผ่านแพลตฟอร์มนี้คือวิธีที่ง่ายที่สุด มันช่วยลดความยุ่งยากในการตั้งค่า และให้คุณมีเครื่องมือทั้งหมดที่จำเป็นสำหรับ MLOps ตรงที่คุณกำลังทำงานอยู่
ทำตามขั้นตอนต่อไปนี้ภายในพื้นที่ทำงาน Databricks ของคุณเพื่อเริ่มต้น:
- ไปที่ส่วน Model Garden หรือ Mosaic AI
- เลือก DBRX Base หรือ DBRX Instruct ตามความต้องการของคุณ
- กำหนดจุดปลายทาง (endpoint) สำหรับการเข้าถึง API หรือตั้งค่าสภาพแวดล้อม notebook เพื่อการใช้งานแบบโต้ตอบ
- เริ่มทดสอบการอนุมานด้วยคำสั่งตัวอย่าง เพื่อตรวจสอบว่าทุกอย่างทำงานอย่างถูกต้อง ก่อนที่จะขยายการฝึกอบรมหรือการนำโมเดล AI ไปใช้งานจริง
วิธีนี้ช่วยให้คุณเข้าถึงเครื่องมือต่าง ๆ ได้อย่างราบรื่น เช่น MLflow สำหรับการติดตามการทดลอง และ Unity Catalogสำหรับการบริหารจัดการโมเดล
📮 ClickUp Insight: ผู้ทำงานมืออาชีพใช้เวลามากกว่า 30 นาทีต่อวันในการค้นหาข้อมูลที่เกี่ยวข้องกับงาน — ซึ่งเท่ากับสูญเสียเวลามากกว่า 120 ชั่วโมงต่อปีไปกับการค้นหาในอีเมล บทสนทนาใน Slack และไฟล์ที่กระจัดกระจาย
ผู้ช่วย AI ที่อัจฉริยะซึ่งถูกฝังอยู่ในพื้นที่ทำงานของคุณสามารถเปลี่ยนสิ่งนั้นได้ พบกับClickUp Brain
ClickUp ให้ข้อมูลเชิงลึกและคำตอบทันที โดยแสดงเอกสาร การสนทนา และรายละเอียดงานที่ถูกต้องภายในไม่กี่วินาที — ทำให้คุณไม่ต้องเสียเวลาค้นหาอีกต่อไป และสามารถเริ่มทำงานได้ทันที
วิธีปรับแต่ง DBRX และฝึกโมเดล AI แบบกำหนดเอง
โมเดลสำเร็จรูป ไม่ว่าจะทรงพลังเพียงใด ก็ไม่สามารถเข้าใจความละเอียดอ่อนที่เป็นเอกลักษณ์ของธุรกิจคุณได้ เนื่องจาก DBRX เป็นโอเพนซอร์ส คุณจึงสามารถปรับแต่งมันเพื่อสร้างโมเดลที่ปรับแต่งเอง ซึ่งเข้าใจภาษาของบริษัทคุณ หรือทำงานเฉพาะที่คุณต้องการให้มันจัดการได้
ต่อไปนี้คือสามวิธีทั่วไปที่คุณสามารถทำได้:
1. ปรับแต่ง DBRX ด้วยชุดข้อมูลจาก Hugging Face
สำหรับทีมที่เพิ่งเริ่มต้นหรือกำลังทำงานกับงานทั่วไป ชุดข้อมูลสาธารณะจาก Hugging Face Hub เป็นทรัพยากรที่ยอดเยี่ยม เนื่องจากข้อมูลเหล่านี้ได้รับการจัดรูปแบบไว้ล่วงหน้าและโหลดได้ง่าย ซึ่งหมายความว่าคุณไม่จำเป็นต้องเสียเวลาหลายชั่วโมงในการเตรียมข้อมูล
กระบวนการนี้ง่ายมาก:
- ค้นหาชุดข้อมูลบน Hub ที่ตรงกับงานของคุณ (เช่น การปฏิบัติตามคำสั่ง การสรุปเนื้อหา)
- โหลดข้อมูลโดยใช้ไลบรารีชุดข้อมูล
- ตรวจสอบให้แน่ใจว่าข้อมูลถูกจัดรูปแบบเป็นคู่คำสั่ง-คำตอบ
- กำหนดค่าสคริปต์การฝึกด้วยไฮเปอร์พารามิเตอร์ เช่น อัตราการเรียนรู้และขนาดแบทช์
- เริ่มงานการฝึกอบรม โดยอย่าลืมบันทึกจุดตรวจสอบ (checkpoints) เป็นระยะ
- ประเมินโมเดลที่ปรับแต่งแล้วบนชุดข้อมูลการตรวจสอบที่แยกไว้เพื่อวัดการปรับปรุง
2. ปรับแต่ง DBRX ด้วยชุดข้อมูลท้องถิ่น
โดยทั่วไป คุณจะได้ผลลัพธ์ที่ดีที่สุดจากการปรับแต่งแบบละเอียดด้วยข้อมูลเฉพาะของบริษัทคุณเอง ซึ่งช่วยให้คุณสามารถสอนโมเดลให้เข้าใจศัพท์เฉพาะ สไตล์ และความรู้ในสาขาเฉพาะของบริษัทคุณได้แต่โปรดจำไว้ว่า วิธีนี้จะให้ผลลัพธ์ที่ดีก็ต่อเมื่อข้อมูลของคุณสะอาด จัดเตรียมไว้อย่างดี และมีปริมาณที่เพียงพอ
ทำตามขั้นตอนต่อไปนี้เพื่อเตรียมข้อมูลภายในของคุณ:
- การเก็บข้อมูล: รวบรวมตัวอย่างคุณภาพสูงจากวิกิภายใน เอกสาร และฐานข้อมูลของคุณ
- การแปลงรูปแบบ: จัดโครงสร้างข้อมูลให้เป็นรูปแบบคำสั่ง-คำตอบที่สม่ำเสมอ โดยทั่วไปจะใช้รูปแบบ JSON lines
- การกรองคุณภาพ: ลบตัวอย่างที่มีคุณภาพต่ำ ซ้ำซ้อน หรือไม่เกี่ยวข้อง
- การแบ่งข้อมูลเพื่อตรวจสอบความถูกต้อง: แยกส่วนข้อมูลขนาดเล็ก (โดยทั่วไป 10-15%) เพื่อประเมินประสิทธิภาพของโมเดล
- การตรวจสอบความเป็นส่วนตัว: ลบหรือปิดบังข้อมูลที่สามารถระบุตัวตนได้ (PII) หรือข้อมูลที่ละเอียดอ่อน
3. ปรับแต่ง DBRX ด้วย StreamingDataset
หากชุดข้อมูลของคุณมีขนาดใหญ่เกินไปจนไม่สามารถเก็บไว้ในหน่วยความจำของเครื่องได้ ไม่ต้องกังวล คุณสามารถใช้ไลบรารี Streaming Dataset ของ Databricks ได้ ซึ่งช่วยให้คุณสามารถสตรีมข้อมูลโดยตรงจากพื้นที่จัดเก็บข้อมูลบนคลาวด์ในขณะที่โมเดลกำลังฝึกอยู่ แทนที่จะต้องโหลดข้อมูลทั้งหมดเข้าสู่หน่วยความจำในครั้งเดียว
นี่คือวิธีที่คุณสามารถทำได้:
- การเตรียมข้อมูล: ทำความสะอาดและจัดโครงสร้างข้อมูลการฝึกอบรมของคุณ แล้วเก็บไว้ในรูปแบบที่สามารถสตรีมได้ เช่น JSONL หรือ CSV ในพื้นที่จัดเก็บข้อมูลบนคลาวด์
- การแปลงรูปแบบข้อมูลแบบสตรีมมิ่ง: แปลงชุดข้อมูลของคุณเป็นรูปแบบที่เหมาะสำหรับการสตรีมมิ่ง เช่น Mosaic Data Shard (MDS) เพื่อให้สามารถอ่านได้อย่างมีประสิทธิภาพระหว่างการฝึกอบรม
- การตั้งค่าตัวโหลดการฝึก: ตั้งค่าตัวโหลดการฝึกให้ชี้ไปยังชุดข้อมูลระยะไกล และกำหนดแคชท้องถิ่นสำหรับการจัดเก็บข้อมูลชั่วคราว
- การเริ่มต้นโมเดล: เริ่มกระบวนการปรับแต่ง DBRX โดยใช้เฟรมเวิร์กการฝึกอบรมที่รองรับ StreamingDataset เช่น LLM Foundry
- การฝึกอบรมแบบสตรีม: ดำเนินการฝึกอบรมโดยให้ข้อมูลถูกส่งเข้ามาเป็นชุดๆ ระหว่างการฝึกอบรม แทนที่จะโหลดข้อมูลทั้งหมดเข้าสู่หน่วยความจำ
- จุดตรวจสอบและกู้คืน: ดำเนินการฝึกอบรมต่อได้อย่างราบรื่นหากการรันถูกขัดจังหวะ โดยไม่ต้องทำซ้ำหรือข้ามข้อมูล
- การประเมินและปรับใช้: ตรวจสอบประสิทธิภาพของโมเดลที่ปรับแต่งแล้ว และปรับใช้มันโดยใช้ระบบให้บริการหรือระบบการอนุมานที่คุณชื่นชอบ
💡เคล็ดลับจากผู้เชี่ยวชาญ: แทนที่จะสร้างแผนการฝึกอบรม DBRX จากศูนย์ ให้เริ่มด้วย แม่แบบแผนงานโครงการ AI และ Machine Learning ของ ClickUp แล้วปรับให้เหมาะสมกับความต้องการของทีม แม่แบบนี้ให้โครงสร้างที่ชัดเจนสำหรับการวางแผนชุดข้อมูล ขั้นตอนการฝึกอบรม การประเมินผล และการนำไปใช้งาน ทำให้คุณสามารถมุ่งเน้นไปที่การจัดระเบียบงานแทนที่จะต้องสร้างกระบวนการทำงานใหม่
กรณีการใช้งาน DBRX สำหรับการฝึกโมเดล AI
การมีโมเดลที่ทรงพลังเป็นเรื่องหนึ่ง แต่การรู้อย่างแน่ชัดว่าโมเดลนั้นแสดงศักยภาพได้ดีที่สุดด้านใดเป็นเรื่องอีกเรื่องหนึ่ง
เมื่อไม่มีความเข้าใจที่ชัดเจนเกี่ยวกับจุดแข็งของโมเดล ก็ง่ายที่จะเสียเวลาและทรัพยากรไปกับการพยายามทำให้มันทำงานในสถานการณ์ที่มันไม่เหมาะสม ซึ่งส่งผลให้เกิดผลลัพธ์ที่ต่ำกว่ามาตรฐานและความรู้สึกผิดหวัง
สถาปัตยกรรมและข้อมูลการฝึกอบรมที่เป็นเอกลักษณ์ของ DBRX ทำให้มันเหมาะสมอย่างยิ่งสำหรับกรณีการใช้งานหลักหลายอย่างในองค์กร การเข้าใจจุดแข็งเหล่านี้จะช่วยให้คุณปรับให้โมเดลสอดคล้องกับเป้าหมายธุรกิจและเพิ่มผลตอบแทนจากการลงทุนให้สูงสุด
การสร้างข้อความและการสร้างเนื้อหา
DBRX Instruct ได้รับการปรับแต่งอย่างละเอียดเพื่อปฏิบัติตามคำสั่งและสร้างข้อความคุณภาพสูง ซึ่งทำให้มันเป็นเครื่องมือที่ทรงพลังสำหรับการอัตโนมัติงานที่เกี่ยวข้องกับเนื้อหาอย่างหลากหลาย หน้าต่างบริบทที่กว้างเป็นข้อได้เปรียบสำคัญ ทำให้มันสามารถจัดการเอกสารยาวได้โดยไม่สูญเสียความต่อเนื่อง
คุณสามารถใช้มันเพื่อ:
- เอกสารทางเทคนิค: สร้างและปรับปรุงคู่มือผลิตภัณฑ์ เอกสารอ้างอิง API และคู่มือผู้ใช้
- เนื้อหาด้านการตลาด: ร่างบทความบล็อก จดหมายข่าวทางอีเมล และอัปเดตบนโซเชียลมีเดีย
- การสร้างรายงาน: สรุปผลการวิเคราะห์ข้อมูลที่ซับซ้อนและสร้างบทสรุปสำหรับผู้บริหารที่กระชับ
- การแปลและปรับให้เหมาะสมกับท้องถิ่น: ปรับเนื้อหาที่มีอยู่ให้เหมาะสมกับตลาดและกลุ่มเป้าหมายใหม่
การสร้างโค้ดและงานแก้ไขข้อผิดพลาด
ส่วนสำคัญของข้อมูลการฝึกของ DBRX ประกอบด้วยโค้ด ซึ่งทำให้มันกลายเป็นเครื่องมือสนับสนุน LLM ที่มีประสิทธิภาพสำหรับนักพัฒนา มันสามารถช่วยเร่งความเร็วของวงจรการพัฒนาได้โดยการอัตโนมัติงานเขียนโค้ดที่ซ้ำซาก และช่วยในการแก้ปัญหาที่ซับซ้อน
ต่อไปนี้คือวิธีที่ทีมวิศวกรรมของคุณสามารถใช้ประโยชน์จากมันได้:
- การเติมโค้ดอัตโนมัติ: สร้างตัวฟังก์ชันโดยอัตโนมัติจากความคิดเห็นหรือ docstrings
- การตรวจหาข้อผิดพลาด: วิเคราะห์ส่วนโค้ดเพื่อระบุข้อผิดพลาดที่อาจเกิดขึ้นหรือข้อบกพร่องทางตรรกะ
- คำอธิบายโค้ด: แปลอัลกอริทึมที่ซับซ้อนหรือโค้ดเก่าเป็นภาษาอังกฤษที่เข้าใจง่าย
- การสร้างการทดสอบ: สร้างการทดสอบหน่วย (unit tests) โดยอิงจากลายเซ็นของฟังก์ชันและพฤติกรรมที่คาดหมาย
RAG และแอปพลิเคชันที่มีบริบทยาว
Retrieval-Augmented Generation (RAG)เป็นเทคนิคที่ทรงพลัง ซึ่งช่วยให้คำตอบของโมเดลมีพื้นฐานจากข้อมูลส่วนตัวของบริษัทคุณ อย่างไรก็ตาม ระบบ RAG มักประสบปัญหาเมื่อใช้กับโมเดลที่มีหน้าต่างบริบทขนาดเล็ก ซึ่งทำให้ต้องแบ่งข้อมูลเป็นชิ้นๆ อย่างรุนแรง จนอาจสูญเสียบริบทสำคัญไป หน้าต่างบริบทขนาด 32K ของ DBRX ทำให้มันเป็นพื้นฐานที่ยอดเยี่ยมสำหรับแอปพลิเคชัน RAG ที่มีความเสถียร
สิ่งนี้ช่วยให้คุณสร้างเครื่องมือภายในที่ทรงพลัง เช่น:
- การค้นหาในองค์กร: สร้างแชทบอทที่ตอบคำถามของพนักงานโดยใช้ฐานความรู้ภายในองค์กร
- บริการลูกค้า: สร้างเอเจนต์ที่สร้างคำตอบสนับสนุนโดยอ้างอิงจากเอกสารคู่มือผลิตภัณฑ์ของคุณ
- การสนับสนุนการวิจัย: พัฒนาเครื่องมือที่สามารถสังเคราะห์ข้อมูลจากเอกสารวิจัยหลายร้อยหน้า
- การตรวจสอบความสอดคล้อง: ตรวจสอบข้อความการตลาดโดยอัตโนมัติให้สอดคล้องกับแนวทางแบรนด์ภายในหรือเอกสารกฎระเบียบ
วิธีผสานการฝึกอบรม DBRX เข้ากับกระบวนการทำงานของทีม
โครงการฝึกอบรมโมเดล AI ที่ประสบความสำเร็จนั้นไม่ใช่แค่เรื่องโค้ดและกำลังการคำนวณเท่านั้น แต่เป็นความร่วมมือระหว่างวิศวกร ML นักวิทยาศาสตร์ข้อมูล ผู้จัดการผลิตภัณฑ์ และผู้มีส่วนได้ส่วนเสีย
เมื่อการร่วมมือนี้ถูกกระจายไปทั่ว Jupyter notebooks, ช่อง Slack และเครื่องมือจัดการโครงการที่แยกกัน คุณจะสร้างcontext sprawl ซึ่งเป็นสถานการณ์ที่ข้อมูลสำคัญของโครงการถูกกระจายไปทั่วเครื่องมือที่มากเกินไป
ClickUp ช่วยแก้ปัญหานี้ได้ แทนที่จะต้องใช้เครื่องมือหลายอย่างพร้อมกัน คุณจะได้รับพื้นที่ทำงาน AI แบบรวมศูนย์ (Converged AI Workspace) ที่รวมการจัดการโครงการ การบันทึกข้อมูล และการสื่อสารไว้ในที่เดียว — ทำให้การทดลองของคุณยังคงเชื่อมโยงกันตั้งแต่ขั้นตอนการวางแผน ไปจนถึงการดำเนินการ และการประเมินผล
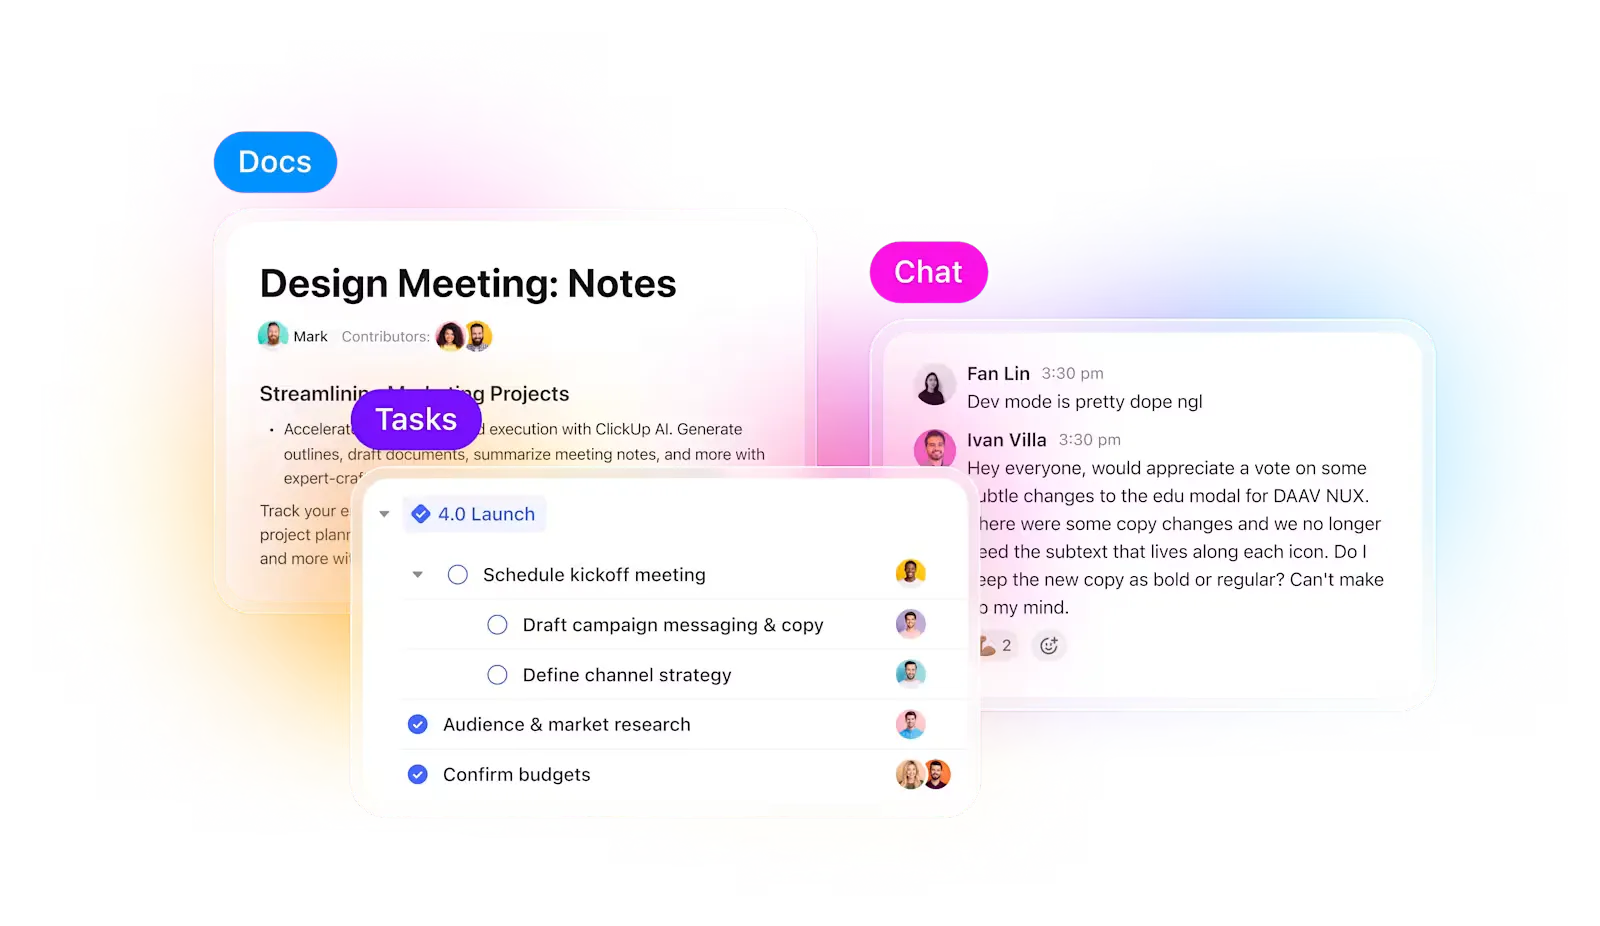
อย่าให้ทดลองและความคืบหน้าหลุดจากสายตา
เมื่อดำเนินการทดลองหลายครั้ง ส่วนที่ยากที่สุดไม่ใช่การฝึกโมเดล แต่คือการติดตามว่าอะไรได้เปลี่ยนแปลงไประหว่างกระบวนการนั้น เช่น เวอร์ชันชุดข้อมูลใดถูกใช้ อัตราการเรียนรู้ใดให้ผลลัพธ์ดีที่สุด หรือการทดลองครั้งใดที่ได้รับการนำไปใช้งานจริง?
ClickUp ทำให้กระบวนการนี้ง่ายมากสำหรับคุณ คุณสามารถติดตาม แต่ละรอบการฝึก แยกกันในClickUp Tasks และภายในแต่ละงาน คุณสามารถใช้Custom Fieldsเพื่อบันทึก:
- เวอร์ชันชุดข้อมูล
- ไฮเปอร์พารามิเตอร์
- รุ่นโมเดล (DBRX Base vs DBRX Instruct)
- สถานะการฝึก (อยู่ในคิว, กำลังทำงาน, กำลังประเมิน, ได้ปรับใช้แล้ว)
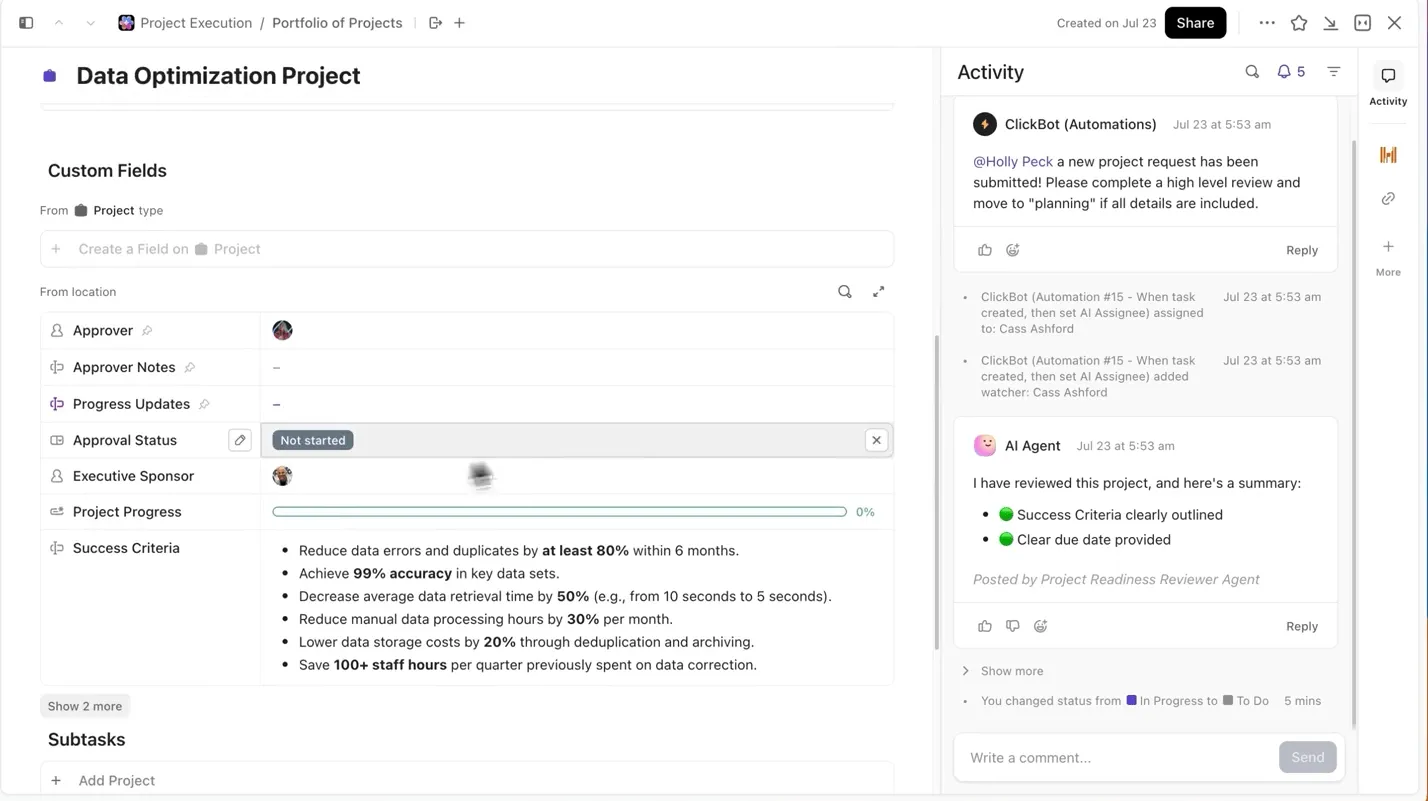
ด้วยวิธีนี้ ทุกการทดลองที่บันทึกไว้สามารถค้นหาได้ เปรียบเทียบกับกันได้ง่าย และสามารถทำซ้ำได้
ให้เอกสารของโมเดลเชื่อมโยงกับงาน
คุณไม่จำเป็นต้องสลับไปมาระหว่าง Jupyter notebooks, ไฟล์ README หรือ thread ใน Slack เพื่อเข้าใจบริบทของงานในทดลอง
ด้วยClickUp Docsคุณสามารถจัดระเบียบและเข้าถึงสถาปัตยกรรมโมเดล สคริปต์เตรียมข้อมูล หรือตัวชี้วัดการประเมินได้อย่างสะดวก โดยบันทึกข้อมูลเหล่านี้ไว้ในเอกสารที่สามารถค้นหาได้ ซึ่งเชื่อมโยงโดยตรงกับงานทดลองที่ข้อมูลเหล่านั้นมาจาก
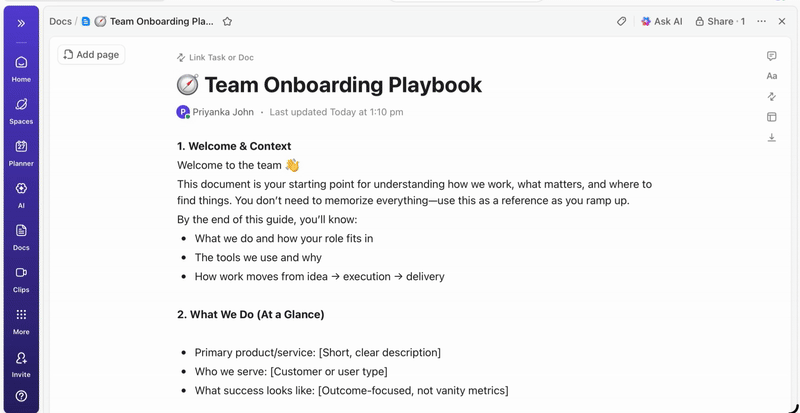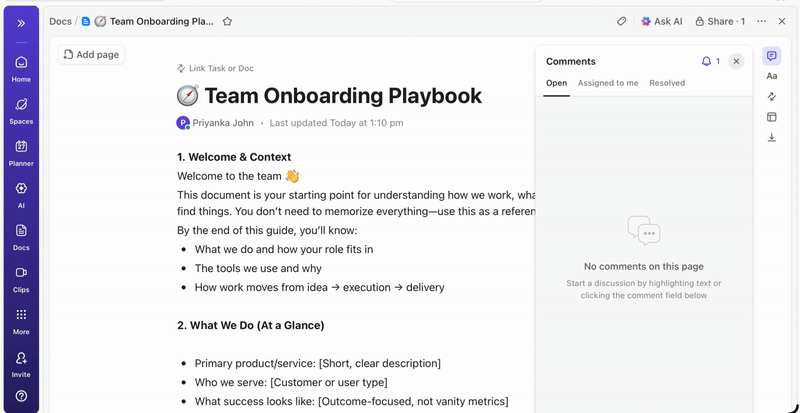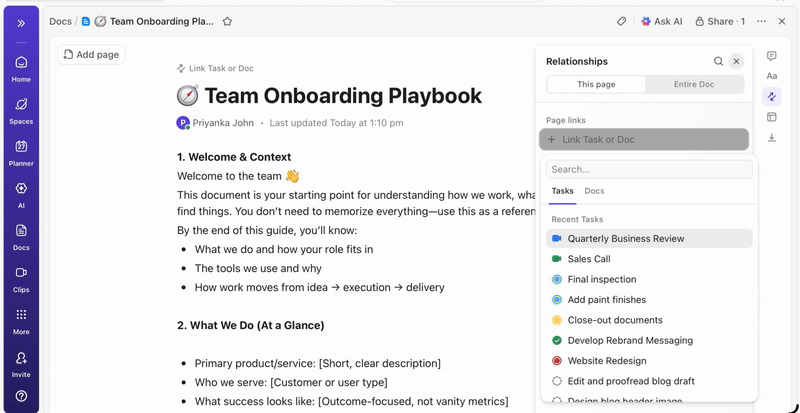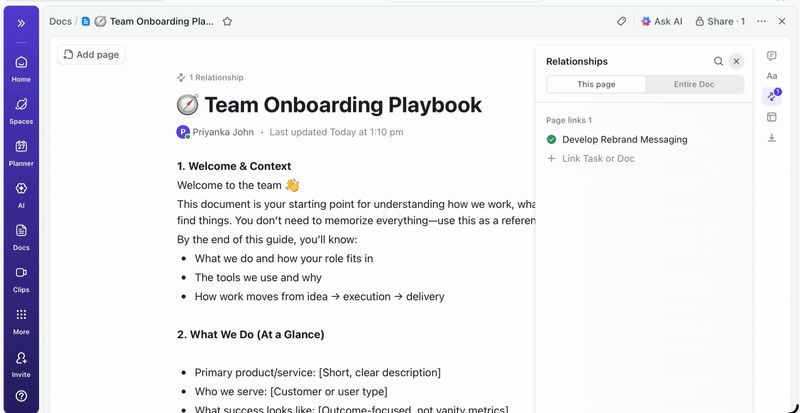
💡เคล็ดลับจากผู้เชี่ยวชาญ: รักษาเอกสารสรุปโครงการที่อัปเดตอย่างต่อเนื่องใน ClickUp Docs ซึ่งระบุรายละเอียดทุกการตัดสินใจ ตั้งแต่สถาปัตยกรรมไปจนถึงการปรับใช้ เพื่อให้สมาชิกทีมใหม่สามารถเข้าใจรายละเอียดโครงการได้อย่างรวดเร็วโดยไม่ต้องค้นหาในหัวข้อสนทนาเก่า
ให้ผู้มีส่วนได้ส่วนเสียสามารถติดตามความคืบหน้าแบบเรียลไทม์
แดชบอร์ดของ ClickUpแสดงความคืบหน้าของการทดลองและปริมาณงานของทีมแบบเรียลไทม์
แทนที่จะต้องรวบรวมข้อมูลอัปเดตหรือส่งอีเมลด้วยมือ แดชบอร์ดจะอัปเดตอัตโนมัติตามข้อมูลในงานของคุณ ทำให้ผู้เกี่ยวข้องสามารถตรวจสอบสถานะได้ทุกเมื่อ ดูความคืบหน้าของงาน และไม่จำเป็นต้องรบกวนคุณด้วยคำถามว่า “สถานะเป็นอย่างไร?”
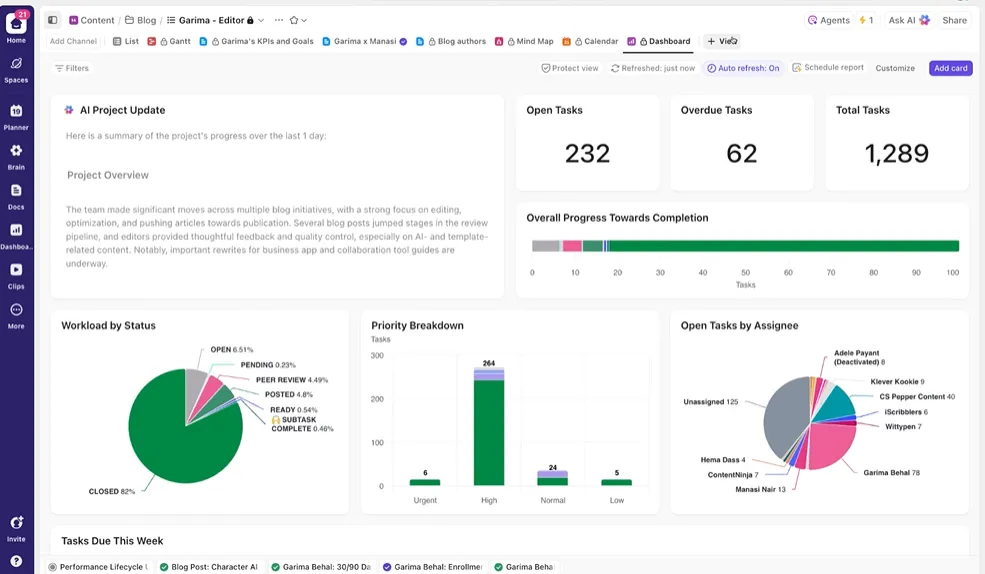
ด้วยวิธีนี้ คุณจะสามารถมุ่งเน้นไปที่การดำเนินการทดลองแทนที่จะต้องรายงานผลการทดลองแบบมืออย่างต่อเนื่อง
เปลี่ยน AI ให้กลายเป็นผู้ช่วยโครงการอัจฉริยะของคุณ
คุณไม่จำเป็นต้องค้นหาข้อมูลการฝึกอบรมที่สะสมมาหลายสัปดาห์ด้วยมือเพื่อรับสรุปผลการทดลองจนถึงขณะนี้ เพียงแค่กล่าวถึง @Brain ในความคิดเห็นของงานใดก็ตาม ClickUp Brain จะให้ความช่วยเหลือที่คุณต้องการ พร้อมบริบทครบถ้วนเกี่ยวกับโครงการที่ผ่านมาและโครงการที่กำลังดำเนินการอยู่
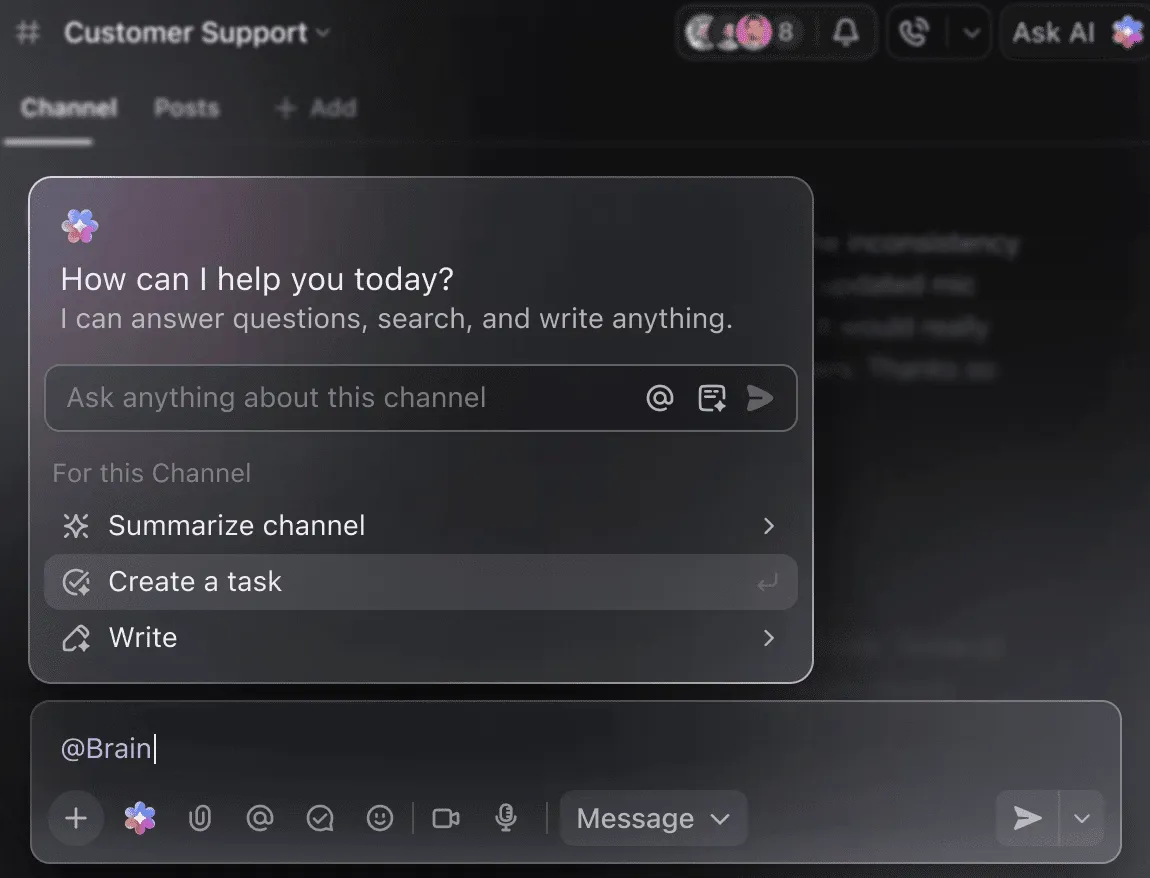
คุณสามารถขอให้ Brain ‘สรุปการทดลองของสัปดาห์ที่แล้วเป็น 5 ข้อ’ หรือ ‘ร่างเอกสารด้วยผลลัพธ์ของไฮเปอร์พารามิเตอร์ล่าสุด’ และได้รับผลลัพธ์ที่สมบูรณ์แบบทันที
🧠 ข้อได้เปรียบของ ClickUp:Super Agentsของ ClickUp นำสิ่งนี้ไปไกลกว่านั้น—พวกมันสามารถ อัตโนมัติกระบวนการทำงานทั้งหมดตามทริกเกอร์ที่คุณกำหนด ไม่เพียงแต่ตอบคำถามของคุณเท่านั้น ด้วย Super Agents คุณสามารถสร้างงานฝึกอบรม DBRX ใหม่ได้โดยอัตโนมัติทุกครั้งที่มีชุดข้อมูลถูกอัปโหลด แจ้งให้ทีมของคุณทราบ และเชื่อมโยงเอกสารที่เกี่ยวข้องเมื่อการฝึกอบรมเสร็จสิ้นหรือถึงจุดตรวจสอบ รวมถึงสร้างสรุปรายงานความคืบหน้าประจำสัปดาห์และส่งไปยังผู้เกี่ยวข้อง โดยที่คุณไม่ต้องทำอะไรเลย
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยง
การเริ่มต้นโครงการฝึกอบรม DBRX เป็นเรื่องที่น่าตื่นเต้น แต่มีข้อผิดพลาดทั่วไปบางประการที่อาจทำให้ความก้าวหน้าของคุณสะดุด การหลีกเลี่ยงข้อผิดพลาดเหล่านี้จะช่วยคุณประหยัดเวลา เงิน และความหงุดหงิดได้มาก
- การประเมินความต้องการด้านฮาร์ดแวร์ต่ำเกินไป: DBRX มีประสิทธิภาพสูง แต่ก็มีขนาดที่ใหญ่มาก การพยายามรันมันบนฮาร์ดแวร์ที่ไม่เพียงพอจะนำไปสู่ข้อผิดพลาดเนื่องจากหน่วยความจำไม่เพียงพอ (out-of-memory errors) และงานการฝึกอบรมที่ล้มเหลว โปรดจำไว้ว่า DBRX (132B) ต้องการ VRAM อย่างน้อย 264GB สำหรับการอนุมานแบบ 16-bit หรือประมาณ 70GB-80GB เมื่อใช้การควอนไทเซชันแบบ 4-bit
- การข้ามขั้นตอนการตรวจสอบคุณภาพข้อมูล: ข้อมูลเข้าไม่ดี ผลลัพธ์ออกก็ไม่ดี การปรับแต่งโมเดลบนชุดข้อมูลที่ยุ่งเหยิงและคุณภาพต่ำ จะทำให้โมเดลเรียนรู้ที่จะสร้างผลลัพธ์ที่ยุ่งเหยิงและคุณภาพต่ำเท่านั้น
- การไม่คำนึงถึงขีดจำกัดความยาวของบริบท: ถึงแม้หน้าต่างบริบท 32K ของ DBRX จะกว้างขวาง แต่ก็ไม่ใช่อันจำกัด การป้อนข้อมูลเข้าโมเดลที่เกินขีดจำกัดนี้จะส่งผลให้ข้อมูลถูกตัดทิ้งโดยไม่แจ้งเตือน และประสิทธิภาพการทำงานลดลง
- การใช้ Base เมื่อ Instruct เป็นตัวเลือกที่เหมาะสม: DBRX Base เป็นโมเดลดิบที่ผ่านการฝึกอบรมเบื้องต้นไว้แล้ว ซึ่งออกแบบมาเพื่อฝึกอบรมต่อในระดับใหญ่ สำหรับงานส่วนใหญ่ที่เกี่ยวข้องกับการปฏิบัติตามคำสั่ง คุณควรเริ่มต้นด้วย DBRX Instruct ซึ่งได้ผ่านการปรับแต่งให้เหมาะสมกับวัตถุประสงค์นั้นแล้ว
- การแยกงานฝึกอบรมออกจากงานประสานงานโครงการ: เมื่อการติดตามการทดลองอยู่ในเครื่องมือหนึ่ง ส่วนแผนโครงการอยู่ในเครื่องมืออีกตัว คุณจะสร้างข้อมูลที่แยกส่วนกัน ใช้แพลตฟอร์มที่บูรณาการอย่าง ClickUp เพื่อรักษาความสอดคล้องระหว่างงานทางเทคนิคและการประสานงานโครงการ
- การละเลยการประเมินผลก่อนการนำระบบไปใช้งานจริง: โมเดลที่ทำงานได้ดีบนข้อมูลฝึกอบรมอาจล้มเหลวอย่างน่าทึ่งในโลกจริง ดังนั้นควรตรวจสอบความถูกต้องของโมเดลที่ปรับแต่งแล้วบนชุดข้อมูลทดสอบที่แยกไว้เสมอ ก่อนที่จะนำระบบไปใช้งานจริง
- ความซับซ้อนในการปรับแต่งละเอียดที่มักถูกมองข้าม: เนื่องจาก DBRX เป็นโมเดล Mixture-of-Experts สคริปต์การปรับแต่งละเอียดมาตรฐานอาจต้องการไลบรารีเฉพาะทาง เช่น Megatron-LM หรือ PyTorch FSDP เพื่อจัดการการแบ่งพารามิเตอร์ (parameter sharding) บน GPU หลายตัว
DBRX เทียบกับแพลตฟอร์มฝึกอบรม AI อื่นๆ
การเลือกแพลตฟอร์มการฝึก AI เกี่ยวข้องกับการแลกเปลี่ยนพื้นฐานระหว่างการควบคุมกับความสะดวกสบาย โมเดลแบบปิดที่ใช้งานผ่าน API เท่านั้นนั้นใช้งานง่าย แต่จะทำให้คุณถูกจำกัดอยู่ในระบบนิเวศของผู้ให้บริการ
โมเดลแบบ open weights อย่าง DBRX ให้ความควบคุมอย่างเต็มที่ แต่ต้องการความรู้ทางเทคนิคและโครงสร้างพื้นฐานที่มากขึ้น การเลือกวิธีนี้อาจทำให้คุณรู้สึกติดขัด ไม่แน่ใจว่าเส้นทางใดจะสนับสนุนเป้าหมายระยะยาวของคุณได้จริง — ซึ่งเป็นความท้าทายที่ทีมหลายทีมต้องเผชิญระหว่างการนำ AI มาใช้
ตารางนี้แสดงจุดแตกต่างหลักเพื่อช่วยคุณตัดสินใจอย่างมีข้อมูล
| น้ำหนัก | เปิด (ปรับแต่ง) | ข้อมูลเฉพาะ | เปิด (ปรับแต่ง) | ข้อมูลเฉพาะ |
| การปรับแต่ง | ควบคุมอย่างเต็มที่ | ใช้ API เป็นพื้นฐาน | ควบคุมอย่างเต็มที่ | ใช้ API เป็นพื้นฐาน |
| การโฮสต์เอง | ใช่ | ไม่ | ใช่ | ไม่ |
| ใบอนุญาต | DB Open Model | เงื่อนไขของ OpenAI | ชุมชน Llama | เงื่อนไขของ Anthropic |
| บริบท | 32K | 128K – 1M | 128K | 200K – 1M |
DBRX เป็นตัวเลือกที่เหมาะสมเมื่อคุณต้องการควบคุมโมเดลอย่างเต็มที่ ต้องโฮสต์เองเพื่อความปลอดภัยหรือการปฏิบัติตามกฎระเบียบ หรือต้องการความยืดหยุ่นจากใบอนุญาตเชิงพาณิชย์ที่ให้อิสระสูง หากคุณไม่มีโครงสร้างพื้นฐาน GPU ที่จัดสรรไว้โดยเฉพาะ — หรือคุณให้ความสำคัญกับการนำผลิตภัณฑ์ออกสู่ตลาดอย่างรวดเร็วมากกว่าการปรับแต่งอย่างลึกซึ้ง — ทางเลือกที่ใช้ API อาจเป็นตัวเลือกที่เหมาะสมกว่า
เริ่มฝึกอบรมอย่างชาญฉลาดยิ่งขึ้นด้วย ClickUp
DBRX ให้คุณมีพื้นฐานที่พร้อมสำหรับระดับองค์กรในการสร้างแอปพลิเคชัน AI ที่ปรับแต่งได้ พร้อมด้วยความโปร่งใสและการควบคุมที่คุณไม่ได้รับจากโมเดลแบบปิด สถาปัตยกรรม MoE ที่มีประสิทธิภาพช่วยลดค่าใช้จ่ายในการอนุมาน และการออกแบบแบบเปิดทำให้การปรับแต่งละเอียดเป็นเรื่องง่าย แต่เทคโนโลยีที่แข็งแกร่งเป็นเพียงครึ่งหนึ่งของสมการเท่านั้น
ความสำเร็จที่แท้จริงเกิดจากการปรับงานทางเทคนิคให้สอดคล้องกับกระบวนการทำงานร่วมกันของทีม การฝึกโมเดล AI เป็นงานที่ต้องทำร่วมกันเป็นทีม และการรักษาความสอดคล้องระหว่างการทดลอง เอกสาร และการสื่อสารกับผู้เกี่ยวข้องเป็นสิ่งสำคัญยิ่ง เมื่อคุณนำทุกสิ่งมารวมไว้ในพื้นที่ทำงานเดียวที่รวมศูนย์ และลดการกระจายของบริบท คุณจะสามารถส่งมอบโมเดลที่ดีกว่าได้อย่างรวดเร็วขึ้น
เริ่มใช้ ClickUp ฟรีเพื่อประสานงานโครงการฝึกอบรม AI ของคุณในพื้นที่ทำงานเดียว ✨
คำถามที่มักถูกถาม
ทำอย่างไรเพื่อติดตามความคืบหน้าของการฝึกอบรมใน DBRX?
คุณสามารถติดตามการฝึกอบรมได้โดยใช้เครื่องมือ ML มาตรฐาน เช่น TensorBoard, Weights & Biases หรือ MLflow หากคุณกำลังฝึกอบรมภายในระบบนิเวศ Databricks MLflow จะถูกบูรณาการแบบเนทีฟเพื่อการติดตามการทดลองที่ราบรื่น
สามารถผสานรวม DBRX กับ CI/CD และ pipeline การปรับใช้ได้หรือไม่?
ใช่ DBRX สามารถผสานรวมเข้ากับท่อ MLOps มาตรฐานได้ โดยการบรรจุโมเดลลงในคอนเทนเนอร์ คุณสามารถปรับใช้โมเดลได้ผ่านแพลตฟอร์มการจัดการระบบอย่าง Kubeflow หรือเวิร์กโฟลว์ CI/CD ที่ปรับแต่งเอง
ความแตกต่างระหว่าง DBRX Base และ DBRX Instruct คืออะไร?
DBRX Base เป็นโมเดลพื้นฐานที่ได้รับการฝึกอบรมล่วงหน้าไว้แล้ว ซึ่งออกแบบมาสำหรับทีมที่ต้องการดำเนินการฝึกอบรมล่วงหน้าอย่างต่อเนื่องในโดเมนเฉพาะ หรือปรับแต่งสถาปัตยกรรมเชิงลึก DBRX Instruct เป็นเวอร์ชันที่ได้รับการปรับแต่งให้เหมาะสมสำหรับการปฏิบัติตามคำสั่ง ทำให้เป็นจุดเริ่มต้นที่ดีกว่าสำหรับการพัฒนาแอปพลิเคชันส่วนใหญ่
DBRX เปรียบเทียบกับ GPT-4 อย่างไรสำหรับโครงการ AI ขององค์กร?
ความแตกต่างหลักอยู่ที่การควบคุม DBRX ให้คุณเข้าถึงน้ำหนักของโมเดลได้อย่างเต็มที่ เพื่อปรับแต่งอย่างลึกซึ้งและโฮสต์เอง ในขณะที่ GPT-4 เป็นบริการที่ใช้งานผ่าน API เท่านั้น
สามารถใช้ DBRX ได้ฟรีหรือไม่?
น้ำหนักโมเดล DBRX มีให้ใช้ฟรีภายใต้ใบอนุญาต Databricks Open Model License อย่างไรก็ตาม คุณต้องรับผิดชอบค่าใช้จ่ายของโครงสร้างพื้นฐานการประมวลผลที่จำเป็นสำหรับการรันหรือปรับแต่งโมเดล