
AI-träningsprojekt misslyckas sällan på modellnivå. De stöter på problem när experiment, dokumentation och uppdateringar till intressenterna är utspridda över för många verktyg.
Den här guiden visar dig hur du tränar modeller med Databricks DBRX – en LLM som är upp till dubbelt så beräkningseffektiv som andra ledande modeller – samtidigt som du håller ordning på arbetet kring det i ClickUp.
Från installation och finjustering till dokumentation och uppdateringar mellan teamen kommer du att se hur en enda, samlad arbetsyta hjälper till att eliminera informationsspridning och håller ditt team fokuserat på att bygga, inte på att söka. 🛠
Vad är DBRX?
DBRX är en kraftfull, öppen källkodsbaserad stor språkmodell (LLM) som är särskilt utformad för träning och inferens av AI-modeller i företagsmiljöer. Eftersom den är öppen källkod enligt Databricks Open Model License har ditt team full tillgång till modellens vikter och arkitektur, vilket gör att du kan granska, modifiera och driftsätta den på dina egna villkor.
Det finns i två varianter: DBRX Base för djup förträning och DBRX Instruct för färdiga uppgifter där modellen följer instruktioner.
DBRX-arkitektur och ”mixture-of-experts”-design
DBRX löser uppgifter med hjälp av en Mixture-of-Experts-arkitektur (MoE). Till skillnad från traditionella stora språkmodeller som använder alla sina miljarder parametrar för varje enskild beräkning, aktiverar DBRX endast en bråkdel av sina totala parametrar (de mest relevanta experterna) för en given uppgift.
Tänk på det som ett team av specialiserade experter; istället för att alla arbetar med alla problem dirigerar systemet på ett intelligent sätt varje uppgift till de mest kvalificerade matchande parametrarna.
Detta minskar inte bara svarstiden, utan ger också prestanda och resultat i toppklass samtidigt som beräkningskostnaderna minskas avsevärt.
Här är en snabb översikt över de viktigaste specifikationerna:
- Totalt antal parametrar: 132 miljarder för alla experter
- Aktiva parametrar: 36B per framåtpass
- Antal experter: totalt 16 (MoE Top-4-routing), varav 4 är aktiva för varje given token
- Kontextfönster: 32 000 token
DBRX-träningsdata och token-specifikationer
Prestandan hos en LLM är bara så bra som de data den tränats på. DBRX har förtränats på en enorm dataset med 12 biljoner token, noggrant sammanställd av Databricks-teamet med hjälp av deras avancerade verktyg för databehandling. Det är precis därför den presterade så bra i branschens jämförelsetester.
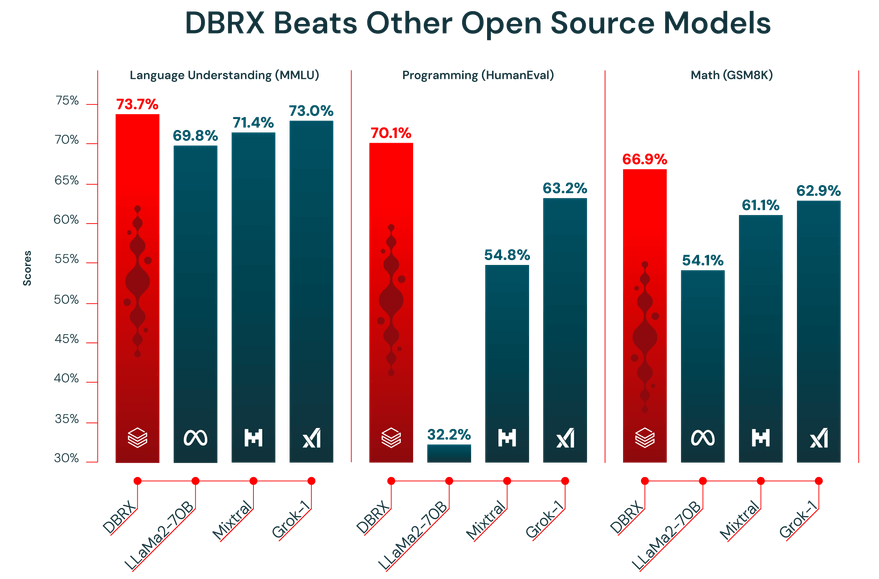
Dessutom har DBRX ett kontextfönster på 32 000 token. Det är den mängd text som modellen kan bearbeta samtidigt. Ett stort kontextfönster är mycket användbart för komplexa uppgifter som att sammanfatta långa rapporter, granska omfattande juridiska dokument eller bygga avancerade RAG-system (Retrieval-Augmented Generation), eftersom det gör att modellen kan behålla sammanhanget utan att informationen förkortas eller glöms bort.
🎥 Titta på den här videon för att se hur en smidig projektkoordinering kan förändra ditt arbetsflöde för AI-träning och eliminera besväret med att växla mellan verktyg som inte är integrerade med varandra. 👇🏽
Så här kommer du åt och konfigurerar DBRX
DBRX erbjuder två huvudsakliga åtkomstvägar, som båda ger full tillgång till modellvikterna enligt förmånliga kommersiella villkor. Du kan använda Hugging Face för maximal flexibilitet eller komma åt det direkt via Databricks för en mer integrerad upplevelse.
Få tillgång till DBRX via Hugging Face
För team som värdesätter flexibilitet och redan är vana vid Hugging Face-ekosystemet är det idealiskt att komma åt DBRX via Hub. Det gör att du kan integrera modellen i dina befintliga Transformers-baserade arbetsflöden.
Så här kommer du igång:
- Skapa eller logga in på ditt Hugging Face-konto
- Gå till DBRX-modellkortet på Hub och godkänn licensvillkoren
- Installera transformers-biblioteket tillsammans med nödvändiga beroenden som accelerate
- Använd klassen AutoModelForCausalLM i ditt Python-skript för att ladda DBRX-modellen
- Konfigurera din inferenspipeline och tänk på att DBRX kräver betydande mängder GPU-minne (VRAM) för att fungera effektivt
📖 Läs mer: Hur man konfigurerar LLM-temperaturen
Få tillgång till DBRX via Databricks
Om ditt team redan använder Databricks för dataengineering eller maskininlärning är det enklast att komma åt DBRX via plattformen. Det eliminerar installationsproblem och ger dig alla verktyg du behöver för MLOps precis där du redan arbetar.
Följ dessa steg i ditt Databricks-arbetsutrymme för att komma igång:
- Gå till avsnittet Model Garden eller Mosaic AI
- Välj antingen DBRX Base eller DBRX Instruct, beroende på dina behov
- Konfigurera en serveringsändpunkt för API-åtkomst eller ställ in en notebook-miljö för interaktiv användning
- Börja testa inferens med exempel på promptar för att säkerställa att allt fungerar korrekt innan du skalar upp träningen eller driftsättningen av din AI-modell
Denna metod ger dig smidig tillgång till verktyg som MLflow för experimentuppföljning och Unity Catalog för modellstyrning.
📮 ClickUp Insight: En genomsnittlig yrkesverksam person lägger mer än 30 minuter om dagen på att söka efter arbetsrelaterad information – det innebär över 120 timmar om året som går förlorade till att leta igenom e-postmeddelanden, Slack-trådar och utspridda filer.
En intelligent AI-assistent inbyggd i ditt arbetsutrymme kan ändra på det. Här kommer ClickUp Brain.
Det ger omedelbara insikter och svar genom att visa rätt dokument, konversationer och uppgiftsdetaljer på några sekunder – så att du kan sluta söka och börja arbeta.
Så här finjusterar du DBRX och tränar anpassade AI-modeller
En färdig modell, hur kraftfull den än är, kommer aldrig att förstå de unika nyanserna i just din verksamhet. Eftersom DBRX är öppen källkod kan du finjustera den för att skapa en anpassad modell som talar ditt företags språk eller utför en specifik uppgift som du vill att den ska hantera.
Här är tre vanliga sätt att göra detta på:
1. Finjustera DBRX med datamängder från Hugging Face
För team som just har börjat eller arbetar med vanliga uppgifter är offentliga datamängder från Hugging Face Hub en utmärkt resurs. De är förformaterade och lätta att ladda, vilket innebär att du slipper lägga timmar på att förbereda dina data.
Processen är ganska enkel:
- Hitta en dataset på Hubben som passar din uppgift (t.ex. att följa instruktioner, sammanfattning)
- Ladda den med hjälp av databiblioteket
- Se till att data är formaterade som instruktions-svar-par
- Konfigurera ditt träningsskript med hyperparametrar som inlärningshastighet och batchstorlek
- Starta träningsjobbet och se till att spara kontrollpunkter med jämna mellanrum
- Utvärdera den finjusterade modellen på en separat valideringsuppsättning för att mäta förbättringen
2. Finjustera DBRX med lokala datamängder
Du får oftast bäst resultat genom att finjustera med dina egna data. På så sätt kan du lära modellen ditt företags specifika terminologi, stil och domänkunskap. Tänk bara på att det bara lönar sig om dina data är rena och väl förberedda, och om de finns i tillräcklig mängd.
Följ dessa steg för att förbereda dina interna data:
- Datainsamling: Samla in högkvalitativa exempel från dina interna wikisidor, dokument och databaser
- Formatkonvertering: Strukturera dina data i ett enhetligt instruktions-svar-format, ofta som JSON-rader
- Kvalitetsfiltrering: Ta bort exempel av låg kvalitet, dubbletter eller irrelevanta exempel
- Valideringsuppdelning: Avsätt en liten del av dina data (vanligtvis 10–15 %) för att utvärdera modellens prestanda
- Sekretessgranskning: Ta bort eller maskera all personligt identifierbar information (PII) eller känsliga uppgifter
3. Finjustera DBRX med StreamingDataset
Om din dataset visar sig vara för stor för att rymmas i datorns minne är det inget problem – du kan använda Databricks Streaming Dataset-bibliotek. Det gör att du kan strömma data direkt från molnlagringen medan modellen tränas, istället för att ladda in allt i minnet på en gång.
Så här gör du:
- Datförberedelse: Rensa och strukturera dina träningsdata och spara dem sedan i ett strömningsbart format som JSONL eller CSV i molnlagring
- Konvertering till strömningsformat: Konvertera din dataset till ett strömningsvänligt format, till exempel Mosaic Data Shard (MDS), så att den kan läsas effektivt under träningen
- Inställning av träningsladdaren: Konfigurera din träningsladdare så att den pekar på det fjärranslutna datasetet och definiera en lokal cache för tillfällig datalagring
- Modellinitialisering: Starta DBRX-finjusteringsprocessen med hjälp av ett träningsramverk som stöder StreamingDataset, till exempel LLM Foundry
- Strömningsbaserad träning: Kör träningsjobbet medan data strömmas in i omgångar under träningen, istället för att laddas in helt i minnet
- Kontrollpunkter och återställning: Återuppta träningen smidigt om en körning avbryts, utan att data dupliceras eller hoppas över
- Utvärdering och driftsättning: Validera den finjusterade modellens prestanda och driftsätt den med hjälp av din föredragna server- eller inferenskonfiguration
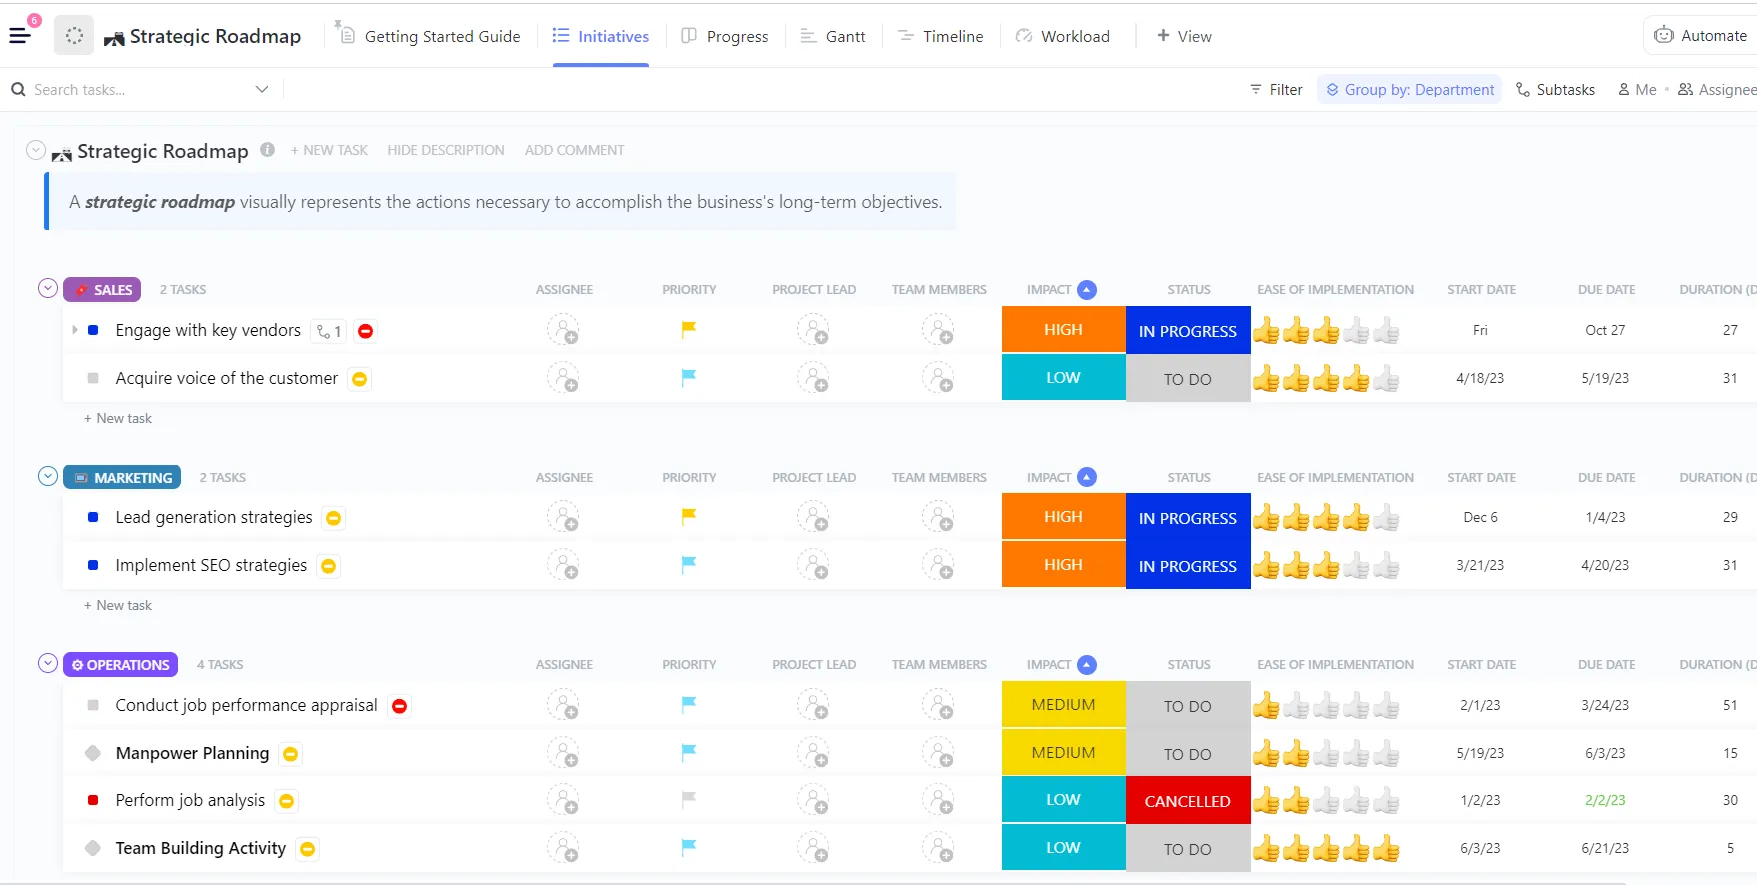
💡Proffstips: Istället för att bygga upp en DBRX-träningsplan från grunden kan du börja med ClickUps mall för AI- och maskininlärningsprojekt och anpassa den efter ditt teams behov. Den ger en tydlig struktur för planering av datamängder, träningsfaser, utvärdering och driftsättning, så att du kan fokusera på att organisera ditt arbete istället för att strukturera ett arbetsflöde.
Användningsfall för DBRX vid träning av AI-modeller
Det är en sak att ha en kraftfull modell, men det är en helt annan sak att veta exakt var den verkligen kommer till sin rätt.
När du inte har en tydlig bild av en modells styrkor är det lätt att lägga tid och resurser på att försöka få den att fungera där den helt enkelt inte passar in. Detta leder till undermåliga resultat och frustration.
DBRX:s unika arkitektur och träningsdata gör det särskilt väl lämpat för flera viktiga användningsfall inom företagsvärlden. Att känna till dessa styrkor hjälper dig att anpassa modellen efter dina affärsmål och maximera avkastningen på din investering.
Textgenerering och innehållsskapande
DBRX Instruct är finjusterat för att följa instruktioner och generera text av hög kvalitet. Detta gör det till ett kraftfullt verktyg för att automatisera ett brett spektrum av innehållsrelaterade uppgifter. Dess stora kontextfönster är en betydande fördel, vilket gör att det kan hantera långa dokument utan att tappa tråden.
Du kan använda det till:
- Teknisk dokumentation: Skapa och förfina produktmanualer, API-referenser och användarhandböcker
- Marknadsföringsinnehåll: Utkast till blogginlägg, nyhetsbrev via e-post och uppdateringar på sociala medier
- Rapportgenerering: Sammanfatta komplexa datafynd och skapa koncisa sammanfattningar för ledningen
- Översättning och lokalisering: Anpassa befintligt innehåll för nya marknader och målgrupper
Kodgenerering och felsökning
En betydande del av DBRX:s träningsdata bestod av kod, vilket gör det till ett kraftfullt LLM-verktyg för utvecklare. Det kan bidra till att påskynda utvecklingscyklerna genom att automatisera repetitiva kodningsuppgifter och hjälpa till med komplex problemlösning.
Här är några exempel på hur ditt teknikteam kan dra nytta av det:
- Kodkomplettering: Generera automatiskt funktionskroppar från kommentarer eller docstrings
- Feldetektering: Analysera kodsnuttar för att identifiera potentiella fel eller logiska brister
- Förklaring av koden: Översätt komplexa algoritmer eller äldre kod till lättförståelig engelska
- Testgenerering: Skapa enhetstester baserade på en funktions signatur och förväntat beteende
RAG och applikationer med lång kontext
Retrieval-Augmented Generation (RAG) är en kraftfull teknik som baserar modellens svar på ditt företags privata data. RAG-system har dock ofta svårt med modeller som har små kontextfönster, vilket tvingar fram aggressiv uppdelning av data som kan leda till att viktig kontext går förlorad. DBRX:s kontextfönster på 32K gör det till en utmärkt grund för robusta RAG-applikationer.
Detta gör att du kan bygga kraftfulla interna verktyg, till exempel:
- Företagssökning: Skapa en chattbot som besvarar medarbetarnas frågor med hjälp av er interna kunskapsbas
- Kundsupport: Skapa en agent som genererar supportsvar baserade på din produktdokumentation
- Forskningsstöd: Utveckla ett verktyg som kan sammanställa information från hundratals sidor med forskningsartiklar
- Kontroll av efterlevnad: Kontrollera automatiskt marknadsföringstexter mot interna varumärkesriktlinjer eller lagstadgade dokument
Så här integrerar du DBRX-träning i ditt teams arbetsflöde
Ett framgångsrikt projekt för träning av AI-modeller handlar om mer än bara kod och datorkraft. Det är ett samarbete mellan ML-ingenjörer, dataforskare, produktchefer och intressenter.
När detta samarbete är utspritt över Jupyter-anteckningsböcker, Slack-kanaler och separata projektledningsverktyg skapas kontextutbredning – en situation där viktig projektinformation är utspridd över alltför många verktyg.
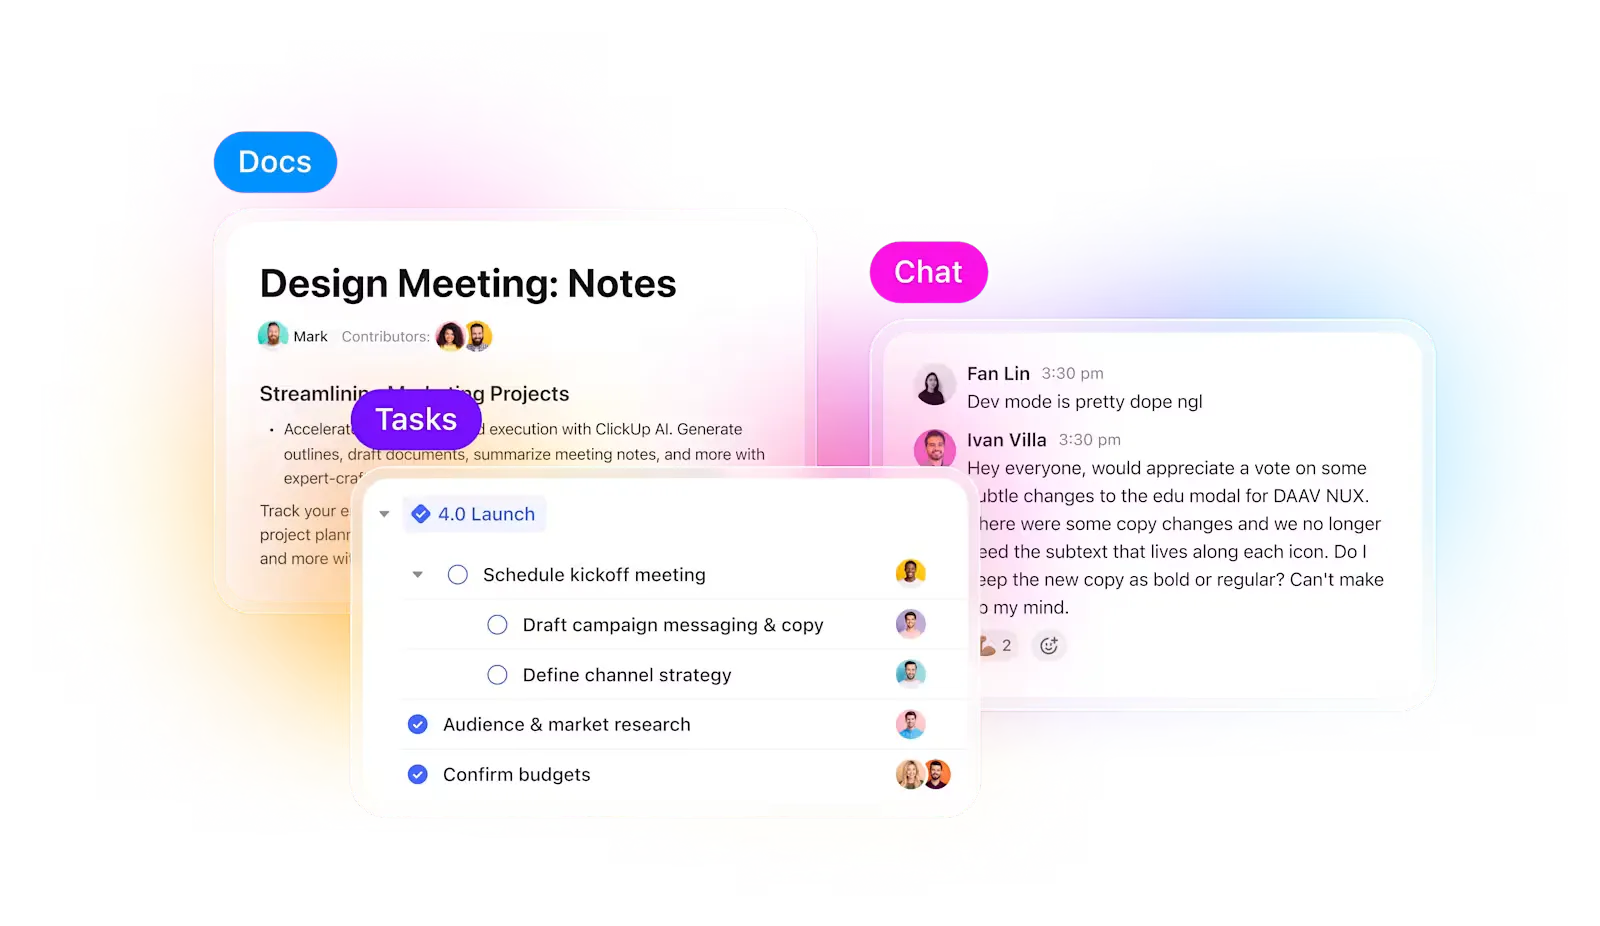
ClickUp löser det. Istället för att jonglera med flera verktyg får du ett samlat AI-arbetsutrymme där projektledning, dokumentation och kommunikation samsas – så att dina experiment hänger ihop från planering till genomförande och utvärdering.
Tappa aldrig bort experiment och framsteg
När man kör flera experiment är det svåraste inte att träna modellen, utan att hålla reda på vad som förändrats under processen. Vilken version av datasetet användes, vilken inlärningshastighet fungerade bäst eller vilken körning levererades?
ClickUp gör den här processen superenkel för dig. Du kan spåra varje träningsomgång separat i ClickUp-uppgifter, och inom uppgifterna kan du använda anpassade fält för att logga:
- Datamängdsversion
- Hyperparametrar
- Modellvariant (DBRX Base vs DBRX Instruct)
- Träningsstatus (I kö, Pågår, Utvärderas, Distribuerad)
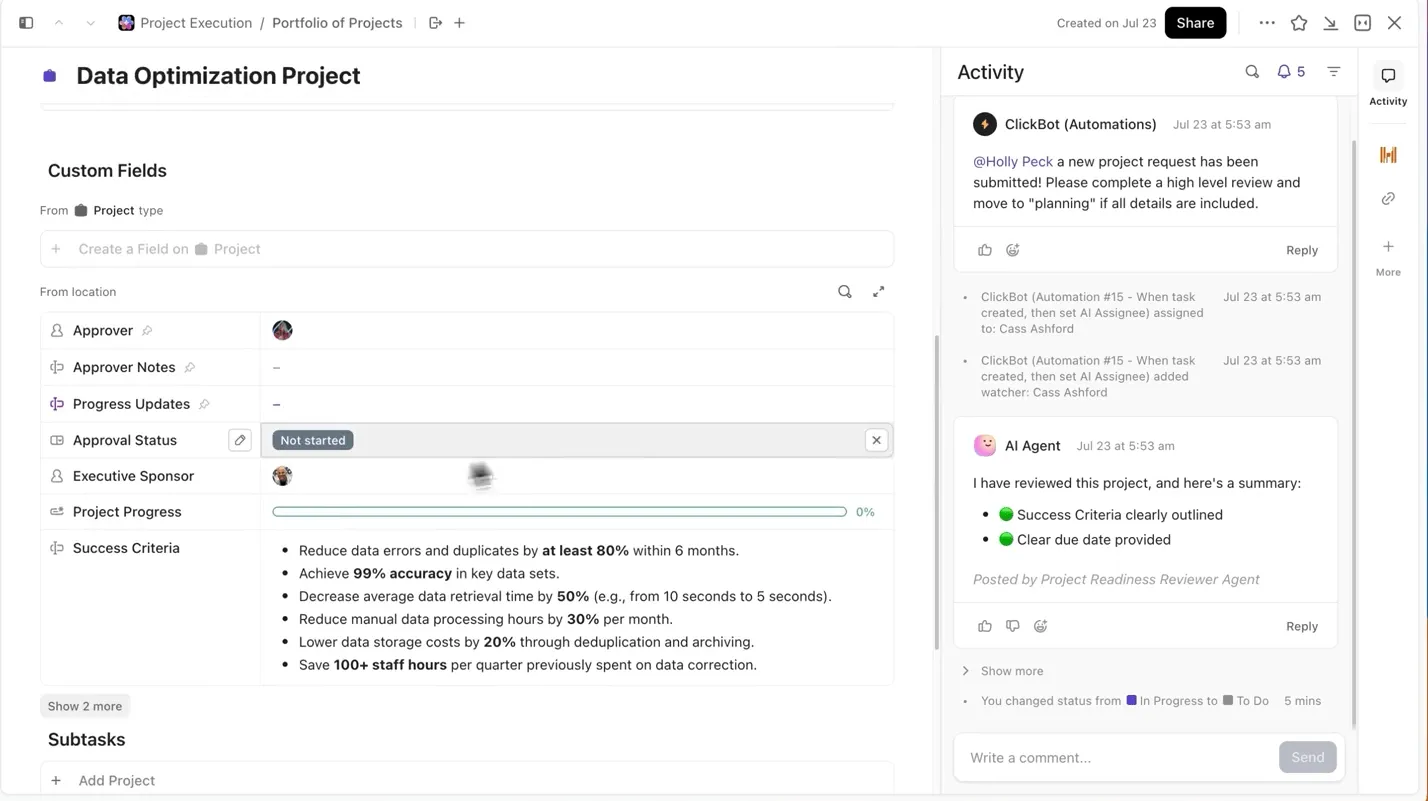
På så sätt blir varje dokumenterat experiment sökbart, lätt att jämföra med andra och reproducerbart.
Håll modelldokumentationen kopplad till arbetet
Du behöver inte hoppa mellan Jupyter-anteckningsböcker, README-filer eller Slack-trådar för att förstå sammanhanget för en uppgift i ett experiment.
Med ClickUp Docs kan du hålla ordning på din modellarkitektur, dina skript för datapreparering och dina utvärderingsmått samt göra dem lättillgängliga genom att dokumentera dem i ett sökbart dokument som länkar direkt till de experimentuppgifter de härrör från.
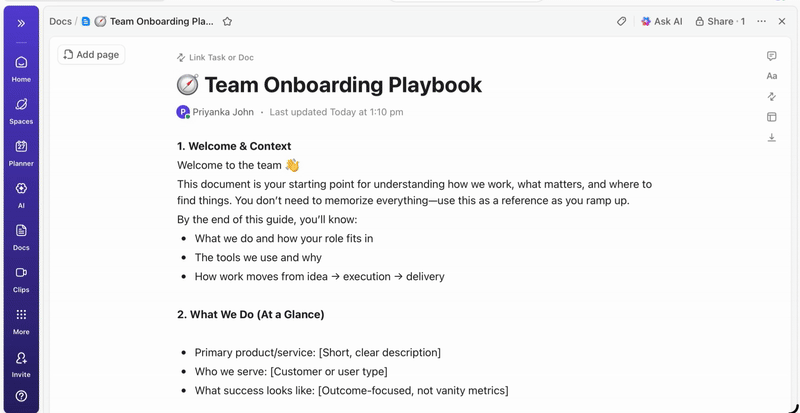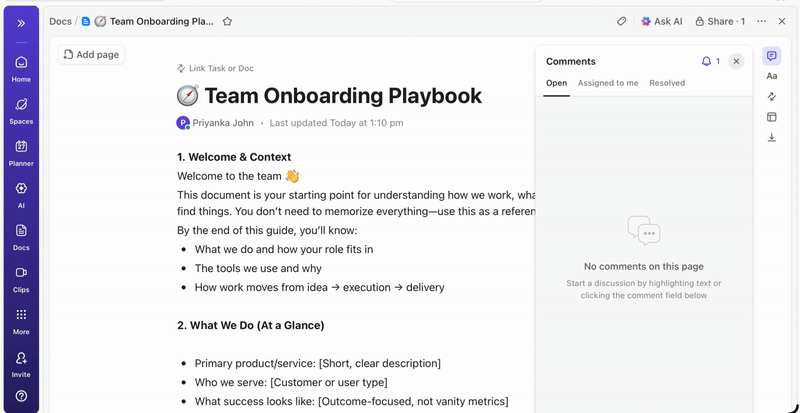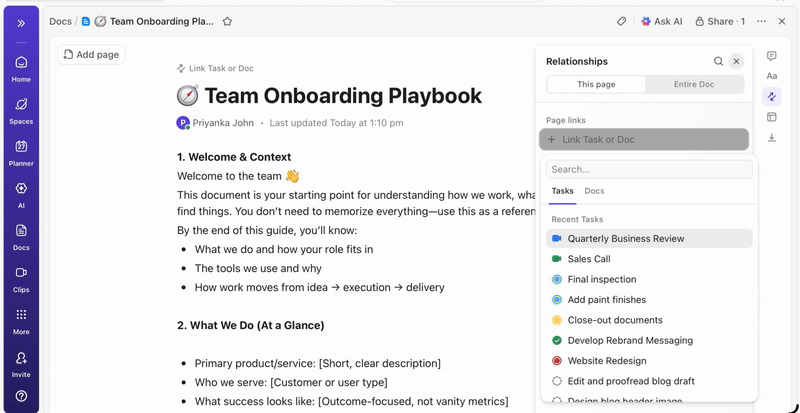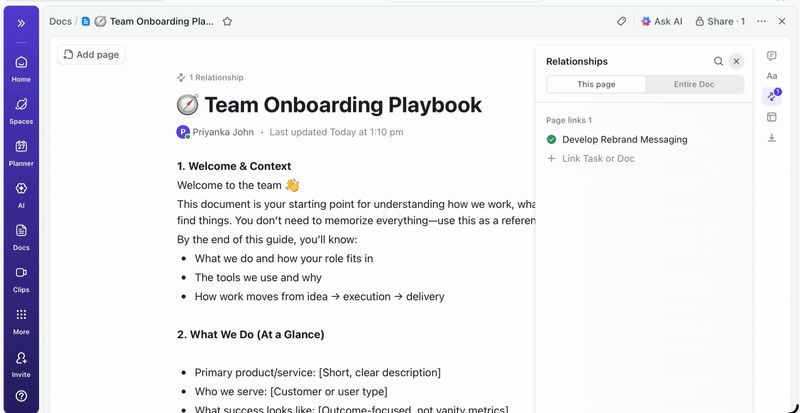
💡Proffstips: Håll en uppdaterad projektbeskrivning i ClickUp Docs som redogör för varje beslut, från arkitektur till driftsättning, så att nya teammedlemmar alltid kan sätta sig in i projektdetaljerna utan att behöva leta igenom gamla trådar
Ge intressenterna insyn i realtid
ClickUp-dashboards visar experimentens framsteg och teamets arbetsbelastning i realtid. I
Istället för att manuellt sammanställa uppdateringar eller skicka e-postmeddelanden uppdateras instrumentpanelerna automatiskt utifrån data i dina uppgifter. På så sätt kan intressenterna kolla läget när som helst, se hur det går och slipper störa dig med frågor som ”hur ser läget ut?”.
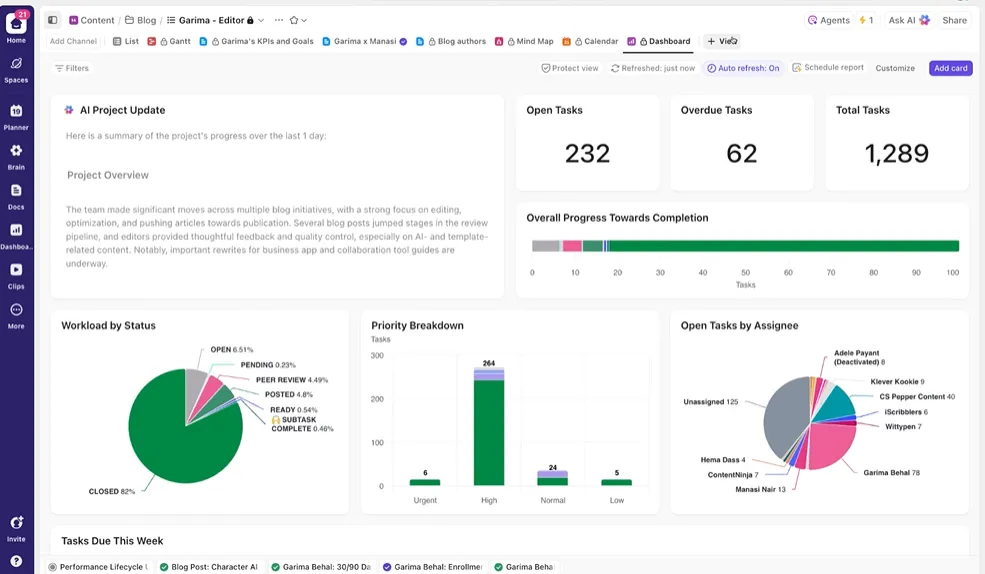
På så sätt kan du fokusera på att genomföra experiment istället för att ständigt behöva rapportera om dem manuellt.
Gör AI till din smarta projektpartner
Du behöver inte manuellt gå igenom veckor av träningsdata för att få en sammanfattning av experimenten hittills. Nämn bara @Brain i en kommentar till en uppgift, så ger ClickUp Brain dig den hjälp du behöver med fullständig kontext för dina tidigare och pågående projekt.
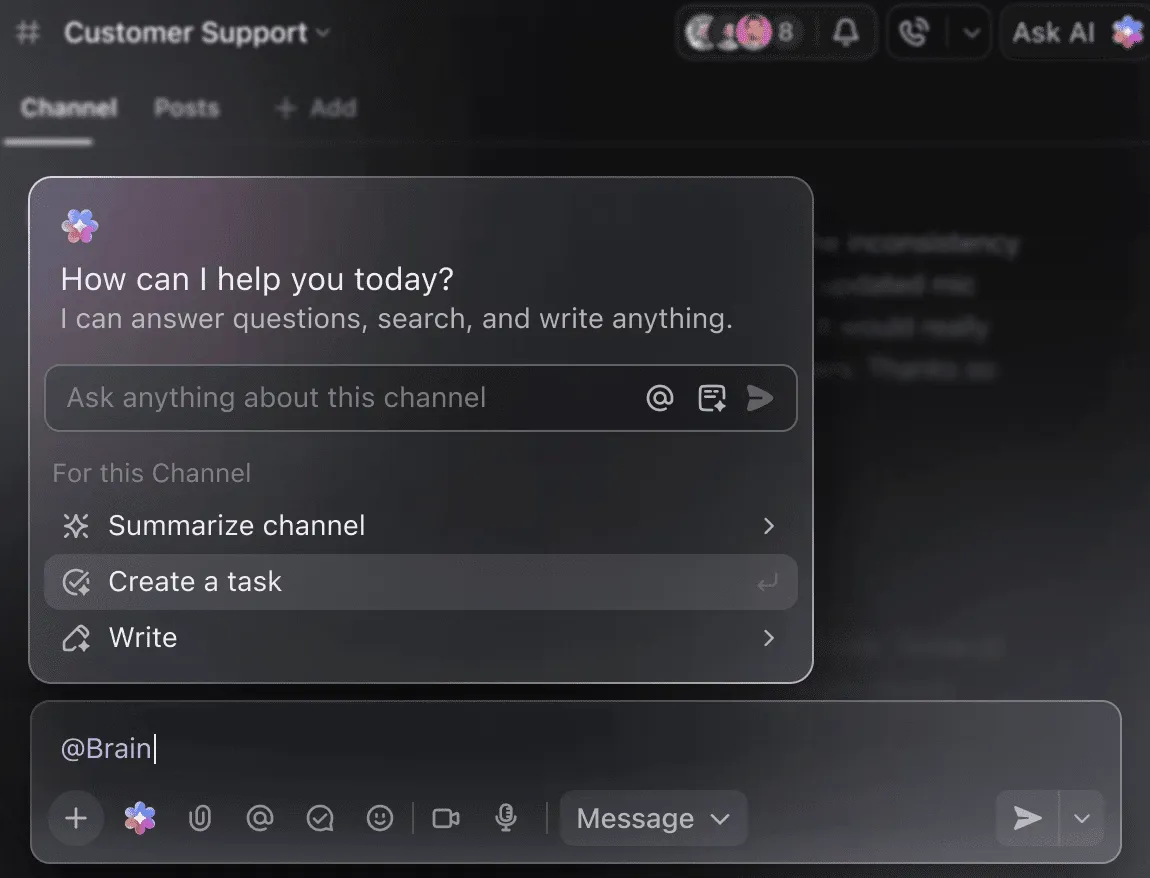
Du kan be Brain att ”sammanfatta förra veckans experiment i fem punkter” eller ”skapa ett utkast till ett dokument med de senaste hyperparameterresultaten” och omedelbart få ett färdigt resultat.
🧠 Fördelen med ClickUp: ClickUps Super Agents tar detta ett steg längre – de kan automatisera hela arbetsflöden baserat på triggare som du definierar, inte bara svara på dina frågor. Med superagenterna kan du automatiskt skapa en ny DBRX-träningsuppgift varje gång en dataset laddas upp, meddela ditt team och länka till relevanta dokument när träningskörningen är klar eller når en kontrollpunkt, samt generera en veckovis sammanfattning av framstegen och skicka den till intressenterna utan att du behöver göra någonting alls.
Vanliga misstag att undvika
Att påbörja ett DBRX-träningsprojekt är spännande, men några vanliga fallgropar kan hindra dina framsteg. Genom att undvika dessa misstag sparar du tid, pengar och en hel del frustration.
- Att underskatta hårdvarukraven: DBRX är kraftfullt, men det är också stort. Att försöka köra det på otillräcklig hårdvara leder till minnesbristfel och misslyckade träningsjobb. Tänk på att DBRX (132B) kräver minst 264 GB VRAM för 16-bitars inferens, eller ungefär 70–80 GB vid användning av 4-bitars kvantisering.
- Att hoppa över datakvalitetskontroller: Skräp in, skräp ut. Finjustering av en rörig datamängd av låg kvalitet kommer bara att lära modellen att producera röriga resultat av låg kvalitet.
- Att ignorera begränsningar för kontextlängd: Även om DBRX:s kontextfönster på 32K är generöst är det inte oändligt. Om du matar in data som överskrider denna gräns kommer modellen att trunka dem utan varning, vilket leder till sämre prestanda
- När är det lämpligt att använda Base istället för Instruct: DBRX Base är en obearbetad, förtränad modell avsedd för vidare, storskalig träning. För de flesta uppgifter som kräver att instruktioner följs bör du börja med DBRX Instruct, som redan har finjusterats för just det ändamålet
- Att separera träningsarbetet från projektkoordineringen: När din experimentuppföljning sker i ett verktyg och din projektplan i ett annat skapar du informationssilor. Använd en integrerad plattform som ClickUp för att hålla ditt tekniska arbete och din projektkoordinering synkroniserade
- Att försumma utvärdering före driftsättning: En modell som presterar bra på dina träningsdata kan misslyckas totalt i verkligheten. Validera alltid din finjusterade modell på en separat testuppsättning innan du driftsätter den i produktion.
- Att bortse från komplexiteten i finjusteringen: Eftersom DBRX är en Mixture-of-Experts-modell kan vanliga finjusteringsskript kräva specialiserade bibliotek som Megatron-LM eller PyTorch FSDP för att hantera parameterspridning över flera GPU:er
DBRX jämfört med andra plattformar för AI-träning
Att välja en plattform för AI-träning innebär en grundläggande avvägning: kontroll kontra bekvämlighet. Proprietära modeller som endast är tillgängliga via API är lätta att använda, men låser in dig i en leverantörs ekosystem.
Modeller med öppna vikter, som DBRX, erbjuder fullständig kontroll men kräver mer teknisk expertis och infrastruktur. Detta val kan göra att du känner dig fast och osäker på vilken väg som faktiskt stöder dina långsiktiga mål – en utmaning som många team står inför när de inför AI.
Den här tabellen visar de viktigaste skillnaderna för att hjälpa dig att fatta ett välgrundat beslut.
| Vikter | Öppna (Anpassad) | Egenutvecklat | Öppna (anpassad) | Egenutvecklat |
| Finjustering | Full kontroll | API-baserat | Full kontroll | API-baserat |
| Egen hosting | Ja | Nej | Ja | Nej |
| Licens | DB Open Model | OpenAI:s villkor | Llama-communityn | Anthropic-termer |
| Sammanhang | 32K | 128 000 – 1 miljon | 128K | 200 000 – 1 miljon |
DBRX är det rätta valet när du behöver full kontroll över modellen, måste driva den själv av säkerhets- eller efterlevnadsskäl, eller vill ha flexibiliteten som en generös kommersiell licens ger. Om du inte har dedikerad GPU-infrastruktur – eller om du värdesätter snabb lansering mer än djupgående anpassning – kan API-baserade alternativ vara ett bättre val.
Börja träna smartare med ClickUp
DBRX ger dig en företagsanpassad grund för att bygga anpassade AI-applikationer, med den transparens och kontroll som du inte får från proprietära modeller. Dess effektiva MoE-arkitektur håller inferenskostnaderna nere, och dess öppna design gör det enkelt att finjustera. Men stark teknik är bara halva ekvationen.
Verklig framgång uppnås genom att anpassa det tekniska arbetet till teamets samarbetsflöde. Träning av AI-modeller är ett lagarbete, och det är avgörande att hålla experiment, dokumentation och kommunikationen med intressenterna synkroniserade. När du samlar allt i ett enda samlat arbetsutrymme och minskar informationsspridningen kan du leverera bättre modeller snabbare.
Kom igång gratis med ClickUp för att samordna dina AI-träningsprojekt i ett enda arbetsutrymme. ✨
Vanliga frågor
Hur övervakar jag träningsförloppet i DBRX?
Du kan övervaka träningen med hjälp av vanliga ML-verktyg som TensorBoard, Weights & Biases eller MLflow. Om du tränar inom Databricks-ekosystemet är MLflow integrerat som standard för smidig spårning av experiment.
Kan jag integrera DBRX med CI/CD och distributionspipelines?
Ja, DBRX kan integreras i vanliga MLOps-pipelines. Genom att containerisera modellen kan du driftsätta den med hjälp av orkestreringsplattformar som Kubeflow eller anpassade CI/CD-arbetsflöden.
Vad är skillnaden mellan DBRX Base och DBRX Instruct?
DBRX Base är den grundläggande, förtränade modellen avsedd för team som vill utföra domänspecifik fortsatt förträning eller djup arkitektonisk finjustering. DBRX Instruct är en finjusterad version som är optimerad för att följa instruktioner, vilket gör den till en bättre utgångspunkt för de flesta typer av applikationsutveckling.
Hur står sig DBRX jämfört med GPT-4 när det gäller AI-projekt för företag?
Den största skillnaden är kontrollen. DBRX ger dig full tillgång till modellvikterna för djupgående anpassning och egen hosting, medan GPT-4 är en tjänst som endast tillhandahålls via API.
Kan man använda DBRX gratis?
DBRX-modellernas vikter är tillgängliga gratis under Databricks Open Model License. Du ansvarar dock själv för kostnaderna för den datainfrastruktur som krävs för att köra eller finjustera modellen.