
A mesterséges intelligencia-képzési projektek ritkán buknak meg a modell szintjén. Akkor kerülnek nehéz helyzetbe, amikor a kísérletek, a dokumentáció és az érdekelt felek számára szánt frissítések túl sok eszköz között vannak szétszórva.
Ez az útmutató végigvezeti Önt a Databricks DBRX – egy olyan nagy nyelvi modell (LLM), amely akár kétszer olyan számítási hatékonyságú, mint más vezető modellek – segítségével történő modellek betanításán, miközben a kapcsolódó feladatokat a ClickUp-ban szervezetten tartja.
A beállítástól és a finomhangolástól a dokumentációig és a csapatok közötti frissítésekig megismerheti, hogyan segít egy egységes, konvergált munkaterület kiküszöbölni a kontextus szétszóródását, és hogyan tartja a csapat figyelmét a fejlesztésen, nem pedig a keresésen. 🛠
Mi az a DBRX?
A DBRX egy hatékony, nyílt forráskódú nagy nyelvi modell (LLM), amelyet kifejezetten vállalati mesterséges intelligencia-modellek edzésére és következtetésre terveztek. Mivel a Databricks Open Model License alapján nyílt forráskódú, csapata teljes hozzáféréssel rendelkezik a modell súlyozásaihoz és architektúrájához, így saját feltételei szerint ellenőrizheti, módosíthatja és üzembe helyezheti azt.
Két változatban érhető el: a DBRX Base a mély előképzéshez, a DBRX Instruct pedig a rögtön használható, utasításokat követő feladatokhoz.
A DBRX architektúrája és a „mixture-of-experts” tervezési módszer
A DBRX a Mixture-of-Experts (MoE) architektúrát használja a feladatok megoldásához. A hagyományos nagy nyelvi modellektől eltérően, amelyek minden egyes számításhoz a több milliárd paraméterük mindegyikét felhasználják, a DBRX egy adott feladat megoldásához a teljes paramétertömegnek csak egy részét (a legrelevánsabb szakértőket) aktiválja.
Képzelje el úgy, mintha egy szakértői csapatról lenne szó: ahelyett, hogy mindenki minden problémán dolgozna, a rendszer intelligensen irányítja az egyes feladatokat a legmegfelelőbb paraméterekkel rendelkező szakértőkhöz.
Ez nemcsak a válaszidőt rövidíti le, hanem csúcsminőségű teljesítményt és eredményeket is biztosít, miközben jelentősen csökkenti a számítási költségeket.
Íme egy rövid áttekintés a legfontosabb műszaki adatokról:
- Összes paraméter: 132 milliárd az összes szakértő esetében
- Aktív paraméterek: 36 milliárd az előremeneti lépésenként
- Szakértők száma: összesen 16 (MoE Top-4 routing), amelyek közül bármely adott token esetében 4 aktív
- Kontextusablak: 32 000 token
A DBRX edzési adatai és token-specifikációi
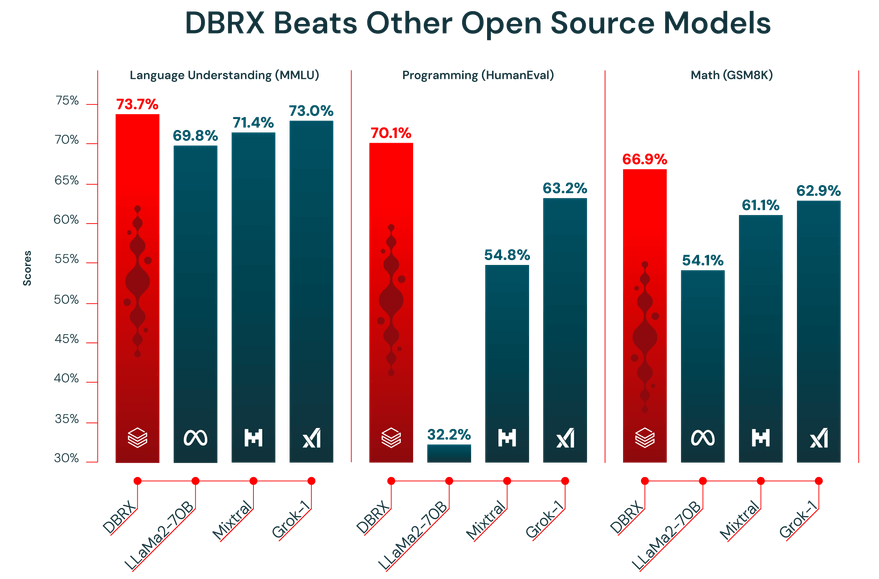
Egy nagy nyelvi modell (LLM) teljesítménye csak annyira lehet jó, amennyire azok az adatok, amelyekkel betanították. A DBRX-et egy hatalmas, 12 billió tokenből álló adatkészleten előre betanították, amelyet a Databricks csapata gondosan válogatott össze fejlett adatfeldolgozó eszközeik segítségével. Pontosan ez az oka annak, hogy az iparági teljesítménytesztek során kiemelkedő eredményeket ért el.
Ezen felül a DBRX 32 000 tokenes kontextusablakkal rendelkezik. Ez az a szövegmennyiség, amelyet a modell egyszerre képes figyelembe venni. A nagy kontextusablak rendkívül hasznos olyan összetett feladatoknál, mint a hosszú jelentések összefoglalása, a terjedelmes jogi dokumentumok áttekintése vagy a fejlett, visszakereséssel kiegészített generálás (RAG) rendszerek építése, mivel lehetővé teszi a modell számára, hogy megőrizze a kontextust anélkül, hogy az információkat csonkítaná vagy elfelejtené.
🎥 Nézze meg ezt a videót, és lássa el, hogyan alakíthatja át a hatékonyabb projektkoordináció az AI-edzési munkafolyamatát, és hogyan szüntetheti meg az egymástól független eszközök közötti váltás okozta nehézségeket. 👇🏽
A DBRX elérésének és beállításának módja
A DBRX két fő hozzáférési módot kínál, amelyek mindegyike teljes hozzáférést biztosít a modell súlyozásaihoz kedvező kereskedelmi feltételek mellett. A maximális rugalmasság érdekében használhatja a Hugging Face-t, vagy a még integráltabb élmény érdekében közvetlenül a Databricksen keresztül érheti el a szolgáltatást.
Érje el a DBRX-et a Hugging Face-en keresztül
Azok számára, akik nagyra értékelik a rugalmasságot, és már jól ismerik a Hugging Face ökoszisztémát, a Hubon keresztül történő DBRX-hozzáférés az ideális megoldás. Ez lehetővé teszi a modell integrálását a meglévő, Transformer-alapú munkafolyamatokba.
Így kezdheted el:
- Hozzon létre egy Hugging Face-fiókot, vagy jelentkezzen be a meglévő fiókjába
- Keresse meg a DBRX modellkártyát a Hubon, és fogadja el a licencfeltételeket
- Telepítse a transformers könyvtárat a szükséges függőségekkel együtt, például az accelerate-tel
- Használja az AutoModelForCausalLM osztályt a Python szkriptjében a DBRX-modell betöltéséhez
- Állítsa be a következtetés-feldolgozási folyamatot, figyelembe véve, hogy a DBRX hatékony működéséhez jelentős mennyiségű GPU-memória (VRAM) szükséges.
📖 További információk: Hogyan állítsuk be az LLM hőmérsékletét?
Hozzáférés a DBRX-hez a Databricksen keresztül
Ha a csapata már használja a Databricks-et adattechnikai feladatokhoz vagy gépi tanuláshoz, a legegyszerűbb megoldás a DBRX-hez való hozzáférés a platformon keresztül. Ezzel elkerülhetőek a beállítási nehézségek, és az MLOps-hoz szükséges összes eszköz közvetlenül ott áll rendelkezésre, ahol máris dolgozik.
Kövesse az alábbi lépéseket a Databricks munkaterületén a kezdéshez:
- Lépjen a Model Garden vagy a Mosaic AI szakaszra
- Válassza ki az igényeinek megfelelően a DBRX Base vagy a DBRX Instruct verziót
- Konfiguráljon egy kiszolgáló végpontot az API-hozzáféréshez, vagy állítson be egy notebook-környezetet interaktív használatra
- Kezdje el tesztelni a következtetést mintapromptokkal, hogy megbizonyosodjon arról, minden megfelelően működik-e, mielőtt kiterjesztené az AI-modell betanítását vagy bevezetését.
Ez a megközelítés zökkenőmentes hozzáférést biztosít olyan eszközökhöz, mint az MLflow a kísérletek nyomon követéséhez és a Unity Catalog a modellek irányításához.
📮 ClickUp Insight: Az átlagos szakember naponta több mint 30 percet tölt munkával kapcsolatos információk keresésével – ez évente több mint 120 óra, amelyet e-mailek, Slack-beszélgetések és szétszórt fájlok átkutatásával veszteget el.
Ezt megváltoztathatja egy, a munkaterületébe beépített intelligens AI-asszisztens. Ismerje meg a ClickUp Brain-t!
A megfelelő dokumentumok, beszélgetések és feladatrészletek másodpercek alatt történő megjelenítésével azonnali betekintést és válaszokat nyújt – így nem kell tovább keresgélnie, hanem rögtön munkához láthat.
A DBRX finomhangolása és egyedi AI-modellek betanítása
Egy kész modell, bármilyen hatékony is legyen, soha nem fogja megérteni vállalkozása egyedi sajátosságait. Mivel a DBRX nyílt forráskódú, finomhangolhatja, hogy olyan egyedi modellt hozzon létre, amely a vállalat nyelvét beszéli, vagy elvégzi azt a konkrét feladatot, amit Ön szeretne, hogy elvégezzen.
Íme három gyakori módszer, amellyel ezt megteheti:
1. A DBRX finomhangolása a Hugging Face adatkészleteivel
Azoknak a csapatoknak, amelyek még csak most kezdik a munkát, vagy általános feladatokon dolgoznak, a Hugging Face Hub nyilvános adatkészletei kiváló forrásként szolgálnak. Ezek előre formázottak és könnyen betölthetők, így nem kell órákat töltenie az adatok előkészítésével.
A folyamat meglehetősen egyszerű:
- Keressen a Hubon egy olyan adatkészletet, amely megfelel a feladatának (pl. utasítások követése, összefoglalás)
- Töltse be az adatkészlet-könyvtár segítségével
- Győződjön meg arról, hogy az adatok utasítás-válasz párokká vannak formázva
- Konfigurálja a betanítási szkriptjét olyan hiperparaméterekkel, mint a tanulási sebesség és a kötegméret
- Indítsa el a betanítási feladatot, és ügyeljen arra, hogy rendszeresen mentse az ellenőrzőpontokat
- Értékelje a finomhangolt modellt egy elkülönített validációs halmazon, hogy megmérje a javulást
2. A DBRX finomhangolása helyi adatkészletekkel
Általában a saját, egyedi adataival végzett finomhangolással érheti el a legjobb eredményeket. Ez lehetővé teszi, hogy a modellt megtanítsa vállalata sajátos terminológiájára, stílusára és szakterületi ismereteire. Ne feledje azonban, hogy ez csak akkor kifizetődő, ha adatai tiszták, jól előkészítettek és elegendő mennyiségűek.
Kövesse az alábbi lépéseket a belső adatok előkészítéséhez:
- Adatgyűjtés: Gyűjtsön kiváló minőségű példákat a belső wikikből, dokumentumokból és adatbázisokból
- Formátumkonverzió: Szervezze adatait egységes utasítás-válasz formátumba, gyakran JSON-sorokként
- Minőségi szűrés: Távolítson el minden alacsony minőségű, duplikált vagy irreleváns példát
- Validációs felosztás: Tegyen félre az adatok egy kis részét (általában 10–15%-át) a modell teljesítményének értékeléséhez.
- Adatvédelmi ellenőrzés: Távolítson el vagy fedje el minden személyazonosításra alkalmas információt (PII) vagy érzékeny adatot
3. A DBRX finomhangolása a StreamingDataset segítségével
Ha az adatkészlet végül túl nagy lesz ahhoz, hogy beférjen a gép memóriájába, ne aggódjon: használhatja a Databricks Streaming Dataset könyvtárát. Ez lehetővé teszi, hogy a modell edzése közben az adatokat közvetlenül a felhőalapú tárolóból streamelje, ahelyett, hogy egyszerre töltené be az egészet a memóriába.
Így teheti meg:
- Adatelőkészítés: Tisztítsa meg és strukturálja a képzési adatait, majd tárolja azokat streamelhető formátumban, például JSONL-ben vagy CSV-ben, egy felhőalapú tárolóban.
- Streaming formátumkonverzió: Konvertálja az adatkészletét streaming-barát formátumba, például Mosaic Data Shard (MDS) formátumba, hogy a képzés során hatékonyan lehessen olvasni.
- A betanítóprogram beállítása: Konfigurálja a betanítóprogramot úgy, hogy a távoli adatkészletre mutasson, és határozzon meg egy helyi gyorsítótárat az ideiglenes adatok tárolásához.
- A modell inicializálása: Indítsa el a DBRX finomhangolási folyamatát egy olyan képzési keretrendszer segítségével, amely támogatja a StreamingDataset-et, például az LLM Foundry-t.
- Streaming-alapú betanítás: Futtassa a betanítási feladatot úgy, hogy az adatok a betanítás során kötegenként kerüljenek beolvasásra, ahelyett, hogy teljes egészükben a memóriába lennének betöltve
- Ellenőrzőpontok és helyreállítás: Folytassa zökkenőmentesen a képzést, ha egy futtatás megszakad, anélkül, hogy az adatok duplikálódnának vagy kihagynák őket
- Értékelés és bevezetés: Ellenőrizze a finomhangolt modell teljesítményét, majd vezesse be azt a kívánt kiszolgálási vagy következtetés-kivonási beállítások segítségével
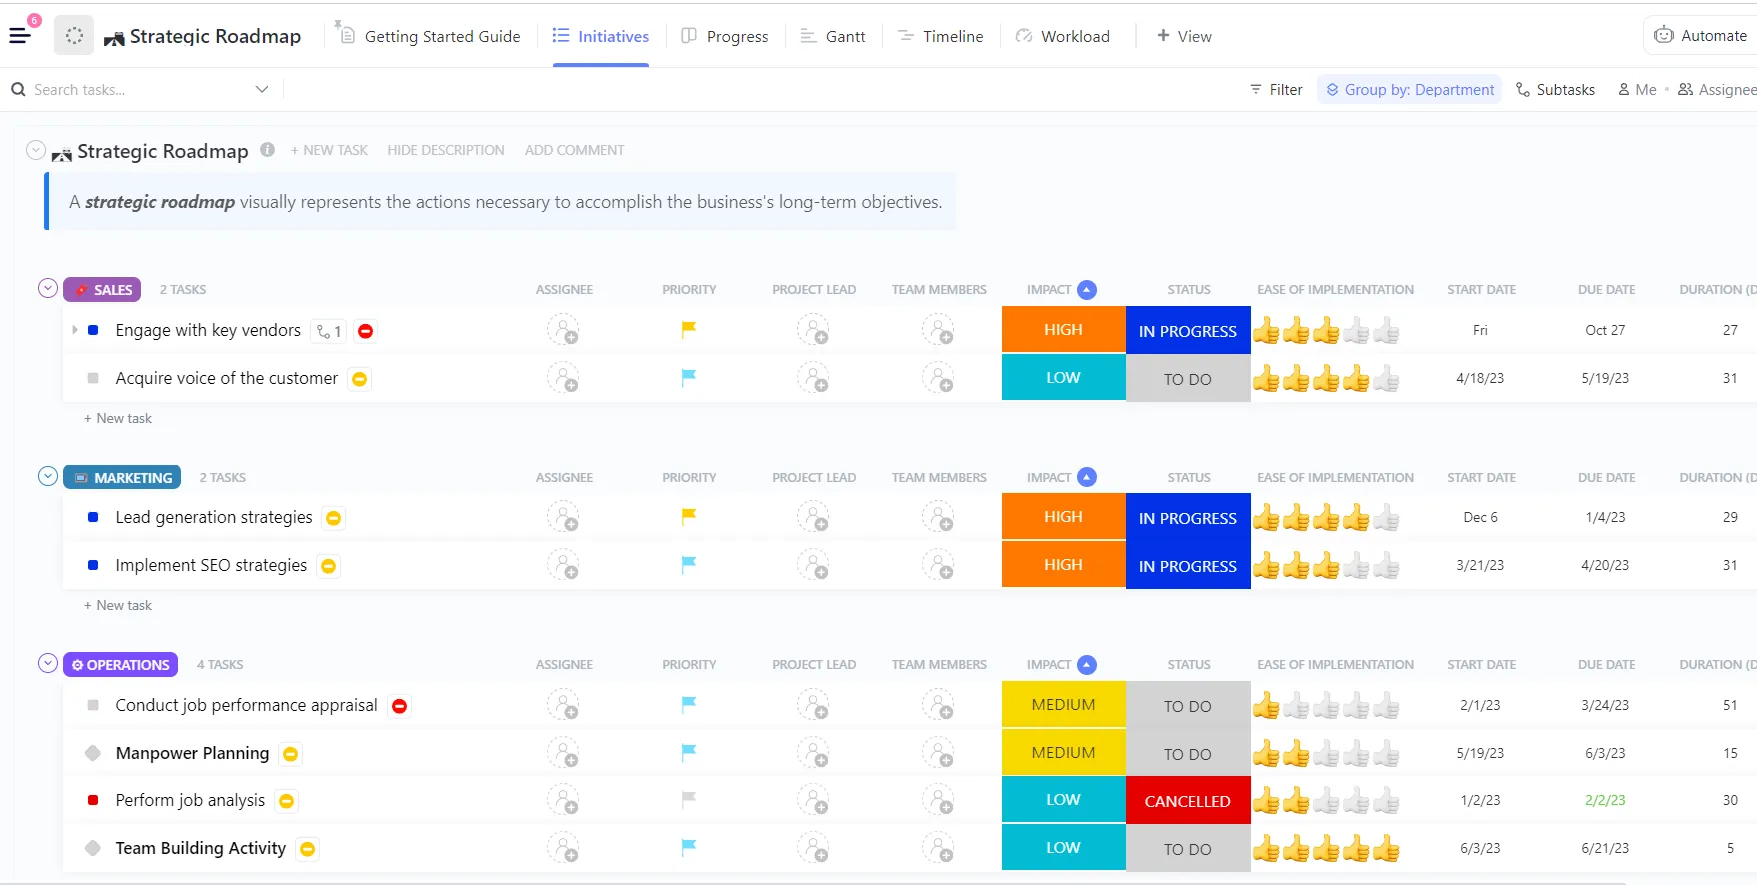
💡Profi tipp: Ahelyett, hogy a DBRX-es képzési tervet a semmiből építené fel, kezdje a ClickUp AI és gépi tanulás projektek ütemterv-sablonjával, és igazítsa azt a csapata igényeihez. Ez egy világos szerkezetet biztosít az adatkészletek, a képzési fázisok, az értékelés és a bevezetés tervezéséhez, így a munkafolyamat felépítése helyett a munkájának szervezésére koncentrálhat.
A DBRX felhasználási esetei a mesterséges intelligencia modellek képzéséhez
Egy dolog, ha van egy hatékony modellünk, de egészen más dolog pontosan tudni, hogy mely területeken nyújt kiemelkedő teljesítményt.
Ha nincs világos képe a modell erősségeiről, könnyen előfordulhat, hogy időt és erőforrásokat pazarol arra, hogy olyan területeken próbálja működőképessé tenni, ahol egyszerűen nem illeszkedik. Ez pedig gyenge eredményekhez és frusztrációhoz vezet.
A DBRX egyedülálló architektúrája és edzési adatai miatt kiválóan alkalmas számos fontos vállalati felhasználási esetre. Ezen erősségek ismerete segít abban, hogy a modellt az üzleti céljaihoz igazítsa, és maximalizálja a befektetés megtérülését.
Szöveggenerálás és tartalomkészítés
A DBRX Instructot úgy hangolták be, hogy pontosan kövesse az utasításokat és kiváló minőségű szöveget állítson elő. Ezzel hatékony eszközzé válik a tartalommal kapcsolatos feladatok széles körének automatizálásához. Jelentős előnye a nagy kontextusablak, amely lehetővé teszi hosszú dokumentumok kezelését anélkül, hogy elveszítené a fonalat.
A következőkre használhatja:
- Műszaki dokumentáció: Készítsen és finomítson termék kézikönyveket, API-referenciákat és felhasználói útmutatókat
- Marketingtartalom: Blogbejegyzések, e-mailes hírlevelek és közösségi média-bejegyzések vázlatai
- Jelentéskészítés: Összegezze a komplex adatelemzések eredményeit, és készítsen tömör vezetői összefoglalókat
- Fordítás és lokalizáció: A meglévő tartalmak új piacokhoz és közönségekhez való igazítása
Kódgenerálás és hibakeresési feladatok
A DBRX edzési adatainak jelentős része kódot tartalmazott, így a rendszer hatékony LLM-támogatást nyújt a fejlesztők számára. Segítségével felgyorsíthatók a fejlesztési ciklusok az ismétlődő kódolási feladatok automatizálásával és a komplex problémamegoldás támogatásával.
Íme néhány módszer, ahogyan a mérnöki csapata kihasználhatja ezeket:
- Kódkiegészítés: Funkciótestek automatikus generálása megjegyzésekből vagy dokumentációs karakterláncokból
- Hibakeresés: Elemezze a kódrészleteket a lehetséges hibák vagy logikai hibák azonosítása érdekében
- Kódmagyarázat: Fordítsa le a bonyolult algoritmusokat vagy a régi kódot közérthető nyelvre
- Tesztgenerálás: Készítsen egységteszteket egy függvény szignatúrája és várható viselkedése alapján
RAG és hosszú kontextusú alkalmazások
A visszakereséssel kiegészített generálás (RAG) egy hatékony technika, amely a modell válaszait a vállalat saját adataira alapozza. A RAG-rendszerek azonban gyakran küszködnek a kis kontextusablakkal rendelkező modellekkel, ami agresszív adatszegmentálást kényszerít ki, amelynek során fontos kontextuselemek veszhetnek el. A DBRX 32K-s kontextusablaka kiváló alapot biztosít a robusztus RAG-alkalmazásokhoz.
Ez lehetővé teszi, hogy hatékony belső eszközöket hozzon létre, például:
- Vállalati keresés: Hozzon létre egy csevegőrobotot, amely a belső tudásbázis segítségével válaszol a munkatársak kérdéseire
- Ügyfélszolgálat: Készítsen olyan ügynököt, amely a termékdokumentáció alapján generál ügyfélszolgálati válaszokat
- Kutatási segítség: Fejlesszen ki egy olyan eszközt, amely képes több száz oldalnyi kutatási cikkből származó információkat összefoglalni
- Megfelelőségi ellenőrzés: A marketing szövegek automatikus ellenőrzése a belső márkairányelvek vagy a szabályozási dokumentumok alapján
Hogyan integrálhatja a DBRX-képzést a csapat munkafolyamatába
Egy sikeres AI-modell-betanítási projekt nem csupán kódolásról és számítási erőforrásokról szól. Ez egy olyan együttműködés, amelyben gépi tanulási mérnökök, adatelemzők, termékmenedzserek és az érdekelt felek egyaránt részt vesznek.
Amikor ez az együttműködés Jupyter-notebookokra, Slack-csatornákra és különálló projektmenedzsment-eszközökre oszlik szét, kontextus-szétszóródás jön létre, vagyis olyan helyzet, amikor a kritikus projektinformációk túl sok eszközre oszlanak szét.
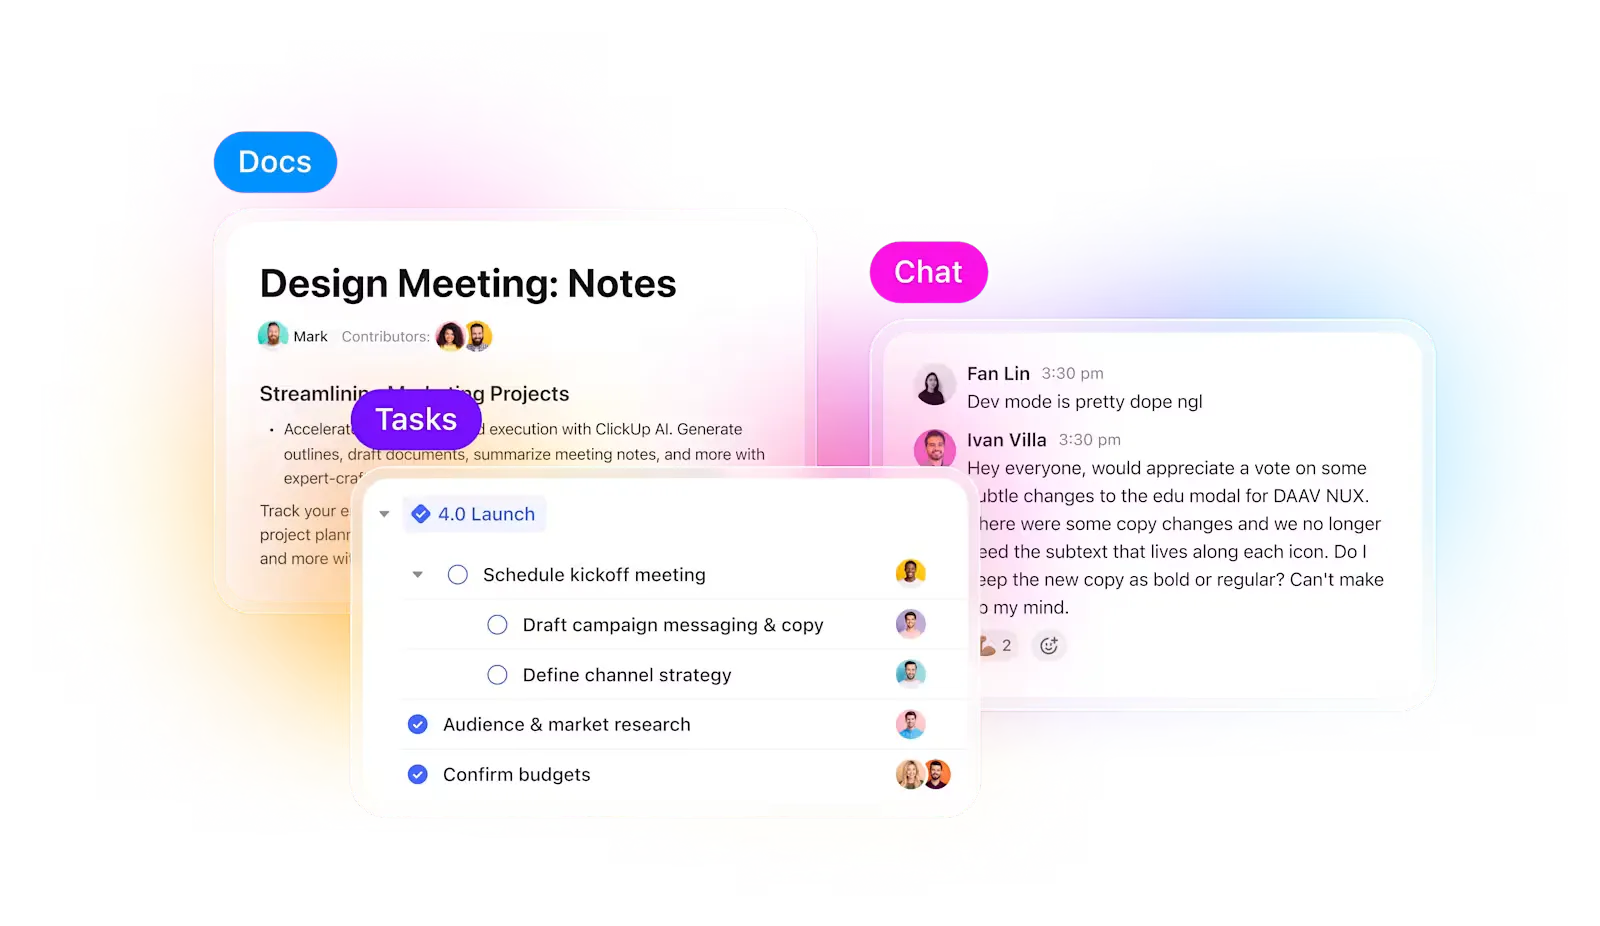
A ClickUp megoldja ezt a problémát. Ahelyett, hogy több eszközzel kellene ügyeskednie, egy olyan integrált AI-munkaterületet kap, ahol a projektmenedzsment, a dokumentáció és a kommunikáció egy helyen található – így kísérletei a tervezéstől a végrehajtáson át az értékelésig összekapcsolódnak.
Soha ne veszítse szem elől a kísérleteket és az előrehaladást
Több kísérlet futtatásakor a legnehezebb feladat nem a modell betanítása, hanem annak nyomon követése, hogy mi változott a folyamat során. Melyik adatkészlet-verziót használták, melyik tanulási sebesség bizonyult a leghatékonyabbnak, vagy melyik futtatás került kiadásra?
A ClickUp rendkívül egyszerűvé teszi ezt a folyamatot az Ön számára. A ClickUp Feladatokbanminden egyes edzési futást külön nyomon követhet, és a feladatokon belül az Egyéni mezők segítségével rögzítheti:
- Adatkészlet verziója
- Hiperparaméterek
- Modellváltozatok (DBRX Base vs. DBRX Instruct)
- Képzési állapot (Sorban, Futás alatt, Értékelés alatt, Telepítve)
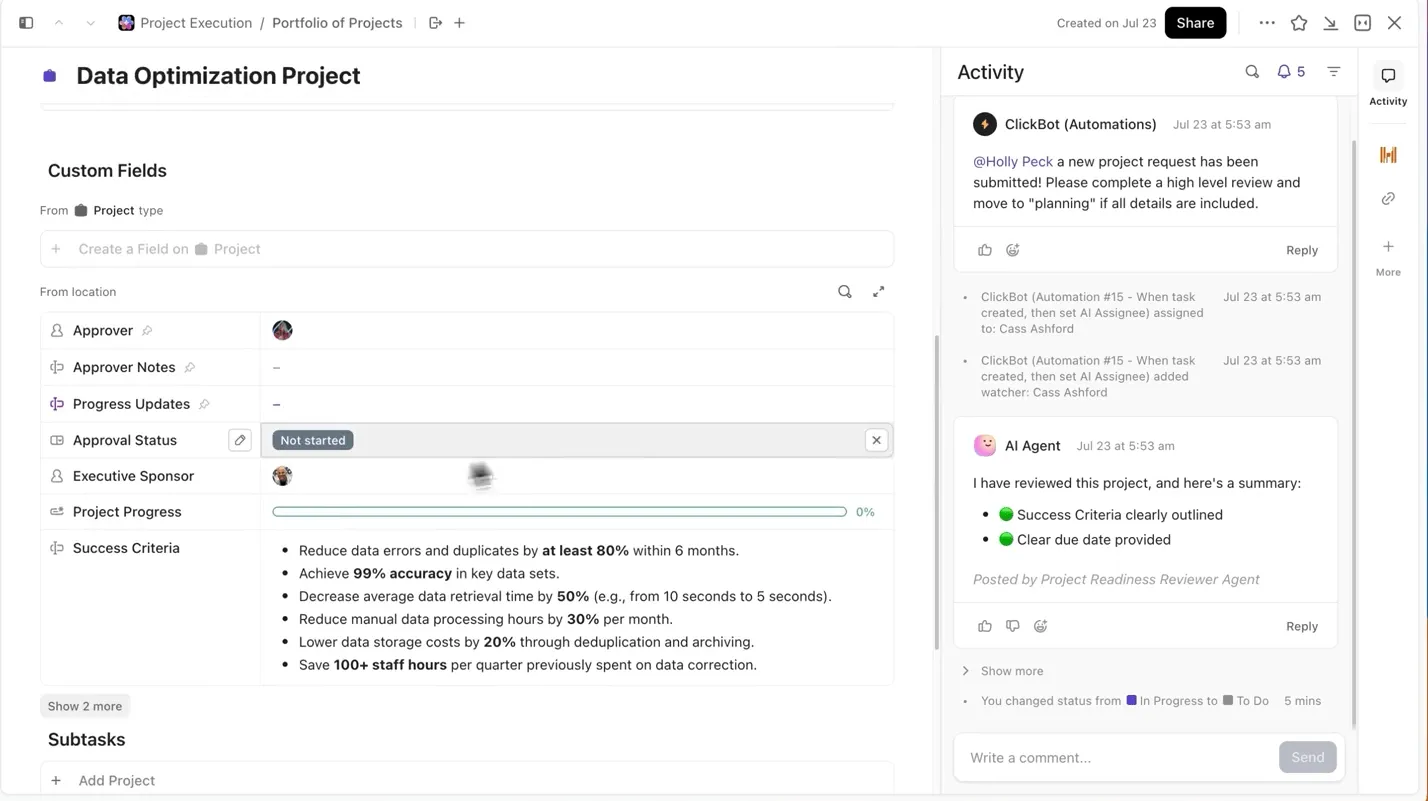
Így minden dokumentált kísérlet kereshető, könnyen összehasonlítható másokkal, és reprodukálható.
Tartsa a modell dokumentációját a munkához kapcsolva
Nem kell a Jupyter-notebookok, a README-fájlok vagy a Slack-szálak között ugrálnia ahhoz, hogy megértse egy kísérlet feladatának összefüggéseit.
A ClickUp Docs segítségével rendszerezheti és hozzáférhetővé teheti a modellarchitektúrát, az adatelőkészítési szkripteket vagy az értékelési mutatókat úgy, hogy azokat egy kereshető dokumentumban rögzíti, amely közvetlenül kapcsolódik azokhoz a kísérleti feladatokhoz, amelyekből származnak.
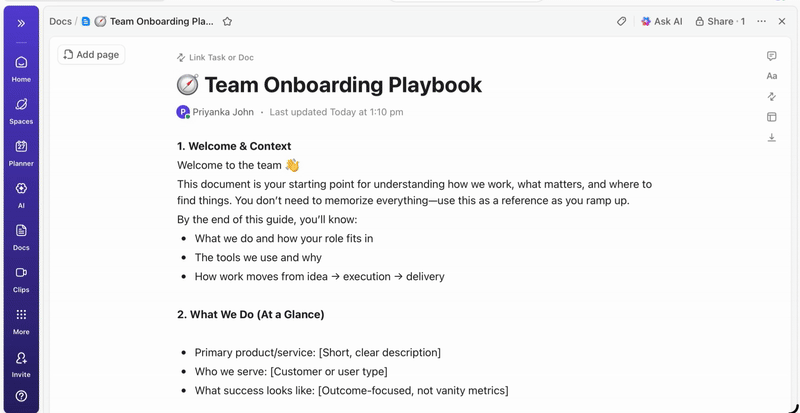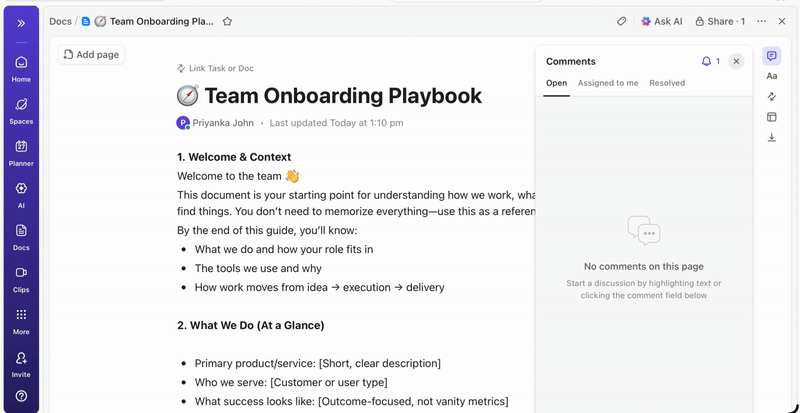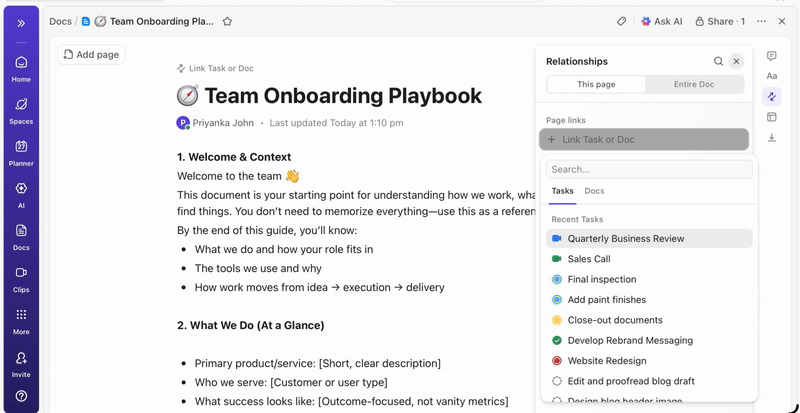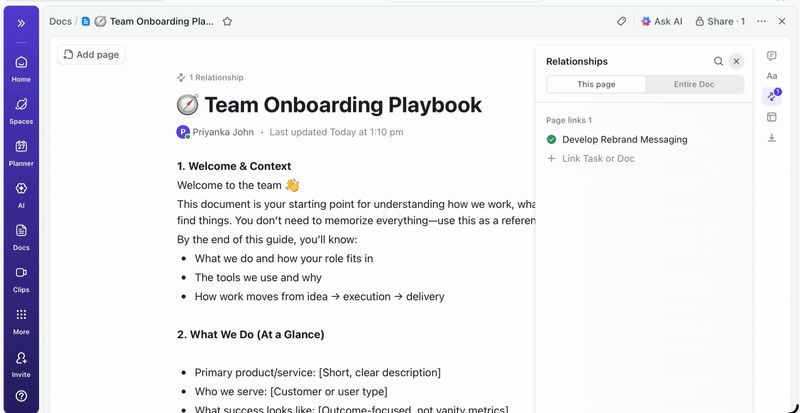
💡Profi tipp: Készítsen egy folyamatosan frissülő projektleírást a ClickUp Docs-ban, amely részletesen bemutatja az összes döntést, az architektúrától a bevezetésig, így az új csapattagok mindig gyorsan áttekinthetik a projekt részleteit anélkül, hogy régi beszélgetéseket kellene átnézniük.
Valós idejű áttekintést biztosítson az érdekelt felek számára
A ClickUp irányítópultjai valós időben mutatják a kísérletek előrehaladását és a csapat munkaterhelését. I
Ahelyett, hogy kézzel állítanád össze a frissítéseket vagy e-maileket küldenének, a műszerfalak automatikusan frissülnek a feladataidban szereplő adatok alapján. Így az érdekelt felek bármikor bejelentkezhetnek, megnézhetik, hol tartanak a dolgok, és soha nem kell megzavarniuk téged azzal a kérdéssel, hogy „mi a helyzet?”.
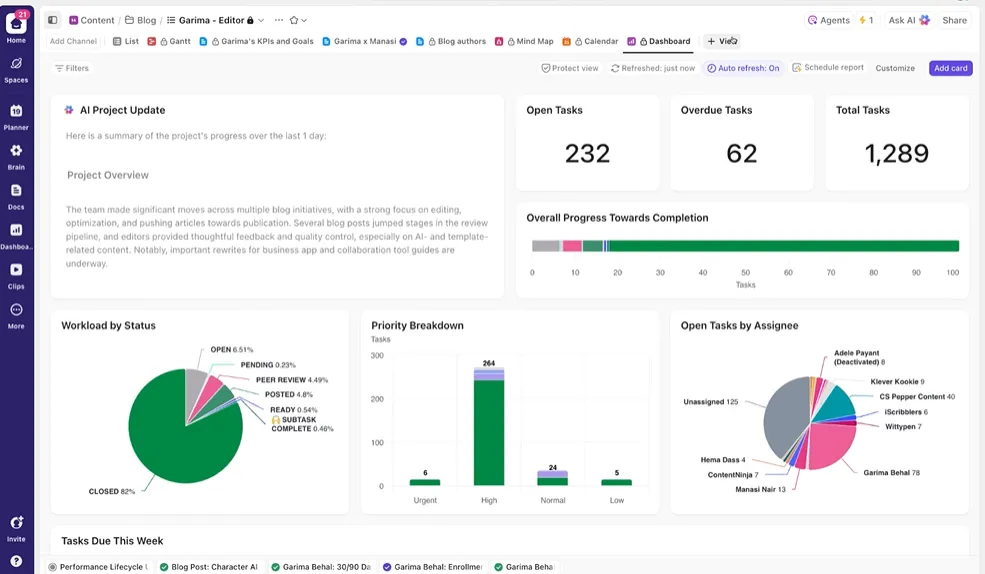
Így a kísérletek végrehajtására koncentrálhat, ahelyett, hogy folyamatosan manuálisan kellene jelentést készítenie róluk.
Tegye az AI-t a projektje intelligens segédjévé
Nem kell kézzel átnéznie heteknyi edzési adatot ahhoz, hogy áttekintést kapjon az eddigi kísérletekről. Csak említsd meg a @Brain-t bármely feladat megjegyzésében, és a ClickUp Brain a szükséges segítséget nyújtja a korábbi és folyamatban lévő projektek teljes kontextusával együtt.
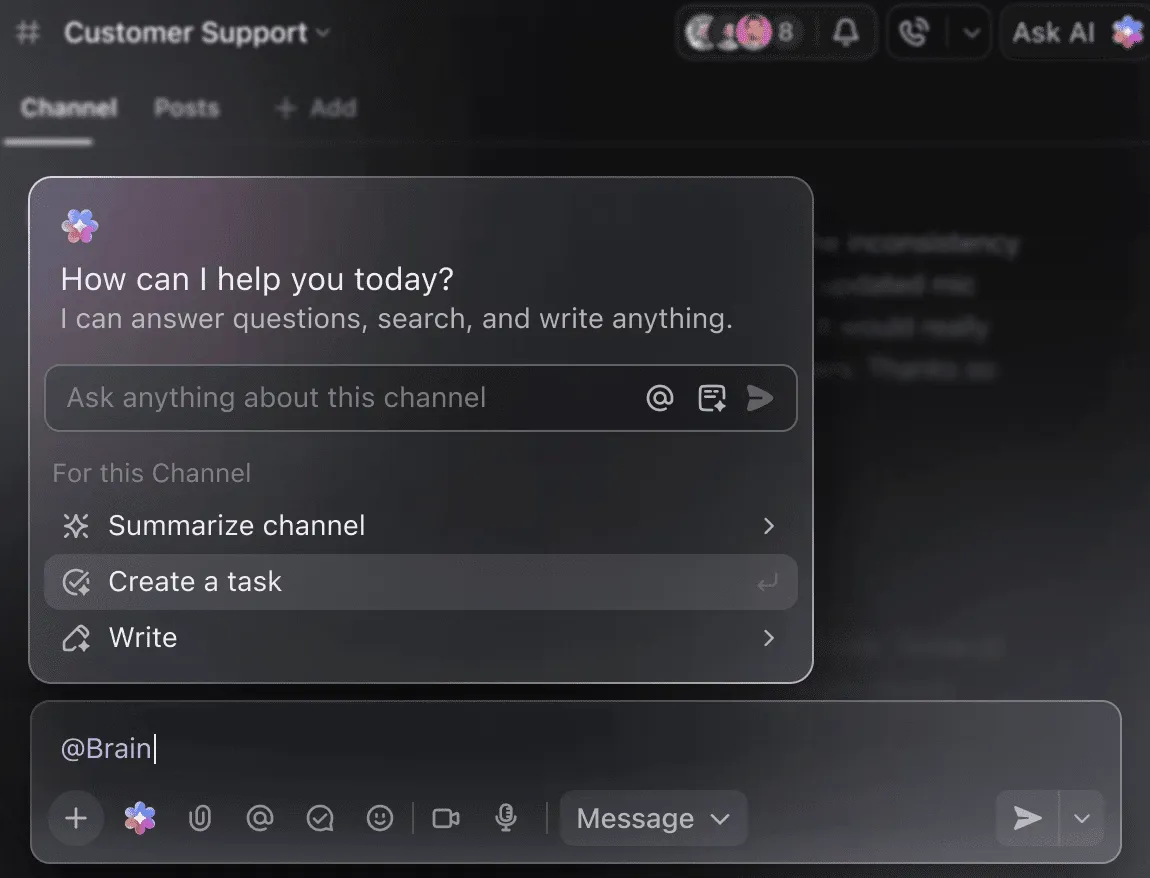
Megkérheted a Brain-t, hogy „Összegezze az elmúlt heti kísérleteket 5 pontban” vagy „Készítsen dokumentumot a legfrissebb hiperparaméter-eredményekről”, és azonnal kaphatsz egy kifogástalan eredményt.
🧠 A ClickUp előnye: A ClickUp szuperügynökei ennél is tovább mennek – az Ön által meghatározott események alapján teljes munkafolyamatokat automatizálhatnak, nem csak a kérdéseire válaszolnak. A szuperügynökök segítségével automatikusan létrehozhat egy új DBRX-edzési feladatot, amikor adatállományt töltenek fel, értesítheti a csapatát, és összekapcsolhatja a releváns dokumentumokat, amikor az edzés befejeződik vagy elér egy ellenőrzőpontot, valamint hetente összefoglalót készíthet az előrehaladásról, és eljuttathatja az érdekelt felekhez anélkül, hogy Önnek bármit is tennie kellene.
Elkerülendő gyakori hibák
A DBRX-es képzési projekt megkezdése izgalmas, de néhány gyakori buktató megakadályozhatja az előrehaladást. Ha elkerüli ezeket a hibákat, időt, pénzt és sok frusztrációt takaríthat meg.
- A hardverigény alábecsülése: A DBRX nagy teljesítményű, de egyben nagy méretű is. Ha nem megfelelő hardveren próbálja futtatni, memóriahiányos hibákhoz és sikertelen edzési feladatokhoz vezet. Ne feledje, hogy a DBRX (132B) legalább 264 GB VRAM-ot igényel 16 bites következtetéshez, vagy körülbelül 70–80 GB-ot 4 bites kvantálás esetén.
- Az adatminőség-ellenőrzés kihagyása: Ha rossz az adat, rossz lesz az eredmény is. Ha egy rendezetlen, alacsony minőségű adatkészleten végez finomhangolást, a modell csak azt fogja megtanulni, hogy rendezetlen, alacsony minőségű eredményeket állítson elő.
- A kontextus hosszának korlátai figyelmen kívül hagyása: Bár a DBRX 32K-s kontextusablaka bőséges, nem végtelen. Ha a modellnek olyan bemeneti adatokat adunk, amelyek túllépik ezt a határt, az csendes csonkításhoz és gyenge teljesítményhez vezet.
- Mikor érdemes a Base-t használni az Instruct helyett: A DBRX Base egy nyers, előre betanított modell, amelyet további, nagyméretű betanításra szántak. A legtöbb utasításkövető feladat esetében érdemes a DBRX Instruct-tal kezdeni, amelyet már erre a célra finomhangoltak.
- A képzési feladatok elszigetelése a projektkoordinációtól: Ha a kísérletek nyomon követése egy eszközben, a projektterv pedig egy másikban történik, akkor információs szigetek jönnek létre. Használjon egy integrált platformot, mint például a ClickUp-ot, hogy a technikai munkát és a projektkoordinációt szinkronban tartsa.
- A bevezetés előtti értékelés elhanyagolása: Egy modell, amely jól teljesít a képzési adatokon, a valós világban látványosan kudarcot vallhat. Mindig ellenőrizze a finomhangolt modellt egy elkülönített tesztkészleten, mielőtt éles környezetbe helyezné.
- A finomhangolás bonyolultságának figyelmen kívül hagyása: Mivel a DBRX egy „Mixture-of-Experts” modell, a szokásos finomhangoló szkriptekhez speciális könyvtárakra, például a Megatron-LM-re vagy a PyTorch FSDP-re lehet szükség a paraméterek több GPU-ra történő elosztásának kezeléséhez.
A DBRX és más AI-edzési platformok összehasonlítása
Az AI-edzési platform kiválasztásakor alapvető kompromisszumot kell kötni: az irányítás és a kényelem között. A zárt, kizárólag API-n keresztül elérhető modellek könnyen használhatók, de a gyártó ökoszisztémájához kötik a felhasználót.
A DBRX-hez hasonló nyílt súlyozású modellek teljes körű ellenőrzést biztosítanak, de több technikai szakértelmet és infrastruktúrát igényelnek. Ez a választás olyan helyzetet teremthet, ahol elakadsz, és nem vagy biztos benne, melyik út támogatja valójában a hosszú távú céljaidat – ez egy olyan kihívás, amellyel sok csapat szembesül a mesterséges intelligencia bevezetése során.
Ez a táblázat összefoglalja a legfontosabb különbségeket, hogy megalapozott döntést hozhasson.
| Súlyok | Nyitott (Egyéni) | Saját fejlesztésű | Nyitott (Egyéni) | Saját fejlesztésű |
| Finomhangolás | Teljes ellenőrzés | API-alapú | Teljes ellenőrzés | API-alapú |
| Saját szerveren való üzemeltetés | Igen | Nem | Igen | Nem |
| Licenc | DB Open Model | OpenAI feltételek | Llama közösség | Anthropic kifejezések |
| Háttér | 32K | 128 ezer – 1 millió | 128K | 200 000 – 1 millió |
A DBRX a megfelelő választás, ha teljes ellenőrzést szeretne gyakorolni a modell felett, biztonsági vagy megfelelőségi okokból saját szerveren kell futtatnia a modellt, vagy ha egy rugalmas, szabadon használható kereskedelmi licenc nyújtotta rugalmasságot részesíti előnyben. Ha nincs dedikált GPU-infrastruktúrája – vagy a mélyreható testreszabásnál fontosabbnak tartja a gyors piacra lépést –, akkor az API-alapú alternatívák lehetnek a megfelelőbbek.
Kezdje el okosabban a betanítást a ClickUp segítségével
A DBRX vállalati szintű alapot biztosít egyedi AI-alkalmazások fejlesztéséhez, olyan átláthatósággal és ellenőrzési lehetőségekkel, amelyeket a zárt forráskódú modellek nem nyújtanak. Hatékony MoE-architektúrája alacsonyan tartja a következtetés költségeit, nyitott kialakítása pedig megkönnyíti a finomhangolást. De a kiváló technológia csak a siker egyik fele.
Az igazi siker abból fakad, hogy a technikai munkát összehangolja a csapat együttműködésen alapuló munkafolyamatával. A mesterséges intelligencia-modellek betanítása csapatmunka, ezért elengedhetetlen, hogy a kísérletek, a dokumentáció és az érdekelt felekkel való kommunikáció összhangban legyenek. Ha mindent egyetlen, összevont munkaterületbe hoz, és csökkenti a kontextus szétszóródását, akkor jobb modelleket tud gyorsabban elkészíteni.
Kezdje el ingyenesen használni a ClickUp-ot, hogy egyetlen munkaterületen koordinálhassa mesterséges intelligencia-képzési projektjeit. ✨
Gyakran feltett kérdések
Hogyan követhetem nyomon a képzés előrehaladását a DBRX-ben?
A betanítást olyan szabványos gépi tanulási eszközökkel követheti nyomon, mint a TensorBoard, a Weights & Biases vagy az MLflow. Ha a Databricks ökoszisztémán belül végez betanítást, az MLflow natívan integrálva van a kísérletek zökkenőmentes nyomon követése érdekében.
Integrálhatom a DBRX-et a CI/CD-vel és a telepítési folyamatokkal?
Igen, a DBRX integrálható a szokásos MLOps-folyamatokba. A modell konténeresítésével olyan koordinációs platformok segítségével telepítheti azt, mint a Kubeflow, vagy egyéni CI/CD-munkafolyamatok segítségével.
Mi a különbség a DBRX Base és a DBRX Instruct között?
A DBRX Base egy alapvető, előre betanított modell, amelyet azoknak a csapatoknak szánnak, amelyek domain-specifikus folyamatos előbetanítást vagy mélyreható architektúra-finomhangolást szeretnének végrehajtani. A DBRX Instruct egy utasítások követésére optimalizált, finomhangolt változat, így a legtöbb alkalmazásfejlesztéshez jobb kiindulási pontot jelent.
Hogyan viszonyul a DBRX a GPT-4-hez a vállalati AI-projektek terén?
A fő különbség az irányításban rejlik. A DBRX teljes hozzáférést biztosít a modell súlyozásaihoz a mélyreható testreszabás és az önálló üzemeltetés érdekében, míg a GPT-4 kizárólag API-alapú szolgáltatás.
Ingyenesen használható a DBRX?
A DBRX-modellek súlyozásai ingyenesen elérhetők a Databricks Open Model License keretében. A modell futtatásához vagy finomhangolásához szükséges számítási infrastruktúra költségeit azonban Önnek kell viselnie.