
คุณกำลังถูกข้อมูลท่วมท้นอยู่หรือไม่? แม้แต่ผู้เชี่ยวชาญด้านข้อมูลที่มีประสบการณ์มากที่สุดก็ยังต้องดิ้นรนเพื่อรับมือกับคลื่นข้อมูลมหาศาลที่เกิดจากโลกที่ให้ความสำคัญกับดิจิทัลเป็นอันดับแรก—ยังไม่ต้องพูดถึงการพยายามเพิ่มประสิทธิภาพของกระบวนการทำงาน ตั้งแต่การวิเคราะห์เว็บ ไปจนถึงข้อมูลลูกค้า และตัวชี้วัดประสิทธิภาพ คุณคือผู้รับผิดชอบในการรักษาข้อมูลเหล่านี้ให้แม่นยำและทันสมัยที่สุดเท่าที่จะเป็นไปได้ ✨
การออกแบบฐานข้อมูลที่มั่นคงเป็นสิ่งจำเป็นสำหรับการสร้างและดูแลฐานข้อมูลสำหรับธุรกิจของคุณ แต่แม้กระนั้น คุณก็จำเป็นต้องรู้วิธีป้องกันการปนเปื้อนข้ามกันและความซ้ำซ้อนของข้อมูล ความสัมพันธ์ระหว่างข้อมูลกำหนดความสัมพันธ์ระหว่างคุณสมบัติของข้อมูล ซึ่งช่วยในทุกด้าน ตั้งแต่ความแม่นยำของข้อมูลไปจนถึงการวิเคราะห์ข้อมูลเชิงลึก
ส่วนที่น่าสนใจที่สุดคือ? มี มากมาย ประเภทของความสัมพันธ์ให้เลือก แต่ความสัมพันธ์เชิงฟังก์ชันเป็นสิ่งที่ขาดไม่ได้ หากคุณกำลังรอไม่ไหวที่จะสร้างฐานข้อมูล
ในคู่มือนี้ เราจะอธิบายว่าความสัมพันธ์เชิงฟังก์ชันคืออะไร ให้ตัวอย่างของทุกประเภทความสัมพันธ์เชิงฟังก์ชัน และเสนอเคล็ดลับที่เป็นประโยชน์เพื่อเพิ่มประสิทธิภาพฐานข้อมูลเชิงสัมพันธ์ของคุณให้สูงสุด

ความสัมพันธ์เชิงฟังก์ชันคืออะไร?
ความพึ่งพาเชิงฟังก์ชันเป็นประเภทหนึ่งของความพึ่งพาที่มีความสัมพันธ์ระหว่างตัวแปรสองตัว โดยด้านซ้ายคือคุณลักษณะตัวกำหนด (determinant attribute) หรือที่เรียกว่าคีย์หลัก (primary key) ส่วนด้านขวาคือคุณลักษณะที่พึ่งพา (dependent attribute) หรือที่เรียกว่าคุณลักษณะที่ไม่ใช่คีย์ (non-key attribute) ฟังก์ชันหรือผลลัพธ์จะเปลี่ยนแปลงไปตามความสัมพันธ์ระหว่างตัวแปรทั้งสองตัว
เรารู้ว่าเรื่องนี้ฟังดูซับซ้อนเล็กน้อย ดังนั้นนี่คือวิธีการทำงานของความสัมพันธ์เชิงฟังก์ชัน:
- สมมติว่าคุณใช้ซอฟต์แวร์ฐานข้อมูลลูกค้าเพื่อติดตามวันเกิดของลูกค้า คุณต้องการส่งอีเมลที่ปรับแต่งให้เหมาะกับลูกค้าแต่ละคนในวันเกิดของพวกเขา เพื่อสร้างความสัมพันธ์ที่ดี
- คุณจำเป็นต้องใช้ความสัมพันธ์เชิงฟังก์ชันเพื่อส่งอีเมลให้ผู้ใช้แต่ละคนในวันเกิดของพวกเขา — เพราะการส่งข้อความ “สุขสันต์วันเกิด” ที่ไม่เกี่ยวข้องไปยัง 300 คน จะดูแปลกๆ ใช่ไหม?
- ในกรณีนี้ ฟังก์ชันการส่งอีเมลขึ้นอยู่กับตัวแปรวันเกิดของลูกค้า
- หากคุณต้องการความสัมพันธ์ประเภทนี้ในฐานข้อมูลของคุณ คุณจะต้องตั้งค่าความพึ่งพาเชิงฟังก์ชันระหว่างวันเกิดของลูกค้าและฟังก์ชันที่ส่งอีเมลในวันเกิดของพวกเขา
ความพึ่งพาเชิงฟังก์ชันเป็นพื้นฐานสำคัญสำหรับการปรับโครงสร้างฐานข้อมูลให้เป็นมาตรฐาน (normalization) ผ่านกระบวนการปรับโครงสร้างให้เป็นมาตรฐานนี้ คุณจะจัดระเบียบฐานข้อมูล — คล้ายกับการจัดห้อง — เพื่อจัดเรียงข้อมูลให้หลีกเลี่ยงการซ้ำซ้อน
กฎเกณฑ์ของความสัมพันธ์เชิงฟังก์ชันในระบบจัดการฐานข้อมูล
ความพึ่งพาเชิงฟังก์ชันปฏิบัติตามกฎการอนุมานหลายข้อ — ซึ่งยังเรียกว่า “หลักการของอาร์มสตรอง” (Armstrong’s Axioms)
มีกฎหลักสามข้อของความสัมพันธ์เชิงฟังก์ชัน:
- ความสะท้อนกลับ: กฎความสะท้อนกลับระบุว่า หากคุณสมบัติ A มีความสัมพันธ์กับคุณสมบัติ X แล้ว คุณสมบัติ X ก็มีความสัมพันธ์กับคุณสมบัติ A เช่น หาก A เป็นชื่อจริงของบุคคลใดนั้น และ X เป็นนามสกุลของบุคคลนั้น คุณสมบัติทั้งสองนี้จะมีความสัมพันธ์กันเสมอ
- การเพิ่มข้อมูล (Augmentation): กฎการเพิ่มข้อมูล (Augmentation Rule) ระบุว่า หากคุณเพิ่มข้อมูลลงในตัวแปร (ซึ่งเรียกว่าการเพิ่มข้อมูล) คุณต้องเพิ่มการเพิ่มข้อมูลนั้นเข้าไปในชุดคุณสมบัติ ดังนั้น หากคุณเพิ่มชื่อเล่นลงในช่องชื่อแรก ช่องนั้นจะมีความสัมพันธ์กับช่องชื่อหลังด้วย
- การถ่ายโอน: กฎการถ่ายโอนระบุว่า หากคุณสมบัติ A มีความสัมพันธ์กับคุณสมบัติ C แล้ว โดยความสัมพันธ์นี้ คุณสมบัติ B ก็เท่ากับคุณสมบัติ C เช่นกัน อย่าให้เรื่องนี้ทำให้คุณสับสน—การพึ่งพาแบบถ่ายโอนหมายความว่า บางครั้งสิ่งหนึ่งสามารถกำหนดสิ่งอื่น ซึ่งสิ่งนั้นกำหนดสิ่งอื่นอีก ตัวอย่างเช่น หากคุณกำลังสร้างบาร์โค้ดในแพลตฟอร์ม CRMสำหรับลูกค้าโดยอิงจากชื่อและนามสกุลของพวกเขา แล้วชื่อนั้นจะกำหนดตำแหน่งของลูกค้าในรายชื่อตามลำดับตัวอักษร
ความพึ่งพาเชิงฟังก์ชันจะเปลี่ยนโมเดลข้อมูลของคุณให้เป็นสคีมาความสัมพันธ์จริงโดยใช้ SQL ซึ่งช่วยรักษาความสมบูรณ์ของข้อมูล ในทางปฏิบัติ คุณสามารถใช้ความพึ่งพาเชิงฟังก์ชันในระบบจัดการฐานข้อมูล (DBMS) เพื่อหลีกเลี่ยงความซ้ำซ้อนของข้อมูลและสถานการณ์ “อุ๊ย” ที่อาจทำให้ฐานข้อมูลเสียหาย 👀
ความพึ่งพาเชิงฟังก์ชันแบบเต็มเทียบกับความพึ่งพาเชิงฟังก์ชันแบบบางส่วน
ก่อนที่จะพิจารณาประเภทต่าง ๆ ของความพึ่งพาเชิงฟังก์ชัน สิ่งสำคัญคือต้องแยกแยะระหว่างความพึ่งพาเชิงฟังก์ชันแบบบางส่วนและความพึ่งพาเชิงฟังก์ชันแบบเต็มรูปแบบ
สมมติว่าคุณกำลังนำข้อมูลแผนผังองค์กรไปใส่ในฐานข้อมูล ด้วยความพึ่งพาเชิงหน้าที่แบบเต็มรูปแบบ คุณลักษณะหนึ่งจะขึ้นอยู่กับชุดคุณลักษณะอื่น แต่ไม่ขึ้นอยู่กับส่วนย่อยของชุดคุณลักษณะนั้น ดังนั้น สมมติว่าเรามีการรวมกันของ “ชื่อพนักงาน” และ “รหัสพนักงาน” ที่กำหนด “สถานที่ทำงาน”
หากทราบ “ชื่อพนักงาน” และ “รหัสพนักงาน” ก็สามารถกำหนด “สถานที่” ได้ อย่างไรก็ตาม ไม่สามารถพิจารณาตัวแปรทั้งสองนี้เพียงอย่างเดียวเพื่อกำหนด “สถานที่” ได้ ในกรณีนี้ “สถานที่” ขึ้นอยู่กับการรวมกันของ “ชื่อพนักงาน” และ “รหัสพนักงาน” อย่างสมบูรณ์
ความพึ่งพาเชิงฟังก์ชันแบบบางส่วนเกิดขึ้นเมื่อคุณสมบัติหนึ่งขึ้นอยู่กับเพียงส่วนหนึ่งของคีย์หลัก แทนที่จะขึ้นอยู่กับคีย์หลักแบบผสม ตัวอย่างเช่น หากคุณสามารถกำหนดค่าของฟิลด์ข้อมูล “Years Worked” ได้โดยใช้ “Employee ID” คุณจะมีความพึ่งพาแบบบางส่วน เพราะ “Years Worked” ไม่ขึ้นอยู่กับ “Location”
อาจฟังดูเหมือนเป็นความแตกต่างเล็กน้อย แต่สิ่งนี้มีผลกระทบอย่างมากต่อการปรับรูปแบบข้อมูลให้เป็นมาตรฐาน (data normalization) ความสัมพันธ์เชิงหน้าที่แบบบางส่วน (partial functional dependencies) อาจก่อให้เกิดข้อมูลซ้ำซ้อนในฐานข้อมูลของคุณ ซึ่งหมายความว่าคุณต้องแก้ไขปัญหาเหล่านี้ในขั้นตอนการปรับรูปแบบข้อมูลให้เป็นมาตรฐานระดับที่สอง หรือ 2NF นี่ไม่ใช่เรื่องใหญ่โตอะไร แต่เป็นสิ่งที่คุณจำเป็นต้องแก้ไขในภายหลังอย่างแน่นอน 🛠️
รูปแบบปกติที่ 1, 2 และ 3 ใน SQL
เมื่อทำการปรับรูปแบบข้อมูล (normalization) เป้าหมายคือการกำจัดความผิดปกติในการเพิ่ม แก้ไข หรือลบข้อมูลในฐานข้อมูล ซึ่งอาจก่อให้เกิดความเสียหายอย่างรุนแรง การปรับรูปแบบข้อมูลโดยใช้ความสัมพันธ์เชิงหน้าที่ (functional dependencies) มี 3 ขั้นตอน
รูปแบบปกติขั้นที่หนึ่ง
คิดถึงรูปแบบปกติที่หนึ่ง (1NF) เป็นพื้นฐานสำหรับการสร้างระบบที่คุณสามารถใช้ความพึ่งพาเชิงฟังก์ชันได้ มันวางรากฐานสำหรับการระบุความพึ่งพาในรูปแบบปกติที่สองและสาม ในทางเทคนิค รูปแบบปกติที่หนึ่ง (1NF) มีแอตทริบิวต์ที่ประกอบด้วยค่าอะตอมิกเท่านั้น ซึ่งรับประกันว่าไม่มีกลุ่มที่ซ้ำกัน
รูปแบบปกติที่สอง
หลังจากนำข้อมูลผ่าน 1NF แล้ว คุณจะได้ตารางที่ทุกแอตทริบิวต์ที่ไม่ใช่คีย์มีความพึ่งพาเชิงหน้าที่อย่างสมบูรณ์ต่อคีย์หลัก ใน 2NF คุณจะกำจัดความพึ่งพาแบบบางส่วนโดยการแบ่งตารางออก เพื่อตรวจสอบอีกครั้งว่าทุกแอตทริบิวต์ที่ไม่ใช่คีย์มีความพึ่งพาอย่างสมบูรณ์ต่อคีย์หลัก
รูปแบบปกติที่สาม
เมื่อตารางข้อมูลอยู่ในรูปแบบ 2NF แล้ว จะก้าวสู่รูปแบบ 3NF เมื่อทุกแอตทริบิวต์มีความสัมพันธ์เชิงหน้าที่กับคีย์หลักเท่านั้น และไม่มีความสัมพันธ์กับสิ่งอื่นใดอีก ในรูปแบบ 3NF คุณจะลบความสัมพันธ์เชิงหน้าที่แบบทรานซิทีฟทั้งหมดออก โดยการแบ่งตารางเพิ่มเติมในขั้นตอนนี้
1NF เป็นพื้นฐานสำหรับความสัมพันธ์เชิงฟังก์ชัน ส่วน 2NF และ 3NF ช่วยปรับปรุงวิธีการจัดระเบียบข้อมูลโดยปรับโครงสร้างความสัมพันธ์เชิงฟังก์ชันใหม่ ซึ่งช่วยให้มั่นใจได้ว่าข้อมูลทุกส่วนจะถูกจัดเก็บไว้ในตำแหน่งที่เหมาะสมที่สุด ลดความซ้ำซ้อน และเพิ่มความสมบูรณ์ของข้อมูลในกระบวนการนี้

ประเภทของความสัมพันธ์เชิงฟังก์ชัน พร้อมตัวอย่าง
หากคุณพร้อมที่จะเริ่มใช้ความพึ่งพาเชิงฟังก์ชันแล้ว มีสี่ตัวเลือกให้คุณเลือก
เรื่องง่ายๆ
ความพึ่งพาแบบทริวิอัล (trivial dependency) เป็นประเภทพื้นฐานของความพึ่งพาเชิงฟังก์ชัน ซึ่งคุณลักษณะหรือชุดคุณลักษณะหนึ่งเป็นตัวกำหนดตัวเอง ทุกองค์ประกอบที่พึ่งพาเป็นชุดย่อยของตัวกำหนด ในคำอื่น ๆ หาก C เป็นชุดย่อยของ A ความสัมพันธ์เชิงฟังก์ชันนี้จะเป็นแบบทริวิอัล
อาจฟังดูชัดเจนเล็กน้อย แต่ตัวอย่างหนึ่งคือการระบุชื่อหนังสือเมื่อคุณรู้ทั้งชื่อหนังสือและผู้เขียน การมองเห็นความสัมพันธ์ระหว่างคุณสมบัติทั้งสองนี้ค่อนข้างง่าย ซึ่งนี่คือเหตุผลที่ความสัมพันธ์เชิงหน้าที่แบบพื้นฐานเป็นสิ่งที่เข้าใจได้ง่ายที่สุด
ไม่ใช่เรื่องง่าย
นี่คือจุดที่เรื่องเริ่มน่าสนใจขึ้น ในความสัมพันธ์เชิงฟังก์ชันที่ไม่ธรรมดา คุณสมบัติหนึ่งสามารถกำหนดคุณสมบัติอื่นที่ต่างออกไปได้ ในกรณีนี้ A เป็นชุดของคุณสมบัติ และ B ก็เป็นชุดของคุณสมบัติเช่นกัน แต่ B ไม่ใช่ส่วนย่อยของ A หาก B ไม่ใช่ ส่วนย่อยของ A ทั้งสองจึงมีความสัมพันธ์ที่ไม่ธรรมดา
คุณจะมีความสัมพันธ์ที่ไม่ธรรมดา หากสร้างฐานข้อมูลหนังสือ กำหนดรหัสเฉพาะให้กับแต่ละเล่ม และสามารถค้นหาชื่อหนังสือได้เมื่อรู้รหัสที่กำหนดให้กับหนังสือนั้น
ค่าหลายค่า
ในความสัมพันธ์แบบหลายค่า (multivalued dependency) คุณสมบัติหนึ่งจะเชื่อมโยงกับคุณสมบัติอื่น ๆ หลายตัว คุณสมบัติในกลุ่มที่ขึ้นอยู่กับกัน (dependents) ไม่พึ่งพาซึ่งกันและกัน ดังนั้น หากคุณสมบัติ A และ C ไม่มีความสัมพันธ์เชิงหน้าที่ (functional dependency) ความสัมพันธ์ระหว่าง B, A และ C ก็จะเป็นความสัมพันธ์แบบหลายค่า
เพื่อต่อความเปรียบเทียบกับหนังสือ นี่ก็เหมือนกับนักเขียนที่เขียนหนังสือมาหลายเล่ม หากคุณรู้ชื่อของเขา คุณก็สามารถระบุรายชื่อหนังสือทั้งหมดที่เขาเขียนได้ ในความพึ่งพาเชิงฟังก์ชันแบบหลายค่า นักเขียนหนึ่งคนจะมีหนังสือหลายเล่มที่เชื่อมโยงกับชื่อของเขา
Transitive
ความสัมพันธ์เชิงฟังก์ชันแบบทรานซิทีฟ คือเมื่อคุณสมบัติหนึ่งกำหนดคุณสมบัติอีกอย่าง และจากนั้นกำหนดคุณสมบัติอีกอย่างหนึ่งต่อ เป็นเหมือนปฏิกิริยาลูกโซ่ หากเรื่องนี้ฟังดูคุ้นหู ก็เพราะความสัมพันธ์เชิงฟังก์ชันประเภทนี้ปฏิบัติตามกฎทรานซิทีฟ
ในกรณีนี้ หาก A เท่ากับ B และ B เท่ากับ C แล้ว A ก็ต้องเท่ากับ C เช่นกัน สมมติว่าคุณกำลังสร้างฐานข้อมูลหนังสือ และรหัสหนังสือที่ไม่ซ้ำกันของคุณกำหนดผู้ออกพิมพ์และประเภทหนังสือ หากรู้รหัสหนังสือ คุณก็สามารถระบุได้ว่าผู้ออกพิมพ์คือใครและประเภทหนังสือเป็นอะไร
วิธีใช้ความพึ่งพาเชิงฟังก์ชันในการจัดการฐานข้อมูล
คุณพร้อมที่จะเริ่มใช้ความพึ่งพาเชิงฟังก์ชันแล้วหรือยัง? คุณสามารถใช้ความพึ่งพาเชิงฟังก์ชันได้ตามวิธีที่คุณเห็นเหมาะสม แต่เมื่อคุณต้องการทำงานอย่างชาญฉลาดขึ้นและลดความยุ่งยากลง ให้เลือกใช้ ClickUp
ต่อไปนี้คือภาพรวมสั้นๆ เกี่ยวกับวิธีการสร้างฐานข้อมูลใน ClickUp และรวมความพึ่งพาเชิงฟังก์ชันเข้าไป:
ก่อนอื่น คุณต้องตั้งค่าฐานข้อมูลใน ClickUp ก่อน คุณสามารถนำเข้าแผ่นข้อมูลจาก Excel หรือสร้างแผ่นข้อมูลของคุณเองจากต้นจนจบ
โหมดดูแบบตาราง (Table view) ของ ClickUpช่วยให้สามารถแก้ไขข้อมูลแบบกลุ่มและสร้างมุมมองที่ปรับแต่งได้เพื่อติดตามข้อมูลเกี่ยวกับแทบทุกเรื่อง ClickUpยังช่วยแสดงข้อมูลแบบภาพเพื่อให้คุณสรุปข้อมูลจากฐานข้อมูลได้ในเวลาอันรวดเร็ว
ข่าวดีคือคุณไม่ต้องเริ่มต้นจากศูนย์เลยแม่แบบฐานข้อมูลของ ClickUpทำให้การสร้างฐานข้อมูลเป็นเรื่องง่ายมาก
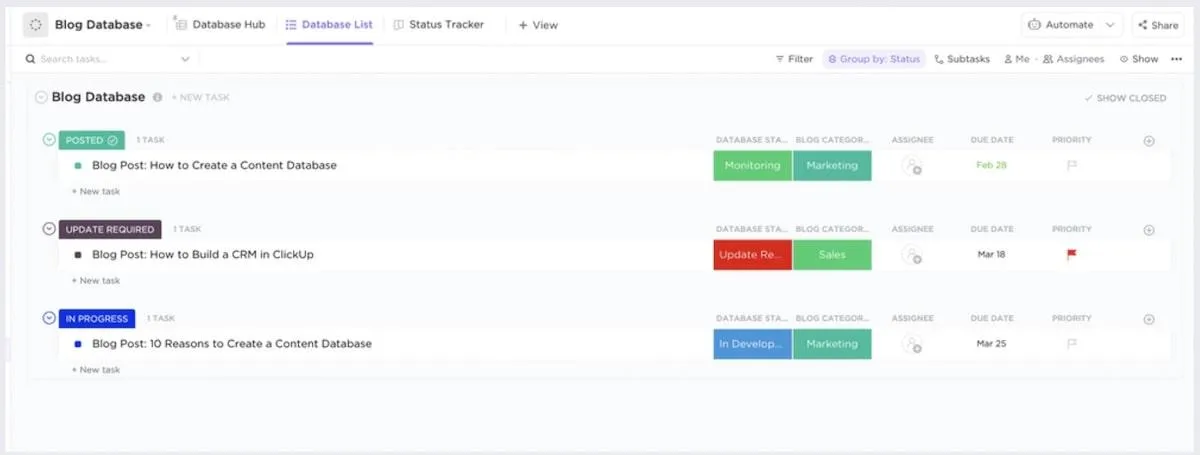
เทมเพลตฐานข้อมูลของ ClickUp Blogมีประโยชน์อย่างยิ่งสำหรับการวางแผนเนื้อหา ส่วนเทมเพลตรายชื่อพนักงานของ ClickUpก็เหมาะอย่างยิ่งสำหรับการสร้างฐานข้อมูลที่มีข้อมูลติดต่อของเพื่อนร่วมงานได้อย่างรวดเร็ว นอกจากนี้ ฐานข้อมูลนี้ยังไม่ต้องเขียนโค้ด ดังนั้นหากคุณต้องการสร้างฐานข้อมูลโดยไม่ต้องเรียนรู้ SQL เราก็มีโซลูชันที่ตอบโจทย์คุณ
การนำความพึ่งพาเชิงฟังก์ชันมาใช้ใน ClickUp
โดยปกติแล้ว คุณจะต้องใช้ SQL อย่างหนักเพื่อสร้างความสัมพันธ์เชิงฟังก์ชันในฐานข้อมูล แต่โชคดีที่อินเทอร์เฟซแบบลากและวางของ ClickUp ทำให้การสร้างความสัมพันธ์ระหว่างงานและเอกสารเป็นเรื่องง่าย นอกจากนี้เครื่องมือ AIใน ClickUp ยังช่วยให้การจัดการฐานข้อมูลเป็นเรื่องง่ายมาก แม้ว่าคุณจะไม่ใช่ผู้เชี่ยวชาญด้านฐานข้อมูลก็ตาม
นี่คือวิธีสร้างความพึ่งพาในฐานข้อมูล ClickUp ของคุณ
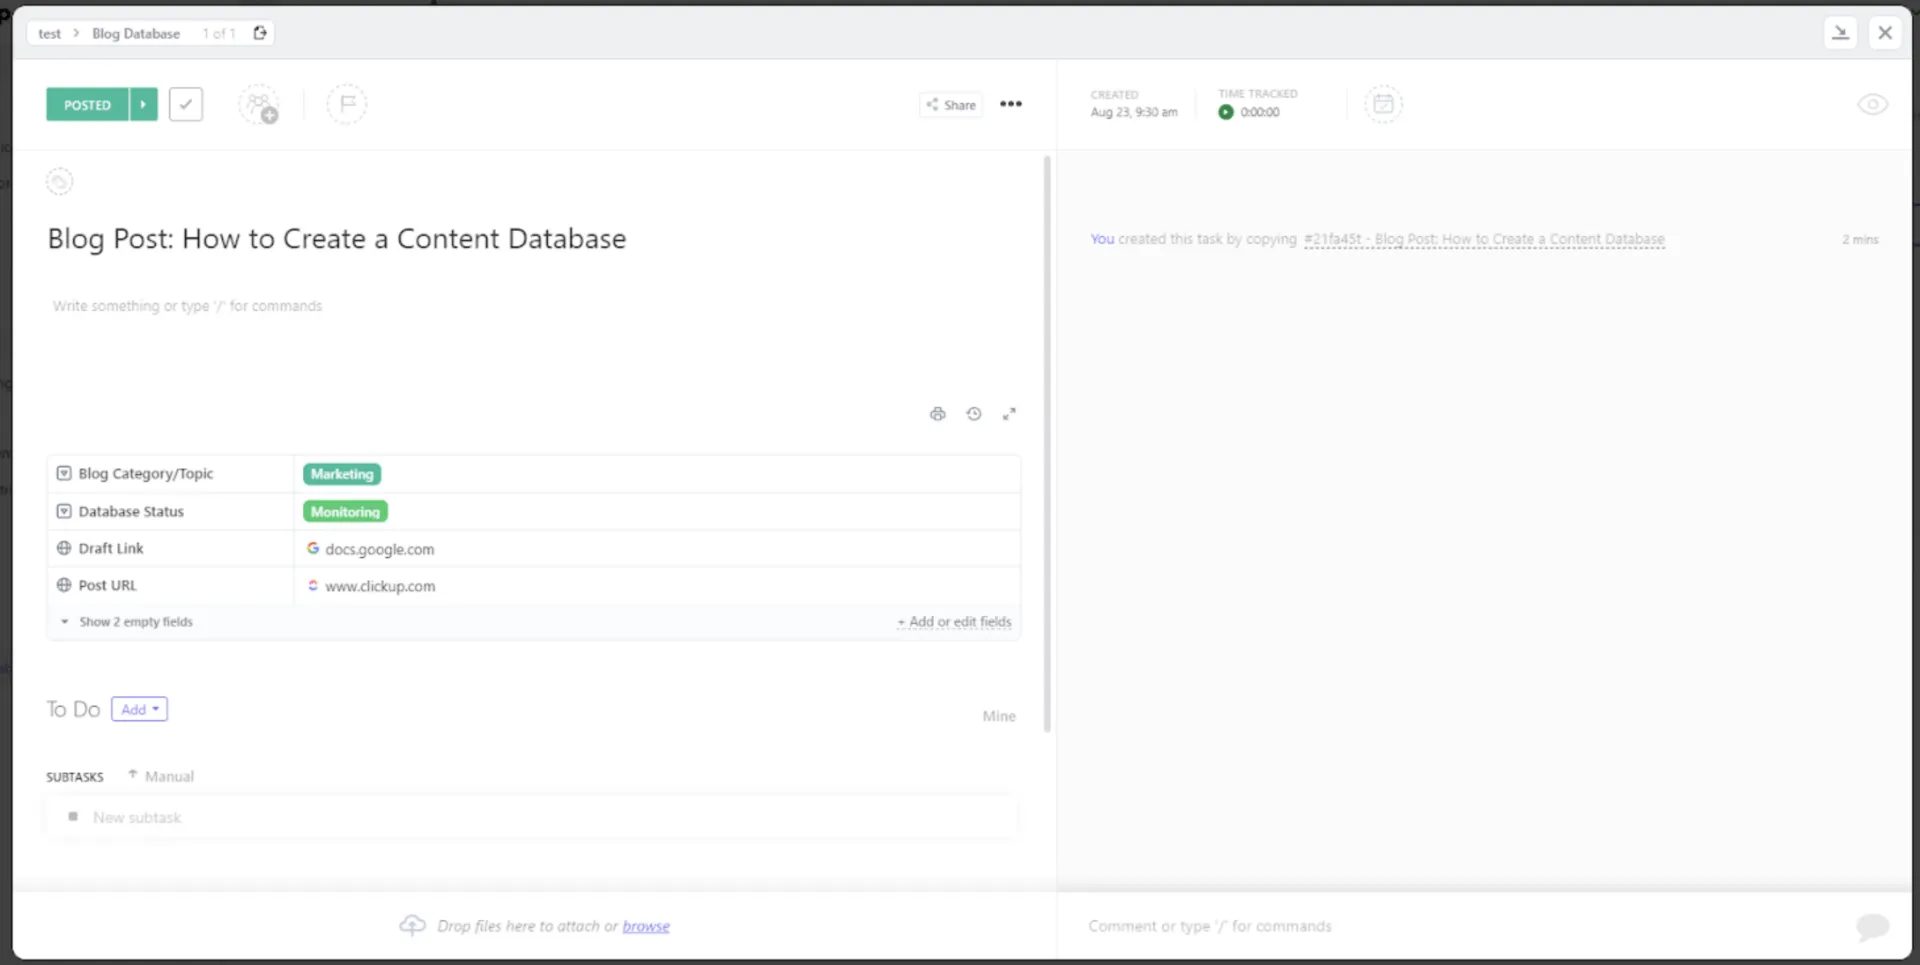
ก่อนอื่น ให้คลิกที่งานที่คุณต้องการทำงาน
ไปที่ Relationships > Dependency. เลือกจาก Waiting On, Blocking และ Tasks เพื่อปรับแต่งความสัมพันธ์
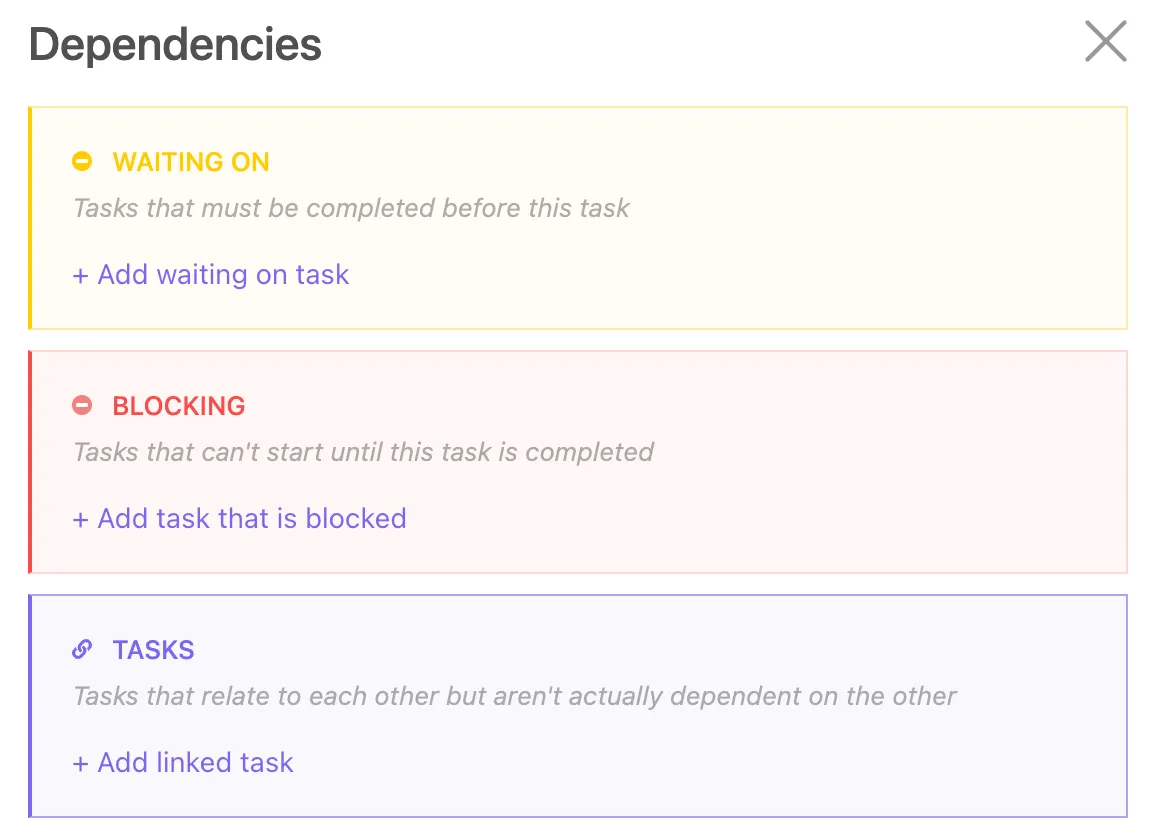
ในกรณีนี้ เราจะเลือก Waiting On และค้นหางานอื่นที่มีความเกี่ยวข้องกับงานปัจจุบัน
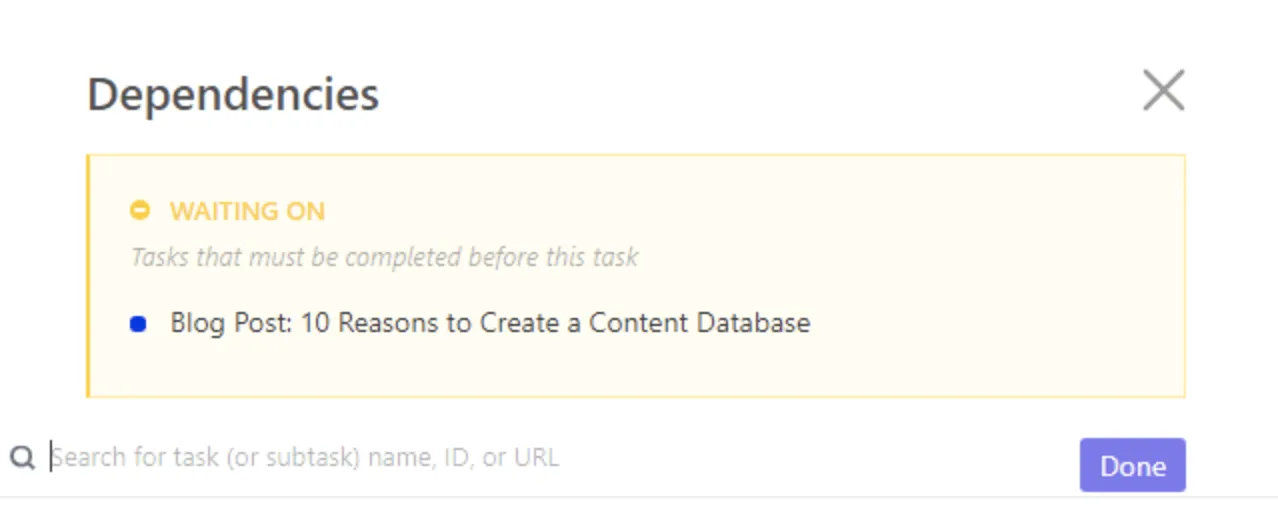
คลิก “Done” และคุณก็เสร็จแล้ว! 🙌
ทำให้ความสัมพันธ์ระหว่างงานง่ายขึ้นด้วย ClickUp
ใครว่างานบริหารจัดการฐานข้อมูลต้องซับซ้อน? ตราบใดที่คุณเข้าใจหลักการของข้อพึ่งพาเชิงหน้าที่อย่างถ่องแท้ คุณก็จะสามารถออกแบบฐานข้อมูลที่รวดเร็วและแม่นยำ ซึ่งช่วยให้องค์กรของคุณก้าวหน้าต่อไปได้
คุณไม่จำเป็นต้องทำสิ่งนี้คนเดียวด้วย ClickUp เป็นระบบจัดการฐานข้อมูลที่เชื่อถือได้ ซึ่งรวมข้อมูลกับเทมเพลต โครงการ งาน เป้าหมาย และทุกสิ่งอื่น ๆ ที่เกี่ยวข้อง
ประหยัดเวลาได้มากขึ้นและมุ่งเน้นไปที่งานที่มีมูลค่าสูง โดยเปลี่ยนมาใช้แพลตฟอร์ม ClickUp ที่ครบวงจรอย่างแท้จริง
ลองทำเอง:สร้างบัญชี ClickUp ฟรีเพื่อสร้างฐานข้อมูลที่ดีขึ้น!