
ภัยพิบัติทางไอทีอาจเกิดขึ้นได้โดยไม่มีการเตือนล่วงหน้า
ตั้งแต่การหยุดทำงานของเซิร์ฟเวอร์ไปจนถึงการโจมตีทางไซเบอร์ — และหากไม่มีแผนการกู้คืนที่มั่นคง ธุรกิจของคุณอาจต้องเผชิญกับเวลาหยุดทำงานเป็นชั่วโมง การสูญเสียข้อมูล และความเสียหายทางการเงินที่รุนแรง โดย54% ของการหยุดทำงานที่รุนแรงมีค่าใช้จ่ายเกิน 100,000 ดอลลาร์สหรัฐ
บล็อกนี้จะนำคุณผ่านขั้นตอนการสร้างแผนการกู้คืนระบบ IT ที่ครอบคลุม เพื่อปกป้องระบบของคุณ กำหนดเป้าหมายการกู้คืนที่ชัดเจน และรับประกันว่าทีมของคุณจะรู้แน่ชัดว่าต้องทำอะไรเมื่อเกิดปัญหา
แผนการกู้คืนระบบ IT คืออะไร?
หากเซิร์ฟเวอร์ของคุณเกิดขัดข้องทันทีตอนนี้ ทีมของคุณจะรู้แน่ชัดว่าต้องทำอย่างไรหรือไม่? 🛠️
แผนการกู้คืนระบบ IT (DR) คือกลยุทธ์ที่บันทึกไว้อย่างเป็นทางการ เพื่อกู้คืนระบบ IT และข้อมูลหลังจากเกิดการหยุดชะงักใดๆ — ตั้งแต่ภัยธรรมชาติไปจนถึงการโจมตีทางไซเบอร์ โดยพื้นฐานแล้ว นี่คือคู่มือปฏิบัติการของคุณในการนำระบบเทคโนโลยีกลับมาทำงานได้อีกครั้งเมื่อเกิดปัญหา
💡 การกู้คืนหลังภัยพิบัติ (DR) เทียบกับ ความต่อเนื่องทางธุรกิจ
การกู้คืนหลังภัยพิบัติ (DR) มุ่งเน้นโดยเฉพาะไปที่การกู้คืนโครงสร้างพื้นฐาน IT และข้อมูลของคุณ ส่วนการรักษาความต่อเนื่องของธุรกิจ (BC) มีขอบเขตกว้างกว่า โดยมีเป้าหมายเพื่อรักษาให้ธุรกิจของคุณทั้งหมดยังคงดำเนินการได้ทั้งในช่วงและหลังวิกฤต แม้ระบบ IT จะหยุดทำงานก็ตาม ให้คิดถึง DR ว่าเป็นส่วนสำคัญของกลยุทธ์ BC โดยรวมของคุณ
💡 การกู้คืนหลังภัยพิบัติ (DR) เทียบกับ ความต่อเนื่องทางธุรกิจ
การกู้คืนหลังภัยพิบัติ (DR) มุ่งเน้นเฉพาะการกู้คืนโครงสร้างพื้นฐาน IT และข้อมูลของคุณ ส่วนการรักษาความต่อเนื่องของธุรกิจ (BC) มีขอบเขตกว้างกว่า โดยมีเป้าหมายเพื่อรักษาให้ธุรกิจของคุณทั้งหมดยังคงดำเนินการได้ทั้งระหว่างและหลังวิกฤต แม้ระบบ IT จะหยุดทำงานก็ตาม ให้คิดถึง DR เป็นส่วนสำคัญของกลยุทธ์ BC โดยรวมของคุณ
แผนการกู้คืนหลังภัยพิบัติของคุณมีความสำคัญ เพราะเวลาที่ระบบหยุดทำงานไม่เพียงแต่ก่อให้เกิดค่าใช้จ่ายทางการเงินเท่านั้น แต่ทุกนาทีที่ระบบของคุณไม่สามารถใช้งานได้ อาจทำให้ความเชื่อมั่นของลูกค้าลดลง ก่อให้เกิดความขัดข้องในการดำเนินงาน และอาจนำไปสู่การถูกปรับเนื่องจากไม่ปฏิบัติตามข้อกำหนด แผนการกู้คืนหลังภัยพิบัติที่ครบถ้วนคือแผนที่นำทางสู่ความยืดหยุ่นของระบบ
แผนที่ดีควรรวมถึง:
- ขั้นตอนการสำรองข้อมูล: วิธีและสถานที่ที่คุณเก็บสำเนาข้อมูลสำคัญ เพื่อสามารถกู้คืนข้อมูลได้
- ขั้นตอนการกู้คืนระบบ: ลำดับขั้นตอนที่ถูกต้องเพื่อนำบริการกลับมาทำงานตามลำดับที่ถูกต้อง
- ความรับผิดชอบของทีม: ใครทำหน้าที่อะไรระหว่างเกิดเหตุการณ์ เพื่อหลีกเลี่ยงความสับสน
- โปรโตคอลการสื่อสาร: วิธีที่คุณจะอัปเดตข้อมูลให้กับผู้เกี่ยวข้อง ตั้งแต่ทีมของคุณไปจนถึงลูกค้า
- เป้าหมายการกู้คืน: เป้าหมายเฉพาะของคุณเกี่ยวกับความเร็วที่ระบบต้องกลับมาทำงานได้ และปริมาณการสูญเสียข้อมูลที่ยอมรับได้
สถานการณ์ภัยพิบัติ IT ที่พบบ่อยและผลกระทบ
ภัยพิบัติไม่ใช่เพียงฉากในภาพยนตร์ฮอลลีวูดเท่านั้น แต่เกิดขึ้นกับธุรกิจทุกวัน การเข้าใจว่าคุณกำลังป้องกันอะไร จะช่วยให้คุณสร้างระบบป้องกันที่แข็งแกร่งขึ้นอย่างมาก
ภัยธรรมชาติและความเสียหายทางกายภาพ
เหตุการณ์ต่าง ๆ เช่น น้ำท่วม ไฟไหม้ แผ่นดินไหว และการหยุดจ่ายไฟฟ้าครั้งใหญ่ สามารถทำลายศูนย์ข้อมูลทั้งแห่งได้ภายในไม่กี่นาที ตัวอย่างเช่น เมื่อเกิดน้ำท่วมครั้งใหญ่ที่ศูนย์ข้อมูลในเมืองแนชวิลล์ บริษัทบางแห่งสูญเสียข้อมูลที่เก็บไว้เป็นเวลาหลายสัปดาห์ และต้องใช้เวลาหลายเดือนในการกู้คืนข้อมูล วิธีป้องกันที่ดีที่สุดต่อเหตุการณ์นี้คือการใช้ความซ้ำซ้อนทางภูมิศาสตร์ ซึ่งหมายถึงการกระจายโครงสร้างพื้นฐานของคุณไปยังหลายสถานที่ทางกายภาพ เพื่อป้องกันไม่ให้เหตุการณ์เดียวสามารถทำให้ระบบทั้งหมดหยุดทำงานได้
การโจมตีทางไซเบอร์และการรั่วไหลของข้อมูล
แรนซัมแวร์ การโจมตีแบบปฏิเสธการให้บริการแบบกระจาย (DDoS) และการรั่วไหลของข้อมูล แตกต่างจากภัยพิบัติทางกายภาพ พวกมันมักตรวจจับได้ยากกว่า สามารถแพร่กระจายอย่างเงียบๆ ผ่านระบบที่เชื่อมต่อกัน และมักมุ่งเป้าไปที่ระบบสำรองข้อมูลของคุณด้วย ทำให้การกู้คืนข้อมูลเป็นเรื่องที่ท้าทายเป็นพิเศษ ความถี่และความซับซ้อนของการโจมตีทางไซเบอร์เหล่านี้ยังคงเพิ่มขึ้นอย่างต่อเนื่องในทุกอุตสาหกรรมโดยแรนซัมแวร์ปัจจุบันมีส่วนเกี่ยวข้องใน 44%ของการรั่วไหลของข้อมูลที่ได้รับการยืนยันทั้งหมด ทำให้มันกลายเป็นภัยคุกคามอันดับต้นๆ
📖 อ่านเพิ่มเติม: 10 วิธีลดความเสี่ยงด้านความปลอดภัยไซเบอร์ในการบริหารโครงการ
ความล้มเหลวของอุปกรณ์ฮาร์ดแวร์และการสูญเสียข้อมูล
บางครั้ง แม้แต่ระบบสำรองข้อมูลที่ผ่านการทดสอบและเชื่อถือได้มากที่สุด ก็อาจเกิดข้อผิดพลาดได้เช่นกัน การหยุดทำงานของเซิร์ฟเวอร์ ความล้มเหลวของระบบจัดเก็บข้อมูล และความผิดปกติของอุปกรณ์เครือข่าย อาจเกิดขึ้นได้โดยไม่มีสัญญาณเตือนล่วงหน้า แม้คุณจะมีระบบสำรอง (redundant) ก็ตาม ระบบเหล่านั้นก็อาจล้มเหลวพร้อมกันได้ หากใช้ส่วนประกอบหรือแหล่งจ่ายไฟร่วมกัน ซึ่งก่อให้เกิดจุดล้มเหลวเดียว (single point of failure)
👀 คุณรู้หรือไม่: ในช่วงเดือนตุลาคม 2568AWS ได้ประสบปัญหาการหยุดให้บริการครั้งใหญ่เมื่อข้อผิดพลาดในระบบจัดการ DNS ภายในสำหรับ Amazon DynamoDB ทำให้การแปลงชื่อโดเมนล้มเหลวในภูมิภาคศูนย์ข้อมูล US-EAST-1 ข้อบกพร่องทางเทคนิค “เล็กน้อย” นี้ได้ก่อให้เกิดความล้มเหลวแบบลูกโซ่ในบริการ AWS หลายสิบแห่ง และทำให้แอปพลิเคชันและแพลตฟอร์มยอดนิยมหลายร้อยแห่งทั่วโลกหยุดทำงาน — ตั้งแต่แอปส่งข้อความและโซเชียลมีเดีย ไปจนถึงธนาคาร เว็บไซต์เกม และอื่นๆ อีกมากมาย สำหรับหลายคน การหยุดให้บริการครั้งนี้ทำให้อินเทอร์เน็ตส่วนใหญ่ “หายไป” ชั่วคราว ซึ่งชี้ให้เห็นว่าโครงสร้างพื้นฐานดิจิทัลของเรามีความเปราะบางเพียงใด เมื่อทุกอย่างต้องพึ่งพาผู้ให้บริการคลาวด์เพียงไม่กี่ราย
ข้อผิดพลาดของซอฟต์แวร์และการหยุดให้บริการ
ฐานข้อมูลที่เสียหาย การอัปเดตซอฟต์แวร์ที่ล้มเหลว หรือข้อผิดพลาดในการตั้งค่าที่เรียบง่าย ก็สามารถทำให้แพลตฟอร์มทั้งระบบหยุดทำงานได้ คุณอาจสังเกตเห็นว่าบรรทัดโค้ดเดียวที่ตั้งค่าผิดพลาดสามารถส่งผลกระทบต่อเนื่องไปยังระบบที่เชื่อมต่อกัน จนก่อให้เกิดการหยุดทำงานอย่างกว้างขวางที่มีขอบเขตความเสียหายใหญ่ การจัดการการเปลี่ยนแปลงอย่างถูกต้องและสภาพแวดล้อมการทดสอบที่จัดไว้โดยเฉพาะคือเครื่องมือสำคัญที่สุดในการลดความเสี่ยงเหล่านี้
ข้อผิดพลาดของมนุษย์และการตั้งค่าผิด
การลบข้อมูลโดยไม่ได้ตั้งใจ การตั้งค่าผิด และการเปลี่ยนแปลงโดยไม่ได้รับอนุญาต ยังคงเป็นหนึ่งในสาเหตุที่พบบ่อยที่สุดของการหยุดทำงานของระบบ IT คำสั่งที่ผิดเพียงคำสั่งเดียวหรือไฟล์ที่ถูกลบไปอาจก่อให้เกิดเวลาหยุดทำงานเป็นเวลาหลายชั่วโมงและทำให้คุณภาพบริการลดลง แม้ว่าการฝึกอบรมและการควบคุมการเข้าถึงจะช่วยได้ แต่ไม่สามารถขจัดข้อผิดพลาดของมนุษย์ออกไปได้ทั้งหมด
📮ClickUp Insight:92% ของพนักงานใช้วิธีการที่ไม่สม่ำเสมอในการติดตามรายการงานที่ต้องดำเนินการ ซึ่งส่งผลให้การตัดสินใจถูกพลาดและการดำเนินการล่าช้า
ไม่ว่าคุณจะส่งข้อความติดตามผลหรือใช้สเปรดชีต กระบวนการนี้มักกระจัดกระจายและไม่มีประสิทธิภาพ แต่ด้วยคุณสมบัติการจัดการงานของ ClickUpคุณไม่ต้องกังวลเรื่องนี้อีกต่อไป สร้างงานจากแชทความคิดเห็นใน ClickUp เอกสาร และอีเมลได้ด้วยการคลิกเพียงครั้งเดียว!
ส่วนประกอบหลักของแผนการกู้คืนระบบ IT หลังเกิดภัยพิบัติ
แผนการกู้คืนหลังภัยพิบัติ (DR) ที่มั่นคงคือคู่มือครบถ้วนสำหรับการกลับมาทำงานได้อีกครั้ง แต่ละองค์ประกอบเหล่านี้เสริมสร้างซึ่งกันและกันเพื่อสร้างการปกป้องที่ครอบคลุมสำหรับธุรกิจของคุณ
การประเมินความเสี่ยงและการจัดลำดับความสำคัญ
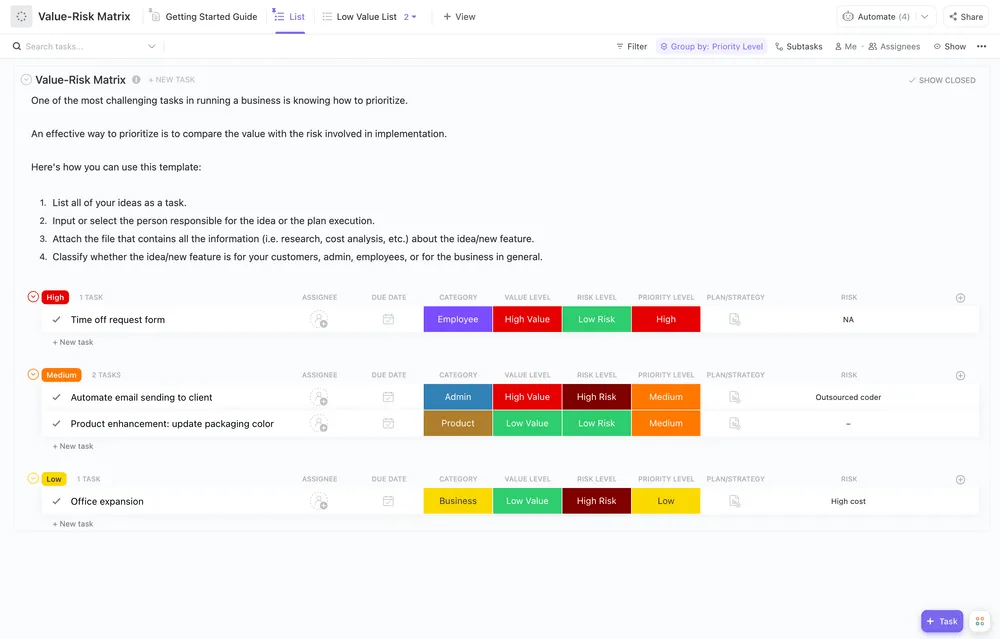
ก่อนอื่น คุณต้องรู้ว่าคุณกำลังเผชิญกับอะไรการประเมินความเสี่ยงคือกระบวนการระบุจุดอ่อนของคุณ และประเมินความน่าจะเป็นและผลกระทบของแต่ละภัยคุกคามที่อาจเกิดขึ้น คุณสามารถจัดเรียงข้อมูลนี้ลงในแมทริกซ์ความเสี่ยงเพื่อดูว่าภัยคุกคามใดมีความรุนแรงที่สุด
การประเมินของคุณควรครอบคลุม:
- ระบบสำคัญ: ระบบใดที่จำเป็นต้องทำงานอย่างต่อเนื่องเพื่อให้ธุรกิจของคุณดำเนินต่อไปได้
- ระดับความละเอียดอ่อนของข้อมูล: ข้อมูลใดที่จำเป็นต้องได้รับการคุ้มครองในระดับสูงสุด (เช่น ข้อมูลลูกค้า)
- ความพึ่งพา: ระบบหรือกระบวนการอื่นใดที่จะหยุดทำงานเมื่อระบบแต่ละระบบเกิดข้อผิดพลาด
📖 อ่านเพิ่มเติม: วิธีนำระบบการจัดการโครงสร้างพื้นฐาน IT ไปใช้
การวิเคราะห์ผลกระทบต่อธุรกิจและระดับความสำคัญ
ถัดไป ให้คำนวณค่าใช้จ่ายจริงจากเวลาที่ระบบหยุดทำงานการวิเคราะห์ผลกระทบต่อธุรกิจ (BIA)จะช่วยคุณกำหนดผลกระทบทางการเงินและด้านการดำเนินงานจากการหยุดทำงานของระบบแต่ละระบบ ซึ่งช่วยให้คุณสามารถจัดระบบของคุณเป็นระดับความสำคัญต่าง ๆ เพื่อกำหนดลำดับความสำคัญในการดำเนินการกู้คืน
| สำคัญ | น้อยกว่าหนึ่งชั่วโมง | การประมวลผลการชำระเงิน, ฐานข้อมูลลูกค้า |
| สูง | 1 ถึง 4 ชั่วโมง | อีเมล, เครื่องมือสื่อสารภายใน |
| Medium | 4 ถึง 24 ชั่วโมง | สภาพแวดล้อมการพัฒนา, เครื่องมือรายงาน |
| ต่ำ | 24+ ชั่วโมง | ระบบเก็บข้อมูลสำรอง, เซิร์ฟเวอร์ทดสอบที่ไม่ใช้ในระบบผลิต |
เป้าหมาย RTO และ RPO
สองคำย่อนี้เป็นหัวใจของกลยุทธ์การกู้คืนของคุณ
- เป้าหมายเวลาการกู้คืน (RTO): นี่คือระยะเวลาสูงสุดที่คุณสามารถยอมรับได้สำหรับระบบที่จะหยุดทำงาน มันตอบคำถามว่า “เราต้องการให้ระบบนี้กลับมาทำงานได้เร็วแค่ไหน?”
- เป้าหมายจุดกู้คืน (RPO): นี่คือปริมาณข้อมูลสูงสุดที่คุณสามารถยอมรับการสูญเสียได้ ซึ่งวัดด้วยเวลา มันตอบคำถามว่า “เราสามารถสูญเสียข้อมูลได้มากเท่าใดโดยไม่ก่อให้เกิดความเสียหายอย่างรุนแรง?”
ตัวอย่างเช่น ระบบอีเมลภายในองค์กรของคุณอาจมี RTO (เป้าหมายเวลาการกู้คืน) อยู่ที่ 4 ชั่วโมง แต่ฐานข้อมูลอีคอมเมิร์ซที่ให้บริการลูกค้าอาจมี RPO (เป้าหมายเวลาการกู้คืนข้อมูล) เพียง 15 นาที ซึ่งหมายความว่าคุณไม่สามารถสูญเสียข้อมูลธุรกรรมเกิน 15 นาทีได้
แผนการสำรองข้อมูลและการกู้คืนข้อมูล
แผนสำรองข้อมูลคือเครือข่ายความปลอดภัยที่สำคัญที่สุดของคุณ หลักปฏิบัติที่ดีที่สุดที่นิยมใช้กันคือกฎ 3-2-1: เก็บข้อมูลสำคัญไว้อย่างน้อยสามสำเนา เก็บไว้บนสื่อสองประเภทที่แตกต่างกัน และเก็บสำเนาหนึ่งไว้ที่สถานที่อื่นนอกสำนักงาน
คุณยังสามารถเลือกระหว่างประเภทการสำรองข้อมูลต่าง ๆ ได้:
- การสำรองข้อมูลแบบเต็ม: สำเนาครบถ้วนของข้อมูลทั้งหมด ซึ่งมักดำเนินการทุกสัปดาห์หรือทุกเดือน
- การสำรองข้อมูลแบบเพิ่มทีละส่วน: สำรองข้อมูลเฉพาะส่วนที่เปลี่ยนแปลงไปตั้งแต่การสำรองข้อมูล ครั้งสุดท้าย ไม่ว่าจะประเภทใด
- การสำรองข้อมูลแบบต่างส่วน (Differential backups): สำรองข้อมูลทุกการเปลี่ยนแปลงที่เกิดขึ้นตั้งแต่การสำรองข้อมูล เต็มครั้งสุดท้าย
ที่สำคัญที่สุดคือ คุณต้องทดสอบกระบวนการกู้คืนข้อมูลสำรองอย่างสม่ำเสมอ การสำรองข้อมูลที่ยังไม่ได้รับการทดสอบนั้นเป็นเพียงความหวัง ไม่ใช่แผนการ
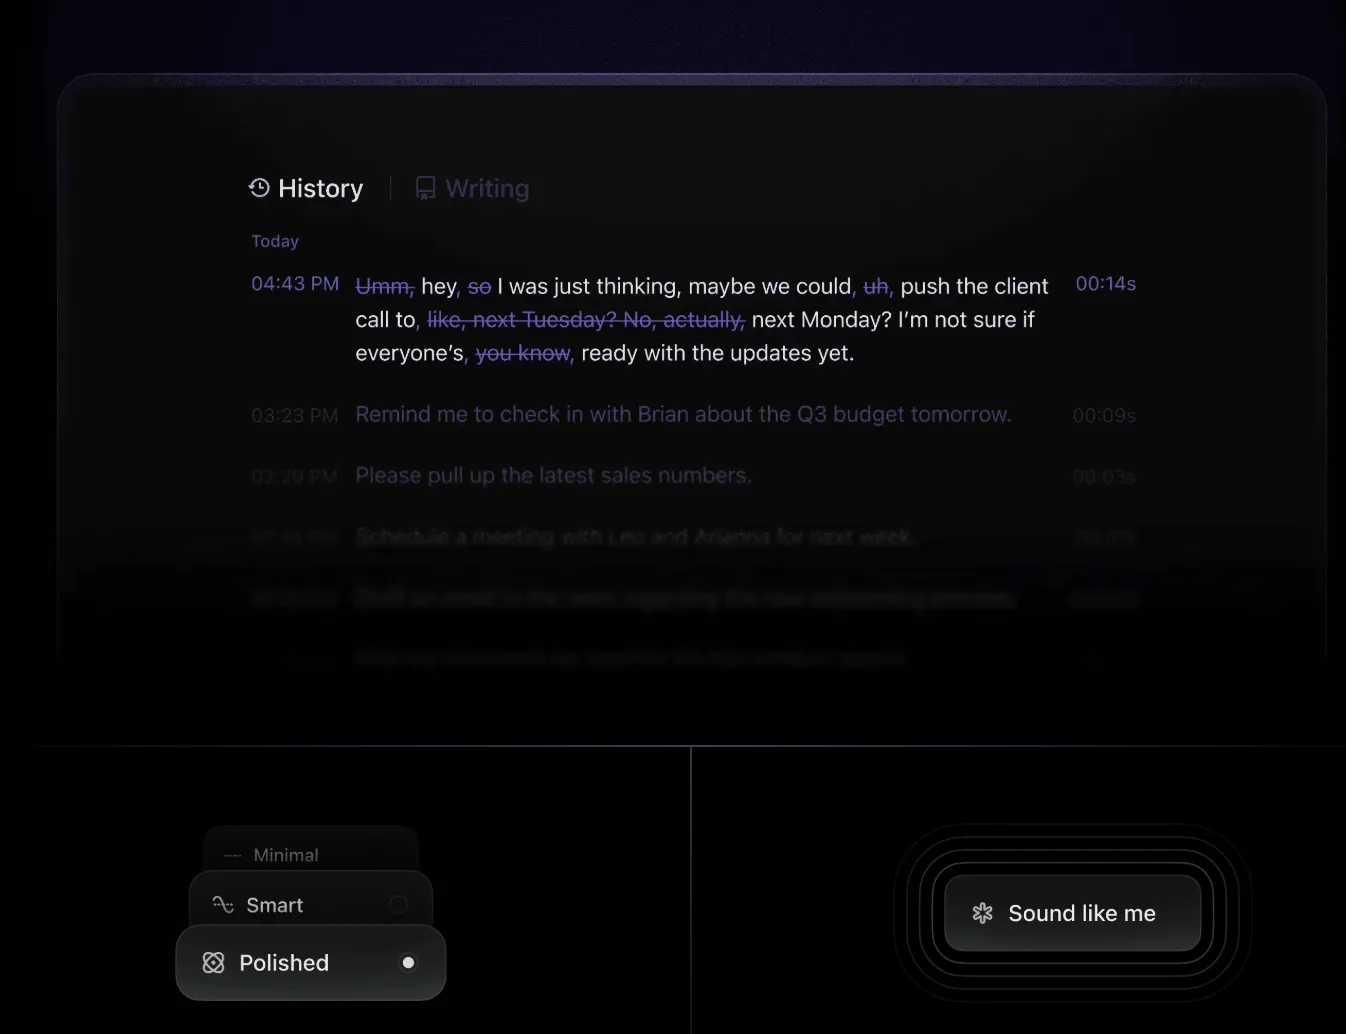
💟 โบนัส: บันทึกข้อมูลสำคัญระหว่างเหตุการณ์ที่สร้างความเครียดสูงด้วยฟีเจอร์แปลงเสียงเป็นข้อความของ ClickUp Brain MAX เพื่อไม่ให้คุณพลาดข้อมูลสำคัญแม้ในสถานการณ์ที่ไม่สะดวกในการพิมพ์ เพียงพูดสิ่งที่คุณสังเกตเห็น แล้วให้ AI จัดการการบันทึกข้อมูลให้
แผนการสื่อสารและการอัปเดตข้อมูลให้กับผู้เกี่ยวข้อง
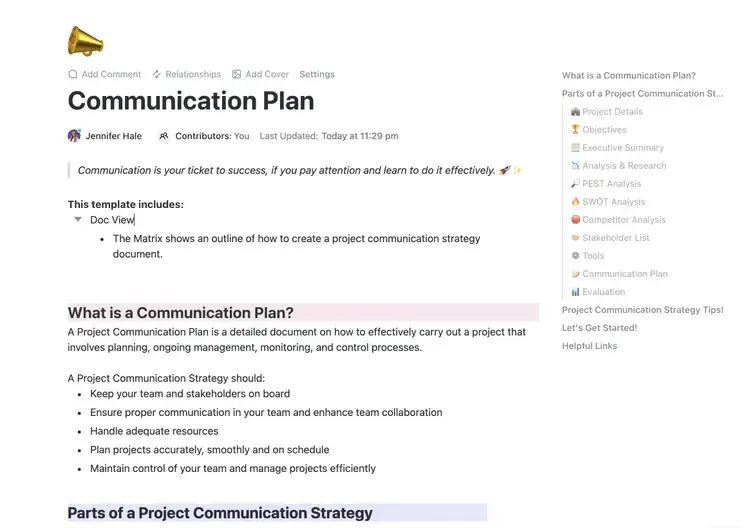
เมื่อเกิดภัยพิบัติแผนการสื่อสารที่ชัดเจนคือสิ่งสำคัญที่สุด แผนของคุณต้องกำหนดลำดับการแจ้งเตือน ความถี่ในการอัปเดตข้อมูล และช่องทางการสื่อสารที่จะใช้สำหรับแต่ละประเภทของเหตุการณ์
กลุ่มต่าง ๆ ต้องการข้อมูลที่แตกต่างกัน:
- ทีมภายใน: ต้องการรายละเอียดทางเทคนิคและขั้นตอนการดำเนินการที่เฉพาะเจาะจง
- ลูกค้า: จำเป็นต้องทราบสถานะบริการและคาดการณ์ว่าปัญหาจะได้รับการแก้ไขเมื่อใด
- ผู้จำหน่าย: อาจจำเป็นต้องติดต่อเพื่อขอความช่วยเหลือหรือส่งเรื่องไปยังระดับที่สูงขึ้น
- หน่วยงานกำกับดูแล: อาจต้องการการแจ้งให้ทราบอย่างเป็นทางการ ขึ้นอยู่กับอุตสาหกรรมของคุณ
เครื่องมืออย่างแม่แบบแผนการสื่อสารที่พร้อมใช้งานจาก ClickUp นี้ สามารถช่วยคุณดำเนินการได้อย่างรวดเร็วขึ้นด้วยขั้นตอนที่กำหนดไว้ล่วงหน้าในช่วงวิกฤต
โปรแกรมการทดสอบและการฝึกอบรม
แผนที่ไม่ได้ทดสอบเลยคือแผนที่จะล้มเหลว การทดสอบอย่างสม่ำเสมอจะช่วยเปิดเผยจุดอ่อนและช่องว่างก่อนที่ภัยพิบัติจริงจะเกิดขึ้น
กำหนดการทดสอบประเภทต่าง ๆ ตลอดทั้งปี:
- การฝึกซ้อมบนโต๊ะ: ทีมของคุณจะจำลองสถานการณ์ภัยพิบัติบนกระดาษเพื่อตรวจสอบความสมเหตุสมผลของแผน
- การเปลี่ยนระบบแบบบางส่วน: คุณจะทดสอบการกู้คืนของส่วนประกอบหรือบริการเฉพาะที่ไม่สำคัญ
- การทดสอบการกู้คืนจากภัยพิบัติแบบเต็มรูปแบบ: คุณดำเนินการเปลี่ยนระบบไปยังระบบสำรองอย่างสมบูรณ์ (การทดสอบขั้นสูงสุด)
หลังการทดสอบทุกครั้ง ให้อัปเดตเอกสารและฝึกอบรมสมาชิกทีมใหม่เกี่ยวกับขั้นตอนการดำเนินการทันที
📖 อ่านเพิ่มเติม: วิธีพัฒนานโยบายและขั้นตอน IT ที่มีประสิทธิภาพ
ขั้นตอนการสร้างแผนการกู้คืนระบบ IT หลังเกิดภัยพิบัติ
การสร้างแผนการกู้คืนหลังภัยพิบัติ (DR) ไม่จำเป็นต้องเป็นเรื่องที่ซับซ้อนหรือยากลำบาก
นี่คือวิธีที่คุณสามารถดำเนินการทีละขั้นตอนได้ 🙌
ขั้นตอนที่ 1: สร้างรายการสินทรัพย์
คุณไม่สามารถปกป้องสิ่งที่คุณไม่ทราบว่ามีอยู่ได้ เริ่มต้นด้วยการสร้างรายการสินทรัพย์ที่ระบุทุกชิ้นส่วนฮาร์ดแวร์ ซอฟต์แวร์ ที่เก็บข้อมูล และความพึ่งพาระบบในสภาพแวดล้อมของคุณ อย่าลืมรวมข้อมูลติดต่อของผู้จำหน่าย รหัสใบอนุญาต และรายละเอียดการตั้งค่า เพื่อใช้เป็นข้อมูลอ้างอิงอย่างรวดเร็วระหว่างกระบวนการกู้คืน
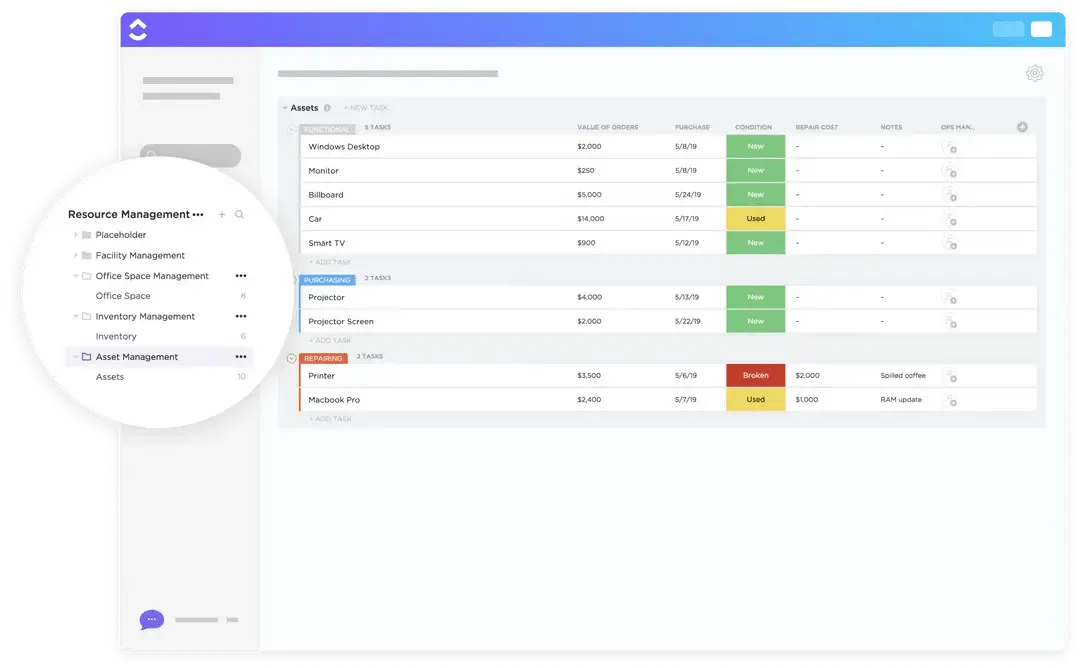
เทมเพลต ClickUp ITAMรวมการจัดการเหตุการณ์ การจัดการปัญหา การจัดการการเปลี่ยนแปลง โซลูชันการจัดการสินทรัพย์แบบง่าย และการจัดการความรู้เทมเพลต ITSM Known Errorsของเราช่วยให้การติดตามข้อผิดพลาดที่ทราบในระบบของคุณง่ายขึ้นสำรวจเทมเพลต ITทั้งหมดของเราทันทีที่วัตถุประสงค์ของคุณเปลี่ยนแปลง
ปรับแต่งกระบวนการทำงานตามสไตล์ที่คุณต้องการสำหรับแต่ละขั้นตอนของ ITAM ตั้งแต่การติดตั้งและกำหนดค่า ไปจนถึงการบำรุงรักษาและการเลิกใช้งาน
ขั้นตอนที่ 2: จัดประเภทบริการสำคัญ
ตอนนี้ ให้ระบุสินทรัพย์ใดเป็นสินทรัพย์ที่จำเป็นต่อภารกิจหลัก (mission-critical) และสินทรัพย์ใดเป็นเพียงสินทรัพย์เสริม (nice-to-have) สร้างแผนผังความพึ่งพาของบริการ (service dependency maps) ที่แสดงให้เห็นว่าระบบของคุณเชื่อมต่อและพึ่งพาซึ่งกันและกันอย่างไร ให้ให้ความสำคัญเป็นพิเศษกับบริการที่ติดต่อกับลูกค้า ซึ่งส่งผลโดยตรงต่อรายได้หรือประสบการณ์ของผู้ใช้
🎥 ดูวิดีโอคู่มือปฏิบัติจริงนี้ที่แสดงวิธีการสร้างแผนระดับสูงที่มีโครงสร้างชัดเจนโดยใช้คุณสมบัติอันทรงพลังของ ClickUp — ตั้งแต่การตั้งเป้าหมาย การจัดสรรงาน ไปจนถึงการติดตามความก้าวหน้า
ขั้นตอนที่ 3: ประเมินความเสี่ยงและภัยคุกคาม
ประเมินความเสี่ยงและภัยคุกคามโดยการวิเคราะห์ความน่าจะเป็นและผลกระทบของแต่ละประเภทภัยคุกคามในสถานการณ์เฉพาะของคุณ พิจารณาความเสี่ยงทางภูมิศาสตร์ (คุณอยู่ในเขตแผ่นดินไหวหรือพื้นที่น้ำท่วมหรือไม่?) และภัยคุกคามเฉพาะอุตสาหกรรม (เช่น การเปลี่ยนแปลงกฎระเบียบหรือการโจมตีทางไซเบอร์ที่มีเป้าหมาย) บันทึกทุกอย่างไว้ในทะเบียนความเสี่ยงเพื่อติดตามความเปลี่ยนแปลงตามเวลา

แม่แบบกระดานไวท์บอร์ดการประเมินความเสี่ยงของ ClickUpช่วยเพิ่มมิติทางภาพให้กับกระบวนการประเมินความเสี่ยงของคุณ แม่แบบนี้ช่วยในการประเมินและจัดประเภทความเสี่ยง พร้อมทั้งสร้างแรงบันดาลใจให้ทีมของคุณแบ่งปันข้อมูลเชิงลึกและทำงานร่วมกันในรูปแบบที่น่าสนใจและชัดเจน
แม่แบบนี้ช่วยให้คุณสามารถ:
- ประเมินประเภทความเสี่ยงและผลกระทบที่อาจเกิดขึ้น
- วิเคราะห์ข้อมูลเพื่อระบุพื้นที่ที่อาจก่อให้เกิดปัญหา
- กำหนดมาตรการป้องกันเพื่อลดความเสี่ยง
ด้วยคุณสมบัติที่ช่วยให้คุณสามารถวาด เขียน และเพิ่มโน้ตติดได้ แม่แบบไวท์บอร์ดการจัดการความเสี่ยงนี้จึงเหมาะอย่างยิ่งสำหรับการประเมินความเสี่ยงของโครงการของคุณ
ขั้นตอนที่ 4: กำหนดเป้าหมาย RTO และ RPO
ทำงานร่วมกับผู้มีส่วนได้ส่วนเสียในธุรกิจโดยตรงเพื่อกำหนดว่าพวกเขาถือว่าระยะเวลาหยุดทำงานและการสูญเสียข้อมูลในระดับใดเป็นที่ยอมรับได้สำหรับแต่ละระดับบริการที่คุณได้ระบุไว้ก่อนหน้านี้ คุณจะต้องหาจุดสมดุลระหว่างค่าใช้จ่ายในการกู้คืนที่รวดเร็วขึ้นกับผลกระทบต่อธุรกิจ — ไม่ใช่ทุกบริการที่จำเป็นต้องกู้คืนทันทีโดยไม่สูญเสียข้อมูลเลย ขอรับการอนุมัติจากผู้บริหารระดับสูงสำหรับเป้าหมายเหล่านี้
ขั้นตอนที่ 5: กำหนดเส้นทางสำรองข้อมูลและเส้นทางสลับระบบ
เมื่อกำหนดเป้าหมายแล้ว คุณสามารถออกแบบโซลูชันทางเทคนิคได้ สร้างกลยุทธ์การสำรองข้อมูลที่ปรับให้เหมาะสมกับ RPO ของแต่ละระบบ และวางแผนขั้นตอนการเปลี่ยนระบบสำรองอย่างละเอียด รวมถึงสถานที่ประมวลผลสำรองและวิธีการเข้าถึงในสถานการณ์ฉุกเฉิน ให้รวมแผนผังเครือข่ายและคู่มือดำเนินการแบบทีละขั้นตอนเพื่อทำให้การดำเนินการเป็นไปอย่างราบรื่นและไม่มีข้อผิดพลาด
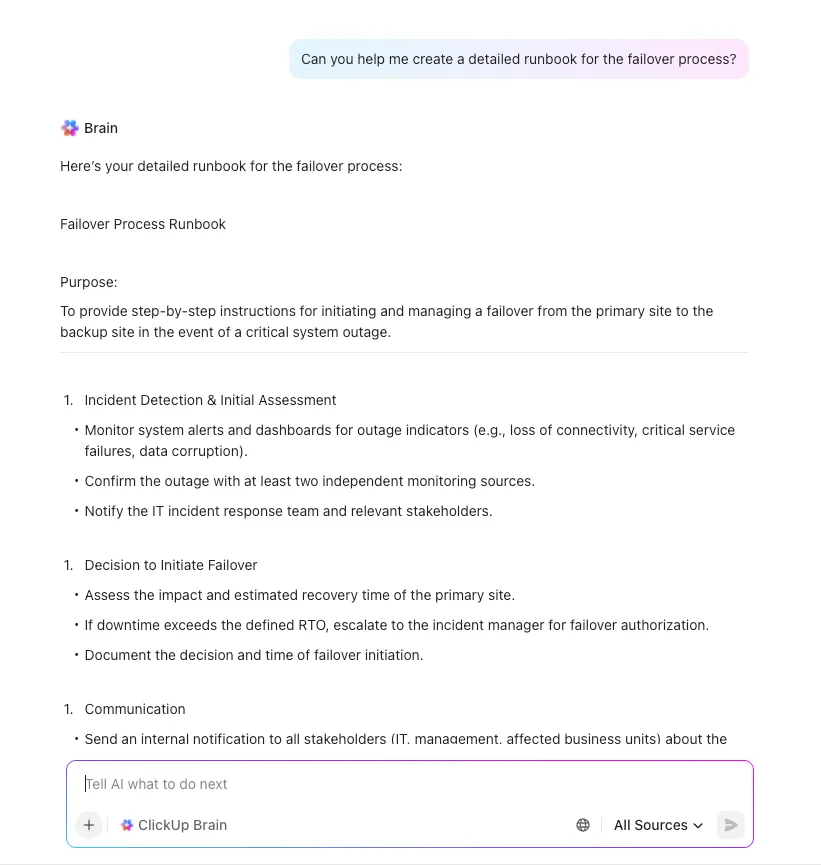
ขั้นตอนที่ 6: กำหนดบทบาทและขั้นตอนการรายงานปัญหา
กำหนดโครงสร้างทีมการกู้คืนหลังภัยพิบัติ (DR) ด้วยความรับผิดชอบและอำนาจการตัดสินใจที่ชัดเจน สร้างรายชื่อผู้ติดต่อที่ครบถ้วน พร้อมระบุบุคลากรหลักและสำรองสำหรับแต่ละบทบาท แมทริกซ์ RACI (Responsible, Accountable, Consulted, Informed) เป็นเครื่องมือที่มีประสิทธิภาพในการป้องกันความสับสนระหว่างเหตุการณ์ที่มีความเครียดสูง
ขั้นตอนที่ 7: บันทึกและสื่อสารแผน
บันทึกและสื่อสารแผนด้วยขั้นตอนที่ชัดเจนและเป็นลำดับขั้น ซึ่งสมาชิกในทีมทุกคนสามารถปฏิบัติตามได้ แม้ในสถานการณ์ที่กดดัน การเก็บเอกสารนี้ไว้ในสถานที่ที่เข้าถึงได้ง่ายและแยกจากโครงสร้างพื้นฐานหลักของคุณเป็นสิ่งสำคัญอย่างยิ่ง ให้แน่ใจว่าสมาชิกในทีมทุกคนรู้อย่างแน่ชัดว่าจะหาแผนนี้ได้ที่ไหนในช่วงวิกฤต

ปรับปรุงการวางแผนโครงการให้ราบรื่นยิ่งขึ้นด้วยแม่แบบการวางแผน RACI ของ ClickUp แม่แบบเอกสารนี้จะเป็นตัวเปลี่ยนเกม โดยให้แผนภูมิที่ชัดเจนเพื่อกำหนดบทบาทและความรับผิดชอบของทีมที่เกี่ยวข้องกับงานโครงการ นำกรอบงาน RACI (Responsible, Accountable, Consulted, and Informed) มาใช้เพื่อให้ทุกคนเข้าใจตรงกัน พร้อมทั้งรับประกันความรับผิดชอบและความสอดคล้องกับเป้าหมายขององค์กร
ขั้นตอนที่ 8: ทดสอบ ตรวจสอบ และปรับปรุง
สุดท้าย ให้กำหนดการทดสอบทุกไตรมาสเพื่อตรวจสอบความถูกต้องของขั้นตอนและระบุจุดอ่อนที่อาจมี จดบันทึกบทเรียนที่ได้รับจากแต่ละการทดสอบและเหตุการณ์จริงที่เกิดขึ้น และใช้ข้อมูลเหล่านั้นเพื่อปรับปรุงแผนของคุณ สร้างระบบติดตามการปรับปรุงอย่างเป็นระบบเพื่อให้มั่นใจว่าปัญหาที่พบจะได้รับการแก้ไข
🌼 คุณรู้หรือไม่: ในปี 2017 GitLab ได้ประสบปัญหาการหยุดทำงานของฐานข้อมูลอย่างรุนแรง ระหว่างกระบวนการกู้คืน พวกเขาค้นพบว่าวิธีการสำรองข้อมูลหลายวิธีได้ล้มเหลวอย่างเงียบๆ มาเป็นเวลาหลายวัน เหตุการณ์นี้ได้สอนบทเรียนสำคัญให้กับอุตสาหกรรมเทคโนโลยีทั้งหมด: การตรวจสอบความถูกต้องของข้อมูลสำรองเป็นสิ่งที่ไม่อาจประนีประนอมได้ ข้อมูลสำรองที่ยังไม่ผ่านการทดสอบนั้น แท้จริงแล้วไม่ใช่ข้อมูลสำรองเลย
🌼 คุณรู้ไหม: ในปี 2017 GitLab ได้ประสบกับปัญหาการหยุดทำงานของฐานข้อมูลอย่างรุนแรง ระหว่างกระบวนการกู้คืน พวกเขาพบว่าวิธีการสำรองข้อมูลหลายวิธีได้ล้มเหลวอย่างเงียบๆ มาหลายวันแล้ว เหตุการณ์นี้ได้สอนบทเรียนสำคัญให้กับอุตสาหกรรมเทคโนโลยีทั้งหมด: การตรวจสอบความถูกต้องของข้อมูลสำรองเป็นสิ่งที่ไม่อาจประนีประนอมได้ ข้อมูลสำรองที่ยังไม่ผ่านการทดสอบนั้น แท้จริงแล้วไม่ใช่ข้อมูลสำรองเลย
กลยุทธ์และโซลูชันการกู้คืนหลังภัยพิบัติ
ไม่ทุกองค์กรจำเป็นต้องใช้วิธีการฟื้นฟูหลังภัยพิบัติแบบเดียวกัน มาสำรวจตัวเลือกต่าง ๆ ของคุณตามงบประมาณ ความต้องการในการฟื้นฟู และทรัพยากรที่มีอยู่กันเถอะ
วิธีการสำรองและกู้คืนข้อมูล
นี่คือวิธีที่ง่ายที่สุดและประหยัดค่าใช้จ่ายที่สุด โดยต้องทำการสำรองข้อมูลอย่างสม่ำเสมอไปยังสถานที่นอกสถานที่ (เช่น บนคลาวด์หรือศูนย์ข้อมูลสำรอง) และจากนั้นกู้คืนข้อมูลด้วยมือเมื่อจำเป็น วิธีนี้เหมาะที่สุดสำหรับระบบที่ไม่สำคัญ ซึ่งสามารถทนต่อ RTO ที่ยาวนานได้ เนื่องจากการกู้คืนอาจใช้เวลาหลายชั่วโมงหรือแม้กระทั่งหลายวัน
ความพร้อมใช้งานสูงและความซ้ำซ้อน
กลยุทธ์นี้มีวัตถุประสงค์เพื่อขจัดจุดล้มเหลวเดียว (single point of failure) โดยใช้ระบบที่ทำงานอยู่หลายระบบ เทคนิคต่าง ๆ เช่น การกระจายโหลด (load balancing) การจัดกลุ่มเซิร์ฟเวอร์ (server clustering) และระบบจัดเก็บข้อมูล RAID จะรับประกันว่าหากส่วนประกอบหนึ่งเกิดข้อผิดพลาด ส่วนประกอบอื่นจะรับหน้าที่ทันที แม้ว่าการติดตั้งและบำรุงรักษาจะมีค่าใช้จ่ายสูงกว่า แต่วิธีการนี้สามารถลดเวลาหยุดทำงานลงเหลือเพียงไม่กี่วินาทีหรือไม่กี่นาที ทำให้เป็นตัวเลือกที่เหมาะสมที่สุดสำหรับบริการที่สำคัญ
ตัวเลือกการคัดลอกข้อมูลและการเปลี่ยนระบบอัตโนมัติเมื่อเกิดข้อผิดพลาด
การคัดลอกข้อมูล (Replication) คือการคัดลอกข้อมูลไปยังไซต์สำรองในแบบเกือบเรียลไทม์ ซึ่งช่วยลดการสูญเสียข้อมูลให้น้อยที่สุดเมื่อเกิดภัยพิบัติ
- การคัดลอกแบบซิงโครนัส: เขียนข้อมูลไปยังทั้งไซต์หลักและไซต์รองพร้อมกัน ซึ่งรับประกันว่าไม่มีการสูญเสียข้อมูลเลย อย่างไรก็ตาม วิธีนี้ต้องการแบนด์วิธสูงและอาจทำให้ระบบหลักทำงานช้าลง
- การคัดลอกแบบไม่พร้อมกัน: เขียนข้อมูลไปยังไซต์หลักก่อน แล้วจึงคัดลอกไปยังไซต์รองด้วยความล่าช้าเล็กน้อย วิธีนี้มีค่าใช้จ่ายต่ำกว่าและส่งผลกระทบต่อประสิทธิภาพน้อยลง แต่คุณต้องยอมรับความเสี่ยงเล็กน้อยในการสูญเสียข้อมูล
การกู้คืนหลังภัยพิบัติบนคลาวด์และ DRaaS
บริการการกู้คืนหลังภัยพิบัติ (Disaster Recovery as a Service: DRaaS) ได้กลายเป็นตัวเลือกยอดนิยมสำหรับธุรกิจหลายแห่ง โดยให้บริการด้วยระบบการจ่ายตามการใช้งาน (pay-as-you-go) การกระจายทางภูมิศาสตร์แบบทันที และการจัดการการกู้คืนอัตโนมัติ โดยไม่จำเป็นต้องสร้างและดูแลรักษาศูนย์กู้คืนหลังภัยพิบัติทางกายภาพของตนเอง บริการ DR บนคลาวด์ช่วยลดค่าใช้จ่ายทุนมหาศาลในการสร้างศูนย์ข้อมูลสำรอง พร้อมทั้งให้การขยายขนาดที่รวดเร็วขึ้นและความยืดหยุ่นมากกว่าวิธีการใช้ศูนย์กู้คืนแบบร้อน (hot), แบบอุ่น (warm) หรือแบบเย็น (cold) แบบดั้งเดิม
วิธีที่ ClickUp ช่วยปรับปรุงกระบวนการวางแผนการกู้คืนระบบ IT หลังเกิดภัยพิบัติ
การจัดการแผนการกู้คืนหลังภัยพิบัติ (DR) ผ่านสเปรดชีต เอกสาร และสายอีเมลที่กระจัดกระจายกันนั้น ก่อให้เกิดความเสี่ยงต่อภัยพิบัติในตัวมันเอง
การขยายตัวของงานประเภทนี้ การกระจายงานไปทั่วเครื่องมือหลายตัวที่ไม่เชื่อมต่อกันและไม่สามารถสื่อสารกันได้ รวมถึงการขยายตัวของบริบท ซึ่งทำให้ทีมต้องเสียเวลาหลายชั่วโมงในการค้นหาข้อมูลที่กระจายอยู่ทั่วแอปพลิเคชันและแพลตฟอร์มต่าง ๆ จะนำไปสู่ความสับสน ข้อมูลที่ล้าสมัย และเวลาตอบสนองที่ช้า ในขณะทุกวินาทีล้วนสำคัญ
ด้วยClickUp Converged AI Workspace— แพลตฟอร์มเดียวที่ปลอดภัย ซึ่งรวมแอปทำงาน ข้อมูล และกระบวนการทำงานทั้งหมดของคุณไว้ในที่เดียว พร้อมด้วย AI ที่เข้าใจบริบทเป็นชั้นปัญญา — ที่ผสานการจัดการโครงการ การจัดทำเอกสาร และการสื่อสารในทีมเข้าด้วยกัน หยุดการต้องสลับไปมาระหว่างแพลตฟอร์มหลายตัว และนำการวางแผนการกู้คืนหลังภัยพิบัติ (DR) การทดสอบ และการตอบสนองต่อเหตุการณ์ผิดปกติมาไว้ในระบบเดียวที่รวมเป็นหนึ่ง
เอกสารการกู้คืนหลังภัยพิบัติแบบรวมศูนย์ด้วย ClickUp Docs และระบบช่วยเหลือ AI ที่มาพร้อมในตัว
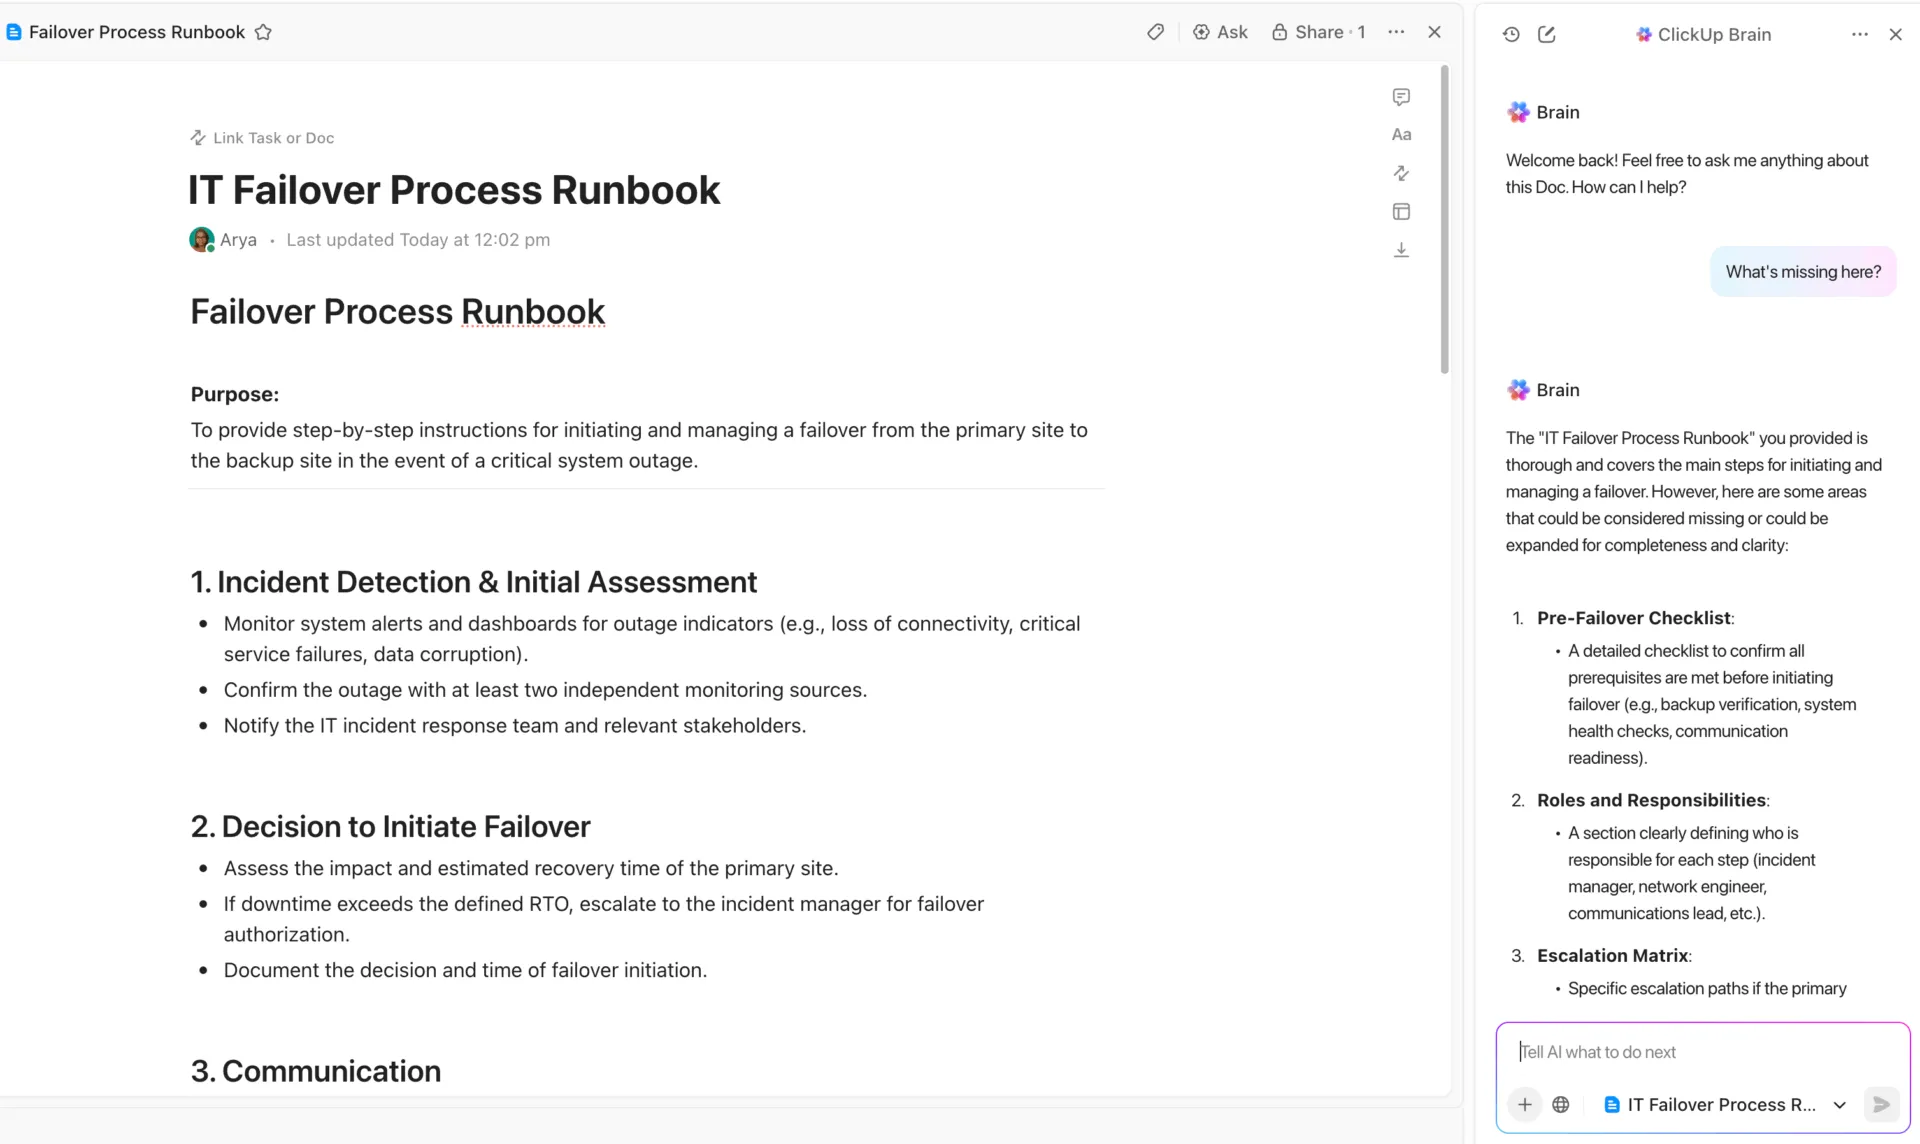
รับรองว่าทีมของคุณจะมีแหล่งข้อมูลที่เชื่อถือได้เพียงแหล่งเดียวเสมอด้วยClickUp Docs
สร้างแผนการกู้คืนหลังภัยพิบัติทั้งหมดของคุณในพื้นที่ทำงานร่วมกัน ที่ทุกคนสามารถมีส่วนร่วมแบบเรียลไทม์ได้เมื่อเกิดเหตุการณ์ไม่คาดคิด เชื่อมต่อเอกสาร (Docs) เข้ากับงานและโครงการที่เกี่ยวข้องกับเหตุการณ์โดยตรง เพื่อการนำทางที่ราบรื่น และฝังแผนภาพหรือคู่มือการดำเนินการ (runbooks) เพื่อให้ข้อมูลสำคัญอยู่ตรงที่คุณต้องการ
ที่สำคัญที่สุดคือ คุณสามารถปกป้องเอกสารเพื่อป้องกันการแก้ไขโดยไม่ได้ตั้งใจ และใช้สิทธิ์การเข้าถึงของ ClickUpที่ละเอียดเพื่อควบคุมว่าใครสามารถดูหรือเปลี่ยนแปลงขั้นตอนการกู้คืนข้อมูลที่ละเอียดอ่อนได้ ทุกการเปลี่ยนแปลงจะถูกบันทึกไว้ในประวัติของเอกสาร ทำให้คุณมีบันทึกการตรวจสอบที่ครบถ้วน
การสร้างแผนด้วย AI ผ่าน ClickUp Brain
เร่งการวางแผนการกู้คืนหลังภัยพิบัติและกำจัดช่องว่างสำคัญด้วยClickUp Brain— ผู้ช่วย AI ที่เข้าใจบริบทและเข้าใจพื้นที่ทำงานของคุณอย่างครบถ้วน ต่างจากเครื่องมือ AI ทั่วไป ClickUp Brain ใช้ประโยชน์จากงาน เอกสาร และกระบวนการทำงานจริงขององค์กรคุณ เพื่อมอบการสนับสนุนที่แม่นยำและสามารถนำไปปฏิบัติได้จริงสำหรับโครงการกู้คืนหลังภัยพิบัติ
เพียงให้คำสั่งกับ ClickUp Brain ด้วยคำขอ เช่น “สร้างรายการตรวจสอบการกู้คืนหลังภัยพิบัติสำหรับแพลตฟอร์มอีคอมเมิร์ซของเรา” และคุณจะได้รับเทมเพลตที่ครบถ้วนและปรับแต่งให้เหมาะสมกับระบบ กระบวนการ และข้อกำหนดด้านการปฏิบัติตามกฎระเบียบของคุณทันที เทมเพลตนี้สามารถช่วยคุณในเรื่องต่อไปนี้:
- การเข้าใจบริบท: ClickUp Brain มีสิทธิ์เข้าถึงโครงสร้าง เนื้อหา และสิทธิ์การเข้าถึงในพื้นที่ทำงานของคุณ มันสามารถอ้างอิงงาน เอกสาร ความคิดเห็น และแม้กระทั่งแอปที่เชื่อมต่อได้ เพื่อให้คำตอบและขั้นตอนการดำเนินการที่ปรับให้เหมาะสมกับงานจริงของคุณ — ไม่ใช่เพียงคำแนะนำทั่วไป
- การแก้ไขปัญหาและคำแนะนำ: แก้ไขปัญหาทันที รับคำแนะนำทีละขั้นตอน หรือสอบถามแนวทางปฏิบัติที่ดีที่สุดสำหรับฟีเจอร์ใด ๆ ของ ClickUp Brain สามารถนำคุณผ่านกระบวนการที่ซับซ้อน อัตโนมัติงานที่ทำซ้ำ ๆ และช่วยแก้ไขอุปสรรคต่าง ๆ
- การอัตโนมัติและการเร่งความเร็วของกระบวนการทำงาน: ใช้เอเยนต์ AI ที่สร้างไว้ล่วงหน้าหรือปรับแต่งเองเพื่ออัตโนมัติกระบวนการทำงานหลายขั้นตอน จัดลำดับความสำคัญของคำขอ หรือจัดการงานที่เกิดขึ้นซ้ำๆ — ช่วยประหยัดเวลาหลายชั่วโมงทุกสัปดาห์
- การค้นหาเชิงลึก: ค้นหาข้อมูลที่ซ่อนอยู่ทุกที่ในพื้นที่ทำงานของคุณ รวมถึงงาน เอกสาร และเครื่องมือที่ผสานรวม แม้ข้อมูลนั้นจะมีอายุหลายปีหรือยากที่จะค้นหาด้วยเครื่องมือค้นหาทั่วไป
- สรุปและอัปเดตแบบเรียลไทม์: สร้างอัปเดตโครงการ สรุปการประชุม หรือรายงานความคืบหน้าได้ทันที โดยดึงข้อมูลจากพื้นที่ทำงานแบบเรียลไทม์
- การเรียบง่ายเอกสารทางเทคนิค: แปลงเอกสารทางเทคนิคที่ซับซ้อนให้เป็นขั้นตอนหรือรายการตรวจสอบที่ชัดเจนและสามารถนำไปปฏิบัติได้ ซึ่งทีมของคุณสามารถทำตามได้ แม้ในสถานการณ์ที่กดดัน
- ระบบปัญญาประดิษฐ์แบบหลายโมเดล: เลือกจากโมเดล AI ชั้นนำ (OpenAI GPT-4.1, GPT-5, Claude, Gemini และอื่นๆ) เพื่อผลลัพธ์ที่ดีที่สุดในทุกงาน — ไม่จำเป็นต้องสมัครสมาชิกแยกต่างหาก
- ปลอดภัยและคำนึงถึงสิทธิ์การเข้าถึง: Brain จะเข้าถึงข้อมูลเฉพาะที่คุณมีสิทธิ์ดูเท่านั้น เพื่อรักษามาตรฐานความเป็นส่วนตัวและการปฏิบัติตามกฎระเบียบอย่างเคร่งครัด
- อินเทอร์เฟซแบบสนทนา: ใช้ @brain ในส่วนความคิดเห็นหรือแชทเพื่อรับข้อมูลเชิงลึกตามบริบท สร้างข้อความตอบกลับแบบร่าง หรือเรียกใช้ระบบอัตโนมัติโดยไม่ต้องออกจากขั้นตอนการทำงานของคุณ
- คำสั่งที่กำหนดเองและกระบวนการทำงานที่บันทึกไว้: บันทึกและใช้คำสั่งซ้ำสำหรับความต้องการที่เกิดขึ้นบ่อยครั้ง เพื่อรับประกันความสม่ำเสมอและประหยัดเวลาให้กับทีมของคุณ
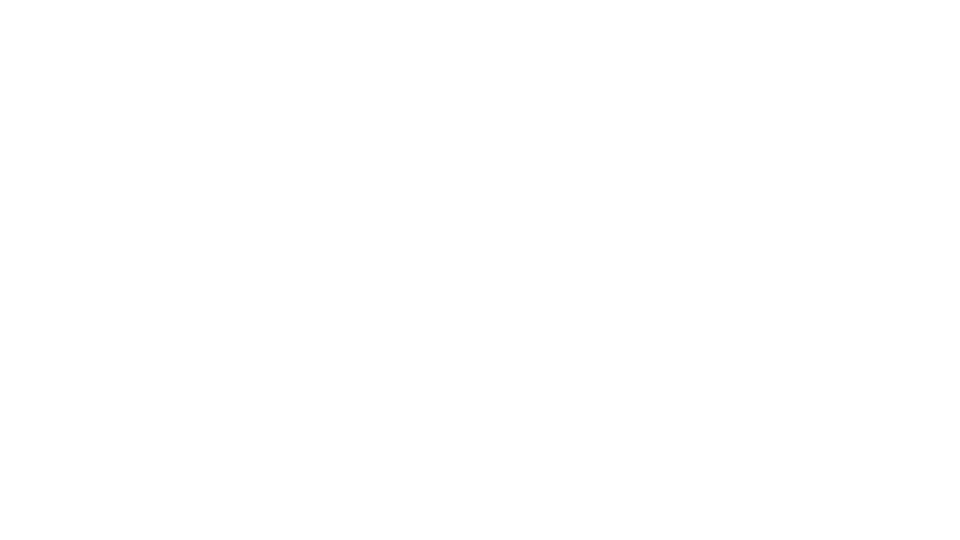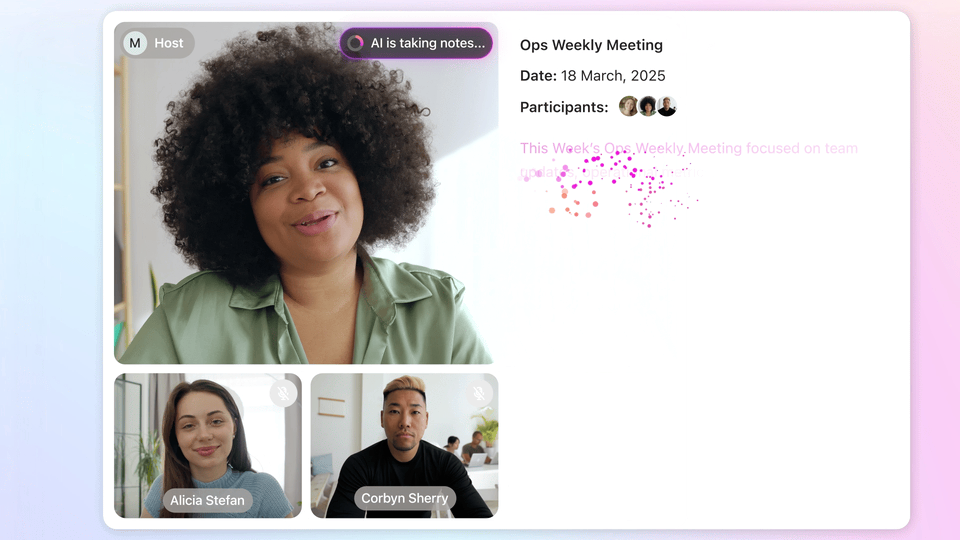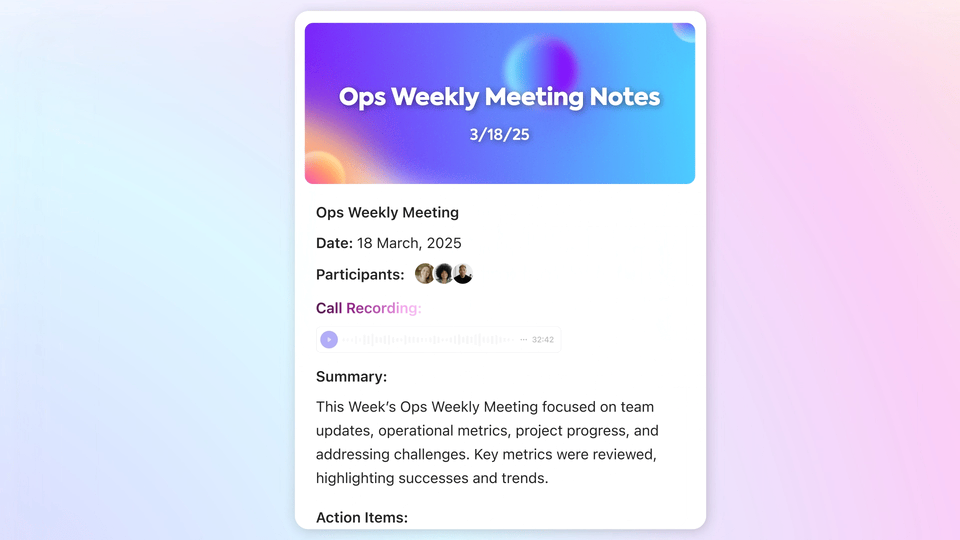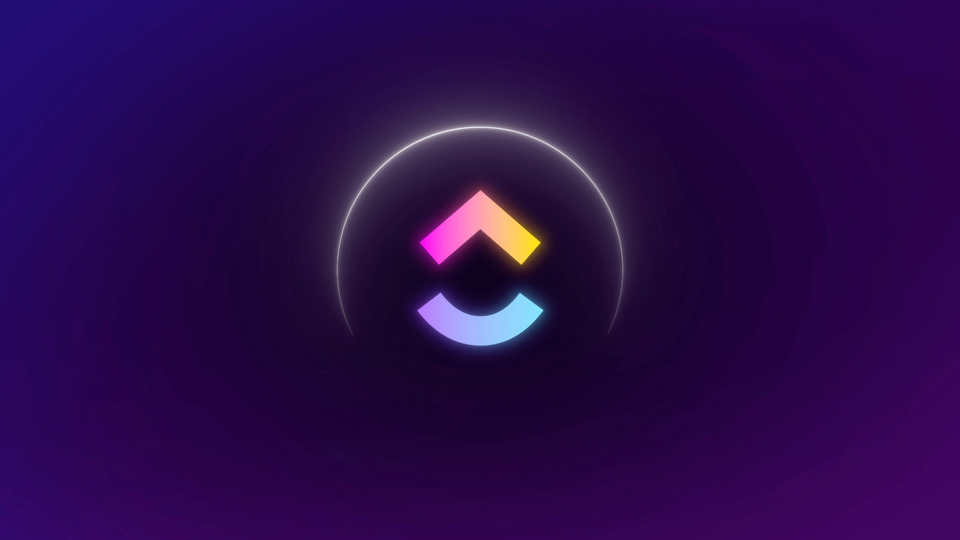
💡เคล็ดลับจากผู้เชี่ยวชาญ: อย่าพลาดบทเรียนใดจากประชุมทบทวนเหตุการณ์โดยบันทึกทุกรายละเอียดด้วยClickUp AI Notetaker มันสามารถเข้าร่วมประชุมออนไลน์ของคุณ แปลงคำพูดทั้งหมดเป็นข้อความ และสร้างรายการงานที่ต้องดำเนินการโดยอัตโนมัติจากบทเรียนที่ได้รับ สิ่งนี้ช่วยสร้างประวัติเหตุการณ์ที่สามารถค้นหาได้ ทำให้คุณสามารถอ้างอิงเหตุการณ์ในอดีตและวิธีแก้ไขได้อย่างรวดเร็ว
กระบวนการทำงานอัตโนมัติสำหรับการกู้คืนหลังภัยพิบัติด้วย ClickUp Automations
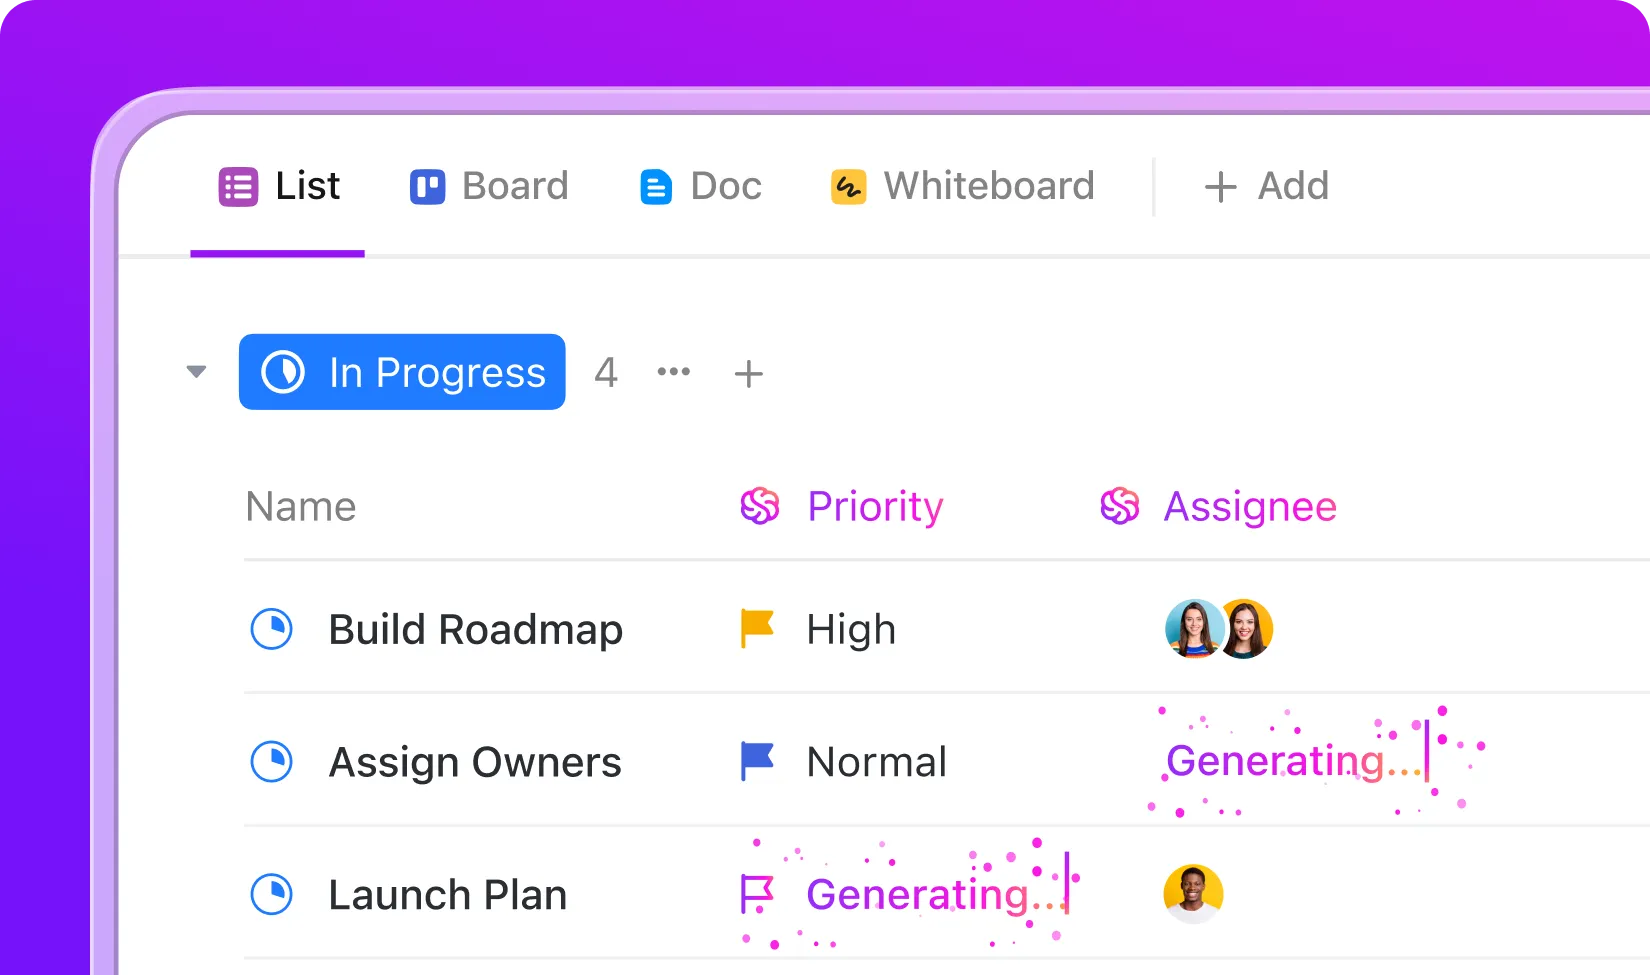
ลองจินตนาการว่าทีมของคุณกำลังเผชิญกับปัญหาการหยุดทำงานอย่างกะทันหัน — ทุกวินาทีล้วนสำคัญ และคุณไม่สามารถพลาดขั้นตอนใดได้ ด้วยClickUp AI AgentsและAutomations คุณไม่จำเป็นต้องตื่นตระหนกหรือพึ่งพาความจำ เมื่อมีเหตุการณ์ถูกประกาศขึ้น AI ของ ClickUp จะเริ่มทำงานทันที โดยนำทางทีมของคุณและจัดการงานที่ซ้ำซาก เพื่อให้คุณสามารถมุ่งเน้นไปที่การแก้ไขปัญหา
นี่คือวิธีการทำงานในสถานการณ์จริง:
- เมื่อมีผู้ใช้กำหนดสถานะของงานเป็น “Incident Declared” ClickUp Agent จะสร้างรายการตรวจสอบขั้นตอนการตอบสนองโดยอัตโนมัติ มอบหมายงานให้กับผู้รับผิดชอบที่เหมาะสม และเริ่มจับเวลาเพื่อติดตามระยะเวลาที่ใช้ในการกู้คืน
- หากเหตุการณ์ถูกกำหนดเป็น “วิกฤต” ตัวแทนสามารถส่งอีเมลแจ้งเตือนไปยังทีมผู้นำของคุณได้ทันที และตั้งห้องแชทพิเศษ — “ห้องบัญชาการ” ของคุณ — เพื่อให้ทุกคนสามารถสื่อสารกันได้ในที่เดียว
- ระบบ AI สามารถเรียกดูรายงานเหตุการณ์ในอดีตและเอกสารที่เกี่ยวข้องได้ ทำให้ทีมของคุณมีทุกสิ่งที่จำเป็นอยู่ภายในมือ
ดูขั้นตอนการทำงานได้ที่นี่:
ด้วย ClickUp AI Agents คุณจะได้รับเพื่อนร่วมงานดิจิทัลที่น่าเชื่อถือ ซึ่งช่วยให้ทีมของคุณรักษาความสงบ ความเป็นระเบียบ และประสิทธิภาพการทำงาน — แม้ในสถานการณ์ที่กดดัน
ติดตามข้อมูลแบบเรียลไทม์ด้วย ClickUp Dashboards
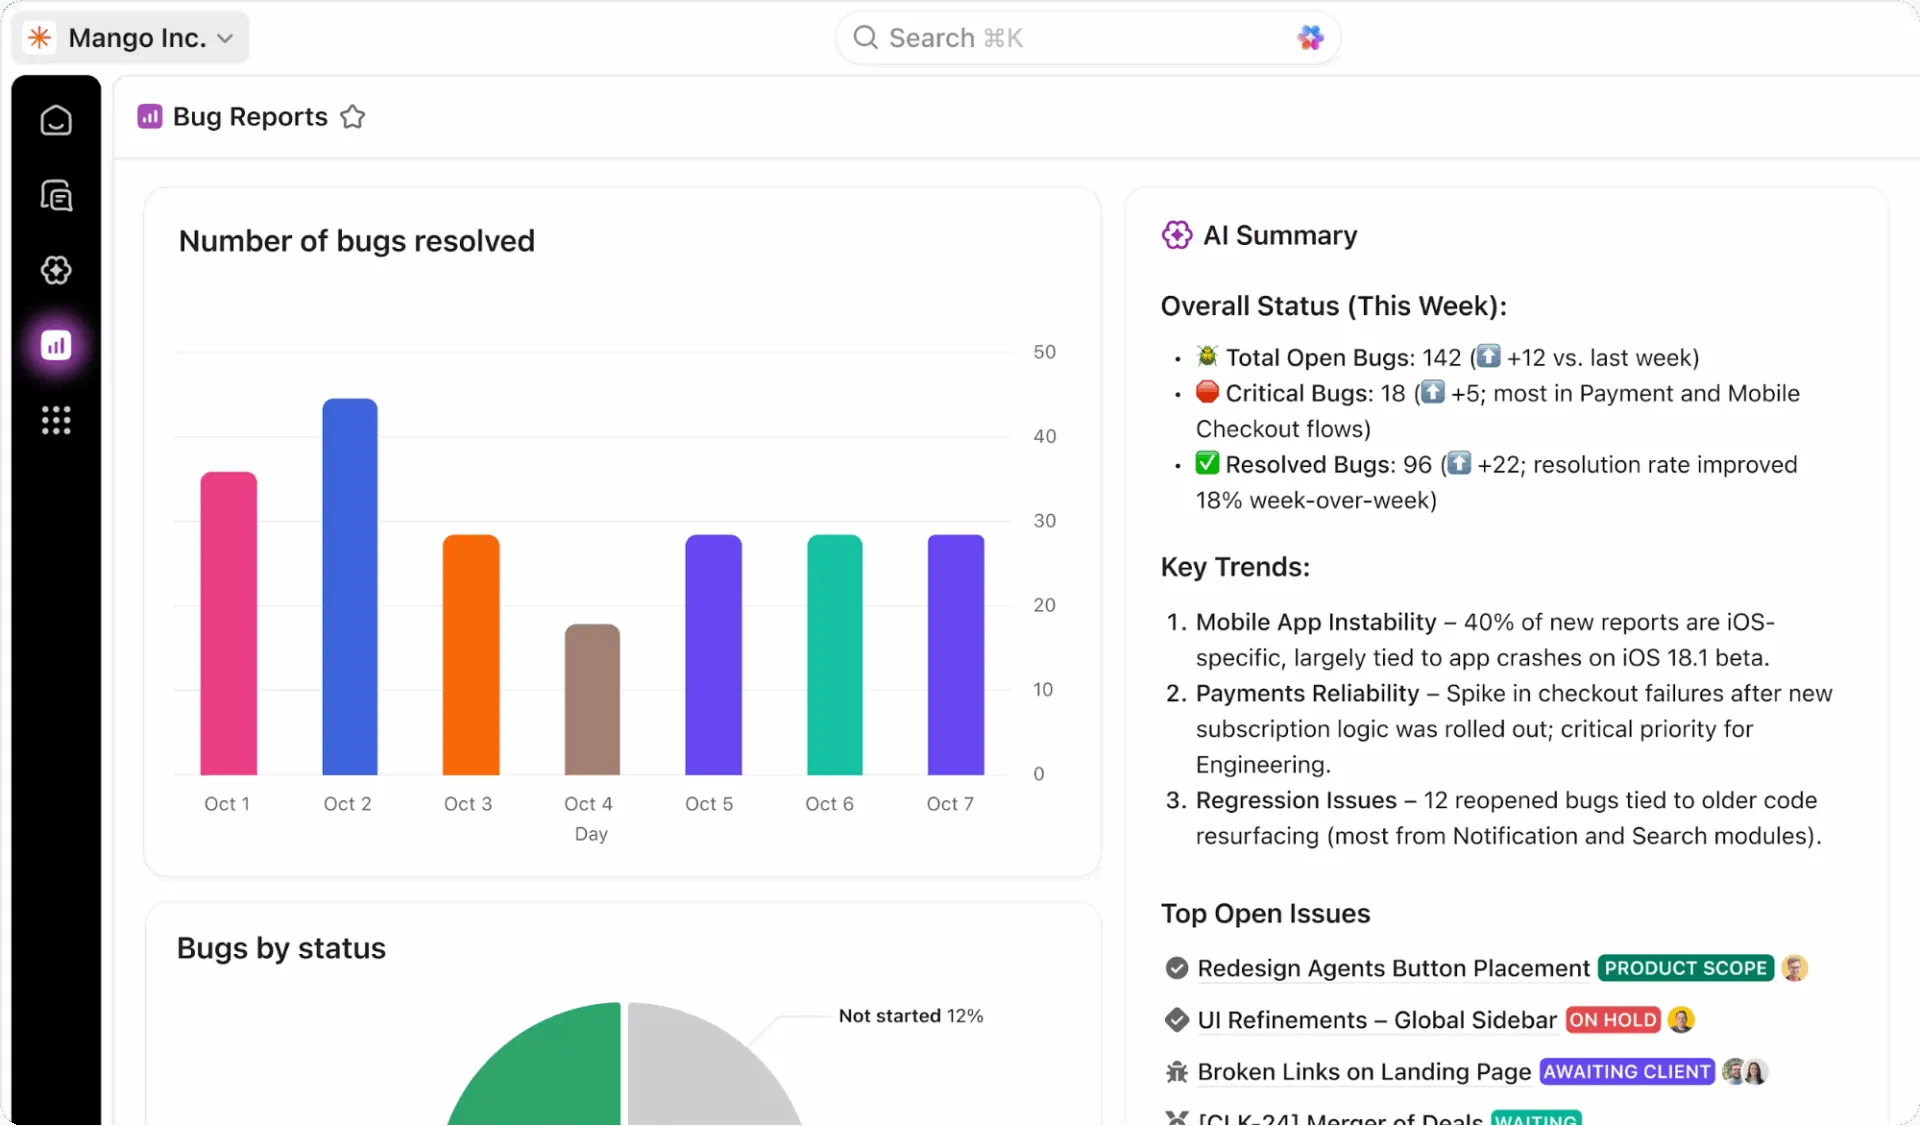
รับภาพรวมที่ครบถ้วนเกี่ยวกับสถานะของโปรแกรมการกู้คืนหลังภัยพิบัติ (DR) โดยติดตามทุกสิ่งแบบเรียลไทม์ด้วยClickUp Dashboards คุณสามารถสร้างวิดเจ็ตเพื่อติดตามประสิทธิภาพ RTO และ RPO ระหว่างการทดสอบ ติดตามอัตราการเสร็จสิ้นการทดสอบ และดูแนวโน้มของเหตุการณ์ตามช่วงเวลา
เพิ่มClickUp Custom Fieldsลงในงานของคุณเพื่อติดตามระดับความสำคัญของระบบ สถานะการกู้คืน และผลการทดสอบ จากนั้นนำข้อมูลทั้งหมดมารวมไว้ในมุมมองระดับสูงเดียว แดชบอร์ดเหล่านี้จะให้รายงานที่พร้อมสำหรับผู้บริหาร ซึ่งอัปเดตอยู่เสมอด้วยข้อมูลแบบเรียลไทม์จากกิจกรรมการทดสอบและการตอบสนองต่อเหตุการณ์ของทีมคุณ
📖 อ่านเพิ่มเติม: วิธีสร้างรายการตรวจสอบการประเมินความเสี่ยง
สร้างแผนการกู้คืนหลังภัยพิบัติของคุณวันนี้
ทุกวันที่คุณดำเนินการโดยไม่มีแผนการกู้คืนหลังภัยพิบัติ (DR) ก็เหมือนกับการพนันที่คุณไม่สามารถรับความเสี่ยงได้ ภัยพิบัติเป็นสิ่งที่หลีกเลี่ยงไม่ได้ — ไม่ว่าจะเกิดจากธรรมชาติ ความล้มเหลวทางเทคโนโลยี หรือความผิดพลาดของมนุษย์ — แต่การเตรียมตัวของคุณคือปัจจัยที่กำหนดว่าภัยพิบัติเหล่านั้นจะกลายเป็นความไม่สะดวกเล็กน้อยหรือภัยพิบัติครั้งใหญ่
แผนการกู้คืนหลังภัยพิบัติ (DR) ที่ครบถ้วนจำเป็นต้องเข้าใจความเสี่ยงของคุณ บันทึกขั้นตอนที่ชัดเจน และทดสอบขั้นตอนเหล่านั้นอย่างสม่ำเสมอ เครื่องมือที่เหมาะสมจะช่วยให้กระบวนการนี้ง่ายต่อการจัดการ โดยขจัดความสับสนจากเอกสารที่กระจัดกระจายและขั้นตอนที่ต้องทำด้วยมือ
แม้จะเป็นแผนฉุกเฉินขั้นพื้นฐาน ก็ยังดีกว่าไม่มีอะไรเลยเมื่อเกิดภัยพิบัติ การทดสอบและอัปเดตอย่างสม่ำเสมอจะเปลี่ยนแผนการกู้คืนหลังภัยพิบัติของคุณจากเอกสารที่เก็บฝุ่นเป็นระบบที่ทำงานได้จริง ซึ่งสามารถปกป้องธุรกิจของคุณได้อย่างแท้จริง
ก้าวแรกสู่การสร้างแผนการกู้คืนหลังภัยพิบัติของคุณด้วย ClickUp วันนี้เริ่มใช้งาน ClickUp ฟรีและรวมการวางแผนการกู้คืนหลังภัยพิบัติ เอกสารที่เกี่ยวข้อง และการตอบสนองต่อเหตุการณ์ทั้งหมดไว้ในแพลตฟอร์มเดียวที่รวมเป็นหนึ่ง ✨
คำถามที่พบบ่อย
ทีมควรอัปเดตแม่แบบแผนการกู้คืนระบบ IT จากภัยพิบัติบ่อยแค่ไหน?
คุณควรตรวจสอบแผนการกู้คืนหลังภัยพิบัติ (DR) อย่างน้อยสี่ครั้งต่อปี และอัปเดตแผนทันทีหลังมีการเปลี่ยนแปลงโครงสร้างพื้นฐานที่สำคัญหรือเกิดเหตุการณ์จริง ส่วนใหญ่ขององค์กรจะดำเนินการทบทวนแผนอย่างละเอียดและครอบคลุมทุกปี เพื่อนำบทเรียนที่ได้รับมาปรับใช้และปรับตัวให้สอดคล้องกับเทคโนโลยีใหม่
ทีมใดเป็นฝ่ายรับผิดชอบเอกสารและกระบวนการทดสอบการกู้คืนหลังภัยพิบัติ?
ทีม IT, ทีมความปลอดภัย และผู้วางแผนความต่อเนื่องทางธุรกิจมักเป็นผู้นำในการวางแผนและทดสอบการกู้คืนหลังภัยพิบัติ อย่างไรก็ตาม พวกเขาจำเป็นต้องได้รับข้อมูลสำคัญจากผู้นำฝ่ายปฏิบัติการและผู้นำหน่วยธุรกิจ เพื่อรับรองว่าแผนดังกล่าวสอดคล้องกับความต้องการและลำดับความสำคัญทางธุรกิจในโลกจริง
เราติดตาม RTO และ RPO อย่างไรระหว่างการทดสอบการกู้คืนหลังภัยพิบัติ?
ใช้เครื่องจับเวลาและเครื่องหมายเวลาที่ชัดเจนเพื่อวัดเวลาการกู้คืนจริงเทียบกับเป้าหมายที่กำหนดไว้ระหว่างการทดสอบแต่ละครั้ง การบันทึกช่องว่างระหว่างเป้าหมายและประสิทธิภาพจริงในรายงานการทดสอบเป็นสิ่งสำคัญอย่างยิ่ง เพื่อเป็นแนวทางในการปรับปรุงในอนาคต
เครื่องมือใดที่ช่วยในการบันทึกและอัตโนมัติแผนการกู้คืนหลังภัยพิบัติ?
แพลตฟอร์มการจัดการโครงการ เช่น ClickUp เป็นตัวเลือกที่เหมาะที่สุดสำหรับการรวมเอกสารไว้ในที่เดียว การอัตโนมัติกระบวนการทำงาน และการติดตามตัวชี้วัดสำหรับโปรแกรมการกู้คืนหลังภัยพิบัติ (DR) ทั้งหมดของคุณ หลังจากนั้น คุณสามารถใช้แพลตฟอร์มเหล่านี้ร่วมกับเครื่องมือ DR เฉพาะทางที่จัดการด้านเทคนิคของการคัดลอกข้อมูลและการเปลี่ยนระบบอัตโนมัติเมื่อเกิดข้อผิดพลาด