
A legtöbb csapat úgy tekint az SQL-generálásra, mint egy varázstrükkre. Beír egy kérdést, és kap egy lekérdezést.
De a valóság a következő: a Snowflake Cortex Analyst csak annyira működik jól, amennyire az Ön által előbb létrehozott szemantikai modell, és ez a beállítás nem triviális feladat. Miután megtanulták, hogyan kell használni a Snowflake Cortexet SQL-generáláshoz, az adatelemző csapatok most már másodpercek alatt képesek a természetes nyelvet komplex, végrehajtható lekérdezésekre alakítani.
Ez az útmutató végigvezeti Önt a tényleges megvalósítási folyamaton, a YAML szemantikai modell meghatározásától kezdve az adatraktár természetes nyelvű lekérdezéséig, hogy még a kezdés előtt megismerje mind a rendszer előnyeit, mind az előfeltételeket.
Megvizsgáljuk azt is, hogy a Snowflake Cortex milyen területeken mutat hiányosságokat, és hogy a ClickUp hogyan tudja támogatni az SQL-generálást körülvevő szélesebb körű munkafolyamatokat.
Mi az a Snowflake Cortex Analyst?
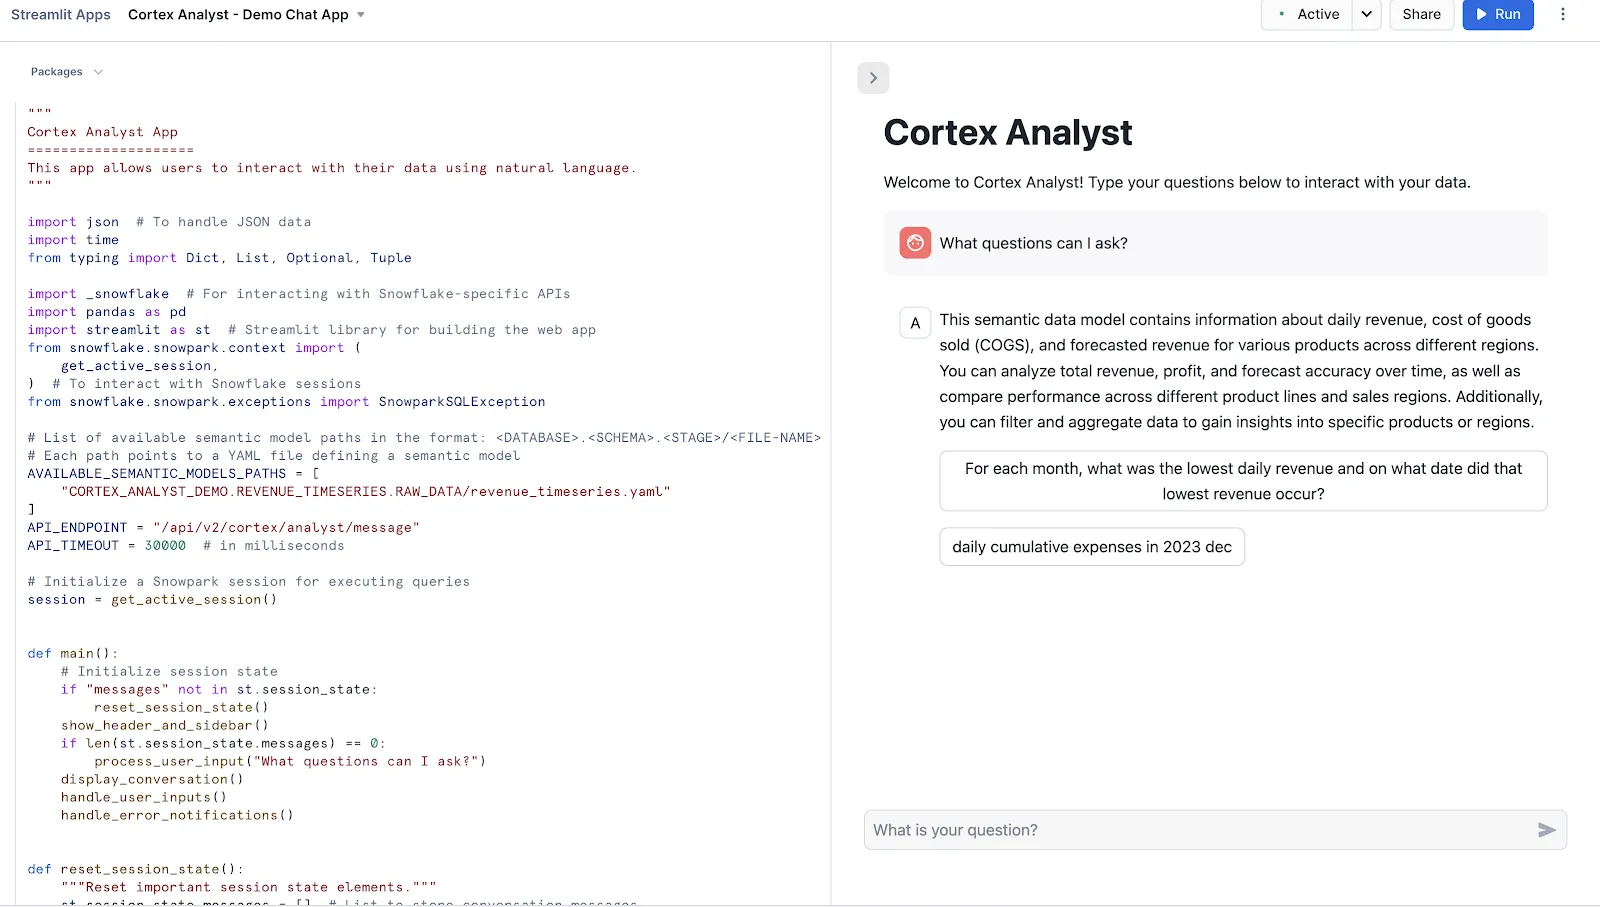
A Snowflake Cortex Analyst egy teljesen felügyelt szolgáltatás, amely lehetővé teszi, hogy beszélgetésalapú alkalmazásokat építsen az analitikai adatai alapján.
A szolgáltatás egy speciális szöveg-SQL átalakító ügynököt használ, amely a természetes nyelvű kérdéseket pontos, végrehajtható lekérdezésekké alakítja át. Ez a szolgáltatás áthidalja a szakadékot a komplex adatstruktúrák és azok között az üzleti felhasználók között, akik kódírás nélkül szeretnének válaszokat kapni.
A legfontosabb funkciók a következők:
- Nagy pontosságú felület biztosítása a strukturált adatokkal való interakcióhoz
- Szemantikai modellek használata az Ön konkrét üzleti logikájának és terminológiájának megértéséhez
- REST API-t kínál az egyedi alkalmazásokba vagy BI-eszközökbe való egyszerű integrációhoz
- Az adatvédelem biztosítása a kérések Snowflake biztonsági határain belüli feldolgozásával
📮 ClickUp Insight: A felmérésünkben résztvevők 88%-a használja a mesterséges intelligenciát személyes feladataihoz, mégis több mint 50% kerüli annak használatát a munkahelyén. A három fő akadály? A zökkenőmentes integráció hiánya, a tudásbeli hiányosságok és a biztonsági aggályok.
De mi lenne, ha az AI be lenne építve a munkaterületébe, és már eleve biztonságos lenne? A ClickUp Brain, a ClickUp beépített AI-asszisztense, ezt valósággá teszi. Megérti a köznyelvi utasításokat, így megoldja az AI bevezetésével kapcsolatos mindhárom aggályt, miközben összeköti a csevegést, a feladatokat, a dokumentumokat és a tudást a munkaterületen belül.
Egyetlen kattintással találjon válaszokat és betekintést!
A Snowflake Cortex SQL-generálás előfeltételei
A megfelelő beállítások nélkül a Snowflake Cortex használatába vágni frusztrációhoz vezet. Pontatlan eredményeket kaphat, időt pazarolhat a hibaelhárításra, és tévesen arra a következtetésre juthat, hogy az eszköz nem működik, miközben a valódi probléma a gyenge alapok.
Ennek elkerülése érdekében először három alapvető elemet kell biztosítania.
1. Állítsa be az adatbázisát és a tábláit
Az AI-je csak annyira okos, amennyire az adatok, amelyekhez hozzáfér. Ha az adatbázis-sémája olyan rejtélyes oszlopnevekből álló labirintus, mint például a cust_dat_v2_final, akkor mind az elemzői, mind az AI nehezen fogják tudni értelmezni.
Ez a zavar oda vezet, hogy a mesterséges intelligencia helytelen csatlakozásokat generál, vagy a rossz oszlopokból von ki adatokat, és a csapata órákat pazarol el csak azzal, hogy megpróbálja megfejteni a sémát, mielőtt egyáltalán lekérdezést írhatna.
Először győződjön meg arról, hogy az adatraktár-szoftver tartalmazza azokat a táblákat, amelyeket a Cortex Analyst-nek lekérdeznie kell. Amennyiben lehetséges, használjon egyértelmű, leíró oszlopneveket. Például a customer_lifetime_value nevű oszlop mind az emberek, mind a mesterséges intelligencia számára sokkal intuitívabb, mint a clv_01.
A beállítás folytatásához a Snowflake-szerepkörének a következő jogosultságokra lesz szüksége:
- HASZNÁLAT: Azon az adatbázison és sémán, amely tartalmazza a tábláit
- SELECT: Azokon a táblákon, amelyekre a Cortex Analyst lekérdezést hajtson végre
- CREATE STAGE: A sémán, amely szükséges a szemantikai modellfájl feltöltéséhez
📖 Olvassa el még: Hogyan használhatja a Snowflake Cortexet üzleti intelligencia céljára?
2. Készítse el a szemantikai modellfájlt
Bármely szöveg-SQL átalakító eszköz legnagyobb akadálya az, hogy a mesterséges intelligencia nem ismeri a vállalat egyedi nyelvét. Nem tudja eleve, hogy az „ARR” az „Annual Recurring Revenue” (éves ismétlődő bevétel) rövidítése, vagy hogy az ügyfelek táblája a customer_id mező alapján kapcsolódik a megrendelések táblájához.
Enélkül az AI olyan SQL-kódot generálhat, amely technikailag érvényes, de logikailag hibás, így olyan válaszokat ad, amelyek helyesnek tűnnek, de veszélyesen félrevezetőek.
A megoldás a szemantikai modell. Ez egy YAML-fájl, amely egyedi „fordítási rétegként” működik, és megtanítja a Cortex Analystnek az Ön vállalkozásának sajátos szókincsét és logikáját. E fájl létrehozása és karbantartása az ETL-eszközöket használó, a sémát ismerő adatelemzők és a terminológiát ismerő üzleti elemzők közös munkájának eredménye.
A szemantikai modellfájlnak a következő kulcsfontosságú elemeket kell tartalmaznia:
| Komponens | Cél |
| Táblázatok | Felsorolja az egyes táblákat, és egyszerű nyelven leírja azok rendeltetését |
| Oszlopok | Meghatározza az egyes oszlopok szemantikai típusát (például kategória vagy mutató), és tartalmazhat mintaértékeket is |
| Kapcsolatok | Meghatározza, hogy a táblák hogyan kapcsolódnak össze csatlakozások révén, így az AI számára nincs szükség találgatásra |
| Ellenőrzött lekérdezések | Példákat tartalmaz kérdés-SQL párokra, amelyek hatékony útmutatóként szolgálnak az LLM számára |
3. A Cortex Search Service beállítása (opcionális)
Előfordul, hogy a szükséges válaszok strukturálatlan szövegekben rejtőznek, például termékleírásokban, ügyfélszolgálati jegyekben vagy telefonbeszélgetések átirataiban. A szokásos SQL-lekérdezések nem tudnak hozzáférni ezekhez az adatokhoz, ami azt jelenti, hogy gyakran elkerüli a figyelmét a „mi” mögött rejlő „miért”.
Opcionálisan hozzáadhatja ide a Snowflake Cortex Search Service szolgáltatást is. Ez egy „search-as-a-service” réteg, amely lehetővé teszi, hogy egyidejűleg lekérdezze mind a strukturált tábláit, mind a strukturálatlan szöveges adatait, az adatelemzéshez AI-ügynököket használva.
A Cortex Search beállítására akkor van szükség, ha az elemzőinek olyan kérdéseket kell feltenniük, amelyekhez az SQL generálása előtt kontextust kell kinyerni a szövegből. Például először kereshet az összes olyan termékértékelés között, amely tartalmazza a „battery issue” kifejezést, majd generálhat egy SQL-lekérdezést, amely kizárólag ezeknek a termékeknek az értékesítési adatait összesíti.
Strukturált táblákra vonatkozó tiszta SQL-generáláshoz ez a szolgáltatás nem szükséges.
🧠 Érdekesség: Az 1970-es évek elején az IBM kutatói, Donald Chamberlin és Raymond Boyce létrehozták a „Structured English Query Language” nyelvet. A nevet SQL-re kellett változtatniuk, mert a „SEQUEL” már egy brit repülőgépgyártó cég védjegye volt.
Lépésről lépésre: SQL-kód generálása a Cortex Analyst segítségével
Elvégezte az előkészítő munkát, de most egy üres képernyő előtt áll, és nem biztos benne, hogy pontosan hogyan is zajlik a munkafolyamat. Hogyan jut el a fejében felmerülő kérdéstől egy futtatható SQL-lekérdezésig? Ha a munkafolyamat kezelése nem egyértelmű, az új eszközöket gyakran nem használják, és a beállításba fektetett erőfeszítések kárba vesznek.
A gyakorlati folyamat üdítően egyszerű. Nézzük meg közelebbről!
1. lépés: Adatainak előkészítése a Snowflake-ben
Mindenekelőtt a strukturált adatainak a Snowflake-ben kell tárolódniuk. Minden Cortex Analyst alkalmazás vagy egy táblára, vagy egy vagy több táblából álló nézetre van irányítva. Győződjön meg arról, hogy a táblái létre vannak hozva és kitöltve.
Ha síkfájlokból tölti be az adatokat:
- Töltse fel adatfájljait (pl. CSV-fájlokat) egy Snowflake Stage-be
- Használja a COPY INTO parancsot az adatok betöltéséhez a köztes tárolóból a táblákba
- Mielőtt továbbhaladna, ellenőrizze, hogy az adatok sikeresen betöltődtek-e
📖 Olvassa el még: Hogyan használhatja a Snowflake Cortexet vállalati elemzésekhez?
2. lépés: Szemantikai modell (vagy szemantikai nézet) létrehozása
Ez a legfontosabb beállítási lépés. A Cortex Analyst ereje abból fakad, hogy nagy nyelvi modelleket (LLM-eket) kombinál szemantikai modellekkel, egy YAML-fájllal, amely az adatbázis-sémához tartozik, és kódolja az üzleti kontextust.
A szemantikai nézetek mostantól a Snowflake által a Cortex Analyst számára ajánlott módszer. Ezek az üzleti mutatókat, kapcsolatokat és definíciókat közvetlenül a Snowflake-ben tárolják. A régi YAML szemantikai modellfájlok továbbra is működnek, de a Snowflake az új implementációk esetében a szemantikai nézetek használatát javasolja.
A szemantikai modelljének vagy nézetének a következőket kell tartalmaznia:
- Táblák és oszlopok leírása: Egyszerű nyelven megfogalmazott magyarázatok az egyes mezők jelentéséről
- Üzleti mutatók: A számított mezők, például a bevétel, az ügyfélelvándorlás vagy a konverziós arány definíciói
- Szűrők és szinonimák: Olyan alternatív kifejezések, amelyeket a felhasználók használhatnak (pl. a „törölve” kifejezés egy adott állapotértékhez rendelve)
- Ellenőrzött lekérdezések: A Snowflake Ellenőrzött Lekérdezések Tára a jóváhagyott kérdés-SQL párokat tárolja. Ha egy felhasználói kérdés hasonlít az egyik ilyen bejegyzéshez, a Cortex Analyst hivatkozhat rá az SQL-generálás során.
🤝 Barátian emlékeztető: A Snowflake azt javasolja, hogy a Snowsight munkafolyamatban az optimális teljesítmény érdekében legfeljebb 10 táblát és legfeljebb 50 kiválasztott oszlopot használjon.
3. lépés: Töltse fel a szemantikai modellt egy Snowflake-szakaszba
Ha YAML-alapú szemantikai modellt használ, azt előkészítenie kell, hogy a Cortex Analyst futásidőben hivatkozhasson rá.
- Töltse fel a .yaml fájlt egy Snowflake belső tárolóba (pl. RAW_DATA)
- Ellenőrizze a Snowsight felhasználói felületén vagy a LIST @stage_name paranccsal, hogy a fájl megjelenik-e a szakaszban.
- Jegyezze meg a szakasz elérési útját; erre fog hivatkozni az API-hívásokban vagy az alkalmazás konfigurációjában.
Ha szemantikus nézetet használ, ezt a lépést a Snowflake natívan kezeli, így nincs szükség külön feltöltésre.
🔍 Tudta ezt? Az SQL-ben a NULL nem jelent nullát vagy üres értéket. Ismeretlen vagy hiányzó adatot jelöl, ami olyan, az intuíciótól eltérő viselkedéshez vezet, mint például az olyan összehasonlítások, amelyek sem igazat, sem hamisat nem adnak vissza.
4. lépés: Küldjön el egy természetes nyelvű kérdést a REST API-n keresztül
Most kezdődik el a tényleges SQL-generálás. A REST API a kérésben megadott szemantikai modell vagy szemantikai nézet segítségével generál egy SQL-lekérdezést egy adott kérdésre.
Az API-kérés felépítéséhez használja a következőket:
- üzenetek; egy tömb, amely tartalmazza a felhasználó kérdését, szerepkör: „user”
- Hivatkozás a szemantikai modelljére vagy szemantikai nézetére
- Válassza ki a kívánt modellt (vagy hagyja az „auto” beállítást, hogy a Cortex válassza ki a legjobbat)
Többfordulós beszélgetéseket folytathat, amelyek során a korábbi lekérdezésekre épülő kiegészítő kérdéseket tehet fel.
5. lépés: Az API-válasz elemzése
A válaszban szereplő minden üzenet tartalmazhat több, különböző típusú tartalomblokkot. A type mezőben jelenleg három érték támogatott: text, suggestions és SQL.
Az egyes típusok jelentése a következő:
- SQL: A Cortex sikeresen generált egy lekérdezést; ezt fogja végrehajtani
- szöveg: Az SQL-hez tartozó természetes nyelvű magyarázat vagy válasz
- javaslatok: A javaslatok tartalomtípusa csak akkor szerepel a válaszban, ha a felhasználó kérdése kétértelmű volt, és a Cortex Analyst nem tudott SQL-utasítást visszaadni az adott lekérdezéshez. Használja ezeket a kérdés pontosításához vagy finomításához
🔍 Tudta ezt? Az SQL-parancsok írási sorrendje nem egyezik meg a végrehajtásuk sorrendjével. Annak ellenére, hogy a SELECT parancsot írja le elsőként, az adatbázisok valójában a FROM és a WHERE parancsokat dolgozzák fel, mielőtt kiválasztanák az oszlopokat. Ez egyaránt zavarba ejti a kezdőket és a tapasztalt felhasználókat is.
6. lépés: Futtassa a generált SQL-kódot a Snowflake-ben
Miután megkapta a válaszból az SQL-blokkot, futtassa azt a Snowflake virtuális adattárházában. A generált SQL-lekérdezés a Snowflake virtuális adattárházában kerül végrehajtásra a végső kimenet előállításához. Az adatok a Snowflake irányítási határain belül maradnak.
A végrehajtáskor tudnia kell a következőket:
- A Cortex Analyst teljes mértékben integrálódik a Snowflake szerepköralapú hozzáférés-vezérlési (RBAC) szabályaival, biztosítva, hogy a generált és végrehajtott SQL-lekérdezések minden érvényes hozzáférés-vezérlési szabálynak megfeleljenek.
- Ha egy felhasználónak nincs hozzáférése egy táblához, a lekérdezés végrehajtása sikertelen lesz, pontosan úgy, mint a kézzel írt SQL esetében.
- Ebben a szakaszban a raktár számítási költségei érvényesek, a Cortex Analyst saját használati díjaitól függetlenül.
7. lépés: Finomítás és iteráció
Nem mindig garantált, hogy az első próbálkozásra tökéletes lekérdezést kap. Íme, hogyan javíthatja az eredményeket idővel:
- Adjon hozzá ellenőrzött lekérdezéseket a szemantikai modelljéhez az ismétlődő kérdések esetére
- Gazdagítsa szemantikai modelljét jobb leírásokkal, szinonimákkal és szűrőkkel, amikor a Cortex egy kifejezést félreértelmez.
- Használjon többszakas beszélgetést a folytatáshoz, például: „Most szűrje azt régió szerint” – a többszakas beszélgetések lehetővé teszik az előző lekérdezésekre épülő kiegészítő kérdések feltevését.
- Kövesse nyomon a használatot a CORTEX_ANALYST_USAGE_HISTORY és a Snowflake lekérdezési előzményei segítségével, hogy felismerje a sikertelen vagy pontatlan lekérdezésekben megjelenő mintákat.
🧠 Érdekesség: Egyetlen hiányzó JOIN-feltétel is hatalmas problémákat okozhat. Ha elfelejtünk egy join-feltételt, az kartézi szorzatot eredményezhet, ami drámaian megnöveli a sorok számát, és esetenként a rendszer összeomlásához is vezethet.
A Snowflake szöveg-SQL átalakításának pontosságára vonatkozó bevált gyakorlatok
A szemantikai modell minősége közvetlenül meghatározza a generált lekérdezések pontosságát. Íme a pontosságot javító bevált gyakorlatok. 🛠️
- Adjon hozzá ellenőrzött lekérdezéseket a szemantikai modelljéhez: Ez a leghatásosabb lépés, amit tehet. Számos olyan példakérdés-SQL párral egészítse ki a modellt, amelyek tükrözik, hogy a csapata valójában hogyan fogalmazza meg a kérdéseit.
- Használjon leíró oszlop- és táblaneveket: A modell jobban teljesít, ha az oszlop- és táblanevek önmagukban is érthetőek. Ha nem tudja módosítani a sémát, adjon hozzá egyértelmű leírásokat a YAML-fájlban az érthetetlen oszlopnevekhez.
- Példaértékek hozzáadása: A kategorikus oszlopokhoz (például állapot vagy régió) példaadatok hozzáadása segít a modellnek megérteni az elérhető érvényes szűrőopciókat.
- Tesztelje szélsőséges esetekkel: A fejlesztés során szándékosan tegyen fel kétértelmű vagy trükkös kérdéseket, hogy azonosítsa, hol van szükség a szemantikai modelljében további kontextusra vagy pontosításra.
- Fejlessze tovább szemantikai modelljét: Tekintse szemantikai modelljét élő dokumentumnak. A modellt folyamatosan frissíteni kell egy iteratív folyamat keretében, figyelembe véve, hogy mely lekérdezések sikerülnek, és melyek nem.
ClickUp: A Snowflake Cortex egyszerűbb alternatívája
A Snowflake Cortex kiválóan alkalmas arra, amikor a csapatok SQL-kódot szeretnének generálni és lekérdezéseket futtatni strukturált adatokon. A csapatok meghatározzák a sémákat, leképezik a kapcsolatokat, és lekérdezéseket írnak az adatokból nyerhető információk kinyerése érdekében. Ez a felépítés különösen adatigényes környezetekben bizonyul hatékonynak, főleg akkor, ha az elemzés és a jelentések készítése az elemzők feladata.
Sok csapatnak azonban nincs szüksége teljes SQL-rétegre a mindennapi operatív kérdések megválaszolásához. A termékmenedzserek, a programvezetők és az operációs csapatok gyakran gyors válaszokat szeretnének kapni az aktuális munkájukhoz kapcsolódó kérdésekre.
A ClickUp egy könnyebben hozzáférhető megoldást kínál. A csapatok egyszerű nyelven tesznek fel kérdéseket, élő irányítópultokat tekintenek át, és a kapott információk alapján cselekszenek anélkül, hogy SQL-kódot kellene írniuk vagy szemantikai modelleket kellene építeniük.
Gyorsabb SQL-generálás és finomítás
A Snowflake Cortex arra összpontosít, hogy adatraktár-környezetben strukturált adatkészletekből SQL-lekérdezéseket generáljon. Ez akkor működik jól, ha az adatok már a Snowflake-ben vannak, és a sémák is kialakításra kerültek.
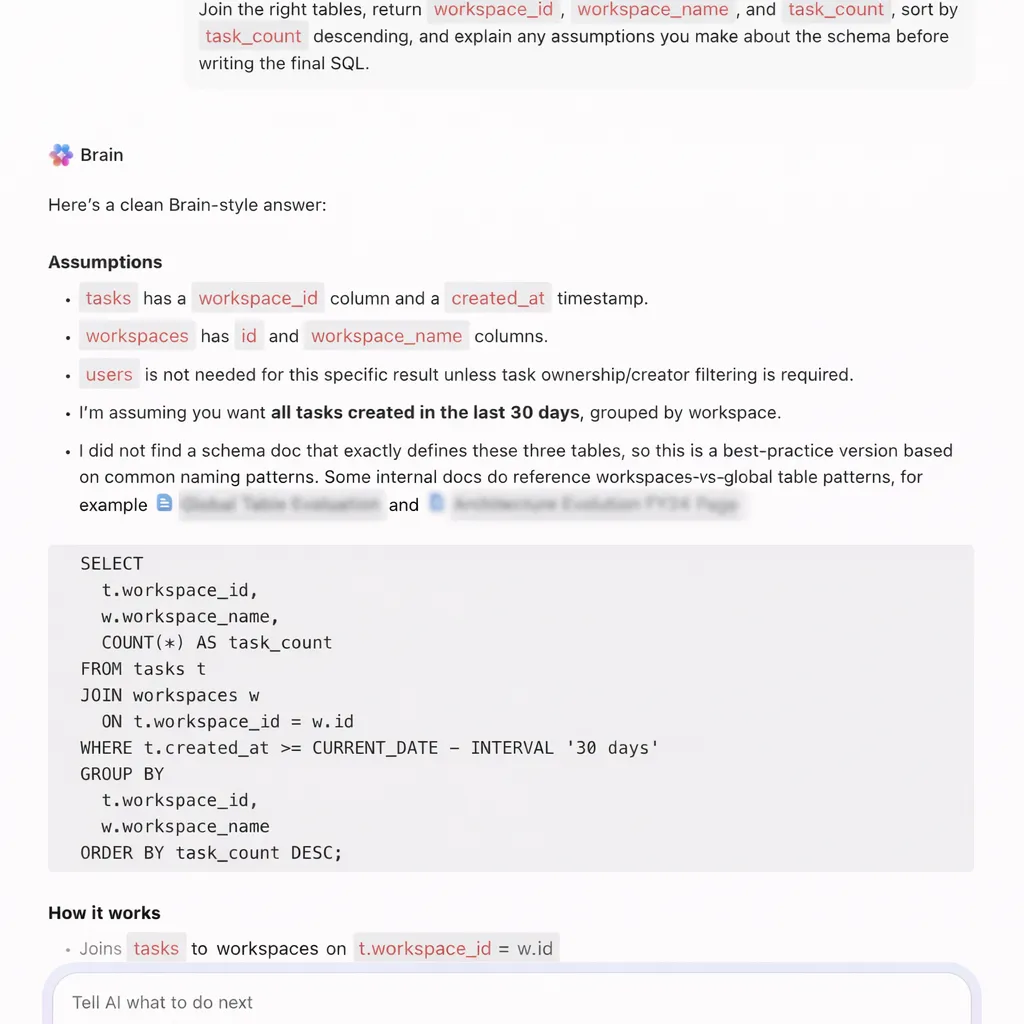
A ClickUp Brain rugalmasabb, a végrehajtásra összpontosító módon támogatja az SQL-kód generálását. A csapatok közvetlenül a munkaterületükön generálják, finomítják és tárolják az SQL-lekérdezéseket, ahol az elemzések, megbeszélések és döntések máris zajlanak.
Tegyük fel, hogy egy termékelemző a ClickUp-on belül egy ügyfélmegtartási elemzési feladaton dolgozik. Ahelyett, hogy más eszközre váltana a lekérdezések írásához, a ClickUp Brain-hez fordul:
📌 Próbálja ki ezt a parancsot: Írjon egy SQL-lekérdezést, amely kiszámítja a regisztrációs kohorszok szerint csoportosított felhasználók hétnapos megtartási arányát.
A ClickUp Brain strukturált lekérdezést generál, amely tartalmazza a kohortcsoportosítást, a dátumszűrőket és a megtartási logikát. Az elemző beilleszti a lekérdezést a Snowflake-be vagy egy másik adattárházba, és azonnal futtatja.
Ez segít:
- Írjon összekapcsolásokat több táblára, például a felhasználók, a megrendelések és az események tábláira
- Alapvető angol nyelvű termékkel kapcsolatos kérdéseket alakítson végrehajtásra kész SQL-logikává
- Hibás lekérdezések hibakeresése és a problémák magyarázata, például helytelen csatlakozások vagy hiányzó feltételek esetén
- Írja át a lekérdezéseket a jobb teljesítmény vagy olvashatóság érdekében
Például egy növekedési kísérlet értékelése során egy marketinges a következő kérdést teszi fel: „Írjon egy SQL-lekérdezést, amely összehasonlítja a két céloldal konverziós arányait az elmúlt 14 napban”.
A ClickUp Brain feltételes összesítés és dátumszűrők segítségével generálja a lekérdezést. A csapat futtatja azt a Snowflake-ben, és ellenőrzi a kísérlet eredményeit.
📌 Próbálja ki ezt a parancsot: Javítsa ki ezt az SQL-lekérdezést, amelyben a csatlakozás sorokat duplikál, és magyarázza el a problémát.
A ClickUp Brain azonosítja a csatlakozási problémát, kijavítja a lekérdezést, és elmagyarázza, hogyan keletkeztek az ismétlődő sorok a helytelen csatlakozási feltételek miatt.
Cserélje le az SQL-alapú jelentéskészítést
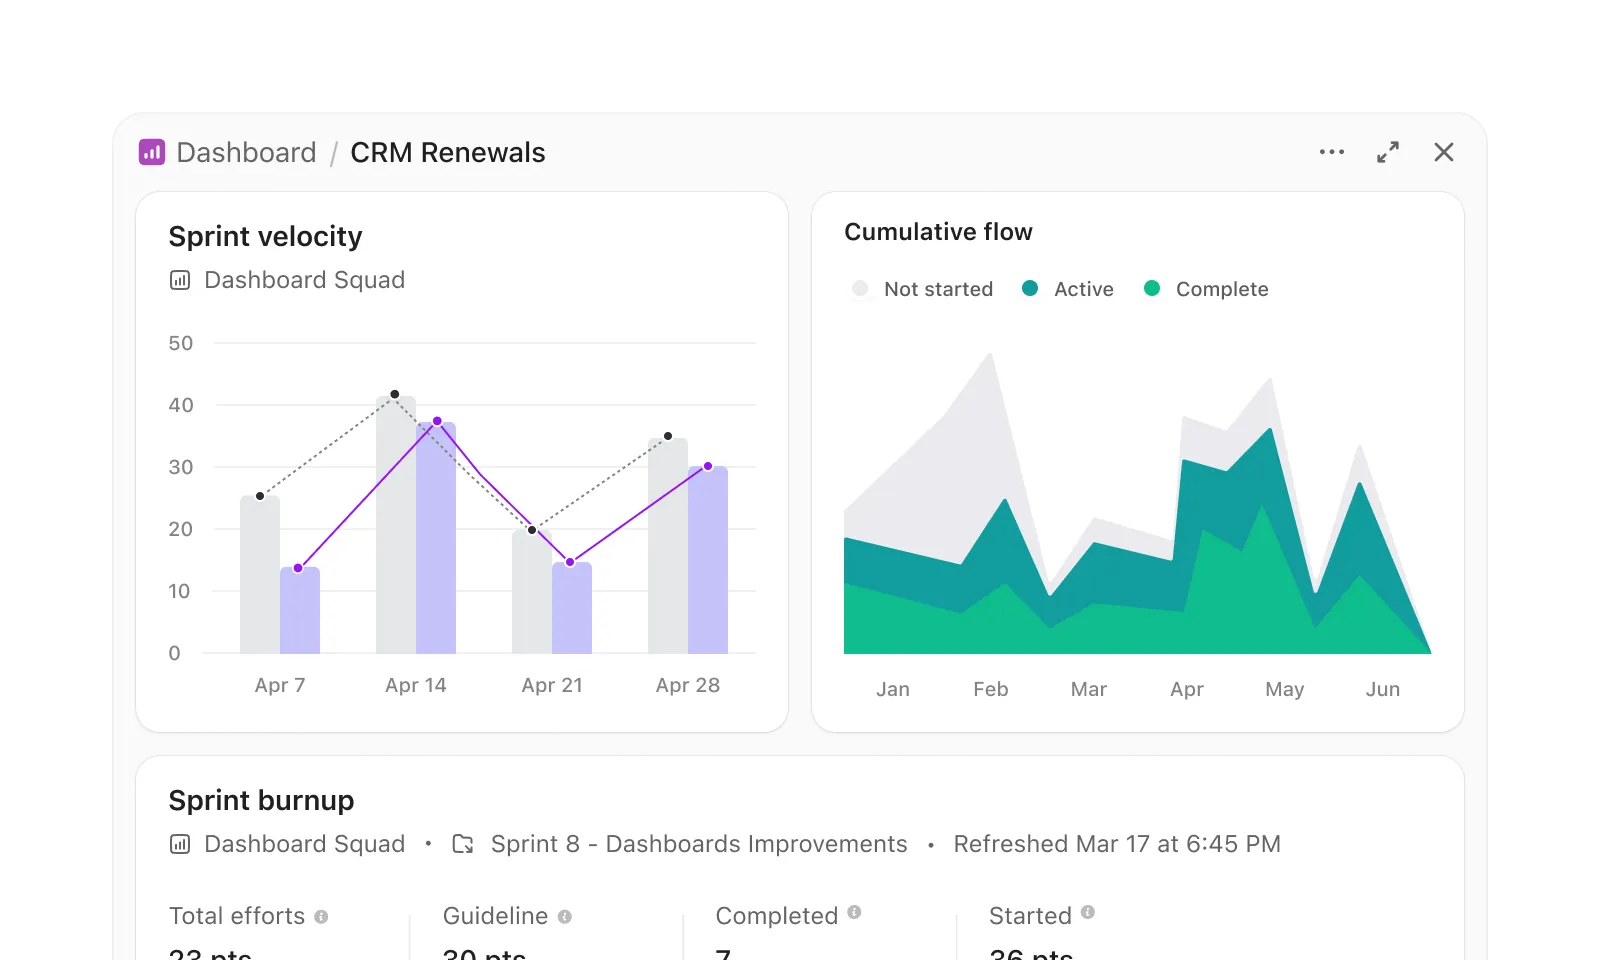
A Snowflake Cortex munkafolyamatai gyakran magukban foglalják az SQL-kód generálását, a lekérdezések futtatását és az eredmények egy külön rétegben történő megjelenítését. A ClickUp Dashboards kiküszöböli ezt a több lépésből álló folyamatot, és az élő munkából közvetlenül nyújt betekintést az adatokba.
A kiadásra való felkészültséget nyomon követő programmenedzsment-csapat lekérdezések írása nélkül is létrehozhat egy irányítópultot. Például egy kiadási irányítópult a következőket tartalmazhatja:
- Egy feladatlista-kártya, amely úgy van szűrve, hogy az összes termékcsapatnál a határidőn túllépett feladatokat mutassa
- Egy munkafolyamat-kártya, amely bemutatja a feladatok elosztását a mérnökök között
- Egy oszlopdiagram, amely összehasonlítja a befejezett és a függőben lévő feladatokat sprintenként
- Egy számítási kártya, amely nyomon követi az átlagos feldolgozási időt
Tegyük fel, hogy egy programvezető a kiadási megbeszélés előtt áttekinti ezt a műszerfalat. Azonnal észreveszi, hogy a háttérszolgáltatásoknál magasabb a késleltetési arány. Megnyitja a feladatlista kártyát, és megvizsgálja, mely feladatok okozzák pontosan a kockázatot.
Egy valódi ClickUp-felhasználó így mesél:
A ClickUp segítségével GYORSAN átadhatjuk egymásnak a projekteket, KÖNNYEDEN ellenőrizhetjük a projektek állapotát, és felettesünk bármikor betekintést nyerhet a munkaterhelésünkbe anélkül, hogy meg kellene szakítania a munkánkat. A ClickUp használatával biztosan egy napot, ha nem többet is megtakarítottunk hetente. Az e-mailek száma JELENTŐSEN csökkent.
A ClickUp segítségével GYORSAN átadhatjuk egymásnak a projekteket, KÖNNYEDEN ellenőrizhetjük a projektek állapotát, és a felettesünk bármikor betekintést nyerhet a munkaterhelésünkbe anélkül, hogy meg kellene szakítania a munkánkat. A ClickUp használatával biztosan egy napot, ha nem többet is megtakarítottunk hetente. Az e-mailek száma JELENTŐSEN csökkent.
Használja ki az információkat pipeline-ok nélkül
A Snowflake Cortex az adatokból nyert betekintések generálására összpontosít. Az eredmények értelmezése és a cselekvések elindítása továbbra is a csapatok feladata.
A ClickUp AI Super Agents áthidalja ezt a szakadékot, és a betekintést cselekvéssé alakítja. Olyan AI-csapattársakként működnek, amelyek folyamatosan figyelemmel kísérik a munkaterület adatait, és a feltételek alapján intézkednek.
Tegyük fel, hogy egy programmenedzser több termékkezdeményezést felügyel. Egy Super Agent képes:
- Kövesse nyomon a feladatokat a különböző projektekben, és észlelje, ha a késedelmes feladatok meghaladják a meghatározott küszöbértéket
- Azonosítson olyan mintákat, mint például az azonos munkafolyamat-szakaszban ismétlődő késések
- Hozzon létre egy feladatot, amely összefoglalja az érintett projekteket, és rendelje hozzá a programvezetőhöz
- Értesítse a csapatvezetőket, ha a határidő lejárta után is megoldatlanok maradnak a kritikus feladatok
Például egy kiadási ciklus során egy Super Agent észleli, hogy két csapatnál összesen több mint 10 kiemelt fontosságú feladat nem tartotta be a határidőt. Létrehoz egy „Kiadási kockázat: határidő túllépés” nevű ClickUp-feladatot, hozzáadja az összes releváns feladatot, és a programmenedzsernek rendeli hozzá azonnali áttekintés céljából.
A csapatok közvetlenül is kommunikálhatnak a Super Agenttel: „Elemezd az összes aktív projektet, és emeld ki a jelen sprinttel kapcsolatos kivitelezési kockázatokat”.
A Super Agent áttekinti a határidőket, a függőségeket és a feladatok állapotát, majd strukturált összefoglalót tesz közzé a munkaterületen belül.
Így állíthatja be saját Super Agentjét a ClickUp-ban:
Központosítsa adatfeldolgozási munkafolyamatait a ClickUp segítségével
A Snowflake Cortexhez hasonló „text-to-SQL” eszközök hozzáférhetőbbé teszik az adatokat. Ugyanakkor a megbízható eredmények elérése továbbra is erőfeszítést igényel.
A csapatoknak tiszta sémákra, erős szemantikai modellekre és folyamatos iterációra van szükségük ahhoz, hogy az eredmények pontosak maradjanak. Még a megfelelő lekérdezés generálása után sem ér véget a munka. Valakinek továbbra is értelmeznie kell az eredményeket, meg kell osztania a megállapításokat, és azokat döntésekké kell alakítania.
A ClickUp egy másfajta megközelítést kínál. Ahelyett, hogy elválasztaná az elemzést a végrehajtástól, a ClickUp összekapcsolja a kettőt. A csapatok ugyanazon a munkaterületen belül generálnak SQL-lekérdezéseket, dokumentálják az eredményeket, együttműködnek a megállapítások alapján, és azok alapján cselekszenek.
A ClickUp Brain segít a lekérdezések megírásában és finomításában, míg a műszerfalak és az AI-ügynökök segítségével a csapatok nyomon követhetik az eredményeket, és előrehaladhatnak a munkával anélkül, hogy különböző eszközök között kellene váltogatniuk.
A Snowflake Cortex segít megtalálni a válaszokat. A ClickUp pedig segít azok felhasználásában. Regisztráljon még ma a ClickUp-ra!
Gyakran feltett kérdések
Mi az a Snowflake Cortex Analyst, és miben különbözik a Cortex AI-tól?
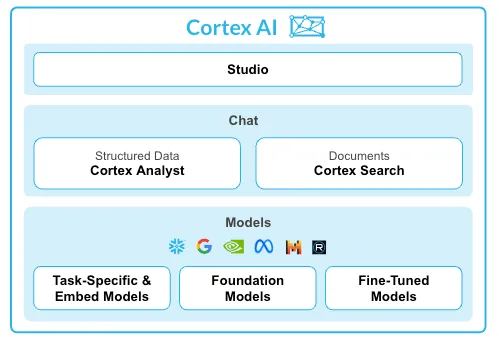
A Snowflake Cortex Analyst a szélesebb körű Snowflake Cortex AI csomag egy speciális szolgáltatása. A Cortex Analyst kifejezetten a szemantikai modellek segítségével történő szöveg-SQL generálásra összpontosít, míg a Cortex AI szélesebb körű LLM-funkciókat, gépi tanulási modell-következtetést és keresési képességeket tartalmaz.
A Snowflake Cortex Analyst működik-e külső adatforrásokkal, például Iceberg-táblákkal?
Igen, a Cortex Analyst lekérdezheti az Apache Iceberg táblákat, amelyeket a Snowflake kezel. Amennyiben a táblák elérhetők a Snowflake-környezetében, és megfelelően vannak definiálva a szemantikai modellben, lekérdezéseket generálhat rájuk.
Mennyire pontos a Snowflake szöveg-SQL generálása komplex lekérdezések esetén?
A komplex lekérdezések pontossága szinte teljes mértékben a szemantikai modell minőségétől függ. A jól definiált táblakapcsolatokkal, számos ellenőrzött lekérdezéssel és leíró metaadatokkal rendelkező modell jelentősen pontosabb eredményeket ad a több táblás csatlakozások és a komplex összesítések esetén.
Mennyibe kerül a Snowflake Cortex SQL-generálási funkciója?
A Snowflake Cortex Analyst árazása a Snowflake felhasználásalapú modelljét követi, ami azt jelenti, hogy a számlázás a lekérdezések generálása során felhasznált számítási kreditek alapján történik. A legfrissebb árakról mindig a Snowflake hivatalos árazási dokumentációjában tájékozódjon.