
Většina týmů považuje generování SQL za kouzlo. Zadáte otázku a dostanete dotaz.
Realita je však taková: Snowflake Cortex Analyst funguje pouze tak dobře, jak dobrý je sémantický model, který nejprve vytvoříte, a jeho nastavení není triviální. Po osvojení práce se Snowflake Cortex pro generování SQL mohou nyní datové týmy během několika sekund převádět přirozený jazyk na složité, spustitelné dotazy.
Tato příručka vás provede samotným procesem implementace, od definování sémantického modelu YAML až po dotazování datového skladu pomocí přirozeného jazyka, abyste ještě před začátkem pochopili jak jeho možnosti, tak i nezbytné předpoklady.
Podíváme se také na to, v čem Snowflake Cortex zaostává a jak může ClickUp podporovat širší pracovní postupy související s generováním SQL.
Co je Snowflake Cortex Analyst?
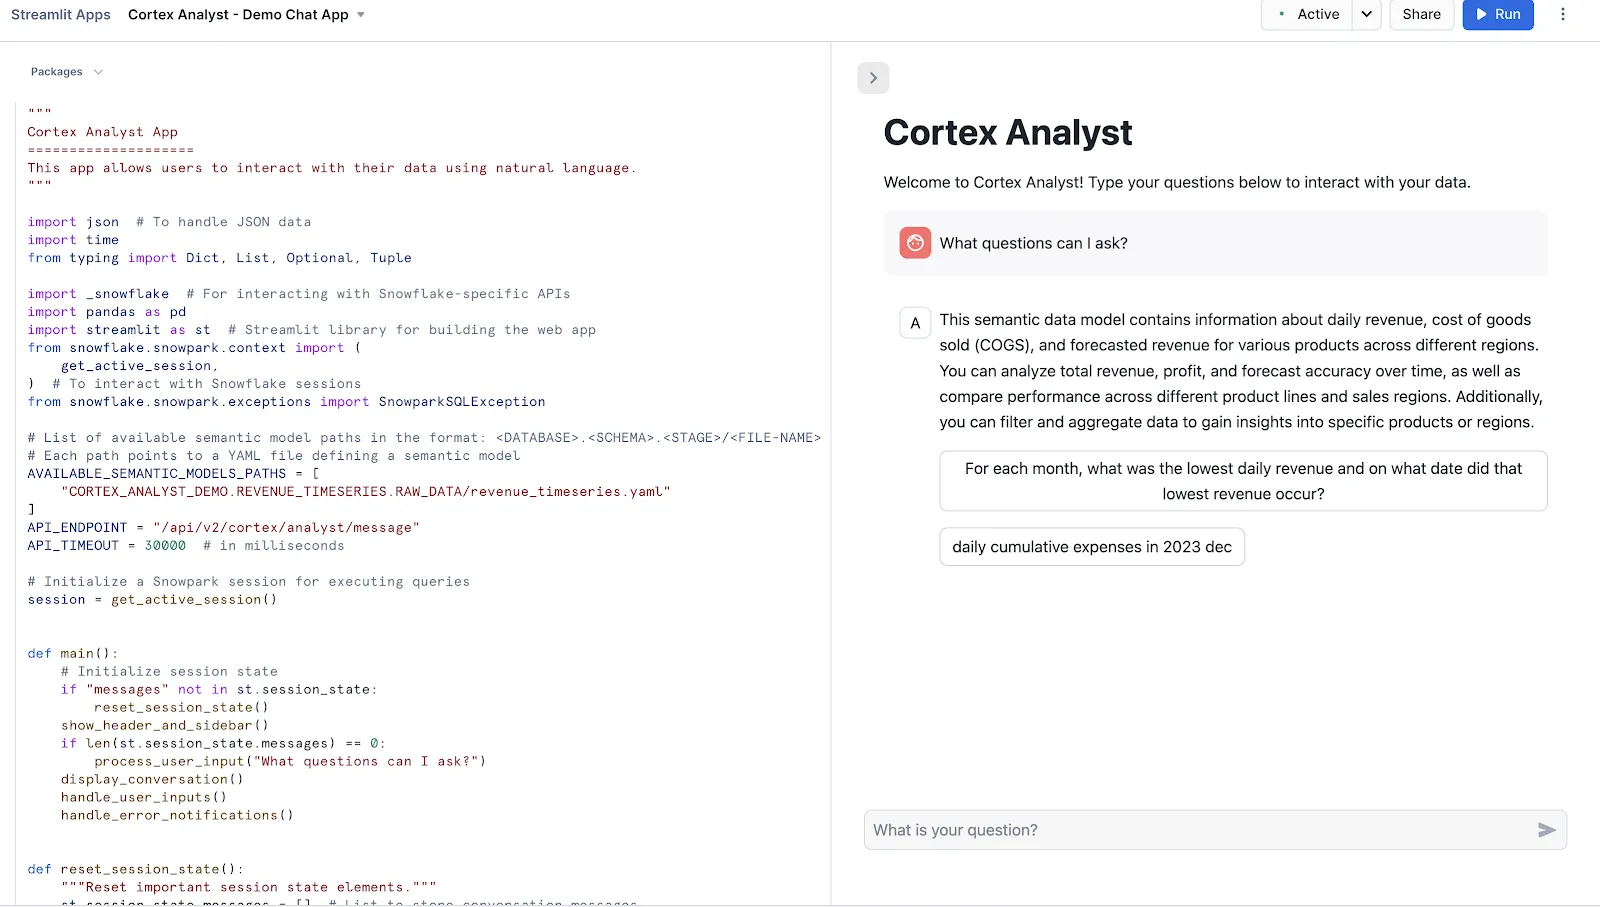
Snowflake Cortex Analyst je plně spravovaná služba, která vám umožňuje vytvářet konverzační aplikace na základě vašich analytických dat.
Využívá specializovaný agent pro převod textu na SQL, který přeměňuje otázky v přirozeném jazyce na přesné a proveditelné dotazy. Tato služba překlenuje propast mezi složitými datovými strukturami a obchodními uživateli, kteří potřebují odpovědi, aniž by museli psát kód.
Mezi klíčové funkce patří:
- Poskytuje vysoce přesné rozhraní pro práci se strukturovanými daty
- Využití sémantických modelů k pochopení vaší specifické obchodní logiky a terminologie
- Nabízí rozhraní REST API pro snadnou integraci do vlastních aplikací nebo nástrojů BI.
- Zajištění ochrany osobních údajů zpracováním požadavků v rámci bezpečnostních hranic Snowflake
📮 ClickUp Insight: 88 % respondentů našeho průzkumu využívá umělou inteligenci pro své osobní úkoly, avšak více než 50 % se jejího použití v práci vyhýbá. Jaké jsou tři hlavní překážky? Nedostatečná integrace, mezery ve znalostech a obavy o bezpečnost.
Ale co když je AI integrována přímo do vašeho pracovního prostředí a je již zabezpečená? ClickUp Brain, integrovaný AI asistent ClickUpu, to proměňuje ve skutečnost. Rozumí pokynům v běžném jazyce, čímž řeší všechny tři obavy spojené se zavedením AI a zároveň propojuje váš chat, úkoly, dokumenty a znalosti napříč celým pracovním prostředím.
Získejte odpovědi a poznatky jediným kliknutím!
Předpoklady pro generování SQL pomocí Snowflake Cortex
Pokud se pustíte do používání Snowflake Cortex bez správného nastavení, čeká vás frustrace. Můžete získat nepřesné výsledky, ztrácet čas řešením problémů a mylně dojít k závěru, že nástroj nefunguje, zatímco skutečným problémem je slabý základ.
Abyste tomu předešli, musíte nejprve zajistit tři základní prvky.
1. Nastavte si databázi a tabulky
Vaše AI je jen tak chytrá, jak chytrá jsou data, ke kterým má přístup. Pokud je schéma vaší databáze bludištěm záhadných názvů sloupců, jako je například cust_dat_v2_final, budou mít jak vaši analytici, tak i AI potíže s tím, aby se v něm zorientovali.
Tato nejistota vede k tomu, že AI generuje nesprávné spojení nebo čerpá data ze špatných sloupců, a váš tým tak ztrácí hodiny jen tím, že se snaží rozluštit schéma, ještě než vůbec může napsat dotaz.
Nejprve se ujistěte, že váš software pro datový sklad obsahuje tabulky, které má Cortex Analyst dotazovat. Kdykoli je to možné, používejte jasné a popisné názvy sloupců. Například sloupec s názvem customer_lifetime_value je pro lidi i umělou inteligenci mnohem intuitivnější než clv_01.
Chcete-li pokračovat v nastavení, bude vaše role ve Snowflake potřebovat následující oprávnění:
- POUŽITÍ: V databázi a schématu obsahujícím vaše tabulky
- SELECT: V tabulkách, které má Cortex Analyst dotazovat
- FÁZE VYTVÁŘENÍ: Ve schématu, které je nutné pro nahrání souboru sémantického modelu
📖 Přečtěte si také: Jak používat Snowflake Cortex pro business intelligence
2. Vytvořte soubor sémantického modelu
Největší překážkou u jakéhokoli nástroje pro převod textu na SQL je to, že umělá inteligence nerozumí specifickému jazyku vaší společnosti. Neví automaticky, že „ARR“ znamená „Annual Recurring Revenue“ (roční opakující se tržby) nebo že tabulka zákazníků se spojuje s tabulkou objednávek podle pole customer_id.
Bez tohoto kontextu by AI mohla generovat SQL, které je sice technicky platné, ale logicky nesprávné, a poskytovat vám tak odpovědi, které vypadají správně, ale jsou nebezpečně zavádějící.
Řešením je sémantický model. Jedná se o soubor YAML, který funguje jako vaše vlastní „překladová vrstva“ a učí Cortex Analyst specifickou terminologii a logiku vašeho podnikání. Vytvoření a údržba tohoto souboru je výsledkem spolupráce mezi datovými inženýry, kteří pomocí nástrojů ETL znají schéma, a obchodními analytiky, kteří znají terminologii.
Váš soubor sémantického modelu by měl obsahovat tyto klíčové komponenty:
| Komponenta | Účel |
| Tabulky | Uvádí seznam jednotlivých tabulek s popisem jejich účelu v běžném jazyce |
| Sloupce | Definuje sémantický typ každého sloupce (například kategorii nebo metriku) a může obsahovat ukázkové hodnoty |
| Vztahy | Určuje, jak se tabulky propojují pomocí spojení, čímž eliminuje jakékoli dohady ze strany AI |
| Ověřené dotazy | Obsahuje příklady dvojic otázek a SQL dotazů, které slouží jako užitečné vodítko pro LLM. |
3. Nakonfigurujte službu Cortex Search Service (volitelné)
Někdy jsou odpovědi, které potřebujete, skryté v nestrukturovaném textu, jako jsou popisy produktů, žádosti o podporu nebo přepisy hovorů. Standardní dotazy SQL se k těmto datům nedostanou, což znamená, že vám často uniká „proč“ za „čím“.
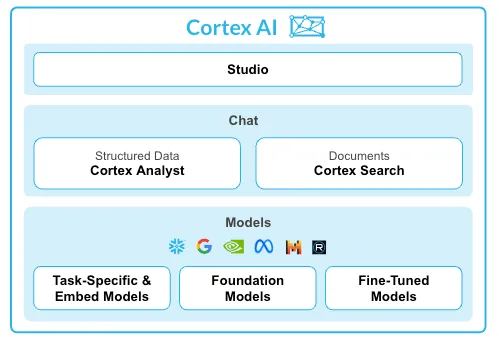
Zde můžete volitelně přidat službu Snowflake Cortex Search Service. Jedná se o vrstvu typu „search-as-a-service“, která vám umožňuje současně dotazovat jak strukturované tabulky, tak nestrukturovaná textová data pomocí agentů umělé inteligence pro analýzu dat.
Cortex Search byste měli nakonfigurovat, pokud vaši analytici potřebují klást otázky, které vyžadují získání kontextu z textu před generováním dotazu SQL. Můžete například nejprve vyhledat všechny recenze produktů obsahující frázi „problém s baterií“ a poté vygenerovat dotaz SQL, který agreguje údaje o prodeji pouze těchto produktů.
Pro generování čistého kódu SQL pro strukturované tabulky není tato služba nutná.
🧠 Zajímavost: Na počátku 70. let 20. století vytvořili výzkumníci společnosti IBM Donald Chamberlin a Raymond Boyce jazyk „Structured English Query Language“. Museli však název změnit na SQL, protože název „SEQUEL“ již byl chráněn jako ochranná známka britské letecké společnosti.
Podrobný průvodce generováním SQL pomocí nástroje Cortex Analyst
Přípravné práce máte za sebou, ale teď sedíte před prázdnou obrazovkou a nejste si jisti, jak vlastně postupovat. Jak se dostat od otázky, kterou máte v hlavě, k spustitelnému dotazu SQL? Pokud není jasné, jak postupovat, nové nástroje často zůstávají nevyužité a investice do jejich nastavení přichází vniveč.
Praktický postup je příjemně jednoduchý. Podívejme se na to blíže!
Krok č. 1: Připravte si data ve Snowflake
Především je nutné, aby vaše strukturovaná data byla uložena v Snowflake. Každá aplikace Cortex Analyst je nasměrována buď na jednu tabulku, nebo na pohled složený z jedné či více tabulek. Ujistěte se, že jsou vaše tabulky vytvořeny a naplněny daty.
Pokud načítáte data z plochých souborů:
- Nahrajte své datové soubory (např. CSV) do Snowflake Stage
- Pomocí příkazu COPY INTO načtěte data ze stage do svých tabulek
- Než budete pokračovat, ověřte, zda se data úspěšně načtla.
📖 Přečtěte si také: Jak používat Snowflake Cortex pro podnikovou analytiku
Krok č. 2: Vytvořte sémantický model (nebo sémantický pohled)
Toto je nejdůležitější krok při nastavení. Síla nástroje Cortex Analyst spočívá v kombinaci velkých jazykových modelů (LLM) se sémantickými modely, což je soubor YAML, který je umístěn vedle schématu vaší databáze a kóduje obchodní kontext.
Sémantické pohledy jsou nyní metodou doporučovanou společností Snowflake pro nástroj Cortex Analyst. Ukládají obchodní metriky, vztahy a definice přímo do Snowflake. Starší soubory sémantických modelů ve formátu YAML stále fungují, ale Snowflake doporučuje pro nové implementace používat sémantické pohledy.
Váš sémantický model nebo pohled by měl obsahovat:
- Popisy tabulek a sloupců: Vysvětlení významu jednotlivých polí v běžném jazyce
- Obchodní metriky: Definice vypočítaných polí, jako jsou tržby, míra odchodu zákazníků nebo míra konverze
- Filtry a synonyma: Alternativní výrazy, které mohou uživatelé použít (např. „zrušeno“ přiřazené ke konkrétní hodnotě stavu)
- Ověřené dotazy: Repozitář ověřených dotazů Snowflake ukládá schválené páry otázek a SQL dotazů. Pokud se otázka uživatele podobá některé z těchto položek, může Cortex Analyst při generování SQL na ni odkazovat.
🤝 Přátelské připomenutí: Společnost Snowflake doporučuje pro optimální výkon v rámci pracovního postupu Snowsight používat maximálně 10 tabulek a maximálně 50 vybraných sloupců.
Krok č. 3: Nahrajte sémantický model do Snowflake Stage
Pokud používáte sémantický model založený na YAML, je třeba jej připravit tak, aby na něj mohl Cortex Analyst odkazovat během běhu.
- Nahrajte svůj soubor .yaml do interní fáze Snowflake (např. RAW_DATA)
- Ověřte, zda se soubor objeví ve fázi, a to buď prostřednictvím uživatelského rozhraní Snowsight, nebo pomocí příkazu LIST @stage_name.
- Poznamenejte si cestu ke stage; budete na ni odkazovat ve svých voláních API nebo v konfiguraci aplikace.
Pokud používáte sémantický pohled, tento krok se provádí nativně v rámci Snowflake a není nutné provádět žádné samostatné nahrávání.
🔍 Věděli jste, že? Hodnota NULL v jazyce SQL neznamená nulu ani prázdnou hodnotu. Představuje neznámá nebo chybějící data, což vede k neintuitivnímu chování, jako jsou například porovnání, která nevracejí ani hodnotu true, ani false.
Krok č. 4: Odeslání dotazu v přirozeném jazyce prostřednictvím rozhraní REST API
Nyní začíná samotné generování SQL. REST API vygeneruje SQL dotaz pro danou otázku pomocí sémantického modelu nebo sémantického pohledu uvedeného v požadavku.
Strukturovejte svůj požadavek API pomocí:
- zprávy; pole obsahující otázku uživatele s rolí: „user“
- Odkaz na váš sémantický model nebo sémantický pohled
- Váš preferovaný model (nebo ponechte nastavení „auto“, aby Cortex vybral ten nejlepší)
Můžete vést vícekolové konverzace, během nichž můžete klást navazující otázky vycházející z předchozích dotazů.
Krok č. 5: Analýza odpovědi API
Každá zpráva v odpovědi může obsahovat více bloků obsahu různých typů. V poli typu jsou v současné době podporovány tři hodnoty: text, návrhy a SQL.
Zde je vysvětlení jednotlivých typů:
- SQL: Cortex úspěšně vygeneroval dotaz; tento dotaz budete provádět
- text: Vysvětlení nebo odpověď v přirozeném jazyce doprovázející dotaz SQL
- návrhy: Typ obsahu „návrhy“ je do odpovědi zahrnut pouze v případě, že otázka uživatele byla nejednoznačná a Cortex Analyst nemohl pro daný dotaz vrátit příkaz SQL. Použijte je k upřesnění nebo zpřesnění otázky
🔍 Věděli jste, že... Pořadí, v jakém píšete příkazy SQL, není pořadí, v jakém se provádějí. I když napíšete příkaz SELECT jako první, databáze ve skutečnosti nejprve zpracují příkazy FROM a WHERE a teprve poté vyberou sloupce. To mate jak začátečníky, tak i zkušené uživatele.
Krok č. 6: Spusťte vygenerovaný kód SQL v Snowflake
Jakmile získáte blok SQL z odpovědi, spusťte jej ve svém virtuálním skladu Snowflake. Generovaný dotaz SQL se provede ve vašem virtuálním skladu Snowflake, čímž se vygeneruje konečný výstup. Data zůstávají v rámci hranic správy Snowflake.
Klíčové informace, které je třeba znát v době provedení:
- Cortex Analyst je plně integrován s politikami řízení přístupu na základě rolí (RBAC) platformy Snowflake, čímž zajišťuje, že generované a prováděné dotazy SQL dodržují všechna stanovená pravidla řízení přístupu.
- Pokud uživatel nemá přístup k tabulce, dojde při provádění dotazu k selhání, stejně jako by tomu bylo u ručně napsaného kódu SQL.
- V této fázi se účtují náklady na výpočetní výkon datového skladu, které jsou oddělené od poplatků za vlastní využití služby Cortex Analyst.
Krok č. 7: Vylepšujte a opakujte
Není vždy zaručeno, že se vám podaří vytvořit dokonalý dotaz hned na první pokus. Zde je návod, jak výsledky postupem času vylepšovat:
- Přidejte ověřené dotazy do svého sémantického modelu pro otázky, které se opakovaně vyskytují
- Obohaťte svůj sémantický model o lepší popisy, synonyma a filtry, když Cortex nesprávně interpretuje nějaký termín.
- Využijte vícekolovou konverzaci k navázání, například „Teď to filtruj podle regionu“ – vícekolové konverzace umožňují navazující otázky, které vycházejí z předchozích dotazů.
- Sledujte využití pomocí CORTEX_ANALYST_USAGE_HISTORY a historie dotazů Snowflake, abyste odhalili vzorce v neúspěšných nebo nepřesných dotazech.
🧠 Zajímavost: Jedna chybějící podmínka JOIN může způsobit obrovské problémy. Zapomenutí na podmínku JOIN může vést ke vzniku kartézského součinu, který dramaticky znásobí počet řádků a někdy dokonce způsobí selhání systému.
Osvědčené postupy pro přesnost převodu textu na SQL v Snowflake
Kvalita vašeho sémantického modelu přímo určuje přesnost dotazů, které generuje. Zde jsou osvědčené postupy, které zvyšují přesnost. 🛠️
- Přidejte ověřené dotazy do svého sémantického modelu: To je to nejdůležitější, co můžete udělat. Zahrňte spoustu příkladů dvojic otázka–SQL, které odrážejí, jak váš tým skutečně klade otázky.
- Používejte popisné názvy sloupců a tabulek: Model funguje lépe, když jsou názvy sloupců a tabulek srozumitelné. Pokud nemůžete změnit schéma, přidejte do souboru YAML jasné popisy u všech nejasných názvů sloupců.
- Zahrňte vzorové hodnoty: Přidání vzorových dat pro kategorické sloupce (například stav nebo region) pomáhá modelu porozumět platným dostupným možnostem filtrování.
- Testujte s okrajovými případy: Během vývoje záměrně klást nejednoznačné nebo záludné otázky, abyste zjistili, kde váš sémantický model potřebuje více kontextu nebo upřesnění.
- Vylepšujte svůj sémantický model: Považujte svůj sémantický model za živý dokument. Měl by být průběžně aktualizován prostřednictvím iterativního procesu založeného na tom, které dotazy jsou úspěšné a které neúspěšné
ClickUp: Jednodušší alternativa k Snowflake Cortex
Snowflake Cortex se osvědčuje v případech, kdy týmy chtějí generovat SQL a spouštět dotazy na strukturovaných datech. Týmy definují schémata, mapují vztahy a píší dotazy za účelem získání poznatků. Takové nastavení dává smysl v prostředích s velkým objemem dat, zejména pokud za reporting odpovídají analytici.
Mnoho týmů však k zodpovězení každodenních provozních otázek nepotřebuje plnohodnotnou vrstvu SQL. Produktoví manažeři, vedoucí programů a provozní týmy často potřebují rychlé odpovědi související s aktuální prací.
ClickUp nabízí přístupnější řešení. Týmy kladou otázky v běžném jazyce, prohlížejí si živé dashboardy a reagují na získané poznatky, aniž by musely psát SQL nebo vytvářet sémantické modely.
Rychlejší generování a vylepšování dotazů SQL
Snowflake Cortex se zaměřuje na generování dotazů SQL ze strukturovaných datových sad v prostředí datového skladu. To funguje dobře, pokud jsou vaše data již uložena ve Snowflake a máte zmapovaná schémata.
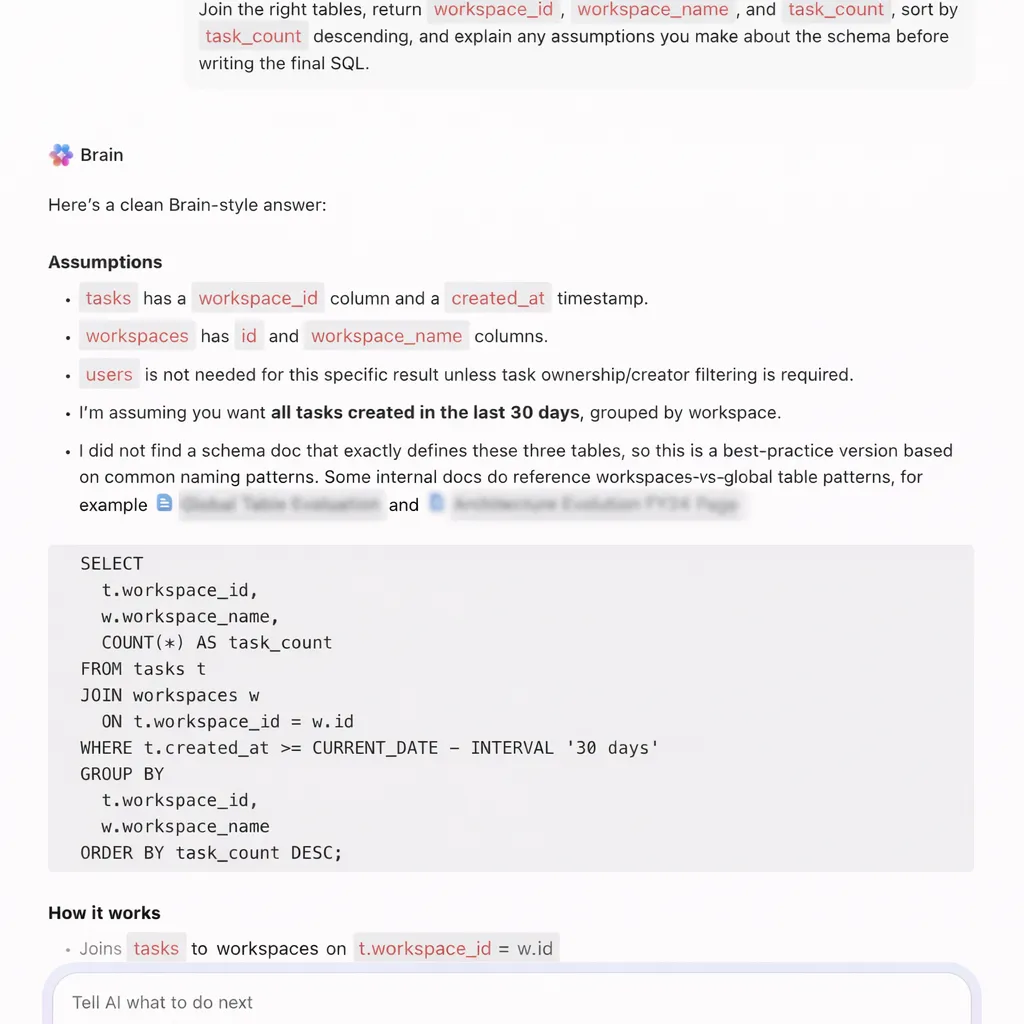
ClickUp Brain podporuje generování SQL flexibilnějším způsobem zaměřeným na provádění dotazů. Týmy generují, vylepšují a ukládají dotazy SQL přímo ve svém pracovním prostoru, kde již probíhají analýzy, diskuse a rozhodování.
Představme si, že produktový analytik pracuje na analýze retence v ClickUp. Místo toho, aby přepínal mezi nástroji a psal dotazy, zeptá se ClickUp Brain:
📌 Vyzkoušejte tento příkaz: Napište dotaz SQL pro výpočet sedmidenní retence uživatelů seskupených podle kohorty registrace.
ClickUp Brain generuje strukturovaný dotaz, který zahrnuje seskupení kohort, filtry podle data a logiku retence. Analytik vloží dotaz do Snowflake nebo jiného datového skladu a okamžitě jej spustí.
Pomáhá:
- Vytvářejte spojení mezi více tabulkami, jako jsou uživatelé, objednávky a události
- Převádějte běžné otázky o produktech v angličtině na logiku SQL připravenou k provedení
- Odstraňujte chyby v dotazech a vysvětlujte problémy, jako jsou nesprávné spojení nebo chybějící podmínky
- Přepište dotazy pro lepší výkon nebo čitelnost
Například při hodnocení experimentu zaměřeného na růst se marketingový pracovník zeptá: „Napište dotaz SQL, který porovná míry konverze mezi dvěma vstupními stránkami za posledních 14 dní“.
ClickUp Brain generuje dotaz pomocí podmíněné agregace a datových filtrů. Tým jej spustí v Snowflake a ověří výsledky experimentu.
📌 Vyzkoušejte tento příkaz: Opravte tento dotaz SQL, ve kterém spojení (join) duplikuje řádky, a vysvětlete, v čem spočívá problém.
ClickUp Brain identifikuje problém se spojováním, opraví dotaz a vysvětlí, jak došlo k duplicitním řádkům v důsledku nesprávných podmínek spojování.
Nahraďte reportování založené na SQL
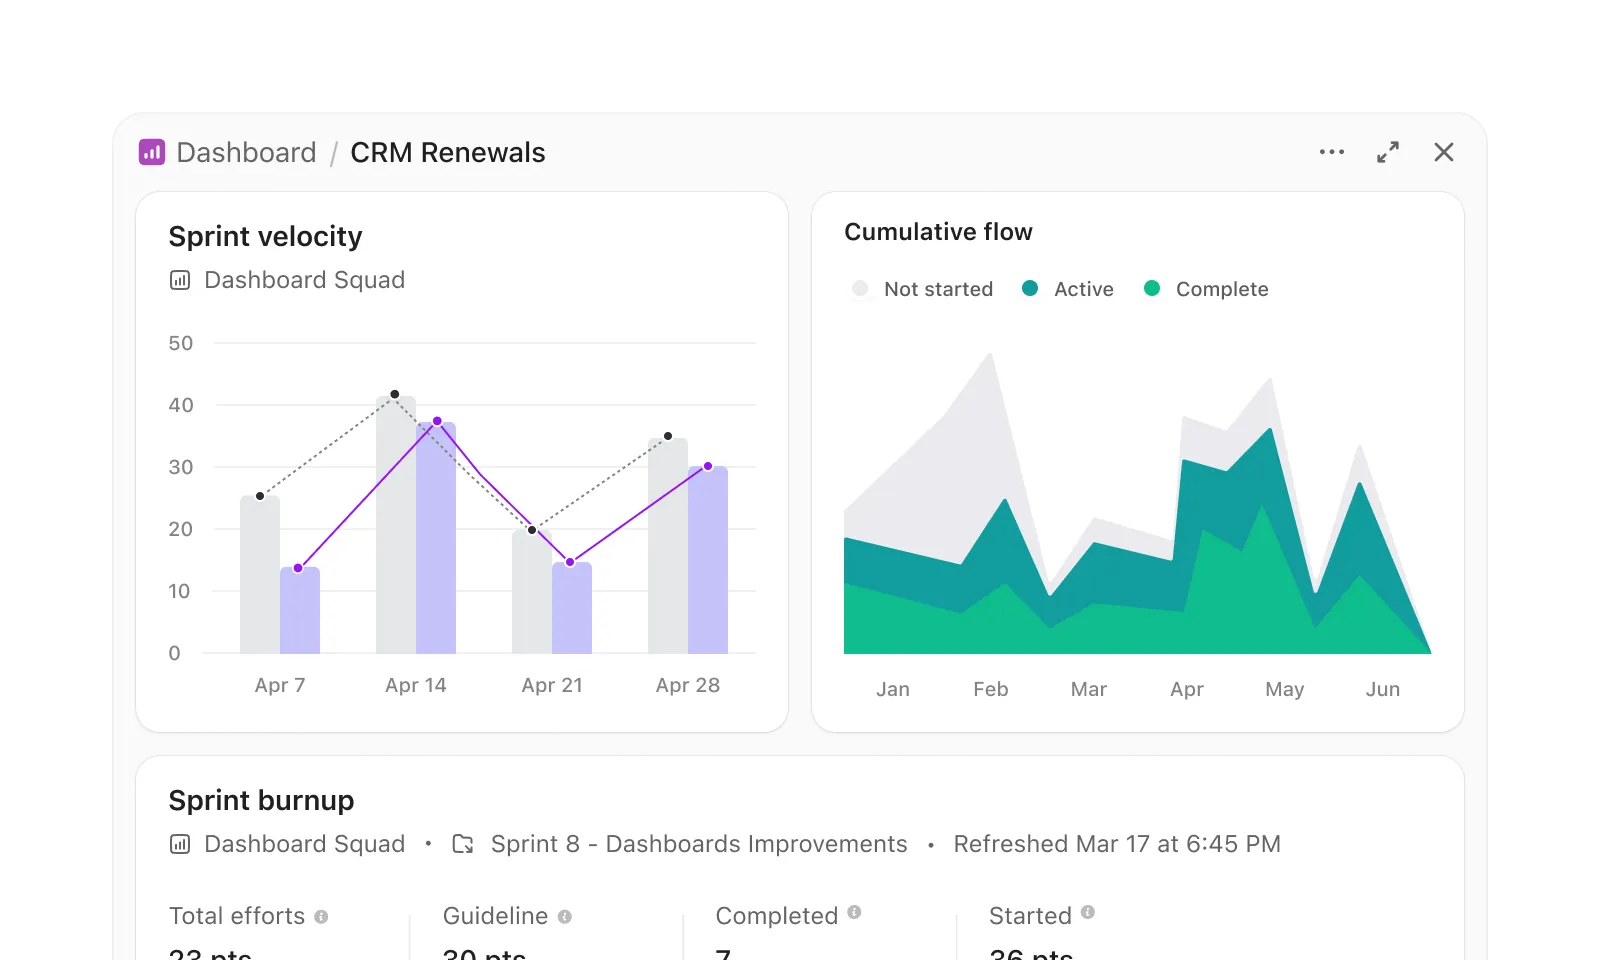
Pracovní postupy Snowflake Cortex často zahrnují generování SQL, spouštění dotazů a vizualizaci výsledků v samostatné vrstvě. Dashboardy ClickUp tento vícestupňový proces eliminují a prezentují poznatky přímo z aktuální práce.
Tým pro správu programu, který sleduje připravenost na vydání, může vytvořit dashboard bez nutnosti psát dotazy. Dashboard pro vydání může například obsahovat:
- Karta se seznamem úkolů filtrovaná tak, aby zobrazovala úkoly po termínu ve všech produktových týmech
- Karta pracovního zatížení, která zobrazuje rozložení úkolů mezi jednotlivé inženýry
- Sloupcový graf porovnávající dokončené a nevyřízené úkoly podle sprintu
- Výpočetní karta sledující průměrnou dobu dokončení
Představme si, že vedoucí programu před schůzkou k vydání zkontroluje tento dashboard. Okamžitě si všimne, že backendové služby vykazují vyšší míru zpoždění. Otevře kartu se seznamem úkolů a zkontroluje konkrétní úkoly, které představují riziko.
Své zkušenosti sdílí skutečný uživatel ClickUp:
ClickUp nám umožňuje RYCHLE si navzájem předávat projekty, SNADNO kontrolovat stav projektů a dává naší nadřízené kdykoli přehled o našem pracovním vytížení, aniž by nás musela rušit. Díky ClickUp jsme určitě ušetřili jeden den týdně, ne-li více. Počet e-mailů se VÝRAZNĚ snížil.
ClickUp nám umožňuje RYCHLE si navzájem předávat projekty, SNADNO kontrolovat stav projektů a dává naší nadřízené přehled o našem pracovním vytížení kdykoli, aniž by nás musela rušit. Díky ClickUp jsme určitě ušetřili jeden den týdně, ne-li více. Počet e-mailů se VÝRAZNĚ snížil.
Reagujte na poznatky bez nutnosti vytvářet datové potrubí
Snowflake Cortex se zaměřuje na získávání poznatků z dat. Týmy však stále musí výsledky interpretovat a spouštět akce samostatně.
Superagenti ClickUp AI tuto mezeru vyplňují a proměňují poznatky v konkrétní akce. Fungují jako AI spolupracovníci, kteří nepřetržitě monitorují data v pracovním prostoru a na základě daných podmínek podnikají příslušné kroky.
Předpokládejme, že programový manažer dohlíží na několik produktových iniciativ. Super Agent dokáže:
- Sledujte úkoly napříč projekty a zjistěte, kdy počet zpožděných úkolů překročí definovanou hranici
- Identifikujte vzorce, jako jsou opakovaná zpoždění ve stejné fázi pracovního postupu
- Vytvořte úkol, který shrne dotčené projekty, a přiřaďte jej vedoucímu programu
- Upozorněte vedoucí týmů, pokud kritické úkoly zůstávají nevyřešeny i po uplynutí termínů
Například během cyklu vydávání nové verze Super Agent zjistí, že ve dvou týmech nebylo dodrženo více než 10 úkolů s vysokou prioritou. Vytvoří úkol v ClickUp s názvem „Riziko vydání: nedodržené termíny“, připojí k němu všechny relevantní úkoly a přiřadí jej programovému manažerovi k okamžitému posouzení.
Týmy mohou také přímo komunikovat se Super Agentem: „Analyzuj všechny aktivní projekty a vyznač rizika dodání pro tento sprint“.
Super Agent zkontroluje termíny, závislosti a stav úkolů a poté zveřejní strukturované shrnutí v pracovním prostoru.
Zde je návod, jak si v ClickUp nastavit vlastního Super Agenta:
Centralizujte své datové pracovní postupy pomocí ClickUp
Nástroje pro převod textu na SQL, jako je Snowflake Cortex, zvyšují přístupnost dat. Získání spolehlivých výsledků však stále vyžaduje určité úsilí.
Týmy potřebují přehledná schémata, silné sémantické modely a neustálé iterace, aby výstupy zůstaly přesné. Ani po vygenerování správného dotazu práce nekončí. Někdo stále musí výsledky interpretovat, sdílet poznatky a proměnit je v rozhodnutí.
ClickUp přináší odlišný přístup. Namísto oddělení analýzy od provedení ClickUp obě tyto činnosti propojuje. Týmy generují dotazy SQL, dokumentují poznatky, spolupracují na zjištěních a na jejich základě jednají, a to vše v rámci stejného pracovního prostoru.
ClickUp Brain pomáhá psát a vylepšovat dotazy, zatímco řídicí panely a agenti s umělou inteligencí pomáhají týmům sledovat výsledky a posouvat práci vpřed, aniž by museli přepínat mezi různými nástroji.
Snowflake Cortex vám pomůže získat odpovědi. ClickUp vám pomůže s nimi pracovat. Zaregistrujte se do ClickUp ještě dnes!
Často kladené otázky
Co je Snowflake Cortex Analyst a v čem se liší od Cortex AI?
Snowflake Cortex Analyst je specializovaná služba v rámci širší sady Snowflake Cortex AI. Cortex Analyst se zaměřuje konkrétně na generování dotazů typu „text-to-SQL“ pomocí sémantických modelů, zatímco Cortex AI zahrnuje širší škálu funkcí LLM, inferenci modelů strojového učení a vyhledávací funkce.
Funguje Snowflake Cortex Analyst s externími zdroji dat, jako jsou tabulky Iceberg?
Ano, Cortex Analyst dokáže dotazovat tabulky Apache Iceberg spravované prostřednictvím Snowflake. Pokud jsou tabulky dostupné ve vašem prostředí Snowflake a správně definovány ve vašem sémantickém modelu, můžete na nich generovat dotazy.
Jak přesná je generace text-to-SQL v Snowflake u složitých dotazů?
Přesnost složitých dotazů závisí téměř výhradně na kvalitě vašeho sémantického modelu. Model s dobře definovanými vztahy mezi tabulkami, četnými ověřenými dotazy a popisnými metadaty bude poskytovat výrazně přesnější výsledky při spojování více tabulek a složitých agregacích.
Kolik stojí funkce Snowflake Cortex pro generování SQL?
Ceny služby Snowflake Cortex Analyst se řídí modelem Snowflake založeným na spotřebě, což znamená, že vám budou účtovány poplatky na základě výpočetních kreditů spotřebovaných během procesu generování dotazů. Aktuální sazby najdete vždy v oficiální cenové dokumentaci společnosti Snowflake.