
ทีมส่วนใหญ่ถือว่าการสร้าง SQL เป็นเหมือนกลมายากล คุณเพียงพิมพ์คำถาม ก็ได้รับคำสั่งค้นหาทันที
แต่ความจริงคือ: Snowflake Cortex Analyst จะทำงานได้ดีเพียงเท่าที่โมเดลเชิงความหมายที่คุณสร้างขึ้นก่อนนั้นดีเท่านั้น และการตั้งค่าดังกล่าวไม่ใช่เรื่องง่าย การเรียนรู้วิธีใช้ Snowflake Cortex เพื่อสร้าง SQL ทำให้ทีมข้อมูลสามารถแปลงภาษาธรรมชาติเป็นคำสั่งค้นหาที่ซับซ้อนและสามารถดำเนินการได้ในไม่กี่วินาที
คู่มือนี้จะนำคุณผ่านกระบวนการนำไปใช้จริง ตั้งแต่การกำหนดโมเดลความหมาย YAML ไปจนถึงการส่งคำสั่งค้นหาข้อมูลในคลังข้อมูลโดยใช้ภาษาธรรมชาติ เพื่อให้คุณเข้าใจทั้งศักยภาพและข้อกำหนดเบื้องต้นก่อนที่จะเริ่มใช้งาน
นอกจากนี้ เรายังจะวิเคราะห์จุดอ่อนของ Snowflake Cortex และวิธีที่ClickUpสามารถสนับสนุนกระบวนการทำงานที่กว้างขึ้นที่เกี่ยวข้องกับการสร้าง SQL ได้อย่างไร
Snowflake Cortex Analyst คืออะไร?
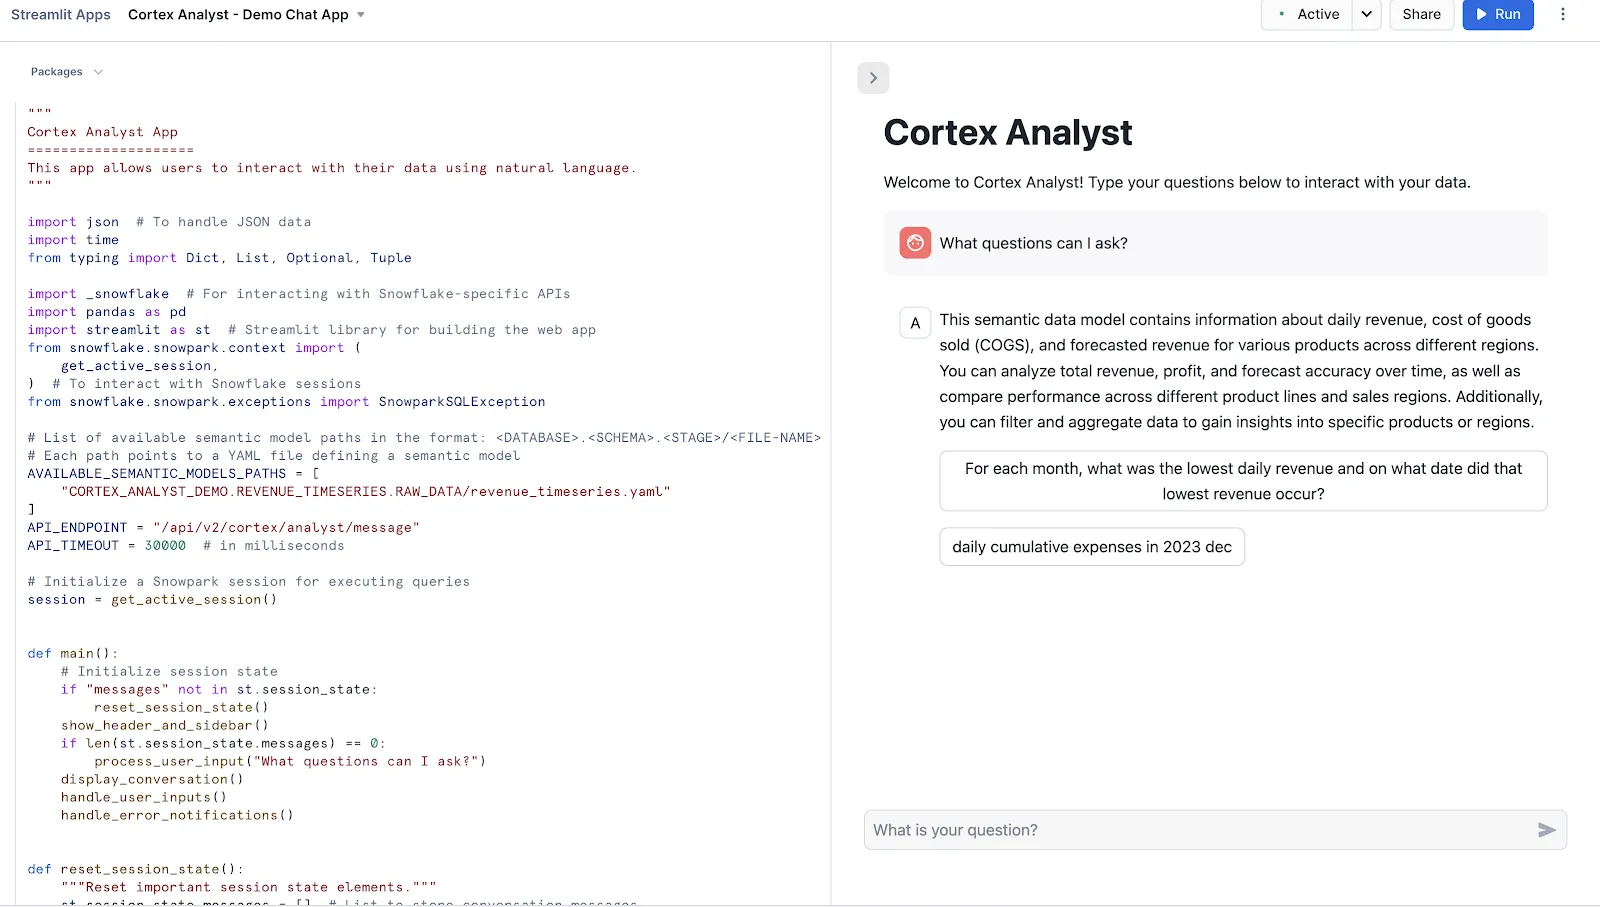
Snowflake Cortex Analyst เป็นบริการที่ได้รับการจัดการอย่างครบถ้วน ซึ่งช่วยให้คุณสามารถสร้างแอปพลิเคชันแบบสนทนาบนข้อมูลวิเคราะห์ของคุณได้
บริการนี้ใช้เอเจนต์แปลงข้อความเป็น SQL ที่ได้รับการออกแบบมาโดยเฉพาะ เพื่อเปลี่ยนคำถามในภาษาธรรมชาติให้เป็นคำสั่งค้นหาที่แม่นยำและสามารถดำเนินการได้ บริการนี้ช่วยเชื่อมช่องว่างระหว่างโครงสร้างข้อมูลที่ซับซ้อนกับผู้ใช้ธุรกิจที่ต้องการคำตอบโดยไม่ต้องเขียนโค้ด
คุณสมบัติหลัก ได้แก่:
- ให้อินเทอร์เฟซที่มีความแม่นยำสูงสำหรับการโต้ตอบกับข้อมูลที่มีโครงสร้าง
- ใช้โมเดลเซมิติกเพื่อเข้าใจตรรกะธุรกิจและศัพท์เฉพาะของคุณ
- มี REST API เพื่อการผสานรวมที่ง่ายดายกับแอปพลิเคชันที่ปรับแต่งเองหรือเครื่องมือ BI
- รักษาความเป็นส่วนตัวของข้อมูลด้วยการประมวลผลคำขอภายในขอบเขตความปลอดภัยของ Snowflake
📮 ClickUp Insight: 88% ของผู้ตอบแบบสำรวจของเราใช้ AI สำหรับงานส่วนตัว แต่กว่า 50% ยังลังเลที่จะใช้มันในที่ทำงาน อุปสรรคหลัก 3 ประการคือ? การขาดการบูรณาการที่ราบรื่น ช่องว่างด้านความรู้ หรือความกังวลเรื่องความปลอดภัย
แต่หาก AI ถูกบูรณาการไว้ในพื้นที่ทำงานของคุณและมีความปลอดภัยอยู่แล้วล่ะ? ClickUp Brain — ผู้ช่วย AI ที่มาพร้อมใน ClickUp — ทำให้สิ่งนี้เป็นจริงได้ มันเข้าใจคำสั่งในภาษาธรรมดา ช่วยแก้ปัญหาทั้งสามข้อที่มักกังวลเมื่อนำ AI มาใช้ พร้อมทั้งเชื่อมต่อแชท งาน เอกสาร และความรู้ของคุณทั่วทั้งพื้นที่ทำงาน
ค้นพบคำตอบและข้อมูลเชิงลึกด้วยเพียงคลิกเดียว!
เงื่อนไขเบื้องต้นสำหรับการสร้าง SQL ด้วย Snowflake Cortex
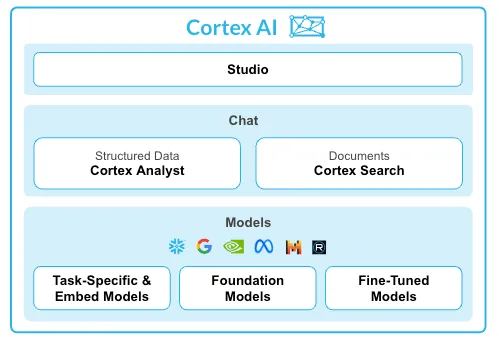
การเริ่มใช้ Snowflake Cortex โดยไม่มีการตั้งค่าที่ถูกต้องจะก่อให้เกิดความหงุดหงิด คุณอาจได้รับผลลัพธ์ที่ไม่แม่นยำ เสียเวลาในการแก้ไขปัญหา และสรุปผิดว่าเครื่องมือมีปัญหา ทั้งที่ปัญหาที่แท้จริงคือพื้นฐานที่ยังไม่มั่นคง
เพื่อหลีกเลี่ยงปัญหานี้ คุณต้องจัดเตรียมสามองค์ประกอบพื้นฐานให้พร้อมก่อน
1. ตั้งค่าฐานข้อมูลและตาราง
ความฉลาดของ AI ของคุณขึ้นอยู่กับข้อมูลที่มันสามารถเข้าถึงได้ หากโครงสร้างฐานข้อมูลของคุณเป็นเขาวงกตของชื่อคอลัมน์ที่เข้าใจยาก เช่น cust_dat_v2_final ทั้งนักวิเคราะห์และ AI ของคุณก็จะพบความยากลำบากในการเข้าใจข้อมูลนั้น
ความสับสนนี้ทำให้ AI สร้างการ join ที่ไม่ถูกต้องหรือดึงข้อมูลจากคอลัมน์ที่ผิด ทำให้ทีมของคุณต้องเสียเวลาหลายชั่วโมงเพียงเพื่อพยายามถอดรหัสสคีมา ก่อนที่จะสามารถเขียนคำสั่งค้นหาได้
เริ่มด้วยการตรวจสอบให้แน่ใจ ว่าซอฟต์แวร์คลังข้อมูลของคุณมีตารางที่คุณต้องการให้ Cortex Analyst ทำการค้นหาข้อมูล เมื่อเป็นไปได้ ให้ใช้ชื่อคอลัมน์ที่ชัดเจนและอธิบายได้ เช่น คอลัมน์ที่มีชื่อ customer_lifetime_value จะเข้าใจได้ง่ายกว่ามากทั้งสำหรับมนุษย์และ AI เมื่อเทียบกับ clv_01
เพื่อดำเนินการตั้งค่าต่อไป บทบาท Snowflake ของคุณจะต้องมีสิทธิ์ดังต่อไปนี้:
- วิธีใช้: บนฐานข้อมูลและสคีมาที่มีตารางของคุณ
- SELECT: บนตารางที่คุณต้องการให้ Cortex Analyst ทำการค้นหาข้อมูล
- CREATE STAGE: บนสคีมา ซึ่งจำเป็นสำหรับการอัปโหลดไฟล์โมเดลเซมิติกของคุณ
📖 อ่านเพิ่มเติม: วิธีใช้ Snowflake Cortex สำหรับ Business Intelligence
2. สร้างไฟล์โมเดลเซมิติกของคุณ
อุปสรรคใหญ่ที่สุดของเครื่องมือแปลงข้อความเป็น SQL ใดๆ ก็คือ AI ไม่เข้าใจภาษาเฉพาะของบริษัทคุณ มันไม่ทราบโดยธรรมชาติว่า “ARR” หมายถึง “Annual Recurring Revenue” หรือว่าตารางลูกค้าของคุณจะทำการ join กับตารางคำสั่งซื้อผ่านฟิลด์ customer_id
หากขาดบริบทนี้ AI อาจสร้าง SQL ที่ถูกต้องทางเทคนิคแต่ผิดทางตรรกะ ซึ่งให้คำตอบที่ดูเหมือนถูกต้องแต่กลับทำให้เข้าใจผิดอย่างอันตราย
โมเดลเชิงความหมายคือคำตอบ มันคือไฟล์ YAML ที่ทำหน้าที่เป็น “ชั้นแปล” ที่ปรับแต่งได้ ซึ่งสอน Cortex Analyst ให้เข้าใจคำศัพท์และตรรกะเฉพาะของธุรกิจคุณ การสร้างและดูแลไฟล์นี้ต้องอาศัยความร่วมมือระหว่างวิศวกรข้อมูลที่ใช้ เครื่องมือ ETLเพื่อเข้าใจโครงสร้างข้อมูล (schema) และนักวิเคราะห์ธุรกิจที่เข้าใจคำศัพท์เฉพาะ
ไฟล์โมเดลเซมิติกของคุณควรประกอบด้วยองค์ประกอบหลักต่อไปนี้:
| ส่วนประกอบ | วัตถุประสงค์ |
| ตาราง | แสดงรายชื่อตารางแต่ละตารางพร้อมคำอธิบายวัตถุประสงค์ของตารางด้วยภาษาธรรมดา |
| คอลัมน์ | กำหนดประเภทความหมายของแต่ละคอลัมน์ (เช่น หมวดหมู่หรือตัวชี้วัด) และสามารถรวมค่าตัวอย่างได้ |
| ความสัมพันธ์ | กำหนดวิธีที่ตารางต่าง ๆ เชื่อมต่อกันผ่านการ join เพื่อขจัดความไม่แน่นอนในการทำงานของ AI |
| คำสั่งค้นหาที่ผ่านการตรวจสอบ | ให้ตัวอย่างคู่คำถาม-SQL ที่ทำหน้าที่เป็นคู่มือที่มีประสิทธิภาพสูงสำหรับ LLM |
3. ตั้งค่า Cortex Search Service (ไม่บังคับ)
บางครั้ง คำตอบที่คุณต้องการอาจซ่อนอยู่ในข้อความที่ไม่มีโครงสร้าง เช่น คำอธิบายผลิตภัณฑ์ ตั๋วสนับสนุน หรือบันทึกการสนทนาทางโทรศัพท์ คำสั่ง SQL มาตรฐานไม่สามารถเข้าถึงข้อมูลเหล่านี้ได้ ซึ่งหมายความว่าคุณมักพลาด ‘เหตุผล’ ที่อยู่เบื้องหลัง ‘สิ่งที่เกิดขึ้น’
คุณสามารถเพิ่ม Snowflake Cortex Search Service ได้ที่นี่ตามความต้องการ นี่คือชั้นบริการ ค้นหาแบบ Search-as-a-Serviceที่ช่วยให้คุณสามารถส่งคำสั่งค้นหาไปยังทั้งตารางข้อมูลที่มีโครงสร้างและข้อมูลข้อความที่ไม่มีโครงสร้างได้พร้อมกัน โดยใช้ เอเยนต์ AI สำหรับการวิเคราะห์ข้อมูล
คุณควรตั้งค่า Cortex Search หากนักวิเคราะห์ของคุณจำเป็นต้องถามคำถามที่จำเป็นต้องดึงบริบทจากข้อความก่อนที่จะสร้าง SQL ตัวอย่างเช่น คุณสามารถค้นหาบทวิจารณ์ผลิตภัณฑ์ทั้งหมดที่มีวลี ‘battery issue’ ก่อน แล้วสร้างคำสั่ง SQL เพื่อรวมข้อมูลการขายเฉพาะสำหรับผลิตภัณฑ์เหล่านั้น
สำหรับการสร้าง SQL แบบบริสุทธิ์สำหรับตารางที่มีโครงสร้าง บริการนี้ไม่จำเป็น
🧠 ข้อมูลน่าสนใจ:ในช่วงต้นทศวรรษ 1970 นักวิจัยของ IBM คือ Donald Chamberlin และ Raymond Boyce ได้สร้าง ‘Structured English Query Language’ ขึ้น แต่พวกเขาต้องเปลี่ยนชื่อเป็น SQL เพราะ ‘SEQUEL’ ได้ถูกจดทะเบียนเครื่องหมายการค้าไว้แล้วโดยบริษัทผลิตเครื่องบินของอังกฤษ
คู่มือทีละขั้นตอนในการสร้าง SQL ด้วย Cortex Analyst
คุณได้เตรียมงานไว้แล้ว แต่ตอนนี้คุณกำลังเผชิญกับหน้าจอว่างเปล่า และไม่แน่ใจเกี่ยวกับขั้นตอนการทำงานที่แท้จริง คุณจะเปลี่ยนคำถามในหัวให้กลายเป็นคำสั่ง SQL ที่สามารถรันได้อย่างไร? เมื่อขั้นตอนการทำงานไม่ชัดเจน เครื่องมือใหม่มักไม่ถูกใช้งาน และการลงทุนในการตั้งค่าก็สูญเปล่า
กระบวนการฝึกปฏิบัติจริงนี้ง่ายและเข้าใจได้อย่างรวดเร็ว มาดูรายละเอียดกัน!
ขั้นตอนที่ 1: เตรียมข้อมูลของคุณใน Snowflake
ก่อนอื่นใด ข้อมูลที่มีโครงสร้างของคุณต้องถูกจัดเก็บไว้ใน Snowflake ก่อน แอปพลิเคชัน Cortex Analyst แต่ละตัวจะถูกกำหนดให้ชี้ไปยังตารางเดียว หรือวิวที่ประกอบด้วยตารางหนึ่งหรือหลายตาราง ตรวจสอบให้แน่ใจว่าตารางของคุณได้ถูกสร้างขึ้นและเติมข้อมูลเรียบร้อยแล้ว
หากคุณกำลังโหลดข้อมูลจากไฟล์แบบแบน:
- อัปโหลดไฟล์ข้อมูลของคุณ (เช่น CSV) ไปยัง Snowflake Stage
- ใช้คำสั่ง COPY INTO เพื่อโหลดข้อมูลจาก stage เข้าสู่ตารางของคุณ
- ตรวจสอบให้แน่ใจว่าข้อมูลได้โหลดสำเร็จแล้วก่อนที่จะดำเนินการต่อ
📖 อ่านเพิ่มเติม: วิธีใช้ Snowflake Cortex สำหรับการวิเคราะห์ข้อมูลระดับองค์กร
ขั้นตอนที่ 2: สร้างโมเดลเชิงความหมาย (หรือมุมมองเชิงความหมาย)
นี่คือขั้นตอนการตั้งค่าที่สำคัญที่สุด ความสามารถของ Cortex Analyst มาจากการรวมโมเดลภาษาขนาดใหญ่(LLMs) กับโมเดลเซมิติก ซึ่งเป็นไฟล์ YAML ที่อยู่คู่กับสคีมาฐานข้อมูลของคุณ และเข้ารหัสบริบททางธุรกิจ
Semantic Views เป็นวิธีการที่ Snowflake แนะนำสำหรับ Cortex Analyst ในปัจจุบัน โดยเก็บข้อมูลเมตริกทางธุรกิจ ความสัมพันธ์ และคำนิยามไว้โดยตรงภายใน Snowflake ไฟล์โมเดลเซมานติก YAML แบบเดิมยังคงใช้งานได้ แต่ Snowflake แนะนำให้ใช้ Semantic Views สำหรับการนำไปใช้ใหม่
โมเดลหรือมุมมองเชิงความหมายของคุณควรรวมถึง:
- คำอธิบายตารางและคอลัมน์: คำอธิบายด้วยภาษาธรรมดาเกี่ยวกับความหมายของแต่ละฟิลด์
- ตัวชี้วัดทางธุรกิจ: คำนิยามสำหรับฟิลด์ที่คำนวณได้ เช่น รายได้ อัตราการสูญเสียลูกค้า หรืออัตราการแปลง
- ตัวกรองและคำพ้องความหมาย: คำทางเลือกที่ผู้ใช้อาจใช้ (เช่น ‘cancelled’ ที่ถูกแมปไปยังค่าสถานะเฉพาะ)
- คำสั่งที่ได้รับการยืนยัน: Snowflake’s Verified Query Repository เก็บคู่คำถามและคำสั่ง SQL ที่ได้รับการอนุมัติไว้ เมื่อคำถามของผู้ใช้คล้ายกับหนึ่งในรายการเหล่านั้น Cortex Analyst สามารถอ้างอิงรายการนั้นได้ระหว่างการสร้างคำสั่ง SQL
🤝 คำเตือนที่เป็นมิตร: Snowflake แนะนำให้ใช้ไม่มากกว่า 10 ตาราง และไม่มากกว่า 50 คอลัมน์ที่เลือก เพื่อประสิทธิภาพที่ดีที่สุดในกระบวนการทำงานของ Snowsight
ขั้นตอนที่ 3: อัปโหลดโมเดลเซมิติกไปยัง Snowflake stage
หากคุณกำลังใช้โมเดลเซมิติกที่อิงจาก YAML โมเดลดังกล่าวจำเป็นต้องถูกจัดเตรียมไว้เพื่อให้ Cortex Analyst สามารถอ้างอิงได้ขณะทำงาน
- อัปโหลดไฟล์ .yaml ของคุณไปยัง stage ภายในของ Snowflake (เช่น RAW_DATA)
- ตรวจสอบว่าไฟล์ปรากฏใน stage ผ่าน Snowsight UI หรือคำสั่ง LIST @stage_name
- โปรดบันทึกเส้นทางของ stage ไว้; คุณจะต้องอ้างอิงถึงมันในการเรียก API หรือการตั้งค่าแอปของคุณ
หากคุณกำลังใช้ Semantic View ขั้นตอนนี้จะได้รับการจัดการโดย Snowflake เอง โดยไม่ต้องอัปโหลดข้อมูลเพิ่มเติม
🔍 คุณรู้ไหม? NULL ใน SQLไม่หมายถึงศูนย์หรือว่างเปล่า แต่เป็นตัวแทนของข้อมูลที่ไม่ทราบหรือขาดหายไป ซึ่งอาจก่อให้เกิดพฤติกรรมที่ขัดกับสัญชาตญาณ เช่น การเปรียบเทียบที่ให้ผลลัพธ์ไม่ใช่ทั้ง true หรือ false
ขั้นตอนที่ 4: ส่งคำถามด้วยภาษาธรรมชาติผ่าน REST API
ตอนนี้กระบวนการสร้าง SQL จริงจะเริ่มขึ้นแล้ว REST API จะสร้างคำสั่ง SQL สำหรับคำถามที่กำหนด โดยใช้โมเดลเชิงความหมายหรือมุมมองเชิงความหมายที่ระบุไว้ในคำขอ
จัดโครงสร้างคำขอ API ของคุณด้วย:
- ข้อความ; มصفوفาที่ประกอบด้วยคำถามของผู้ใช้ของคุณ พร้อมด้วยบทบาท: “user”
- การอ้างอิงไปยังโมเดลเชิงความหมายหรือมุมมองเชิงความหมายของคุณ
- เลือกโมเดลที่คุณต้องการ (หรือปล่อยให้เป็น "auto" เพื่อให้ Cortex เลือกโมเดลที่ดีที่สุด)
คุณสามารถสนทนาแบบหลายรอบได้ โดยสามารถถามคำถามต่อที่พัฒนาจากคำสั่งค้นหาเดิม
ขั้นตอนที่ 5: วิเคราะห์คำตอบจาก API
ข้อความแต่ละข้อความในคำตอบอาจมีหลายบล็อกเนื้อหาประเภทต่าง ๆ ค่าสามประเภทที่ได้รับการสนับสนุนในปัจจุบันสำหรับสนามประเภท ได้แก่: text, suggestions และ SQL
ต่อไปนี้คือความหมายของแต่ละประเภท:
- SQL: Cortex ได้สร้างคำสั่งค้นหาสำเร็จแล้ว; นี่คือคำสั่งที่คุณจะนำไปใช้
- text: คำอธิบายหรือคำตอบในภาษาธรรมชาติที่มาพร้อมกับคำสั่ง SQL
- คำแนะนำ: ประเภทเนื้อหา "คำแนะนำ" จะถูกรวมไว้ในคำตอบเฉพาะเมื่อคำถามของผู้ใช้ไม่ชัดเจน และ Cortex Analyst ไม่สามารถส่งคืนคำสั่ง SQL สำหรับการค้นหาดังกล่าวได้ ใช้คำแนะนำเหล่านี้เพื่อชี้แจงหรือปรับคำถามให้ชัดเจนยิ่งขึ้น
🔍 คุณรู้ไหม?ลำดับที่คุณเขียน SQLไม่เท่ากับลำดับที่มันทำงาน แม้คุณจะเขียน SELECT ก่อน แต่ฐานข้อมูลจะประมวลผล FROM และ WHERE ก่อนที่จะเลือกคอลัมน์ ซึ่งทำให้ทั้งผู้เริ่มต้นและผู้ใช้ที่มีประสบการณ์สับสน
ขั้นตอนที่ 6: ดำเนินการ SQL ที่สร้างขึ้นใน Snowflake
เมื่อได้รับบล็อก SQL จากคำตอบแล้ว ให้รันมันบน Snowflake virtual warehouse ของคุณ คำสั่ง SQL ที่สร้างขึ้นจะถูกดำเนินการใน Snowflake virtual warehouse ของคุณ เพื่อสร้างผลลัพธ์สุดท้าย ข้อมูลจะยังคงอยู่ภายในขอบเขตการกำกับดูแลของ Snowflake
สิ่งที่สำคัญที่ควรรู้ในเวลาดำเนินการ:
- Cortex Analyst ผสานรวมอย่างสมบูรณ์กับนโยบายการควบคุมการเข้าถึงตามบทบาท (RBAC) ของ Snowflake ซึ่งรับประกันว่าคำสั่ง SQL ที่สร้างและดำเนินการจะปฏิบัติตามการควบคุมการเข้าถึงที่กำหนดไว้ทั้งหมด
- หากผู้ใช้ไม่มีสิทธิ์เข้าถึงตาราง คำสั่งค้นหาจะล้มเหลวในการดำเนินการ เช่นเดียวกับเมื่อเขียน SQL ด้วยมือ
- ในขั้นตอนนี้จะมีค่าใช้จ่ายในการประมวลผลของคลังข้อมูล ซึ่งแยกต่างหากจากค่าใช้บริการของ Cortex Analyst เอง
ขั้นตอนที่ 7: ปรับแต่งและทำซ้ำ
การได้รับคำสั่งค้นหาที่สมบูรณ์แบบตั้งแต่ครั้งแรกอาจไม่เกิดขึ้นเสมอไป นี่คือวิธีปรับปรุงผลลัพธ์ให้ดีขึ้นตามเวลา:
- เพิ่มคำสั่งค้นหาที่ได้รับการตรวจสอบ เข้าสู่โมเดลเชิงความหมายของคุณ สำหรับคำถามที่ปรากฏขึ้นซ้ำๆ
- เสริมความสมบูรณ์ให้โมเดลเซมิติก ด้วยคำอธิบายที่ดีขึ้น คำพ้องความหมาย และตัวกรอง เมื่อ Cortex ตีความคำผิด
- ใช้การสนทนาหลายรอบ เพื่อติดตามผล เช่น ‘ตอนนี้กรองข้อมูลนั้นตามภูมิภาค’, การสนทนาหลายรอบช่วยให้สามารถถามคำถามต่อที่ต่อยอดจากคำสั่งค้นหาเดิม
- ติดตามการใช้งาน ผ่าน CORTEX_ANALYST_USAGE_HISTORY และประวัติการค้นหาของ Snowflake เพื่อค้นพบรูปแบบในคำสั่งค้นหาที่ล้มเหลวหรือไม่ถูกต้อง
🧠 ข้อมูลน่าสนใจ: การขาดเงื่อนไข JOIN เพียงหนึ่งข้อก็อาจก่อให้เกิดปัญหาใหญ่ได้ การลืมเงื่อนไข JOIN อาจทำให้เกิดผลคูณคาร์ทีเซียน ซึ่งทำให้จำนวนแถวเพิ่มขึ้นอย่างมหาศาล และบางครั้งอาจทำให้ระบบล่มได้
แนวทางปฏิบัติที่ดีที่สุดเพื่อเพิ่มความแม่นยำในการแปลงข้อความเป็น SQL ของ Snowflake
คุณภาพของโมเดลเซมิติกของคุณมีผลโดยตรงต่อความแม่นยำของคำสั่งค้นหาที่มันสร้างขึ้น นี่คือแนวทางปฏิบัติที่ดีที่สุดที่ช่วยเพิ่มความแม่นยำ 🛠️
- เพิ่มคำสั่ง SQL ที่ได้รับการตรวจสอบแล้วลงในโมเดลเซมิติกของคุณ: นี่คือสิ่งที่มีผลกระทบมากที่สุดที่คุณสามารถทำได้ ให้รวมตัวอย่างคู่คำถาม-SQL จำนวนมากที่สะท้อนถึงวิธีที่ทีมของคุณถามคำถามอย่างจริงจัง
- ใช้ชื่อคอลัมน์และชื่อตารางที่อธิบายได้ชัดเจน: โมเดลจะทำงานได้ดีขึ้นเมื่อชื่อคอลัมน์และชื่อตารางสามารถเข้าใจได้โดยไม่ต้องอธิบายเพิ่มเติม หากไม่สามารถเปลี่ยนสคีมาได้ ให้เพิ่มคำอธิบายที่ชัดเจนในไฟล์ YAML สำหรับชื่อคอลัมน์ที่เข้าใจยาก
- รวมค่าตัวอย่าง: การเพิ่มข้อมูลตัวอย่างสำหรับคอลัมน์ประเภทหมวดหมู่ (เช่น สถานะหรือภูมิภาค) จะช่วยให้โมเดลเข้าใจตัวเลือกตัวกรองที่ถูกต้องที่มีอยู่
- ทดสอบกับกรณีพิเศษ: ระหว่างการพัฒนา ให้ตั้งคำถามที่คลุมเครือหรือซับซ้อนอย่างตั้งใจ เพื่อระบุจุดที่โมเดลความหมายของคุณต้องการบริบทเพิ่มเติมหรือการชี้แจง
- ปรับปรุงโมเดลเซมิติกของคุณอย่างต่อเนื่อง: ถือโมเดลเซมิติกของคุณเป็นเอกสารที่พัฒนาได้ตลอดเวลา มันควรได้รับการอัปเดตอย่างต่อเนื่องผ่าน กระบวนการปรับปรุงซ้ำๆโดยพิจารณาจากคำสั่งค้นหาที่ประสบความสำเร็จและคำสั่งค้นหาที่ล้มเหลว
ClickUp: ทางเลือกที่ง่ายกว่า Snowflake Cortex
Snowflake Cortex ทำงานได้ดีเมื่อทีมต้องการสร้าง SQL และรันคำสั่งค้นหาบนข้อมูลที่มีโครงสร้าง ทีมสามารถกำหนดสคีมา กำหนดความสัมพันธ์ และเขียนคำสั่งค้นหาเพื่อสกัดข้อมูลเชิงลึก การตั้งค่านี้เหมาะสมกับสภาพแวดล้อมที่มีข้อมูลจำนวนมาก โดยเฉพาะอย่างยิ่งเมื่อนักวิเคราะห์เป็นผู้รับผิดชอบในการสร้างรายงาน
อย่างไรก็ตาม ทีมงานหลายทีมไม่จำเป็นต้องใช้ชั้น SQL แบบเต็มรูปแบบเพื่อตอบคำถามด้านการดำเนินงานประจำวัน ผู้จัดการผลิตภัณฑ์ ผู้นำโครงการ และทีมปฏิบัติการมักต้องการคำตอบที่รวดเร็วและเกี่ยวข้องกับงานที่กำลังดำเนินการอยู่
ClickUp ให้ทางเลือกที่เข้าถึงได้ง่ายกว่า ทีมสามารถถามคำถามด้วยภาษาธรรมดา ตรวจสอบแดชบอร์ดแบบเรียลไทม์ และดำเนินการตามข้อมูลเชิงลึกได้โดยไม่ต้องเขียน SQL หรือสร้างโมเดลเชิงความหมาย
สร้างและปรับปรุง SQL ได้เร็วขึ้น
Snowflake Cortex มุ่งเน้นไปที่การสร้างคำสั่ง SQL จากชุดข้อมูลที่มีโครงสร้างภายในสภาพแวดล้อมคลังข้อมูล ซึ่งทำงานได้ดีเมื่อข้อมูลของคุณอยู่ใน Snowflake แล้ว และคุณได้กำหนดโครงสร้างข้อมูลไว้เรียบร้อยแล้ว
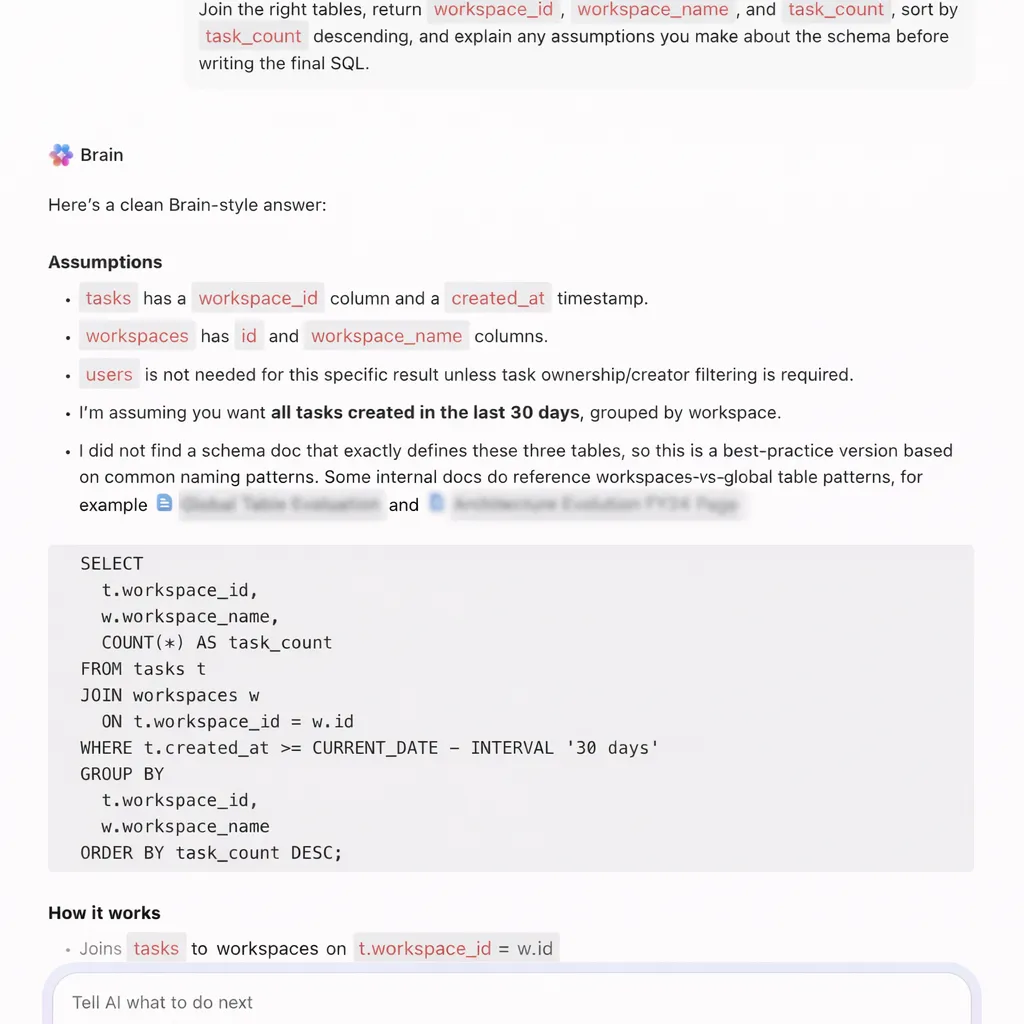
ClickUp Brainรองรับการสร้าง SQL ด้วยวิธีที่ยืดหยุ่นมากขึ้นและเน้นไปที่การดำเนินการ ทีมสามารถสร้าง ปรับแต่ง และเก็บรักษาคำสั่ง SQL ได้โดยตรงภายในพื้นที่ทำงานของพวกเขา ซึ่งก็คือสถานที่ที่การวิเคราะห์ การอภิปราย และการตัดสินใจกำลังเกิดขึ้นอยู่แล้ว
สมมติว่านักวิเคราะห์ผลิตภัณฑ์กำลังทำงานวิเคราะห์การรักษาลูกค้าภายใน ClickUp แทนที่จะต้องเปลี่ยนเครื่องมือเพื่อเขียนคำสั่งค้นหา พวกเขาสามารถถาม ClickUp Brain ได้ว่า:
📌 ลองใช้คำสั่งนี้: เขียนคำสั่ง SQL เพื่อคำนวณอัตราการรักษาผู้ใช้ใน 7 วัน สำหรับผู้ใช้ที่จัดกลุ่มตามกลุ่มการสมัคร
ClickUp Brain สร้างคำสั่งค้นหาที่มีโครงสร้าง ซึ่งรวมถึงการแบ่งกลุ่มตามโคฮอร์ท ตัวกรองวันที่ และตรรกะการเก็บรักษาข้อมูล นักวิเคราะห์เพียงคัดลอกคำสั่งค้นหานี้ไปวางใน Snowflake หรือคลังข้อมูลอื่น ๆ แล้วรันทันที
มันช่วย:
- เขียนคำสั่ง join ระหว่างตารางหลายตาราง เช่น ตารางผู้ใช้ ตารางคำสั่งซื้อ และตารางเหตุการณ์
- แปลงคำถามเกี่ยวกับผลิตภัณฑ์ในภาษาอังกฤษธรรมดาให้เป็นตรรกะ SQL ที่พร้อมสำหรับการดำเนินการ
- แก้ไขข้อผิดพลาดในคำสั่งค้นหาที่ทำงานผิดปกติ และอธิบายปัญหาต่าง ๆ เช่น การ join ที่ไม่ถูกต้อง หรือเงื่อนไขที่ขาดหายไป
- เขียนใหม่คำสั่งค้นหาเพื่อเพิ่มประสิทธิภาพหรือความเข้าใจได้ง่ายขึ้น
ตัวอย่างเช่น ระหว่างการทบทวนการทดลองเพื่อเพิ่มการเติบโต นักการตลาดอาจถามว่า: ‘เขียนคำสั่ง SQL เพื่อเปรียบเทียบอัตราการแปลงระหว่างหน้าแลนดิ้งเพจสองหน้าในช่วง 14 วันที่ผ่านมา’
ClickUp Brain สร้างคำสั่งค้นหาโดยใช้การรวมข้อมูลตามเงื่อนไขและตัวกรองวันที่ ทีมงานรันคำสั่งนี้ใน Snowflake และตรวจสอบความถูกต้องของผลการทดลอง
📌 ลองใช้คำสั่งนี้: แก้ไขคำสั่ง SQL นี้ที่การ join ทำให้แถวซ้ำกัน และอธิบายปัญหา
ClickUp Brain ระบุปัญหาการ join, แก้ไขคำสั่งค้นหา และอธิบายว่าแถวที่ซ้ำกันเกิดขึ้นได้อย่างไร เนื่องจากเงื่อนไขการ join ที่ไม่ถูกต้อง
แทนที่ระบบรายงานที่ขับเคลื่อนด้วย SQL
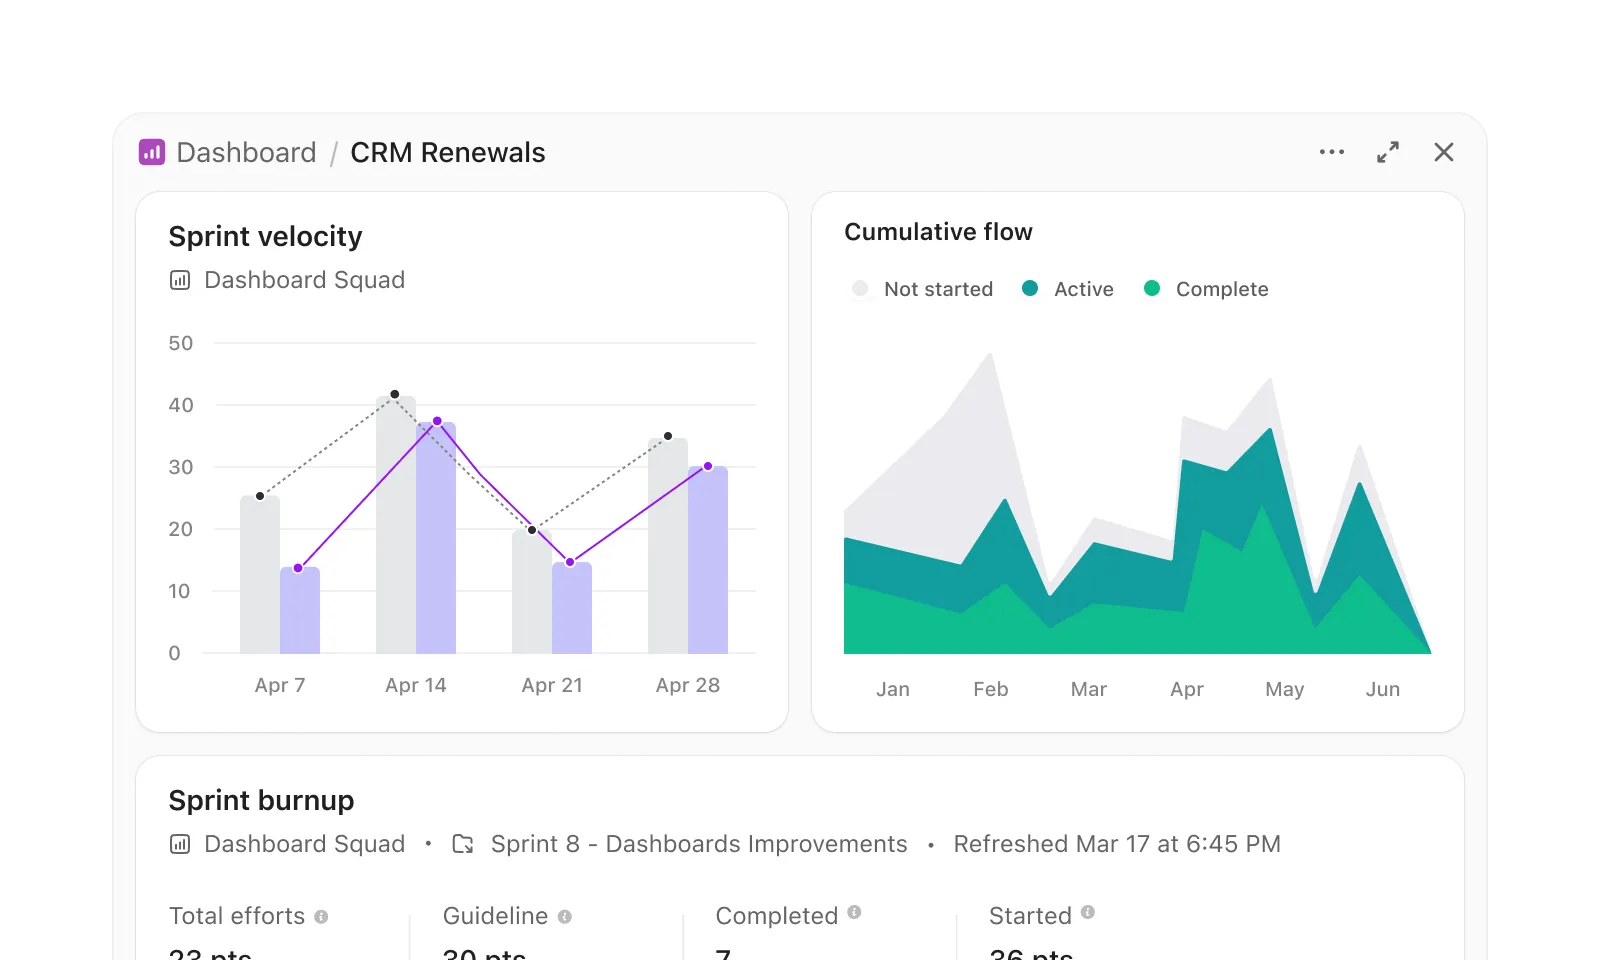
เวิร์กโฟลว์ของ Snowflake Cortex มักเกี่ยวข้องกับการสร้าง SQL การรันคำสั่งค้นหา และการแสดงผลในชั้นที่แยกต่างหากแต่แดชบอร์ดของ ClickUpช่วยขจัดกระบวนการหลายขั้นตอนนั้น และนำเสนอข้อมูลเชิงลึกโดยตรงจากงานที่กำลังดำเนินการอยู่
ทีมบริหารโครงการที่ติดตามความพร้อมสำหรับการปล่อยเวอร์ชันสามารถสร้างแดชบอร์ดได้โดยไม่ต้องเขียนคำสั่งค้นหา ตัวอย่างเช่น แดชบอร์ดการปล่อยเวอร์ชันอาจประกอบด้วย:
- บัตรรายการงาน ที่ถูกกรองเพื่อแสดงงานที่เกินกำหนดในทุกทีมผลิตภัณฑ์
- บัตรงาน ที่แสดงการกระจายงานระหว่างวิศวกร
- แผนภูมิแท่ง ที่เปรียบเทียบงานที่เสร็จสิ้นกับงานที่ยังค้างอยู่ตามสปรินต์
- บัตรคำนวณ ที่ติดตามเวลาเสร็จสิ้นเฉลี่ย
สมมติว่าหัวหน้าโครงการตรวจสอบแดชบอร์ดนี้ก่อนการประชุมปล่อยเวอร์ชันใหม่ เขาจะเห็นทันทีว่าบริการแบ็กเอนด์มีอัตราการล่าช้าที่สูงขึ้น เขาเปิดบัตรรายการงานและตรวจสอบงานที่ก่อให้เกิดความเสี่ยงอย่างแม่นยำ
ผู้ใช้ ClickUp จริงแบ่งปันประสบการณ์:
ClickUp ช่วยให้เราส่งโครงการให้กันได้อย่างรวดเร็ว ตรวจสอบสถานะโครงการได้อย่างง่ายดาย และให้ผู้บังคับบัญชาของเราสามารถติดตามปริมาณงานของเราได้ทุกเมื่อ โดยไม่ต้องรบกวนเรา เราประหยัดเวลาได้อย่างน้อยหนึ่งวันต่อสัปดาห์จากการใช้ ClickUp หรืออาจมากกว่านั้น จำนวนอีเมลก็ลดลงอย่างมีนัยสำคัญ
ClickUp ช่วยให้เราสามารถส่งต่อโครงการให้กันได้อย่างรวดเร็ว ตรวจสอบสถานะโครงการได้อย่างง่ายดาย และให้ผู้บังคับบัญชาของเราสามารถติดตามปริมาณงานของเราได้ทุกเมื่อ โดยไม่ต้องรบกวนเรา เราประหยัดเวลาได้อย่างน้อยหนึ่งวันต่อสัปดาห์จากการใช้ ClickUp หรืออาจมากกว่านั้น จำนวนอีเมลก็ลดลงอย่างมีนัยสำคัญ
ดำเนินการตามข้อมูลเชิงลึกโดยไม่ต้องใช้ระบบท่อข้อมูล
Snowflake Cortex มุ่งเน้นไปที่การสร้างข้อมูลเชิงลึกจากข้อมูล ทีมงานยังคงต้องตีความผลลัพธ์และดำเนินการตามผลลัพธ์นั้นอย่างแยกกัน
ClickUp AI Super Agentsช่วยปิดช่องว่างนั้นและเปลี่ยนข้อมูลเชิงลึกให้เป็นการดำเนินการจริง พวกเขาทำงานเหมือนเพื่อนร่วมทีม AI ที่ติดตามข้อมูลในพื้นที่ทำงานอย่างต่อเนื่อง และดำเนินการตามเงื่อนไขที่กำหนด
สมมติว่าผู้จัดการโครงการรับผิดชอบดูแลโครงการผลิตภัณฑ์หลายโครงการ Super Agent สามารถ:
- ติดตามงานในโครงการต่าง ๆ และตรวจจับเมื่องานที่เกินกำหนดเวลาเกินค่าขีดจำกัดที่กำหนดไว้
- ระบุรูปแบบ เช่น ความล่าช้าที่เกิดขึ้นซ้ำๆ ในขั้นตอนเดียวกันของเวิร์กโฟลว์
- สร้างงานที่สรุปโครงการที่ได้รับผลกระทบและมอบหมายงานนั้นให้กับหัวหน้าโครงการ
- แจ้งให้เจ้าของทีมทราบเมื่อมีงานสำคัญที่ยังไม่ได้รับการแก้ไขหลังจากผ่านกำหนดเวลา
ตัวอย่างเช่น ในระหว่างรอบการปล่อยเวอร์ชัน Super Agent ตรวจพบว่า มีงานที่มีลำดับความสำคัญสูงมากกว่า 10 งาน ที่ไม่ทันกำหนดเวลาในสองทีม มันจึงสร้างงาน ClickUpที่มีชื่อว่า ‘ความเสี่ยงในการปล่อยเวอร์ชัน: ไม่ทันกำหนดเวลา’ แนบงานที่เกี่ยวข้องทั้งหมด และมอบหมายให้ผู้จัดการโครงการตรวจสอบทันที
ทีมยังสามารถโต้ตอบโดยตรงกับ Super Agent ได้: ‘วิเคราะห์โครงการทั้งหมดที่กำลังดำเนินการอยู่ และเน้นย้ำความเสี่ยงในการส่งมอบสำหรับสปรินต์นี้’
Super Agent ตรวจสอบกำหนดเวลา ความสัมพันธ์ระหว่างงาน และสถานะงาน จากนั้นโพสต์สรุปที่มีโครงสร้างภายในพื้นที่ทำงาน
นี่คือวิธีตั้งค่า Super Agent ของคุณเองใน ClickUp:
รวมศูนย์กระบวนการทำงานกับข้อมูลของคุณด้วย ClickUp
เครื่องมือแปลงข้อความเป็น SQL เช่น Snowflake Cortex ช่วยให้ข้อมูลเข้าถึงได้ง่ายขึ้น แต่ในขณะเดียวกัน การได้ผลลัพธ์ที่เชื่อถือได้ยังคงต้องใช้ความพยายาม
ทีมจำเป็นต้องมีสคีมาที่ชัดเจน โมเดลเชิงความหมายที่แข็งแกร่ง และกระบวนการปรับปรุงอย่างต่อเนื่อง เพื่อให้ผลลัพธ์มีความแม่นยำ แม้หลังจากสร้างคำสั่งค้นหาที่ถูกต้องแล้ว งานก็ยังไม่จบเพียงเท่านี้ ยังต้องมีผู้รับผิดชอบในการตีความผลลัพธ์ แบ่งปันข้อมูลเชิงลึก และนำข้อมูลเหล่านั้นมาใช้ในการตัดสินใจ
ClickUp นำเสนอวิธีการที่แตกต่างออกไป แทนที่จะแยกการวิเคราะห์ออกจากกระบวนการดำเนินการ ClickUp เชื่อมต่อทั้งสองส่วนเข้าด้วยกัน ทีมสามารถสร้าง SQL บันทึกข้อมูลเชิงลึก ร่วมมือกันวิเคราะห์ผลลัพธ์ และดำเนินการตามผลลัพธ์เหล่านั้นภายในพื้นที่ทำงานเดียวกัน
ClickUp Brain ช่วยเขียนและปรับปรุงคำสั่งค้นหา ส่วน Dashboards และ AI Agents ช่วยทีมติดตามผลลัพธ์และผลักดันงานให้ก้าวหน้าโดยไม่ต้องเปลี่ยนไปใช้เครื่องมืออื่น ๆ
Snowflake Cortex ช่วยคุณหาคำตอบได้ ส่วน ClickUp ช่วยคุณนำคำตอบเหล่านั้นไปใช้งานได้สมัครใช้ ClickUpวันนี้เลย!
คำถามที่มักถูกถาม
Snowflake Cortex Analyst คืออะไร และมันแตกต่างจาก Cortex AI อย่างไร?
Snowflake Cortex Analyst เป็นบริการเฉพาะทางภายในชุด Snowflake Cortex AI ที่กว้างขวางกว่า Cortex Analyst มุ่งเน้นเฉพาะการสร้าง SQL จากข้อความโดยใช้โมเดลเชิงความหมาย ในขณะที่ Cortex AI ครอบคลุมฟังก์ชัน LLM ที่หลากหลายยิ่งขึ้น การอนุมานโมเดลการเรียนรู้ของเครื่อง และความสามารถในการค้นหา
Snowflake Cortex Analyst สามารถทำงานร่วมกับแหล่งข้อมูลภายนอก เช่น ตาราง Iceberg ได้หรือไม่?
ใช่ Cortex Analyst สามารถส่งคำสั่งค้นหาไปยังตาราง Apache Iceberg ที่ได้รับการจัดการผ่าน Snowflake ได้ ตราบใดที่ตารางเหล่านั้นสามารถเข้าถึงได้ภายในสภาพแวดล้อม Snowflake ของคุณ และถูกกำหนดไว้อย่างถูกต้องในโมเดลเซมานติกของคุณ คุณก็สามารถสร้างคำสั่งค้นหาเพื่อใช้กับตารางเหล่านั้นได้
ความแม่นยำของระบบสร้าง SQL จากข้อความของ Snowflake สำหรับคำสั่งค้นหาที่ซับซ้อนเป็นอย่างไร?
ความแม่นยำของคำสั่งค้นหาที่ซับซ้อนขึ้นอยู่กับคุณภาพของโมเดลเซมิติกของคุณเกือบทั้งหมด โมเดลที่มีความสัมพันธ์ระหว่างตารางที่กำหนดไว้อย่างชัดเจน คำสั่งค้นหาที่ผ่านการตรวจสอบจำนวนมาก และข้อมูลเมตาดาต้าที่อธิบายได้ จะให้ผลลัพธ์ที่แม่นยำขึ้นอย่างมีนัยสำคัญสำหรับการรวมข้อมูลจากหลายตารางและการรวมข้อมูลที่ซับซ้อน
ค่าใช้จ่ายของ Snowflake Cortex สำหรับฟีเจอร์การสร้าง SQL เป็นเท่าใด?
ราคาของ Snowflake Cortex Analyst ใช้ตามโมเดลการคิดค่าบริการตามการใช้งานของ Snowflake ซึ่งหมายความว่าคุณจะถูกคิดค่าบริการตามเครดิตการประมวลผลที่ใช้ไปในช่วงกระบวนการสร้างคำสั่งค้นหา สำหรับอัตราค่าบริการล่าสุด คุณควรอ้างอิงเอกสารราคาอย่างเป็นทางการของ Snowflake เสมอ