
De flesta team ser på SQL-generering som ett trolleritrick. Du skriver in en fråga och får en fråga.
Men så här ser verkligheten ut: Snowflake Cortex Analyst fungerar bara så bra som den semantiska modell du bygger först, och den konfigurationen är inte helt enkel. Genom att lära sig hur man använder Snowflake Cortex för SQL-generering kan datateam nu omvandla naturligt språk till komplexa, körbara frågor på några sekunder.
Den här guiden leder dig genom själva implementeringsprocessen, från att definiera din semantiska YAML-modell till att göra frågor i ditt datalager med hjälp av naturligt språk, så att du förstår både möjligheterna och förutsättningarna innan du sätter igång.
Vi tittar också på var Snowflake Cortex har sina begränsningar och hur ClickUp kan stödja de bredare arbetsflödena kring SQL-generering.
Vad är Snowflake Cortex Analyst?
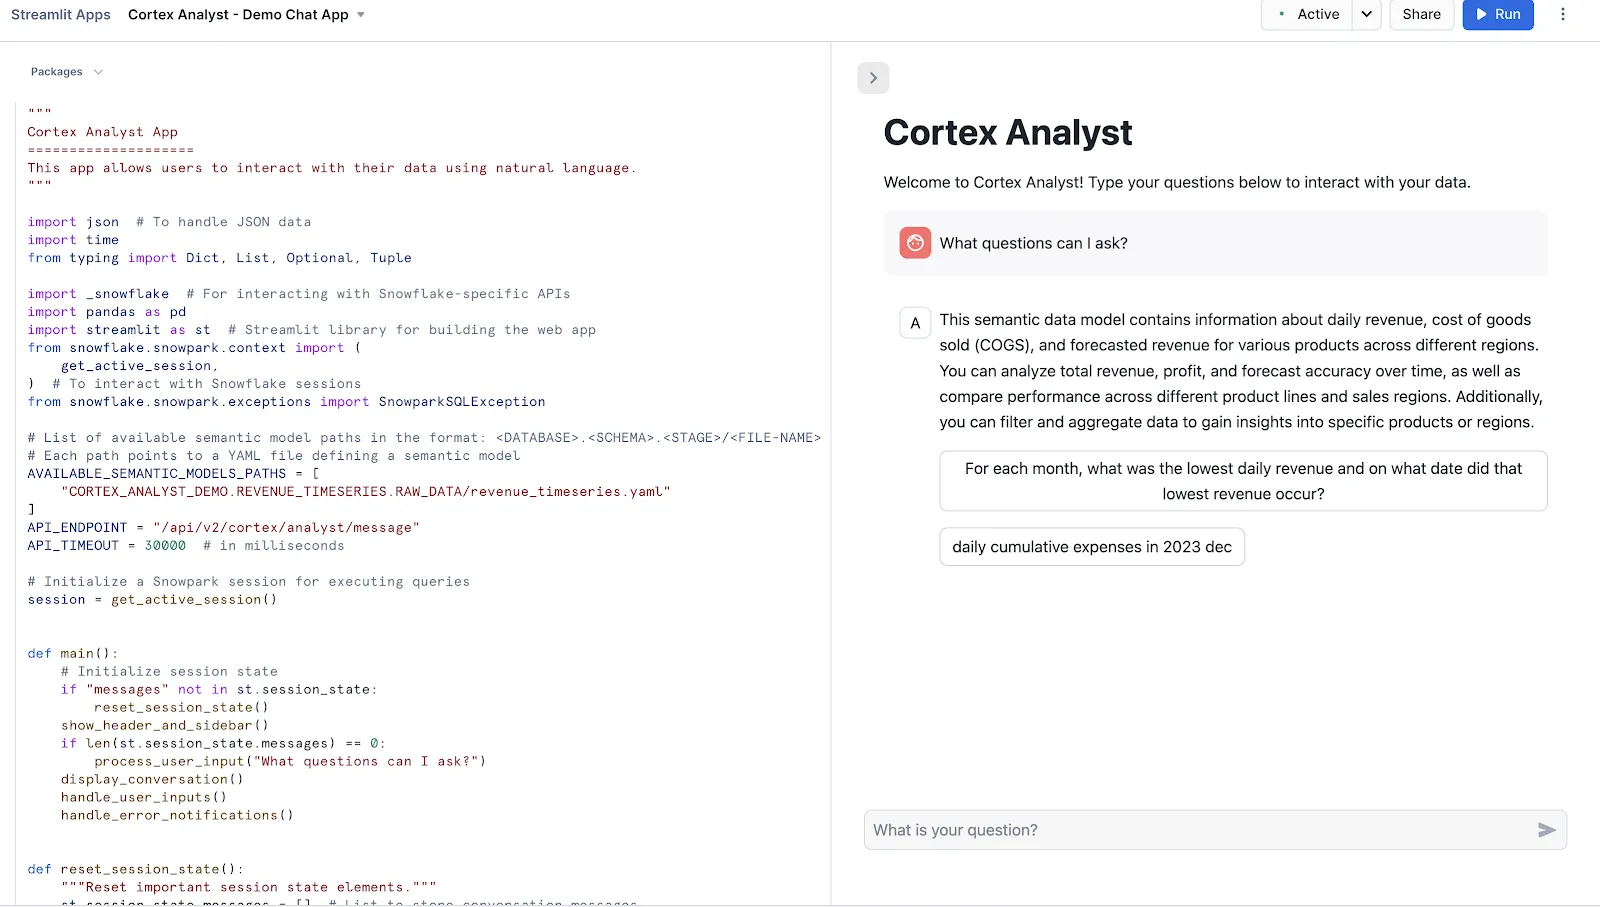
Snowflake Cortex Analyst är en helt hanterad tjänst som gör det möjligt för dig att bygga konversationsbaserade applikationer utifrån dina analysdata.
Tjänsten använder en specialiserad text-till-SQL-agent för att omvandla frågor i naturligt språk till exakta, körbara frågor. Denna tjänst överbryggar klyftan mellan komplexa datastrukturer och affärsanvändare som behöver svar utan att behöva skriva kod.
Viktiga funktioner inkluderar:
- Ett gränssnitt med hög precision för interaktion med strukturerade data
- Använd semantiska modeller för att förstå just din affärslogik och terminologi
- Erbjuder ett REST-API för enkel integration i anpassade applikationer eller BI-verktyg
- Upprätthåll dataintegriteten genom att bearbeta förfrågningar inom Snowflakes säkerhetsgränser
📮 ClickUp Insight: 88 % av de som svarade på vår undersökning använder AI för sina personliga uppgifter, men över 50 % drar sig för att använda det på jobbet. De tre största hindren? Brist på smidig integration, kunskapsluckor eller säkerhetsfarhågor.
Men tänk om AI vore inbyggt i din arbetsmiljö och redan vore säkert? ClickUp Brain, ClickUps inbyggda AI-assistent, gör detta till verklighet. Den förstår instruktioner i vardagligt språk och löser därmed alla tre farhågorna kring AI-implementering samtidigt som den kopplar samman din chatt, dina uppgifter, dokument och kunskap i hela arbetsmiljön.
Hitta svar och insikter med ett enda klick!
Förutsättningar för SQL-generering med Snowflake Cortex
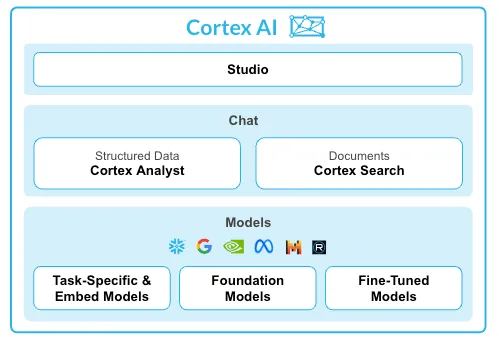
Att ge sig in i Snowflake Cortex utan rätt inställningar leder till frustration. Du kan få felaktiga resultat, slösa tid på felsökning och felaktigt dra slutsatsen att verktyget inte fungerar, när det egentliga problemet är en bristfällig grund.
För att undvika detta måste du först se till att tre grundläggande element finns på plats.
1. Konfigurera din databas och dina tabeller
Din AI är bara så smart som de data den har tillgång till. Om ditt databasschema är en labyrint av kryptiska kolumnnamn som cust_dat_v2_final kommer både dina analytiker och AI:n att ha svårt att förstå det.
Denna förvirring leder till att AI:n genererar felaktiga sammanfogningar eller hämtar data från fel kolumner, och ditt team slösar bort timmar på att försöka tolka schemat innan de ens kan skriva en fråga.
Börja med att se till att din datalagringsprogramvara innehåller de tabeller som du vill att Cortex Analyst ska göra frågor mot. Använd så långt det är möjligt tydliga och beskrivande kolumnnamn. En kolumn med namnet customer_lifetime_value är till exempel betydligt mer intuitivt för både människor och AI än clv_01.
För att fortsätta med konfigurationen måste din Snowflake-roll ha följande behörigheter:
- ANVÄNDNING: I databasen och schemat som innehåller dina tabeller
- SELECT: På de tabeller som du vill att Cortex Analyst ska göra frågor mot
- CREATE STAGE: I schemat, vilket krävs för att ladda upp din semantiska modellfil
2. Skapa din semantiska modellfil
Det största hindret med alla text-till-SQL-verktyg är att AI:n inte talar ditt företags unika språk. Den vet inte automatiskt att ”ARR” betyder ”Annual Recurring Revenue” eller att din kundtabell kopplas samman med din ordertabell via fältet customer_id.
Utan detta sammanhang kan AI:n generera SQL-koder som är tekniskt giltiga men logiskt felaktiga, vilket ger dig svar som ser korrekta ut men som är farligt missvisande.
Den semantiska modellen är lösningen. Det är en YAML-fil som fungerar som ditt anpassade ”översättningslager” och lär Cortex Analyst det specifika vokabuläret och logiken i din verksamhet. Att skapa och underhålla denna fil är ett samarbete mellan dataingenjörer som använder ETL-verktyg för att förstå schemat och affärsanalytiker som känner till terminologin.
Din semantiska modellfil bör innehålla följande nyckelkomponenter:
| Komponent | Syfte |
| Tabeller | Listan innehåller varje tabell med en beskrivning i klartext av dess syfte |
| Kolumner | Definierar varje kolumns semantiska typ (t.ex. kategori eller mätvärde) och kan inkludera exempelvärden |
| Relationer | Anger hur tabeller kopplas samman genom sammanfogningar, vilket eliminerar behovet av gissningar för AI:n |
| Verifierade frågor | Innehåller exempel på par av frågor och SQL-frågor som fungerar som kraftfulla vägledningar för LLM |
3. Konfigurera Cortex Search Service (valfritt)
Ibland finns de svar du behöver gömda i ostrukturerad text, till exempel produktbeskrivningar, supportärenden eller samtalsutskrifter. Vanliga SQL-frågor kan inte hantera dessa data, vilket innebär att du ofta går miste om ”varför” bakom ”vad”.
Du kan valfritt lägga till Snowflake Cortex Search Service här. Det är ett sök-som-tjänst-lager som gör det möjligt att samtidigt söka i både dina strukturerade tabeller och dina ostrukturerade textdata med hjälp av AI-agenter för dataanalys.
Du bör konfigurera Cortex Search om dina analytiker behöver ställa frågor som kräver att man hämtar sammanhang från text innan man genererar SQL. Du kan till exempel först söka efter alla produktrecensioner som innehåller frasen ”batteriproblem” och sedan generera en SQL-fråga för att sammanställa försäljningsdata endast för dessa produkter.
För ren SQL-generering mot strukturerade tabeller behövs inte den här tjänsten.
🧠 Rolig fakta: I början av 1970-talet skapade IBM-forskarna Donald Chamberlin och Raymond Boyce ”Structured English Query Language”. De var tvungna att byta namn till SQL eftersom ”SEQUEL” redan var ett registrerat varumärke som tillhörde ett brittiskt flygplanföretag.
Steg-för-steg-guide för att generera SQL med Cortex Analyst
Du har gjort förarbetet, men nu står du framför en tom skärm och är osäker på hur arbetsflödet egentligen ska se ut. Hur går du från en fråga i huvudet till en körbar SQL-fråga? När arbetsflödeshanteringen inte är tydlig blir nya verktyg ofta outnyttjade, och investeringen i installationen går till spillo.
Den praktiska processen är förvånansvärt enkel. Här är en närmare titt!
Steg 1: Förbered dina data i Snowflake
Innan du gör något annat måste dina strukturerade data finnas i Snowflake. Varje Cortex Analyst-applikation riktas mot antingen en enskild tabell eller en vy som består av en eller flera tabeller. Se till att dina tabeller är skapade och fyllda med data.
Om du laddar in data från platta filer:
- Ladda upp dina datafiler (t.ex. CSV-filer) till en Snowflake Stage
- Använd kommandot COPY INTO för att ladda data från mellanlagret till dina tabeller
- Kontrollera att data har laddats korrekt innan du går vidare
Steg 2: Skapa en semantisk modell (eller semantisk vy)
Detta är det viktigaste steget i konfigurationen. Cortex Analyst hämtar sin styrka från kombinationen av stora språkmodeller (LLM) och semantiska modeller – en YAML-fil som finns vid sidan av ditt databasschema och kodar affärskontexten.
Semantiska vyer är nu Snowflakes rekommenderade metod för Cortex Analyst. De lagrar affärsmetriker, relationer och definitioner direkt i Snowflake. Äldre YAML-filer för semantiska modeller fungerar fortfarande, men Snowflake rekommenderar att nya implementationer görs med semantiska vyer.
Din semantiska modell eller vy bör innehålla:
- Tabell- och kolumnbeskrivningar: Förklaringar i klartext av vad varje fält betyder
- Affärsmetriker: Definitioner för beräknade fält som intäkter, kundbortfall eller konverteringsgrad
- Filter och synonymer: Alternativa termer som användare kan använda (t.ex. ”avbokad” som mappas till ett specifikt statusvärde)
- Verifierade frågor: Snowflakes Verified Query Repository lagrar godkända par av frågor och SQL-koder. När en användarfråga liknar en av dessa poster kan Cortex Analyst hänvisa till den vid generering av SQL-koder.
🤝 Vänlig påminnelse: Snowflake rekommenderar att du använder högst 10 tabeller och högst 50 valda kolumner för optimal prestanda i Snowsight-arbetsflödet.
Steg 3: Ladda upp den semantiska modellen till en Snowflake-stage
Om du använder en YAML-baserad semantisk modell måste den förberedas så att Cortex Analyst kan referera till den vid körning.
- Ladda upp din .yaml-fil till en intern Snowflake-etapp (t.ex. RAW_DATA)
- Kontrollera att filen visas i scenen via Snowsight-användargränssnittet eller med kommandot LIST @stage_name
- Notera stegvägen; du kommer att behöva den i dina API-anrop eller i appkonfigurationen
Om du använder en semantisk vy hanteras detta steg direkt i Snowflake, och ingen separat uppladdning behövs.
🔍 Visste du att? NULL i SQL betyder inte noll eller tomt. Det representerar okända eller saknade data, vilket leder till ointuitivt beteende, till exempel jämförelser som varken returnerar sant eller falskt.
Steg 4: Skicka en fråga i naturligt språk via REST-API:et
Nu börjar själva SQL-genereringen. REST-API:et genererar en SQL-fråga för en given fråga med hjälp av en semantisk modell eller semantisk vy som anges i förfrågan.
Strukturera din API-förfrågan med:
- meddelanden; en array som innehåller din användarfråga med rollen: ”user”
- En referens till din semantiska modell eller semantiska vy
- Välj önskad modell (eller låt inställningen vara på ”auto” så att Cortex väljer den bästa)
Du kan föra konversationer i flera steg där du kan ställa uppföljningsfrågor som bygger vidare på tidigare frågor.
Steg 5: Analysera API-svaret
Varje meddelande i ett svar kan innehålla flera innehållsblock av olika typer. Tre värden som för närvarande stöds för fältet ”type” är: text, suggestions och SQL.
Här förklaras vad de olika typerna betyder:
- SQL: Cortex har genererat en fråga; detta är vad du ska köra
- text: En förklaring eller ett svar på naturligt språk som åtföljer SQL-frågan
- förslag: Innehållstypen ”förslag” ingår endast i ett svar om användarens fråga var tvetydig och Cortex Analyst inte kunde returnera ett SQL-uttryck för den frågan. Använd dessa för att förtydliga eller förfina frågan
🔍 Visste du att? Ordningen du skriver SQL i är inte samma som den ordning den körs i. Även om du skriver SELECT först bearbetar databaser faktiskt FROM och WHERE innan de väljer ut kolumner. Detta förvirrar både nybörjare och erfarna användare.
Steg 6: Kör den genererade SQL-koden i Snowflake
När du har fått SQL-blocket från svaret kör du det mot ditt virtuella Snowflake-lager. Den genererade SQL-frågan körs i ditt virtuella Snowflake-lager för att generera det slutliga resultatet. Data förblir inom Snowflakes styrningsgränser.
Viktiga saker att känna till vid körning:
- Cortex Analyst är fullt integrerat med Snowflakes policyer för rollbaserad åtkomstkontroll (RBAC), vilket säkerställer att de SQL-frågor som genereras och körs följer alla fastställda åtkomstkontroller.
- Om en användare saknar åtkomst till en tabell kommer frågan att misslyckas vid körning, precis som det skulle göra med handskriven SQL.
- I detta skede tillkommer kostnader för datalagring, utöver Cortex Analyst:s egna användningsavgifter.
Steg 7: Förfina och iterera
Det är inte alltid garanterat att man får en perfekt fråga redan vid första försöket. Så här kan du förbättra resultaten över tid:
- Lägg till verifierade frågor i din semantiska modell för frågor som återkommer ofta
- Berika din semantiska modell med bättre beskrivningar, synonymer och filter när Cortex misstolkar ett begrepp
- Använd flerrundiga konversationer för att följa upp, till exempel ”Filtrera nu det efter region”. Flerrundiga konversationer möjliggör uppföljningsfrågor som bygger vidare på tidigare frågor.
- Övervaka användningen via CORTEX_ANALYST_USAGE_HISTORY och Snowflakes frågehistorik för att upptäcka mönster i misslyckade eller felaktiga frågor
🧠 Rolig fakta: Ett enda saknat JOIN-villkor kan orsaka enorma problem. Om man glömmer ett JOIN-villkor kan det leda till ett kartesiskt produkt, vilket dramatiskt multiplicerar antalet rader och ibland får systemet att krascha.
Bästa praxis för noggrannhet vid text-till-SQL-omvandling i Snowflake
Kvaliteten på din semantiska modell avgör direkt noggrannheten hos de frågor som den genererar. Här är de bästa metoderna för att förbättra noggrannheten. 🛠️
- Lägg till verifierade frågor i din semantiska modell: Det här är det mest effektiva du kan göra. Inkludera många exempel på frågor och motsvarande SQL-frågor som återspeglar hur ditt team faktiskt ställer frågor.
- Använd beskrivande kolumn- och tabellnamn: Modellen fungerar bättre när kolumn- och tabellnamnen är självförklarande. Om du inte kan ändra schemat, lägg till tydliga beskrivningar i din YAML-fil för eventuella kryptiska kolumnnamn
- Inkludera exempelvärden: Att lägga till exempeldata för kategoriska kolumner (som status eller region) hjälper modellen att förstå vilka giltiga filteralternativ som finns tillgängliga
- Testa med gränsfall: Ställ medvetet tvetydiga eller knepiga frågor under utvecklingen för att identifiera var din semantiska modell behöver mer sammanhang eller förtydligande.
- Utveckla din semantiska modell: Betrakta din semantiska modell som ett levande dokument. Den bör uppdateras kontinuerligt genom en iterativ process baserad på vilka frågor som lyckas och vilka som misslyckas
ClickUp: Ett enklare alternativ till Snowflake Cortex
Snowflake Cortex fungerar bra när team vill generera SQL och köra frågor på strukturerade data. Team definierar scheman, kartlägger relationer och skriver frågor för att utvinna insikter. Denna uppsättning är lämplig för datatunga miljöer, särskilt när analytikerna själva ansvarar för rapporteringen.
Många team behöver dock inte ett fullständigt SQL-lager för att besvara vardagliga operativa frågor. Produktchefer, programledare och driftsteam vill ofta ha snabba svar kopplade till det pågående arbetet.
ClickUp erbjuder en mer tillgänglig väg. Team ställer frågor på vanligt språk, granskar realtidsdashboards och agerar utifrån insikterna utan att behöva skriva SQL eller bygga semantiska modeller.
Skapa och finjustera SQL snabbare
Snowflake Cortex fokuserar på att generera SQL-frågor från strukturerade datamängder i en datalagringsmiljö. Det fungerar bra när dina data redan finns i Snowflake och du har scheman utformade.
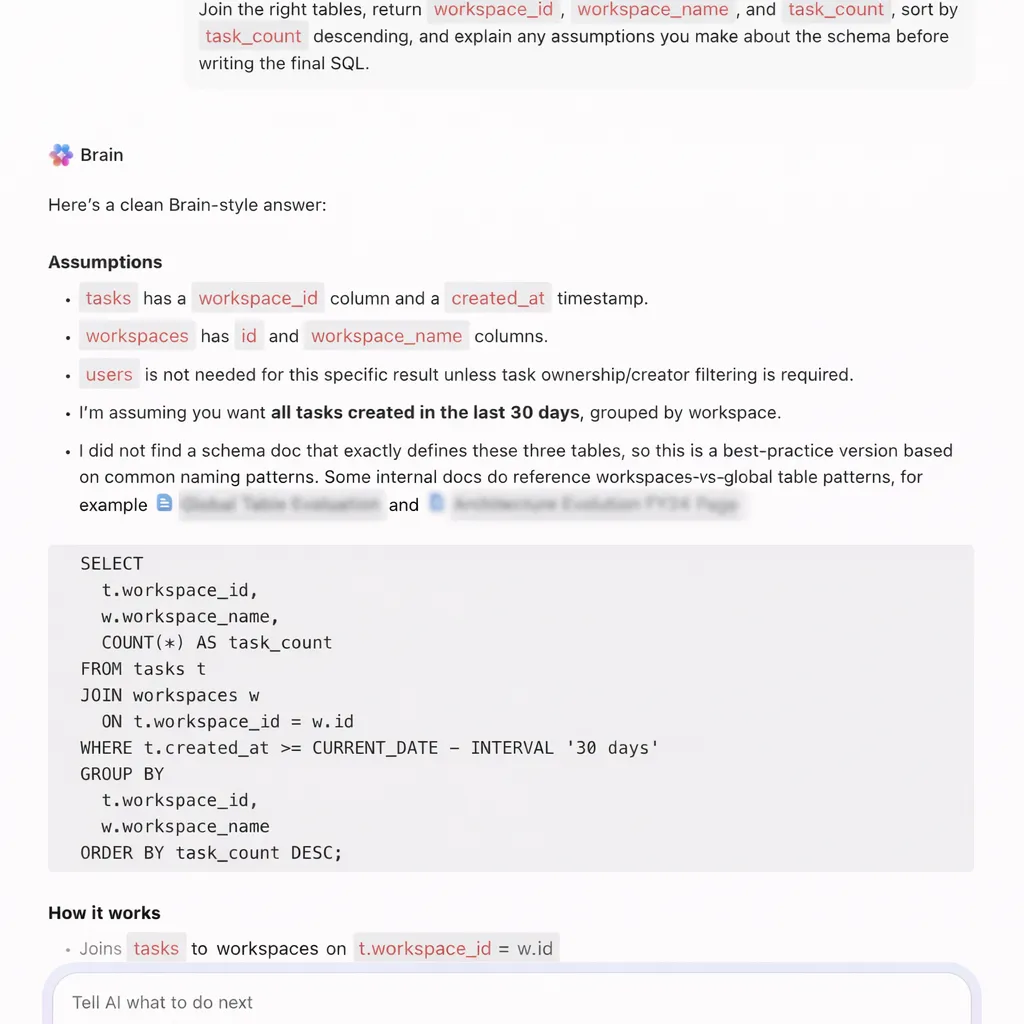
ClickUp Brain stöder generering av SQL på ett mer flexibelt och exekveringsinriktat sätt. Team kan skapa, finjustera och spara SQL-frågor direkt i sin arbetsyta, där analys, diskussioner och beslut redan äger rum.
Anta att en produktanalytiker arbetar med en analys av kundlojalitet i ClickUp. Istället för att byta verktyg för att skriva frågor frågar hen ClickUp Brain:
📌 Prova följande prompt: Skriv en SQL-fråga för att beräkna sju dagars kvarhållning för användare grupperade efter registreringskohort.
ClickUp Brain genererar en strukturerad fråga som inkluderar kohortgruppering, datumfilter och retentionlogik. Analytikern klistrar in frågan i Snowflake eller ett annat datalager och kör den omedelbart.
Det hjälper till att:
- Skriv sammanfogningar mellan flera tabeller, till exempel användare, beställningar och händelser
- Omvandla produktfrågor på vanlig engelska till SQL-logik som är redo att köras
- Felsök felaktiga frågor och förklara problem, till exempel felaktiga sammanfogningar eller saknade villkor
- Skriv om frågor för bättre prestanda eller läsbarhet
Till exempel, under en genomgång av ett tillväxtexperiment, frågar en marknadsförare: ”Skriv en SQL-fråga för att jämföra konverteringsgraden mellan två landningssidor under de senaste 14 dagarna”.
ClickUp Brain genererar frågan med hjälp av villkorlig aggregering och datumfilter. Teamet kör den i Snowflake och validerar experimentresultaten.
📌 Prova följande uppgift: Rätta till denna SQL-fråga där join-operationen duplicerar rader och förklara problemet.
ClickUp Brain identifierar problemet med sammanfogningen, korrigerar frågan och förklarar hur dubbla rader uppstod på grund av felaktiga sammanfogningsvillkor.
Ersätt SQL-baserad rapportering
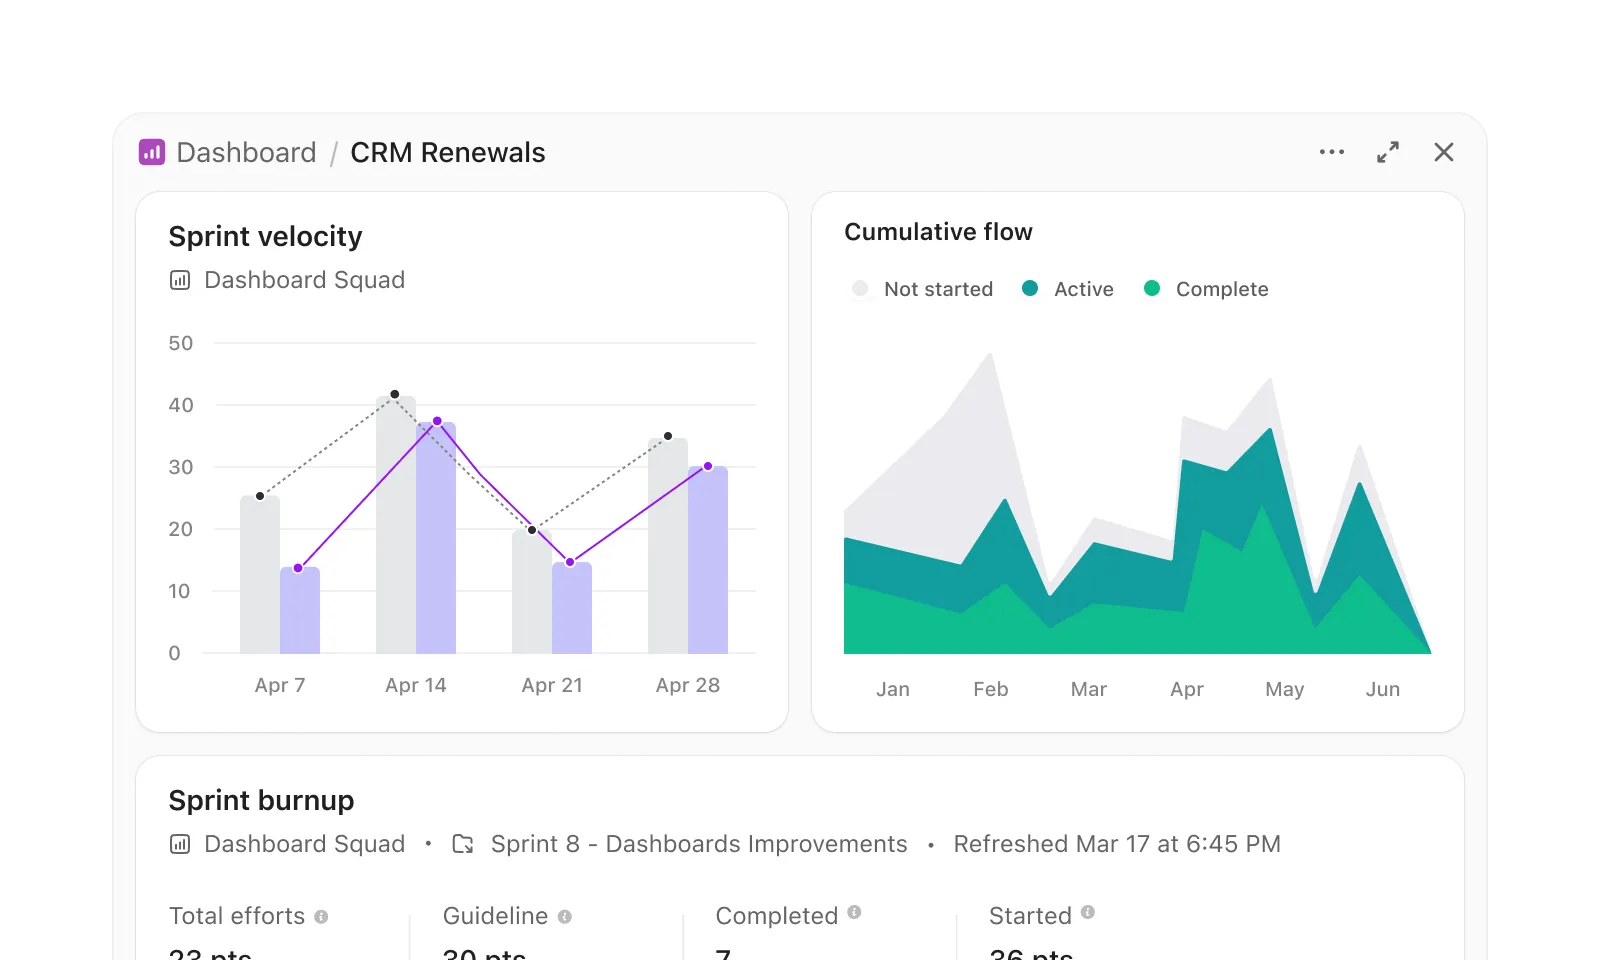
Arbetsflöden i Snowflake Cortex innebär ofta att man genererar SQL, kör frågor och visualiserar resultaten i ett separat lager. ClickUp-dashboards eliminerar den här flerstegsprocessen och presenterar insikter direkt från det pågående arbetet.
Ett programledningsteam som övervakar releaseberedskapen kan skapa en översiktssida utan att behöva skriva frågor. En översiktssida för en release kan till exempel innehålla:
- Ett uppgiftskort som filtrerats för att visa försenade uppgifter i alla produktteam
- Ett arbetsbelastningskort som visar fördelningen av uppgifter mellan ingenjörerna
- Ett stapeldiagram som jämför slutförda uppgifter med pågående uppgifter per sprint
- Ett beräkningskort som spårar genomsnittlig slutförandetid
Anta att en programledare granskar denna instrumentpanel inför ett release-möte. Hen ser omedelbart att backend-tjänsterna uppvisar högre fördröjningsfrekvenser. Hen öppnar kortet med uppgiftslistan och undersöker exakt vilka uppgifter som utgör en risk.
En verklig ClickUp-användare berättar:
ClickUp gör det möjligt för oss att SNABBT överlämna projekt till varandra, ENKELT kontrollera projektens status och ger vår chef en inblick i vår arbetsbelastning när som helst utan att hon behöver störa oss. Vi har definitivt sparat en dag per vecka genom att använda ClickUp, om inte mer. Antalet e-postmeddelanden har MINSKAT AVSEVÄRT.
ClickUp gör det möjligt för oss att SNABBT överlämna projekt till varandra, ENKELT kontrollera projektens status och ger vår chef en inblick i vår arbetsbelastning när som helst utan att hon behöver störa oss. Vi har definitivt sparat en dag per vecka genom att använda ClickUp, om inte mer. Antalet e-postmeddelanden har MINSKAT AVSEVÄRT.
Agera på insikter utan pipelines
Snowflake Cortex fokuserar på att generera insikter från data. Teamen måste fortfarande tolka resultaten och sätta igång åtgärder separat.
ClickUp AI Super Agents överbryggar den klyftan och omvandlar insikter till handling. De fungerar som AI-teammates som kontinuerligt övervakar data i arbetsytan och vidtar åtgärder utifrån olika villkor.
Anta att en programchef ansvarar för flera produktinitiativ. En Super Agent kan:
- Övervaka uppgifter i olika projekt och upptäck när försenade uppgifter överskrider en definierad tröskel
- Identifiera mönster, till exempel upprepade förseningar i samma steg i arbetsflödet
- Skapa en uppgift som sammanfattar de berörda projekten och tilldela den till programledaren
- Meddela teamledare när kritiska uppgifter fortfarande är olösta efter att tidsfristen har löpt ut
Under en release-cykel upptäcker till exempel en Super Agent att mer än 10 uppgifter med hög prioritet har missat sina deadlines i två team. Den skapar en ClickUp-uppgift med titeln ”Release-risk: missade deadlines”, bifogar alla relevanta uppgifter och tilldelar programchefen för omedelbar granskning.
Team kan också interagera direkt med Super Agent: ”Analysera alla aktiva projekt och markera leveransrisker för denna sprint”.
Superagenten granskar deadlines, beroenden och uppgiftsstatus och publicerar sedan en strukturerad sammanfattning i arbetsytan.
Så här konfigurerar du din egen Super Agent i ClickUp:
Centralisera dina dataflöden med ClickUp
Verktyg för text-till-SQL, som Snowflake Cortex, gör data mer tillgängliga. Samtidigt krävs det fortfarande en del arbete för att få tillförlitliga resultat.
Team behöver tydliga scheman, robusta semantiska modeller och kontinuerlig iteration för att säkerställa korrekta resultat. Även efter att rätt fråga har genererats är arbetet inte slut. Någon måste fortfarande tolka resultaten, dela insikter och omvandla dem till beslut.
ClickUp erbjuder ett annorlunda tillvägagångssätt. Istället för att separera analys från utförande kopplar ClickUp samman båda delarna. Team genererar SQL, dokumenterar insikter, samarbetar kring resultaten och agerar utifrån dem inom samma arbetsyta.
ClickUp Brain hjälper till att skriva och finjustera frågor, medan dashboards och AI-agenter hjälper teamen att följa upp resultat och driva arbetet framåt utan att behöva växla mellan olika verktyg.
Snowflake Cortex hjälper dig att få svar. ClickUp hjälper dig att göra något med dem. Registrera dig på ClickUp idag!
Vanliga frågor
Vad är Snowflake Cortex Analyst och hur skiljer det sig från Cortex AI?
Snowflake Cortex Analyst är en specialiserad tjänst inom den bredare Snowflake Cortex AI-sviten. Cortex Analyst är specifikt inriktat på generering av text-till-SQL med hjälp av semantiska modeller, medan Cortex AI omfattar ett bredare utbud av LLM-funktioner, inferens av maskininlärningsmodeller och sökfunktioner.
Fungerar Snowflake Cortex Analyst med externa datakällor som Iceberg-tabeller?
Ja, Cortex Analyst kan utföra sökningar i Apache Iceberg-tabeller som hanteras via Snowflake. Så länge tabellerna är tillgängliga i din Snowflake-miljö och korrekt definierade i din semantiska modell kan du generera sökfrågor mot dem.
Hur exakt är Snowflakes text-till-SQL-generering för komplexa frågor?
Noggrannheten för komplexa frågor beror nästan helt på kvaliteten på din semantiska modell. En modell med väldefinierade tabellrelationer, många verifierade frågor och beskrivande metadata ger betydligt mer exakta resultat för sammanfogningar av flera tabeller och komplexa aggregeringar.
Vad kostar Snowflake Cortex för funktioner för SQL-generering?
Prissättningen för Snowflake Cortex Analyst följer Snowflakes förbrukningsbaserade modell, vilket innebär att du debiteras utifrån de beräkningskrediter som används under processen för generering av frågor. För de senaste priserna bör du alltid hänvisa till Snowflakes officiella prisdokumentation.