
Повечето екипи разглеждат генерирането на SQL като магически трик. Въвеждате въпрос и получавате заявка.
Но ето как стоят нещата в действителност: Snowflake Cortex Analyst работи толкова добре, колкото семантичният модел, който създадете първо, а тази настройка не е тривиална. Като научат как да използват Snowflake Cortex за генериране на SQL, екипите за работа с данни вече могат да преобразуват естествен език в сложни, изпълними заявки за секунди.
Това ръководство ви води през целия процес на внедряване – от дефинирането на вашия семантичен модел в YAML до извършването на заявки към хранилището ви за данни чрез естествен език – за да разберете както възможностите, така и предварителните изисквания, преди да започнете.
Ще разгледаме също така къде Snowflake Cortex има недостатъци и как ClickUp може да подпомогне по-широките работни процеси, свързани с генерирането на SQL.
Какво представлява Snowflake Cortex Analyst?
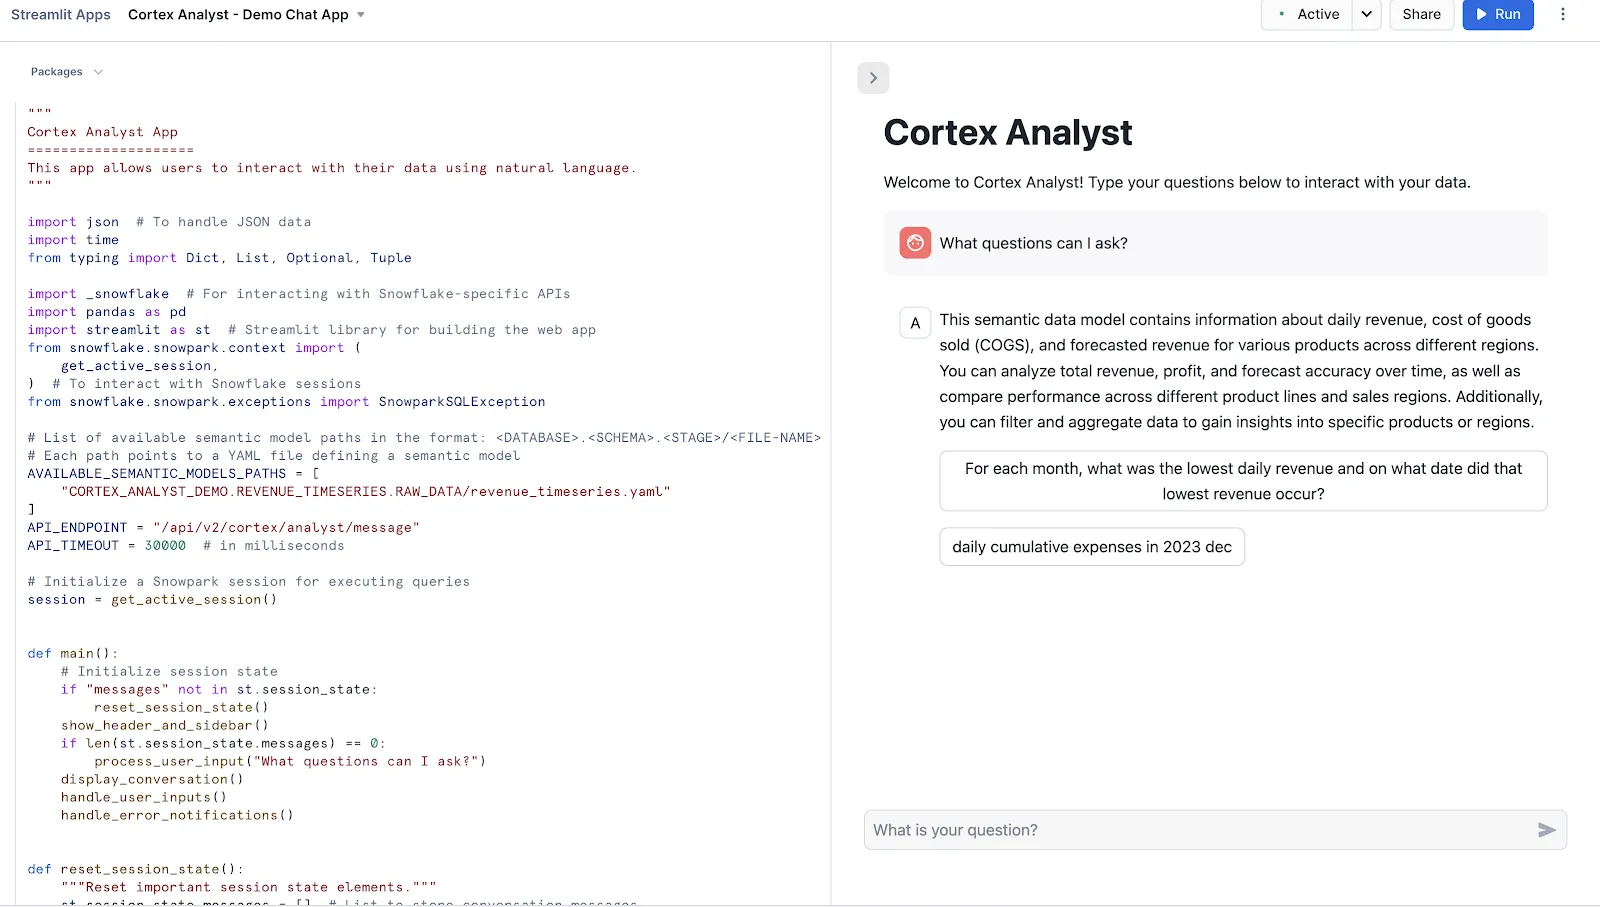
Snowflake Cortex Analyst е изцяло управлявана услуга, която ви позволява да създавате приложения за диалогово взаимодействие въз основа на вашите аналитични данни.
Услугата използва специализиран агент за преобразуване на текст в SQL, за да превърне въпросите, зададени на естествен език, в точни и изпълними заявки. Тази услуга преодолява различията между сложните структури от данни и бизнес потребителите, които се нуждаят от отговори, без да пишат код.
Основните възможности включват:
- Осигуряване на интерфейс с висока точност за взаимодействие със структурирани данни
- Използване на семантични модели за разбиране на вашата специфична бизнес логика и терминология
- Предлага REST API за лесна интеграция в персонализирани приложения или BI инструменти
- Опазване на поверителността на данните чрез обработка на заявките в рамките на границите на сигурността на Snowflake
📮 ClickUp Insight: 88% от участниците в нашето проучване използват изкуствен интелект за личните си задачи, но над 50% се въздържат да го използват на работното място. Кои са трите основни пречки? Липса на безпроблемна интеграция, пропуски в знанията или опасения относно сигурността.
Но какво ще стане, ако изкуственият интелект е вграден във вашето работно пространство и вече е защитен? ClickUp Brain, вграденият AI асистент на ClickUp, превръща това в реалност. Той разбира команди на обикновен език, като решава и трите проблема, свързани с внедряването на AI, и същевременно свързва чата, задачите, документите и знанията ви в цялото работно пространство.
Намерете отговори и полезна информация с едно кликване!
Предпоставки за генериране на SQL с Snowflake Cortex
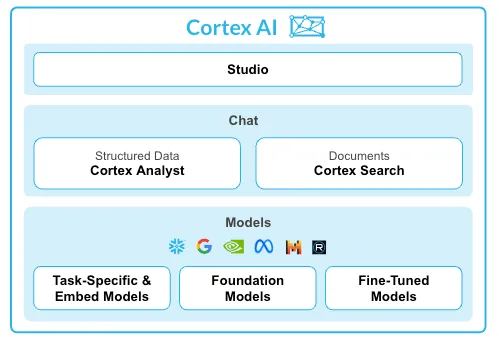
Започването на работа със Snowflake Cortex без подходяща настройка води до разочарование. Може да получите неточни резултати, да загубите време в отстраняване на проблеми и погрешно да заключите, че инструментът не работи, когато всъщност истинският проблем е слабата основа.
За да избегнете това, първо трябва да осигурите три основни елемента.
1. Настройте базата данни и таблиците си
Вашият ИИ е толкова умен, колкото са данните, до които има достъп. Ако схемата на вашата база данни е лабиринт от загадъчни имена на колони като cust_dat_v2_final, както вашите анализатори, така и ИИ ще се затруднят да я разберат.
Това объркване води до това, че ИИ генерира неправилни съединения или извлича данни от грешни колони, а вашият екип губи часове, просто опитвайки се да разгадае схемата, преди дори да може да напише заявка.
Започнете, като се уверите, че софтуерът за хранилището на данни съдържа таблиците, които искате Cortex Analyst да запитва. Когато е възможно, използвайте ясни и описателни имена на колоните. Например, колона с име customer_lifetime_value е много по-интуитивна както за хората, така и за изкуствения интелект, отколкото clv_01.
За да продължите с настройката, вашата роля в Snowflake ще се нуждае от следните разрешения:
- УПОТРЕБА: В базата данни и схемата, съдържащи вашите таблици
- SELECT: Въз основа на таблиците, към които искате Cortex Analyst да отправи заявка
- CREATE STAGE: В схемата, която е необходима за качването на файла с вашия семантичен модел
📖 Прочетете също: Как да използвате Snowflake Cortex за бизнес анализи
2. Създайте своя файл със семантичен модел
Най-голямото препятствие при всеки инструмент за преобразуване на текст в SQL е, че изкуственият интелект не говори уникалния език на вашата компания. Той по принцип не знае, че „ARR“ означава „годишни повтарящи се приходи“ или че таблицата с клиентите ви се свързва с таблицата с поръчките по полето customer_id.
Без този контекст изкуственият интелект може да генерира SQL, който е технически валиден, но логически погрешен, като ви дава отговори, които изглеждат правилни, но са опасно подвеждащи.
Решението е семантичният модел. Това е YAML файл, който действа като ваш персонализиран „преводачески слой“, който обучава Cortex Analyst на специфичната лексика и логика на вашия бизнес. Създаването и поддържането на този файл е съвместно усилие между инженерите по данни, които използват ETL инструменти, за да познават схемата, и бизнес анализаторите, които познават терминологията.
Файлът с вашия семантичен модел трябва да съдържа следните ключови компоненти:
| Компонент | Цел |
| Таблици | Изброява всяка таблица с описание на нейното предназначение на обикновен език |
| Колони | Определя семантичния тип на всяка колона (като категория или метрика) и може да включва примерни стойности |
| Връзки | Определя как таблиците се свързват чрез съединения, като премахва необходимостта от предположения за изкуствения интелект |
| Проверени заявки | Предоставя примери за двойки „въпрос-SQL“, които служат като полезни насоки за LLM |
3. Конфигуриране на Cortex Search Service (по избор)
Понякога отговорите, от които се нуждаете, са скрити в неструктуриран текст, като описания на продукти, заявки за поддръжка или стенограми от разговори. Стандартните SQL заявки не могат да обработват тези данни, което означава, че често пропускате „защо“ зад „какво“.
По желание можете да добавите тук услугата Snowflake Cortex Search Service. Това е слой от типа „търсене като услуга“, който ви позволява едновременно да извършвате заявки както към структурираните си таблици, така и към неструктурираните си текстови данни, като използвате AI агенти за анализ на данните.
Трябва да конфигурирате Cortex Search, ако вашите анализатори трябва да задават въпроси, които изискват извличане на контекст от текста, преди да се генерира SQL. Например, първо можете да потърсите всички рецензии за продукти, съдържащи израза „проблем с батерията“, и след това да генерирате SQL заявка, за да агрегирате данните за продажбите само за тези продукти.
За генериране на чист SQL за структурирани таблици тази услуга не е необходима.
🧠 Интересен факт: В началото на 70-те години на миналия век изследователите от IBM Доналд Чембърлин и Реймънд Бойс създадоха „Structured English Query Language“ (Структуриран английски език за заявки). Те трябваше да променят името на SQL, защото „SEQUEL“ вече беше запазена търговска марка на британска авиационна компания.
Стъпка по стъпка: Ръководство за генериране на SQL с Cortex Analyst
Извършили сте подготвителната работа, но сега сте изправени пред празен екран и не сте сигурни как да продължите. Как да превърнете въпроса, който ви се върти в главата, в изпълнима SQL заявка? Когато управлението на работния процес не е ясно, новите инструменти често остават неизползвани, а инвестицията в настройката се оказва напразна.
Практическият процес е приятно прост. Ето по-подробна информация!
Стъпка № 1: Подгответе данните си в Snowflake
Преди всичко, вашите структурирани данни трябва да се намират в Snowflake. Всяко приложение на Cortex Analyst е насочено към една таблица или към изглед, съставен от една или повече таблици. Уверете се, че таблиците ви са създадени и попълнени.
Ако зареждате данни от плоски файлове:
- Качете вашите файлове с данни (например CSV файлове) в Snowflake Stage
- Използвайте командата COPY INTO, за да заредите данни от междинния етап в таблиците си
- Уверете се, че данните са заредени успешно, преди да продължите
📖 Прочетете още: Как да използвате Snowflake Cortex за корпоративна аналитика
Стъпка № 2: Създайте семантичен модел (или семантичен изглед)
Това е най-важната стъпка при настройката. Силата на Cortex Analyst се крие в комбинирането на големи езикови модели (LLM) със семантични модели – YAML файл, който се намира редом със схемата на вашата база данни и кодира бизнес контекста.
Семантичните изгледи вече са препоръчителният метод на Snowflake за Cortex Analyst. Те съхраняват бизнес показатели, взаимоотношения и дефиниции директно в Snowflake. Старите YAML файлове със семантични модели все още работят, но Snowflake насочва новите имплементации към семантичните изгледи.
Вашият семантичен модел или изглед трябва да включва:
- Описания на таблици и колони: Обяснения на обикновен език за значението на всяко поле
- Бизнес показатели: Дефиниции за изчислени полета като приходи, отпадане на клиенти или процент на конверсия
- Филтри и синоними: Алтернативни термини, които потребителите могат да използват (например „отменено“, съответстващо на конкретна стойност на статуса)
- Проверени заявки: Хранилището за проверени заявки на Snowflake съхранява одобрени двойки „въпрос-SQL“. Когато въпросът на потребителя прилича на някоя от тези записи, Cortex Analyst може да я използва като отправна точка при генерирането на SQL
🤝 Приятелско напомняне: Snowflake препоръчва да използвате не повече от 10 таблици и не повече от 50 избрани колони за оптимална производителност в работния поток на Snowsight.
Стъпка № 3: Качете семантичния модел в етап на Snowflake
Ако използвате семантичен модел на базата на YAML, той трябва да бъде подготвен, за да може Cortex Analyst да го използва по време на изпълнение.
- Качете вашия .yaml файл във вътрешен етап на Snowflake (например RAW_DATA)
- Уверете се, че файлът се появява в етапа чрез потребителския интерфейс на Snowsight или чрез командата LIST @stage_name
- Запишете си пътя към етапа; ще го използвате в API заявките си или в конфигурацията на приложението
Ако използвате Semantic View, тази стъпка се обработва директно в Snowflake и не се налага отделно качване.
🔍 Знаете ли? NULL в SQL не означава нула или празно. То представлява неизвестни или липсващи данни, което води до неинтуитивно поведение, като например сравнения, които не връщат нито „true“, нито „false“.
Стъпка № 4: Изпратете въпрос на естествен език чрез REST API
Сега започва самото генериране на SQL. REST API генерира SQL заявка за даден въпрос, като използва семантичен модел или семантичен изглед, предоставен в заявката.
Структурирайте заявката си към API с:
- съобщения; масив, съдържащ въпроса на потребителя с роля: „user“
- Препратка към вашия семантичен модел или семантичен изглед
- Изберете предпочитания от вас модел (или оставете настройката на „автоматично“, за да може Cortex да избере най-подходящия)
Можете да водите многоетапни разговори, в които да задавате последващи въпроси, основаващи се на предишни заявки.
Стъпка № 5: Анализирайте отговора на API
Всяко съобщение в отговора може да съдържа няколко блока със съдържание от различни типове. Три стойности, които понастоящем се поддържат за полето „type“, са: text, suggestions и SQL.
Ето какво означава всеки тип:
- SQL: Cortex успешно генерира заявка; ето какво ще изпълните
- текст: Обяснение или отговор на естествен език, придружаващ SQL заявката
- предложения: Типът съдържание „предложения“ се включва в отговора само ако въпросът на потребителя е бил двусмислен и Cortex Analyst не е могъл да върне SQL израз за тази заявка. Използвайте ги, за да изясните или прецизирате въпроса
🔍 Знаете ли, че... Редът, в който пишете SQL, не е редът, в който той се изпълнява. Въпреки че първо пишете SELECT, базите данни всъщност обработват FROM и WHERE, преди да подберат колоните. Това обърква както начинаещите, така и опитните потребители.
Стъпка № 6: Изпълнете генерирания SQL код в Snowflake
След като получите SQL блока от отговора, изпълнете го във вашия виртуален склад на Snowflake. Генерираната SQL заявка се изпълнява във вашия виртуален склад на Snowflake, за да се генерира крайният резултат. Данните остават в рамките на управлението на Snowflake.
Важни неща, които трябва да знаете по време на изпълнение:
- Cortex Analyst се интегрира напълно с политиките за контрол на достъпа въз основа на роли (RBAC) на Snowflake, като гарантира, че генерираните и изпълнени SQL заявки спазват всички установени правила за контрол на достъпа
- Ако даден потребител няма достъп до дадена таблица, заявката ще се провали при изпълнението си, точно както би се случило с ръчно написан SQL код.
- На този етап се прилагат разходи за изчислителна мощност на хранилището, които са отделни от таксите за използване на Cortex Analyst.
Стъпка № 7: Усъвършенстване и итерация
Не винаги е гарантирано, че ще получите перфектна заявка още от първия опит. Ето как да подобрите резултатите с течение на времето:
- Добавете проверени заявки към семантичния си модел за въпроси, които се повтарят често
- Обогатете семантичния си модел с по-добри описания, синоними и филтри, когато Cortex интерпретира неправилно даден термин
- Използвайте многоетапни разговори за последващи въпроси, например: „Сега филтрирай това по регион“ – многоетапните разговори позволяват задаването на последващи въпроси, които се основават на предишни заявки
- Следете използването чрез CORTEX_ANALYST_USAGE_HISTORY и историята на заявките в Snowflake, за да откривате модели в неуспешните или неточните заявки
🧠 Интересен факт: Едно пропуснато условие за JOIN може да доведе до огромни проблеми. Пропускането на условие за JOIN може да доведе до декартово произведение, което драстично увеличава броя на редовете и понякога причинява срив на системите.
Най-добри практики за точност при преобразуването на текст в SQL в Snowflake
Качеството на вашия семантичен модел пряко определя точността на заявките, които той генерира. Ето най-добрите практики, които подобряват точността. 🛠️
- Добавете проверени заявки към семантичния си модел: Това е най-ефективното нещо, което можете да направите. Включете много примери за двойки „въпрос-SQL“, които отразяват начина, по който екипът ви наистина задава въпроси.
- Използвайте описателни имена на колони и таблици: Моделът работи по-добре, когато имената на колоните и таблиците са самоописателни. Ако не можете да промените схемата, добавете ясни описания във вашия YAML файл за всички неясни имена на колони
- Включете примерни стойности: Добавянето на примерни данни за категориални колони (като статус или регион) помага на модела да разбере валидните налични опции за филтриране
- Тествайте с крайни случаи: По време на разработката задавайте умишлено двусмислени или сложни въпроси, за да установите къде семантичният ви модел се нуждае от повече контекст или пояснения.
- Усъвършенствайте семантичния си модел: Разглеждайте семантичния си модел като динамичен документ. Той трябва да се актуализира непрекъснато чрез итеративен процес, основан на това кои заявки са успешни и кои не са.
ClickUp: По-проста алтернатива на Snowflake Cortex
Snowflake Cortex работи добре, когато екипите искат да генерират SQL и да изпълняват заявки върху структурирани данни. Екипите дефинират схеми, картографират взаимоотношения и пишат заявки, за да извличат информация. Тази конфигурация е подходяща за среди с голям обем данни, особено когато анализаторите отговарят за отчетността.
Много екипи обаче не се нуждаят от пълен SQL слой, за да отговорят на ежедневните оперативни въпроси. Продуктовите мениджъри, ръководителите на програми и оперативните екипи често искат бързи отговори, свързани с текущата работа.
ClickUp предлага по-достъпен подход. Екипите задават въпроси на обикновен език, преглеждат табла в реално време и действат въз основа на получените данни, без да пишат SQL или да създават семантични модели.
Генерирайте и усъвършенствайте SQL по-бързо
Snowflake Cortex се фокусира върху генерирането на SQL заявки от структурирани набори от данни в среда на хранилище. Това работи добре, когато данните ви вече се намират в Snowflake и имате изготвени схеми.
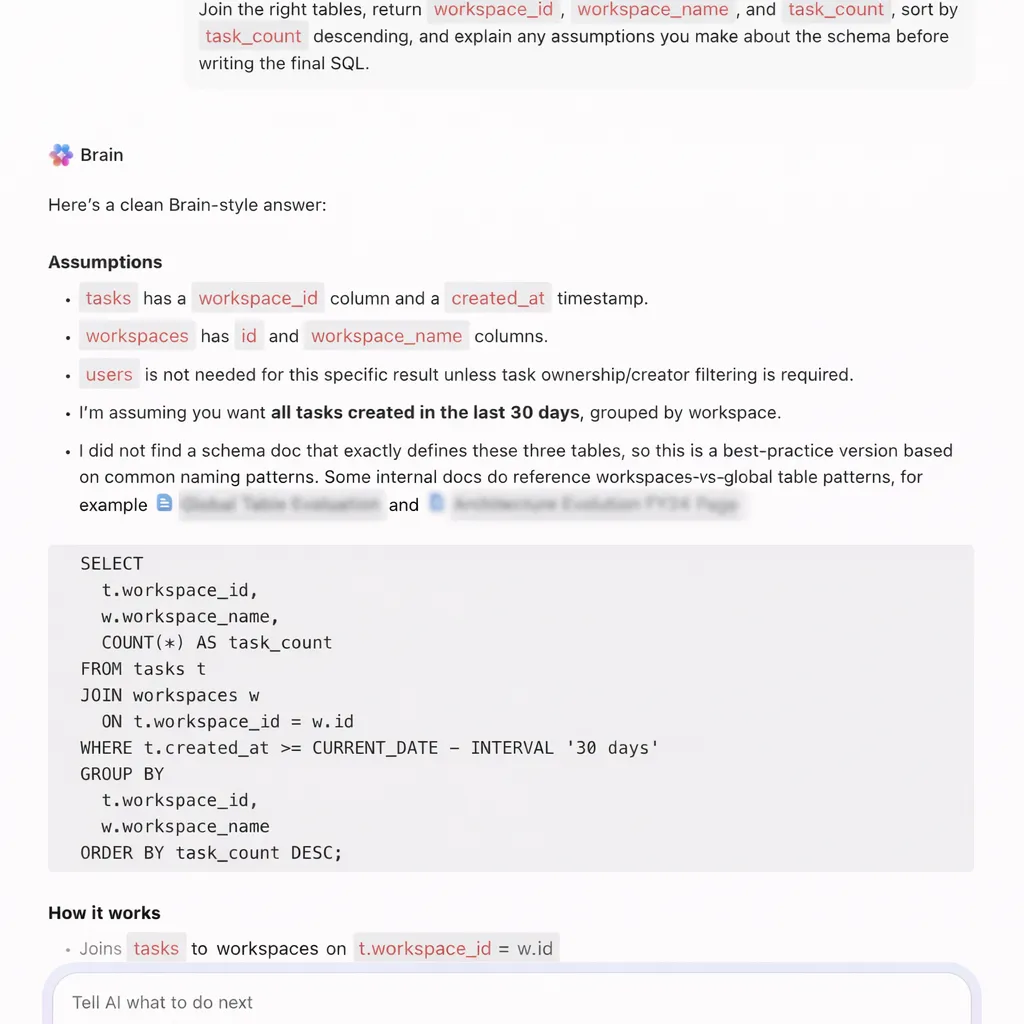
ClickUp Brain поддържа генерирането на SQL по по-гъвкав начин, фокусиран върху изпълнението. Екипите генерират, усъвършенстват и съхраняват SQL заявки директно в своето работно пространство, където вече се извършват анализи, дискусии и вземане на решения.
Да предположим, че продуктов анализатор работи по задача за анализ на задържането на клиенти в ClickUp. Вместо да сменя инструментите, за да напише заявки, той пита ClickUp Brain:
📌 Опитайте с този промпт: Напишете SQL заявка за изчисляване на седемдневната задържаемост на потребителите, групирани по кохорти на регистрация.
ClickUp Brain генерира структурирана заявка, която включва групиране по кохорти, филтри по дата и логика за задържане. Аналитикът поставя заявката в Snowflake или друго хранилище и я изпълнява незабавно.
Това помага за:
- Напишете съединения между няколко таблици, като например потребители, поръчки и събития
- Преобразувайте въпроси за продукти, формулирани на обикновен английски език, в SQL логика, готова за изпълнение
- Отстранявайте грешки в заявките и обяснявайте проблемите, като например неправилни съединения или липсващи условия
- Пренапишете заявките за по-добра производителност или четимост
Например, по време на преглед на експеримент за растеж маркетологът задава въпроса: „Напишете SQL заявка, за да сравните процентите на конверсия между две целеви страници през последните 14 дни“.
ClickUp Brain генерира заявката, като използва условна агрегация и филтри по дата. Екипът я изпълнява в Snowflake и проверява резултатите от експеримента.
📌 Опитайте с този промпт: Поправете тази SQL заявка, в която съединението дублира редове, и обяснете проблема.
ClickUp Brain идентифицира проблема с обединяването, коригира заявката и обяснява как са възникнали дублиращите се редове поради неправилни условия за обединяване.
Заменете отчетите, базирани на SQL
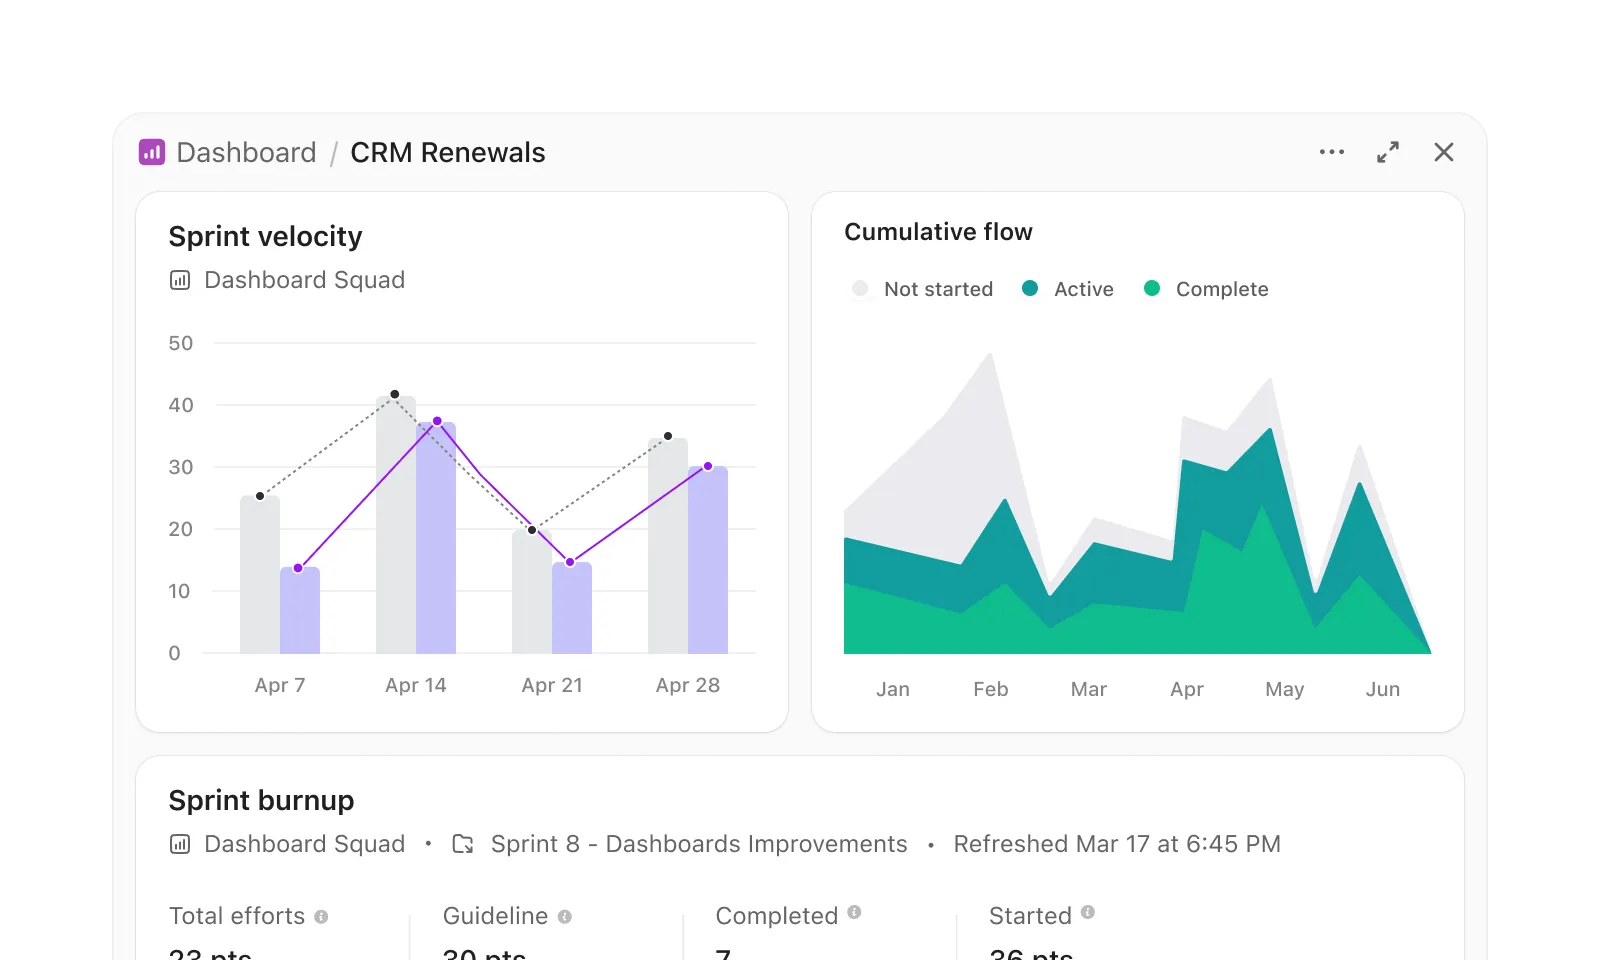
Работните процеси в Snowflake Cortex често включват генериране на SQL, изпълняване на заявки и визуализиране на резултатите в отделен слой. Таблото за управление на ClickUp премахва този многоетапен процес и представя аналитични данни директно от текущата работа.
Екипът за управление на програмата, който следи готовността за пускане на версии, може да създаде табло, без да пише заявки. Например, таблото за пускане на версии може да включва:
- Карта със списък със задачи, филтрирана така, че да показва просрочените задачи във всички продуктови екипи
- Карта на работната натовареност, която показва разпределението на задачите между инженерите
- Диаграма с ленти, сравняваща завършените и чакащите задачи по спринт
- Карта за изчисления, която проследява средното време за изпълнение
Да предположим, че ръководител на програмата преглежда този дашборд преди среща за пускане на версия. Той веднага забелязва, че бекенд услугите показват по-високи нива на закъснение. Той отваря картата със списъка със задачи и проверява точно кои задачи създават риск.
Един реален потребител на ClickUp споделя:
ClickUp ни позволява БЪРЗО да си предаваме проектите, ЛЕСНО да проверяваме статуса на проектите и дава на нашия ръководител възможност да следи натовареността ни по всяко време, без да се налага да ни прекъсва. С помощта на ClickUp със сигурност спестяваме един ден седмично, ако не и повече. Броят на имейлите е ЗНАЧИТЕЛНО намален.
ClickUp ни позволява БЪРЗО да си предаваме проектите, ЛЕСНО да проверяваме статуса на проектите и дава на нашия ръководител възможност да следи натовареността ни по всяко време, без да се налага да ни прекъсва. С помощта на ClickUp определено спестяваме един ден седмично, ако не и повече. Броят на имейлите е ЗНАЧИТЕЛНО намален.
Действайте въз основа на аналитични данни без пипалини
Snowflake Cortex се фокусира върху извличането на информация от данните. Екипите все още трябва да интерпретират резултатите и да задействат действия поотделно.
Super Agents на ClickUp AI запълват тази празнина и превръщат прозренията в действие. Те работят като AI съотборници, които непрекъснато наблюдават данните в работната среда и предприемат действия въз основа на определени условия.
Да предположим, че един програмен мениджър ръководи няколко продуктови инициативи. Един Super Agent може:
- Следете задачите в различните проекти и откривайте кога просрочените задачи надвишават определен праг
- Идентифицирайте модели като повтарящи се закъснения в един и същ етап от работния процес
- Създайте задача, която обобщава засегнатите проекти, и я възложете на ръководителя на програмата
- Уведомявайте ръководителите на екипите, когато критични задачи остават нерешени след изтичане на крайните срокове
Например, по време на цикъл на пускане на версия Super Agent установява, че повече от 10 задачи с висок приоритет в два екипа не са спазили крайните срокове. Той създава задача в ClickUp с заглавие „Риск при пускането на версията: пропуснати крайни срокове“, прикачва всички свързани задачи и я възлага на програмния мениджър за незабавен преглед.
Екипите могат също така да взаимодействат директно със Super Agent: „Анализирай всички активни проекти и подчертай рисковете за изпълнението на този спринт“.
Super Agent проверява крайните срокове, зависимостите и състоянието на задачите, след което публикува структурирано обобщение в работната среда.
Ето как да настроите своя собствен Super Agent в ClickUp:
Централизирайте работните си потоци с данни с ClickUp
Инструментите за преобразуване на текст в SQL, като Snowflake Cortex, правят данните по-достъпни. В същото време получаването на надеждни резултати все още изисква усилия.
Екипите се нуждаят от изчистени схеми, стабилни семантични модели и непрекъснати итерации, за да поддържат точността на резултатите. Дори след генерирането на правилния запит работата не спира дотук. Все още е необходимо някой да интерпретира резултатите, да сподели изводите и да ги превърне в решения.
ClickUp предлага различен подход. Вместо да разделя анализа от изпълнението, ClickUp свързва и двете. Екипите генерират SQL, документират изводите, сътрудничат си по отношение на резултатите и предприемат действия въз основа на тях в рамките на едно и също работно пространство.
ClickUp Brain помага при писането и усъвършенстването на заявките, докато Dashboards и AI Agents помагат на екипите да проследяват резултатите и да напредват в работата си, без да се налага да преминават от един инструмент към друг.
Snowflake Cortex ви помага да получите отговори. ClickUp ви помага да ги използвате. Регистрирайте се в ClickUp още днес!
Често задавани въпроси
Какво представлява Snowflake Cortex Analyst и с какво се различава от Cortex AI?
Snowflake Cortex Analyst е специализирана услуга в рамките на по-широкия пакет Snowflake Cortex AI. Cortex Analyst е насочен конкретно към генерирането на SQL от текст чрез използване на семантични модели, докато Cortex AI включва по-широк спектър от функции за големи езикови модели (LLM), извличане на заключения от модели за машинно обучение и възможности за търсене.
Работи ли Snowflake Cortex Analyst с външни източници на данни като таблици Iceberg?
Да, Cortex Analyst може да извършва заявки към таблици в Apache Iceberg, които се управляват чрез Snowflake. Доколкото таблиците са достъпни във вашата Snowflake среда и са правилно дефинирани във вашия семантичен модел, можете да генерирате заявки към тях.
Колко точно е генерирането на SQL от текст в Snowflake при сложни заявки?
Точността при сложни заявки зависи почти изцяло от качеството на вашия семантичен модел. Модел с добре дефинирани взаимоотношения между таблиците, множество проверени заявки и описателни метаданни ще дава значително по-точни резултати при обединяване на няколко таблици и сложни агрегации.
Колко струват функциите за генериране на SQL в Snowflake Cortex?
Ценообразуването за Snowflake Cortex Analyst следва модела на Snowflake, базиран на потреблението, което означава, че се таксувате въз основа на изчислителните кредити, използвани по време на процеса на генериране на заявки. За най-актуалните тарифи винаги трябва да се обръщате към официалната документация за ценообразуване на Snowflake.