
Jste zaplaveni daty? I ti nejzkušenější odborníci na data mají potíže udržet krok s přívalem dat generovaných světem, kde digitální technologie hrají prim – nemluvě o snaze zefektivnit procesy. Ať už jde o webovou analytiku, údaje o zákaznících nebo metriky výkonnosti, je na vás, abyste zajistili, že tato data budou co nejpřesnější a nejaktuálnější. ✨
Pro vytvoření a údržbu databáze pro vaši firmu je nezbytný solidní návrh databáze, ale i tak musíte vědět, jak zabránit vzájemnému ovlivňování dat a redundanci dat. Závislosti definují vztahy mezi atributy dat, což pomáhá ve všech oblastech, od přesnosti dat až po pokročilé analýzy.
A to nejlepší? Na výběr je opravdu mnoho typů závislostí. Funkční závislosti jsou však nezbytností, pokud se už nemůžete dočkat, až si vytvoříte vlastní databázi.
V tomto průvodci vysvětlíme, co je to funkční závislost, uvedeme několik příkladů všech typů funkčních závislostí a nabídneme užitečné tipy, jak co nejlépe využít vaši relační databázi.

Co je to funkční závislost?
Funkční závislost je typ závislosti, který představuje vztah mezi dvěma proměnnými. Na levé straně se nachází určující atribut, známý také jako primární klíč, a na pravé straně závislý atribut, známý také jako neklíčový atribut. Funkce nebo výsledek se bude měnit v závislosti na vztahu mezi těmito dvěma proměnnými.
Víme, že to zní trochu komplikovaně, proto vám zde vysvětlíme, jak funkční závislosti fungují:
- Řekněme, že používáte software pro správu databáze zákazníků, abyste mohli sledovat narozeniny svých zákazníků. Chcete zákazníkům v den jejich narozenin poslat personalizovaný e-mail, abyste si u nich vybudovali dobrou pověst.
- Funkční závislost potřebujete k tomu, abyste mohli každému uživateli poslat e-mail k jeho narozeninám – vždyť by přece bylo trochu divné rozesílat 300 lidem irelevantní hromadný e-mail s přáním „Všechno nejlepší k narozeninám“, ne?
- V tomto případě závisí funkce odeslání e-mailu na proměnné představující datum narozenin zákazníka.
- Pokud chcete tento typ vztahu ve své databázi, musíte nastavit funkční závislost mezi datem narozenin zákazníka a funkcí, která mu v den narozenin odešle e-mail.
Funkční závislosti jsou základem normalizace databáze. Pomocí normalizace uspořádáte databázi – podobně jako při úklidu pokoje – tak, aby data nebyla duplicitní.
Pravidla funkčních závislostí v systémech pro správu databází
Funkční závislosti se řídí několika pravidly odvození – nazývanými také Armstrongovy axiomy.
Existují tři hlavní pravidla funkční závislosti:
- Reflexivita: Reflexivní pravidlo říká, že pokud se atribut A vztahuje k atributu X, pak se atribut X vztahuje k atributu A. Například pokud A je křestní jméno a X je příjmení, budou se tyto dva atributy vždy vzájemně vztahovat.
- Rozšíření: Pravidlo rozšíření říká, že pokud k proměnné přidáte data (tzv. rozšíření), musíte toto rozšíření přidat do sady atributů. Pokud tedy rozšíříte pole „křestní jméno“ o přezdívku, vztahuje se toto pole nyní také k poli „příjmení“.
- Transitivita: Pravidlo transitivity říká, že pokud se atribut A vztahuje k atributu C, pak z toho vyplývá, že atribut B se také rovná atributu C. Nenechte se tím zmást – transitivní závislost znamená, že někdy jedna věc může určovat druhou, která zase určuje třetí věc. Například pokud ve své CRM platformě generujete čárové kódy pro zákazníky na základě jejich křestního jména a příjmení, pak jméno určuje pořadí zákazníka v abecedním seznamu.
Funkční závislosti promění vaše datové modely v reálné relační schéma pomocí jazyka SQL, čímž zajistí integritu vašich dat. V praxi můžete funkční závislosti využít ve svém systému pro správu databází (DBMS), abyste se zbavili datové redundance a předešli „nepříjemným překvapením“, která mohou způsobit selhání databáze. 👀
Úplná funkční závislost versus částečná funkční závislost
Než se podíváme na různé typy funkčních závislostí, je důležité rozlišovat mezi částečnými a plnými funkčními závislostmi.
Představme si, že vkládáte data z organizačního schématu do databáze. V případě plné funkční závislosti závisí jeden atribut na jiné sadě atributů, nikoli však na její podmnožině. Řekněme tedy, že máme kombinaci „Jméno zaměstnance“ a „ID zaměstnance“, která určuje „Pobočku“.
Pokud znáte „Jméno zaměstnance“ a „ID zaměstnance“, můžete určit „Místo“. Avšak nelze určit „Místo“ pouze na základě těchto dvou proměnných. V tomto případě je „Místo“ plně závislé na kombinaci „Jména zaměstnance“ a „ID zaměstnance“.
K částečné funkční závislosti dochází, když atribut závisí pouze na části primárního klíče, nikoli na složeném primárním klíči. Pokud například můžete určit datové pole „Počet odpracovaných let“ pomocí „ID zaměstnance“, jedná se o částečnou závislost, protože „Počet odpracovaných let“ nezávisí na „Místě“.
Může to znít jako malý rozdíl, ale má to velké důsledky pro normalizaci dat. Částečné funkční závislosti mohou vést k redundancím ve vaší databázi, což znamená, že se jimi budete muset zabývat v rámci druhé normální formy normalizačního procesu, neboli 2NF. Není to sice konec světa, ale rozhodně je to něco, co budete muset v budoucnu napravit. 🛠️
První, druhá a třetí normální forma v jazyce SQL
Cílem normalizace dat je odstranit z databáze jakékoli anomálie při vkládání, aktualizaci nebo mazání, které by mohly způsobit chaos. Normalizace pomocí funkčních závislostí se skládá ze tří kroků.
První normální forma
První normální formu si představte jako základ pro budování systému, ve kterém můžete využívat funkční závislosti. Vytváří základ pro identifikaci závislostí ve druhé a třetí normální formě. Technicky vzato obsahuje 1NF atributy, které obsahují pouze atomické hodnoty, čímž je zajištěno, že se v nich nevyskytují opakující se skupiny.
Druhá normální forma
Po převedení dat do 1NF získáte tabulku, ve které jsou všechny neklíčové atributy plně funkčně závislé na primárním klíči. Ve 2NF odstraníte částečné závislosti rozdělením tabulek, abyste se ujistili, že každý neklíčový atribut je plně závislý na primárním klíči.
Třetí normální forma
Jakmile je datová tabulka v 2NF, přechází do 3NF, jakmile jsou všechny atributy funkčně závislé pouze na primárním klíči a na ničem jiném. Ve 3NF v této fázi odstraníte všechny tranzitivní závislosti dalším rozdělením tabulek.
1NF vytváří základ pro funkční závislosti, zatímco 2NF a 3NF zdokonalují způsob organizace dat restrukturalizací funkčních závislostí. Tím je zajištěno, že každý úsek dat je uložen na nejlogičtějším místě, což snižuje redundanci a zároveň zvyšuje integritu dat.

Typy funkčních závislostí s příklady
Pokud jste připraveni začít používat funkční závislosti, máte na výběr ze čtyř možností.
Triviální
Triviální závislost je základní typ funkční závislosti, kdy atribut nebo množina atributů určuje sama sebe. Každý závislý prvek je v tomto případě podmnožinou svého určujícího prvku. Jinými slovy, pokud je C podmnožinou A, jedná se o triviální funkční vztah.
Možná to zní trochu jako samozřejmost, ale příkladem by mohlo být určení názvu knihy, když znáte jak název, tak autora. Vztah mezi těmito dvěma atributy je poměrně snadno rozpoznatelný, a proto jsou triviální funkční závislosti nejjednodušší k pochopení.
Netriviální
Tady to začíná být zajímavější. V případě netriviální funkční závislosti může jeden atribut určovat jiný, odlišný atribut. V tomto případě je A množinou atributů a totéž platí i pro B, ale B není podmnožinou A. Pokud B není podmnožinou A, mají mezi sebou netriviální vztah.
Máte k dispozici netriviální vztah, pokud vytvoříte databázi knih, každé knize přiřadíte jedinečný kód a můžete vyhledat název knihy, pokud znáte kód, který jí byl přiřazen.
Vícehodnotové
U vícehodnotové závislosti se jeden atribut spojuje s několika dalšími atributy. Atributy ve vaší sadě závislých atributů na sobě nejsou vzájemně závislé. Pokud tedy atributy A a C nemají funkční závislost, je vztah mezi B, A a C vícehodnotový.
Abychom zůstali u analogie s knihami, je to jako u autora, který napsal mnoho knih. Pokud znáte jeho jméno, můžete vyjmenovat všechny knihy, které napsal. Ve vícehodnotové funkční závislosti bude mít jeden autor k svému jménu přiřazeno více knih.
Transitivní
Transitivní funkční závislost nastává, když jeden atribut určuje další a ten zase další. Je to něco jako řetězová reakce. Pokud vám to zní povědomě, je to proto, že tento typ funkční závislosti se řídí pravidlem transitivity.
V tomto případě platí, že pokud A se rovná B a B se rovná C, pak se A musí rovnat C. Představme si, že vytváříte databázi knih a vaše jedinečné kódy knih určují vydavatele a žánry. Pokud znáte kód knihy, můžete zjistit, kdo je vydavatel a jaký je žánr knihy.
Jak využívat funkční závislosti pro správu databází
Těšíte se na to, až začnete využívat funkční závislosti? Můžete je používat, jak se vám zlíbí, ale pokud chcete pracovat chytřeji a s menším úsilím, sáhněte po ClickUp.
Zde je stručný přehled toho, jak vytvořit databázi v ClickUp a začlenit do ní funkční závislosti:
Nejprve je třeba v ClickUp nastavit databázi. Můžete importovat datové listy z Excelu nebo si vytvořit vlastní od základu.
Zobrazení tabulky v ClickUp umožňuje hromadné úpravy a další přizpůsobená zobrazení, díky kterým můžete sledovat data prakticky o čemkoli. ClickUp také vizualizuje data, takže můžete vyhodnotit svou databázi v rekordním čase.
Dobrou zprávou je, že zde nezačínáte úplně od nuly. Díky šablonám databází v ClickUp je jejich vytváření hračkou.
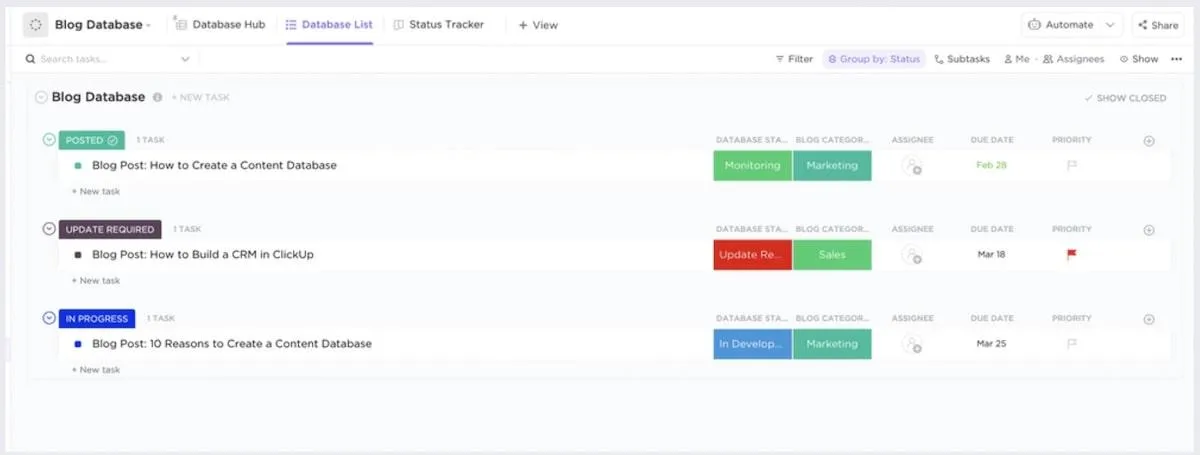
Šablona databáze ClickUp Blog je velmi užitečná pro plánování obsahu a šablona ClickUp Employee Directory je ideální pro rychlé vytvoření databáze s kontaktními údaji spolupracovníků. Jedná se také o databázi bez nutnosti programování, takže pokud chcete vytvořit databázi, aniž byste se museli učit jazyk SQL, máme pro vás řešení.
Začlenění funkčních závislostí do ClickUp
Obvykle byste museli psát spoustu SQL kódu, abyste v databázi vytvořili funkční závislosti. Naštěstí rozhraní ClickUp s funkcí drag-and-drop usnadňuje vytváření vztahů mezi úkoly a dokumenty. Navíc nástroje umělé inteligence v ClickUpu dělají správu databáze hračkou – i když sami nejste odborníci na databáze.
Zde je návod, jak vytvořit závislost ve vaší databázi ClickUp.
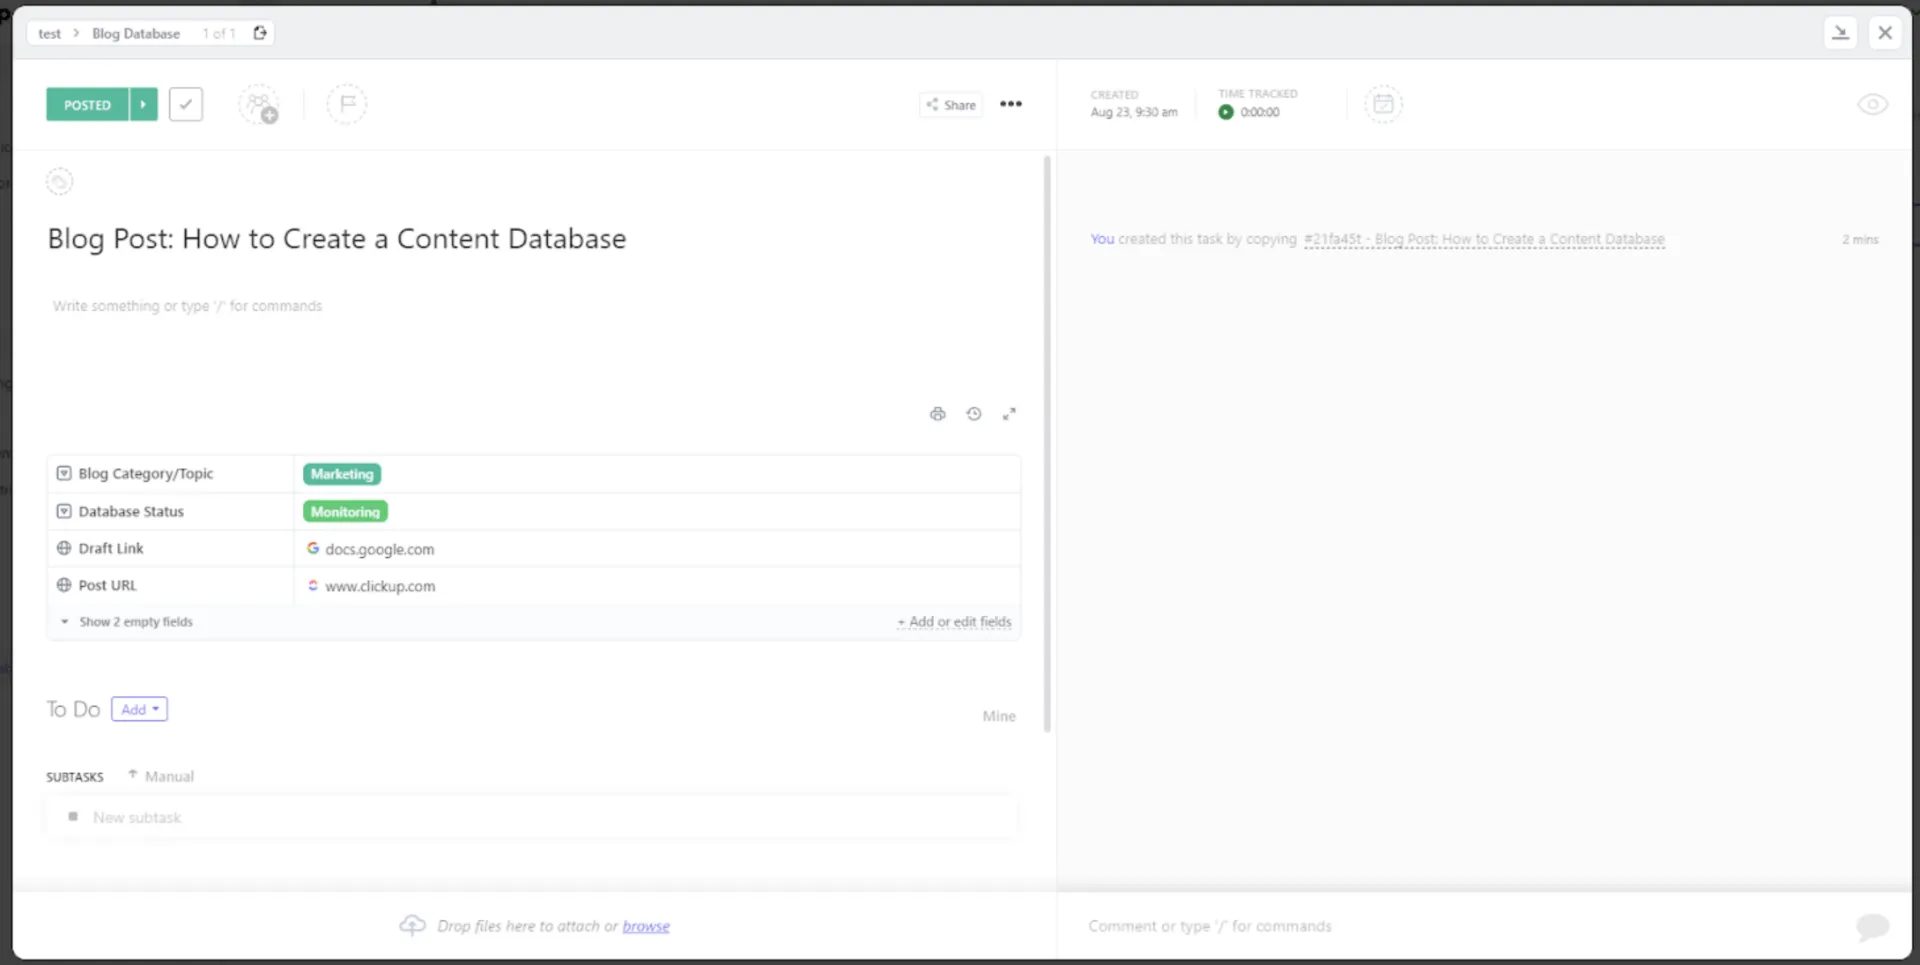
Nejprve klikněte na úkol, se kterým chcete pracovat.
Přejděte do části Vztahy > Závislost. Vyberte si z možností Čeká na, Blokuje a Úkoly a přizpůsobte si vztah podle svých potřeb.
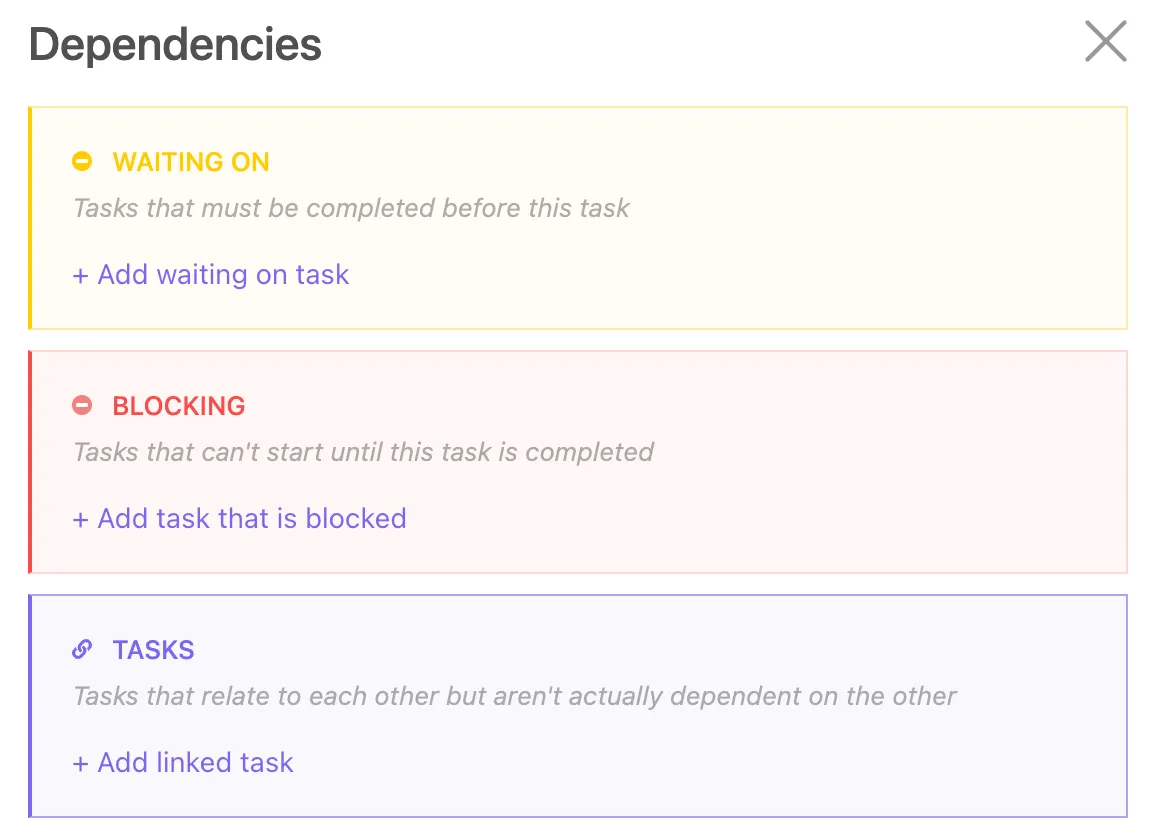
V tomto případě zvolíme možnost Waiting On a vyhledáme další úkol, který bude souviset s aktuálním úkolem.
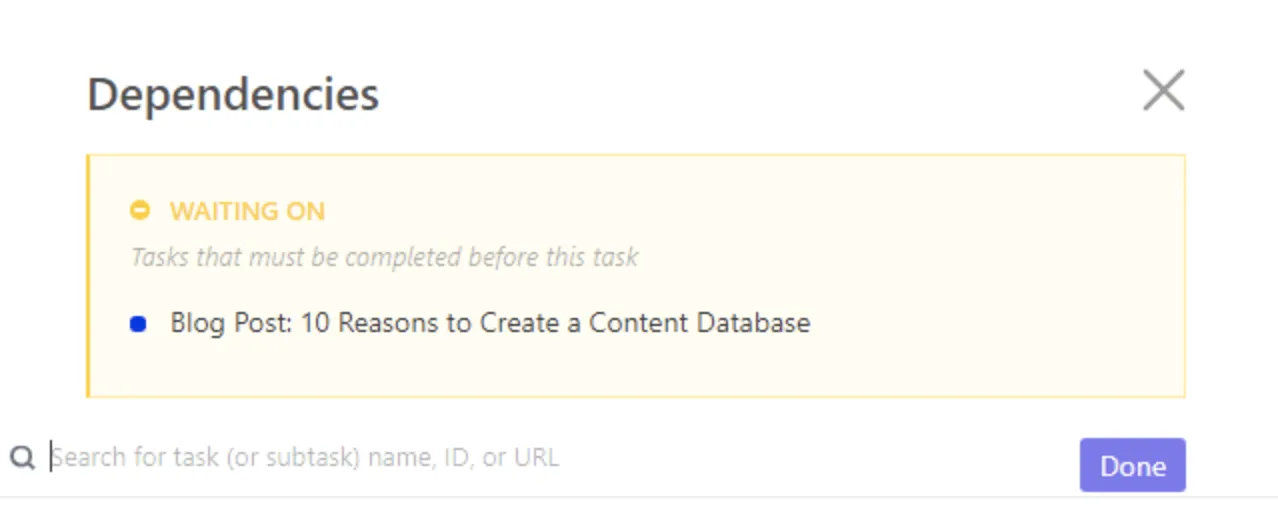
Klikněte na „Hotovo“ a máte hotovo! 🙌
Zjednodušte závislosti s ClickUpem
Kdo říká, že správa databází musí být složitá? Pokud porozumíte principům funkčních závislostí, navrhnete rychlou a přesnou databázi, která pomůže vaší organizaci v dalším rozvoji.
A nemusíte to zvládat sami. ClickUp je spolehlivý systém pro správu databází, který kombinuje data se šablonami, projekty, úkoly, cíli a vším, co k tomu patří.
Ušetřete více času a soustřeďte se na úkoly s vysokou přidanou hodnotou díky přechodu na skutečně komplexní platformu ClickUp.
Vyzkoušejte si to sami: Vytvořte si bezplatný účet na ClickUp a vytvořte si lepší databázi!