2026. szeptember 22-én az Anthropic kiadta a Claude Opus 5.5-öt, míg az OpenAI a Sol és a Luna modellekkel bővítette a GPT-6 családot. Ez az időzítés újabb körre ösztönözte a szerszámok teljesítményének összehasonlítását.
A probléma azonban az, hogy sem a Claude, sem a ChatGPT már nem egyetlen modell.
A Claude jelenleg a Fable, az Opus, a Sonnet és a Haiku verziókat foglalja magában, míg a ChatGPT a különböző feladatokat a saját GPT-modellei és üzemmódjai között osztja szét. A teljesítménymérési táblázatok gyakran ezeknek a családoknak különböző tagjait hasonlítják össze különböző beállítások mellett, ami megnehezíti egy egyértelmű „a Claude X pontot, a ChatGPT pedig Y pontot ért el” jellegű következtetés megfogalmazását.
Így áll valójában a Claude és a ChatGPT közötti választás 2026-ban.
Bár a nyers teljesítmény továbbra is fontos, a teljesítménymutatók önmagukban nem jelentenek meggyőző vásárlási érvet. A gyakorlati különbségek között szerepelnek a rendelkezésre álló modellek, a funkciók, a használati korlátok és a frissítés költségei. Ebben a blogbejegyzésben részletesen bemutatjuk mindazt, amit tudnod kell – attól kezdve, hogy kinek készült a termék, egészen addig, hogy melyikben vannak hiányosságok.
Összefoglalás: A Claude és a ChatGPT nyers teljesítménye tekintetében közel állnak egymáshoz. Az igazi különbségek a munkafolyamatban, az eszközökben és a korlátokban mutatkoznak meg.
- Ne a teljesítményteszteket vedd alapul a döntéshez! A szolgáltatók egymás modelljeit különböző beállítások mellett tesztelik. Először próbáld ki mindkét szolgáltatás ingyenes csomagját a saját feladataidra!
- Tartsd meg mindkettőt csak akkor, ha a különbségek hetente megjelennek a munkádban
- Válasszuk a Claude-ot hosszú programozási munkákhoz, nagy méretű dokumentumokhoz és olyan írási feladatokhoz, amelyeknek részletes utasításokat kell követniük, és amelyek során számos átdolgozásra van szükség.
- Válassza a ChatGPT-t, ha egyetlen asszisztenst szeretne a kutatáshoz, a fájlokhoz, a képekhez, a hangfelvételekhez és a programozáshoz, ráadásul a legolcsóbb fizetős csomagot (az USA-ban 8 dollár/hó a Go csomagért).
- A programozás terén a Claude Code előnyösebb a hosszú refaktorálások és migrációk esetében. A Codex jobb választás, ha asztali számítógép, CLI, IDE, felhő és mobil eszközök között váltogatsz.
- A Claude nem tud képeket generálni. A ChatGPT viszont képes rá, és ez az a különbség, amelyet a felhasználók leggyakrabban említenek.
❗️A legtöbb AI-ügynök 65 pont alatt teljesített.
6 mesterséges intelligencia-eszközt teszteltünk egy valós feladaton: egy rövid leírás alapján kellett kidolgozni egy végrehajtható projekttervet. A győztes nem az volt, aki a legjobban írt, hanem az, amelyik hozzáférhetett valós munkadatokhoz. 👇🏼
A Claude és a ChatGPT összehasonlítása egy pillanat alatt
| Kategória | Claude | ChatGPT |
|---|---|---|
| Legalkalmasabb | Hosszú programozási munkamenetek, nagy méretű dokumentumok, kutatás és utasításokban gazdag szövegek írása | Kutatás, írás, képek, programozás, fájlok, hang és többformátumú munkafolyamatok |
| A fizetős szolgáltatás kezdő ára | 20 dollár/hó a Pro verzióért, vagy 200 dollár/év (~17 dollár/hó) | 8 dollár/hó a Go csomagért az Egyesült Államokban; 20 dollár/hó a Plus csomagért |
| Kiemelkedő erősség | Mélyreható, kontextusigényes feladatok, amelyek több lépésből állnak | Széles körű eszközök és formátumok egyetlen termékben |
| Programozás | Kifejezetten alkalmas hosszú távú refaktorálásokhoz, migrációkhoz, auditokhoz és a repository-kkel kapcsolatos munkákhoz | Jobban megfelel a felhőalapú futtatáshoz, valamint az asztali számítógép, az IDE, a CLI és a mobil eszközök közötti váltáshoz |
| Írás | Inkább hosszú szövegek megírásához, forrásanyagokkal járó szerkesztéshez és részletes stílus szabályokhoz alkalmas | Inkább strukturált írásra alkalmas, amely összekapcsolható kutatásokkal, fájlokkal, képekkel és egyéb formátumokkal |
| Használati korlátok | A Claude, a Desktop és a Claude Code között megosztott keret, ötórás és heti korlátokkal | A korlátok modelltől és funkciótól függően változnak, külön keretek vonatkoznak a Chat, a Work, a Codex, a Voice és egyéb eszközökre. |
| Natív képgenerálás | Nem | Igen |
| A csúcsmodell API-árak | Opus 5.5: 4 USD/20 USD; Fable 5.1: 10 USD/50 USD 1 millió bemeneti/kimeneti tokenenként | GPT-6 Astra: 10 USD/50 USD 1 millió bemeneti/kimeneti tokenenként |
| Fő kompromisszum | Szűkebb eszközkészlet és korlátozások bizonyos kiberbiztonsági és élettudományi feladatok esetében | Bonyolultabb modellhozzáférés és korlátozások a termék különböző részein |
Hogyan értékeljük a szoftvereket a ClickUp-nál
Szerkesztőségünk átlátható, kutatásokon alapuló és gyártóktól független eljárást követ, így bízhat abban, hogy ajánlásaink a termékek valós értékén alapulnak.
Íme egy részletes áttekintés arról, hogyan értékeljük a szoftvereket a ClickUp-nál.
Claude és ChatGPT teljesítménytesztek: Miért nem árulnak el mindent a pontszámok?
A teljesítményteszt-eredmények már nem adnak egyértelmű választ a Claude és a ChatGPT közötti kérdésre. Az értékelési verzió, a következtetés-beállítás, a biztonsági intézkedések, a tartalékmodellek és a tesztelési környezet mind befolyásolhatják az eredményt.
A Zapier által fejlesztett AutomationBench azt teszteli, hogy egy ügynök képes-e valós üzleti munkafolyamatokat végrehajtani a csatlakoztatott alkalmazások között. Az OpenAI GPT-6 Astra bejelentésében a GPT-5.6 Sol 18,1%-os eredményt ért el. Alig 19 nappal később az Anthropic Opus 5.5 bejelentése a Zapier ranglistájának eredményei alapján 28,8%-ot jelentett a GPT-5.6 Sol esetében.
Ez 10,7 pontos különbség ugyanazon modell esetében ugyanazon a teljesítményteszten. A Zapier megjegyzi, hogy saját értékelési adatkészlete a teljesítményteszt-verziók között változhat, és a különböző ügynökbeállítások eltérő eredményeket hozhatnak. A pontszámot a tesztelési feltételekkel együtt kell értelmezni.
A teljesítménytesztek azt is mutatják, hogy az OpenAI és az Anthropic nem mindig ugyanolyan feltételek mellett tesztelte a Claude-ot:
- Az OpenAI időnként egy kevésbé korlátozott Claude-modellt használt. A ScreenSpot-Pro és az ExploitGym esetében az OpenAI szerint a Fable-eredmények a Mythosból származnak, amelyet a cég úgy ír le, mint „kevesebb biztonsági intézkedéssel rendelkező Fable-t”.
- Az Anthropic megtartotta az Opus 5.5 termelési biztonsági intézkedéseit. Amikor ezek a biztonsági intézkedések beavatkoztak, egyes kiberbiztonsági feladatokat át kellett irányítani az Opus 4.8-ra, míg egyes biológiai és határterületi LLM-feladatokat az Opus 5-re. Az AutomationBench-en nem volt tartalékmodell, így a beavatkozás sikertelen feladatnak számított.
Az elutasítási viselkedés is részét képezi az összehasonlításnak. Az OpenAI kihagyta a Claude Fable 5 és 5.1 verzióit a LifeSciBench Gold v1, a GeneBench Pro v13 és a MedChemBench tesztekből, mivel a modellek a kérdések nagy részét elutasították. A HealthBench Professional tesztben az OpenAI az Opus 5-öt használta tartalék megoldásként, amikor a Fable 5.1 elutasította a kérdéseket.
Mondani sem kell, hogy egy modell rendelkezhet a szükséges alapvető képességekkel, de mégis alkalmatlan lehet egy munkafolyamatra, ha nem lehet hozzá megbízhatóan hozzáférni. Az Anthropic elismeri magát a tágabb problémát is, mondván, hogy „a teljesítményteszt-eredmények már kevésbé megbízható útmutatók a valós különbségekhez. ”
Mely területeken teljesít jobban a Claude Opus 5.5 és a GPT-6 Astra?
Az Anthropic 2026. szeptemberi táblázata öt közvetlen összehasonlítást tartalmaz a Claude Opus 5.5 és a GPT-6 Astra között.
| Teljesítményteszt | Claude Opus 5. 5 | GPT-6 Astra | Magasabb pontszám |
|---|---|---|---|
| Terminal-Bench 4.0 (agenciális kódolás) | 66,4% | 57,9% | Opus 5. 5 |
| GDPval-AA v2.1 (tudásalapú munka, Elo) | 1846 | 1542 | Opus 5. 5 |
| Az emberiség utolsó vizsgája (eszközökkel) | 67,7% | 57,2% | Opus 5. 5 |
| AutomationBench (üzleti munkafolyamatok) | 40,0% | 41. 4% | GPT-6 Astra |
| Terminal-Bench-Science 0.1 | 58,7% | 64,6% | GPT-6 Astra |
Az Anthropic szerint az Opus 5.5 – ha másképp nem jelezzük – maximális erőfeszítéssel alkalmazta az adaptív gondolkodást.
A „erőfeszítés” alatt azt értjük, hogy mennyi időt kap az AI a munkája ellenőrzésére. Az Anthropic szinte minden tesztnél a maximális gondolkodási időt engedélyezte az Opus számára. Egy kódolási teszt, a Terminal-Bench 4.0 esetében egyik modell sem futott a maximális beállításon: az Opus egy lépéssel alatta futott, az Astra pontszáma pedig az OpenAI saját jelentéséből származik, alacsonyabb beállítás mellett. Az Anthropic szerint ezek voltak azok a beállítások, amelyekkel az egyes modellek a legjobb eredményt érték el. Akárcsak az emberek, az AI is túlgondolhat egy problémát, így a hosszabb gondolkodási idő nem mindig jelent jobb eredményt.
Összességében az Opus 5.5 jobb eredményeket ér el az ügynöki kódolás, a tudásalapú munka és a „Humanity’s Last Exam” feladatok terén, az eszközök használatával. Az Astra jobb eredményeket ér el az üzleti munkafolyamatok és az ügynöki tudományos kutatás terén.
Claude (erősségek, legjobb felhasználási esetek és korlátozások)
A Claude az Anthropic mesterséges intelligencia-modelljeinek családja. A jelenlegi termékpaletta a Fable 5.1, az Opus 5.5, a Sonnet 5 és a Haiku 4.5 modelleket tartalmazza.
A Fable 5.1, az Opus 5.5 és a Sonnet 5 egyaránt támogatja az 1 millió tokenes kontextusablakot, míg a Haiku 4.5 200 000 tokent támogat. Az Anthropic a Fable-t igényes érvelési feladatokhoz és hosszú távú munkákhoz, az Opust kódoláshoz és tudásalapú munkákhoz, a Sonnetet a sebesség és az intelligencia közötti egyensúlyhoz, a Haikut pedig gyorsabb, nagy volumenű feladatokhoz pozícionálja.
Kiknek készült a Claude?
A Claude kiválóan alkalmas azok számára, akik nem egyszeri feladatokra, hanem nagy, összetett feladatokra bízzák az AI-t. Ide tartoznak a nagy kódbázisokon dolgozó fejlesztők, a hosszú dokumentumokat átnéző elemzők, a bizonyítékokat összegyűjtő kutatók, valamint a részletes briefekkel és stílus szabályokkal dolgozó írók és szerkesztők.
Egyszerűen fogalmazva: a Claude olyan feladatokhoz a legalkalmasabb, amelyek sok kontextust, több lépést vagy hosszú munkamenetet igényelnek. Ez jól illeszkedik nagy fájlokhoz, hosszú beszélgetésekhez és olyan projektekhez, amelyek korábbi munkákra épülnek.
Kiemelkedő erősségek
- Hosszú távú kódolási és ügynöki feladatok. Az Opus 5.5-öt olyan feladatokra tervezték, mint a kódbázis-szintű migrációk, auditok és a több lépésből álló ügynöki feladatok. Az Anthropic beszámolója szerint egy korai tesztelő kevesebb mint három óra alatt befejezte egy 200 000 soros kódbázis auditját és javítását, míg az Opus 5-nek ehhez több mint 20 órára volt szüksége. A független értékelő, a METR óvatosabb volt: megállapította, hogy az Opus 5.5 szerény javulást jelent a Fable 5.1-hez képest a nehéz, hosszú távú feladatok esetében, és arra számít, hogy felgyorsítja az AI-kutatás és -fejlesztés egyes részeit.
- Nagy, sok forrásanyagot igénylő projektek. A Claude Projects segítségével a dokumentumokat, a kódot és az utasításokat egy munkaterületen tarthatja össze. A fizetős csomagoknál a Projects automatikusan átáll a visszakeresési módra, amikor a tudásbázis megnő, és akár tízszer több projekttartalomból is ki tudja szűrni a releváns anyagokat.
- Kutatás és dokumentumkezelés. A Claude hosszú forrásanyagok feldolgozására is képes, miközben az eredeti anyagok mindig kéznél vannak. A Fable 5.1 kifejezetten a több lépésből álló kutatásokhoz, valamint dokumentumok, táblázatok és diák kezeléséhez készült, míg az Opus 5.5 a tudásalapú munkára, valamint a kódolásra és az ügynökökre összpontosít.
- A következő szöveg egy rövid összefoglalót követ. Az Anthropic úgy hangolta be az Opus 5.5-öt, hogy az a legfontosabb információkat helyezze előtérbe, kerülje a szakzsargont, és szigorúbban kövesse az írási szabályokat. Ez hasznos olyan munkáknál, ahol a hangnemnek, a szerkezetnek és az utasításoknak több körös átdolgozáson is át kell menniük.
Értékelések
- G2: 4,6/5 (több mint 470 értékelés)
- Capterra: 4,4/5 (több mint 50 értékelés)
Egy G2-felhasználó így nyilatkozott:
A számos elérhető AI-csevegő és ügynökszerű kódolási eszköz közül a Claude teljesítményét és pontosságát rendkívül lenyűgözőnek találom – különösen, ha komplex problémák kezeléséről, a kontextus megértéséről és a megbízható, kiváló minőségű eredmények következetes előállításáról van szó. A Claude Code emellett rendkívül hasznos funkciók fejlesztéséhez, tesztek futtatásához és hibajavításhoz, valamint az automatizáláshoz és a telepítéshez is. Összességében úgy érzem, hogy pontosság, teljesítmény és a megbízható eredmény eléréséhez szükséges idő tekintetében messze megelőzi a többi hasonló kódolási eszközt.
A számos elérhető AI-csevegő és ügynökszerű kódolási eszköz közül a Claude teljesítményét és pontosságát rendkívül lenyűgözőnek találom – különösen, ha komplex problémák kezeléséről, a kontextus megértéséről és a megbízható, kiváló minőségű eredmények következetes előállításáról van szó. A Claude Code rendkívül hasznos a funkciók fejlesztésében, a tesztek futtatásában és a hibajavításban, valamint az automatizálásban és a telepítésben is. Összességében úgy érzem, hogy pontosság, teljesítmény és a megbízható eredmény eléréséhez szükséges idő tekintetében messze megelőzi a többi hasonló kódolási eszközt.
Hol ér véget a verseny
A Claude továbbra sem készít fényképeket vagy illusztrációkat. Képes elemezni a feltöltött képeket, és HTML-ben és SVG-ben táblázatokat, diagramokat és interaktív vizuális elemeket létrehozni, de nincs saját képgenerátora. Ha azt szeretné, hogy ugyanaz az AI-eszköz írja meg a kampány szövegét és készítse el a hozzá tartozó grafikákat is, akkor a képekhez egy másik eszközre lesz szüksége.
Biztonsági intézkedései a fejlett kiberbiztonsági és élettudományi munkára is hatással lehetnek. Az Opus 5.5 a jelzett kiberbiztonsági kéréseket átirányíthatja az Opus 4.8-ra, míg a Fable 5.1 egyes kiberbiztonsági és biológiai kérések esetén visszatérhet az Opus-modellekhez. Az Anthropic hitelesítési programokat kínál a legitim kutatások számára, bár az Opus 5.5 Cyber Verification hozzáférése még folyamatban van.
Legalkalmasabb: Hosszú programozási és ügynöki munkamenetek, nagy dokumentumok elemzése, kutatás és írás, ahol részletes stílus- vagy formázási szabályokat adsz meg a modellnek.
Hagyja ki, ha: natív képgenerálásra van szüksége, vagy a mindennapi munkája nagymértékben korlátozott kiberbiztonsági vagy élettudományi feladatokra épül.
ChatGPT (erősségek, legjobb felhasználási esetek és korlátok)
A ChatGPT az OpenAI mesterséges intelligenciás asszisztense, amely különféle feladatokhoz külön modellekkel és üzemmódokkal rendelkezik.
A GPT-5.6 Sol biztosítja a fő fizetős csevegési élményt, míg egy könnyebb GPT-modell szolgálja ki a Free és a Go felhasználókat. A GPT-6 Astra által működtetett GPT-6 Pro a legmagasabb szintet képviseli a jogosult Pro, Business és Enterprise felhasználók számára. A Work és a Codex csomagok a választott tervtől függően hozzáférést biztosítanak olyan modellekhez, mint a GPT-6 Astra, a Sol és a Luna.
Kiknek készült a ChatGPT?
A ChatGPT-t azoknak fejlesztették, akik egyetlen asszisztenst szeretnének különböző típusú feladatokhoz. Egy marketinges képeket és szövegeket is generálhat, egy kutató a Deep Research segítségével hivatkozásokkal ellátott jelentéseket készíthet, egy elemző PDF-fájlokat és táblázatokat dolgozhat fel, egy fejlesztő pedig átléphet a Codexbe. Emellett olyan mindennapi feladatokat is ellát, mint a keresés, a tervezés, a fájlok elemzése és a gyors kérdések megválaszolása.
Kiemelkedő erősségek
- Különböző forrásokból származó hivatkozott kutatások. A Deep Research az internetről, feltöltött fájlokból és csatlakoztatott alkalmazásokból gyűjt adatokat, majd hivatkozásokkal ellátott jelentést állít össze. A keresést konkrét webhelyekre korlátozhatja, szerkesztheti a kutatási tervet, és a folyamat közben átirányíthatja a keresést.
- Képek létrehozása és szerkesztése. A dedikált Images munkaterület egy helyen tárolja a létrehozott képeket, hogy azokat szerkeszthessük, elmenthessük és újra felhasználhassuk. Tölts fel egy meglévő képet, és írj le egyszerű nyelven, hogy mit szeretnél változtatni, vagy indulj ki egy sablonból poszterek és logók készítéséhez
- Weboldalak és könnyűsúlyú alkalmazások. Az OpenAI saját példái a Sites szolgáltatásra vonatkozóan magukban foglalják a műszerfalakat, a projektkövetőket, a bevezetési naptárakat, a prototípusokat és a belső portálokat, amelyek mindegyikét a ChatGPT-n keresztül hozták létre, nézték át és tették közzé. A Sites jelenleg béta verzióban érhető el a Plus, a Pro és az arra jogosult munkaterületeken.
- Ütemezett és összekapcsolt feladatok. Egy új e-mail, Slack-üzenet vagy GitHub-pull-request önmagában is elindíthat egy feladatot. Ezen kiváltó tényezőkön túl a ChatGPT egyszeri vagy ismétlődő feladatokat is végrehajt, és a Gmail, a Slack, a GitHub, a Google Drive és más összekapcsolt alkalmazásokkal is együttműködik.
Értékelések
- G2: 4,6/5 (több mint 3 000 értékelés)
- Capterra: 4,4/5 (több mint 400 értékelés)
Egy G2-felhasználó így nyilatkozott:
Imádom a ChatGPT-t a lenyűgöző képalkotási képességei miatt, amelyeket az AI legjobb funkciójának tartok. Az interaktivitás számomra egy másik kiemelkedő szempont. Segít megoldani számos problémát, például annak megállapításában, mely feladatok sürgősek, valamint támogat a tartalomkészítésben, a forgatókönyvírásban és akár az e-mailek megírásában is. Nagyra értékelem, hogy mind a szakmai, mind a magánéletem terén segítséget nyújt. Ráadásul a kezdeti beállítás is nagyon egyszerű volt: csak be kellett jelentkeznem, és máris elkezdődött a beszélgetés.
Imádom a ChatGPT-t a lenyűgöző képalkotási képességei miatt, amelyeket az AI legjobb funkciójának tartok. Az interaktivitás számomra egy másik kiemelkedő szempont. Segít megoldani számos problémát, például annak azonosításában, hogy mely feladatok sürgősek, és támogat a tartalomkészítésben, a forgatókönyvírásban, sőt még az e-mailek írásában is. Nagyra értékelem, hogy mind a szakmai, mind a magánéletem terén segítséget nyújt. Ráadásul a kezdeti beállítás is nagyon egyszerű volt: csak be kellett jelentkeznem, és máris elkezdődött a beszélgetés.
Hol ér véget
A ChatGPT modellválasztéka néha zavaros lehet. Az Astra által támogatott GPT-6 Pro a normál Chat Pro, Business és Enterprise csomagokban érhető el, de a Plus csomagban nem. A Plus felhasználók a Work és a Codex szolgáltatásokon keresztül érhetik el az Astrát. A GPT-6 Sol és a Luna szintén a Work és a Codex szolgáltatásokban található, nem pedig a normál Chatben. Az, hogy melyik modellt használhatod, a csomagodtól és a használt felülettől függ.
Az Astra kiegészítő biztonsági ellenőrzései néha megszakíthatják a jogos munkavégzést, beleértve a védekező kiberbiztonsági tevékenységeket is. A ChatGPT-ben és a Codexben egy jelzett feladat áttekintés céljából szünetelhet, mielőtt folytathatnánk. Az API-ban a feladat leáll.
Legalkalmasabb: Azok számára, akik egyetlen AI-munkaterületet szeretnének a kutatáshoz, fájlokhoz, képekhez, programozáshoz, hangfelvételekhez, weboldalakhoz és ismétlődő feladatokhoz.
Hagyja ki, ha: Munkája főként hosszú ideig tartó kódolásból vagy dokumentumokhoz kötődő elemzésből áll, és inkább a mélyebb folyamatosságra szeretne optimalizálni, mint egy széles körű eszközkészletre.
Claude és ChatGPT összehasonlítása programozás szempontjából
A Claude Code és a Codex egyaránt képes a reposztóriumok áttekintésére, fájlok szerkesztésére, parancsok futtatására, a változtatások tesztelésére, valamint a több lépésből álló fejlesztési feladatok kezelésére. A legszembetűnőbb különbség a modell körüli munkafolyamatban rejlik.
Az Anthropic által közzétett teljesítménymérési eredmények szerint az Opus 5.5 a Terminal-Bench 4.0-n 66,4%-os pontszámot ért el az Astra 57,9%-ával szemben, míg a FrontierCode sokkal közelebb áll hozzá: 54,4% szemben 53,3%-kal.
A független eredmények kevésbé egyoldalúak.
Az Artificial Analysis az Opus 5.5-öt 59,6%-os eredménnyel mérte a Terminal-Bench 4.0-n, ami egy szintre hozza az Astra-val, míg az Endor Labs megállapította, hogy a Codex és az Astra kissé megelőzi a Claude Code-ot és az Opus 5.5-öt a biztonságos kódgenerálás terén (34,6% szemben 33,5%-kal).
Claude programozáshoz
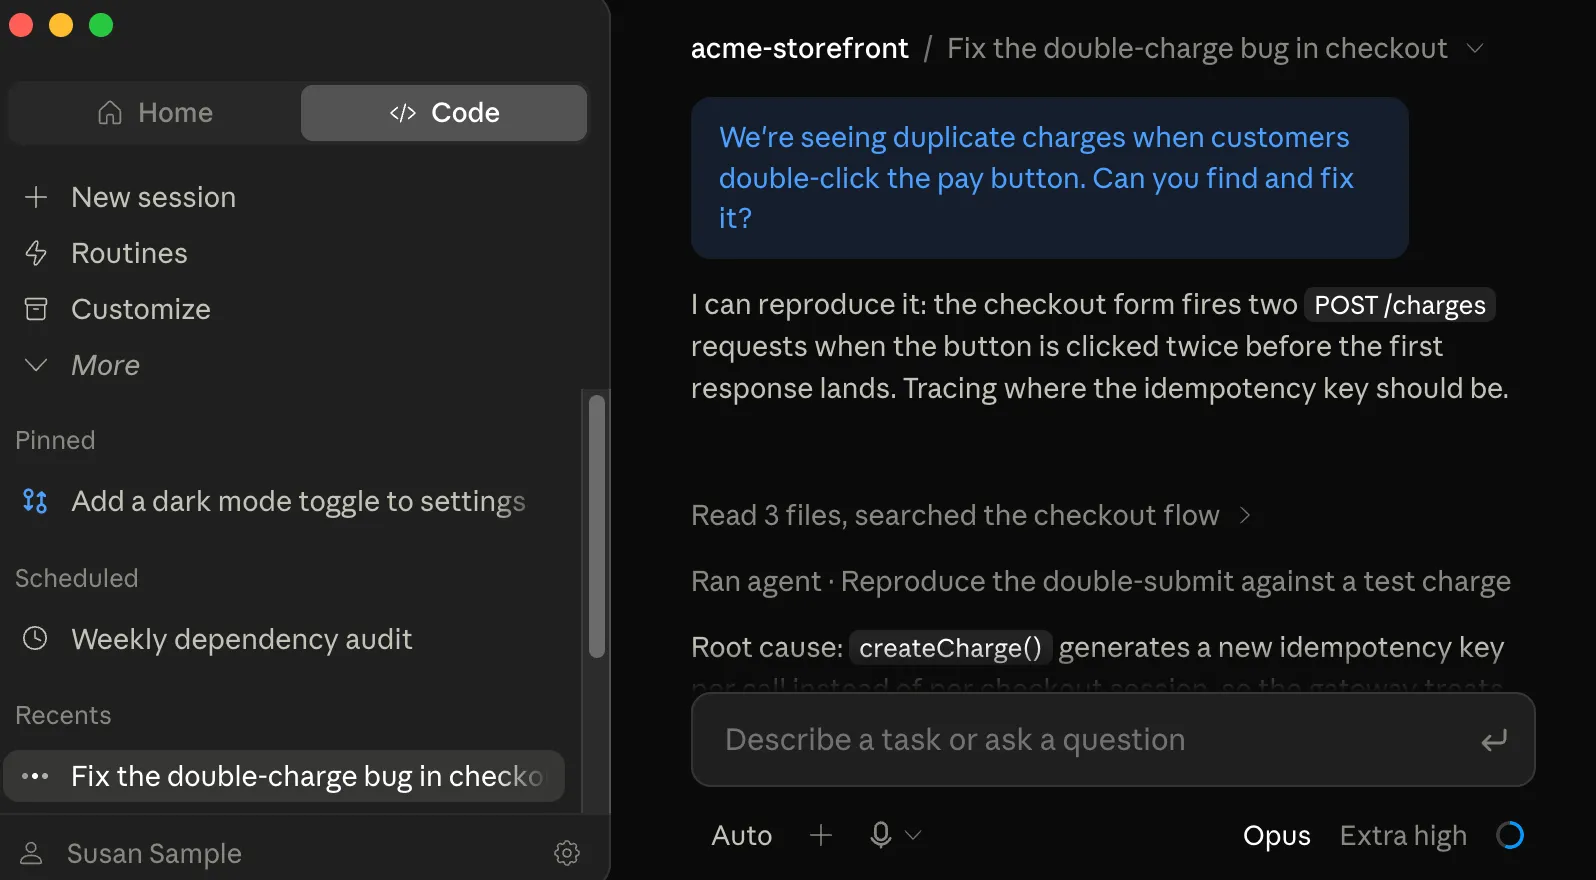
A Claude Code a repository-szintű munkavégzésre épül. A CLAUDE.md fájl a munkamenetek között is elérhetővé teszi a projektkonvenciókat, míg a Skills ismétlődő munkafolyamatokat és referenciaanyagokat tárol. Az alügynökök saját kontextusukban külön feladatokon dolgozhatnak, a dinamikus munkafolyamatok pedig a nagyobb feladatokat – például az auditokat vagy a migrációkat – több ügynök között oszthatják szét.
A hookok segítségével a fejlesztők szigorúbban szabályozhatják az ügynökök körüli eseményeket. Szerkesztés után futtathatnak teszteket vagy lintereket, végrehajtás előtt blokkolhatnak bizonyos parancsokat, vagy a munkafolyamat meghatározott pontjain szkripteket és egyéb eszközöket indíthatnak el. A Claude Code emellett támogatja a nyelvi szerver integrációját a szimbólumok közötti navigációhoz és az élő típushibák jelzéséhez, valamint az MCP-kapcsolatokat külső eszközök és adatokhoz.
A ellenőrzőpontok akkor hasznosak, amikor egy nagy változtatás rossz irányba kezd haladni. A Claude Code vissza tudja tekerni a nyomon követett szerkesztéseket és a beszélgetés állapotát egy korábbi pontra, ami segít különböző megközelítések tesztelésében vagy egy rossz változtatás utáni helyreállításban.
Az Opus 5.5 ára az API-díjak tekintetében is alacsonyabb, mint az Astraé: 4 dollár millió bemeneti tokenenként és 20 dollár millió kimeneti tokenenként, szemben az Astra 10, illetve 50 dollárjával. Az Anthropic szerint az Opus 5.5 feladatonkénti költségének körülbelül 40%-ával képes felvenni a versenyt az Astra Terminal-Bench teljesítményével, bár ez a költségösszehasonlítás az Anthropic saját tesztjein alapul.
A ChatGPT programozáshoz
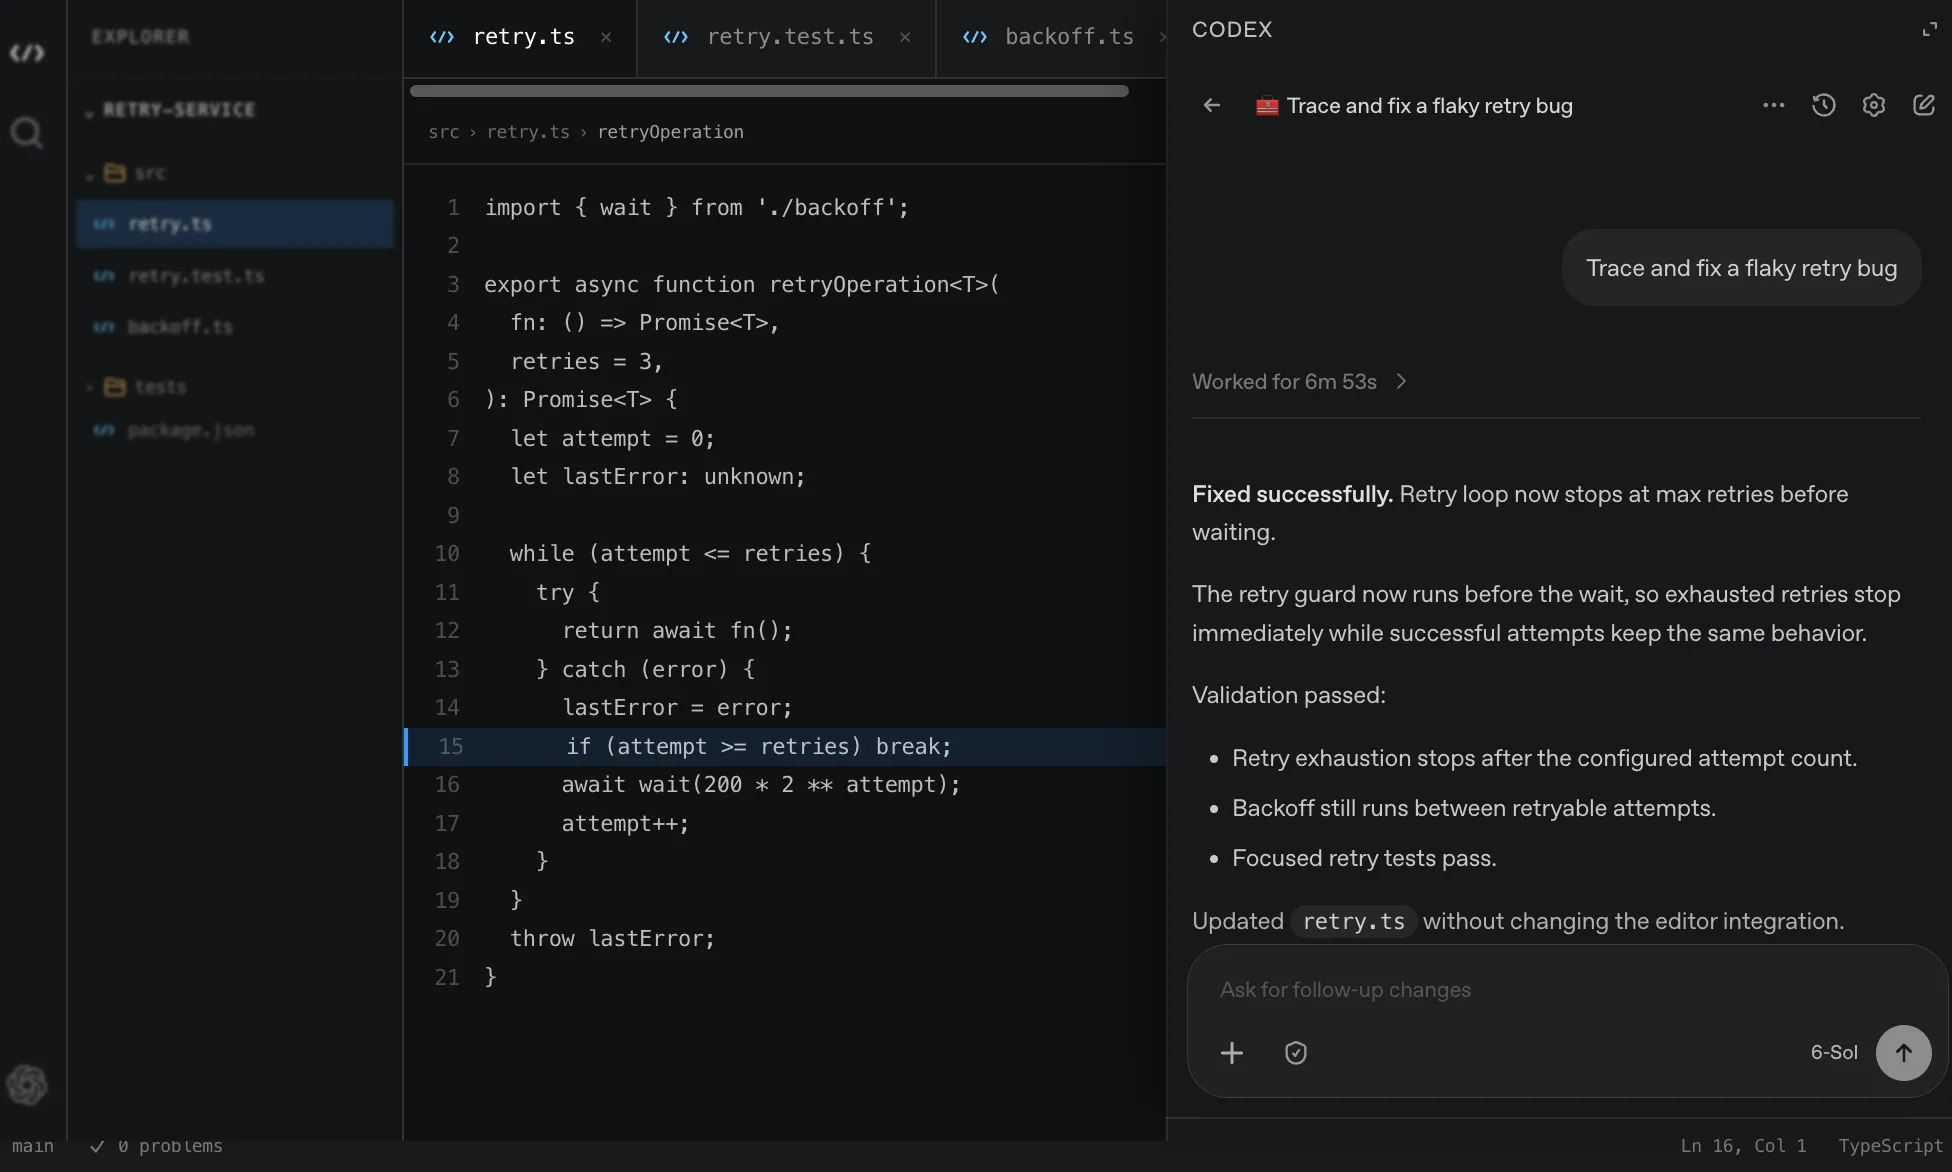
A Codex inkább az eszközök és környezetek közötti együttműködésre összpontosít. Asztali alkalmazáson, CLI-n, IDE-n és felhőn keresztül érhető el, míg a ChatGPT mobilalkalmazás Remote funkciója lehetővé teszi a fejlesztők számára, hogy egy másik gépen futó munkákat indítsanak el, irányítsanak, ellenőrizzék és szervezzék. A Remote emellett támogatja a munkafákat, a mellékbeszélgetéseket, a beágyazott felülvizsgálatot, a sorba állított parancsokat és a feladatirányítást is.
A célok a munkafolyamat másik hasznos elemei. A cél egy olyan eredményt jelöl ki a Codex számára, amelyre több lépésen keresztül törekednie kell, egyértelmű befejezési feltételekkel. Az OpenAI olyan feladatokhoz ajánlja őket, mint a függőségek áttelepítése, a teljesítményoptimalizálás, a megbízhatatlan tesztek kivizsgálása, a több lépésből álló refaktorálás és a hibakeresés, ahol a következő lépés attól függ, hogy a Codex mit talál.
Az Astra emellett megváltoztatja azt is, ahogyan a Codex kezeli a nagyon hosszú munkameneteket. Amikor a kontextusablak megtelik, a rendszer ablakok között is megőrizheti a jegyzeteket, miközben a korábbi üzenetek és az eszközök eredményei továbbra is kereshetőek maradnak. Ez lehetővé teszi a Codex számára, hogy egy régi követelményt, sikertelen javítást vagy teszt eredményt is előhívjon anélkül, hogy kizárólag egy tömörített összefoglalóra kellene támaszkodnia. Az OpenAI jelenleg kísérleti funkciónak minősíti ezt a szolgáltatást.
A Codexnek saját projektutasításai és újrafelhasználható Skills-jei is vannak, az OpenAI ügynök-stackje pedig most már támogatja az alügynököket és a felügyelt koordinációt. Ezzel részben megszűnt az a szerszámbeli különbség, amely korábban elválasztotta a két terméket.
Melyiket válasszuk?
Összességében a Claude Code előnyösebb a kódolás terén, különösen hosszú refaktorálások, migrációk, auditok és egyéb, nagy mennyiségű kódtárat igénylő feladatok esetében. Projektszabályai, hookjai, ellenőrzőpontjai, alügynökei és dinamikus munkafolyamatai révén a fejlesztőknek erős ellenőrzést biztosít a kód felett, míg az Opus 5.5 API-díjszabás alapján olcsóbb is, mint az Astra.
A Codex azoknak a fejlesztőknek felel meg jobban, akiknek fontosabb a mobilitás és a felhőalapú futtatás. Asztali, CLI, IDE, felhőalapú és távoli munkafolyamatai lehetővé teszik, hogy egy helyen kezdje el a munkát, majd máshol folytassa vagy ellenőrizze azt.
A hibakeresési munkafolyamatokhoz mindkettő jól működik. Ha azonban ma a kódolás a fő szempont a Claude és a ChatGPT közötti választásnál, akkor a Claude Code összességében jobb választásnak bizonyul.
Claude és ChatGPT írási feladatokhoz
A Claude és a ChatGPT egyaránt képes színvonalas vázlatot készíteni. A különbség akkor válik nyilvánvalóvá, amikor a feladatleírás hosszabbá válik, a forrásanyagok halmozódnak, és eljutsz az ötödik szerkesztési körhöz.
Az alábbiakban láthatja, miben nyer és miben marad el az egyes szolgáltatók:
Claude íráshoz
A Claude kiváló választás hosszú cikkek, összetett szerkesztési feladatok vagy bármilyen komoly szerkesztői előírásoknak alávetett feladat esetén.
Képes kezelni az olyan utasításokat, amelyeket a szerkesztők adnak: tartsd meg ezt a szerkezetet, őrizd meg ezeket a kifejezéseket, ne nyúlj ehhez a szakaszhoz, igazodj ehhez a stílushoz, használd ezeket a forrásokat, és vidd át ezeket a szabályokat a következő átdolgozásba is.
A ChatGPT íráshoz
A ChatGPT akkor ésszerűbb választás, ha a vázlat csak a munka egy része
Kutatást végezhet a témában, átnézheti a kiegészítő fájlokat, megírhatja a szöveget, átalakíthatja más formátumra, és elkészítheti a kapcsolódó vizuális elemeket anélkül, hogy több eszközt kellene összekapcsolnia. Használja ezt a megoldást, ha egy forrásból több kimenetet kell létrehoznia, például egy jelentést, egy e-mailt, egy prezentációt és egy rövidebb összefoglalót.
Melyiket válasszuk?
- Válassza a Claude-ot hosszú szövegek írásához és szerkesztéséhez, ha terjedelmes feladatot, rengeteg forrásanyagot vagy több körös átdolgozást kell elvégeznie.
- Válassza a ChatGPT-t, ha írásai rendszeresen kiterjednek kutatásra, elemzésekre, képekre, prezentációkra és egyéb formátumokra
Ha pedig íróként vagy szerkesztőként kell választanod a kettő közül, hagyd ki az általános prompt-tesztet. Adj mindkettőnek ugyanazt a bonyolult feladatot, amit a munkád során is megoldanál, majd nézd meg, melyik vázlat könnyíti meg a munkádat.
Olvassa el még: Claude-készségek az íráshoz
A Claude és a ChatGPT árai 2026-ban
A ChatGPT olcsóbb fizetős belépési ponttal rendelkezik. Az Egyesült Államokban a Go csomag havi 8 dollárba kerül, míg a Claude első fizetős egyéni csomagja a Pro, amely havi 20 dollárba kerül. A Claude emellett éves szinten 200 dollárért is kínálja a Pro csomagot, ami havi szinten körülbelül 17 dollárnak felel meg.
| Csomag | Claude | ChatGPT |
|---|---|---|
| Ingyenes | Ingyenes csomag elérhető | Ingyenes csomag elérhető |
| Fizetős belépés | Nincs | Go, 8 USD/hó az Egyesült Államokban |
| Standard egyéni | Pro, 20 USD/hó vagy 200 USD/év (tényleges havi díj: 17 USD) | Ráadásul 20 dollár/hó |
| Sokszor használó magánszemély | Max. 5x, 100 USD/hó; Max. 20x, 200 USD/hó | Pro 5x, 100 USD/hó; Pro 20x, 200 USD/hó |
| Csapat/vállalat | Standard: 20 USD/felhasználó/hó éves előfizetéssel vagy 25 USD havonta; Premium: 100 USD éves előfizetéssel vagy 125 USD havonta | Standard: 20 USD/felhasználó/hónap éves előfizetéssel vagy 25 USD havonta; Premium: 100 USD éves előfizetéssel vagy 125 USD havonta |
| A csapat mérete | 2–150 felhasználó | 2–200 felhasználó |
| Vállalati | 20 USD/felhasználó/hó, éves számlázással + használat az API-díjszabás szerint | Vegye fel a kapcsolatot az értékesítési osztállyal |
| API-modellek összehasonlítása | Opus 5. 5: 4 dollár bemenet / 20 dollár kimenet; Fable 5. 1: 10 dollár bemenet / 50 dollár kimenet 1 millió tokenenként | GPT-6 Astra: 10 dollár bemenet / 50 dollár kimenet 1 millió tokenenként |
| Gyorsítótárba mentett bevitel | 0,20 dollár 1 millió tokenenként | 1 dollár 1 millió tokenenként |
| A Cache írja | 5 dollár 1 millió tokenenként | 12,50 dollár 1 millió tokenenként |
Egyéni felhasználók számára a fő árkülönbség az alacsonyabb árkategóriában jelentkezik. Csapat szintjén a standard és a prémium felhasználói licenc ára megegyezik.
Az API-árak modelltől függően változnak. Az Opus 5.5 ára 4 dollár millió bemeneti tokenenként és 20 dollár millió kimeneti tokenenként. A GPT-6 Astra ára 10 dollár millió bemeneti tokenenként és 50 dollár millió kimeneti tokenenként. A gyorsítótár-olvasás ára az Opus 5.5 esetében 0,20 dollár millió tokenenként, az Astra esetében pedig 1 dollár.
Ez azonban nem jelenti azt, hogy a Claude az egész modellsorozatában olcsóbb lenne. A Fable 5.1 ára 10 dollár/50 dollár millió bemeneti/kimeneti tokenenként, míg a GPT-6 Sol ára 2 dollár/10 dollár, a GPT-6 Luna ára pedig 0,10 dollár/0,50 dollár. Az API költsége nagymértékben függ attól, hogy melyik modellt használja.
Fontos: Ezen modellek árai gyakran változnak, és a szolgáltatók rendszeresen módosítják a csomagok korlátait, a token-árak és a hozzáférési szinteket. Mielőtt egy modellt választana termelési célra, figyelje a legfrissebb árakkal kapcsolatos információkat.
A Claude és a ChatGPT használati korlátai 2026-ban
A használati korlátokat nehezebb összehasonlítani, mint a csomagárak, mivel egyik terméknél sincs egyetlen egyszerű felső határ. Az alábbiakban feltárjuk azokat a korlátokat, amelyekkel a Claude és a ChatGPT használata során találkozhatsz, beleértve a csevegést, a kódolást, a prémium modelleket és egyéb eszközöket.
A Claude használati korlátai
A Claude közös keretet használ a Claude, a Claude Desktop és az interaktív Claude Code alkalmazásokhoz. Az, hogy milyen gyorsan merül ki ez a keret, a beszélgetés hosszától, a csatolt fájloktól, a modellválasztástól, a funkcióktól és az érveléshez szükséges erőfeszítéstől függ. A Pro és a Max csomagoknál öt órás munkamenet-korlát és heti korlát is van, mindkettőt a Beállítások > Használat menüpontban követheted nyomon.
Egy részlet fontos, ha intenzíven használod a Claude csúcsmodelljeit. A Fable 5 és 5.1 nem tartozik a Pro vagy a standard Team-csomagok alapkeretébe, ezért ezek használata kezdettől fogva fizetős használati krediteket igényel. A Max és a premium Team-csomagokban a Fable benne van, de a modell a heti kereted akár 50%-át is felhasználhatja.
Az Anthropic 2026-ban többször is emelte a korlátokat. Májusban megduplázta a Claude Code ötórás korlátait a Pro, Max, Team és a felhasználóalapú Enterprise csomagok esetében, majd szeptemberben az Opus 5.5 bevezetésével ismét emelte az ötórás korlátokat. Az előfizetők emellett kapnak egy korlát-visszaállítást is, amelyet addig megőrizhetnek, amíg szükségük nem lesz rá.
A ChatGPT használati korlátai
A ChatGPT a korlátokat modellek és funkciók szerint osztja fel. A Free és a Go csomagok korlátlan napi szöveges csevegést tartalmaznak, míg a következtetés, a fájlfeltöltés, a képek, a hang és egyéb eszközök esetében külön korlátok vannak érvényben.
A magasabb kategóriájú modelleknek is megvannak a maguk korlátai. A 100 dolláros Pro-csomagban a GPT-6 Pro és a GPT-5.6 Sol Pro heti 50 üzenetből álló keretet oszt meg egymás között.
A Work és a Codex ismét más rendszert alkalmaz. Használatuk a modelltől, a feladat méretétől, az érveléshez szükséges erőfeszítéstől, a kontextustól és a használt eszközöktől függ. A hosszú kódolási vagy ügynöki feladatok több keretet használhatnak fel, mint a rövidek.
Hogyan kezelik a korlátokat a Claude és a ChatGPT?
Mindkét termék lehetővé teszi a gyakori felhasználók számára, hogy a csomagban szereplő keret kimerülése után is folytassák a használatot. A Claude a szokásos API-díjak szerint számlázott felhasználási krediteket kínál, míg a jogosult ChatGPT Plus és Pro felhasználók krediteket vásárolhatnak olyan támogatott funkciókhoz, mint a Work és a Codex.
A fő különbség a korlátok szervezésében rejlik. A Claude a fő termékei között egységesebb keretet alkalmaz, míg a ChatGPT a korlátokat a csevegésre, a prémium modellekre, a Workre, a Codexre, a Voice-ra és egyéb eszközökre osztja szét.
Mit mondanak a Redditorok a Claude-ról és a ChatGPT-ről
A legutóbbi Reddit-szálak nem jutnak egyértelmű döntésre egy adott eszköz mellett. A vélemények megosztottsága elsősorban a munkavégzéssel kapcsolatos: a Claude-ot inkább azért dicsérik, mert jobban megérti a promptban megfogalmazott feladatot, míg a ChatGPT-t azért értékelik, mert bizonyos munkafolyamatokban pontosabb szövegeket állít elő, és szélesebb körű mindennapi eszközöket kínál.
A Redditorok a Claude-ról
Egy ChatGPT-felhasználó, aki az Opus 5.5 miatt átállt a Claude-ra, Funny-Strawberry-168, így írta le:
Előfizettem a Claude-ra, mert a Codex-előfizetésem őszintén szólva már szinte használhatatlanná vált számomra, és ki akartam próbálni az Opust is. Őszintén lenyűgözött. Tényleg szinte varázslatosnak tűnik.
Folyamatosan észrevesz olyan dolgokat a kódban, amikről soha nem is kérdeztem, rámutat a lehetséges problémákra, megérti, hogyan kapcsolódnak azok ahhoz, amin éppen dolgozom, és még azt is felajánlja, hogy külön, egy másik munkakönyvtárban kijavítja őket. Szó szerint olvassa a gondolataimat, nem csak a parancsot követi. Olyan érzés, mintha valóban létrehozna egy mentális modellt a kódbázisról és mindenről, ami a feladat körül zajlik.
A Sonnet 3.5 óta időnként kipróbálom a Claude-ot, és ezekben a modellekben mindig van valami, amit nehéz leírni. A helyzetfelismerésük egyszerűen őrülten jó.
A GPT-modellek számomra mindig is kissé „kicsapongónak” és túlságosan a promptokra támaszkodónak tűntek.
Előfizettem a Claude-ra, mert a Codex-előfizetésem őszintén szólva számomra már szinte használhatatlanná vált, és ki akartam próbálni az Opust is. Őszintén lenyűgözött. Tényleg szinte varázslatosnak tűnik.
Folyamatosan észrevesz olyan dolgokat a kódban, amelyekről soha nem is kérdeztem, rámutat a lehetséges problémákra, megérti, hogy azok hogyan kapcsolódnak ahhoz, amin éppen dolgozom, és még azt is felajánlja, hogy külön, egy másik munkakörnyezetben kijavítja őket. Szó szerint olvas a gondolataimban, nem csak a parancsot követi. Olyan érzésem van, mintha valóban felépítene egy mentális modellt a kódbázisról és a feladat körül zajló mindenről.
A Sonnet 3.5 óta időnként kipróbálom a Claude-ot, és ezekben a modellekben mindig van valami, amit nehéz leírni. A helyzetfelismerésük egyszerűen őrülten jó.
A GPT-modellek számomra mindig is inkább „lobotómizáltnak” és túlságosan a promptok által vezéreltnek tűntek.
Hozzátették, hogy úgy tűnt, mintha a Claude a parancs követésén túl „mentális modellt építene a kódbázisról”. Ez összhangban áll a Claude-szálakban gyakran felmerülő témával: a felhasználók nagyra értékelik, hogy a modell minden lépés részletes leírása nélkül is észreveszi a függőségeket és a kapcsolódó problémákat.
Ez a dicséret azonban nem általános, még az r/ClaudeAI közösségen belül sem. Egy Reddit-felhasználó, aki a legújabb modelleket tesztelte, a következőket írta:
Úgy találom, hogy különböző dolgokra alkalmasak. Az Astra és a GPT 5,6 Sol írási teljesítménye kiemelkedő, ami a munkamenetem jelentős részét képezi. Jobban tartják magukat a márka arculatához és a specifikációkhoz. Az Opus 5,5 remek, de nem mondhatom, hogy értem a körülötte kialakult felhajtást. Lehet, hogy ez azért van, mert az én felhasználási esetem nem kapcsolódik a kódoláshoz.
Úgy találom, hogy különböző dolgokra jók. Az Astra és a GPT 5,6 Sol írási teljesítménye kiemelkedő, ami a munkamenetem jelentős részét képezi. Jobban tartják magukat a márka arculatához és a specifikációkhoz. Az Opus 5,5 remek, de nem mondhatom, hogy értem a körülötte kialakult felhajtást. Lehet, hogy ez azért van, mert az én felhasználási esetem nem kapcsolódik a kódoláshoz.
A ChatGPT-ről szóló Reddit-hozzászólások
A ChatGPT szélesebb eszköztára gyakran felmerül, amikor a felhasználók elmagyarázzák, miért tartják meg a szolgáltatást. Egy nemrégiben indult, a Claude-ról áttérő felhasználó által indított Reddit-szálban a salmanhameed13 nevű felhasználó a képszerkesztést hozta fel egyszerű példaként:
A ChatGPT valóban képes képet generálni és azt a beszélgetés során iteratív módon szerkeszteni.
A Claude megnézheti a feltöltött fotót, elemezheti, leírhatja, megírhatja a tökéletes képleírást stb. – de jelenleg még nem képes önállóan létrehozni a kész képet.
Ez valószínűleg a legegyszerűbb, 60 másodperces bemutató arról, hogy mire képes a ChatGPT, amit a Claude egyszerűen nem tud megcsinálni.
A ChatGPT valóban képes képet generálni és azt a beszélgetés során többszörösen szerkeszteni.
A Claude megnézheti a feltöltött fotót, elemezheti, leírhatja, megírhatja a tökéletes képleírást stb. – de jelenleg még nem képes önállóan létrehozni a kész képet.
Ez valószínűleg a legegyszerűbb, 60 másodperces bemutató arról, hogy mire képes a ChatGPT, amit a Claude egyszerűen nem tud megcsinálni.
A Claude ugyanazt a képet elemezheti és segíthet a prompt megírásában, de még mindig nem képes natívan előállítani a kész képet. Azok számára, akiknek a napja szöveges és vizuális munkák között oszlik meg, ez a hiányosság sokkal fontosabb, mint egy kis teljesítménybeli előny.
És vannak olyan felhasználók is, akik egyáltalán nem tekintik véglegesnek ezt a választást. Egy sokat vitatott összehasonlító fórumszálban Spontanous_cat így írta le a saját munkamenetét:
Az én bevált kombinációm az, hogy a munkát a Claude-dal végzem el, a ChatGPT-vel pedig kritizálom. Ezután a Claude-dal kijavítom. A Claude néha túlságosan is engedelmes lehet, de ennek ellenére a munkája elég jó. A ChatGPT pedig a tökéletes kritikus ehhez.
Az én bevált kombinációm az, hogy a munkát Claude-dal végzem el, a kritikát pedig a ChatGPT-vel. Ezután pedig Claude-dal javíttatom ki. Claude néha túl engedékeny lehet, de ennek ellenére a munkája elég jó. A ChatGPT pedig a tökéletes kritikus ehhez.
Ugyanebben a szálban más hozzászólók is hasonló megosztást írtak le a Claude Code és a Codex között: az egyiket a megvalósításhoz, a másikat pedig a hibakereséshez vagy az áttekintéshez használják.
Szerkesztői összefoglalás: A Reddit nem mutat egyértelmű konszenzust a Claude és a ChatGPT között. A Claude-felhasználók folyamatosan visszatérnek a kontextusra, az utasítások követésére és a mélyebb munkavégzésre. A ChatGPT-felhasználók pedig a képekre, a kutatásra, a multimodális eszközökre és azokra az esetekre hivatkoznak, amikor a jelenlegi modellek szigorúbb utasításokat követnek. A gyakori felhasználók körében pedig annyira elterjedt a két rendszer párhuzamos használata, hogy már önálló munkafolyamatnak számít.
Ezt azonban inkább a felhasználói hangulat tükrének tekintsük. A modellek és korlátaik túl gyorsan változnak ahhoz, hogy egy Reddit-szál tartós referenciaértéknek szolgálhasson.
Hogyan válasszunk a Claude és a ChatGPT között?
Ezen a ponton a választás már nem annyira arról szól, hogy melyik modell teljesít jobban a teljesítménymérő tesztekben, hanem inkább arról, hogy milyen típusú feladatok töltik ki a napod nagy részét.
| A prioritásod | Melyik a megfelelőbb? | Miért |
|---|---|---|
| Hosszú programozási munkamenetek, refaktorálások, migrációk vagy nagy mennyiségű kódtárat igénylő feladatok | Claude | A Claude Code projekt szabályok, hookok, ellenőrzőpontok, alügynökök és dinamikus munkafolyamatok segítségével hatékony ellenőrzést biztosít a hosszú távú fejlesztési munkák felett |
| Kutatás, fájlok, képek, programozás, hangfelvételek és egyéb feladatok egy helyen | ChatGPT | A ChatGPT egy munkaterületen belül szélesebb körű feladatokat lát el, beleértve a kutatást, a fájlelemzést, a képalkotást, a kódolást és a kapcsolódó eszközöket |
| Hosszú dokumentumok, nagy mennyiségű szerkesztés vagy részletes írási briefek | Claude | A Claude hosszabb munkamenetek során is jól megőrzi a forrásanyagot, a szerkesztési szabályokat és a javítási utasításokat |
| Strukturált szövegek, amelyek prezentációkká, képekké, elemzésekké vagy más formátumokká is alakíthatók | ChatGPT | A ChatGPT megkönnyíti az átállást a vázlatírásból más formátumokba anélkül, hogy eszközt kellene váltani |
| Felhőalapú végrehajtás, mobil hozzáférés, valamint váltás asztali környezet, parancssor (CLI), integrált fejlesztői környezet (IDE) és távoli kódolási munkafolyamatok között | ChatGPT | A Codex úgy lett kialakítva, hogy különböző eszközökön és környezetekben egyaránt működjön |
| A legolcsóbb fizetős belépési lehetőség | ChatGPT Go | A ChatGPT Go ára az Egyesült Államokban havi 8 dollártól kezdődik, míg a Claude Pro ára havi 20 dollártól, illetve éves előfizetés esetén havi körülbelül 17 dollártól kezdődik. |
| Rendszeresen használjuk a Claude-ot a mélyreható munkához, a ChatGPT-t pedig a szélesebb körű eszközkészletéért | Mindkettő | Mindkettő megtartása akkor lehet ésszerű, ha a különbségek elég gyakran jelentkeznek a valós munkamenetben ahhoz, hogy két előfizetést indokoljanak |
Ha még mindig bizonytalan vagy, először teszteld a valódi munkádat. Néhány napon át futtasd le ugyanazokat a dokumentumokat, kódolási feladatokat, kutatási kérdéseket és mindennapi parancsokat mindkét ingyenes szolgáltatási szinten. A teljesítménybeli különbségek túlságosan függnek a beállításoktól és a tesztelési körülményektől ahhoz, hogy ez alapján dönts.
Ha az egyik eszköz szinte mindent elvégzi, amit rendszeresen csinálsz, akkor alig van okod fizetni a másikért. Csak akkor érdemes mindkettőt megtartani, ha a köztük lévő különbségek ismétlődően megjelennek a tényleges munkamenetedben.
További információk: A ChatGPT alkalmazási területei
Hogyan váltsunk át a ChatGPT-ről a Claude-ra
A beállítás kevesebb munkát igényel, mint korábban. A Claude-ban most már beépített funkcióval lehet memóriát átvinni egy másik AI-asszisztensből.
- Tesztelje le a Claude-ot, mielőtt lemondaná a ChatGPT-t. Először végezze el vele a szokásos munkáját, különösen azokat a feladatokat, amelyek elég fontosak ahhoz, hogy indokolják a fizetős előfizetést.
- Töltsd át azokat a kontextuselemeket, amelyeket a Claude-nak meg kell jegyeznie. Lépj a Claude > Beállítások > Memória > Importálás indítása menüpontba. Illeszd be a jelenlegi AI-asszisztensedből exportált memóriát, és a Claude kivonja a releváns részleteket memóriabejegyzésekbe, amelyeket áttekinthetsz. Ezzel átkerülnek az emlékek és a beállítások, de a teljes beszélgetési előzmények nem kerülnek át.
- Exportálja a ChatGPT-adatait archívum létrehozásához. A megfelelő személyes csomagok esetében lépjen a Beállítások > Adatkezelés > Adatok exportálása menüpontba. A letöltött ZIP-fájl tartalmazza a csevegési előzményeket és egyéb fiókadatokat. Az önkiszolgáló exportálás nem érhető el Business, Enterprise vagy Healthcare munkaterületeken.
- Helyezze át az aktív munkáit a Claude Projectsbe. Töltse fel a még mindig használt dokumentumokat, fájlokat vagy kódokat, majd hozza létre újra a fontos szabályokat projektutasításokként. A Claude emellett profilutasításokat is kínál a fiók egészére vonatkozó beállításokhoz, valamint Skills funkciókat az újrafelhasználható viselkedésmintákhoz és munkafolyamatokhoz.
- Figyelj a korlátokra az első, nagy terhelésű héten! A Claude a Beállítások > Használat menüpont alatt jeleníti meg a felhasználást. A fizető felhasználók bekapcsolhatják a használati krediteket is, és így a csomagban szereplő keret kimerülése után is folytathatják a munkát; a többletfelhasználást a szokásos API-díjak szerint számlázzák.
- Csak akkor mondd fel, ha a Claude bebizonyítja, hogy valódi munkára is alkalmas. A ChatGPT-előfizetés felmondásáról szóló útmutatónk bemutatja a számlázási lépéseket. Az ingyenes ChatGPT-fiók megtartása továbbra is értelmes lehet az alapvető natív képalkotáshoz. A Claude képes elemezni a feltöltött képeket, és táblázatokat, diagramokat és interaktív vizuális elemeket készíteni, de még mindig nem generál fényképeket vagy illusztrációkat.
Megjegyzés: Ha még mindig szélesebb körben szeretne összehasonlítani, a Perplexity és a ChatGPT összehasonlítása a keresés-orientált alternatívát tárgyalja, míg az AI-keresőmotorokról szóló útmutatónk a kategória szélesebb körét vizsgálja.
Hogyan illeszkedik a ClickUp a Claude és a ChatGPT közötti döntésbe?
A Claude és a ChatGPT is jól teljesít a saját területén. A Claude hosszú dokumentumok és kódbázisok elemzésére képes. A ChatGPT képes kutatni, képeket generálni, weboldalakat készíteni, kódot írni, és számos különböző eszköz között váltani.
De az ezekkel az eszközökkel kapott eredmények gyakran kihasználatlanul maradnak: nincs hová tárolni őket, vagy – ami még rosszabb – nincs mód azok alapján cselekedni.
Vegyünk egy egyszerű kérdést, például: „Mi történt a Phoenix projekttel?” A hasznos válasz a legfrissebb feladatoktól, felelősöktől, megjegyzésektől, döntésektől, függőségektől, határidőktől és változásoktól függ. A Claude és a ChatGPT ezek egy részéhez hozzáférhet a csatlakoztatott eszközökön keresztül, de a projektnek még mindig szüksége van egy rendszerre, amely naprakészen tartja ezt a kontextust.
Ilyenkor érdemes megismerkedni egy olyan platformmal, mint a ClickUp, amely összefogja az összes munkaprojektedet, és mindezt kontextusfüggő mesterséges intelligenciával egészíti ki.
Brain²: A munkádra épülő mesterséges intelligencia
A Brain² a ClickUp kontextustudatos, munkavégzésre szánt mesterséges intelligenciája. Összefoglalja a projekteket, tartalomvázlatokat készít, témákat kutat, adatokat elemz, valamint feladatokat és dokumentumokat hoz létre. Ezen túlmenően most már interaktív prototípusokat, irányítópultokat, diavetítéseket, képeket, videókat és egyéb eszközöket is készít.
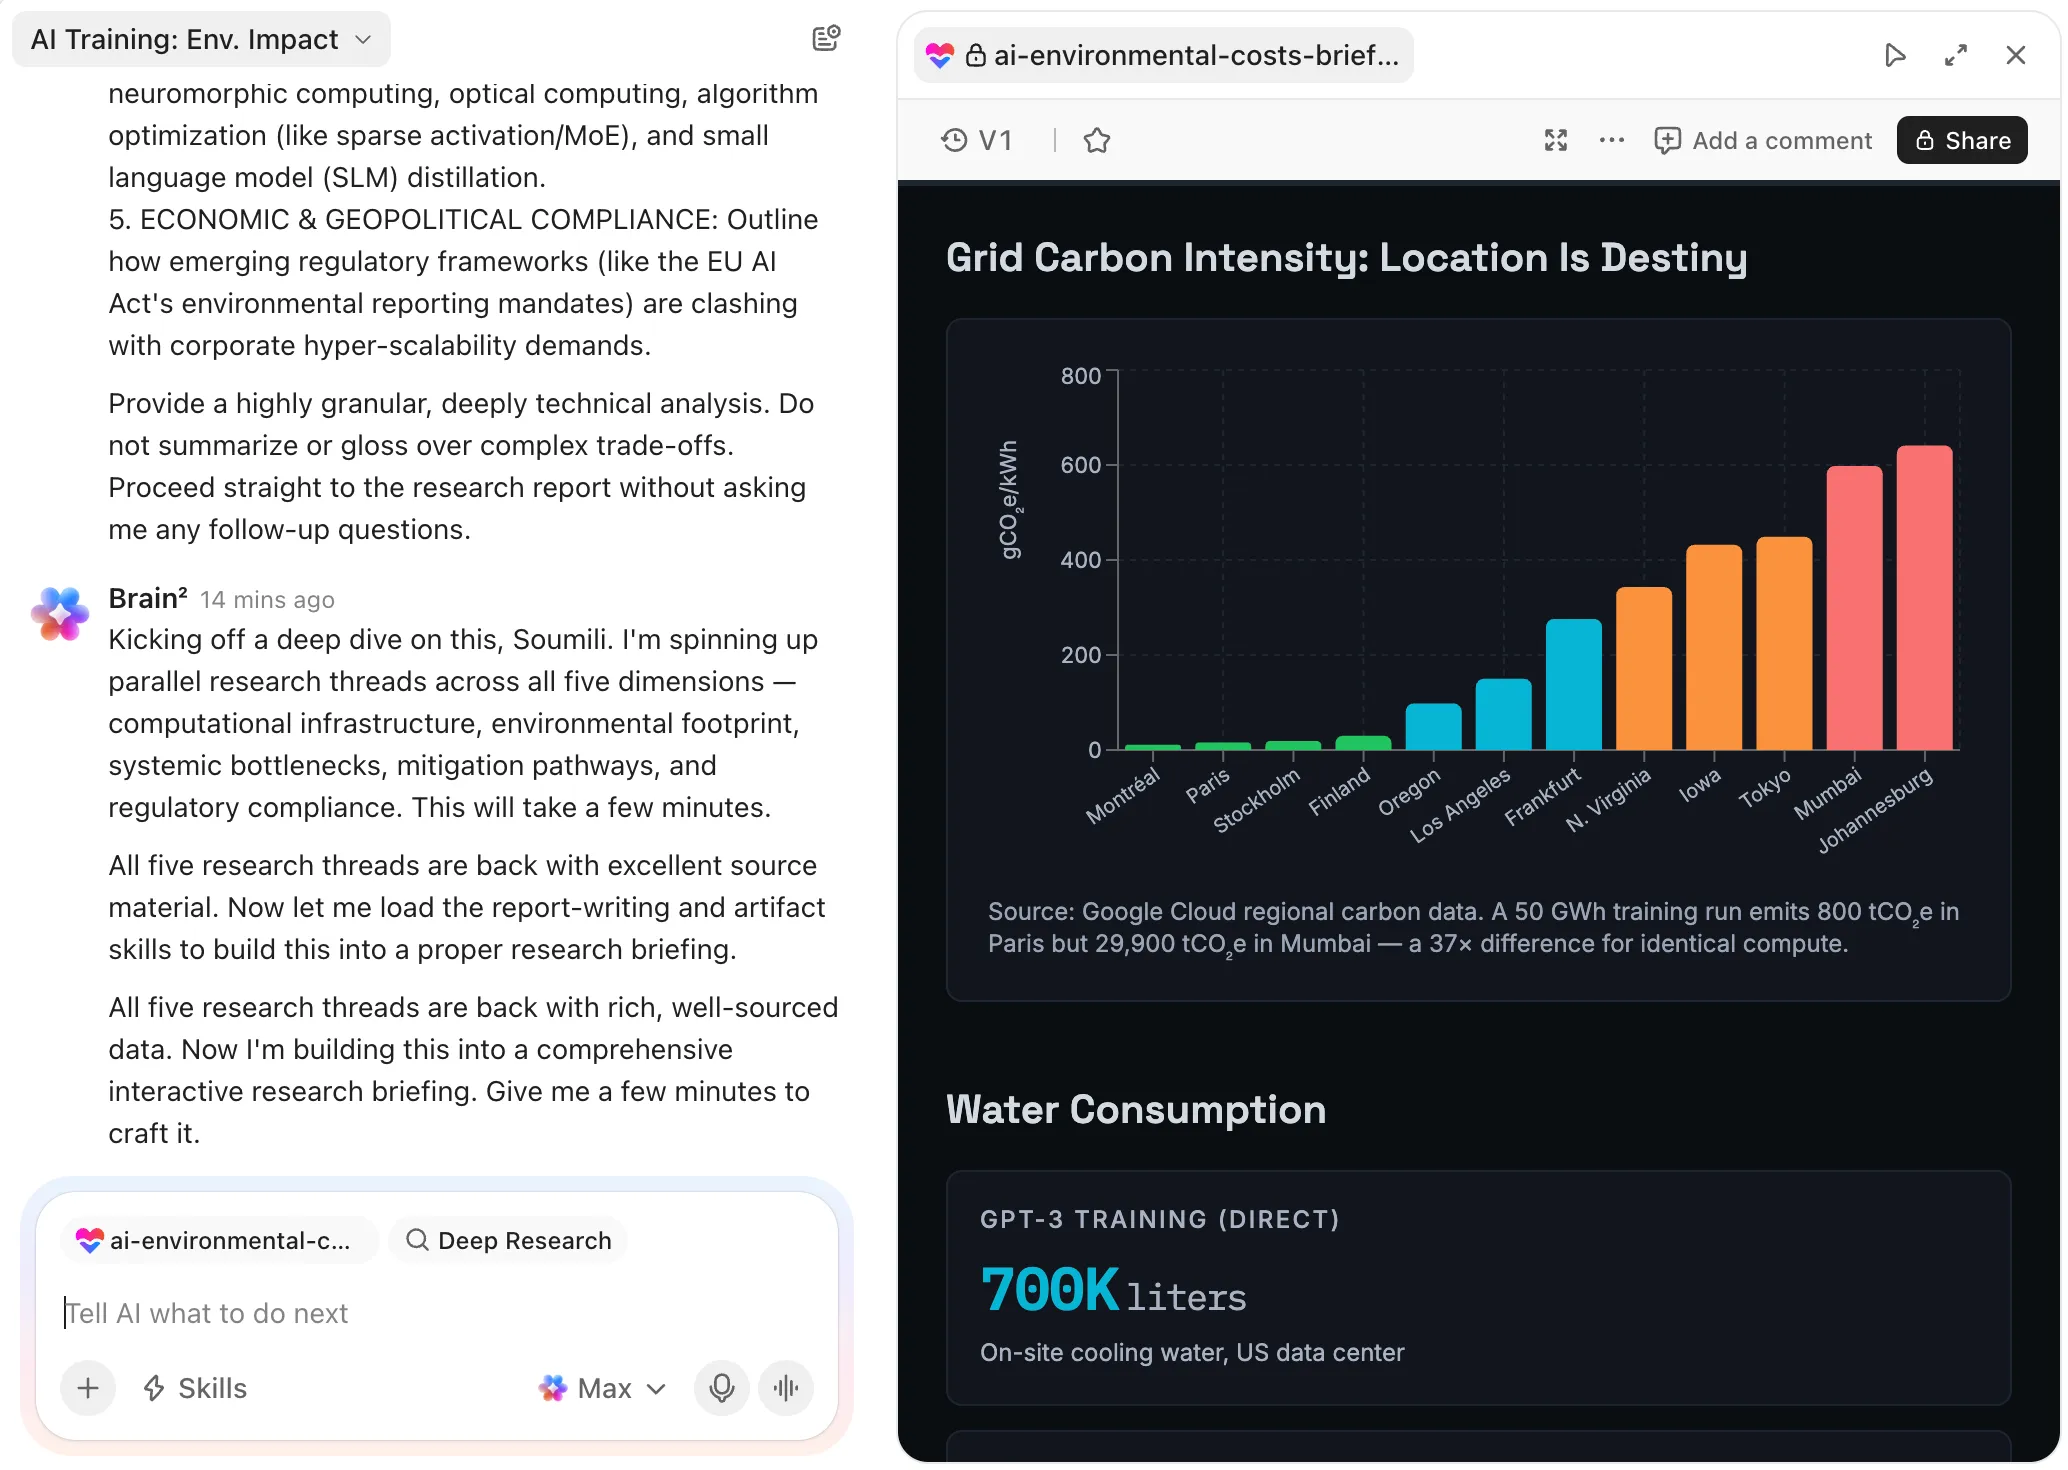
Ami igazán megkülönbözteti a szolgáltatást, az a kimenetek mögötti kontextus. A Brain² a Workspace-ben már meglévő feladatok, dokumentumok, csevegések, döntések, felelősök, akadályok és frissítések alapján tud dolgozni, így nem kell minden egyes parancsban újra felépítened ezt a kontextust. Ha a válasz máshol található, a ClickUp Enterprise Search képes átkutatni a kapcsolódó eszközöket, például a Google Drive-ot, a Figma-t, a GitHub-ot és a Gmail-t.
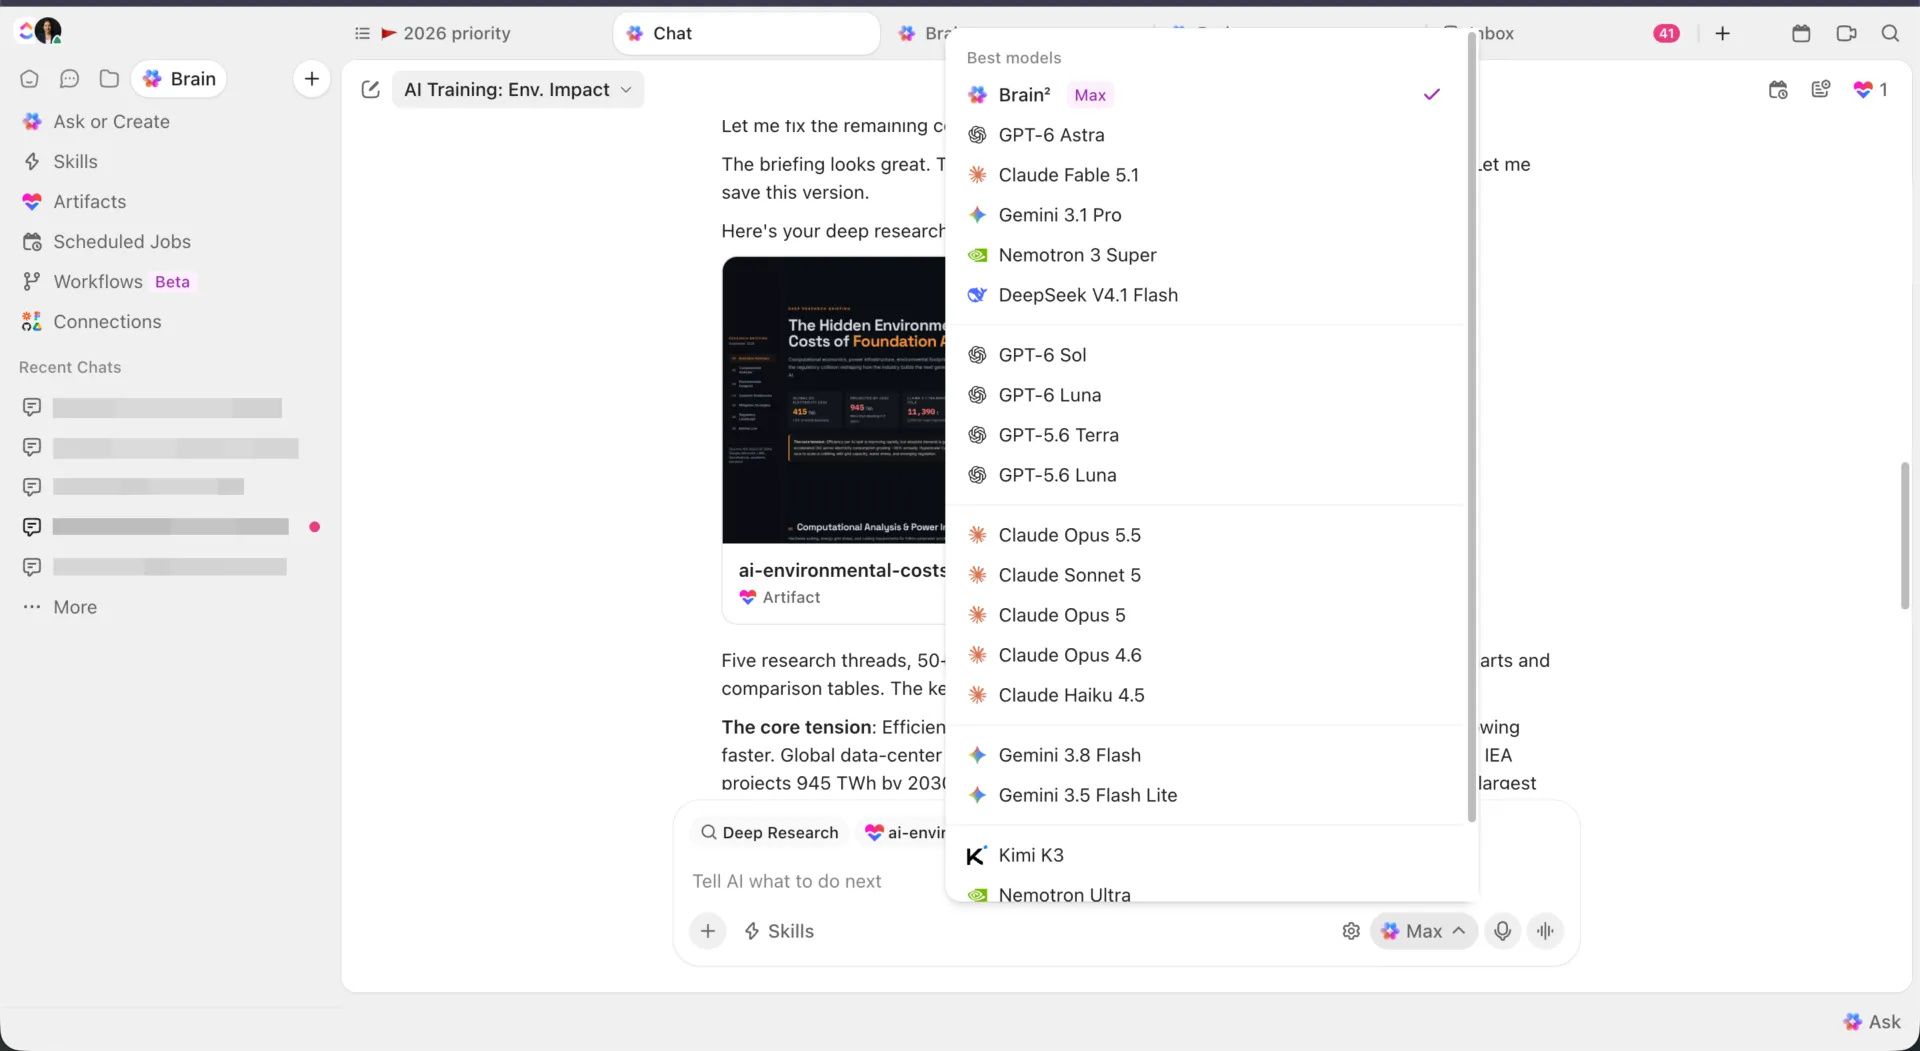
A Brain² emellett egy helyen biztosítja a csapatok számára az OpenAI, az Anthropic, a Google és mások legkorszerűbb modelljeihez való hozzáférést. A Claude, a GPT-modellek, a Gemini és más modellek között válthat úgy, hogy közben megőrzi a munkakörnyezetet, anélkül, hogy külön előfizetéseket kellene fenntartania csak azért, hogy a modellek családjai között válthasson.
ClickUp Super Agents: A kontextus átalakítása folyamatos munkává
A ClickUp Super Agents még tovább viszi ezt a közös kontextust. Ezek az AI-csapattársak több lépésből álló munkafolyamatokat futtathatnak az általad hozzáférhetővé tett eszközök és adatok felhasználásával, kiváltó eseményekkel, memóriával és a kritikus műveletekhez szükséges emberi jóváhagyással.
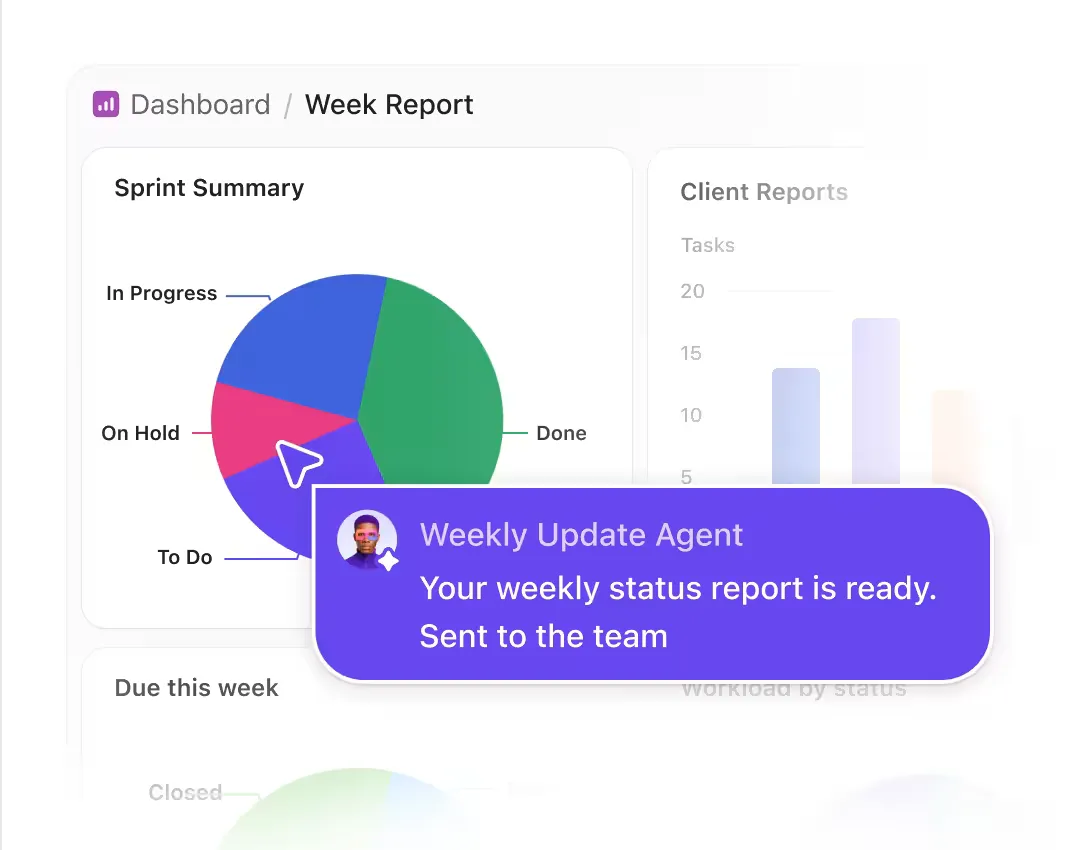
Egy projektügynök például kutathat egy problémáról, jelölheti a lemaradó munkákat, frissítheti a feladatokat, vagy értesítheti a megfelelő személyeket anélkül, hogy valakinek minden lépésnél újra fel kellene építenie a kontextust. Sőt, a csapatok természetes nyelvű szerkesztő segítségével saját ügynököket hozhatnak létre, vagy egy előre elkészített ügynök-sablonból indulhatnak ki.
Codegen by ClickUp: A mérnöki kontextus beépítése a megvalósításba
A szoftverfejlesztő csapatok számára a ClickUp Codegen összekapcsolja a mérnöki feladatot az azt követő kóddal.
Ha feladatot rendelünk a Codegen Agenthez, az a feladatleírás, a kapcsolódó dokumentumok, az elfogadási kritériumok, a függőségek és a munkához már csatolt megbeszélések alapján tud dolgozni. A csapatok @említéssel is felhívhatják az ügynök figyelmét a későbbi változtatásokra, vagy aktiválhatják azt, amikor egy feladat elér egy bizonyos állapotot. A Codegen mindezt elvégzi, míg az ember felel a felülvizsgálatokért és a kapott kód összevonásáért.
Útmutató: Amikor egy önálló AI-asszisztensről áttérsz a csapatodra épülő Work AI-ra, a legnagyobb változás a folytonosság. Az AI képes a megosztott projektek, döntések és felelősök alapján dolgozni, majd a csapat növekedésével segíteni abban, hogy ezt a kontextust a következő feladattá, megbízássá vagy munkafolyamattá alakítsa.
Legalkalmasabb: Azok a csapatok, amelyek már a ClickUp-ban kezelik a projekteket, dokumentumokat, döntéseket és az együttműködést, és szeretnék, ha az AI kérdésekre válaszolna, feladatokat hozna létre, és a vállalat közös kontextusára alapozva cselekedne anélkül, hogy azt minden egyes parancsban újra fel kellene építeni.
Hagyja ki, ha: Főként önálló íráshoz, kutatáshoz, programozáshoz vagy képalkotáshoz szüksége van egy személyes AI-asszisztensre, és nincs szüksége egy megosztott rendszerre az ezekből származó eredmények kezeléséhez.
Nem kell mindenben egyetlen mesterséges intelligenciára támaszkodnia
A legtöbb ember számára a Claude és a ChatGPT közötti választás a munkájuk jellegétől függ.
A Claude jobban teljesít a hosszú, kontextusigényes feladatoknál, mint például a nagy kódbázisok, a sűrű szövegű dokumentumok és azok a feladatleírások, amelyek több körös átdolgozáson kell, hogy átmenjenek. A ChatGPT egy helyen több területet fed le, a kutatástól és a képektől kezdve a hangfeladatokig és az ütemezett feladatokig, és a bevezetése olcsóbb.
Egyik előny sem állandó. Mindkét vállalat néhány havonta új modelleket dob piacra, és az a különbség, amely ma a választásodat meghatározza, a következő kiadásra már megszűnhet. Ha saját munkádat teszteled az eszközökön, az többet árul el neked, mint bármelyik teljesítménymérési táblázat, beleértve a cikkben szereplőket is.
Ha a csapatod végül mindkettőt használja, a nehezebb feladat az lesz, hogy rendszerezve tartsd a velük kapcsolatos munkát: a feladatokat, döntéseket és fájlokat, amelyekhez az egyes válaszok kapcsolódnak. A ClickUp egy helyet biztosít ehhez a munkához, ahol a Claude, a GPT és a Gemini modellek is elérhetők.
Gyakran feltett kérdések a Claude és a ChatGPT összehasonlításáról
Megakadályozhatom, hogy a Claude-dal vagy a ChatGPT-vel folytatott beszélgetéseim bekerüljenek a modell betanításába?
Igen, személyes fiókok esetén mindkét szolgáltatás lehetővé teszi ennek szabályozását. A ChatGPT-ben a Beállítások > Adatkezelés menüpont alatt kapcsolja ki a „Modell javítása mindenki számára” opciót. Az új beszélgetéseket nem fogják felhasználni az OpenAI modelljeinek betanítására, de továbbra is megmaradhatnak a történetében. Ha visszajelzést küld egy válaszra, a kapcsolódó beszélgetést továbbra is felhasználhatják a betanításhoz. A Claude-nál is található egy hasonló modelljavítási beállítás az adatvédelmi beállítások között. Ennek kikapcsolásával megakadályozhatod, hogy az új csevegéseket és kódolási munkameneteket a jövőbeli modelltanítási futtatások során felhasználják. Az Anthropic kivételeket jelöl meg a biztonsági felülvizsgálatra kijelölt beszélgetések, illetve az általad kifejezetten megosztásra választott adatok esetében. A vállalati fiókok esetében az alapértelmezett beállítások eltérőek. Az OpenAI alapértelmezés szerint nem használja a ChatGPT Business, Enterprise, Edu, Healthcare vagy API adatait a modelltanításhoz, és az Anthropic ugyanezt állítja a Claude for Work és annak API-járól is.
A Claude és a ChatGPT megjegyzi-e az információkat a beszélgetések között?
Igen, bár egyik sem emlékszik minden apró részletre, amit valaha megosztottál velük. A ChatGPT Memory funkció a korábbi csevegésekre, a mentett információkra, a fájlokra és a csatlakoztatott alkalmazásokra támaszkodhat, amennyiben ezek a funkciók elérhetők és engedélyezve vannak. Hogy mire tud hivatkozni, az a csomagtól, a régiótól és a munkaterület beállításaitól függ. A Claude is képes memóriát építeni a korábbi csevegésekből. A memória jelenleg alapértelmezés szerint be van kapcsolva a Free, Pro és Max fiókoknál, míg a Team és Enterprise fiókok tulajdonosai maguk szabályozzák, hogy elérhető legyen-e a munkaterületükön. A Claude emellett külön memóriaterületeket tart fenn az egyes projektek számára.
Használhatom a Claude-ot vagy a ChatGPT-t anélkül, hogy a beszélgetést a memóriába menteném?
Igen. A ChatGPT ideiglenes csevegése nem jelenik meg a csevegési előzményekben, nem hoz létre és nem frissít emlékeket, és nem edzi az OpenAI modelljeit. Az OpenAI biztonsági okokból legfeljebb 30 napig megőrizhet egy másolatot. A Claude rendelkezik inkognitó csevegésekkel, amelyek nem kerülnek be a csevegési előzményekbe, sem a Claude memóriájába. Ne feledje, hogy a Team és Enterprise csomagokban az inkognitó csevegések továbbra is megjelenhetnek a szervezeti adatok exportjában, és a szervezet adatmegőrzési irányelveinek hatálya alá tartoznak.
Használhatom a hangvezérlést, a kamera- vagy a képernyőmegosztást bármelyik asszisztensnél?
Mindkettő támogatja a hangalapú beszélgetéseket. A Claude Voice elérhető a Free, Pro, Max, Team és Enterprise csomagokban mobilon, asztali gépen és a weben egyaránt. Beszélgetés közben webes keresést és kapcsolódó eszközöket is használhat, például a Gmailt, a Google Naptárat, a Google Dokumentumokat és a Slacket. A ChatGPT jelenleg több hangmóddal is rendelkezik. A Live természetes beszédes beszélgetéseket támogat, de nem támogatja a videó- vagy képernyőmegosztást. A jogosult előfizetők iOS-en vagy Androidon átválthatnak Advanced módra, ha élő videóra vagy képernyőmegosztásra van szükségük. Ha a kamera- vagy képernyőmegosztás fontos a munkamenetedben, a választás előtt ellenőrizd, hogy a csomagod és a készüléked melyik ChatGPT Voice módot támogatja.
A hirdetett kontextusablak mérete megegyezik-e azzal a szövegmennyiséggel, amelyet feltölthetek?
Nem. A kontextusablak az az információmennyiség, amellyel a modell egyszerre tud dolgozni. A modelltől függően ez a keret magában foglalhatja a felhasználó parancsát, a beszélgetési előzményeket, az eszköz eredményeit, az érvelési tokeneket és a modell válaszát. Ez nem azonos a fájlfeltöltési korláttal. Ez az érték attól is függhet, hogy hol használja a modellt. A Claude például különböző kontextusablak-adatokat tesz közzé a Chat, a Claude Code és a Cowork esetében. Az OpenAI szintén elkülöníti a teljes kontextust a felhasználható bemenettől bizonyos ChatGPT-módokban. Például a manuálisan kiválasztott „Thinking” mód esetében a 256K-s teljes ablakot 128K bemenetnek és legfeljebb 128K kimenetnek írja le.
Ez a munkától függ. A Claude a jobb választás hosszú programozási munkákhoz, nagy dokumentumokhoz és olyan írási feladatokhoz, amelyek részletes utasításokat követnek és többszöri átdolgozást igényelnek. A ChatGPT a jobb választás, ha egyetlen asszisztenst szeretnél kutatáshoz, fájlelemzéshez, képgeneráláshoz, hangfelismeréshez és kódoláshoz, ráadásul az Egyesült Államokban a Go-csomaggal havi 8 dolláros áron elérhető, ami olcsóbb belépési pontot jelent. A teljesítményteszt-eredmények nem döntik el a kérdést, mivel az Anthropic és az OpenAI különböző beállítások mellett tesztelik egymás modelljeit. Végezz el ugyanazokat a valós feladatokat mindkét ingyenes csomaggal néhány napon át, és válaszd azt, amelyikkel több időt takaríthatsz meg.