
Projekty trénování AI málokdy selhávají na úrovni modelu. Problémy nastávají, když jsou experimenty, dokumentace a informace pro zainteresované strany roztříštěné mezi příliš mnoha nástroji.
Tento průvodce vás provede trénováním modelů pomocí Databricks DBRX – modelu LLM, který je až dvakrát výpočetně efektivnější než jiné přední modely – a zároveň vám pomůže udržet související práci přehledně uspořádanou v ClickUp.
Od nastavení a doladění až po dokumentaci a aktualizace napříč týmy uvidíte, jak jediný sjednocený pracovní prostor pomáhá eliminovat roztříštěnost kontextu a udržuje váš tým soustředěný na tvorbu, nikoli na hledání. 🛠
Co je DBRX?
DBRX je výkonný open-source model s velkým jazykovým modelem (LLM), navržený speciálně pro trénování a inferenci podnikových modelů umělé inteligence. Jelikož se jedná o open-source projekt pod licencí Databricks Open Model License, má váš tým plný přístup k váhám a architektuře modelu, což vám umožňuje jej kontrolovat, upravovat a nasazovat podle vlastních potřeb.
K dispozici jsou dvě varianty: DBRX Base pro hloubkové předtrénování a DBRX Instruct pro úkoly typu „out-of-the-box“, při nichž model následuje pokyny.
Architektura DBRX a návrh typu „mixture-of-experts“
DBRX řeší úkoly pomocí architektury Mixture-of-Experts (MoE). Na rozdíl od tradičních velkých jazykových modelů, které při každém výpočtu využívají všechny své miliardy parametrů, DBRX pro daný úkol aktivuje pouze zlomek svých celkových parametrů (nejrelevantnější experty).
Představte si to jako tým specializovaných odborníků; místo toho, aby se všichni zabývali každým problémem, systém inteligentně přiřazuje každý úkol k nejvhodnějším parametrům.
To nejen zkracuje dobu odezvy, ale také přináší špičkový výkon a výsledky a zároveň výrazně snižuje výpočetní náklady.
Zde je stručný přehled jeho klíčových specifikací:
- Celkový počet parametrů: 132 miliard napříč všemi experty
- Aktivní parametry: 36B na jeden průchod vpřed
- Počet expertů: celkem 16 (směrování MoE Top-4), z toho 4 aktivní pro každý daný token
- Okno kontextu: 32 000 tokenů
Specifikace trénovacích dat a tokenů DBRX
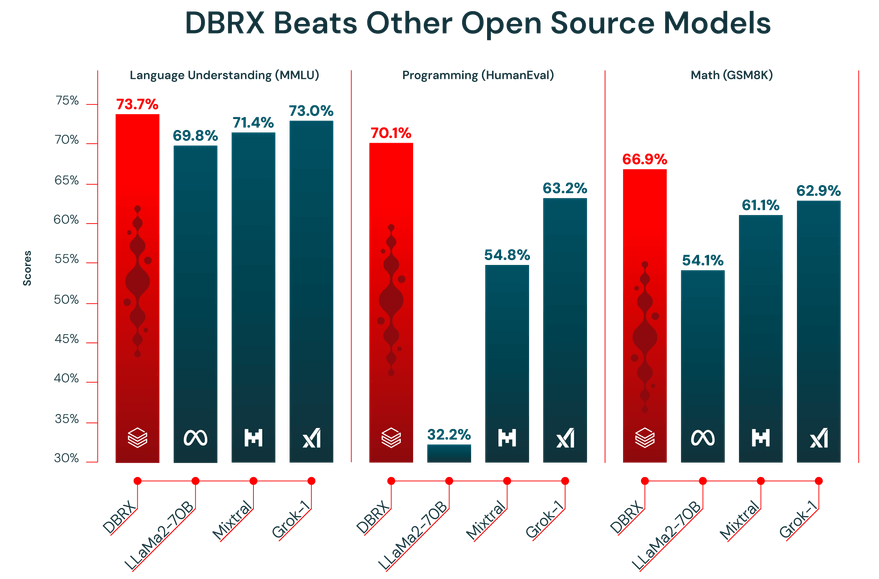
Výkon modelu LLM závisí na kvalitě dat, na kterých byl trénován. DBRX byl předem trénován na obrovském datovém souboru o velikosti 12 bilionů tokenů, který tým Databricks pečlivě sestavil pomocí svých pokročilých nástrojů pro zpracování dat. Právě proto dosáhl vynikajících výsledků v odvětvových benchmarkových testech.
DBRX navíc disponuje kontextovým oknem o velikosti 32 000 tokenů. To je množství textu, které model dokáže zpracovat najednou. Velké kontextové okno je velmi užitečné pro složité úkoly, jako je shrnutí dlouhých zpráv, prohledávání rozsáhlých právních dokumentů nebo vytváření pokročilých systémů RAG (retrieval-augmented generation), protože umožňuje modelu zachovat kontext bez zkracování nebo zapomínání informací.
🎥 Podívejte se na toto video a zjistěte, jak může efektivní koordinace projektů proměnit váš pracovní postup při trénování AI a odstranit potíže spojené s přepínáním mezi nesourodými nástroji. 👇🏽
Jak získat přístup k DBRX a jak jej nastavit
DBRX nabízí dvě hlavní možnosti přístupu, z nichž obě poskytují plný přístup k váhám modelů za výhodných komerčních podmínek. Pro maximální flexibilitu můžete využít Hugging Face, nebo k nim přistupovat přímo přes Databricks a získat tak integrovanější zážitek.
Přístup k DBRX získáte přes Hugging Face
Pro týmy, které si cení flexibility a již jsou zvyklé na ekosystém Hugging Face, je ideální volbou přístup k DBRX prostřednictvím Hubu. Umožňuje vám integrovat model do vašich stávajících pracovních postupů založených na transformerech.
Zde je návod, jak začít:
- Vytvořte si účet na Hugging Face nebo se přihlaste ke svému účtu
- Přejděte na kartu modelu DBRX v Hubu a přijměte licenční podmínky.
- Nainstalujte knihovnu transformers spolu s nezbytnými závislostmi, jako je například accelerate.
- Ve svém skriptu v jazyce Python použijte třídu `AutoModelForCausalLM` k načtení modelu DBRX
- Nakonfigurujte si svůj inferenční pipeline a mějte na paměti, že DBRX pro efektivní provoz vyžaduje značné množství paměti GPU (VRAM).
📖 Přečtěte si více: Jak nakonfigurovat teplotu LLM
Přístup k DBRX prostřednictvím Databricks
Pokud váš tým již používá Databricks pro datové inženýrství nebo strojové učení, nejjednodušší cestou je přístup k DBRX přímo přes tuto platformu. Odpadají tak potíže s nastavením a získáte všechny nástroje potřebné pro MLOps přímo tam, kde již pracujete.
Chcete-li začít, postupujte podle těchto kroků ve svém pracovním prostoru Databricks:
- Přejděte do sekce Model Garden nebo Mosaic AI
- V závislosti na vašich potřebách si vyberte buď DBRX Base, nebo DBRX Instruct.
- Nakonfigurujte koncový bod pro přístup k API nebo nastavte prostředí notebooku pro interaktivní použití
- Začněte testovat inferenci pomocí vzorových zadání, abyste se ujistili, že vše funguje správně, než rozšíříte trénování nebo nasazení svého modelu umělé inteligence.
Tento přístup vám poskytuje plynulý přístup k nástrojům, jako je MLflow pro sledování experimentů a Unity Catalog pro správu modelů.
📮 ClickUp Insight: Průměrný profesionál stráví více než 30 minut denně hledáním informací souvisejících s prací – to je přes 120 hodin ročně ztracených prohledáváním e-mailů, konverzací na Slacku a roztříštěných souborů.
Inteligentní AI asistent integrovaný do vašeho pracovního prostoru to může změnit. Seznamte se s ClickUp Brain.
Poskytuje okamžité přehledy a odpovědi tím, že během několika sekund vyhledá správné dokumenty, konverzace a podrobnosti o úkolech – takže můžete přestat hledat a začít pracovat.
Jak doladit DBRX a trénovat vlastní modely umělé inteligence
Hotový model, ať už je jakkoli výkonný, nikdy nepochopí jedinečné nuance vašeho podnikání. Protože je DBRX open source, můžete jej doladit a vytvořit vlastní model, který mluví jazykem vaší společnosti nebo vykonává konkrétní úkol, který byste mu chtěli svěřit.
Zde jsou tři běžné způsoby, jak toho dosáhnout:
1. Vyladění DBRX pomocí datových sad Hugging Face
Pro týmy, které teprve začínají nebo pracují na běžných úkolech, jsou veřejné datové sady z Hugging Face Hub skvělým zdrojem. Jsou předformátované a snadno se načítají, což znamená, že nemusíte trávit hodiny přípravou dat.
Postup je celkem jednoduchý:
- Najděte si na Hubu datový soubor, který odpovídá vašemu úkolu (např. plnění pokynů, shrnování).
- Načtěte jej pomocí knihovny datových sad
- Zajistěte, aby data byla naformátována do dvojic „příkaz–odpověď“
- Nakonfigurujte svůj trénovací skript pomocí hyperparametrů, jako je rychlost učení a velikost dávky
- Spusťte trénovací úlohu a nezapomeňte pravidelně ukládat kontrolní body.
- Vyhodnoťte vyladěný model na vyhrazené validační sadě, abyste změřili zlepšení.
2. Vyladění DBRX pomocí lokálních datových sad
Nejlepších výsledků obvykle dosáhnete jemným doladěním pomocí vlastních dat. To vám umožní naučit model specifickou terminologii, styl a odborné znalosti vaší společnosti. Mějte však na paměti, že se to vyplatí pouze v případě, že jsou vaše data čistá, dobře připravená a mají dostatečný objem.
Při přípravě interních dat postupujte podle těchto kroků:
- Sběr dat: Shromažďujte vysoce kvalitní příklady z vašich interních wiki stránek, dokumentů a databází
- Převod formátu: Uspořádejte svá data do jednotného formátu příkaz-odpověď, často ve formě řádků JSON
- Filtrování kvality: Odstraňte všechny příklady nízké kvality, duplicitní nebo irelevantní příklady
- Rozdělení dat pro validaci: Vyčleňte malou část svých dat (obvykle 10–15 %) k vyhodnocení výkonu modelu.
- Kontrola ochrany osobních údajů: Odstraňte nebo zamaskujte veškeré osobní identifikační údaje (PII) nebo citlivé údaje
3. Vyladění DBRX pomocí StreamingDataset
Pokud se váš datový soubor ukáže jako příliš velký na to, aby se vešel do paměti vašeho počítače, nemusíte se obávat – můžete využít knihovnu Streaming Dataset od Databricks. Ta vám umožní streamovat data přímo z cloudového úložiště během trénování modelu, místo aby se všechna data najednou načítala do paměti.
Postupujte takto:
- Příprava dat: Vyčistěte a strukturovejte svá trénovací data a poté je uložte v formátu vhodném pro streamování, jako je JSONL nebo CSV, do cloudového úložiště
- Převod formátu pro streamování: Převedete svůj datový soubor do formátu vhodného pro streamování, jako je například Mosaic Data Shard (MDS), aby jej bylo možné během trénování efektivně načítat
- Nastavení trénovacího načítacího modulu: Nakonfigurujte trénovací načítací modul tak, aby odkazoval na vzdálený datový soubor, a definujte lokální mezipaměť pro dočasné ukládání dat
- Inicializace modelu: Spusťte proces jemného ladění v DBRX pomocí trénovacího frameworku, který podporuje StreamingDataset, jako je například LLM Foundry
- Trénování založené na streamování: Spusťte trénovací úlohu tak, aby se data během trénování streamovala po dávkách, místo aby se načítala celá do paměti
- Kontrolní body a obnovení: V případě přerušení tréninku můžete plynule pokračovat, aniž by docházelo k duplikování nebo vynechávání dat.
- Vyhodnocení a nasazení: Ověřte výkonnost vyladěného modelu a nasadte jej pomocí svého preferovaného nastavení pro poskytování služeb nebo inferenci.
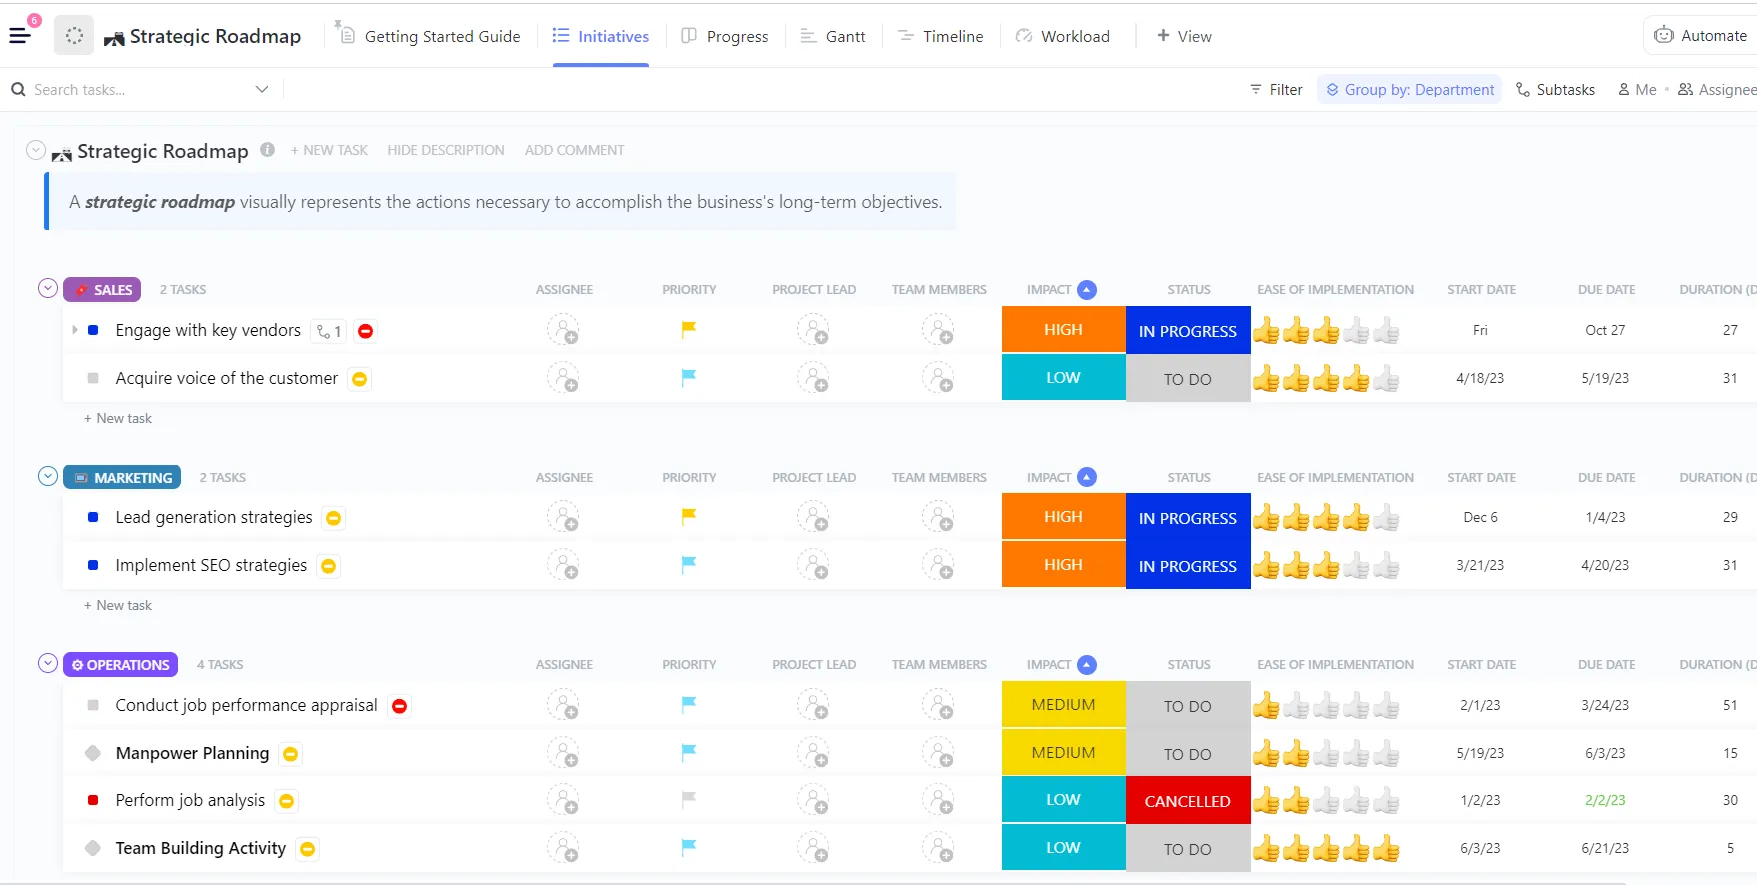
💡Tip pro pokročilé: Místo toho, abyste vytvářeli tréninkový plán pro DBRX úplně od nuly, začněte s šablonou plánu projektů v oblasti AI a strojového učení od ClickUp a přizpůsobte ji potřebám svého týmu. Poskytuje jasnou strukturu pro plánování datových sad, tréninkových fází, vyhodnocování a nasazení, takže se můžete soustředit na organizaci své práce, místo na vytváření struktury pracovního postupu.
Příklady použití DBRX pro trénování modelů umělé inteligence
Jedna věc je mít výkonný model, ale druhá věc je přesně vědět, v čem vyniká.
Pokud nemáte jasnou představu o silných stránkách modelu, snadno se stane, že budete plýtvat časem a zdroji snahou o jeho nasazení tam, kde prostě není vhodný. To vede k podprůměrným výsledkům a frustraci.
Díky své jedinečné architektuře a trénovacím datům je DBRX mimořádně vhodný pro několik klíčových podnikových případů použití. Znalost těchto předností vám pomůže přizpůsobit model vašim obchodním cílům a maximalizovat návratnost investic.
Generování textu a tvorba obsahu
DBRX Instruct je přesně vyladěn pro dodržování pokynů a generování vysoce kvalitního textu. Díky tomu je výkonným nástrojem pro automatizaci široké škály úkolů souvisejících s obsahem. Jeho velká kontextová oblast je významnou výhodou, která mu umožňuje zpracovávat dlouhé dokumenty, aniž by ztratil nit.
Můžete jej použít pro:
- Technická dokumentace: Vytvářejte a vylepšujte produktové manuály, referenční příručky k API a uživatelské příručky
- Marketingový obsah: Návrhy blogových příspěvků, e-mailových zpravodajů a příspěvků na sociálních sítích
- Vytváření reportů: Shrňte komplexní zjištění z dat a vytvořte stručné souhrny pro vedení
- Překlad a lokalizace: Přizpůsobte stávající obsah novým trhům a cílovým skupinám
Úlohy generování kódu a ladění
Významnou část trénovacích dat DBRX tvořil kód, díky čemuž se tento model stal výkonným nástrojem LLM pro vývojáře. Může pomoci urychlit vývojové cykly automatizací opakujících se úloh při programování a asistencí při řešení složitých problémů.
Zde je několik způsobů, jak to může váš technický tým využít:
- Doplňování kódu: Automatické generování těl funkcí z komentářů nebo docstringů
- Detekce chyb: Analyzujte úryvky kódu a identifikujte potenciální chyby nebo logické nedostatky
- Vysvětlení kódu: Přeložte složité algoritmy nebo starší kód do srozumitelné angličtiny
- Generování testů: Vytvářejte jednotkové testy na základě podpisu funkce a očekávaného chování
RAG a aplikace s dlouhým kontextem
Retrieval-Augmented Generation (RAG) je výkonná technika, která zakládá odpovědi modelu na soukromých datech vaší společnosti. Systémy RAG však často narážejí na potíže s modely, které mají malá kontextová okna, což nutí k agresivnímu rozdělování dat na části, při kterém může dojít ke ztrátě důležitého kontextu. Kontextové okno DBRX o velikosti 32K z něj činí vynikající základ pro robustní aplikace RAG.
Díky tomu můžete vytvářet výkonné interní nástroje, jako například:
- Vyhledávání v podniku: Vytvořte chatbota, který bude odpovídat na dotazy zaměstnanců s využitím vaší interní znalostní báze
- Zákaznická podpora: Vytvořte agenta, který generuje odpovědi na dotazy zákazníků na základě dokumentace k vašemu produktu
- Pomoc při výzkumu: Vyvinout nástroj, který dokáže syntetizovat informace ze stovek stránek výzkumných prací
- Kontrola souladu: Automaticky ověřujte marketingové texty podle interních směrnic značky nebo regulačních dokumentů
Jak integrovat trénování pomocí DBRX do pracovního postupu vašeho týmu
Úspěšný projekt trénování modelů umělé inteligence není jen o kódu a výpočetním výkonu. Jedná se o společné úsilí, na kterém se podílejí inženýři strojového učení, datoví vědci, produktoví manažeři a zainteresované strany.
Pokud je tato spolupráce roztříštěná mezi notebooky Jupyter, kanály Slacku a samostatné nástroje pro řízení projektů, dochází k tzv. rozptýlení kontextu – situaci, kdy jsou klíčové informace o projektu roztříštěné mezi příliš mnoha nástroji.
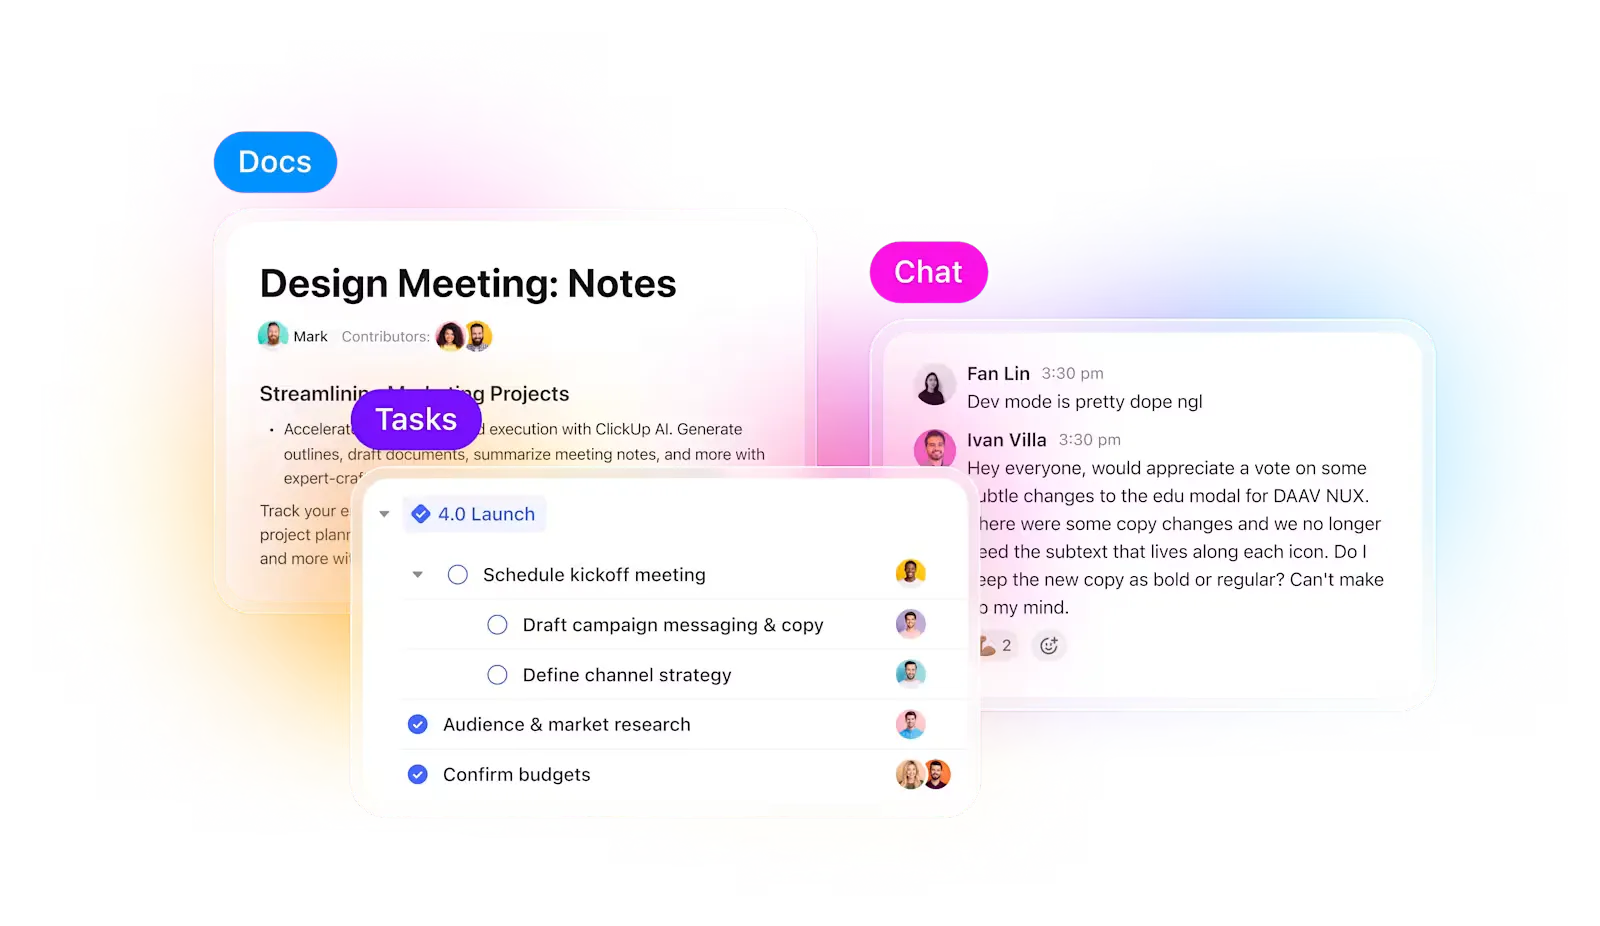
ClickUp tento problém řeší. Místo toho, abyste museli žonglovat s několika nástroji, získáte jeden sjednocený pracovní prostor pro AI, kde se spojuje řízení projektů, dokumentace a komunikace – takže vaše experimenty zůstávají propojené od plánování přes provedení až po vyhodnocení.
Nikdy neztraťte přehled o experimentech a jejich průběhu
Při provádění více experimentů není nejtěžší částí trénování modelu, ale sledování toho, co se během procesu změnilo. Která verze datového souboru byla použita, jaká rychlost učení fungovala nejlépe nebo který běh byl nasazen?
ClickUp vám tento proces výrazně usnadní. V úkolech ClickUp můžete sledovat každý tréninkový cyklus samostatně a v rámci úkolů můžete pomocí vlastních polí zaznamenávat:
- Verze datového souboru
- Hyperparametry
- Varianta modelu (DBRX Base vs. DBRX Instruct)
- Stav trénování (Ve frontě, Probíhá, Vyhodnocuje se, Nasazeno)
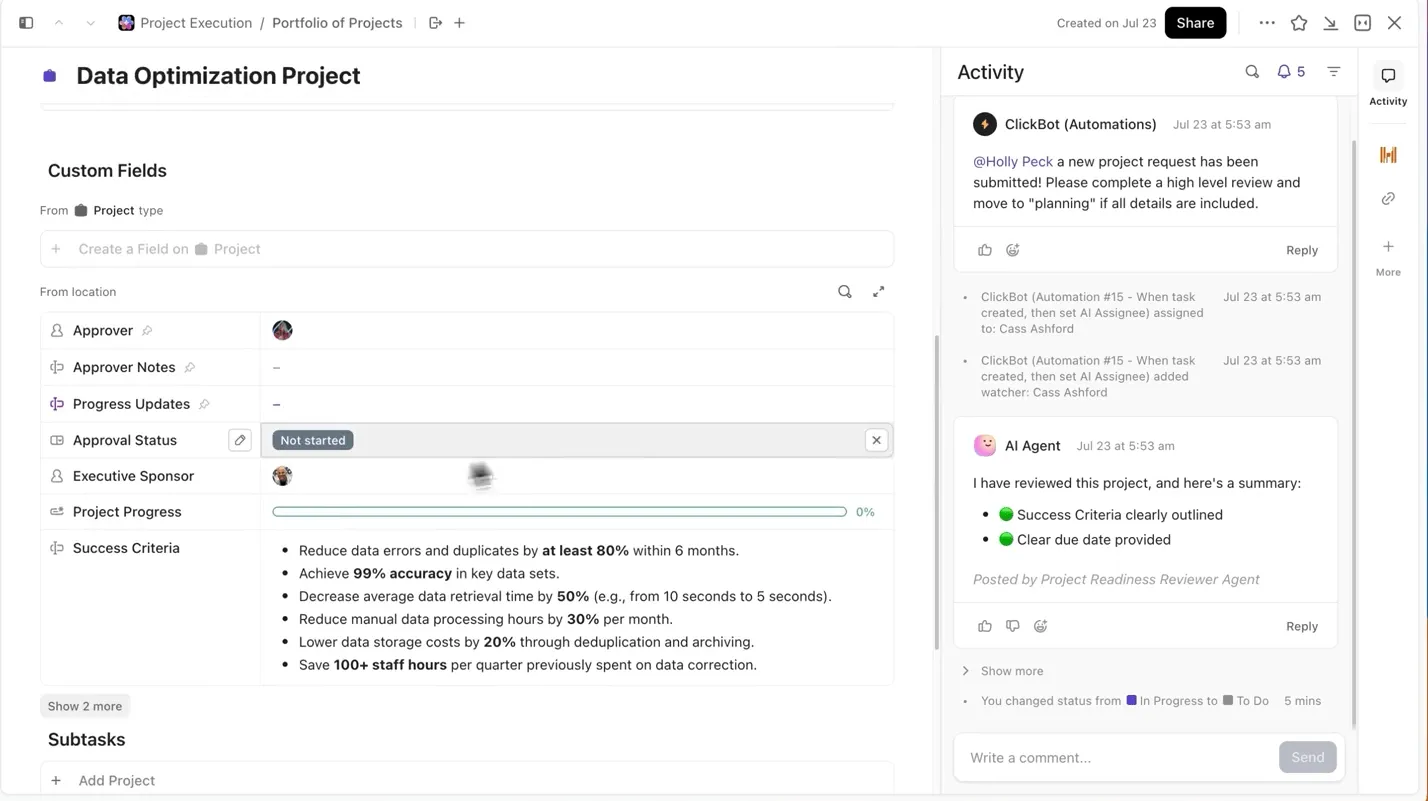
Díky tomu je každý zdokumentovaný experiment vyhledatelný, snadno srovnatelný s ostatními a reprodukovatelný.
Propojte dokumentaci modelů s prací
Nemusíte přeskakovat mezi notebooky Jupyter, soubory README nebo vlákny ve Slacku, abyste pochopili kontext úkolu v rámci experimentu.
Díky ClickUp Docs můžete udržovat architekturu modelů, skripty pro přípravu dat nebo metriky hodnocení přehledně uspořádané a snadno dostupné tím, že je zdokumentujete v prohledávatelném dokumentu, který odkazuje přímo na experimentální úkoly, z nichž pocházejí.
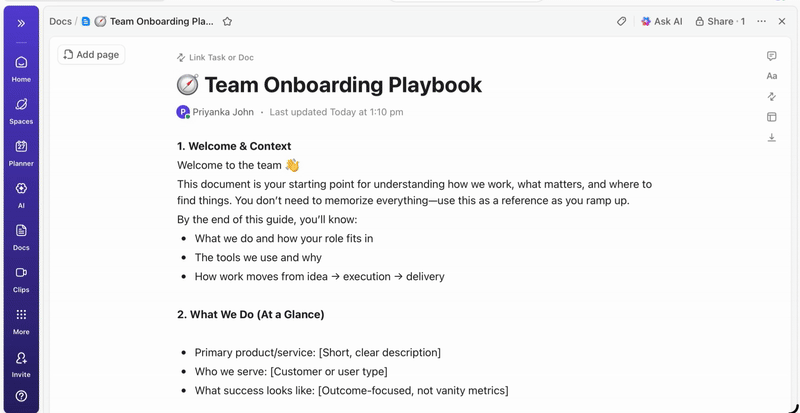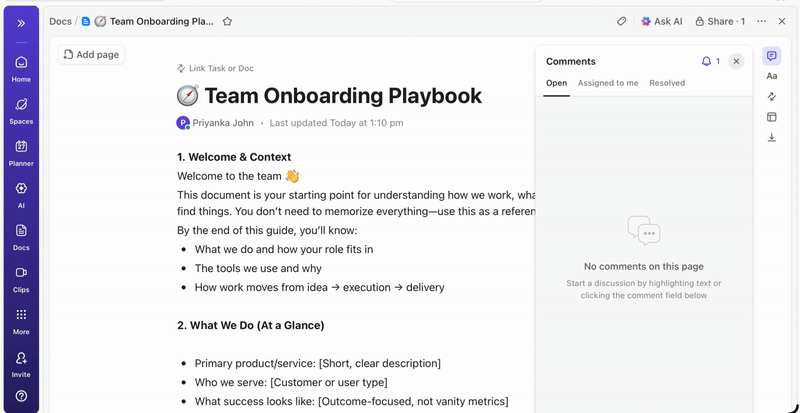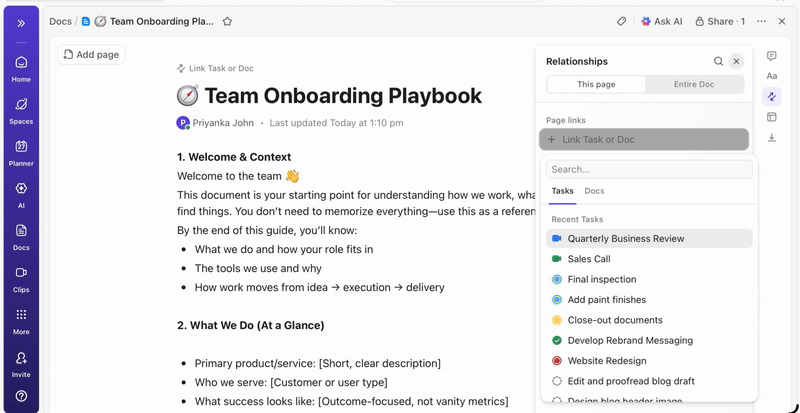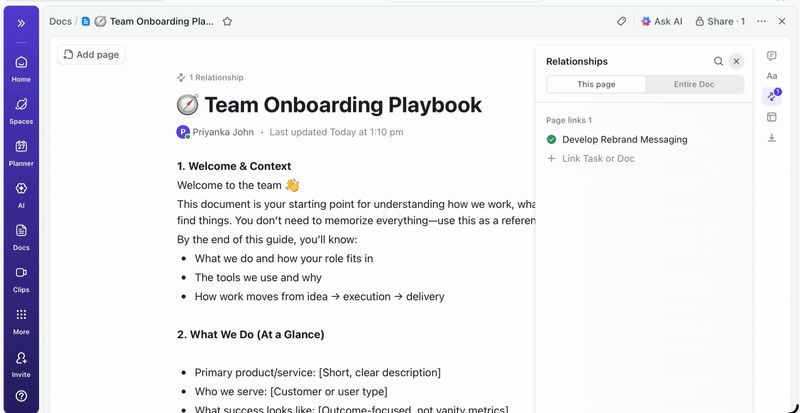
💡Tip pro profesionály: Vytvořte si v ClickUp Docs průběžně aktualizovaný popis projektu, který podrobně zachycuje každé rozhodnutí, od architektury až po nasazení, aby se noví členové týmu mohli kdykoli rychle seznámit s detaily projektu, aniž by museli prohledávat staré diskuze.
Poskytněte zainteresovaným stranám přehled v reálném čase
Dashboardy ClickUp zobrazují průběh experimentů a pracovní vytížení týmu v reálném čase. I
Místo ručního sestavování aktualizací nebo zasílání e-mailů se přehledy aktualizují automaticky na základě dat ve vašich úkolech. Zainteresované strany tak mohou kdykoli nahlédnout do stavu projektu, zjistit, jak to vypadá, a nemusí vás nikdy rušit otázkami typu „jaký je stav?“.
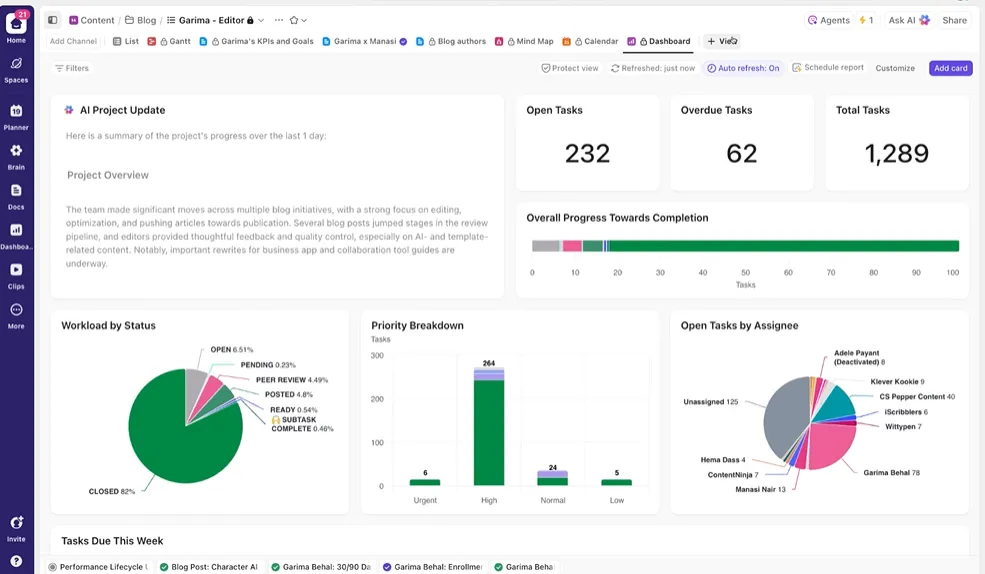
Díky tomu se můžete soustředit na provádění experimentů, místo abyste o nich museli neustále ručně podávat zprávy.
Udělejte z AI svého chytrého pomocníka při práci na projektech
Nemusíte ručně prohledávat týdny trénovacích dat, abyste získali přehled o dosavadních experimentech. Stačí v komentáři k jakémukoli úkolu zmínit @Brain a ClickUp Brain vám poskytne potřebnou pomoc s úplným kontextem vašich minulých i probíhajících projektů.
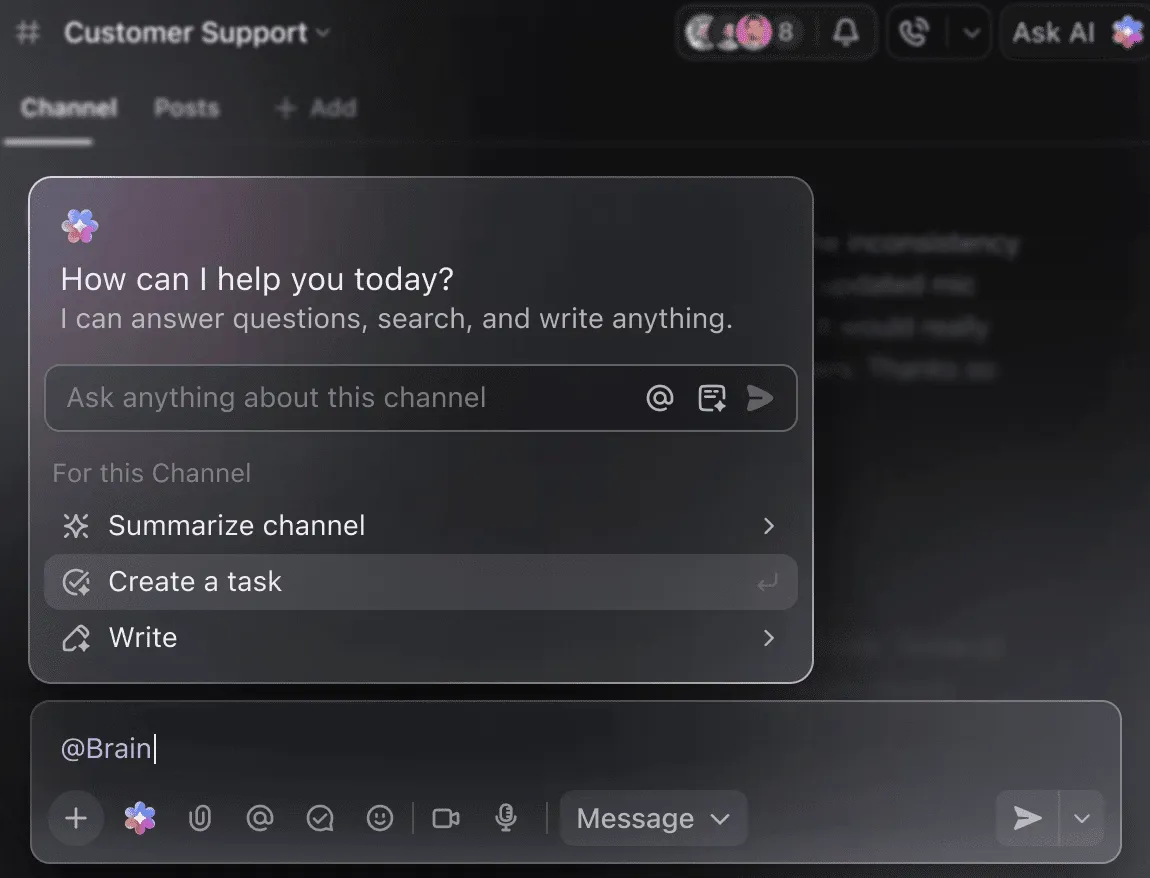
Můžete požádat Brain, aby „shrnul experimenty z minulého týdne do 5 bodů“ nebo „vytvořil dokument s nejnovějšími výsledky hyperparametrů“, a okamžitě získáte propracovaný výstup.
🧠 Výhoda ClickUp: Super agenti ClickUp jdou ještě mnohem dál – dokážou automatizovat celé pracovní postupy na základě spouštěčů, které si sami definujete, a ne jen odpovídat na vaše dotazy. Díky superagentům můžete automaticky vytvořit nový trénovací úkol v DBRX pokaždé, když se nahraje datový soubor, informovat svůj tým a propojit relevantní dokumenty, jakmile se trénink dokončí nebo dosáhne kontrolního bodu, a generovat týdenní souhrn pokroku a odeslat jej zainteresovaným stranám, aniž byste museli hnout prstem.
Časté chyby, kterým je třeba se vyvarovat
Zahájení projektu trénování s DBRX je vzrušující, ale několik běžných úskalí může váš pokrok zbrzdit. Vyhnete-li se těmto chybám, ušetříte čas, peníze a spoustu frustrace.
- Podcenění hardwarových požadavků: DBRX je výkonný, ale také náročný na zdroje. Pokus o jeho spuštění na nedostatečném hardwaru povede k chybám typu „out-of-memory“ a selhání trénovacích úloh. Mějte na paměti, že DBRX (132B) vyžaduje pro 16bitovou inferenci alespoň 264 GB VRAM, nebo přibližně 70–80 GB při použití 4bitové kvantizace.
- Vynechání kontrol kvality dat: Špatná vstupní data vedou k špatným výstupům. Dolaďování modelu na neuspořádaném datovém souboru nízké kvality naučí model pouze vytvářet neuspořádané výstupy nízké kvality.
- Ignorování omezení délky kontextu: Ačkoli je kontextové okno DBRX o velikosti 32K velkorysé, není nekonečné. Pokud do modelu zadáte vstupy, které tento limit překročí, dojde k tichému zkrácení a snížení výkonu.
- Kdy je vhodné použít DBRX Base místo DBRX Instruct: DBRX Base je nezpracovaný, předem vycvičený model určený k dalšímu trénování ve velkém měřítku. Pro většinu úkolů, při nichž je třeba, aby model plnil pokyny, byste měli začít s DBRX Instruct, který již byl pro tento účel doladěn.
- Oddělení trénování od koordinace projektu: Pokud sledujete experimenty v jednom nástroji a projektový plán v jiném, vytváříte informační silo. Použijte integrovanou platformu, jako je ClickUp, abyste udrželi technickou práci a koordinaci projektu v synchronizaci.
- Zanedbání vyhodnocení před nasazením: Model, který podává dobrý výkon na vašich trénovacích datech, může v reálném světě selhat na celé čáře. Vždy ověřte svůj vyladěný model na vyhrazené testovací sadě, než jej nasadíte do produkčního prostředí.
- Přehlížení složitosti jemného ladění: Jelikož je DBRX modelem typu „Mixture-of-Experts“, mohou standardní skripty pro jemné ladění vyžadovat specializované knihovny, jako jsou Megatron-LM nebo PyTorch FSDP, aby zvládly rozdělení parametrů mezi více GPU.
DBRX vs. jiné platformy pro trénování AI
Rozhodování o platformě pro trénování AI s sebou nese zásadní kompromis: kontrola versus pohodlí. Proprietární modely dostupné pouze přes API se snadno používají, ale uzamykají vás do ekosystému daného dodavatele.
Modely s otevřenými váhami, jako je DBRX, nabízejí úplnou kontrolu, ale vyžadují větší technické znalosti a infrastrukturu. Tato volba vás může uvést do slepé uličky, kdy si nebudete jisti, která cesta skutečně podporuje vaše dlouhodobé cíle – což je výzva, s níž se při zavádění umělé inteligence potýká mnoho týmů.
Tato tabulka uvádí přehled klíčových rozdílů, které vám pomohou učinit informované rozhodnutí.
| Váhy | Otevřít (vlastní) | Vlastní | Otevřít (vlastní) | Vlastní |
| Dolaďování | Plná kontrola | Na bázi API | Plná kontrola | Na základě API |
| Vlastní hostování | Ano | Ne | Ano | Ne |
| Licence | DB Open Model | Podmínky OpenAI | Komunita Llama | Termíny společnosti Anthropic |
| Kontext | 32K | 128 000 – 1 milion | 128K | 200 000 – 1 milion |
DBRX je tou správnou volbou, pokud potřebujete plnou kontrolu nad modelem, musíte z důvodů bezpečnosti nebo dodržování předpisů provozovat vlastní server, nebo pokud chcete flexibilitu, kterou nabízí liberální komerční licence. Pokud nemáte k dispozici specializovanou GPU infrastrukturu – nebo pokud upřednostňujete rychlé uvedení na trh před rozsáhlým přizpůsobením – mohou být vhodnější alternativy založené na API.
Začněte trénovat chytřeji s ClickUpem
DBRX vám poskytuje základ vhodný pro podnikové použití pro vytváření vlastních aplikací umělé inteligence, a to s transparentností a kontrolou, které vám proprietární modely nenabízejí. Jeho efektivní architektura MoE udržuje náklady na inferenci na nízké úrovni a díky otevřenému designu je ladění snadné. Silná technologie je však jen polovinou úspěchu.
Skutečný úspěch spočívá v propojení vaší technické práce s kolaborativním pracovním tokem vašeho týmu. Trénování modelů umělé inteligence je týmová záležitost a je zásadní udržovat synchronizaci experimentů, dokumentace a komunikace se zainteresovanými stranami. Když vše sjednotíte do jediného konvergovaného pracovního prostoru a omezíte roztříštěnost kontextu, můžete dodávat lepší modely rychleji.
Začněte zdarma s ClickUp a koordinujte své projekty trénování AI v jednom pracovním prostoru. ✨
Často kladené otázky
Jak mohu sledovat průběh trénování v DBRX?
Trénování můžete sledovat pomocí standardních nástrojů pro strojové učení, jako jsou TensorBoard, Weights & Biases nebo MLflow. Pokud trénujete v rámci ekosystému Databricks, je MLflow nativně integrován pro plynulé sledování experimentů.
Mohu integrovat DBRX s CI/CD a nasazovacími pipeline?
Ano, DBRX lze integrovat do standardních MLOps pipeline. Díky kontejnerizaci modelu jej můžete nasadit pomocí orchestračních platforem, jako je Kubeflow, nebo pomocí vlastních CI/CD workflow.
Jaký je rozdíl mezi DBRX Base a DBRX Instruct?
DBRX Base je základní předtrénovaný model určený pro týmy, které chtějí provádět pokračující předtrénování specifické pro danou doménu nebo hluboké architektonické doladění. DBRX Instruct je doladěná verze optimalizovaná pro plnění pokynů, což z ní činí lepší výchozí bod pro většinu vývoje aplikací.
Jak si DBRX vede ve srovnání s GPT-4 v podnikových projektech umělé inteligence?
Hlavním rozdílem je kontrola. DBRX vám poskytuje plný přístup k váhám modelu pro podrobné přizpůsobení a vlastní hostování, zatímco GPT-4 je služba dostupná pouze prostřednictvím API.
Lze DBRX používat zdarma?
Váhy modelů DBRX jsou k dispozici zdarma na základě licence Databricks Open Model License. Náklady na výpočetní infrastrukturu potřebnou ke spuštění nebo doladění modelu však hradíte vy.